
Za każdym razem, gdy ktoś pyta mnie: „czy scraping Instagrama jest legalny”, odpowiedzi zwykle rozchodzą się na trzy obozy: „zupełnie OK”, „absolutnie nielegalne” i „to zależy”. Tylko ten trzeci obóz ma realną wartość.
Całe zamieszanie bierze się stąd, że odpowiedź zależy od tego, jakie dane zbierasz, gdzie znajdujesz się Ty i osoby, których dane dotyczą, w jaki sposób uzyskujesz dostęp oraz po co tego potrzebujesz. Ten artykuł porządkuje temat. Przejdę przez najważniejsze orzeczenia sądowe, różnicę między złamaniem zasad platformy a złamaniem prawa, porównanie jurysdykcji oraz praktyczny schemat decyzyjny, żebyś mógł ocenić własną sytuację. To nie jest porada prawna — piszę o technologii, nie jestem prawnikiem — ale powinno Ci to dać dużo jaśniejszy obraz terenu.
Co tak naprawdę oznacza „scraping Instagrama”?
Najpierw definicja.
Scraping Instagrama to używanie oprogramowania do automatycznego zbierania publicznie widocznych informacji z witryny lub aplikacji Instagramu — takich jak bio profilu, podpisy pod postami, komentarze, użycia hashtagów, liczba obserwujących czy metryki zaangażowania.
To nie to samo, co korzystanie z oficjalnego Graph API Instagrama, które ma własne ograniczenia, zasady akceptacji i restrykcje dotyczące zastosowań. Scraping nie korzysta z oficjalnego API; pobiera dane bezpośrednio ze stron internetowych albo widoków aplikacji.
Typowe zastosowania:
- Pozyskiwanie leadów: wyszukiwanie potencjalnych klientów lub influencerów na podstawie publicznych profili i wzorców zaangażowania.
- Monitorowanie konkurencji: śledzenie częstotliwości publikacji, poziomu zaangażowania i strategii treści konkurentów.
- Badania rynku: analiza trendów hashtagów, nastrojów lub wzorców geograficznych w publicznych postach.
- Badania akademickie: analiza publicznej debaty, kultury wizualnej albo dynamiki sieci społecznych na potrzeby pracy naukowej.
Ten artykuł skupia się na legalności — nie na technicznych instrukcjach. Jeśli chcesz ustalić, czy konkretny przypadek może skończyć się pozwem, blokadą lub karą, czytaj dalej.
Czy scraping Instagrama jest legalny? Krótka odpowiedź
Scraping publicznie dostępnych danych z Instagrama jest zwykle nieprzestępstwem federalnym w świetle obecnego orzecznictwa w USA — ale „to nie jest przestępstwo” i „to całkowicie bezpieczne” to dwie zupełnie różne rzeczy.
W grę wchodzą trzy odrębne warstwy prawne, a całe zamieszanie często wynika z tego, że ludzie wrzucają je do jednego worka:
- Przepisy dotyczące dostępu do systemów (np. amerykańska Computer Fraud and Abuse Act, czyli CFAA): czy dostęp do danych był „nieautoryzowany”?
- Regulacje prywatności (np. GDPR, CCPA): czy dane obejmują informacje osobowe i czy masz podstawę prawną do ich przetwarzania?
- Umowa / Warunki korzystania z usługi: czy regulamin Instagrama zabrania tego, co robisz, i co grozi za naruszenie?
Każda z tych warstw ma inne konsekwencje, mechanizmy egzekwowania i poziom ryzyka. Scraping może być całkiem w porządku w jednej warstwie, a jednocześnie bardzo problematyczny w innej.
„Czy mój scraping jest legalny?” — schemat decyzyjny, z którego naprawdę da się skorzystać
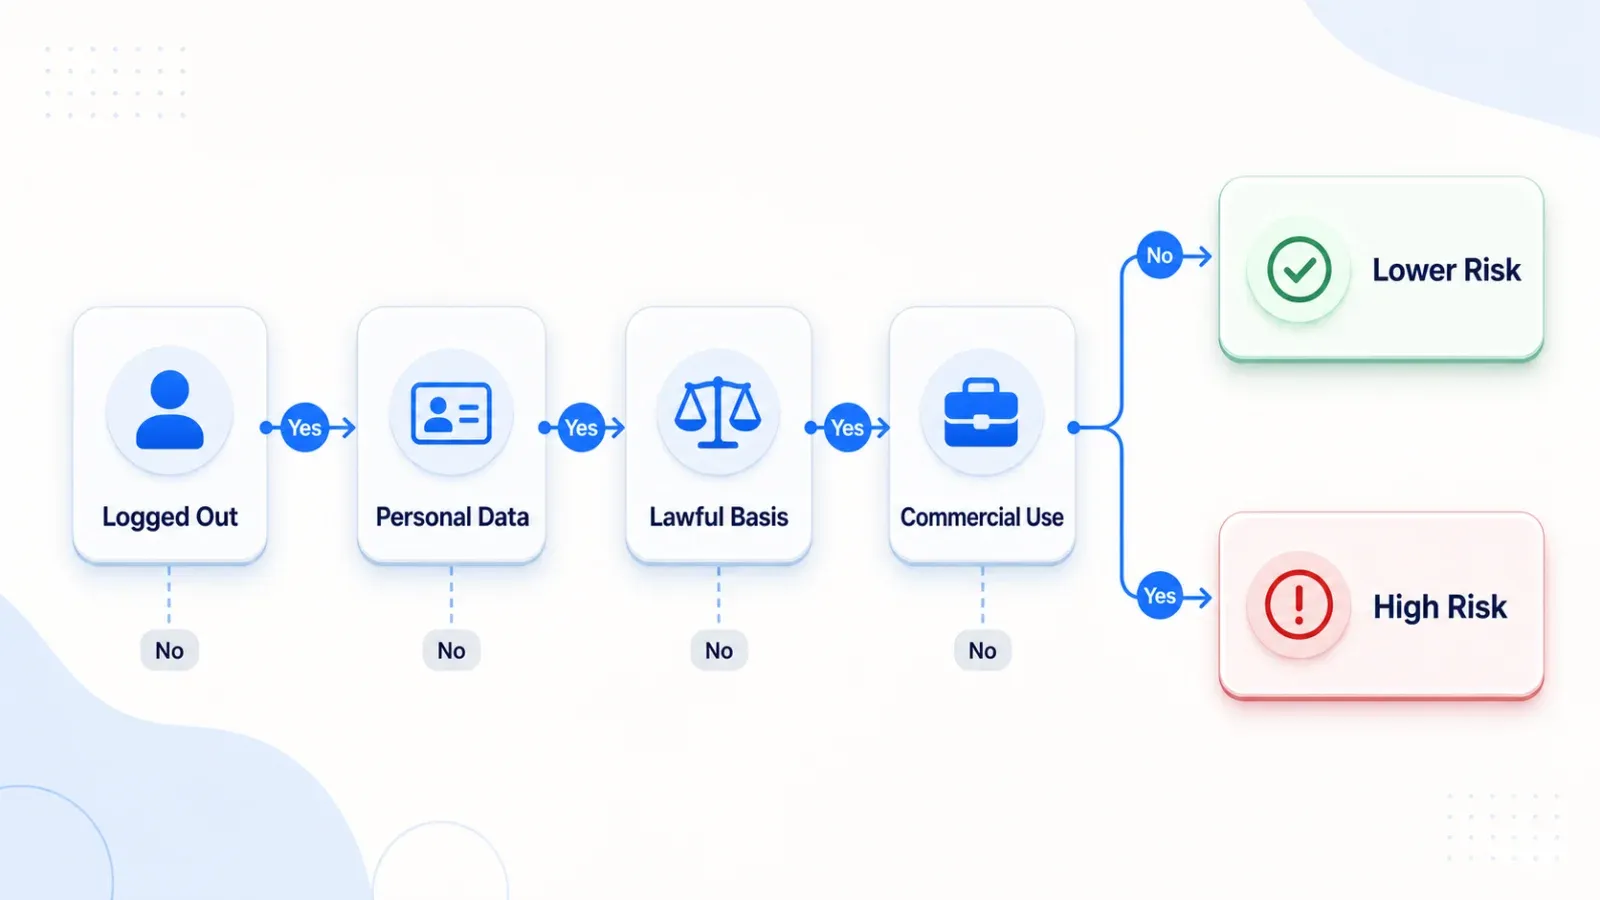
Przeczytałem dziesiątki tekstów na ten temat. Wszystkie wymieniają te same czynniki prawne w ciężkich akapitach — i żaden nie daje prostego sposobu, by w minutę ocenić własną sytuację. Oto drzewo decyzyjne:
| Krok | Pytanie | Jeśli TAK → | Jeśli NIE → |
|---|---|---|---|
| 1 | Czy dane są publicznie widoczne bez logowania? | Przejdź do kroku 2 | ⚠️ Wysokie ryzyko — możliwe zastosowanie CFAA / przepisów o kontroli dostępu |
| 2 | Czy dane zawierają informacje osobowe (imiona, zdjęcia, bio, adresy e-mail)? | Przejdź do kroku 3 (obowiązuje GDPR/CCPA) | Niższe ryzyko — przejdź do kroku 4 |
| 3 | Czy masz podstawę prawną zgodnie z GDPR/CCPA (uzasadniony interes, zgoda itd.)? | Przejdź do kroku 4 | ⛔ Nie działaj bez konsultacji z prawnikiem |
| 4 | Czy użycie ma charakter komercyjny (odsprzedaż danych, lead gen, produkt SaaS)? | Wyższe ryzyko egzekwowania — sprawdź regulamin i precedensy związane z wezwaniami do zaprzestania | Niższe ryzyko — szczególnie przy użyciu osobistym lub akademickim |
| 5 | Czy unikasz obejść technicznych i nadmiernego automatycznego dostępu? | Niższe ryzyko praktyczne | Wyższe ryzyko prawne, platformowe i związane z kontem |
To nie jest „wolna amerykanka” — to ramy oceny ryzyka. Jeśli odpowiedziałeś „tak” na kroki 1, 3 i 5 oraz „nie” na krok 4, jesteś w strefie niższego ryzyka. Jeśli jesteś zalogowany, zbierasz dane osobowe bez podstawy prawnej, sprzedajesz je komercyjnie i ignorujesz ograniczenia platformy, dokładasz ryzyko do ryzyka.
W procesach biznesowych bezpieczniejszą ścieżką jest często całkowite unikanie zbierania danych z Instagrama i korzystanie z dozwolonych źródeł publicznych, takich jak strony firmowe, landing page’e twórców, strony e-commerce, katalogi czy licencjonowane zbiory danych. Ten schemat ma zastosowanie niezależnie od tego, jakiego narzędzia używasz.
Krok 1: Czy dane są publicznie widoczne?
Test okna incognito: otwórz prywatne okno przeglądarki (bez logowania do Instagrama), wejdź na stronę i sprawdź. Jeśli widzisz dane, w praktycznym sensie są one publicznie dostępne. Amerykańskie sprawy, takie jak hiQ v. LinkedIn, traktują dane publiczne dostępne bez logowania inaczej niż dane chronione kontrolą dostępu na potrzeby CFAA — ale to nie jest automatyczna zgoda na wszystko.
Instagram z czasem zmienia też to, co widać bez logowania. Zanim założysz, że dane są dostępne bez konta, sprawdź, co faktycznie jest publiczne dzisiaj.
Krok 2: Czy zawiera informacje osobowe?
Dane osobowe są szeroko rozumiane w GDPR i CCPA: nazwy użytkowników, zdjęcia profilowe, bio, adresy e-mail, oznaczenia lokalizacji, a nawet wnioski wyciągnięte ze zdjęć lub podpisów. Jeśli scrapujesz profile Instagrama, niemal na pewno zbierasz dane osobowe.
Publiczna widoczność nie zwalnia z przepisów o prywatności — to jeden z najbardziej uporczywych mitów w tej dziedzinie.
Krok 3: Czy masz podstawę prawną?
Zgodnie z art. 6 GDPR przed przetwarzaniem danych osobowych potrzebujesz udokumentowanej podstawy prawnej. „Uzasadniony interes” jest najczęściej przywoływaną podstawą przy scrapingu, ale wymaga formalnego testu równowagi — Twojego interesu względem praw osoby, której dane dotyczą. Zgoda to inna opcja, ale przy scrapingu na dużą skalę jest zwykle mało praktyczna.
Zgodnie z CCPA mieszkańcy Kalifornii mają prawa związane ze swoimi danymi osobowymi, w tym prawo dostępu, usunięcia oraz sprzeciwu wobec sprzedaży/udostępniania. Jeśli jesteś kwalifikującą się firmą zbierającą dane o mieszkańcach Kalifornii, te obowiązki mogą Cię dotyczyć.
Brak podstawy prawnej + dane osobowe = stop i konsultacja z prawnikiem.
Krok 4: Czy użycie ma charakter komercyjny?
Komercyjne wykorzystanie — odsprzedaż zbiorów danych, budowanie produktów do generowania leadów, zasilanie narzędzia SaaS — przyciąga największą uwagę egzekucyjną Meta. Projekty osobiste i badania akademickie wiążą się z niższym ryzykiem praktycznym, choć nie są wolne od ryzyka.
Krok 5: Czy respektujesz limity i zabezpieczenia platformy?
Nie obchodź CAPTCHA, ścian logowania, mechanizmów anty-botowych ani ograniczeń konta. Nawet jeśli dane wyglądają na publiczne, agresywny automatyczny dostęp zwiększa ryzyko egzekwowania zasad platformy, naruszenia umowy, naruszenia prywatności i problemów operacyjnych.
Dane publiczne vs. prywatne: granica, która ma największe znaczenie
Wszystko sprowadza się do jednego rozróżnienia: dane publiczne kontra prywatne.
| Zwykle niższe ryzyko scrapingu | Tego nie scrapuj |
|---|---|
| Publiczne bio profilu, nazwy wyświetlane | Posty i relacje z kont prywatnych |
| Publiczne podpisy pod postami i komentarze | Wiadomości bezpośrednie (DM) |
| Publiczne użycia hashtagów | Treści za ścianą logowania |
| Publiczne liczby zaangażowania (polubienia, liczba komentarzy) | Dane z fałszywych / kupionych kont |
| Publiczne zdjęcia profilowe (z zastrzeżeniami prawa prywatności) | Listy obserwujących na dużą skalę (szara strefa) |
Szarych stref jest mnóstwo. Listy obserwujących i obserwowanych, oznaczenia lokalizacji oraz konta dzieci znajdują się w prawnie niejednoznacznym obszarze. Nawet jeśli technicznie są widoczne, ich masowe scrapowanie może uruchomić problemy prywatnościowe albo reakcję platformy. Gdy masz wątpliwości, lepiej tego nie zbierać.
Rozumowanie oparte na amerykańskim prawie dostępu do systemów wynika z takich spraw jak hiQ v. LinkedIn, ale trzeba trzymać się wąskiego zakresu: chodzi o autoryzację dostępu na gruncie CFAA, a nie o stwierdzenie, że każdy publiczny profil społecznościowy można swobodnie zbierać i wykorzystywać. Regulacje prywatności, takie jak GDPR, działają w zupełnie innym modelu.
Naruszenie regulaminu vs. odpowiedzialność karna: największe nieporozumienie wokół scrapingu Instagrama
Powiem to wprost:
Naruszenie Warunków korzystania z Instagrama nie jest przestępstwem.
W Terms of Use Instagram wskazuje, że użytkownicy nie mogą tworzyć kont ani uzyskiwać dostępu / zbierać informacji w nieautoryzowany sposób, w tym poprzez automatyczne pobieranie bez wyraźnej zgody Instagrama. Z kolei Automated Data Collection Terms Meta również wymagają wyraźnej pisemnej zgody.
To są zasady umowne — porozumienie między Tobą a Instagramem. Ich złamanie może prowadzić do blokady konta, a w skrajnych przypadkach do pozwów cywilnych. To nie są przepisy karne.
Oto uproszczona hierarchia prawna:
| Warstwa prawna | Co to jest | Konsekwencja naruszenia |
|---|---|---|
| Prawo umowne (TOS) | Umowa między Tobą a Instagramem | Blokada konta, pozew cywilny za naruszenie umowy |
| Prawo ustawowe (CFAA) | Federalne prawo dotyczące dostępu do systemów | Potencjalna odpowiedzialność karna — ale znacznie zawężona przez Van Buren v. US (2021) |
| Prawo regulacyjne (GDPR/CCPA) | Przepisy o prywatności | Kary do 4% globalnych przychodów (GDPR); różne sankcje w ramach CCPA |
To właśnie kluczowa różnica: zasada platformy może skutkować blokadą konta i odpowiedzialnością cywilną na gruncie umowy, ale nie zamienia się automatycznie w przestępstwo komputerowe.
Istotny jest też niuans, bo Meta v. Bright Data (styczeń 2024) zakończyła się korzystnie dla Bright Data w zakresie teorii naruszenia umowy dotyczącej scrapingu publicznych danych Facebooka i Instagrama w trybie wylogowanym. Ale to orzeczenie było wąskie: dostęp bez logowania, dane publiczne, konkretny stan faktyczny i jeden sąd federalny w USA. Nie oznacza ono przyzwolenia na scraping za ścianą logowania, zbieranie z fałszywych kont, pobieranie danych prywatnych, naruszanie przepisów prywatności ani dowolne komercyjne ponowne wykorzystanie danych z Instagrama.
Co naprawdę może się stać, gdy scrapujesz Instagrama: macierz ryzyka
Ludzie stale pytają: „Czy Instagram może mnie pozwać?” i „Czy moje konto zostanie zablokowane?”. Oto uczciwy podział:
| Skutek | Co się dzieje | Skala | Prawdopodobieństwo |
|---|---|---|---|
| Blokada / zawieszenie konta | Natychmiastowe, zwykle bez możliwości odwołania | Niski-średni wpływ | WYSOKIE przy agresywnym scrapingu |
| Wezwanie do zaprzestania naruszeń | Prawne pismo od prawników Meta | Średni wpływ (koszty prawne odpowiedzi) | ŚREDNIE przy użyciu komercyjnym |
| Pozew cywilny (naruszenie TOS) | Roszczenie o odszkodowanie, nakaz sądowy | Wysoki wpływ | NISKIE (zarezerwowane dla operacji o dużej skali / komercyjnych) |
| Postępowanie CFAA | Oskarżenie karne | Bardzo wysoki wpływ | BARDZO NISKIE (znacznie zawężone po Van Buren) |
| Kara GDPR | Do 4% globalnych przychodów | Bardzo wysoki wpływ | NISKIE-ŚREDNIE przy scrapingu danych osobowych z UE |
Dwa najbardziej prawdopodobne skutki to ograniczenia konta i wezwania do zaprzestania naruszeń. Najlepszą kontrolą nie jest obejście techniczne; jest nią dyscyplina zakresu: unikaj pobierania po zalogowaniu lub z ograniczonym dostępem, minimalizuj dane osobowe, dokumentuj cel i podstawę prawną oraz korzystaj tam, gdzie to możliwe, z oficjalnych lub opartych na zgodzie ścieżek.
Meta twierdzi na swojej stronie o postępach w zakresie prywatności, że blokuje codziennie miliardy podejrzanych nieautoryzowanych działań scrapujących w Facebooku, Instagramie i WhatsAppie. To deklaracja samej Meta i nie mogę niezależnie potwierdzić tej liczby, ale pokazuje, jak poważnie firma traktuje egzekwowanie zasad.
Kraj po kraju: gdzie scraping Instagrama jest legalny?
Legalność zależy od jurysdykcji, a żadne dwa kraje nie traktują tego identycznie. Oto tabela porównawcza, której — o ile wiem — nikt inny nie opublikował w tak łatwej do skanowania formie:
| Jurysdykcja | Kluczowe przepisy | Scraping danych publicznych | Scraping danych osobowych | Ryzyko wynikające wyłącznie z TOS | Ważna sprawa / orzeczenie |
|---|---|---|---|---|---|
| USA | CFAA, stanowe odpowiedniki CFAA | Niższe ryzyko CFAA przy publicznych danych dostępnych bez logowania w niektórych przypadkach, ale zależne od faktów | CCPA/CPRA mogą dotyczyć kwalifikujących się firm i mieszkańców Kalifornii | Nadal może istnieć ekspozycja kontraktowa / kontowa / cywilna | hiQ v. LinkedIn (2022), Van Buren v. US (2021), Meta v. Bright Data (2024) |
| UE | GDPR, dyrektywa o bazach danych | Niższe ryzyko prywatności, jeśli nie ma danych osobowych; nadal mogą mieć znaczenie inne prawa | Wymagana podstawa prawna zgodnie z art. 6 | Nadal może mieć znaczenie egzekwowanie umowy i zasad platformy | Postępowania egzekucyjne GDPR; ryzyko danych szczególnej kategorii w zdjęciach/bio |
| Wielka Brytania | UK GDPR, DPA 2018 | Podobnie jak w UE | Wymagana podstawa prawna; wytyczne ICO zaktualizowane w kwietniu 2026 | Nadal może mieć znaczenie egzekwowanie umowy i zasad platformy | Dokumenty wytycznych ICO |
| Kanada | PIPEDA, przepisy prowincjonalne | Niższe ryzyko, gdy nie ma informacji osobowych | Mogą mieć zastosowanie zgoda i inne obowiązki prywatnościowe | Nadal może mieć znaczenie egzekwowanie umowy i zasad platformy | Ograniczone precedensy dotyczące scrapingu |
| Brazylia | LGPD | Niższe ryzyko, gdy nie ma danych osobowych | Wymagana podstawa prawna | Nadal może mieć znaczenie egzekwowanie umowy i zasad platformy | Rosnące egzekwowanie; brak dużej sprawy o scraping na ten moment |
| Australia | Privacy Act 1988 | Niższe ryzyko, gdy nie ma informacji osobowych | Mogą mieć zastosowanie Australian Privacy Principles (APPs) | Nadal może mieć znaczenie egzekwowanie umowy i zasad platformy | Ograniczone precedensy dotyczące scrapingu |
Widać pewien wspólny wzorzec we wszystkich sześciu jurysdykcjach. W każdej z nich scraping nieosobowych danych publicznych jest scenariuszem o najniższym ryzyku. W momencie, gdy wchodzą dane osobowe, włącza się prawo prywatności — a „dane były publicznie widoczne” nie jest obroną w GDPR, UK GDPR ani LGPD. To czynnik, ale sam w sobie nie jest podstawą prawną.
Dla osób myślących o rezydencji danych i zbieraniu transgranicznym: miejsce zbierania, przetwarzania i przechowywania danych ma znaczenie. Jeśli korzystasz z narzędzia lub dostawcy zewnętrznego do dozwolonych źródeł publicznych, sprawdź region, retencję i kontrolę prywatności, zanim zaczniesz zbierać dane osobowe.
Najważniejsze kamienie milowe prawne dotyczące ryzyka scrapingu Instagrama
Kilka kamieni milowych prawnych i polityki platformy wyjaśnia, dlaczego odpowiedź nadal nie jest zero-jedynkowa:
- 2017: hiQ v. LinkedIn — sąd okręgowy wydaje wstępny nakaz zakazujący LinkedIn blokowania scrapingu publicznych profili przez hiQ. Pierwsze duże orzeczenie w USA korzystne dla scrapingu danych publicznych.
- 2018: GDPR zaczyna obowiązywać w UE, tworząc najbardziej kompleksowe globalne ramy ochrony danych osobowych.
- 2020: CCPA zaczyna obowiązywać w Kalifornii. Meta składa pozew Meta v. BrandTotal, atakując scraping danych z Facebooka.
- 2021: Van Buren v. United States — Sąd Najwyższy USA zawęża pojęcie „przekroczenia autoryzowanego dostępu” w CFAA. To przełomowy moment dla prawa scrapingu.
- 2022: hiQ v. LinkedIn — 9th Circuit wydaje ostateczne orzeczenie, potwierdzając, że scraping danych publicznych nie narusza CFAA.
- 2024: Meta v. Bright Data — sąd w Północnym Dystrykcie Kalifornii uznaje, że regulaminy Facebooka/Instagrama nie zakazywały Bright Data scrapingu publicznych danych w trybie wylogowanym. Wąskie, ale istotne orzeczenie.
- 2024 i dalej: Meta nadal publicznie egzekwuje zasady przeciw scrapowaniu. Na swojej stronie o postępach w zakresie prywatności podaje, że blokuje codziennie miliardy podejrzanych nieautoryzowanych działań scrapujących w Facebooku, Instagramie i WhatsAppie. Traktuj to jako deklarację egzekwowania ze strony Meta, a nie niezależnie zweryfikowany benchmark.
Jak Van Buren v. US zmieniło podejście do scrapowania danych publicznych
Przed Van Buren istniał realny argument, że scrapowanie dowolnej strony internetowej wbrew woli właściciela mogło być przestępstwem federalnym na gruncie CFAA. Sformułowanie o „przekroczeniu autoryzowanego dostępu” było na tyle szerokie, że część prokuratorów i powodów próbowała rozciągać je na naruszenia TOS.
Sąd Najwyższy to uciął. W sprawie Van Buren przyjął logikę „brama podniesiona vs. brama opuszczona”: CFAA ma zastosowanie, gdy ktoś omija technologiczny mechanizm kontroli dostępu (np. ścianę logowania czy hasło), a nie wtedy, gdy po prostu korzysta z informacji, które są swobodnie dostępne, choć właściciel strony wolałby, żeby tak nie było.
W praktyce ma to duże znaczenie dla scrapingu. Jeśli dane są za ścianą logowania lub inną kontrolą dostępu, ryzyko CFAA może szybko wzrosnąć. Jeśli znajdują się na publicznej stronie, którą każdy może otworzyć w oknie incognito, argument oparty na CFAA jest zwykle słabszy — choć nadal mogą istnieć ryzyka prywatnościowe, kontraktowe, własności intelektualnej i związane z egzekwowaniem zasad platformy.
Większość konkurencyjnych artykułów cytuje hiQ, ale niedostatecznie tłumaczy Van Buren. Te orzeczenia się uzupełniają, a Van Buren jest prawdopodobnie ważniejsze, bo to decyzja Sądu Najwyższego o zasięgu ogólnokrajowym, a nie wyrok sądu apelacyjnego.
Jak Meta egzekwuje zasady
Meta nie siedzi z założonymi rękami. Zgodnie z jej własnymi publicznymi deklaracjami zestaw narzędzi egzekwowania obejmuje:
- Limity częstotliwości i limity danych, aby ograniczać automatyczne pobieranie.
- Wykrywanie wzorców nietypowego zachowania przy zbieraniu danych.
- Ograniczanie lub wyłączanie kont, gdy Meta uznaje, że automatyzacja narusza zasady.
- Wezwania do zaprzestania naruszeń, pozwy i żądania usunięcia treści w przypadku operacji scrapujących na dużą skalę lub komercyjnych.
Nawet jeśli interesuje Cię tylko ryzyko prawne, egzekwowanie zasad platformy ma znaczenie. Publiczne stanowisko Meta jest jasne: automatyczne pobieranie danych z jej platform bez zgody narusza zasady, a firma inwestuje znaczne środki w zatrzymywanie takich działań.
Scraping Instagrama do badań akademickich: co powinni wiedzieć studenci i badacze
Studenci studiów magisterskich i badacze akademiccy znajdują się w innej kategorii ryzyka — zwykle niższej niż komercyjna odsprzedaż danych, ale niezerowej.
Niższe ryzyko niż scraping komercyjny, tak. Automatyczne zwolnienie z odpowiedzialności, nie.
Analiza fair use w przypadku danych z Instagrama
W USA doktryna fair use (17 U.S.C. § 107) bierze pod uwagę cztery czynniki:
- Cel i charakter wykorzystania: użycie niekomercyjne, edukacyjne i transformacyjne działa na korzyść fair use. Badania akademickie zwykle wypadają tu dobrze.
- Charakter utworu chronionego prawem autorskim: dane faktyczne (liczba obserwujących, daty postów) są mniej chronione niż treści twórcze (zdjęcia, podpisy). Scraping treści kreatywnych jest bardziej ryzykowny.
- Zakres wykorzystania: pobranie całego publicznego profilu to coś innego niż kilka punktów danych. Zbieraj jak najmniej.
- Wpływ na rynek: jeśli Twoje badanie nie konkuruje z komercyjnymi usługami Instagrama, ten czynnik działa na Twoją korzyść.
Badania akademickie zwykle plasują się po korzystnej stronie tej analizy, ale nie jest to gwarancja — zwłaszcza jeśli scrapujesz duże ilości treści twórczych (obrazy, wideo, pełne podpisy).
Kwestie IRB
Jeśli Twoje badanie obejmuje dane umożliwiające identyfikację osób — a profile Instagrama z definicji są identyfikowalne — komisja Institutional Review Board (IRB) na Twojej uczelni może wymagać przeglądu i zatwierdzenia planu zbierania danych. Dotyczy to również danych publicznie widocznych. Skonsultuj się z IRB, zanim zaczniesz scraping.
Programy badawcze specyficzne dla platformy
Meta oferuje Content Library and API dla zatwierdzonych badaczy, dając dostęp do publicznie dostępnych treści z Facebooka, Instagrama i Threads. Wnioski są rozpatrywane niezależnie. Jeśli się kwalifikujesz, to niżej ryzykowna, oficjalna ścieżka dla akademickich badań nad Instagramem.
(Uwaga: popularne wśród badaczy narzędzie CrowdTangle zostało w dużej mierze wycofane. Content Library/API jest jego następcą.)
Minimalizacja danych dla badaczy
Praktyczne wskazówki:
- Zbieraj tylko te punkty danych, których naprawdę potrzebujesz do pytania badawczego. Nie scrapuj całych profili „na wszelki wypadek”.
- Anonimizuj zbiory danych jak najwcześniej — usuwaj nazwy użytkowników, rozmywaj zdjęcia profilowe, agreguj dane zamiast raportować poziom pojedynczych osób.
- Ustal politykę retencji danych: jak długo będziesz je przechowywać i kiedy je usuniesz?
- Udokumentuj metodologię i podstawę prawną (dla zgodności z GDPR, jeśli ma zastosowanie).
W badaniach poza Instagramem stosuj zasadę minimalizacji danych: zbieraj tylko pola potrzebne do zdefiniowanego celu, unikaj przechowywania zbędnych surowych tekstów i dokumentuj retencję oraz kontrolę dostępu.
Lista kontrolna niższego ryzyka przed zbieraniem danych z Instagrama
Skoro mapa prawna jest już jasna, oto praktyczna lista kontrolna do ograniczania ryzyka:
- Scrapuj wyłącznie dane publicznie widoczne. Użyj testu w oknie incognito. Jeśli nie widzisz czegoś bez logowania, nie scrapuj tego.
- Nigdy nie omijaj ścian logowania ani nie używaj fałszywych kont. Tutaj ryzyko CFAA, naruszenia umowy i egzekwowania zasad platformy mocno rośnie.
- Traktuj zabezpieczenia techniczne i kontowe jak znaki stop. CAPTCHA, ściany logowania, ograniczenia konta i systemy anty-botowe to czerwone flagi.
- Minimalizuj zbieranie danych osobowych. Zbieraj tylko to, czego naprawdę potrzebujesz. Jeśli nie potrzebujesz nazw użytkowników, nie zbieraj ich.
- Miej politykę retencji i usuwania danych. Wiedz, jak długo je przechowasz i kiedy je skasujesz.
- Udokumentuj podstawę prawną, jeśli zbierasz dane osobowe (zwłaszcza w ramach GDPR). „Uzasadniony interes” wymaga pisemnego testu równowagi, a nie tylko ogólnej intencji.
- Korzystaj z oficjalnych, licencjonowanych, opartych na zgodzie lub nieinstagramowych źródeł, gdy to możliwe. Najniższe ryzyko to często takie, którego możesz uniknąć, nie zbierając danych z Instagrama.
Uwaga o narzędziach i alternatywach
Thunderbit zostało zaprojektowane do dozwolonych przepływów pracy z publicznych stron internetowych poza produktami Meta. Nie oferuje zbierania danych z Facebooka, Instagrama, Threads, Messengera, WhatsAppa ani Meta Ad Library, nie łączy kont i nie omija zabezpieczeń.
W wielu pytaniach biznesowych publiczne strony firmowe, katalogi, strony e-commerce, licencjonowane zbiory danych i inne źródła spoza Meta dostarczają potrzebnych informacji przy jaśniejszych warunkach i obowiązkach prywatnościowych. Wybierz źródło, które wyraźnie pozwala na planowane wykorzystanie, a potem minimalizuj przechowywane informacje.
Najważniejsze wnioski
- Scraping publicznie dostępnych danych z Instagrama nie jest automatycznie nielegalny w świetle obecnego orzecznictwa USA, ale „nie jest nielegalny” i „jest bezpieczny” to dwa bardzo różne stany.
- Liczą się trzy warstwy prawne: przepisy o dostępie do systemów (CFAA), regulacje prywatności (GDPR/CCPA) i umowa/Warunki korzystania z usługi. Nie mieszaj ich ze sobą.
- Naruszenie TOS nie jest przestępstwem. Może skończyć się blokadą konta i pozwem cywilnym, ale nie odpowiedzialnością karną (po Van Buren).
- Prawo prywatności obowiązuje nawet przy danych publicznych. Jeśli zbierasz informacje osobowe, potrzebujesz podstawy prawnej — szczególnie w GDPR i CCPA.
- Jurysdykcja ma znaczenie. Krajobraz prawny istotnie różni się między USA, UE, Wielką Brytanią, Kanadą, Brazylią i Australią.
- Schemat decyzyjny jest Twoim sprzymierzeńcem. Przechodź go przy każdym projekcie zbierania danych: dostęp publiczny → dane osobowe → podstawa prawna → przypadek użycia → kontrola platformy.
- Badacze akademiccy mają niższe, ale niezerowe ryzyko. Jeśli się kwalifikujesz, korzystaj z Content Library/API Meta, minimalizuj zbieranie danych, anonimizuj jak najwcześniej i skonsultuj się z IRB.
- Rozważ alternatywne źródła danych. W wielu zastosowaniach biznesowych publiczne strony, katalogi i strony twórców dostarczą potrzebne dane bez ryzyka specyficznego dla Instagrama. Wybierz źródło, które wyraźnie dopuszcza planowane użycie.
- Przy wysokiej stawce komercyjnej skonsultuj się z prawnikiem. Ten artykuł to mapa, nie opinia prawna.
FAQ o legalnym scrapowaniu Instagrama
Czy Instagram może mnie pozwać za scraping publicznych danych?
Meta może wysłać wezwanie do zaprzestania naruszeń albo wnieść pozew cywilny za złamanie Warunków korzystania z usługi. Jednak sądy w USA — w tym w sprawie Meta v. Bright Data (2024) — uznały, że regulamin Instagrama w określonych okolicznościach nie zakazywał scrapingu publicznych danych w trybie wylogowanym, a Van Buren v. US (2021) znacząco zawęziło odpowiedzialność na gruncie CFAA za uzyskiwanie dostępu do publicznych informacji. Prawdopodobieństwo pozwu jest niskie przy małej skali i użyciu niekomercyjnym, ale nie zerowe — zwłaszcza przy operacjach komercyjnych.
Czy scraping Instagrama jest legalny w Europie?
Scraping publicznie dostępnych, nieosobowych danych zwykle wiąże się z niższym ryzykiem prywatnościowym, ale dane z Instagrama często zawierają dane osobowe. Jeśli w grę wchodzą dane osobowe, potrzebujesz podstawy prawnej zgodnie z art. 6 GDPR — na przykład uzasadnionego interesu popartego udokumentowanym testem równowagi. Kary za nieprzestrzeganie mogą sięgać do 4% globalnych rocznych przychodów. Wytyczne ICO (zaktualizowane w kwietniu 2026) wymagają, by organizacje ustaliły i udokumentowały podstawę prawną przed rozpoczęciem przetwarzania.
Czy moje konto na Instagramie zostanie zablokowane za scraping?
Ograniczenia konta to jeden z najbardziej prawdopodobnych skutków agresywnego scrapingu. Polityka ograniczania konta opisuje nieautoryzowany scraping jako automatyzację służącą do zbierania informacji z naruszeniem regulaminu. Unikanie scrapingu z własnego konta zmniejsza ryzyko blokady konta, ale nie sprawia, że zbieranie danych z Instagrama jest wolne od ryzyka prawnego lub kontraktowego.
Czy scraping Instagrama jest legalny w badaniach akademickich?
Zwykle wiąże się z niższym ryzykiem niż komercyjna odsprzedaż, zwłaszcza w przypadku badań niekomercyjnych opartych na danych publicznych, ale nie jest automatycznie wyłączony spod zasad. Fair use lub fair dealing mogą być istotne, jednak badacze powinni sprawdzić wymagania IRB przy pracy z identyfikowalnymi danymi osób, stosować minimalizację danych i rozważyć użycie Content Library and API Meta, jeśli się kwalifikują.
Jaka jest różnica między scrapowaniem Instagrama a korzystaniem z API Instagrama?
Oficjalne Instagram Graph API zapewnia uporządkowany dostęp dla zatwierdzonych zastosowań biznesowych i twórców, ale ma limity, wymogi recenzji i ograniczenia polityczne. Scraping pobiera dane widoczne na stronie poza tą oficjalną ścieżką API. Obie drogi mają konsekwencje prawne: korzystanie z API podlega warunkom deweloperskim Meta, podczas gdy publiczny scraping w trybie wylogowanym został w niektórych wąskich sprawach w USA potraktowany przychylnie, ale nadal może wywołać problemy związane z regulaminem, prywatnością, własnością intelektualną i egzekwowaniem zasad platformy. W większości zastosowań biznesowych oficjalne API, dane oparte na zgodzie, dane licencjonowane lub publiczne źródła spoza Instagrama to ścieżki o niższym ryzyku.
Dowiedz się więcej




