
cURL działa na około 20 miliardach instalacji na całym świecie — jest domyślnie wbudowany w macOS, większość dystrybucji Linuxa oraz Windows 10/11. A jednak wystarczy zapytać dziesięciu developerów, jak poprawnie puścić żądanie cURL przez proxy, i dostaniesz dziesięć trochę innych odpowiedzi, z czego połowa przestaje działać w chwili, gdy pojawia się uwierzytelnianie albo SOCKS.
Właśnie tę lukę chcę tu domknąć. Większość poradników pokazuje jedno polecenie, mówi, że działa, i idzie dalej. Nie pokazują, jak sprawdzić, czy proxy faktycznie cokolwiek robi (uwaga: czasem nie robi), i na pewno nie prowadzą krok po kroku przez kody błędów, które wyskakują sekundę po tym, jak konfiguracja choć trochę odbiegnie od idealnego scenariusza. Ten przewodnik obejmuje cały zakres — proxy HTTP/HTTPS, SOCKS4/SOCKS5/socks5h, zmienne środowiskowe (i ich bardzo konkretne pułapki), porządną tabelę diagnozowania błędów oraz sytuacje, w których cURL i proxy po prostu przestają wystarczać.
Czym jest cURL i po co używać go z proxy?
cURL to narzędzie wiersza poleceń do przesyłania danych do i z adresu URL. I tyle — bez GUI, bez fajerwerków, po prostu program, który obsługuje HTTP, HTTPS, FTP i kilka innych protokołów. Najprostsze użycie wygląda tak:
curl https://example.com
To pobiera stronę i wypisuje surowy HTML w terminalu. Samo w sobie przydatne, ale prawdziwy powód, dla którego developerzy i techniczni użytkownicy biznesowi sięgają po cURL, to testowanie API, pobieranie danych, sprawdzanie treści z ograniczeniami geograficznymi i uruchamianie żądań w pipeline’ach CI/CD.
Proxy stoi między Twoją maszyną a serwerem docelowym i przekazuje żądanie w Twoim imieniu. Serwer docelowy widzi adres IP proxy, a nie Twój. Ma to znaczenie z kilku legalnych powodów: testowania, jak wygląda Twoja strona z innego kraju, obchodzenia limitów podczas QA albo kierowania ruchu przez firmową bramę, której wymaga organizacja. cURL obsługuje pełny zakres protokołów proxy — HTTP, HTTPS, SOCKS4 i SOCKS5 — a w tym przewodniku będziesz często widzieć flagi -x / --proxy (sam adres proxy), -v (tryb szczegółowy, najlepszy przyjaciel debugowania) oraz -k (pomijanie weryfikacji SSL, czego praktycznie nigdy nie powinno się używać poza testami).
Krótka uwaga na start: ten przewodnik dotyczy sieciowej mechaniki używania proxy z cURL. To nie jest przyzwolenie na ignorowanie regulaminu docelowej strony ani polityki bezpieczeństwa organizacji. Proxy zmienia trasę ruchu sieciowego — nie zmienia tego, co jest legalne albo dozwolone.
Zanim zaczniesz
Poziom trudności: początkujący do średnio zaawansowanego
Szacowany czas: około 15 minut na przejście przez podstawowe przykłady
Czego potrzebujesz:
- Zainstalowanego cURL (sprawdź poleceniem
curl --version— jeśli używasz macOS, Linuxa lub Windows 10/11, bardzo możliwe, że już tam jest) - Danych proxy od dostawcy: host, port, protokół (HTTP/HTTPS/SOCKS) oraz nazwę użytkownika i hasło, jeśli są wymagane
- Terminala (Terminal na macOS, dowolnej powłoki na Linuxie, PowerShell lub CMD na Windows)
Jeśli z jakiegoś powodu cURL nie jest zainstalowany, wystarczy jedno polecenie: brew install curl na macOS przez Homebrew, sudo apt install curl na Debianie/Ubuntu albo sudo yum install curl na RHEL/CentOS. Na Windows jest dołączany do systemu od Windows 10 build 17063.
W całym poradniku będę używać przykładowych wartości — proxy.example:8080 jako adres proxy i user:pwd jako dane logowania. Zamień je na własne szczegóły i nigdy nie wklejaj prawdziwych poświadczeń do historii shella, zrzutu ekranu ani wiadomości na Slacku. Widziałem więcej wycieków haseł do proxy na Slacku, niż chciałbym przyznać.
Jak używać cURL z proxy HTTP lub HTTPS
To najczęstszy scenariusz i ten, którego użyjesz w zdecydowanej większości zadań związanych z proxy.
Użycie flagi -x / --proxy
Podstawowa składnia wygląda tak:
curl -x "http://user:pwd@proxy.example:8080" "https://httpbin.org/ip"
-x i --proxy robią dokładnie to samo — wybierz opcję, którą łatwiej zapamiętasz. Ponieważ HTTP jest domyślnym schematem proxy w cURL, technicznie możesz pominąć prefiks http:// i wpisać po prostu proxy.example:8080. Ja i tak polecam podawać go jawnie, bo za pół roku podziękujesz sobie za przejrzystość.
Cały adres URL zamykaj w cudzysłowie. Jeśli hasło zawiera @, # albo &, niecytowany ciąg może zostać zniekształcony przez powłokę, zanim cURL w ogóle go zobaczy.
Łączenie przez proxy HTTPS
Niektórzy dostawcy szyfrują połączenie do samego proxy przez TLS, a nie tylko połączenie z proxy do celu. To coś innego niż pobieranie strony HTTPS — protokół proxy i protokół docelowy są niezależne. Aby to wskazać:
curl -x "https://user:pwd@proxy.example:8080" "https://httpbin.org/ip"
Jeśli pojawi się tutaj błąd certyfikatu, nie spiesz się z dodawaniem -k i przechodzeniem dalej. Ta flaga całkowicie wyłącza weryfikację certyfikatu SSL, co może być akceptowalne przy pięciominutowym teście lokalnym, ale jest naprawdę złym pomysłem wszędzie tam, gdzie dotykasz produkcji lub danych prawdziwych użytkowników. Jeśli masz do czynienia z firmowym proxy, które przechwytuje TLS (konfiguracja MITM, typowa w środowiskach enterprise), właściwą naprawą jest zaimportowanie certyfikatu CA proxy, a nie wyłączanie weryfikacji.
Uwierzytelnianie przez --proxy-user
Możesz też rozdzielić dane logowania do osobnej flagi zamiast upychać je w URL-u:
curl -x "http://proxy.example:8080" --proxy-user "user:pwd" "https://httpbin.org/ip"
Uwaga: wielkie -U nie oznacza tego samego co uwierzytelnianie po stronie serwera docelowego (-u / --user, małe litery) — pomylenie tych opcji to prosty sposób, żeby wysłać hasło do proxy w złe miejsce. W środowiskach korporacyjnych, gdzie zamiast Basic używa się NTLM albo Digest, dodaj --proxy-ntlm lub --proxy-digest razem z --proxy-user.
Jak używać cURL z proxy SOCKS: SOCKS4 vs. SOCKS5 vs. socks5h
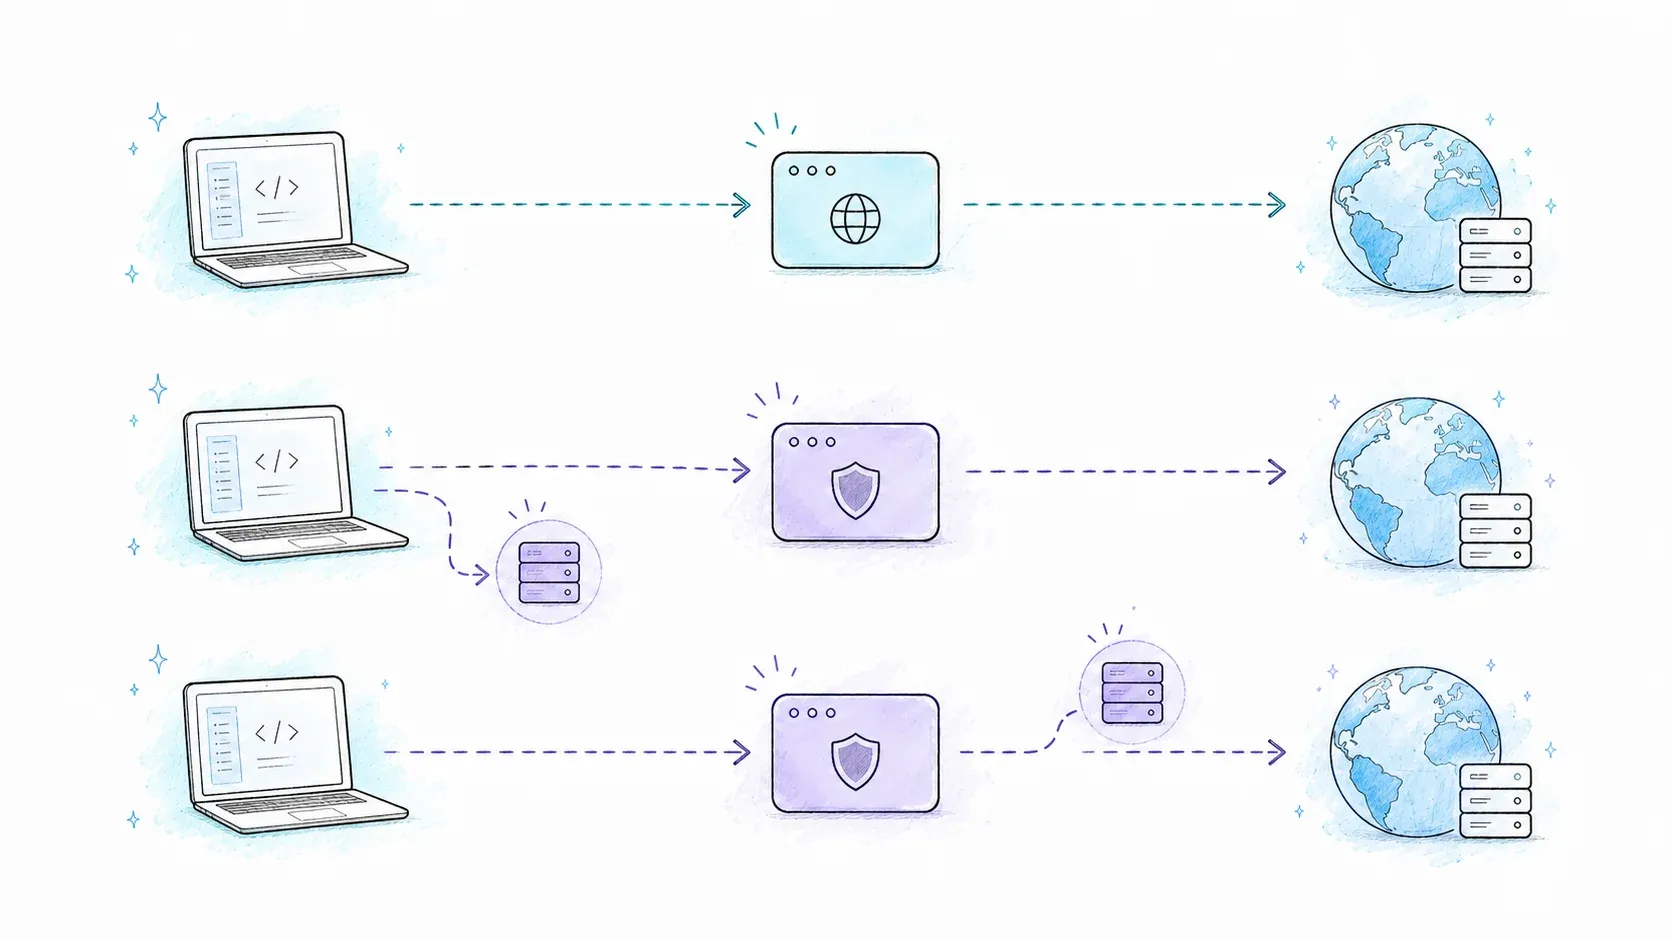
Proxy SOCKS działa na niższym poziomie niż proxy HTTP — nie interesuje go, jakiego protokołu tunelujesz, dlatego jest przydatne dla ruchu nie-HTTP, połączeń Tor i wszystkiego, co wymaga większej prywatności. Większość konkurencyjnych poradników ogranicza się do jednego polecenia i na tym kończy. To błąd, bo różnice między SOCKS4, SOCKS5 i socks5h:// naprawdę mają znaczenie.
| Funkcja | SOCKS4 | SOCKS5 | socks5h:// |
|---|---|---|---|
| Obsługa TCP | Tak | Tak | Tak |
| Obsługa UDP | Nie | Tak | Tak |
| Uwierzytelnianie | Nie | Tak | Tak |
| Zdalne rozwiązywanie DNS | Nie | Nie (lokalny DNS) | Tak (DNS po stronie proxy) |
| Zgodność z Tor | Nie | Ryzykowne (wyciek DNS) | Tak |
Najwięcej osób potyka się o wiersz dotyczący DNS. Przy socks5:// Twoja maszyna rozwiązuje nazwę hosta zanim przekaże połączenie do proxy — co oznacza, że lokalny resolver DNS (a więc i Twój dostawca internetu) widzi dokładnie, do jakiej domeny próbujesz się dostać, mimo że sam ruch HTTP idzie przez proxy. socks5h:// rozwiązuje ten problem, bo to proxy wykonuje rozpoznanie nazwy hosta, więc lokalnie nie wycieka nic o celu połączenia. To właśnie dlatego dokumentacja Tora naciska na socks5h:// — użycie zwykłego socks5:// niweluje sporą część anonimowości, którą Tor ma zapewniać.
Oto każda wersja w cURL:
curl --socks4 "proxy.example:1080" "http://example.com"
curl -x "socks5://user:pwd@proxy.example:1080" "http://example.com"
curl -x "socks5h://user:pwd@proxy.example:1080" "http://example.com"
Jeśli nie masz konkretnego powodu, żeby postąpić inaczej, wybieraj domyślnie socks5h://. Nic to nie kosztuje, a zamyka wyciek, którego inaczej możesz nawet nie zauważyć.
Ustawianie proxy przez zmienne środowiskowe (i unikanie pułapek)
Wpisywanie -x przy każdym poleceniu szybko się nudzi. Zmienne środowiskowe pozwalają ustawić proxy raz na sesję shella i automatycznie dziedziczyć je we wszystkich kolejnych wywołaniach cURL — instrukcja cURL wymienia http_proxy, HTTPS_PROXY, ALL_PROXY i NO_PROXY jako obsługiwany zestaw.
Podstawy
export http_proxy="http://user:pwd@proxy.example:8080"
export HTTPS_PROXY="http://user:pwd@proxy.example:8080"
export ALL_PROXY="socks5h://proxy.example:1080"
Tu pojawia się rzecz, na której ludzie regularnie się wykładają: nazwa zmiennej odnosi się do protokołu adresu URL celu, a nie do protokołu proxy. Czyli http_proxy dotyczy żądań do adresów http://, a HTTPS_PROXY dotyczy żądań do https:// — obie zmienne mogą wskazywać dokładnie ten sam serwer HTTP proxy i jest to całkowicie normalne.
Omijanie z NO_PROXY
export NO_PROXY="localhost,127.0.0.1,.internal.example"
Wartości są rozdzielane przecinkami, a kropka na początku .internal.example działa jak wildcard dla wszystkich subdomen. NO_PROXY ma pierwszeństwo przed wszystkim innym — nawet jeśli w wierszu poleceń jawnie ustawisz -x, dopasowanie w NO_PROXY ominie proxy dla tego żądania.
Pułapki, które naprawdę sprawiają problemy
- Zapomnienie o
export. Jeśli wpiszesz po prostuhttp_proxy=http://...bezexport, zmienna istnieje tylko w bieżącym shellu i jest całkowicie niewidoczna dla cURL uruchamianego jako proces potomny. Z mojego doświadczenia to najczęstsza przyczyna zgłoszeń w stylu „proxy nie działa”. - Czułość na wielkość liter. cURL najpierw sprawdza konkretnie małe
http_proxyi daje mu priorytet, jeśli istnieją obie wersje. Niektóre inne narzędzia czytają tylko wielkie litery. Jeśli debugujesz, czemu zmienna „nie jest wykrywana”, sprawdź, czy nie masz duplikatu z inną wielkością liter. - Pułapka aliasu w PowerShell. W PowerShell 5.1 wpisanie
curlnie uruchamia w ogóle cURL — wywołujeInvoke-WebRequest, całkiem inne narzędzie z innymi flagami. Jeśli flaga-xdaje dziwne błędy na Windows, wpisz jawniecurl.exe, żeby mieć pewność, że faktycznie używasz cURL. - Różnice w składni Windows. CMD używa
set http_proxy=...; PowerShell używa$env:http_proxy = "...". Pomylenie tych form między sesjami terminala to prosty sposób, by stracić pół dnia. - Zaległe zmienne.
unset http_proxyiunset https_proxyusuwają nieaktualną konfigurację proxy, która po cichu przekierowuje — i psuje — każde żądanie.
Na szybkie przełączanie naprawdę pomagają aliasy w .bashrc:
alias proxyon='export http_proxy="http://proxy.example:8080"; export https_proxy="http://proxy.example:8080"'
alias proxyoff='unset http_proxy; unset https_proxy'
Jak sprawić, żeby cURL zawsze używał proxy (plik konfiguracyjny)
Jeśli przez 95% czasu pracujesz za firmowym proxy, plik .curlrc (na systemach uniksowych w katalogu domowym) albo _curlrc (na Windows, w folderze aplikacji) ustawi trwały domyślny parametr bez dotykania zmiennych środowiskowych:
proxy="http://proxy.example:8080"
Gdy chcesz jednorazowo to pominąć, --noproxy "*" nadpisuje konfigurację tylko dla tego konkretnego wywołania. Priorytet zwykle wygląda tak: flaga w wierszu poleceń > zmienna środowiskowa > plik konfiguracyjny, więc -x podany w terminalu zawsze wygra w razie konfliktu.
Ważna uwaga: nie zapisuj hasła w plaintext w .curlrc, jeśli plik może zostać zsynchronizowany, zbackupowany albo przypadkowo dodany do repozytorium. W pipeline’ach CI używaj menedżera sekretów danej platformy i wstrzykuj dane jako maskowane zmienne środowiskowe.
Jak sprawdzić, czy proxy naprawdę działa
To sekcja, którą prawie każdy inny poradnik pomija, a która oszczędza najwięcej czasu przy debugowaniu. Ustawienie proxy i założenie, że ruch rzeczywiście przez nie przechodzi, to prosty sposób, żeby spędzić godziny na szukaniu błędu w scraperze, który w rzeczywistości nigdy nie korzystał z proxy.
Metoda 1: Porównaj adres IP wyjściowy
Uruchom to samo żądanie zwracające IP dwa razy — raz bezpośrednio, raz przez proxy — i porównaj wyniki:
curl https://httpbin.org/ip
curl -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip
Jeśli oba polecenia zwracają ten sam adres IP, proxy nic nie robi. Sprawdź składnię flag, zmienne środowiskowe albo to, czy NO_PROXY przypadkiem nie pasuje do celu.
Metoda 2: Odczytaj tryb szczegółowy
Dodaj -v do dowolnego żądania przez proxy, a cURL wypisze cały handshake:
curl -v -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip
Szukaj linii w stylu * Connected to proxy.example (xx.xx.xx.xx) port 8080, po której pojawia się > CONNECT httpbin.org:443 HTTP/1.1, a ostatecznie < HTTP/1.1 200 Connection established. Ta sekwencja — połączenie z proxy, a potem tunel CONNECT do celu — to działanie metody HTTP CONNECT, czyli dokładnie to, co powinno się wydarzyć, gdy cel HTTPS przechodzi przez proxy HTTP. Jeśli linia CONNECT się nie pojawia, flaga proxy nie jest stosowana. Jedna ważna uwaga: używaj -v tylko podczas aktywnego debugowania i zanonimizuj output, zanim komukolwiek go wyślesz — tryb szczegółowy może wypisać dane proxy w jawnym tekście.
Metoda 3: Porównanie obok siebie
Jeśli testujesz geolokalizację, zapisz oba wyniki do plików i porównaj je diffem:
curl https://httpbin.org/ip > direct.json
curl -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip > proxied.json
diff direct.json proxied.json
Jeśli treść odpowiedzi (albo nagłówki, w przypadku treści z ograniczeniami geograficznymi) różnią się, masz wizualne potwierdzenie, że proxy faktycznie zmienia trasę ruchu — to szybki i mało pracochłonny sposób, by rozwiać wątpliwości, zanim zaczniesz głębszą analizę.
Rozwiązywanie najczęstszych błędów proxy w cURL
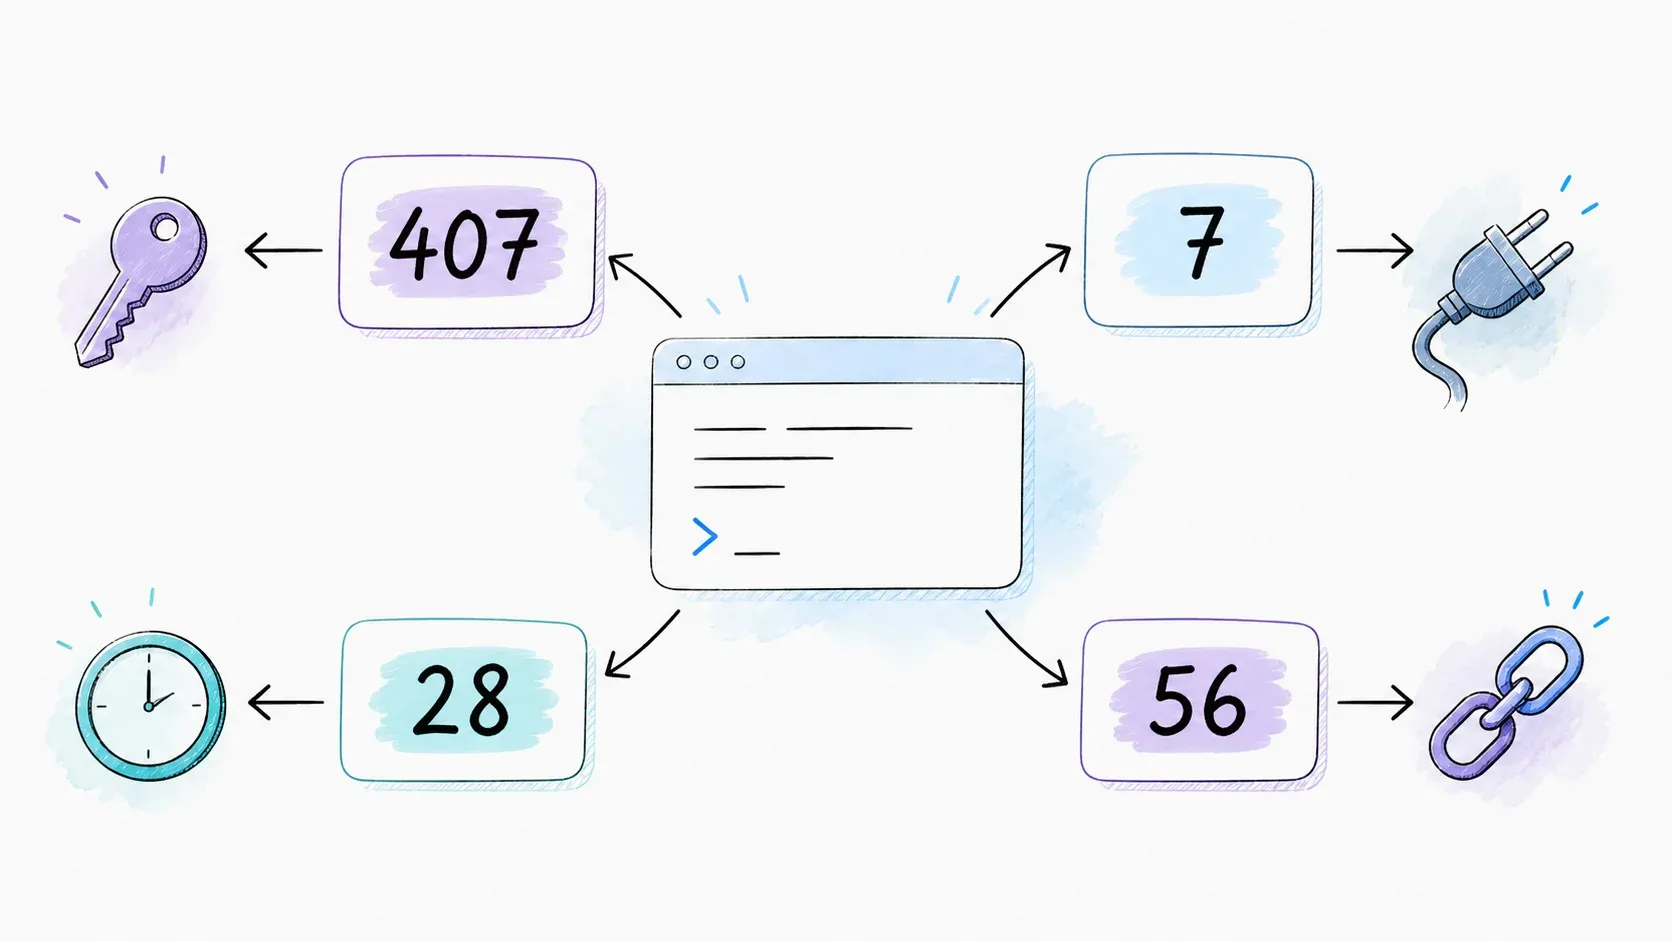
Większość poradników macha tu ręką i wspomina raz -k. Ten temat zasługuje na prawdziwą tabelę referencyjną.
| Błąd | Prawdopodobna przyczyna | Naprawa |
|---|---|---|
curl: (7) Failed to connect | Zły host/port proxy albo proxy nie działa | Sprawdź adres; przetestuj łączność surową przez telnet host port lub nc -zv host port |
407 Proxy Authentication Required | Brakujące lub nieprawidłowe dane logowania do proxy | Dodaj --proxy-user user:pass; sprawdź, czy dostawca nie wymaga NTLM/Digest/Negotiate zamiast Basic |
curl: (56) Recv failure: Connection reset by peer | Proxy zerwało połączenie w trakcie transferu | Sprawdź stabilność proxy u dostawcy; jeśli to proxy kończące TLS, zweryfikuj obsługę certyfikatów zamiast wyłączać ją na siłę |
curl: (28) Connection timed out | Blokada firewalla, nieaktualne proxy albo zły port | Uruchom `env |
| Błąd weryfikacji certyfikatu | Niezaufany certyfikat proxy albo proxy przechwytujące ruch | Pobierz prawidłowy łańcuch CA i użyj --proxy-cacert; unikaj wyłączania weryfikacji poza jednorazową diagnozą |
Uniwersalnym pierwszym krokiem przy każdym z tych problemów jest dodanie -v. Pokazuje ono dokładnie, na którym etapie połączenie się psuje — rozwiązywanie DNS, połączenie TCP, handshake TLS czy wymiana uwierzytelniania z proxy — zamiast zostawiać Cię z domysłami opartymi na trzycyfrowym kodzie błędu.
W przypadku proxy firmowych --proxy-ntlm i --proxy-negotiate obsługują schematy uwierzytelniania z domen Windows. Jedna rzecz, z którą cURL naprawdę sobie nie radzi natywnie: pliki PAC (Proxy Auto-Config), których część firm używa do dynamicznego przypisywania proxy. Jeśli Twoja firma korzysta z takiego rozwiązania, będziesz musiał ręcznie wyciągnąć rzeczywisty host i port proxy — zwykle z ustawień sieciowych przeglądarki — ponieważ cURL nie ma wbudowanego parsera PAC.
Kiedy cURL + proxy to za mało
cURL z proxy radzi sobie ze statycznym HTML-em, wywołaniami REST API i prostym pobieraniem danych właściwie tak dobrze, jak tylko się da. Problemy zaczynają się tam, gdzie nowoczesny web lubi najbardziej dokładać przeszkody: aplikacje typu single-page renderowane w JavaScript, systemy anty-botowe jak Cloudflare czy Akamai oraz ściany CAPTCHA. Jeśli skierujesz cURL na aplikację React albo Vue za taką ochroną, dostaniesz z powrotem pusty <div id="root"></div> — technicznie żądanie się powiodło, praktycznie dane są bezużyteczne. To nie błąd cURL. To po prostu nie jest przeglądarka i nigdy nie udawało, że nią jest.
Jeśli już wygodnie korzystasz z cURL w terminalu i trafisz na tę ścianę, naturalnym następnym krokiem nie jest przechodzenie na zupełnie inny stos narzędzi — tylko dołożenie warstwy, która zajmie się renderowaniem i strukturą za Ciebie. To właśnie tę lukę mają wypełniać narzędzia deweloperskie Thunderbit.
| Scenariusz | cURL + Proxy | Thunderbit API (POST /extract) |
|---|---|---|
| Statyczna strona HTML | Działa bez problemu | Działa, zwraca też dane strukturalne |
| SPA renderowane w JS | Zwraca pusty/częściowy HTML | renderMode: "full" obsługuje JS |
| Anti-bot / CAPTCHA | Blokada | Wbudowana obsługa |
| Strukturalny format wyjścia | Surowy HTML — sam musisz go parsować | JSON według własnego schematu |
| Wiele adresów (100+) | Ręczna pętla + własne rate limiting | POST /batch/extract |
Open API Thunderbit udostępnia endpoint /extract, który zwraca JSON zgodny ze schematem bezpośrednio z ciężkich, JS-owych stron, oraz endpoint /distill do czystej konwersji na Markdown — oba można wywołać z dokładnie tej samej sesji terminala, w której i tak już używasz cURL. Jest też serwer MCP dla asystentów AI do kodowania, takich jak Claude czy Cursor, oraz CLI (npx @thunderbit/thunderbit-cli extract <url> --schema fields.json), jeśli wolisz zostać całkowicie przy skryptach. Nic z tego nie zastępuje cURL w zadaniach, w których cURL jest świetny — po prostu przejmuje pracę tam, gdzie cURL strukturalnie nie może iść dalej. Jeśli chcesz szerzej zrozumieć, gdzie ekstrakcja wspierana przez AI pasuje względem pisania własnej logiki scrapera, nasze omówienie web scrapingu z AI, porównanie najlepszych AI web scraperów oraz artykuł o web scrapingu bez kodowania wyjaśniają to znacznie dokładniej, a tekst o web scrapingu bez kodowania będzie dobrym wprowadzeniem, jeśli podchodzisz do tematu bardziej z perspektywy biznesowej niż inżynierskiej.
Podsumowanie
Sprawienie, by cURL i proxy poprawnie ze sobą współpracowały, nie jest trudne, kiedy już wiesz, gdzie naprawdę pojawiają się problemy — a okazuje się, że prawie nigdy nie leży to po stronie samego proxy. Zapomniane export. Pomylenie -u z -U. Użycie socks5:// zamiast socks5h://. Uruchamianie aliasu curl z PowerShell zamiast curl.exe. Każda z tych rzeczy generuje mylący, ogólny błąd, który nie ma nic wspólnego z dostawcą proxy.
Najbardziej oszczędzający czas nawyk: najpierw weryfikuj, dopiero potem diagnozuj. Uruchom test z adresem IP, zerknij na output -v, potwierdź, że proxy w ogóle znajduje się na ścieżce żądania, zanim założysz, że coś psuje się niżej. A gdy docelowa strona zaczyna zwracać JavaScript zamiast czystego HTML, to nie jest problem cURL do rozwiązania dodatkowymi flagami — to sygnał, że potrzebujesz narzędzia do renderowania, takiego jak API Thunderbit, które oferuje darmowy plan, jeśli chcesz sam zobaczyć różnicę między surowym HTML-em a JSON-em.
FAQ
Czy cURL używa proxy domyślnie?
Nie. Jeśli nie ustawisz zmiennych środowiskowych http_proxy / HTTPS_PROXY albo pliku .curlrc, cURL łączy się bezpośrednio z celem, bez udziału proxy.
Jak zatrzymać użycie proxy przez cURL tylko dla jednego żądania?
Dodaj --noproxy "*" do tego konkretnego polecenia. Aby wyłączyć proxy dla całej sesji shella, uruchom unset http_proxy && unset https_proxy.
Czy mogę używać cURL z proxy rotacyjnymi?
Tak — jeśli dostawca oferuje rotacyjną bramę (jeden endpoint, który przydziela nowy adres IP dla każdego żądania), wystarczy wskazać -x na ten adres bramy jak na każde inne proxy. Przy bardziej złożonej logice rotacji dla celów renderowanych w JS warstwa API, taka jak Thunderbit, obsługuje rotację i stronę anty-botową wewnętrznie, więc nie musisz ręcznie zarządzać logiką ponawiania.
Dlaczego socks5:// ujawnia moje zapytania DNS, a socks5h:// nie?
Przy socks5:// lokalna maszyna rozwiązuje nazwę hosta przed wysłaniem żądania połączenia do proxy — więc resolver DNS Twojego ISP widzi domenę, którą odwiedzasz. socks5h:// przenosi rozwiązywanie nazwy hosta do samego proxy, więc lokalnie nic o celu nie jest widoczne.
Czy używanie cURL z proxy jest legalne?
Samo korzystanie z proxy jest w większości jurysdykcji legalne. Liczy się to, co z nim robisz — zawsze respektuj regulamin strony docelowej, robots.txt tam, gdzie ma zastosowanie, oraz wszelkie przepisy o ochronie danych. Ten przewodnik obejmuje wyłącznie techniczną stronę tematu, a nie prawne przyzwolenie na dowolny przypadek użycia.
Dowiedz się więcej



