
Pobranie jednego obrazu ze strony internetowej jest proste. Zupełnie inną sprawą jest wyciągnięcie właściwych grafik z katalogu produktów, tablicy inspiracji, projektu migracji czy audytu treści.
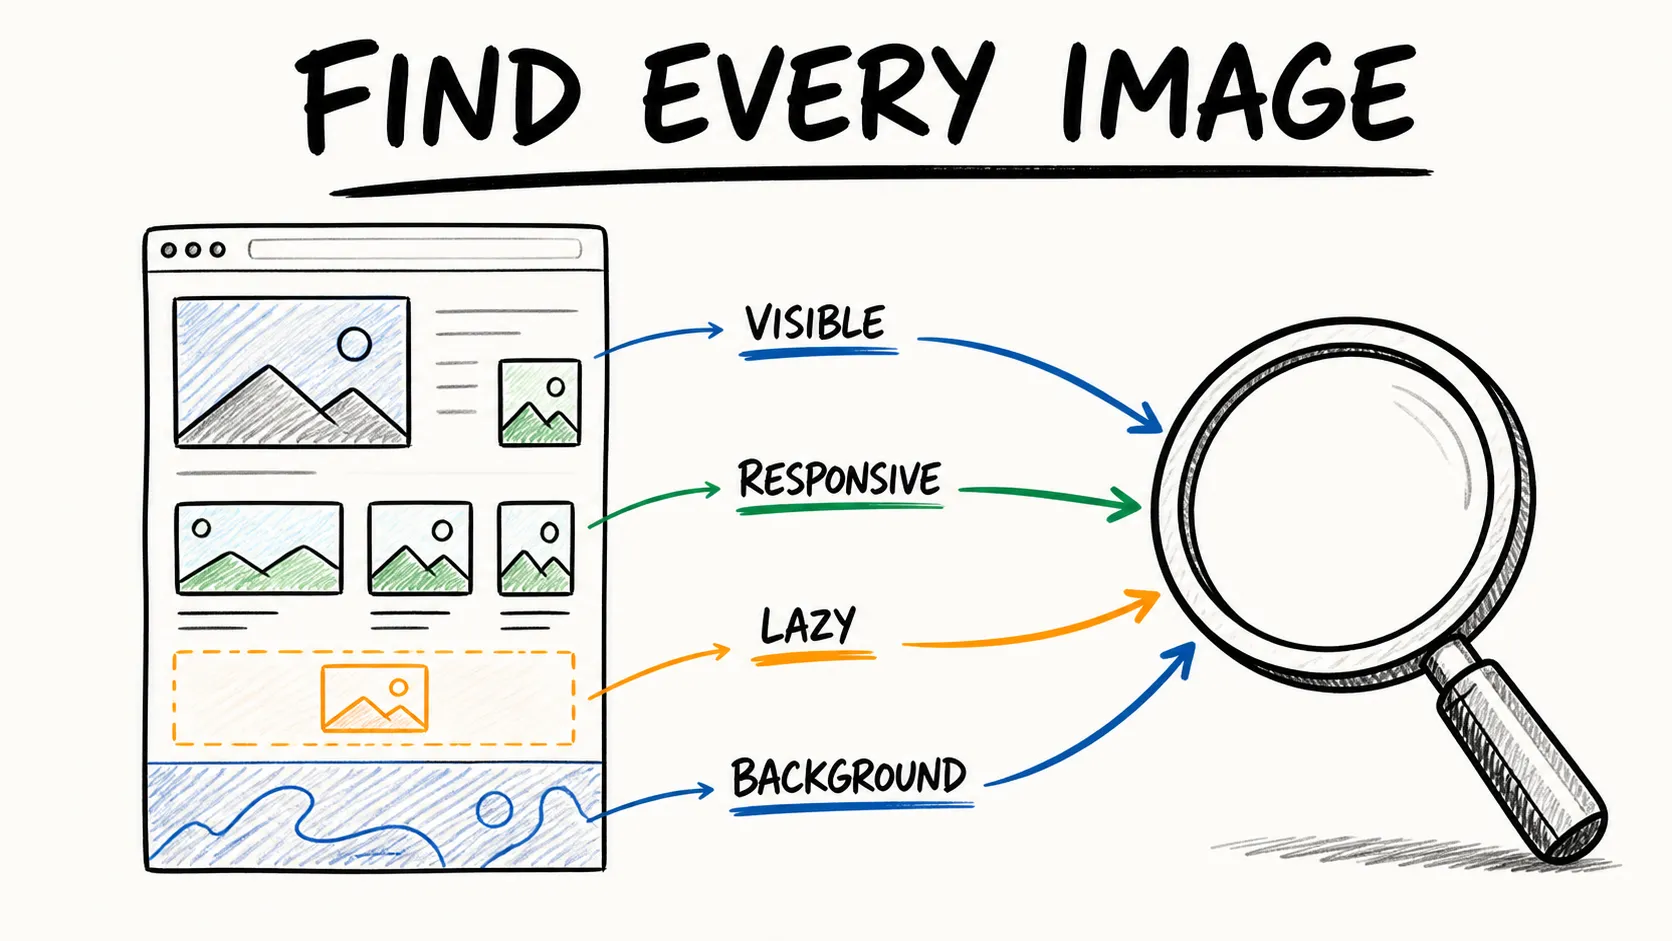
Widoczna miniatura nie zawsze jest plikiem źródłowym. Obrazy mogą być ładowane przez srcset, JavaScript, tła CSS albo atrybuty lazy load. Na stronie mogą też znajdować się logotypy, piksele śledzące, duplikaty w różnych rozmiarach, ikony i placeholdery, które nie mają żadnej wartości poza samą stroną.
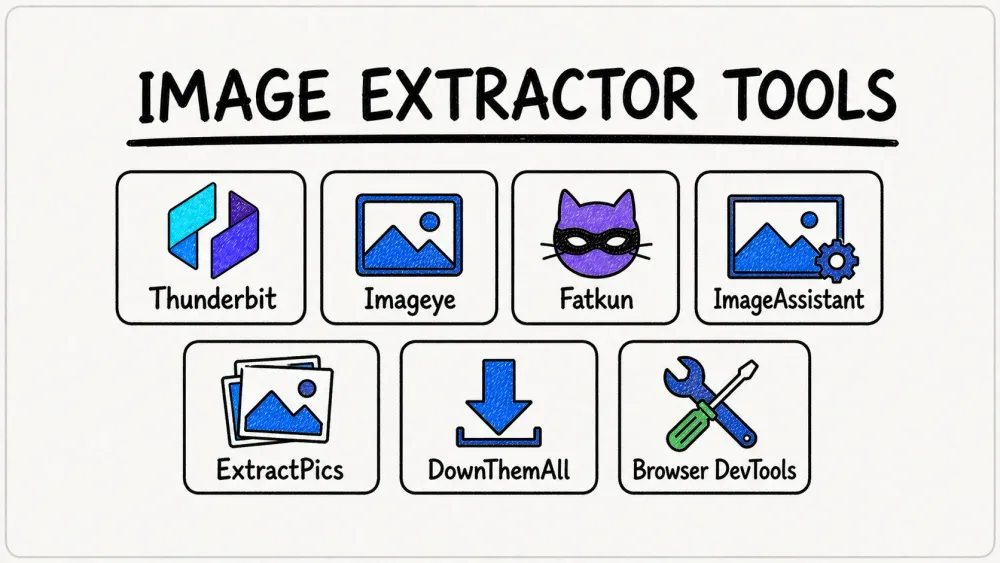
W tym poradniku porównujemy siedem aktualnych ekstraktorów obrazów i metod pod kątem tego, co faktycznie zwracają: pliki, oryginalne adresy URL albo uporządkowany spis z kontekstem źródłowym.
Szybkie porównanie
| Narzędzie | Najlepsze zastosowanie | Wynik | Instalacja |
|---|---|---|---|
| Thunderbit Image Extractor | Uporządkowane zestawienia obrazów i katalogi wielostronicowe | Obrazy lub adresy URL z kontekstem strony i polami arkusza | Rozszerzenie do Chrome |
| Imageye | Estetyczne odkrywanie i filtrowanie na jednej stronie | Wybrane pliki, adresy URL i konwersja formatów | Rozszerzenie do Chrome |
| Fatkun | Strony e-commerce i uporządkowane pobieranie zbiorcze | Filtrowane i przemianowane pliki graficzne | Rozszerzenie do Chrome |
| ImageAssistant | Zasoby ładowane dynamicznie | Wykryte i przeanalizowane pliki graficzne | Rozszerzenie do Chrome |
| ExtractPics | Wyodrębnianie bez instalacji z publicznego URL | Siatka podglądu, ZIP albo skopiowane adresy URL | Aplikacja webowa |
| DownThemAll | Niezawodne kolejki pobierania w Firefoxie | Filtrowane pliki powiązane | Dodatek do Firefoksa |
| Browser DevTools | Diagnozowanie jednego problematycznego oryginalnego zasobu | Dokładny adres żądania sieciowego i odpowiedź | Wbudowane w przeglądarkę |
Najszybszym wyborem dla pojedynczej strony jest zwykle Imageye albo Fatkun. W e-commerce, operacjach contentowych czy migracjach, gdzie każdy obraz potrzebuje informacji o produkcie, tytule, cenie, alt tekście albo kontekście strony źródłowej, Thunderbit sprawdza się lepiej, bo traktuje obrazy jak pola w zbiorze danych. DevTools to rozwiązanie awaryjne, gdy automatyzacja nie potrafi uchwycić jednego nietypowego pliku.
Co dobry ekstraktor obrazów powinien wykrywać
Podstawowy downloader skanuje <img src>. Dobry ekstraktor powinien także radzić sobie z:
- responsywnymi wariantami w
srcset - atrybutami lazy load, takimi jak
data-src - żądaniami
background-imagew CSS - formatami SVG, GIF, WebP i AVIF
- zasobami wstawianymi po przewinięciu lub kliknięciu
- plikami w pełnej rozdzielczości ukrytymi za miniaturami
- zduplikowanymi adresami URL i wariantami rozmiarów
- metadanymi obrazu, takimi jak wymiary, alt text, nazwa produktu i strona źródłowa
Właściwe narzędzie zależy od tego, czy celem jest folder z plikami, czy też ponownie używalny manifest zasobów.
Jak ocenialiśmy siedem opcji
Porównanie skupia się na:
- Obsłudze obrazów w HTML, obrazów responsywnych, lazy load, tła CSS i nowoczesnych formatów
- Umiejętności odnajdywania oryginalnych plików w pełnej rozdzielczości zamiast widocznych miniatur
- Filtrowaniu według wymiarów, typu i wzorców URL
- Zaznaczaniu wielu elementów, pobieraniu ZIP, zmianie nazw i organizacji folderów
- Eksportowaniu URL-i i metadanych
- Obsłudze stron dynamicznych i infinite scroll
- Pracy wielostronicowej
- Aktualnym stanie utrzymania i jasno opisanych limitach darmowych
Listy rozszerzeń w przeglądarkach zmieniają się z czasem. Poniższe wersje i daty aktualizacji zostały sprawdzone w dniu badania.
1. Thunderbit Image Extractor: najlepszy do uporządkowanych spisów obrazów
Thunderbit's Image Extractor może pobrać obrazy ze strony jednym kliknięciem, pobrać je zbiorczo albo wyeksportować adresy URL obrazów i miniatury do Google Sheets, Notion lub Airtable.
Jego przewaga ujawnia się wtedy, gdy obraz potrzebuje kontekstu. Zamiast tworzyć folder pobranych plików z nieczytelnymi nazwami, workflow może zebrać:
- tytuł produktu lub artykułu
- miniaturę obrazu
- oryginalny adres URL obrazu
- alt text
- cenę, kategorię lub SKU
- adres URL strony źródłowej
Taka struktura ma ogromne znaczenie przy migracji katalogów, badaniach e-commerce, audytach kreatywnych i inwentaryzacjach treści. Paginacja może rozszerzyć ekstrakcję na kolejne strony listy, a scrapowanie podstron może otworzyć każdą stronę szczegółów i połączyć obrazy w wyższej rozdzielczości lub metadane z powrotem do głównej tabeli.
Prosty workflow w Thunderbit
- Otwórz przykładową stronę listingu lub galerii.
- Uruchom Thunderbit i wybierz One Click Extract.
- Zachowaj lub dodaj pola, takie jak tytuł, obraz, URL obrazu, alt text i URL źródłowy.
- Przetestuj małą próbkę i sprawdź, czy linki do obrazów prowadzą do użytecznych rozdzielczości.
- Włącz paginację lub scrapowanie podstron dla reszty katalogu.
- Wyeksportuj tabelę albo pobierz wybrane zasoby zbiorczo.
Najlepsze dla: katalogów wielostronicowych, spisów obrazów produktów, migracji stron i zespołów, które potrzebują weryfikowalnego kontekstu źródłowego.
Minus: to rozwiązanie bardziej procesowe niż proste rozszerzenie typu „pobierz wszystko z tej karty”. Do szybkiego zgrania jednej strony Imageye lub Fatkun mogą wydawać się bardziej bezpośrednie.
Wyodrębniaj każdy obraz jednym kliknięciem Thunderbit Image Extractor jest darmowy na zawsze i nigdy nie zużywa kredytów — pobierz wszystkie zdjęcia ze strony jednym kliknięciem. Get Started Free
2. Imageye: najlepsze dopracowane rozszerzenie do pojedynczej strony
Imageye to rozszerzenie do Chrome stworzone z myślą o odkrywaniu i filtrowaniu obrazów na bieżącej stronie. W opisie sklepowym wymieniono filtry szerokości i wysokości, filtry URL, zaznaczanie zbiorcze, sprawdzanie rozmiaru, kopiowanie oryginalnych URL-i, odwrotne wyszukiwanie obrazem oraz konwersję między WebP, JPG i PNG.
Aktualna lista pokazywała wersję 5.30.1, zaktualizowaną 18 marca 2026. Taka świeża konserwacja ma znaczenie w kategorii, w której wiele starszych rozszerzeń znika albo przestaje działać po zmianach w przeglądarce.
Najlepsze dla: użytkownika, który chce siatkę podglądu, szybkie filtrowanie po wymiarach i prosty przepływ pobierania z jednej strony.
Minus: jak większość rozszerzeń skupionych na pojedynczej karcie, jest mniej przydatne, gdy zadanie obejmuje setki stron produktów albo wymaga powiązania obrazów z produktami w arkuszu.
3. Fatkun: najlepszy do filtrowania i organizacji w e-commerce
Fatkun Batch Download Image koncentruje się na zaznaczaniu, grupowaniu, zmianie nazw, filtrowaniu i pobieraniu obrazów hurtowo. W opisie wymieniono filtry według wymiarów i typu, zaznaczanie metodą przeciągania, grupowanie pod e-commerce, konwersję formatów i obsługę wielu otwartych kart.
Lista została zaktualizowana 13 lipca 2026 i wyraźnie wspomina o opcjonalnym planie Pro. Oznacza to, że najlepszym podejściem do oceny Fatkun jest przetestowanie konkretnych potrzebnych funkcji filtrowania i organizacji w wersji darmowej, zamiast zakładać, że wszystkie zaawansowane opcje są dostępne.
Najlepsze dla: stron produktowych, gdy użytkownik chce najpierw przejrzeć kandydatów do pobrania, a potem od razu uporządkować wynik.
Minus: wynik to nadal głównie kolekcja plików. Jeśli późniejszy proces potrzebuje adresów URL, identyfikatorów produktów albo metadanych strony, lepszy będzie ekstraktor strukturalny.
4. ImageAssistant: najlepszy do dynamicznie ładowanych zasobów
ImageAssistant opisuje się jako sniffer, analizator i batch downloader obrazów, z obsługą obrazów ładowanych przez Ajax.
To sprawia, że jest przydatnym narzędziem specjalistycznym, gdy prostsze rozszerzenie widzi tylko pierwszy zestaw obrazów albo pomija zasoby dodane po interakcji. Aktualna lista pokazywała wersję 1.70.7, zaktualizowaną 23 października 2024.
Najlepsze dla: dynamicznych galerii i stron, na których zwykłe skanowanie <img> nie wykrywa wszystkich załadowanych zasobów.
Minus: interfejs i tempo aktualizacji są mniej nowoczesne niż w Imageye czy Fatkun. Traktuj je jako drugie narzędzie do trudnych stron, a nie automatyczny pierwszy wybór dla każdego użytkownika.
5. ExtractPics: najlepsza aplikacja webowa bez instalacji
ExtractPics przyjmuje publiczny URL strony i uruchamia ekstrakcję przez silnik przeglądarkowy. Informacje o produkcie opisują obsługę img i srcset, tła CSS, SVG i ikon, GIF, WebP, AVIF, zasobów lazy-loaded oraz deduplikacji. Wyniki można pobrać jako ZIP albo skopiować jako URL-e.
Strona cenowa pokazuje obecnie darmowe konto z limitem do 100 kredytów i informuje, że zaawansowana ekstrakcja w aplikacji webowej zużywa dwa kredyty, natomiast nieudane ekstrakcje nie zużywają kredytów. Branding i nazewnictwo limitów mogą się zmieniać między extractpics.com a extract.pics, więc przed planowaniem dużej partii warto sprawdzić aktualny limit.
Najlepsze dla: okazjonalnej ekstrakcji z publicznych stron, gdy instalowanie rozszerzenia do przeglądarki jest niewygodne.
Minus: aplikacja oparta na URL może nie widzieć treści wymagających zalogowanej sesji użytkownika lub lokalnej interakcji w przeglądarce. Zużycie kredytów sprawia też, że przy dużym katalogu jest mniej przewidywalna niż specjalnie zbudowany workflow wielostronicowy.
6. DownThemAll: najlepsza kolejka pobierania dla Firefoksa
DownThemAll to darmowy, open-source'owy dodatek do Firefoksa do zaznaczania, kolejkowania, filtrowania, sortowania i zmieniania nazw pobieranych plików. Mozilla oznacza go jako Recommended; aktualna wersja to 4.15.1, zaktualizowana 27 maja 2026.
Nie jest to narzędzie analizujące DOM wyłącznie pod kątem obrazów. Jego siłą jest kolejka pobierania: wielokrotnie używalne filtry, uporządkowane partie i dojrzała obsługa wielu linkowanych plików.
Najlepsze dla: użytkowników Firefoksa, którzy już wiedzą, jakie linkowane zasoby chcą pobrać i potrzebują niezawodnego masowego pobierania.
Minus: może nie wykrywać obrazów ukrytych za JavaScriptem, CSS albo osobnym linkiem do oryginału tak skutecznie jak dedykowany ekstraktor obrazów.
7. Browser DevTools: najlepsza metoda diagnostyczna bez instalacji
Wbudowany w Chrome Network panel nie jest przyjaznym narzędziem do pobierania hurtowego, ale to najbardziej przejrzysty sposób, by odpowiedzieć na pytanie: „który plik obrazu przeglądarka faktycznie załadowała?”
Jak znaleźć oryginalny obraz w DevTools
- Otwórz DevTools i wybierz Network.
- Przefiltruj żądania do Img.
- Odśwież stronę, a potem przewiń ją lub wejdź w interakcję, aby pojawiły się lazy-loaded obrazy.
- Wybierz żądanie i sprawdź jego URL, typ treści oraz wymiary.
- Otwórz żądanie w nowej karcie i zapisz plik.
Często ujawnia to tło CSS, wariant responsywny albo plik w wysokiej rozdzielczości z CDN, którego menu kontekstowe strony nie pokazuje.
Najlepsze dla: jednego problematycznego zasobu, diagnostyki technicznej lub weryfikacji, który wariant responsywny został pobrany.
Minus: jest powolne przy dziesiątkach plików i nie tworzy automatycznie manifestu ani nie zachowuje kontekstu strony.
Pliki vs. URL-e vs. uporządkowane metadane
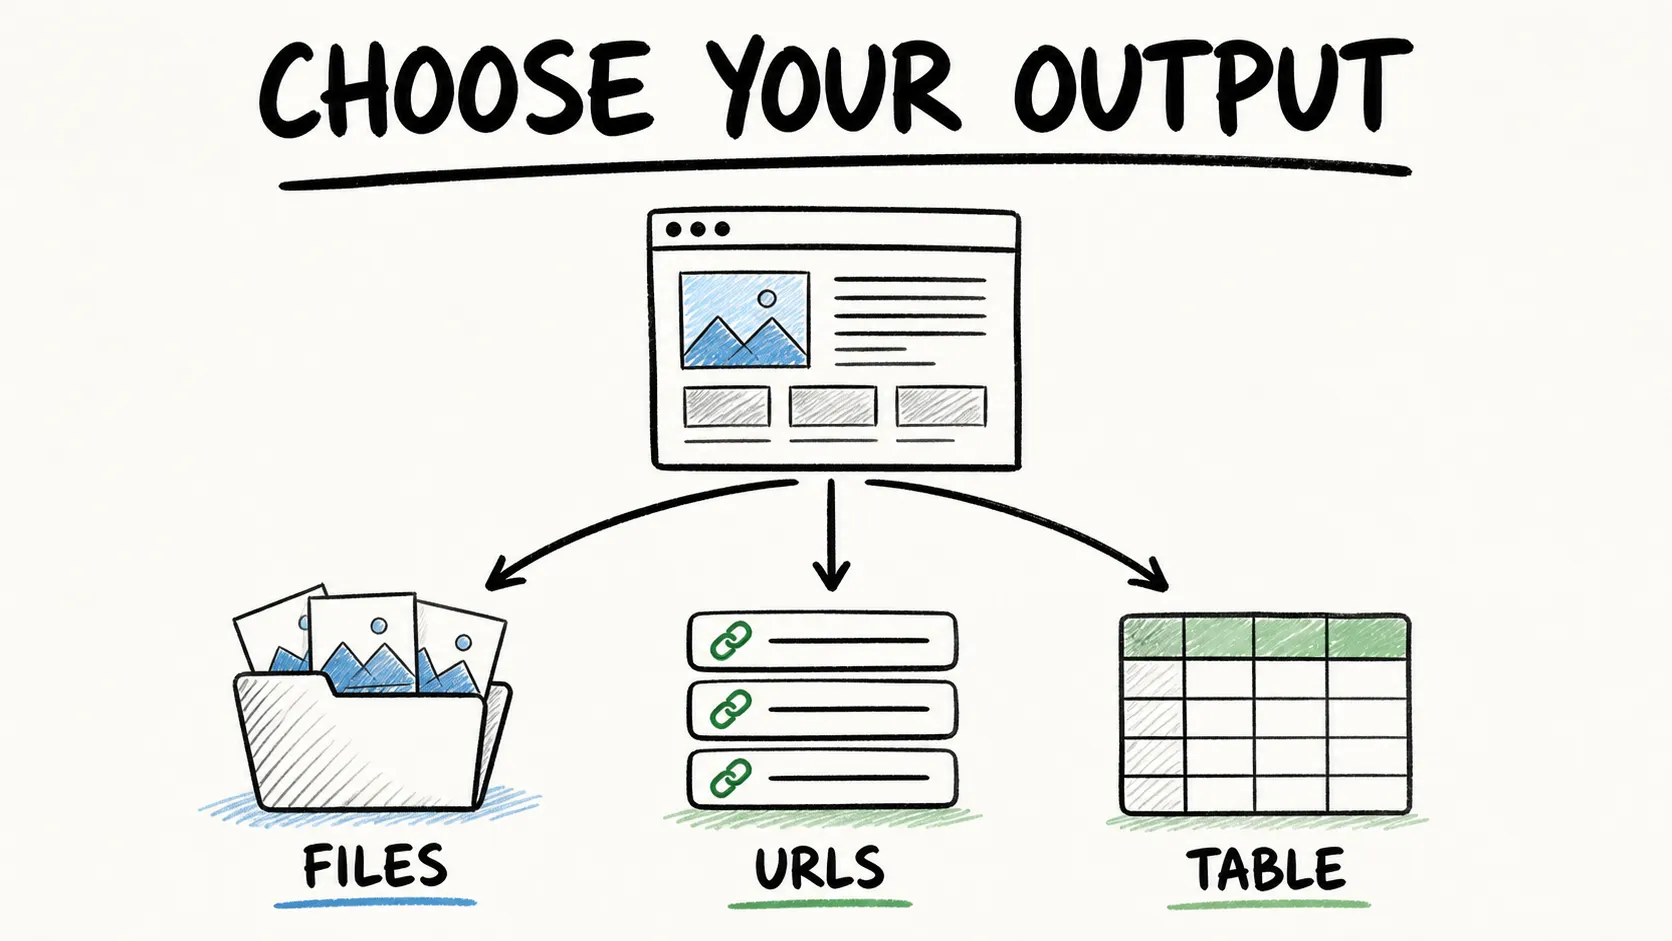 Zanim wybierzesz narzędzie, określ rezultat końcowy:
- Tylko pliki: dobre do mood boardu, przeglądu offline albo jednorazowej kolekcji kreatywnej.
- Adresy URL obrazów: przydatne do skryptów migracyjnych, audytów i deduplikacji.
- Ustrukturyzowane rekordy: najlepsze, gdy obrazy muszą pozostać powiązane z produktami, artykułami, cenami, alt textem, kategoriami lub stronami źródłowymi.
Trzeci wariant zapobiega częstemu problemowi operacyjnemu: folderowi pełnemu zasobów, których nikt nie potrafi już jednoznacznie przypisać do strony lub elementu, z którego pochodzą.
Praktyczny workflow jakości
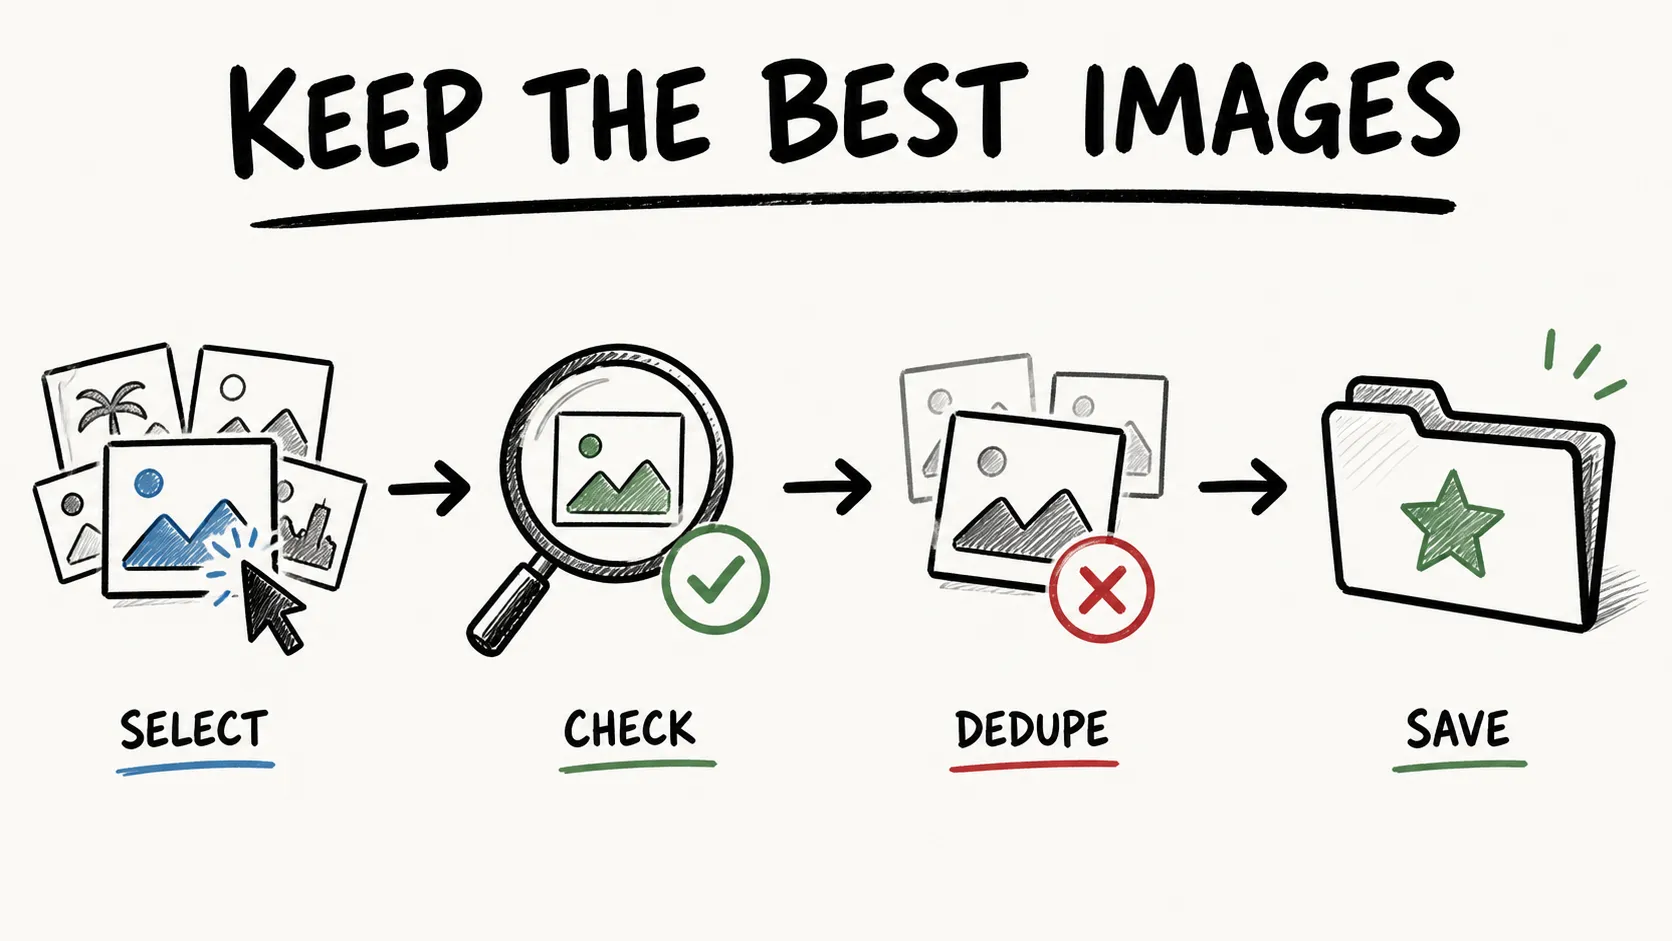 Niezależnie od użytego narzędzia obowiązują te same kontrole jakości:
- Wyzwól lazy loading. Przewiń i wejdź w interakcję, zanim uznasz, że strona została w pełni zeskanowana.
- Wybieraj największy sensowny wariant. Sprawdzaj
srcset, linki do oryginałów i parametry CDN zamiast zapisywać miniaturę. - Filtruj oczywisty szum. Wyklucz małe wymiary oraz znane ścieżki ikon, odznak, logo i trackerów, jeśli są nieistotne.
- Szukaj placeholderów i nakładek. Przezroczyste piksele, szkielety ładowania, sprite’y i znaki wodne mogą zaśmiecić batch.
- Zachowaj dowody źródłowe. Przechowuj adres URL strony źródłowej i oryginalny URL zasobu przy każdym pliku.
- Usuń duplikaty. Porównuj znormalizowane URL-e lub hashe plików, aby ten sam projekt w pięciu rozmiarach nie stał się pięcioma „unikalnymi” zasobami.
- Konwertuj formaty na końcu. Zachowaj oryginał przed konwersją WebP lub AVIF do innego formatu.
Pobranie zasobu nie daje automatycznie prawa do ponownego użycia, więc przed publikacją upewnij się, że planowane wykorzystanie jest dozwolone.
Dostępne w planach Free, Starter i Pro Image Extractor działa w planach Free, Starter i Pro, a przy tym nigdy nie zużywa Twoich kredytów ekstrakcji. Get Started Free
Który darmowy ekstraktor obrazów wybrać?
- Wybierz Thunderbit, gdy zadanie obejmuje wiele stron albo wymaga uporządkowanych metadanych i śledzenia źródeł.
- Wybierz Imageye do dopracowanego, aktualnego workflow na jednej stronie w Chrome.
- Wybierz Fatkun, gdy liczą się grupowanie, filtrowanie i zmiana nazw w e-commerce.
- Wybierz ImageAssistant, gdy dynamiczne ładowanie pokonuje prostsze skanery.
- Wybierz ExtractPics, gdy najwygodniejsza jest aplikacja webowa bez instalacji.
- Wybierz DownThemAll, gdy priorytetem są kolejki pobierania w Firefoxie i wielokrotne używalne filtry.
- Wybierz DevTools, gdy trzeba z pewnością zdiagnozować jeden oryginalny plik.
Wypróbuj darmowy Image Extractor od Thunderbit Get Started Free
Najczęstsze błędy
Zapisywanie widocznej miniatury. Przeglądarka może pokazywać skompresowany wariant, podczas gdy większy plik jest dostępny w srcset albo w żądaniach sieciowych.
Pobieranie przed pełnym załadowaniem strony. Galerie z infinite scroll i lazy load wymagają interakcji.
Filtrowanie wyłącznie po rozszerzeniu pliku. Nowoczesne CDN-y często serwują obrazy z adresów URL bez klasycznego sufiksu .jpg.
Ignorowanie duplikatów. Ten sam obraz źródłowy może występować w kilku rozdzielczościach, kadrach albo wariantach z parametrami URL.
Gubienie strony źródłowej. Pliki bez manifestu źródeł trudno później audytować, aktualizować lub powiązać z produktami.
Zakładanie, że każde rozszerzenie do Chrome jest aktywnie rozwijane. Zanim ustandaryzujesz workflow zespołu, sprawdź aktualną wersję i datę aktualizacji w oficjalnym sklepie.
FAQ
Jaki jest najłatwiejszy darmowy ekstraktor obrazów?
Dla jednej publicznej strony w Chrome dobrym punktem startu jest Imageye. W przypadku katalogu wielostronicowego albo inwentarza, który potrzebuje URL-i źródłowych i metadanych, Thunderbit da bardziej użyteczny wynik.
Jak pobrać oryginalny obraz zamiast miniatury?
Sprawdź srcset, linki do obrazów i żądania sieciowe przeglądarki. Wybierz największy sensowny wariant i zweryfikuj jego wymiary, zamiast ufać plikowi widocznemu w układzie strony.
Czy ekstraktory obrazów potrafią znaleźć tła CSS?
Niektóre tak, w tym narzędzia oparte na silniku przeglądarki, takie jak ExtractPics. Panel Network w Chrome DevTools to niezawodny fallback, bo pokazuje żądanie obrazu faktycznie wykonane przez przeglądarkę.
Czy mogę wyodrębnić obrazy z wielu stron produktowych naraz?
Tak. Użyj narzędzia strukturalnego z paginacją lub scrapowaniem podstron, aby każdy obraz pozostał powiązany z nazwą produktu, SKU, adresem źródłowym i innymi polami. Rozszerzenia pobierające kartę po karcie są przy takiej skali znacznie wolniejsze.
Dlaczego ekstraktor pomija obrazy na stronie z infinite scroll?
Takie zasoby mogą nie istnieć na stronie, dopóki użytkownik nie przewinie lub nie wywoła żądania. Najpierw przewiń stronę, użyj narzędzia obsługującego dynamiczne ładowanie albo wyodrębnij dane przez workflow renderowany w przeglądarce.
Najlepszy darmowy ekstraktor obrazów to nie ten, który zwraca najwięcej plików. To ten, który dostarcza potrzebne zasoby w odpowiedniej rozdzielczości i z wystarczającym kontekstem, by można było z nich efektywnie korzystać.
Dowiedz się więcej



