Większość recenzji „Bright Data” w internecie brzmi jak broszura produktowa z doczepioną oceną w gwiazdkach. Pojawia się wzmianka o puli 400M+ adresów IP, cytuje się promocyjną stawkę „$4/GB” i temat uznaje się za zamknięty. To niewiele pomaga, jeśli próbujesz ocenić, czy ta platforma rzeczywiście jest warta Twojego budżetu. Dlatego przez kilka tygodni rozkładałem na czynniki pierwsze realną matematykę cen, przeglądałem setki opinii użytkowników na Trustpilot, G2, Capterra i Reddit oraz testowałem, jak produkty Bright Data radzą sobie na zabezpieczonych stronach. To, co znalazłem, to platforma, która rzeczywiście zasługuje na miano „best-in-class” w enterprise’owej infrastrukturze proxy — ale jednocześnie ma ukryte pułapki kosztowe, luki w niezawodności przy trudnych celach i poziom złożoności kompletnie niedopasowany do większości zespołów, które po prostu chcą ustrukturyzowanych danych ze stron internetowych. Ten artykuł to szczera recenzja Bright Data, jaką sam chciałbym przeczytać na początku researchu.
Czym jest Bright Data? Krótkie wprowadzenie dla zespołów nietechnicznych
Bright Data to premiumowa sieć proxy i platforma do pozyskiwania danych z sieci. Mówiąc prosto: kieruje Twoje żądania webowe przez miliony różnych adresów IP na całym świecie, dzięki czemu możesz skalować dostęp do stron bez blokad. To coś w rodzaju ogromnej, globalnej sieci „przebrań” dla działań związanych z pozyskiwaniem danych.
Firma, pierwotnie znana jako Luminati Networks (rebranding w marcu 2021), została przejęta przez EMK Capital za 200 milionów dolarów w 2017 roku. Z siedzibą w Netanyi w Izraelu oraz biurami w Nowym Jorku i w całej Europie, Bright Data obsługuje dziś 20,000+ klientów — w tym 14 z 20 najlepszych laboratoriów LLM — i generuje ponad $300M rocznie.
Oferta produktowa dawno wykroczyła poza same proxy:
- Sieci proxy — residential, datacenter, ISP (statyczne) i mobile
- Web Unlocker — API, które automatycznie radzi sobie z zabezpieczeniami anty-bot
- Scraping Browser — przeglądarka w chmurze do stron z ciężkim JavaScriptem
- Web Scraper API — gotowe scrapery dla 437+ serwisów
- Gotowe zbiory danych — prebuilt data dla 120+ domen
- Narzędzia AI — Browser.AI, MCP Server, Deep Lookup (więcej o nich później)
Oto szybki przegląd specyfikacji:
| Specyfikacja | Szczegóły |
|---|---|
| Residential IPs | 400M+ miesięcznie (150M+ z etycznego źródła) |
| Datacenter IPs | 1.3M+ |
| ISP/Static IPs | 1.3M+ |
| Mobile IPs | 7M+ |
| Kraje | 195 (targetowanie według miasta/stanu/ASN) |
| Ocena Trustpilot | 4.4/5 (~969 opinii) |
| Ocena G2 | 4.7/5 (~295 opinii) |
| Ocena Capterra | 4.7/5 (68 opinii) |
| Darmowy okres próbny | 7 dni (wymaga KYC); do 15 DC IP + 2 GB za darmo |
| Cena startowa | $0.60/GB (datacenter); $8.00/GB (residential PAYG) |
Docelową grupą są przede wszystkim zespoły enterprise i techniczne. Jeśli masz programistów na pokładzie i pięciocyfrowy miesięczny budżet na scraping, Bright Data powstało dla Ciebie. Jeśli jesteś menedżerem sprzedaży i potrzebujesz 200 leadów ze strony do piątku, to czytaj dalej.
Cennik Bright Data: pełne rozbicie kosztów (a nie tylko „$4/GB”)
Tutaj większość recenzji Bright Data się rozsypuje. Autorzy podają promocyjną stawkę dla residential proxy i idą dalej. Rzeczywista wycena jest znacznie bardziej złożona — i wyraźnie droższa — niż sugeruje marketing.
Residential Proxies (za GB)
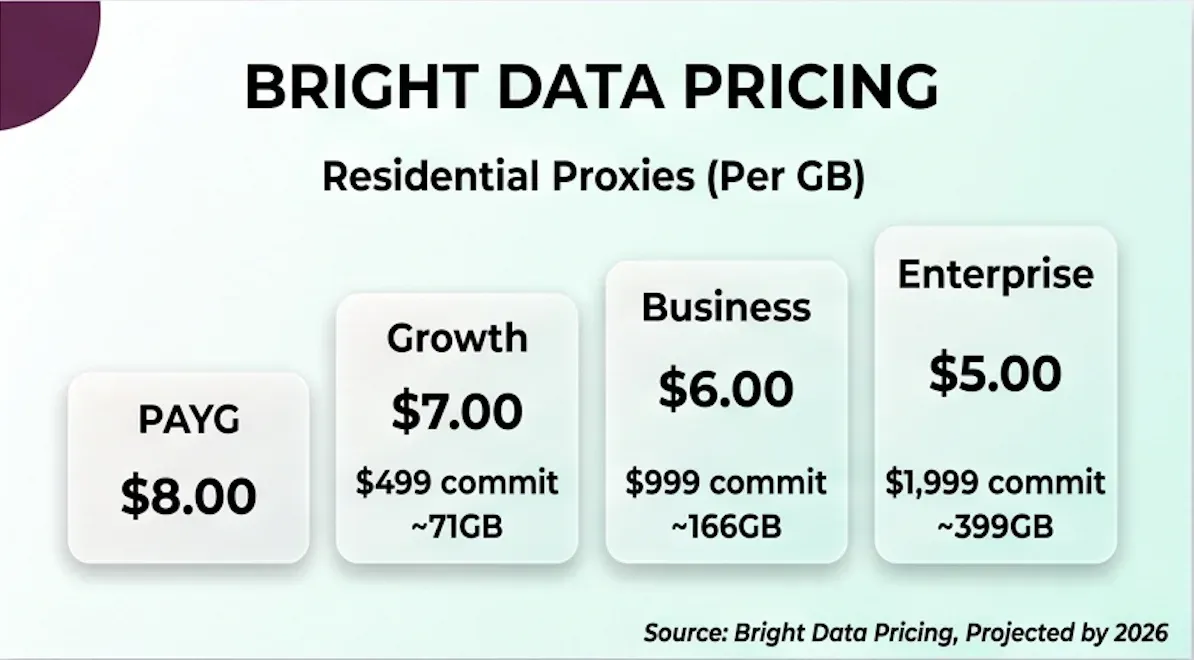
| Plan | Za GB | Miesięczne zobowiązanie | Wliczony transfer |
|---|---|---|---|
| Pay-As-You-Go | $8.00 | Brak | Brak |
| Growth | $7.00 | $499 | ~71 GB |
| Business | $6.00 | $999 | ~166 GB |
| Enterprise | $5.00 | $1,999 | ~399 GB |
To słynne „$4/GB”, które widać wszędzie? To stawka promocyjna (kod RESIGB50, 50% zniżki przez 3 miesiące). Po zakończeniu promocji wracasz do pełnej ceny. Warto też znać kontekst historyczny: PAYG dla residential wynosiło $10.50 przed wrześniem 2023, spadło do $8.40 po marcu 2024 i obecnie wynosi $8.00.
Datacenter Proxies
Najbardziej przystępna cenowo opcja. Pula współdzielona: $0.60/GB PAYG. Pula dedykowana: $0.90–$1.40/IP/miesiąc (standard) albo $1.30–$2.20/IP/miesiąc (premium). Każdy IP ma 100 GB/miesiąc w ramach zasad fair use — po przekroczeniu płacisz stawkę overage jak w PAYG.
ISP (Static Residential) Proxies
Współdzielone: $1.30–$1.80/IP/miesiąc, zależnie od wolumenu. Dedykowane: $2.50–$3.50/IP/miesiąc. Plany transferowe odwzorowują cennik residential. Obowiązuje ten sam limit fair use 100 GB/IP.
Mobile Proxies
W kwietniu 2024 zrównano je cenowo z residential — wcześniej kosztowały $14/GB, teraz $8.00/GB PAYG. Taka sama struktura progów jak w residential.
Web Unlocker API (za 1,000 skutecznych żądań)
| Plan | CPM (za 1K wyników) | Koszt miesięczny |
|---|---|---|
| Pay-As-You-Go | $1.50 | Brak |
| Growth | $1.30 | $499 (~380K wyników) |
| Business | $1.10 | $999 (~900K wyników) |
| Scale | $1.00 | $1,999 (~2M wyników) |
Model rozliczeń tutaj zasługuje na czerwoną flagę. Bright Data promuje Web Unlocker hasłem „Pay Only For Success” — i domyślnie to prawda. Ale ich własna dokumentacja ujawnia kluczowy wyjątek: „When any of the Custom Web Unlocker API features are enabled, you'll be billed for 100% of the requests (both successful and failed).” Do funkcji custom należą ręczne nagłówki, cookies i elementy „expect”. Innymi słowy: w momencie, gdy potrzebujesz precyzyjnej kontroli — a często właśnie wtedy, gdy scrapujesz trudne cele — tracisz ochronę rozliczania wyłącznie za sukces.
Scraping Browser (za GB)
Ta sama struktura progów co w residential: $8.00/GB PAYG, aż do $5.00/GB w Enterprise. W przeciwieństwie do Web Unlocker, dokumentacja nie mówi wprost, czy transfer z nieudanych prób jest naliczany — co w praktyce oznacza, że płatny jest cały transfer, także z porażek.
Web Scraper API
PAYG: $1.50/1K rekordów. Scale: $1.30/1K ($499/mies. za ~384K rekordów). W zestawie 437+ gotowych szablonów scraperów dla Amazon, LinkedIn, Glassdoor, Walmart, Zillow i wielu innych serwisów. Rozliczane są tylko skutecznie dostarczone wyniki. 1K rekordów w wersji próbnej za darmo.
Warto wspomnieć o zmianach ze stycznia 2025: Bright Data obniżyło ceny Web Unlocker i SERP API o 50%, jednocześnie podnosząc ceny Web Scraper API o 50%, co doprowadziło do ujednolicenia stawki w okolicach $1.50/1K CPM. Jeśli budżet był oparty na cenniku z 2024 roku, czas go przeliczyć.
Pay-Per-GB vs. Pay-Per-IP: który model wybrać?
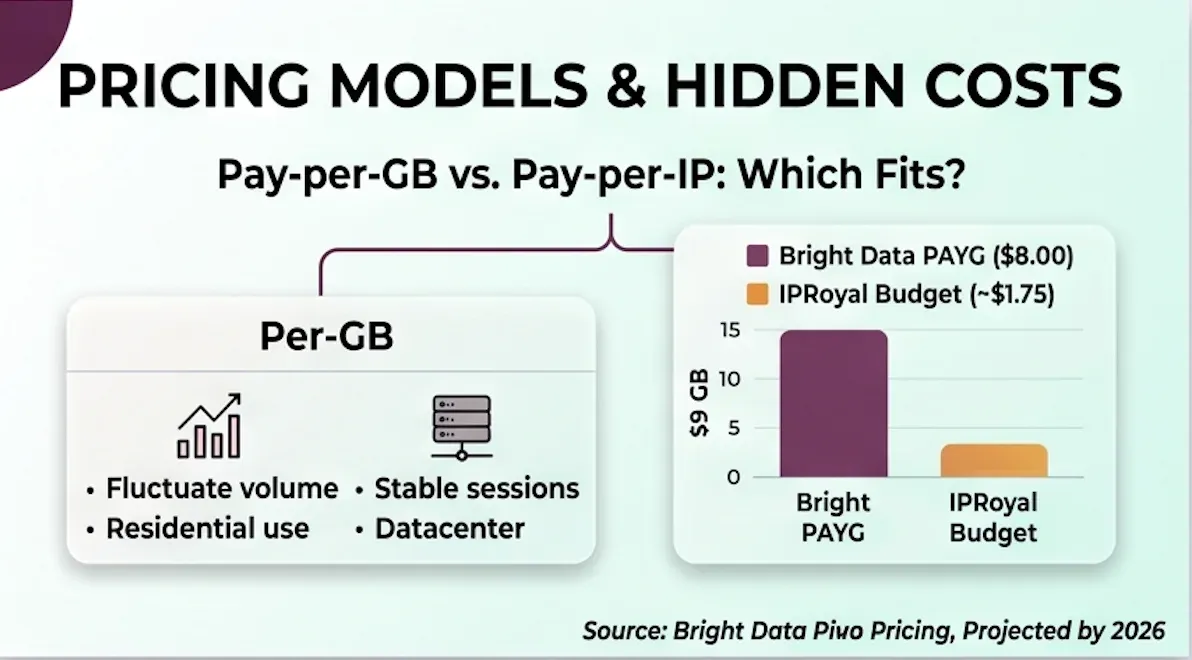
Pay-per-GB ma sens, gdy wolumen scrapingu zmienia się z miesiąca na miesiąc — to typowe dla residential i mobile, gdy celujesz w wiele różnych stron. Pay-per-IP lepiej sprawdza się przy stabilnych, długich sesjach: zarządzaniu kontami, weryfikacji reklam albo monitoringu SEO z datacenter lub ISP proxy, gdzie potrzebujesz tych samych IP w sposób ciągły.
Krótka zasada: przewidywalna liczba IP, ale zmienny transfer? Wybierz per-IP. Przewidywalny transfer, ale potrzebujesz rotujących IP? Wybierz per-GB.
Ukryte koszty, których drobny druk nie eksponuje
- Rozliczanie nieudanych żądań: Web Unlocker nalicza opłaty za wszystkie żądania, gdy włączysz funkcje custom. Scraping Browser rozlicza cały transfer niezależnie od wyniku.
- Przekroczenia transferu: ISP proxy mają limit fair use 100 GB/IP. Jeden z recenzentów opisał „nieoczekiwany rachunek overage na $300” po wykorzystaniu limitu w 23 dni.
- Brak środka pomiędzy: Jak zauważył Hackceleration, „nie ma realnego środka pomiędzy pay-as-you-go za $1.50/1K (zbyt drogie przy większej skali) a zobowiązaniem $499 miesięcznie”.
- Efekt skoku po promocji: 50% zniżki trwają 3 miesiące, po czym wchodzi pełna stawka — i pojawia się szok cenowy w 4. miesiącu.
Scenariusz kosztowy: 50 GB scrapingu residential miesięcznie
| Podejście | Stawka za GB | Koszt miesięczny |
|---|---|---|
| Bright Data PAYG | $8.00 | $400 |
| Bright Data Growth Plan | $7.00 | $499 (wliczone 71 GB) |
| IPRoyal (tańsza alternatywa) | $1.75 | $87.50 |
| Thunderbit Pro | Stała opłata | $38/mies. (na kredytach, ok. 3,000 wierszy) |
To różnica ceny rzędu 4–10x. Dla zespołów, których celem końcowym są ustrukturyzowane dane w arkuszu — a nie surowa infrastruktura proxy — matematyka kosztów rzadko przemawia za Bright Data.
Wypróbuj Thunderbit do ekstrakcji ustrukturyzowanych danych
Jak obniżyć koszty Bright Data: praktyczne sposoby, które naprawdę działają
Już korzystasz z Bright Data (albo jesteś związany umową)? Oto taktyki, które realnie wpływają na rachunek.
Używaj datacenter proxy zamiast residential, jeśli target na to pozwala. Współdzielone datacenter kosztuje $0.60/GB, a residential $8.00/GB — różnica 13x. Wiele niestrzeżonych stron (news, publiczne katalogi, dane rządowe) działa bez problemu na datacenter.
Ustaw limity wydatków per zone w panelu. Panel Bright Data pozwala konfigurować limity ruchowe lub kwotowe dla każdej strefy. Limity przeliczane są co 15 minut, więc strefa może przebić budżet o maksymalnie 15 minut użycia. Alerty mailowe uruchamiają się przy 85% zużycia salda.
Dokończ KYC wcześniej, żeby uzyskać Full Access. Immediate Access (bez KYC) ogranicza Cię do GET, ok. 200 zatwierdzonych domen i throttlingu narzuconego przez dostawcę — co oznacza więcej błędów 402 i więcej zmarnowanego transferu. Full Access odblokowuje wszystkie metody i usuwa większość ograniczeń domenowych, więc rośnie skuteczność, a spadają straty.
Blokuj zbędne zasoby, żeby obciąć transfer o 50–80%. Obrazy, CSS, fonty, reklamy i skrypty śledzące można odciąć przez intercept requestów albo blokowanie tras CDP. Sam ten zabieg potrafi zmniejszyć rachunek o połowę. Lokalne cache’owanie odpowiedzi może ograniczyć transfer nawet o 90% na stronach, które rzadko się zmieniają.
Nie włączaj funkcji custom w Web Unlocker, jeśli nie musisz. Gdy ustawisz ręczne nagłówki albo cookies, przechodzisz z rozliczania za sukces do rozliczania za 100% żądań. Na celu o wysokim odsetku porażek różnica może być ogromna.
Wiedz, kiedy całkowicie zmienić narzędzie. Jeśli Twoim przypadkiem użycia jest wyciąganie ustrukturyzowanych danych ze stron — list produktów, danych kontaktowych, ofert nieruchomości — bez budowania własnych pipeline’ów scrapujących, narzędzia takie jak AI web scraper Thunderbit mogą zastąpić cały stack proxy. Bez opłat za transfer, bez konfiguracji proxy, bez KYC.
Rzeczywistość niezawodności: gdzie Bright Data ma problemy
Bright Data reklamuje uptime 99%+ i wysoką skuteczność. Na łatwych targetach to się zgadza. Problem w tym, że nikt nie kupuje enterprise’owej platformy proxy po to, żeby scrapować łatwe strony.
Skuteczność według kategorii celu
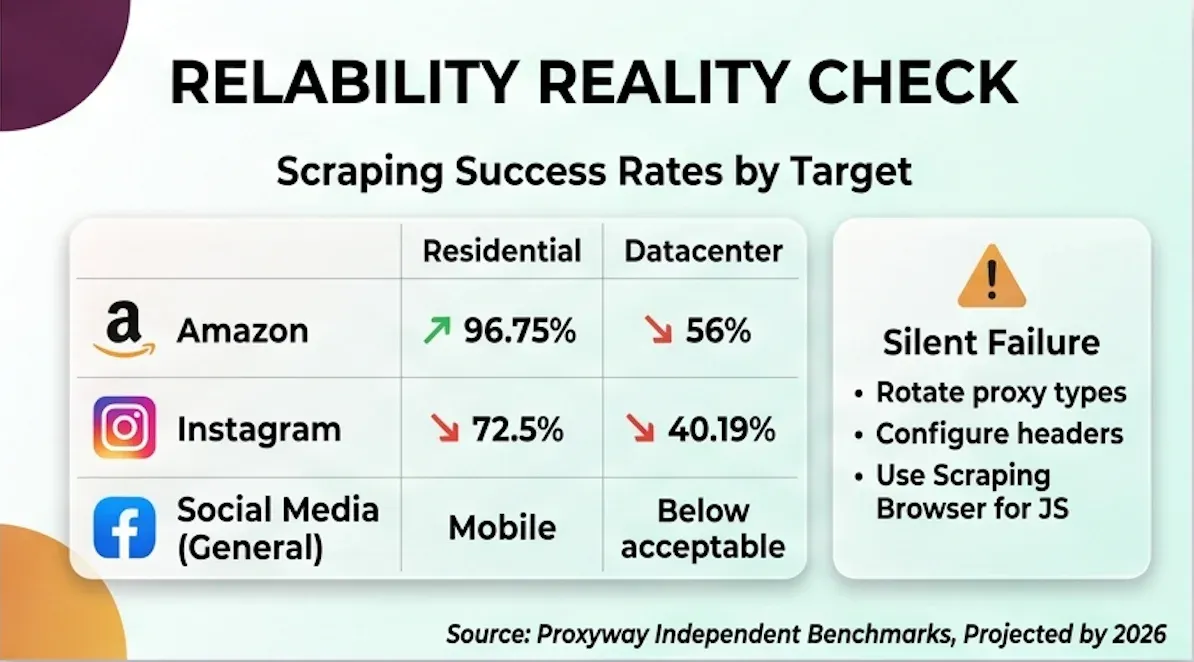
| Cel | Typ proxy | Skuteczność | Źródło |
|---|---|---|---|
| Większość komercyjnych stron | Residential | 98–99% | Proxyway |
| Amazon | Residential | 96.75% | Proxyway |
| Amazon | Datacenter (shared) | 56% | Proxyway |
| Amazon | Datacenter (dedicated) | 65% | Proxyway |
| Residential | 72.5% (odpowiedź 12.56s) | webscraping.blog | |
| Mobile | 40.19% (17.58s) | webscraping.blog | |
| Web Unlocker | 99.3% | Różne | |
| Social media (ogólnie) | Mobile | Poniżej akceptowalnego poziomu | Proxyway: „wolniej i częściej zawodzi niż działa” |
Residential proxy dobrze radzą sobie na większości stron komercyjnych. Skuteczność gwałtownie spada na chronionym e-commerce (Amazon przez datacenter: 56%), social media (Instagram przez mobile: 40%) oraz stronach za agresywnymi WAF-ami, takimi jak Cloudflare czy PerimeterX.
Niezależny benchmark Proxyway dodaje ważny kontekst: mimo że Bright Data reklamuje 400M+ residential IP, Proxyway „w testach znalazło tylko około 3,000 brytyjskich proxy i mniej niż 1,000 australijskich adresów” — co sugeruje, że geograficzna głębokość oferty mocno się różni.
Problem cichego niepowodzenia
To najbardziej podstępne ryzyko. Zamiast wyraźnego błędu „blocked”, niektóre strony zwracają dane, które wyglądają na poprawne — ale są niepełne albo nieaktualne. Sama dokumentacja Bright Data przyznaje, że gdy cel zmienia zabezpieczenia, scraper potrafi zawieść bez ostrzeżenia, zwracając puste pola lub stare dane, mimo że wszystko wygląda normalnie. Możesz nawet nie zauważyć uszkodzenia danych, dopóki nie trafią do pipeline’u.
Najlepsze praktyki, które poprawiają skuteczność
Rotuj nie tylko IP, ale też typ proxy. Jeśli residential nie działa na danym celu, spróbuj ISP albo mobile — różne typy proxy wywołują inne wzorce detekcji.
Konfiguruj poprawne nagłówki żądań i user-agent, by naśladować realne zachowanie przeglądarki. Domyślne ustawienia są zwykle pierwszą rzeczą, którą wyłapują systemy anty-bot.
Używaj Scraping Browser zamiast Web Unlocker dla celów z ciężkim JavaScriptem. Web Unlocker nie renderuje JavaScriptu; Scraping Browser uruchamia pełnego Chrome’a w chmurze. Dla stron wymagających renderowania po stronie klienta (większość nowoczesnych SPA) to różnica między sukcesem a porażką.
Monitoruj stronę statusu sieci Bright Data w czasie rzeczywistym, żeby nie uruchamiać zadań podczas awarii. Brzmi banalnie, ale widziałem zespoły, które przepalały setki dolarów na nieudane żądania w trakcie degradacji sieci.
Dla zespołów, które w ogóle nie chcą grzebać w konfiguracji proxy, no-code’owa alternatywa jak Thunderbit obsługuje wyzwania anty-bot przez silnik AI, bez konieczności wyboru typu proxy, ustawiania nagłówków czy zarządzania retry logic.
Co mówią ponad 500 prawdziwych użytkowników: zebrany sentyment z recenzji Bright Data
Przeczytałem setki opinii na Trustpilot, G2, Capterra i Reddit, żeby wyłapać rzeczywiste wzorce — nie tylko starannie wybrane cytaty.
Oceny na różnych platformach
| Platforma | Ocena | Opinie | Wyróżnik |
|---|---|---|---|
| Trustpilot | 4.4/5 | ~969 | 85% pięciogwiazdkowych, 9% jednogwiazdkowych (bardzo spolaryzowane) |
| G2 | 4.7/5 | ~295 | #1 w kategorii Proxy Network |
| Capterra | 4.7/5 | 68 | Zweryfikowane opinie |
Rozkład na Trustpilot jest mocno spolaryzowany. Zespoły enterprise z dedykowanym account managerem zostawiają pięciogwiazdkowe recenzje. Mniejsze zespoły, które wpadają w ścianę kosztów i złożoności, dają jedną gwiazdkę. Niewiele jest opinii pośrodku.
Sentyment według kategorii
| Kategoria | Sygnał pozytywny | Sygnał negatywny | Wniosek netto |
|---|---|---|---|
| Wielkość puli IP i pokrycie | ★★★★★ | — | Bardzo pozytywny |
| Skuteczność scrapingu | ★★★★ | ★★ | Raczej pozytywny |
| Cena i wartość | ★★ | ★★★★★ | Negatywny |
| Obsługa klienta | ★★★ | ★★★ | Spolaryzowany |
| Łatwość użycia / onboarding | ★★ | ★★★★ | Negatywny |
| Świeżość danych (datasets) | ★★ | ★★★ | Raczej negatywny |
Co użytkownicy lubią w Bright Data
Wielkość puli IP i globalny zasięg są konsekwentnie chwalone. Jeden z użytkowników napisał: „Przed Bright Data nasza skuteczność wynosiła 68% na darmowych proxy. Po wdrożeniu wzrosła do 99.2% — dzienna liczba stron skoczyła z ~2,000 do ~18,000.”
Wsparcie enterprise również zbiera dobre oceny — dedykowani account managerowie, średni czas odpowiedzi mailowej 14 minut dla płacących klientów i proaktywne monitorowanie. Narzędzie Proxy Manager jest cenione przez zespoły techniczne, które chcą precyzyjnie kontrolować rotację, targetowanie i zarządzanie sesjami.
Zgodność z regulacjami i etyczne pozyskiwanie danych mają znaczenie dla klientów korporacyjnych, a SOC 2 Type II, ISO 27001 i audyty zewnętrzne Bright Data dają realne poczucie bezpieczeństwa.
Co użytkownicy krytykują
Cena to zdecydowanie największy zarzut. Użytkownicy opisują ją jako „3–10x wyższą” niż u alternatyw. Jak ujął to jeden z recenzentów: „Jeśli jesteś solo founderem próbującym zebrać dane o cenach konkurencji, złożoność i model kosztowy Bright Data mogą przypominać użycie hydrantu do podlania rośliny doniczkowej.”
Onboarding rzeczywiście boli. KYC wymaga przesłania dokumentu tożsamości wydanego przez rząd, a pełną weryfikację mogą przejść tylko zarejestrowane firmy. Freelancerzy muszą odbyć wideorozmowę po angielsku. Jeden z recenzentów Trustpilot zwrócił uwagę, że „wymaganie sesji wideo z rozmową po angielsku” to istotna bariera dla użytkowników międzynarodowych. Oficjalny czas akceptacji to „48 godzin”, ale użytkownicy raportują od 3 dni do 3 tygodni.
Jakość wsparcia jest spolaryzowana. Konta enterprise dostają szybką pomoc. Bezpłatne konta trial nie mają dostępu do supportu w ogóle. Wsparcie telefoniczne jest dostępne dopiero od progu $5K+/miesiąc. Recenzent G2 napisał: „Produkty Bright Data web unlocker miały odblokowywać trudne strony... w praktyce tak nie było, bo wskaźnik porażek był bardzo wysoki, a ja byłem obciążany za nieudane zapytania.”
Złożoność panelu odstrasza nietechnicznych użytkowników. Interfejs jest potężny, ale przytłaczający. Kilku recenzentów opisywało krzywą uczenia jako „od dni do tygodni”, zanim poczujesz się komfortowo. Jeden z użytkowników Capterra (Emiliano G., wrz 2025) napisał: „Produkty gwałtownie się pogorszyły i teraz mierzą się z wysokim odsetkiem błędów pobierania danych.”
Zwrot Bright Data w stronę AI: Browser.AI, MCP Server i Deep Lookup
2 lipca 2025 Bright Data jednocześnie uruchomiło trzy produkty AI, wyraźnie repositionując się z „dostawcy proxy” na „AI data infrastructure”. CEO Or Lenchner powiedział: „Inteligencja dzisiejszych LLM-ów nie jest już ograniczeniem; ograniczeniem jest dostęp.”
Browser.AI to bezserwerowa, chmurowa autonomiczna przeglądarka dla agentów AI. Wystarczy dać jej zadanie po ludzku: „wejdź na Amazon, wyszukaj słuchawki bezprzewodowe, zbierz 20 najlepszych wyników” — a ona uruchomi prawdziwego Chrome’a w chmurze Bright Data, będzie nawigować jak człowiek, obsłuży CAPTCHA i zwróci ustrukturyzowane dane. Testy Proxyway pokazały 98.44% skuteczności na siedmiu trudnych domenach. Cennik: Free (2 GB), Starter $39/mies. (10 GB), PAYG $8/GB.
MCP Server to open-source’owy most zbudowany na standardzie Anthropic Model Context Protocol. Pozwala asystentom AI (Claude, Cursor, Windsurf, LangChain, LlamaIndex) bezpośrednio korzystać z 30+ narzędzi scrapujących Bright Data. Po 3-miesięcznym prywatnym becie z 15,000 developerów, produkt wszedł publicznie w sierpniu 2025. Darmowy tier: 5,000 żądań/miesiąc. Strategicznie to prawdopodobnie najważniejszy produkt Bright Data — ustawia firmę jako domyślną warstwę web data dla całego ekosystemu agentów AI.
Deep Lookup to silnik researchowy w języku naturalnym, który przeszukuje 1,000+ publicznych źródeł i zwraca ustrukturyzowane dane gotowe do tabeli, wraz z cytowaniami. Nadal w becie (5 darmowych zapytań bez karty). Model: płatność tylko za dopasowane wyniki. Raportowane wskaźniki dopasowania 90–100% dla lead generation i competitive intelligence.
Czy naprawdę potrzebujesz funkcji AI Bright Data?
Jeśli budujesz modele AI, trenujesz LLM-y na danych z internetu albo tworzysz pipeline’y danych czasu rzeczywistego dla machine learning — te narzędzia są naprawdę mocne i warte sprawdzenia.
Ale dla zespołów biznesowych, które potrzebują ustrukturyzowanych danych ze stron — leadów sprzedażowych, cen produktów, ofert nieruchomości, analizy konkurencji — infrastruktura AI dokłada złożoności i kosztów, ale nie daje proporcjonalnej wartości. Każdy produkt AI ma własny model rozliczeń, a całość staje się trudniejsza do przewidzenia kosztowo.
Dla takich zespołów Thunderbit oferuje znacznie prostszą ścieżkę: AI czyta stronę, automatycznie proponuje pola do ekstrakcji i dostarcza ustrukturyzowane dane w 2 kliknięciach. Eksportujesz do Excel, Google Sheets, Airtable albo Notion. Bez MCP, bez chmurowej przeglądarki, bez rozliczeń za transfer. To nie jest proxy — to gotowy wynik bez całej infrastruktury.
Wyciągaj ustrukturyzowane dane z AI w 2 kliknięciach Get Started Free
Bright Data vs. Oxylabs vs. Smartproxy vs. Thunderbit: co wybrać?
Każda inna recenzja Bright Data, jaką znalazłem, pomija porównanie w uporządkowanej formie. Oto wersja, której sam bym oczekiwał — oparta na dopasowaniu do zastosowania, a nie na abstrakcyjnym rankingu:
| Funkcja | Bright Data | Oxylabs | Decodo (Smartproxy) | ScraperAPI | Thunderbit |
|---|---|---|---|---|---|
| Najlepsze dla | Enterprise’owa infrastruktura proxy | Enterprise proxy + scraping API | Proxy dla średniego rynku | Scraping oparty na API (dla devów) | No-code AI extraction |
| Residential IPs | 400M+ | 175M+ | 125M+ | N/A (usługa API) | N/A (browser-based) |
| Opcja no-code | Ograniczona (Scraper IDE) | Ograniczona (Web Scraper API) | Gotowe scrapery | Tylko API | Tak (rdzeń produktu) |
| Krzywa uczenia | Wysoka | Średnia–wysoka | Średnia | Niska | Bardzo niska |
| Darmowy plan | 7-dniowy trial (wymaga KYC) | 2K darmowych wyników | 7-dniowy trial | 1K kredytów/mies. za darmo | 6 darmowych stron/mies. |
| Cena startowa | ~$8/GB residential | ~$4/GB residential | ~$8.50/GB PAYG | $49/mies. | Darmowy plan + $38/mies. Pro |
| Główna zaleta | Największa pula IP, najszerszy zestaw | 99.95% skuteczności scraperów, OxyCopilot AI | Najprostszy UX dla mid-market | Najprostsza integracja API | AI scraping w 2 kliknięciach, darmowy eksport |
| Główne ograniczenie | Złożone, drogie, stroma krzywa uczenia | Słabszy unblocker (40–50%), wyższy próg wejścia | Brak wizualnego scrapera, braki enterprise | 0% skuteczności na social sites | To nie jest infrastruktura proxy |
Bright Data vs. Oxylabs
Obie platformy są enterprise’owe. Oxylabs deklaruje 175M+ residential IP wobec 400M+ Bright Data. Oxylabs bywa droższy w residential (~$4/GB przy wejściu z wolumenem, vs. $8 PAYG Bright Data), ale oferuje mocniejszą wydajność mobile proxy (90–98% vs. niespójne wyniki Bright Data). Bright Data wygrywa zakresem produktu; Oxylabs — bardziej skupioną realizacją i prostszym UX. Jeśli potrzebujesz zarówno proxy, jak i API do scrapingu, Oxylabs Web Scraper API osiąga średnio 99.95% skuteczności — choć z wolniejszym czasem odpowiedzi (~17.5s).
Bright Data vs. Smartproxy (Decodo)
Decodo (po rebrandingu z Smartproxy w kwietniu 2025) to prostsza i tańsza opcja dla zespołów średniego rynku. G2 4.6/5 przy 546 opiniach — bardzo mocny sygnał. Start od $8.50/GB PAYG, ale ceny wolumenowe są konkurencyjne ($1.50/GB przy enterprise 1 TB). Prostszy dashboard, szybszy onboarding (3-dniowy trial vs. proces KYC Bright Data). Dla zespołów, które chcą solidnych proxy bez przedzierania się przez labirynt produktów Bright Data, Decodo jest warte poważnego rozważenia.
Kiedy no-code AI scraper, taki jak Thunderbit, ma większy sens
Wszystko sprowadza się do jednego pytania: potrzebujesz infrastruktury proxy, czy danych?
Większość osób czytających tę recenzję — handlowcy, managerowie operacyjni, researcherzy rynku, analitycy e-commerce — potrzebuje danych. Nie puli IP. Nie zarządzania transferem. Nie algorytmów rotacji proxy.
Danych.
Oto porównanie workflow przy wyciąganiu 100 listingów produktów:
| Krok | Bright Data (ścieżka techniczna) | Thunderbit |
|---|---|---|
| Setup | Załóż konto, dodaj płatność, przejdź przez panel, ukończ KYC | Zainstaluj rozszerzenie Chrome |
| Konfiguracja | Wybierz produkt (Unlocker? Browser? Scraper?), sprawdź, co pasuje | Wejdź na docelową stronę |
| Budowa | Napisz scraper albo wybierz szablon, skonfiguruj selektory | Kliknij AI Suggest Fields |
| Uruchomienie | Odpal, debuguj błędy, popraw selektory | Kliknij Scrape |
| Eksport | Pobierz CSV/JSON | Kliknij Export → Sheets/Excel/Airtable/Notion |
| Czas | 1–2 godziny (dla doświadczonego deva) | ~5 minut (dla każdego) |
| Koszt | ~$1–5 za API + czas dev | Darmowy plan lub $38/mies. Pro |
Zbudowaliśmy Thunderbit właśnie po to, by wypełnić tę lukę. AI czyta strukturę strony, sugeruje odpowiednie kolumny, obsługuje paginację i podstrony oraz eksportuje dane — bez konieczności myślenia o proxy, nagłówkach czy retry logic. To nie jest zamiennik enterprise’owej infrastruktury Bright Data. To zamiennik całej kategorii problemów, które każą Ci myśleć, że potrzebujesz enterprise’owej infrastruktury.
Pobieraj ustrukturyzowane dane ze stron w 2 kliknięciach Get Started Free
Jak podjąć decyzję: prosty framework
| Twoja sytuacja | Najlepszy wybór | Dlaczego | |---|---|---|---| | Potrzebujesz ogromnej infrastruktury proxy do własnych pipeline’ów | Bright Data lub Oxylabs | Największe pule IP, enterprise SLAs, rygor compliance | | Chcesz niezawodnych proxy dla średniego rynku bez enterprise’owej złożoności | Decodo (Smartproxy) | Prostszy UX, uczciwe ceny, 125M+ IP | | Budujesz AI/LLM data pipeline z web feedami w czasie rzeczywistym | Narzędzia AI Bright Data | Browser.AI, MCP Server, marketplace datasetów | | Potrzebujesz ustrukturyzowanych danych ze stron — bez kodu i bez zarządzania proxy | Thunderbit | AI scraping w 2 kliknięciach, darmowy eksport, zero infrastruktury | | Jesteś deweloperem i chcesz jedno wywołanie API do scrapingu | ScraperAPI | Najprostsza integracja API, darmowy plan | | Jednorazowy szybki scraping dla pojedynczego projektu | Darmowy plan Thunderbit lub darmowy plan ScraperAPI | Bez zobowiązań, natychmiastowe wyniki |
Właściwe narzędzie zależy od technicznych możliwości Twojego zespołu, budżetu i tego, co faktycznie robisz z danymi. Zasilasz hurtownię danych, która napędza modele ML? Infrastruktura Bright Data ma sens. Zapełniasz arkusz sprzedażowy? Już nie.
Krótka uwaga o zgodności i etycznym pozyskiwaniu danych
Bright Data traktuje compliance bardzo poważnie — bardziej niż jakikolwiek konkurent. To jednocześnie przewaga i źródło tarcia.
Certyfikaty: SOC 2 Type II (publicznie dostępny SOC 3), ISO 27001:2022 (plus 27017 i 27018), CSA STAR Level 1. Infrastruktura na AWS multi-AZ, TLS 1.3 w transmisji, AES-256 w spoczynku. Na whitelistach Microsoft Defender, Avast, AVG, McAfee i AppEsteem.
Etyczne źródło IP: Residential IP pochodzą z Bright SDK zintegrowanego w aplikacjach partnerów. Użytkownicy wyrażają zgodę przez jasny ekran consent na udostępnianie nieużywanego transferu w zamian za doświadczenie bez reklam lub wersję premium. To wyraźna poprawa względem pierwotnego modelu Hola VPN (2014–2015), gdzie użytkownicy nie byli należycie poinformowani.
Dwa przełomowe zwycięstwa prawne z 2024 roku, które warto znać:
- Meta v. Bright Data (styczeń 2024): sąd uznał, że regulaminy Facebooka/Instagrama nie blokują scrapingu publicznych danych po wylogowaniu.
- X Corp. v. Bright Data (maj 2024): sprawa została oddalona. Sędzia Alsup ostrzegł, że oddanie mediom społecznościowym kontroli nad publicznymi danymi „grozi stworzeniem monopolii informacyjnych”.
Cena tego podejścia: proces KYC jest dokładny, ale wprowadza realne tarcie onboardingowe. Ukończyć go mogą tylko zarejestrowane firmy. Freelancerzy muszą odbyć wideorozmowę po angielsku. Akceptacja trwa od 48 godzin do 3 tygodni. Dla zespołów, które potrzebują danych dziś, a nie w przyszłym tygodniu, to znacząca bariera.
Thunderbit również skupia się na legalnych zastosowaniach biznesowych — scrapowaniu publicznie dostępnych danych dla sprzedaży, e-commerce i researchu — bez wymagania weryfikacji KYC czy przesyłania dokumentów tożsamości.
Czy Bright Data jest warte swojej ceny w 2026 roku? Szczery werdykt
Bright Data ma największą pulę IP (400M+), najszerszą ofertę produktową, najbardziej rygorystyczny program compliance i dwa przełomowe zwycięstwa prawne potwierdzające jego prawo do działania. Żaden konkurent nie ma takiego połączenia. Dla enterprise’owych zespołów z zasobami technicznymi, pięciocyfrowym miesięcznym budżetem i złożonymi potrzebami infrastruktury scrapingu to domyślny wybór nie bez powodu.
Ale „największy zestaw narzędzi” i „najlepszy dla Ciebie” to dwa różne pytania.
Bright Data ma sens, jeśli:
- potrzebujesz ogromnej infrastruktury proxy z geo-targetowaniem na poziomie miast w 195 krajach
- masz dedykowany zespół techniczny do obsługi konfiguracji proxy, retry logic i utrzymania scraperów
- Twój budżet pozwala na minimalne zobowiązania od $500+/mies.
- budujesz pipeline’y danych dla AI/LLM, które wymagają web data feedów w czasie rzeczywistym
Bright Data raczej nie ma sensu, jeśli:
- jesteś małym lub średnim zespołem i potrzebujesz ustrukturyzowanych danych ze stron
- nie masz programistów, którzy mogą zarządzać proxy i debugować błędy
- Twoimi głównymi kryteriami są łatwość użycia i opłacalność
- wolisz poświęcić 5 minut na zdobycie danych niż 5 godzin na konfigurację infrastruktury
Dla zespołów sprzedaży, operacji i researchu, które chcą najszybszej drogi ze strony do arkusza, Thunderbit idzie zupełnie inną drogą.
Ekstrakcja wspierana przez AI w 2 kliknięciach. Darmowy eksport do Excel, Google Sheets, Airtable lub Notion. Bez KYC, bez konfiguracji proxy, bez opłat za transfer.
Po prostu dane.
Możesz już teraz wypróbować darmowy plan Thunderbit — 6 darmowych stron miesięcznie, bez karty kredytowej. Sprawdź, czy prostsze podejście da Ci to, czego potrzebujesz, zanim zwiążesz się enterprise’ową infrastrukturą proxy.
Wypróbuj AI Web Scraper Get Started Free
FAQ
Czy Bright Data jest warte swojej ceny do web scrapingu?
Tak — dla dużych operacji enterprise, które potrzebują 400M+ IP, geo-targetowania na poziomie miast i infrastruktury klasy compliance. Bright Data oferuje możliwości, których żaden konkurent nie odwzorowuje w pełni. Jeśli jednak Twoim celem jest po prostu pobranie danych ze stron bez zarządzania infrastrukturą proxy, odpowiedź brzmi: nie. Prostsze i tańsze alternatywy, takie jak Thunderbit, ScraperAPI czy nawet budżetowi dostawcy proxy jak IPRoyal, dostarczają końcowy rezultat za ułamek kosztu i złożoności.
Czy Bright Data jest legalne i bezpieczne w użyciu?
Tak. Bright Data to dobrze ugruntowana firma z certyfikacją SOC 2 Type II, zgodnością z ISO 27001, 20,000+ klientów, w tym firmami z listy Fortune 500, oraz dwoma przełomowymi zwycięstwami sądowymi (Meta v. Bright Data, X Corp. v. Bright Data), które potwierdziły legalność pozyskiwania publicznych danych webowych. Proces KYC istnieje właśnie po to, by zapewnić legalne wykorzystanie — jest dokładny, ale wprowadza tarcie onboardingowe.
Czy Bright Data nalicza opłaty za nieudane żądania?
To zależy od produktu. Web Unlocker domyślnie rozlicza wyłącznie sukcesy — ale jeśli włączysz funkcje custom (ręczne nagłówki, cookies lub elementy „expect”), wszystkie żądania są naliczane niezależnie od wyniku. Scraping Browser rozlicza transfer GB, w tym transfer z nieudanych prób. SERP API nie nalicza opłat za nieudane żądania.
To właśnie ten niuans rozliczeń jest jednym z najczęstszych powodów skarg użytkowników — i czymś, czego Bright Data nie wyjaśnia wystarczająco jasno podczas rejestracji.
Jaki jest najtańszy typ proxy Bright Data?
Współdzielone proxy z puli datacenter za $0.60/GB — odpowiednie dla stron bez silnej ochrony, takich jak serwisy informacyjne, publiczne katalogi i dane rządowe. Dla stron chronionych residential proxy zaczynają się od $8.00/GB PAYG ($4.00/GB przy aktualnym kodzie promocyjnym, ważnym przez 3 miesiące). Dedykowane datacenter IP zaczynają się od $0.90/IP/miesiąc i zawierają 100 GB w ramach fair use.
Jaka jest najlepsza alternatywa Bright Data dla zespołów nietechnicznych?
Thunderbit — rozszerzenie Chrome z AI, które w 2 kliknięciach wyciąga ustrukturyzowane dane z dowolnej strony. Klikasz „AI Suggest Fields”, a AI czyta stronę i proponuje kolumny. Klikasz „Scrape”, a dane pojawiają się w tabeli. Darmowy eksport do Excel, Google Sheets, Airtable lub Notion. Bez zarządzania proxy, bez kodowania, bez KYC. Darmowy plan daje 6 stron miesięcznie do przetestowania, a plan Pro zaczyna się od $38/mies. — to ułamek minimalnego zobowiązania Bright Data.
Dowiedz się więcej



