
Jeśli porównujesz rozwiązania do web scrapingu w 2026 roku, prawdziwe pytanie zwykle nie brzmi: „który produkt ma najwięcej funkcji?”, tylko: „które narzędzie najszybciej doprowadzi mój zespół od chaotycznej strony WWW do danych, z których da się korzystać, bez zbędnych tarć?”
To rozróżnienie pojawia się bardzo szybko, gdy spojrzysz na realne zadania. Zespoły sprzedaży i operacji najczęściej potrzebują ekstrakcji z poziomu przeglądarki i prostego eksportu. Analitycy chcą powtarzalnych procesów no-code. Zespoły techniczne bardziej zwracają uwagę na API, obsługę anty-botów i to, czy samodzielnie muszą utrzymywać całą infrastrukturę crawlerską.
To edycja 2026 naszego corocznego zestawienia, zawężona z szerszej listy 15 narzędzi, którą przygotowaliśmy w 2025 roku. W sierpniu 2026 ponownie sprawdziłem oficjalne strony produktów, sygnały cenowe i aktualne pozycjonowanie poniższych rozwiązań, a następnie zostawiłem tylko te dziesięć opcji, które nadal mają sens w rzeczywistych procesach biznesowych i deweloperskich.
Szybki wybór według rodzaju pracy
- Potrzebujesz najszybszej drogi od strony WWW do arkusza? Zacznij od Thunderbit.
- Potrzebujesz cyklicznego monitoringu no-code albo uruchomień w chmurze? Warto rozważyć Browse AI, Octoparse i ParseHub.
- Potrzebujesz elastycznej platformy albo infrastruktury do scrapingu? Przyjrzyj się Apify, Bright Data, Oxylabs i ScrapingBee.
- Potrzebujesz pełnej kontroli nad kodem? Scrapy i Playwright powinny znaleźć się na szczycie listy deweloperskiej.
Wypróbuj scraper WWW na żywej stronie Bez konfiguracji i bez selektorów — wskaż stronę AI i jednym kliknięciem otrzymaj uporządkowaną tabelę. Get Started Free
Dlaczego rozwiązania do web scrapingu wciąż są ważne dla firm
Większość zespołów nie potrzebuje „web scrapingu” jako technicznego hobby. Potrzebują ustrukturyzowanych danych z publicznych stron do generowania leadów, monitorowania cen, badań rynku, rekrutacji, operacji contentowych albo śledzenia konkurencji. Problem w tym, że surowe dane ze stron nadal często występują w formatach, których ręczne ponowne wykorzystanie jest bardzo czasochłonne.
Dlatego najlepsze narzędzia konkurują dziś dopasowaniem do procesu, a nie tylko samą mocą ekstrakcji. Liczy się to, czy narzędzie radzi sobie z paginacją, podstronami i dynamicznymi stronami, czy eksportuje dane bezpośrednio do Sheets lub systemów wewnętrznych oraz ile pracy zespół musi włożyć w utrzymanie rozwiązania po wdrożeniu.
Jeśli chcesz szybko zobaczyć, jak wygląda proces ekstrakcji z poziomu przeglądarki na rzeczywistej stronie wyników, ten aktualny materiał wideo o Browse AI będzie dobrym punktem odniesienia:
Jak wybraliśmy najlepsze rozwiązania do web scrapingu
To coroczna lista najlepszych narzędzi, a nie katalog wszystkich produktów, które nadal mają stronę główną. Priorytetowo potraktowałem rozwiązania, które w 2026 roku nadal pokazują realny rozwój produktu i pasują przynajmniej do jednego z czterech modeli pracy:
- Scraping biznesowy z AI na pierwszym miejscu: najszybsza konfiguracja, najmniej tarć, wynik gotowy do arkusza.
- Powtarzalny scraping no-code: wizualne workflow, harmonogramy i bardziej precyzyjna kontrola ekstrakcji.
- Skalowanie platformy i API: wykonywanie w chmurze, infrastruktura do omijania blokad i dostęp programistyczny.
- Pipeline’y utrzymywane przez deweloperów: frameworki open source i biblioteki do automatyzacji przeglądarki dla zespołów, które chcą pełnej kontroli.
Kryteria oceny były proste:
- Czas do pierwszego użytecznego scrapingu: jak szybko realny użytkownik może uzyskać dane do eksportu.
- Koszt utrzymania: czy rozwiązanie pozostaje praktyczne, gdy strony lub workflow się zmieniają.
- Skalowalność: czy produkt nadal ma sens po pierwszym udanym scrapingu.
- Przejrzystość cen: czy dostępny jest użyteczny darmowy plan, samoobsługowy poziom lub przynajmniej uczciwa oferta enterprise.
- Dopasowanie do zespołu: czy narzędzie faktycznie odpowiada modelowi pracy kupującego.
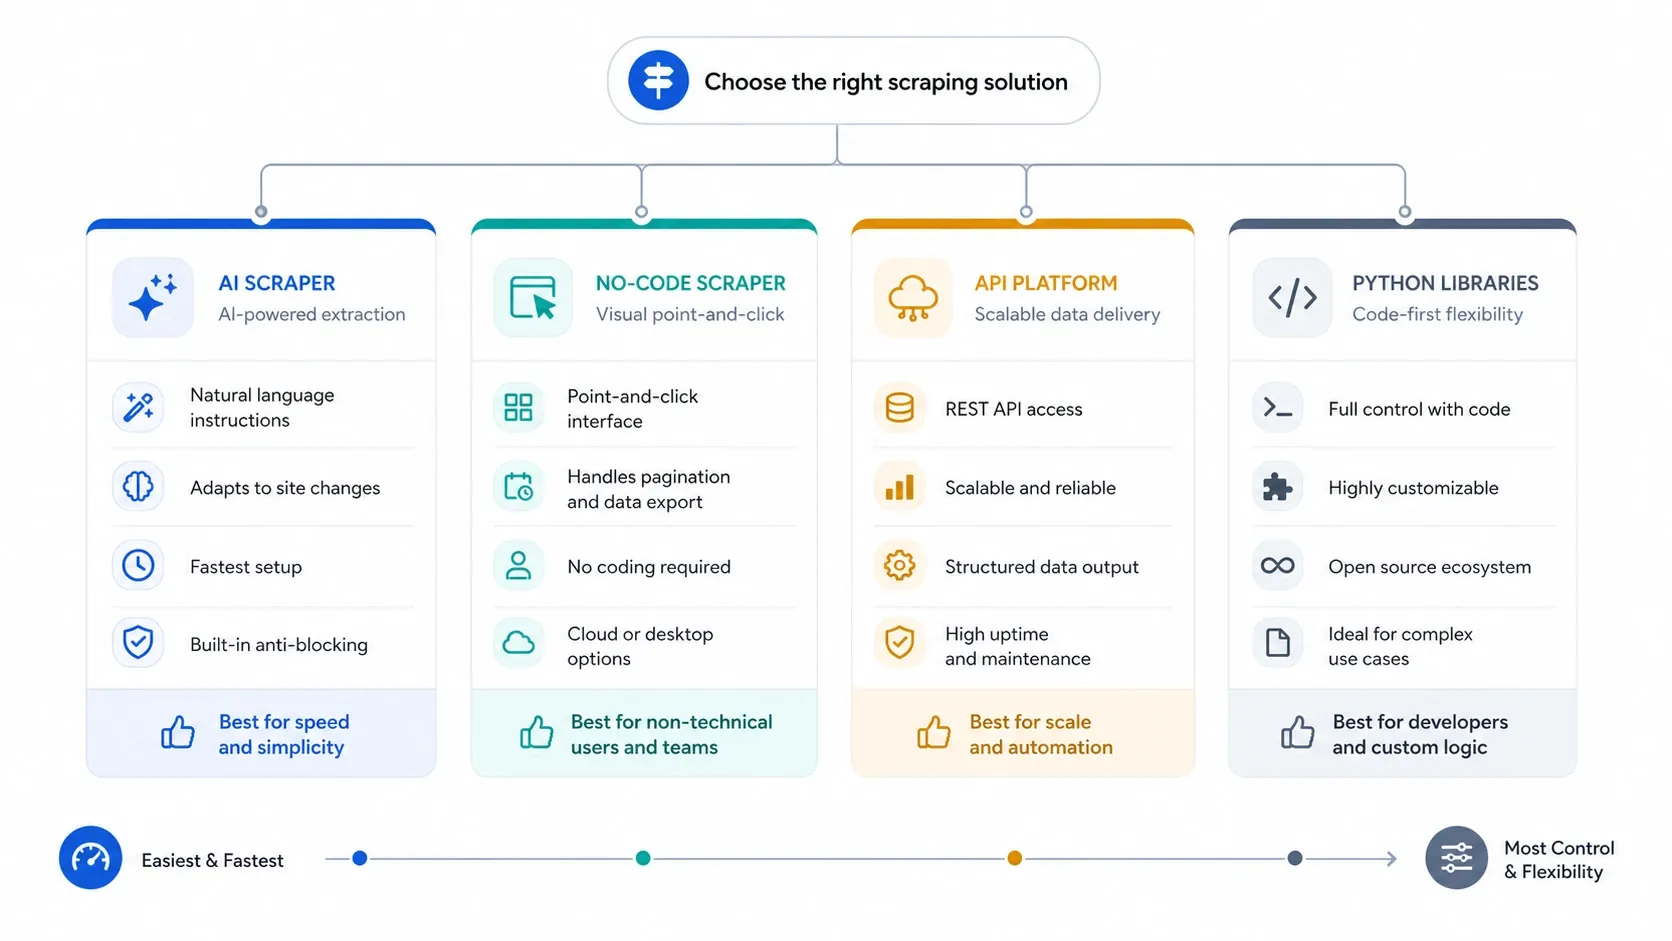
Tabela szybkiego porównania: najlepsze rozwiązania do web scrapingu w 2026 roku
Poniższe sygnały cenowe zostały sprawdzone w sierpniu 2026 na podstawie aktualnych oficjalnych stron produktów, cenników lub stron wsparcia.
| Narzędzie | Sygnał cenowy | Główny model | Najlepsze dla |
|---|---|---|---|
| Thunderbit | Darmowy plan; Starter od 15 USD/mies.; Pro od 38 USD/mies.; ceny biznesowe | AI web scraper i narzędzie do workflow w przeglądarce | Zespoły sprzedaży, operacji, e-commerce i badawcze, które chcą najszybszej konfiguracji |
| Browse AI | Darmowy plan; Personal od 19 USD/mies. przy rozliczeniu rocznym; Professional od 69 USD/mies. przy rozliczeniu rocznym; Premium od 500 USD/mies. przy rozliczeniu rocznym | Platforma robotów AI bez kodu | Monitoring, wykrywanie zmian i cykliczny scraping biznesowy |
| Octoparse | Darmowy plan; Standard od 69 USD/mies.; Professional od 249 USD/mies. | Wizualny scraper no-code z uruchomieniami w chmurze | Analitycy i operacje realizujące większe, cykliczne zadania |
| ParseHub | Darmowy plan; płatne plany od 189 USD/mies. | Desktopowy wizualny scraper dla dynamicznych stron | Użytkownicy, którzy chcą większej kontroli bez pisania kodu |
| Apify | Darmowy plan; Starter od 29 USD/mies.; Scale od 199 USD/mies.; Business od 999 USD/mies. | Chmurowa platforma actorów i infrastruktura do scrapingu | Zespoły hybrydowe potrzebujące gotowych narzędzi i własnych workflow |
| Bright Data | Ceny oparte na użyciu i produktach w obszarze scraper API, proxy i produktów danych | Enterprise’owy stack do zbierania danych | Programy pozyskiwania danych z publicznego internetu na dużą skalę, z uwzględnieniem zgodności |
| Oxylabs | Web Scraper API od 49 USD/mies.; szersze ceny proxy i unblockera różnią się w zależności od produktu | Infrastruktura proxy i API do scrapingu | Zespoły kupujące niezawodność i możliwość omijania blokad jako element infrastruktury |
| ScrapingBee | Freelance od 49 USD/mies.; Startup od 99 USD/mies.; Business od 249 USD/mies. | API do scrapingu z naciskiem na renderowanie stron | Deweloperzy scrapujący mocno oparte na JavaScript strony bez utrzymywania własnej floty przeglądarek |
| Scrapy | Darmowe i open source | Framework do crawlowania w Pythonie | Zespoły deweloperskie budujące własne pipeline’y scrapingu |
| Playwright | Darmowe i open source | Nowoczesna biblioteka do automatyzacji przeglądarki | Zespoły, które chcą sterowania przeglądarką w Chromium, Firefox i WebKit za pomocą kodu |
10 najlepszych rozwiązań do web scrapingu w 2026 roku
1. Thunderbit
Thunderbit to najmocniejszy punkt startowy, gdy zadanie zaczyna się od: „potrzebuję tych danych w arkuszu jeszcze dziś”. Kierunek produktu opiera się na sugestiach pól z AI, wzbogacaniu danych z podstron i eksporcie, który ma sens dla użytkowników biznesowych, a nie tylko dla twórców scraperów.
- Najlepsze dla: sprzedaży, operacji, e-commerce, nieruchomości i procesów badawczych opartych na przeglądarce.
- Co robi dobrze: automatycznie podpowiada pola, obsługuje paginację i podstrony oraz szybko eksportuje do Sheets, Excel, Airtable, Notion, CSV i JSON.
- Dlaczego trafił na listę: nadal oferuje najkrótszą drogę od publicznej strony do ustrukturyzowanego wyniku dla osób nietechnicznych.
- Sygnał cenowy: darmowy plan, Starter od 15 USD/mies., Pro od 38 USD/mies. oraz ceny biznesowe.
Wypróbuj Thunderbit AI Web Scraper za darmo Scrapuj dowolną stronę w 1 kliknięciu, a potem eksportuj dane do Sheets, Excel, Airtable lub Notion. Get Started Free
2. Browse AI
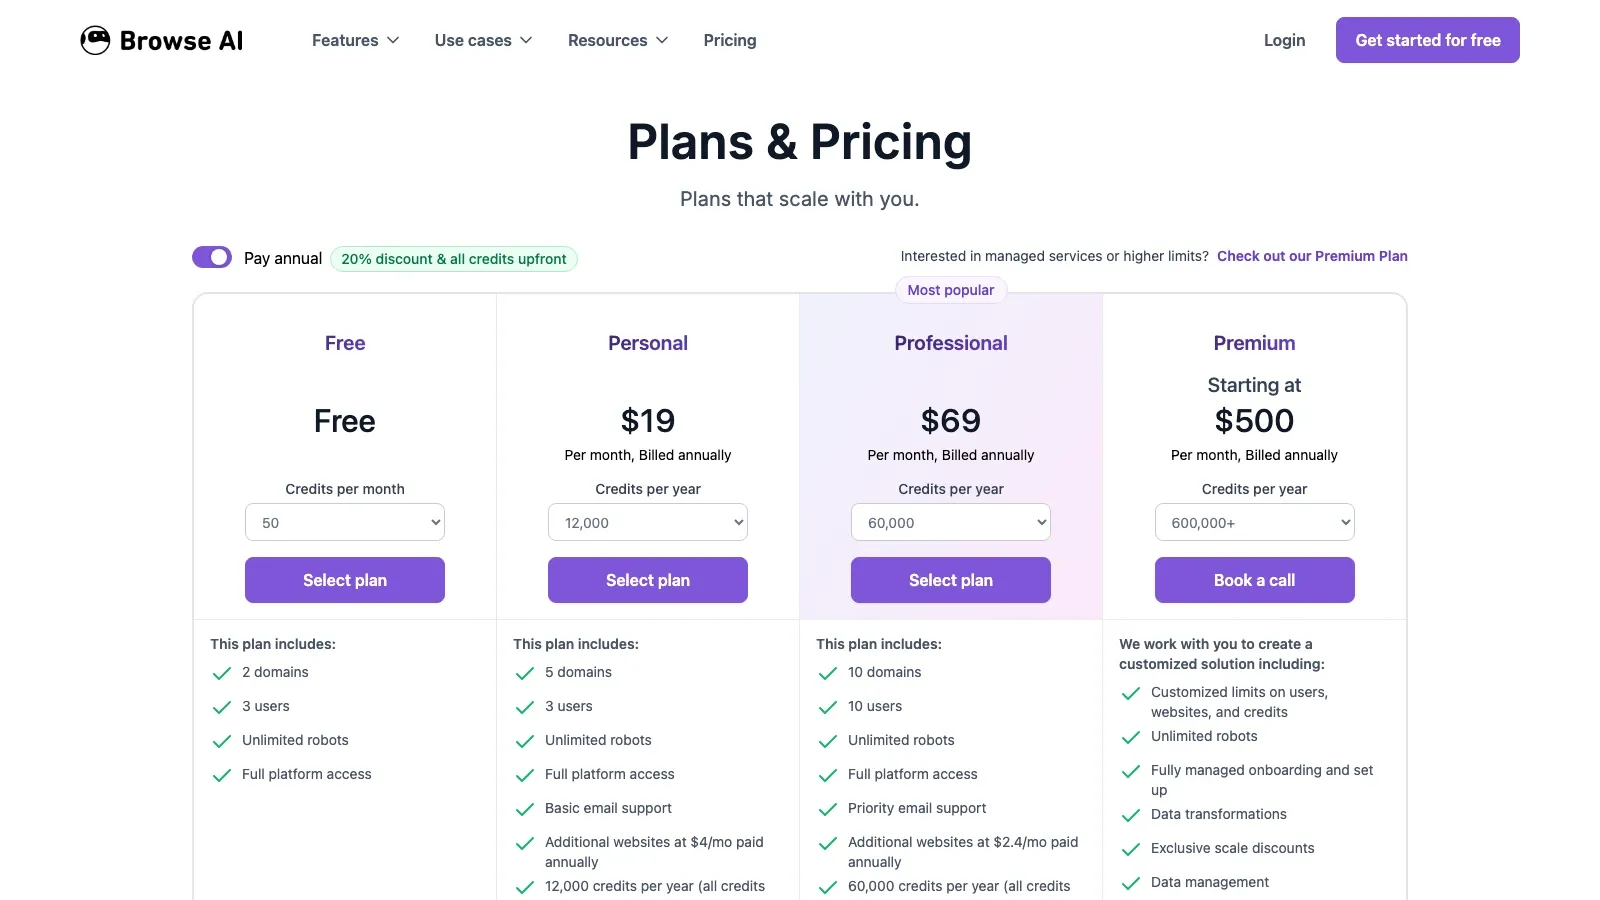
Browse AI pozostaje jedną z najbardziej wiarygodnych alternatyw no-code dla zespołów, które chcą powtarzalnych robotów, monitoringu i wyników przyjaznych dla arkuszy bez pisania kodu. Obecne pozycjonowanie jest najsilniejsze tam, gdzie scraping i wykrywanie zmian są równie ważne.
- Najlepsze dla: monitorowania konkurencji, śledzenia cen, scrapingu katalogów i cyklicznego wykrywania zmian.
- Co robi dobrze: nagrywanie robotów, powtarzalny monitoring, ekstrakcję przypominającą pracę przeglądarki i obsługę stron premium.
- Dlaczego trafił na listę: nadal jest jednym z najczytelniejszych wyborów no-code, gdy workflow jest ciągły, a nie jednorazowy.
- Sygnał cenowy: darmowy plan, Personal od 19 USD/mies. przy rozliczeniu rocznym, Professional od 69 USD/mies. przy rozliczeniu rocznym, Premium od 500 USD/mies. przy rozliczeniu rocznym.
3. Octoparse
Octoparse utrzymuje wysoką pozycję, ponieważ nadal jest jedną z najlepszych dróg rozwoju, gdy scraper przeglądarkowy „jednym kliknięciem” przestaje wystarczać. Oferuje bardziej rozbudowany kreator zadań, ekstrakcję w chmurze i wyższy poziom kontroli niż lżejsze narzędzia oparte na rozszerzeniach.
- Najlepsze dla: analityków, zespołów cenowych i operacji realizujących cykliczne zadania ekstrakcji na większą skalę.
- Co robi dobrze: wizualną konfigurację zadań, uruchomienia w chmurze, szablony, opcje antyblokowania i harmonogramy cykliczne.
- Dlaczego trafił na listę: nadal jest jednym z najczytelniejszych pomostów między prostym scrapingiem biznesowym a cięższą automatyzacją no-code.
- Sygnał cenowy: darmowy plan, Standard od 69 USD/mies., Professional od 249 USD/mies.
Jeśli chcesz porównać workflow oparty na kreatorze zadań z lżejszymi narzędziami AI-first, ten aktualny materiał o Octoparse jest najlepszym punktem pośrednim:
4. ParseHub
ParseHub nadal zasługuje na miejsce na liście dla użytkowników, którzy potrzebują większej kontroli nad dynamiczną nawigacją, ale nie są jeszcze gotowi utrzymywać własnej bazy kodu. Workflow jest cięższy niż w Thunderbit czy Browse AI, ale nadal przydaje się wtedy, gdy struktura strony wymaga bardziej precyzyjnej logiki sterowanej z desktopu.
- Najlepsze dla: użytkowników scrapujących interaktywne lub dynamiczne strony, którzy akceptują większy nakład konfiguracji.
- Co robi dobrze: budowanie przepływów w desktopie, obsługę AJAX, zagnieżdżoną nawigację i własną logikę ekstrakcji.
- Dlaczego trafił na listę: daje większą kontrolę niż lekkie narzędzia przeglądarkowe, bez konieczności wdrażania pełnego procesu inżynierskiego.
- Sygnał cenowy: darmowy plan; płatne plany od 189 USD/mies. według aktualnej oficjalnej dokumentacji wsparcia ParseHub.
Najlepsze narzędzia platformowe i API do pracy na dużą skalę
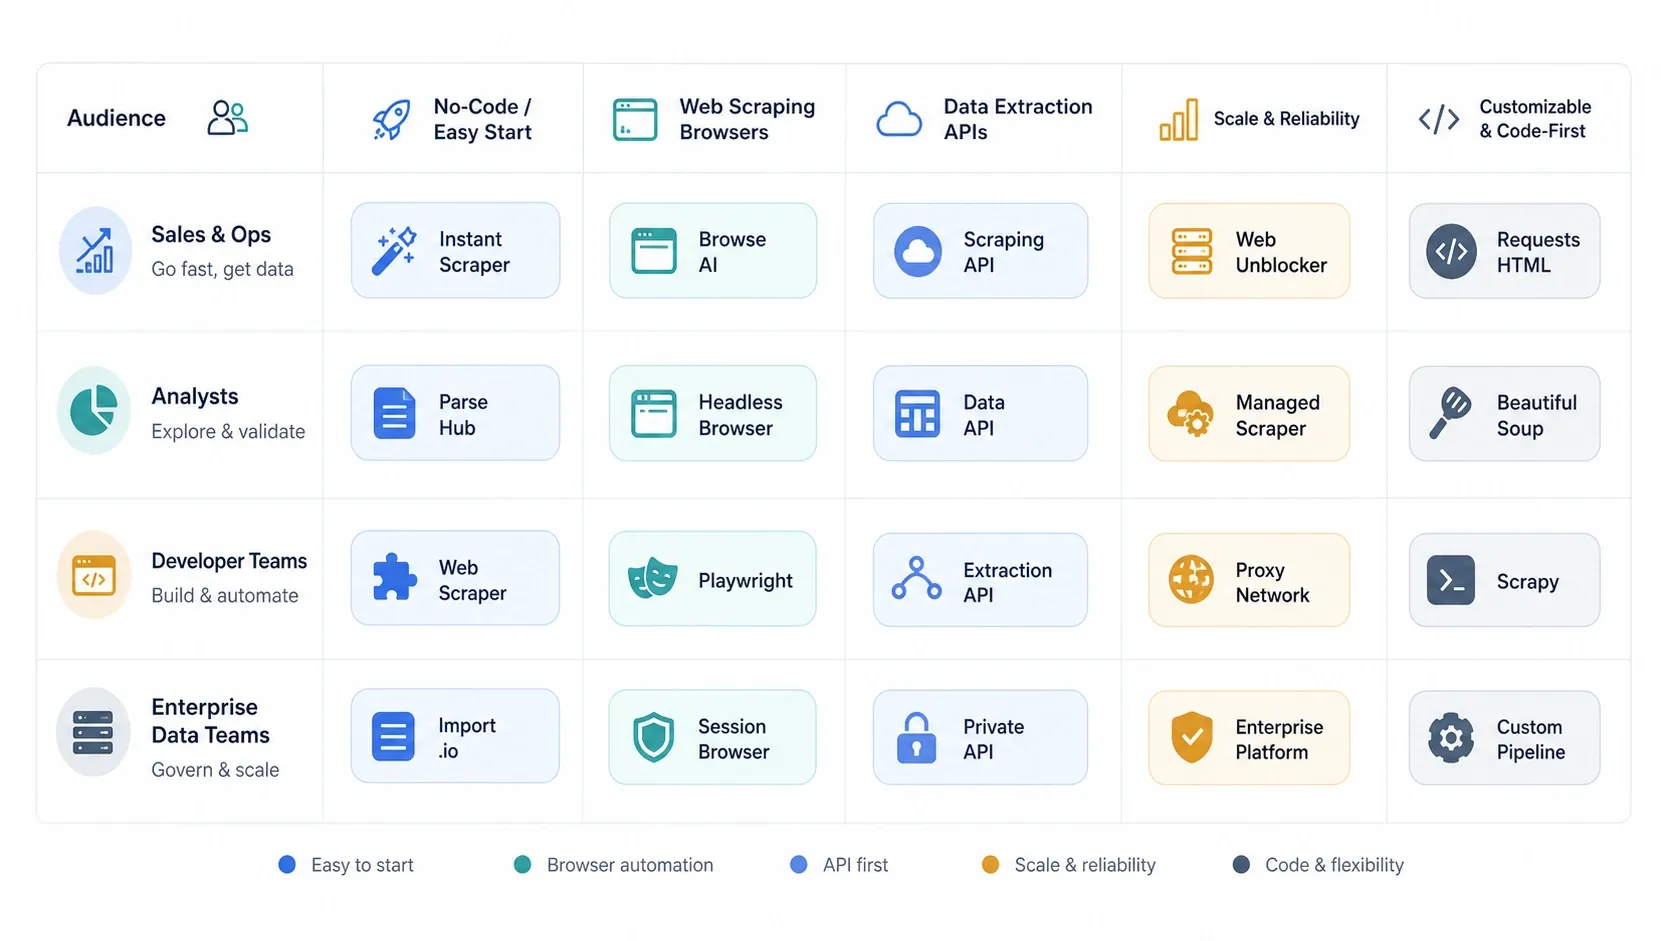
Gdy pytanie przestaje brzmieć „czy mogę zeskrobać tę stronę?” a zaczyna „czy mogę uruchamiać to niezawodnie na dużą skalę?”, lista najlepszych opcji się zmienia. Narzędzia platformowe mają większe znaczenie, gdy renderowanie, skuteczność omijania blokad, routing proxy lub workflow programistyczny stają się prawdziwym wąskim gardłem.
5. Apify
Apify jest najbardziej elastyczną platformą na tej liście, jeśli chcesz zarówno gotowych scraperów, jak i przestrzeni do budowania własnej automatyzacji w przyszłości. Marketplace actorów oraz własne środowisko uruchomieniowe dają mu znacznie większy zakres niż typowe rozszerzenie do przeglądarki.
- Najlepsze dla: zespołów hybrydowych, które chcą jednej platformy dla gotowych scraperów, API i własnych workflow.
- Co robi dobrze: marketplace actorów, uruchomienia w chmurze, dostęp do API, integracje i możliwość użycia własnego kodu.
- Dlaczego trafił na listę: lepiej niż większość konkurentów łączy scraping samoobsługowy z prawdziwą infrastrukturą.
- Sygnał cenowy: darmowy plan, Starter od 29 USD/mies., Scale od 199 USD/mies., Business od 999 USD/mies.
6. Bright Data
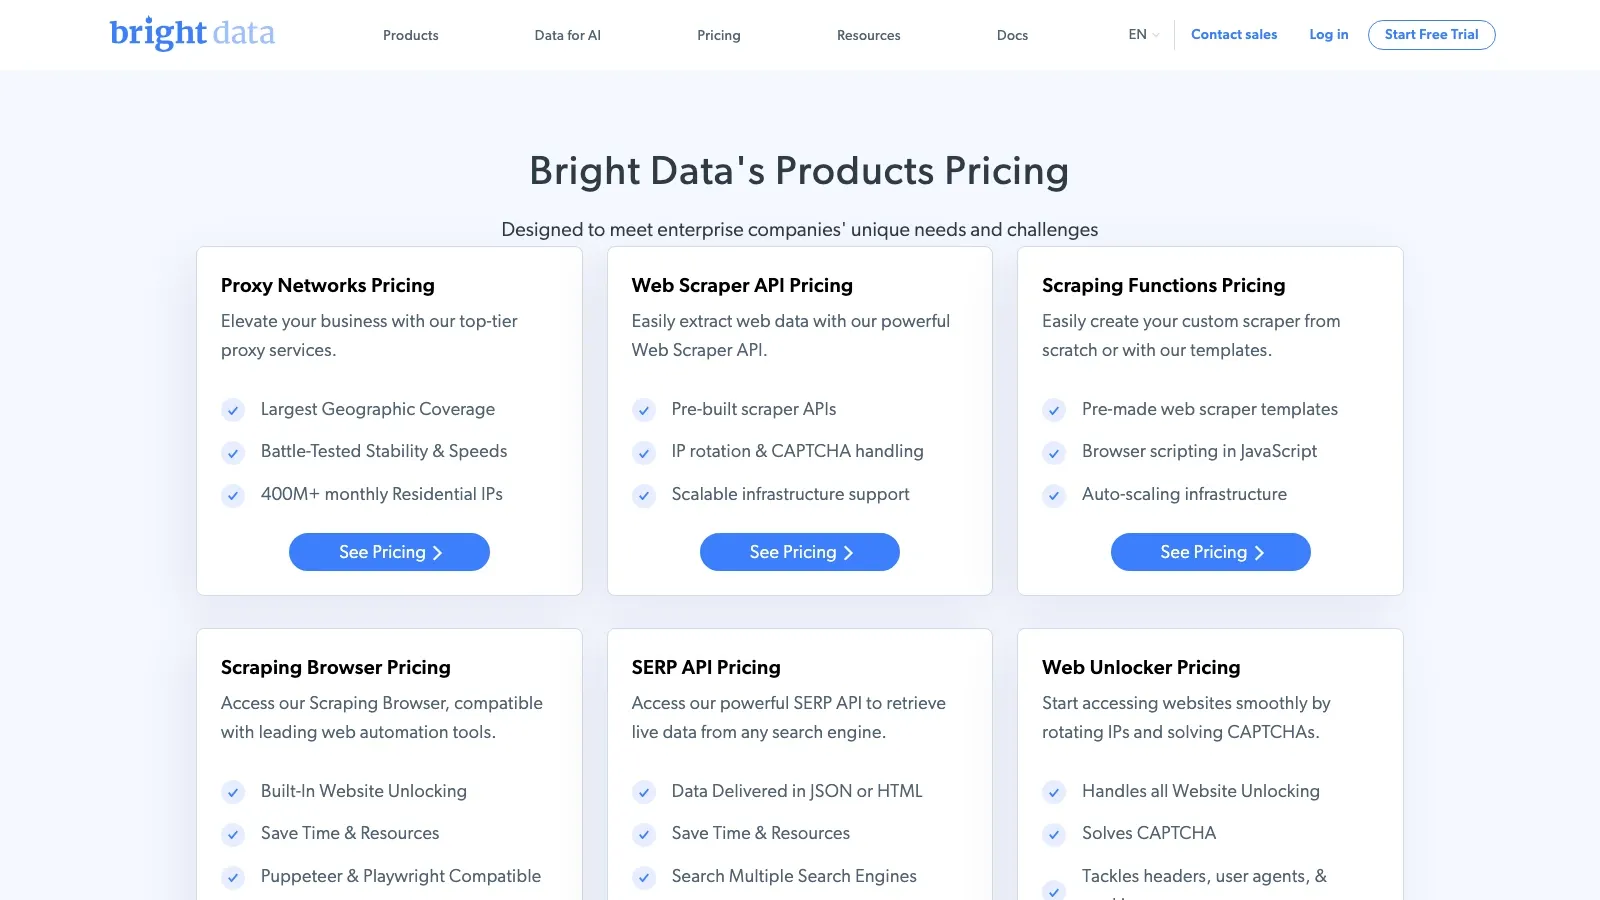
Bright Data jest dla zespołów, które nie kupują po prostu scrapera. Kupują możliwość omijania blokad, zasoby proxy, zarządzane opcje pozyskiwania danych i szeroki stack do zbierania danych, który poradzi sobie z trudniejszymi celami i większym wolumenem.
- Najlepsze dla: enterprise’owych programów zbierania danych, operacji na danych z publicznego internetu z uwzględnieniem zgodności oraz zespołów, które potrzebują czegoś więcej niż prosta aplikacja do scrapingu.
- Co robi dobrze: scraper API, sieci proxy, zarządzane zestawy danych, narzędzia do przeglądarek i głęboka infrastruktura.
- Dlaczego trafił na listę: nadal jest jednym z najmocniejszych wyborów, gdy niezawodność i skala są ważniejsze niż prostota.
- Sygnał cenowy: Bright Data stosuje model oparty na produktach i użyciu w obszarze scraper API, proxy i zarządzanych danych.
7. Oxylabs
Oxylabs pozostaje jednym z najbardziej oczywistych zakupów infrastrukturalnych dla zespołów, które chcą niezawodnego zbierania danych z publicznego internetu bez samodzielnego składania całego stosu do omijania blokad i proxy. Linia produktów jest szczególnie mocna w monitoringu cen, badaniach rynku i stałych programach danych.
- Najlepsze dla: zespołów kupujących scraping jako infrastrukturę, a nie jako narzędzie „kliknij i gotowe”.
- Co robi dobrze: Web Scraper API, Web Unblocker, produkty proxy i proces zakupowy przyjazny enterprise.
- Dlaczego trafił na listę: nadal jest jednym z najbardziej wiarygodnych wyborów, gdy kupującemu zależy bardziej na niezawodności i wsparciu niż na minimalnym progu wejścia.
- Sygnał cenowy: Web Scraper API od 49 USD/mies.; ceny innych produktów proxy i unblockerów zależą od produktu i sposobu użycia.
8. ScrapingBee
ScrapingBee dobrze sprawdza się wtedy, gdy prawdziwe oczekiwanie brzmi: „wyrenderuj stronę, rotuj proxy i pozwól mojemu zespołowi skupić się na parsowaniu”. Jest węższy niż szeroka platforma w stylu Apify, ale właśnie to ukierunkowanie sprawia, że wiele zespołów inżynierskich go ceni.
- Najlepsze dla: deweloperów scrapujących strony mocno oparte na JavaScript, którzy nie chcą utrzymywać własnej floty przeglądarek.
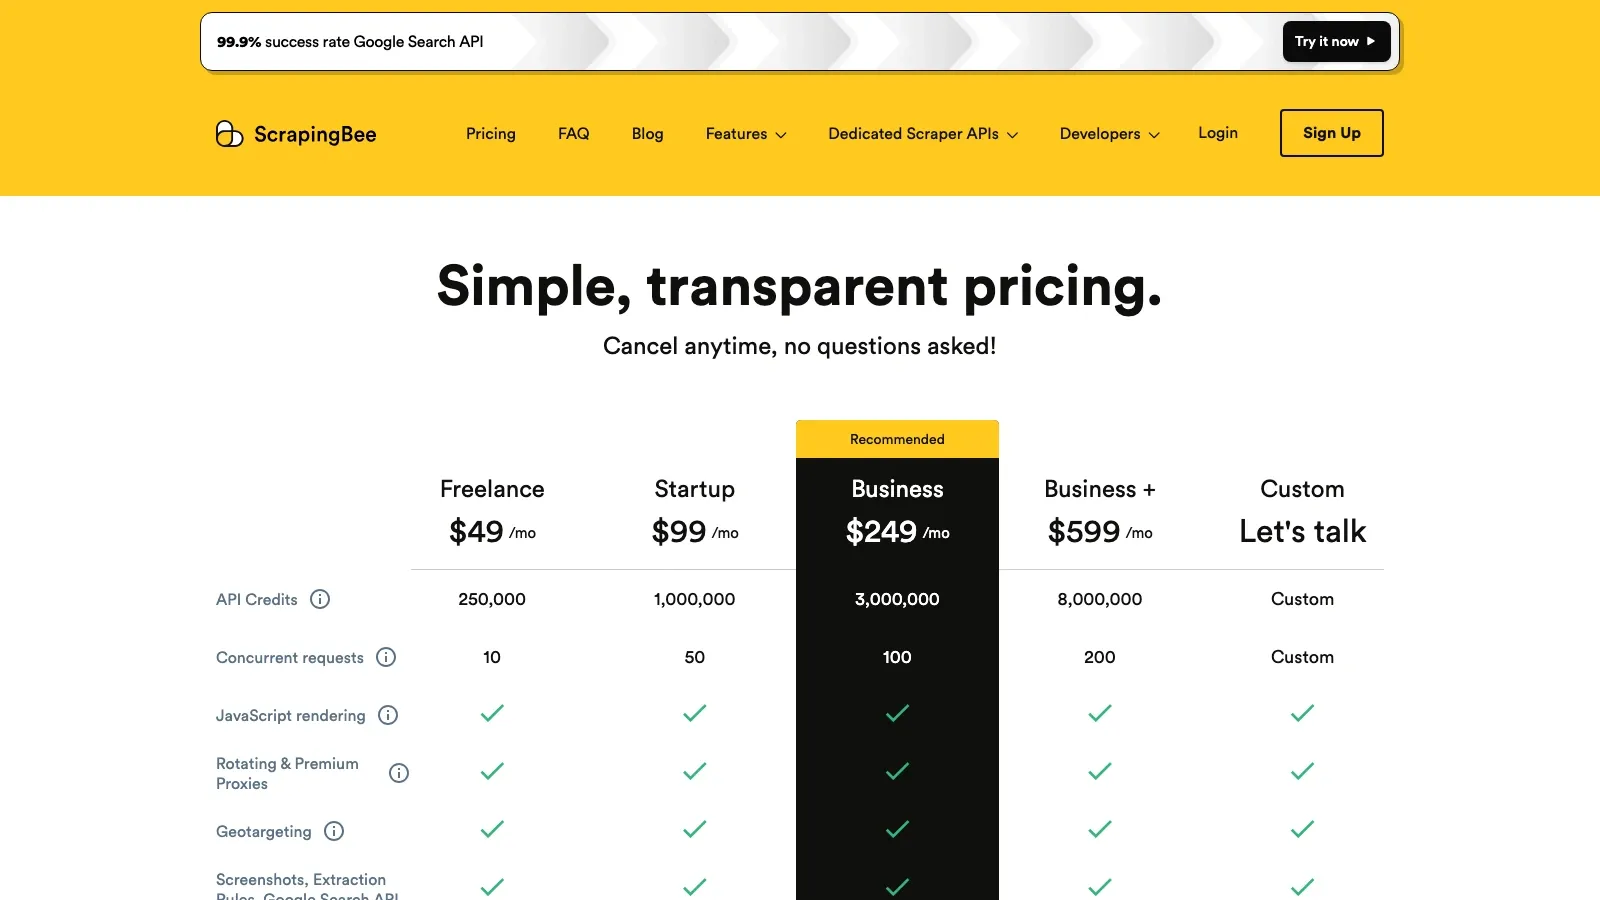
- Co robi dobrze: renderowanie headless, rotację proxy, geotargetowanie i prostszy workflow oparty na API.
- Dlaczego trafił na listę: przejmuje najtrudniejsze problemy infrastruktury przeglądarkowej bez wymuszania pełnego wdrożenia platformy.
- Sygnał cenowy: Freelance od 49 USD/mies., Startup od 99 USD/mies., Business od 249 USD/mies.
Najlepsze frameworki dla zespołów, które chcą posiadać własny pipeline
9. Scrapy
Scrapy nadal jest najważniejszym frameworkiem open source do crawlowania wtedy, gdy zespół chce mieć pełną kontrolę nad pipeline’em. To nie jest najprostsza droga do pierwszego scrapingu, ale pozostaje jednym z najlepszych wyborów dla długowiecznych wewnętrznych systemów crawlowania.
- Najlepsze dla: zespołów Pythonowych budujących wewnętrzne crawlery lub produkcyjne pipeline’y danych.
- Co robi dobrze: crawlowanie o wysokiej wydajności, middleware, pipeline’y i dużą rozszerzalność.
- Dlaczego trafił na listę: nadal daje zespołom technicznym jeden z najlepszych stosunków możliwości do dojrzałości w segmencie open source.
- Sygnał cenowy: darmowe i open source.
10. Playwright
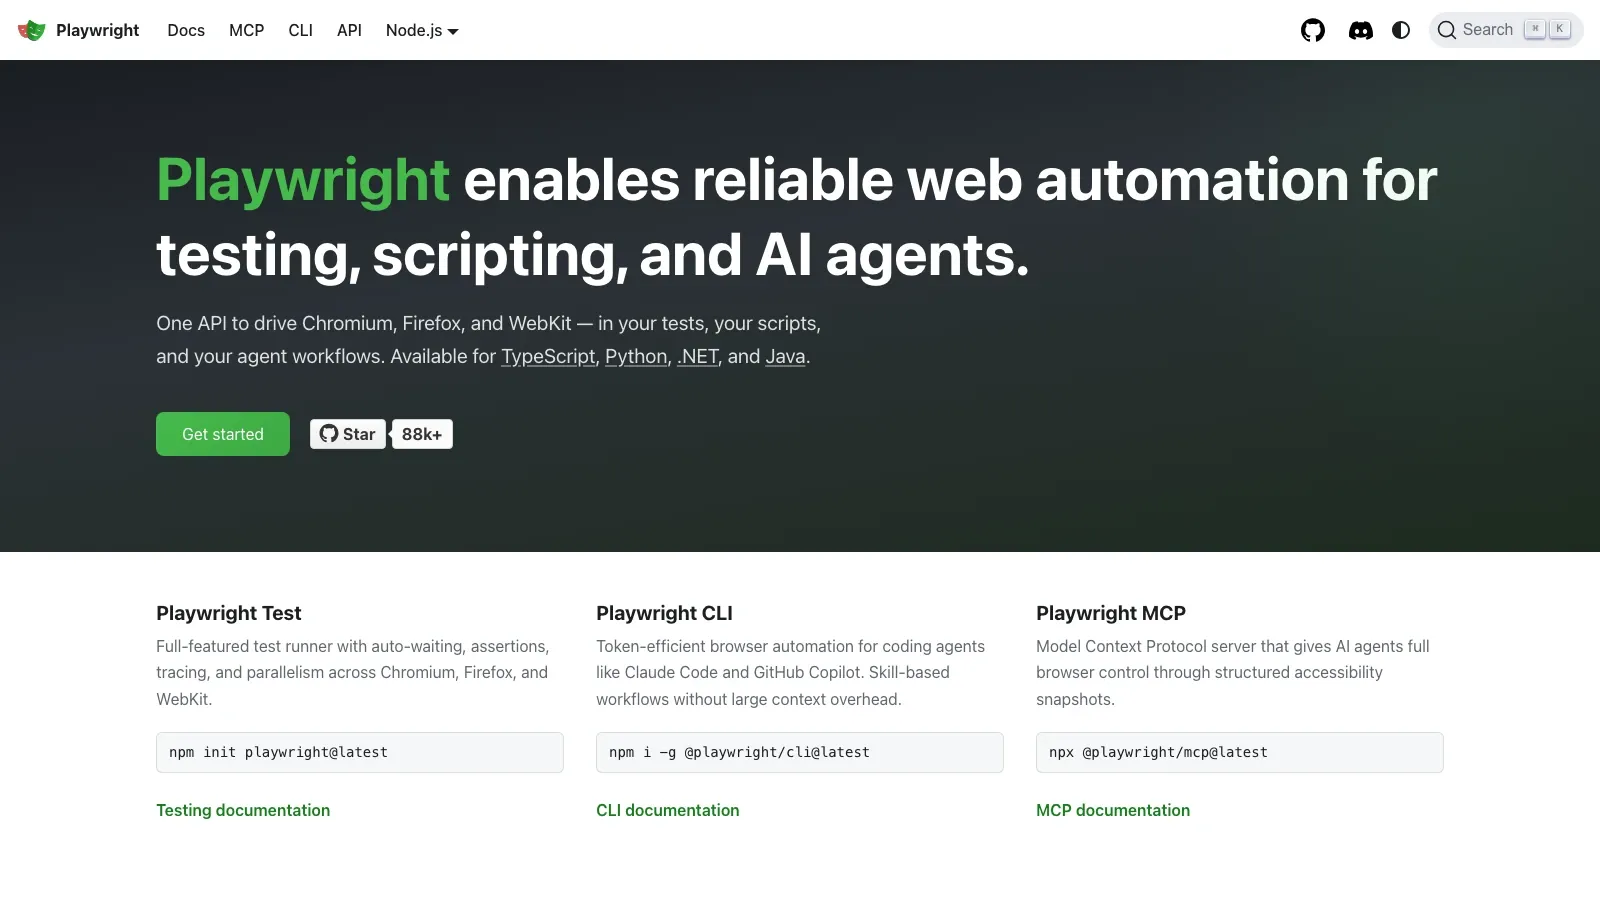
Playwright to mój domyślny wybór, gdy zespół chce nowoczesnej, skryptowej kontroli przeglądarki zamiast klasycznego frameworka crawlerskiego. Obecna oficjalna strona jasno to pokazuje: jedno API dla Chromium, Firefox i WebKit w testowaniu, skryptach i workflow opartych na agentach.
- Najlepsze dla: nowoczesnej automatyzacji przeglądarki, stron mocno opartych na JavaScript i zespołów, które cenią ergonomię pracy dewelopera.
- Co robi dobrze: niezawodne oczekiwanie na elementy, obsługę wielu przeglądarek i bogatą kontrolę automatyzacji w skryptowanych workflow.
- Dlaczego trafił na listę: często jest najczystszą opcją, gdy praca wymaga rzeczywistej interakcji z przeglądarką, a nie tylko crawlowania HTTP.
- Sygnał cenowy: darmowe i open source.
Moja lista polecana według typu zespołu
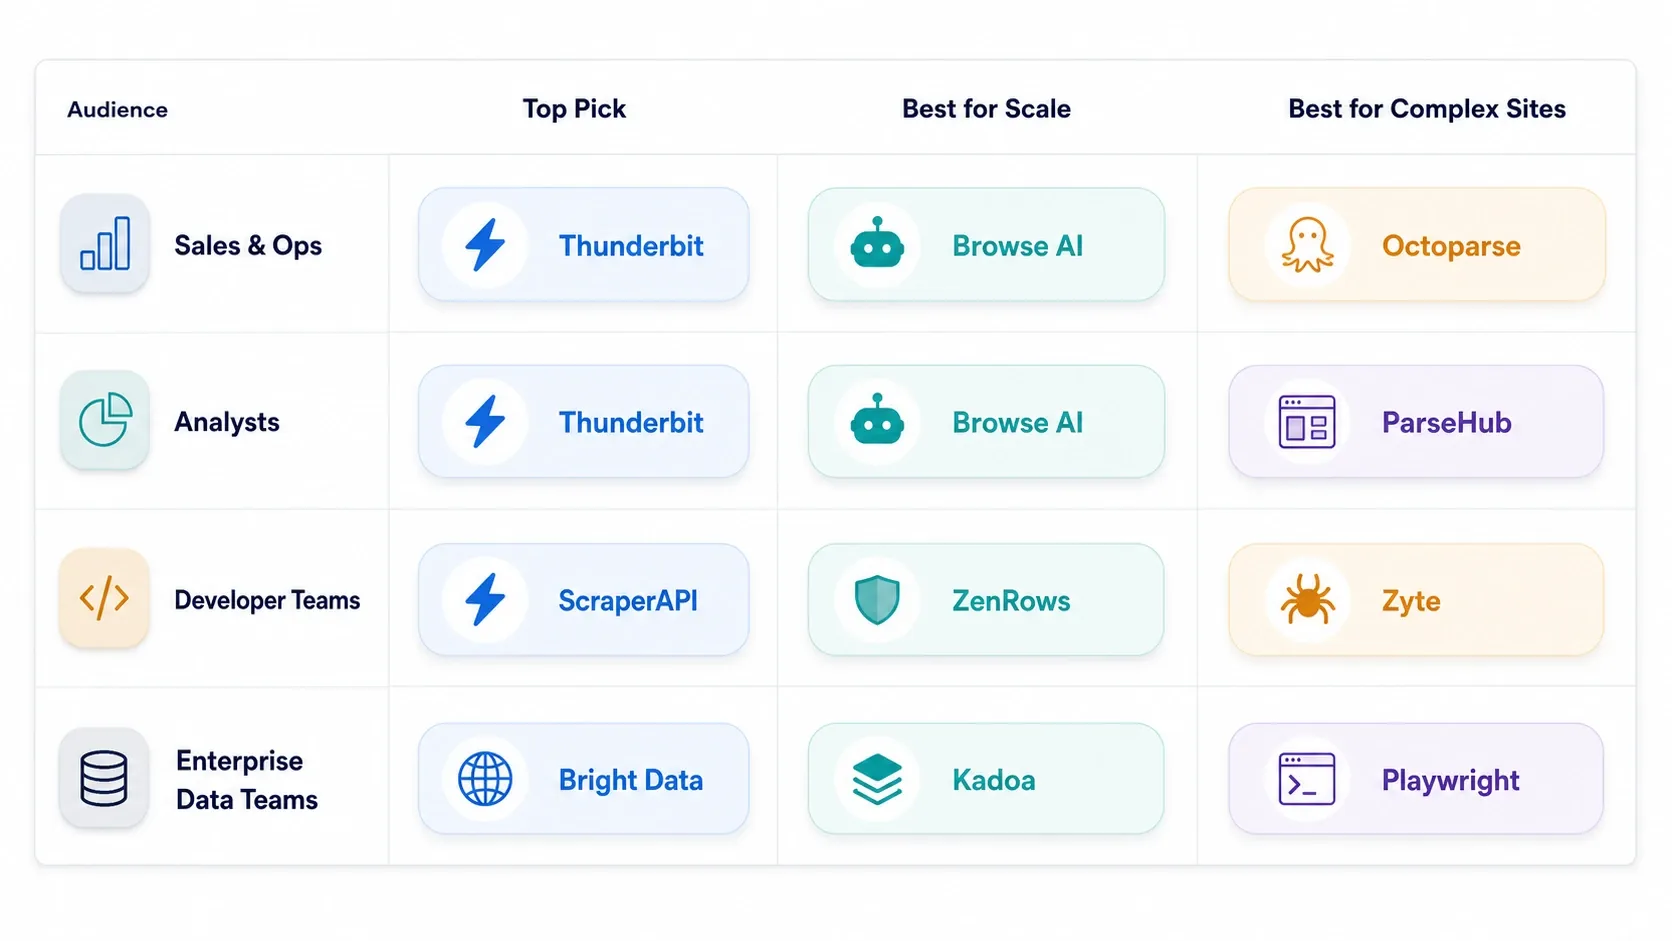
- Zespoły sprzedaży i operacji: zacznij od Thunderbit, a następnie porównaj Browse AI, jeśli monitoring ma większe znaczenie niż wzbogacanie podstron.
- Analitycy i zespoły realizujące cykliczne ekstrakcje: najpierw Octoparse, potem ParseHub, jeśli potrzebujesz bardziej precyzyjnej logiki strony.
- Zespoły techniczne o hybrydowym profilu: Apify, jeśli chcesz jednej platformy do gotowych narzędzi i własnych workflow.
- Enterprise’owe programy danych: Bright Data i Oxylabs, jeśli najważniejsze są skuteczność omijania blokad, proces zakupowy i niezawodność.
- Pipeline’y utrzymywane przez deweloperów: Scrapy do własności crawlera, Playwright do automatyzacji przeglądarki opartej na kodzie.
Jeśli Twoja lista zaczyna już przesuwać się od rozszerzeń przeglądarkowych do powtarzalnego monitoringu i workflow na skalę marketplace’u, ten aktualny materiał o Apify będzie lepszym późnym punktem odniesienia niż kolejny ogólny filmik podsumowujący:
Jak wybrać, żeby nie kupić za dużo
Najczęstszym błędem w tej kategorii jest zakup niewłaściwej warstwy.
- Wybierz scraper AI działający w przeglądarce, jeśli główny problem to czas konfiguracji i dostępność dla użytkowników biznesowych.
- Wybierz narzędzie no-code do workflow, jeśli ważniejsze są zadania cykliczne, uruchomienia w chmurze lub trudna paginacja niż prostota jednego kliknięcia.
- Wybierz platformę lub stack API, jeśli renderowanie, rotacja proxy i skuteczność omijania blokad są już realnym wymaganiem.
- Wybierz framework open source tylko wtedy, gdy zespół inżynieryjny już bierze na siebie utrzymanie i rzeczywiście potrzebuje pełnej kontroli.
Praktyczna zasada jest prosta: kupuj najlżejsze narzędzie, które naprawdę potrafi wykonać zadanie, jakie masz dziś.
Podsumowanie
Nie istnieje jedno uniwersalnie najlepsze rozwiązanie do web scrapingu, ponieważ ta kategoria obejmuje kilka różnych ścieżek zakupowych. Thunderbit jest najlepszym wyborem, gdy praca zaczyna się w przeglądarce i ma szybko zakończyć się w arkuszu. Browse AI, Octoparse i ParseHub lepiej sprawdzają się wtedy, gdy ważniejsza staje się powtarzalność i precyzyjna kontrola no-code. Apify, Bright Data, Oxylabs i ScrapingBee stają się istotne wtedy, gdy wąskim gardłem jest infrastruktura. Scrapy i Playwright są właściwą odpowiedzią, gdy zespół inżynieryjny chce posiadać własny stack.
Zacznij od najlżejszego narzędzia, które naprawdę wykona zadanie Get Started Free
Materiały powiązane
- Najlepsze narzędzia AI Web Scraper w 2026 roku
- Jak scrapować dowolną stronę internetową z użyciem AI
- Jak zeskrobać dane ze strony do Excela
FAQ
1. Jakie narzędzie do web scrapingu jest najlepsze dla użytkowników nietechnicznych w 2026 roku?
Dla większości użytkowników nietechnicznych najlepszym miejscem na start jest Thunderbit, ponieważ minimalizuje pracę konfiguracyjną i szybko eksportuje dane do narzędzi biznesowych. Browse AI i Octoparse to mocne opcje rozwoju, gdy ważniejsze stają się cykliczny monitoring lub bardziej precyzyjna kontrola no-code.
2. Które narzędzie do web scrapingu najlepiej nadaje się do powtarzalnych workflow no-code?
Octoparse to najsilniejszy kompromis, jeśli potrzebujesz uruchomień w chmurze, szablonów i powtarzalnej ekstrakcji według harmonogramu. Browse AI lepiej sprawdza się wtedy, gdy monitoring i wykrywanie zmian są kluczowe dla zadania.
3. Co powinni wybrać deweloperzy, jeśli potrzebują większej skali albo kontroli?
Apify to najmocniejszy wybór platformowy, jeśli chcesz infrastruktury chmurowej i wielokrotnego użytku narzędzi. Scrapy będzie lepszy, gdy zespół chce mieć własny stos crawlerów w Pythonie. Playwright lepiej pasuje, gdy automatyzacja przeglądarki stanowi centrum workflow.
4. Kiedy Bright Data albo Oxylabs mają więcej sensu niż scraper przeglądarkowy?
Mają więcej sensu wtedy, gdy trudność nie polega na zebraniu jednej strony, tylko na obsłudze infrastruktury: skuteczności omijania blokad, routingu proxy, zakupach, zgodności albo niezawodnym zbieraniu danych na dużą skalę.
5. Czy darmowe i open source narzędzia wystarczą do poważnych zadań scrapingu?
Mogą wystarczyć, ale tylko wtedy, gdy zespół jest gotowy samodzielnie odpowiadać za utrzymanie, logikę parsowania, obsługę anty-botów, ponawianie prób i infrastrukturę. Taki kompromis często ma sens dla zespołów inżynierskich, ale zwykle nie jest najlepszym punktem startowym dla użytkowników biznesowych.




