
Mniej więcej przy czternastej zakładce w przeglądarce i trzecim kalkulatorze cenowym dotarło do mnie, że wybór usługi web scrapingu w 2026 roku jest trudniejszy niż samo pobieranie danych. Rynek eksplodował — rozszerzenia Chrome bez kodowania, surowe API, rozbudowane stacki enterprise oparte na proxy, ekstraktory AI i agencje full-service walczą o ten sam budżet.
Przez kilka tygodni testowałem 12 usług web scrapingu na realnych zadaniach: pobieraniu danych produktowych ze sklepów internetowych, wyciąganiu leadów z katalogów firm i scrapowaniu ofert pracy z paginacją oraz podstronami. Celem nie było ustawienie funkcji w próżni, ale odpowiedź na jedno praktyczne pytanie: która usługa pasuje do jakiego zespołu?
Zgodnie z publicznym raportem Bright Data o danych z publicznego webu, 82% organizacji uważa dziś takie dane za kluczowe dla swojej przyszłości. Raport rynkowy ScrapeOps na 2025 rok pokazuje, że ponad 65% organizacji używa web scrapingu do budowania zbiorów danych pod analitykę i AI. A jednak badanie Apify z 2026 roku wskazuje, że 46,7% specjalistów nadal opiera się wyłącznie na własnym kodzie — razem z całym kosztem utrzymania, który się z tym wiąże.
Zanim przejdziemy do narzędzi, krótko wyjaśnijmy kwestie prawne związane ze scrapingiem.
Jak oceniłem najlepsze usługi web scrapingu
Oto kryteria, które brałem pod uwagę. Wybrałem je po obserwacji tego, co psuje się już po etapie demo — nie na podstawie samej listy funkcji.
- Łatwość konfiguracji / wymagany poziom techniczny — czy osoba nietechniczna uzyska wartość w mniej niż 10 minut?
- Radzenie sobie z anty-botami i proxy — czy usługa obsługuje proxy i rozwiązywanie CAPTCHA, czy to już Twój problem?
- Renderowanie JavaScriptu — czy bez problemu obsługuje dynamiczne strony oparte na JS?
- Formaty eksportu i integracje — czy da się przesłać dane do Sheets, Airtable albo Notion bez pisania kodu łączącego?
- Harmonogram / automatyczny monitoring — czy można ustawić cykliczne scrapowanie bez cronów?
- Skalowalność — czy działa przy 100 stronach i nadal działa przy 1 milionie?
- Przejrzystość cen i koszt przy skali — czy da się przewidzieć rachunek za kolejny miesiąc, czy będzie niespodzianka?
- Ekstrakcja oparta na AI vs. ręczne selektory — czy AI potrafi wykryć pola samodzielnie, czy trzeba pisać CSS/XPath ręcznie?
- Koszt utrzymania w czasie — co dzieje się, gdy docelowa strona przechodzi redesign?
Ten ostatni punkt warto szczególnie podkreślić. Opinie użytkowników o narzędziach takich jak Octoparse, Apify, Browse AI i Bright Data wracają do tych samych problemów: niejasne ceny kredytowe, psujące się selektory po zmianie strony, błędy uruchomień w chmurze na chronionych stronach i wysoka krzywa uczenia po pierwszym demo. „Koszt utrzymania” nie jest miłym dodatkiem do oceny. To właśnie on decyduje o tym, czy będziesz korzystać z narzędzia za sześć miesięcy.
Jaki typ usługi web scrapingu pasuje do Twojego zespołu?
Zanim porównamy konkretne narzędzia, najbardziej praktyczne będzie wskazanie właściwej kategorii. Rynek web scrapingu nie jest jednym rynkiem. To pięć nakładających się rynków, a wybór złej kategorii marnuje więcej czasu niż wybór złego narzędzia w dobrej kategorii.
| Twoja sytuacja | Polecany typ usługi | Dlaczego | Dobre dopasowania z tej listy |
|---|---|---|---|
| Zespół nietechniczny (sprzedaż, marketing, operacje) potrzebujący danych szybko | Rozszerzenie Chrome bez kodu | Najszybsza droga od strony do arkusza, najmniej tarcia przy starcie | Thunderbit, Browse AI, Octoparse |
| Programista budujący scraping w aplikacji lub pipeline | API do scrapingu | Większa kontrola, webhooki, zadania asynchroniczne, lepsze dopasowanie do CI/CD | ScrapingBee, ScraperAPI, ZenRows |
| Zespół zasilający dane do workflow opartych na AI/LLM | API ekstrakcji natywne dla AI | Wyjście w Markdown/JSON jako priorytet, mniej czyszczenia HTML | Thunderbit API, Firecrawl, Diffbot |
| Enterprise potrzebujące infrastruktury proxy i wysokiej skali | Platforma do pobierania danych full-stack | Pakiet proxy, anty-bot, SLA, wysoka współbieżność | Bright Data, Oxylabs, Apify |
| Firma, która chce otrzymać dane, a nie obsługiwać narzędzie | Usługa zarządzana / agencja | Dostawca odpowiada za budowę, monitoring, QA i dostawę | ScrapeHero |
To nie jest teoria. Wskazówki Zyte dotyczące decyzji build-vs-buy z 2026 roku jasno pokazują kompromis: własne rozwiązanie daje kontrolę, ale generuje ciągłe utrzymanie; hybrydowe stacki tworzą operacyjny patchwork; usługi zarządzane zdejmują ciężar z wewnętrznego zespołu, ale ograniczają elastyczność self-serve.
Ekstrakcja oparta na AI vs. tradycyjne selektory CSS/XPath
To dziś największy techniczny rozdział na rynku.
Tradycyjny scraping przypomina podążanie za mapą skarbu z dokładnymi współrzędnymi. Analizujesz stronę, znajdujesz selektor typu .product-title, piszesz regułę ekstrakcji, testujesz i liczysz, że jutro strona będzie wyglądać tak samo. Gdy zespół front-end zmieni nazwę klasy albo opakuje treść w nowy div, scraper się psuje.
Scraping oparty na AI działa raczej jak rozmowa z inteligentnym asystentem: „Znajdź na tej stronie nazwę produktu, cenę i status dostępności”. Zamiast zakodować trasę, opisujesz cel.
W praktyce wygląda to tak:
Tradycyjny proces:
- Sprawdź element w DevTools
- Znajdź klasę
.product-titlelub XPath - Napisz regułę ekstrakcji
- Przetestuj na przykładowych stronach
- Poprawiaj za każdym razem, gdy witryna zmienia klasy
Proces oparty na AI (np. Thunderbit):
- Otwórz stronę i kliknij raz
- AI dobiera kolumny — nazwa produktu, cena, ocena
- W razie potrzeby doprecyzuj, czego chcesz, albo po prostu opisz dane
- W przeciwnym razie narzędzie po prostu działa i zwraca tabelę
Badania opublikowane w marketingu bywają bardziej optymistyczne niż rzeczywistość. Artykuł w Scientific Reports z 2025 roku pokazuje o 35% lepszą dokładność ekstrakcji i o 40% wyższą efektywność przetwarzania dla crawlera AI w porównaniu z tradycyjnym, ale testowano tam archiwa gazet, a nie strony produktowe czy katalogi firm, więc nie przenosiłbym tych liczb na witryny z tego artykułu. Bardziej użyteczny jest przegląd Springer z 2025 roku: modele AI lepiej adaptują się do dynamicznych struktur, ale nadal wymagają ponownego trenowania albo logiki awaryjnej, gdy domeny lub wzorce zmieniają się istotnie.
| Wymiar | Tradycyjny (CSS/XPath) | Ekstrakcja oparta na AI |
|---|---|---|
| Czas konfiguracji | 15–60 min na stronę | Około 30 sekund |
| Poziom techniczny | Poziom programisty | Bez wymagań |
| Radzenie sobie ze zmianami układu i nowymi stronami | Pęka — nowe reguły po każdym redesignie, nowe reguły dla każdej nowej strony | Zwykle się adaptuje — czyta stronę od nowa przy każdym uruchomieniu |
| Przewidywalność | Deterministyczna — ta sama reguła pobiera to samo pole za każdym razem | Probabilistyczna — może wybrać złe pole, więc wyniki wymagają sprawdzenia |
| Etykietowanie / transformacja danych | Osobny etap post-processingu | Może etykietować, tłumaczyć i kategoryzować już podczas scrapowania |
| Najlepsze dla | Stabilne pipeline’y o dużej skali, utrzymywane przez devów | Strony „long tail”, różne układy, użytkownicy nietechniczni |
Najbardziej odczuwalna różnica w praktyce to utrzymanie. Nie ma wiarygodnej publicznej liczby, jak często scrapy się psują, więc nie będę jej tu wymyślać. To, co widać konsekwentnie, to kształt skarg w recenzjach G2 i Capterra dotyczących narzędzi opartych na selektorach z tej listy: rzadko problemem jest brak możliwości pobrania danych, a prawie zawsze to, że narzędzie przestało pobierać dane po zmianie strony.
Thunderbit jest najczystszym przykładem modelu AI-first z tej listy. Jego AI wybiera pola warte pobrania po jednym kliknięciu, albo możesz opisać dane w jednym zdaniu, a Field AI Prompts pozwalają etykietować, tłumaczyć, podsumowywać i kategoryzować dane już podczas ekstrakcji — nie dopiero po niej. Jego Open API udostępnia endpointy Distill i Extract, więc ten sam model ekstrakcji AI działa też programowo.
Wypróbuj scraping oparty na AI z Thunderbit
Wszystkie 12 najlepszych usług web scrapingu w skrócie
| Usługa | Typ | Najlepsze zastosowanie | Anty-bot/proxy | Renderowanie JS | Ekstrakcja AI | Darmowy plan | Cena startowa (miesięcznie) | Opcje eksportu |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code Chrome ext + API | Zespoły nietechniczne | ⚠️ Obsługa w chmurze | ✅ | ✅ Pola mapowane przez AI | ✅ 6 stron za darmo | Free; płatny od $15/mies. | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Platforma full-stack | Enterprise-scale pipelines | ✅ Najlepsza w klasie sieć proxy | ✅ | ⚠️ Częściowo / nowsze warstwy AI | ✅ 5K rekordów/mies. | Brak miesięcznego minimum | JSON, CSV, API, webhook |
| Oxylabs | Enterprise proxy + scraping | Scraping SERP, chronione strony | ✅ Residential/DC proxies | ✅ | ⚠️ Ograniczona | ⚠️ Trial | ~$49/mies. | JSON, CSV, API |
| Apify | Platforma + marketplace | Developerzy, automatyzacja | ✅ Przez konfigurację proxy | ✅ | ⚠️ Niektóre actor’y | ✅ $5 za darmo/mies. | $29/mies. + usage | JSON, CSV, Excel, API |
| ScrapingBee | Usługa API | Pipeline’y deweloperskie | ✅ Wbudowane | ✅ | ⚠️ Częściowa ekstrakcja AI | ✅ 1,000 kredytów | $49/mies. | JSON, HTML, Markdown, API |
| ScraperAPI | Usługa API | Monitoring cen na dużą skalę | ✅ Wbudowana rotacja | ✅ | ❌ | ⚠️ Trial 7 dni, 5K kredytów | $49/mies. | JSON, CSV, API |
| ZenRows | Usługa API | Strony mocno chronione anty-botem | ✅ Premium anti-bot | ✅ | ⚠️ Beta | ✅ 5K kredytów/mies. | $19/mies. | JSON, API |
| Octoparse | No-code desktop + cloud | Wizualny scraping bez kodu | ✅ Wbudowane | ✅ | ⚠️ Ograniczone auto-detect | ✅ Darmowy plan (10 zadań) | $39/mies. | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | Platforma AI/NLP | Strukturalne dane enterprise | ⚠️ Podstawowe do umiarkowanych | ✅ | ✅ Oparte na NLP | ✅ 10K kredytów/mies. | $299/mies. | JSON, CSV, API |
| Firecrawl | API dla developerów (AI) | Pipeline’y LLM/RAG | ✅ Wbudowane | ✅ | ✅ Markdown + strukturalne | ✅ 1,000 kredytów/mies. | $19/mies. | Markdown, JSON, HTML, API |
| Browse AI | Monitoring no-code | Wykrywanie zmian, użytkownicy nietechniczni | ⚠️ Podstawowe | ✅ | ⚠️ Oparte na szablonach | ✅ 50 kredytów/mies. | $48/mies. | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Usługa zarządzana / agencja | Firmy chcące rozwiązania bezobsługowego | ✅ W pełni zarządzane | ✅ | N/A | ❌ | Od $199/mies. | Dostawa niestandardowa |
Wzorzec jest prosty.
Thunderbit, Browse AI i Octoparse optymalizują szybkość startu. ScrapingBee, ScraperAPI i ZenRows optymalizują kontrolę deweloperską. Bright Data, Oxylabs i Apify optymalizują skalę i infrastrukturę. Firecrawl i Diffbot optymalizują dane dopasowane do AI. ScrapeHero optymalizuje brak konieczności samodzielnej obsługi.
1. Thunderbit
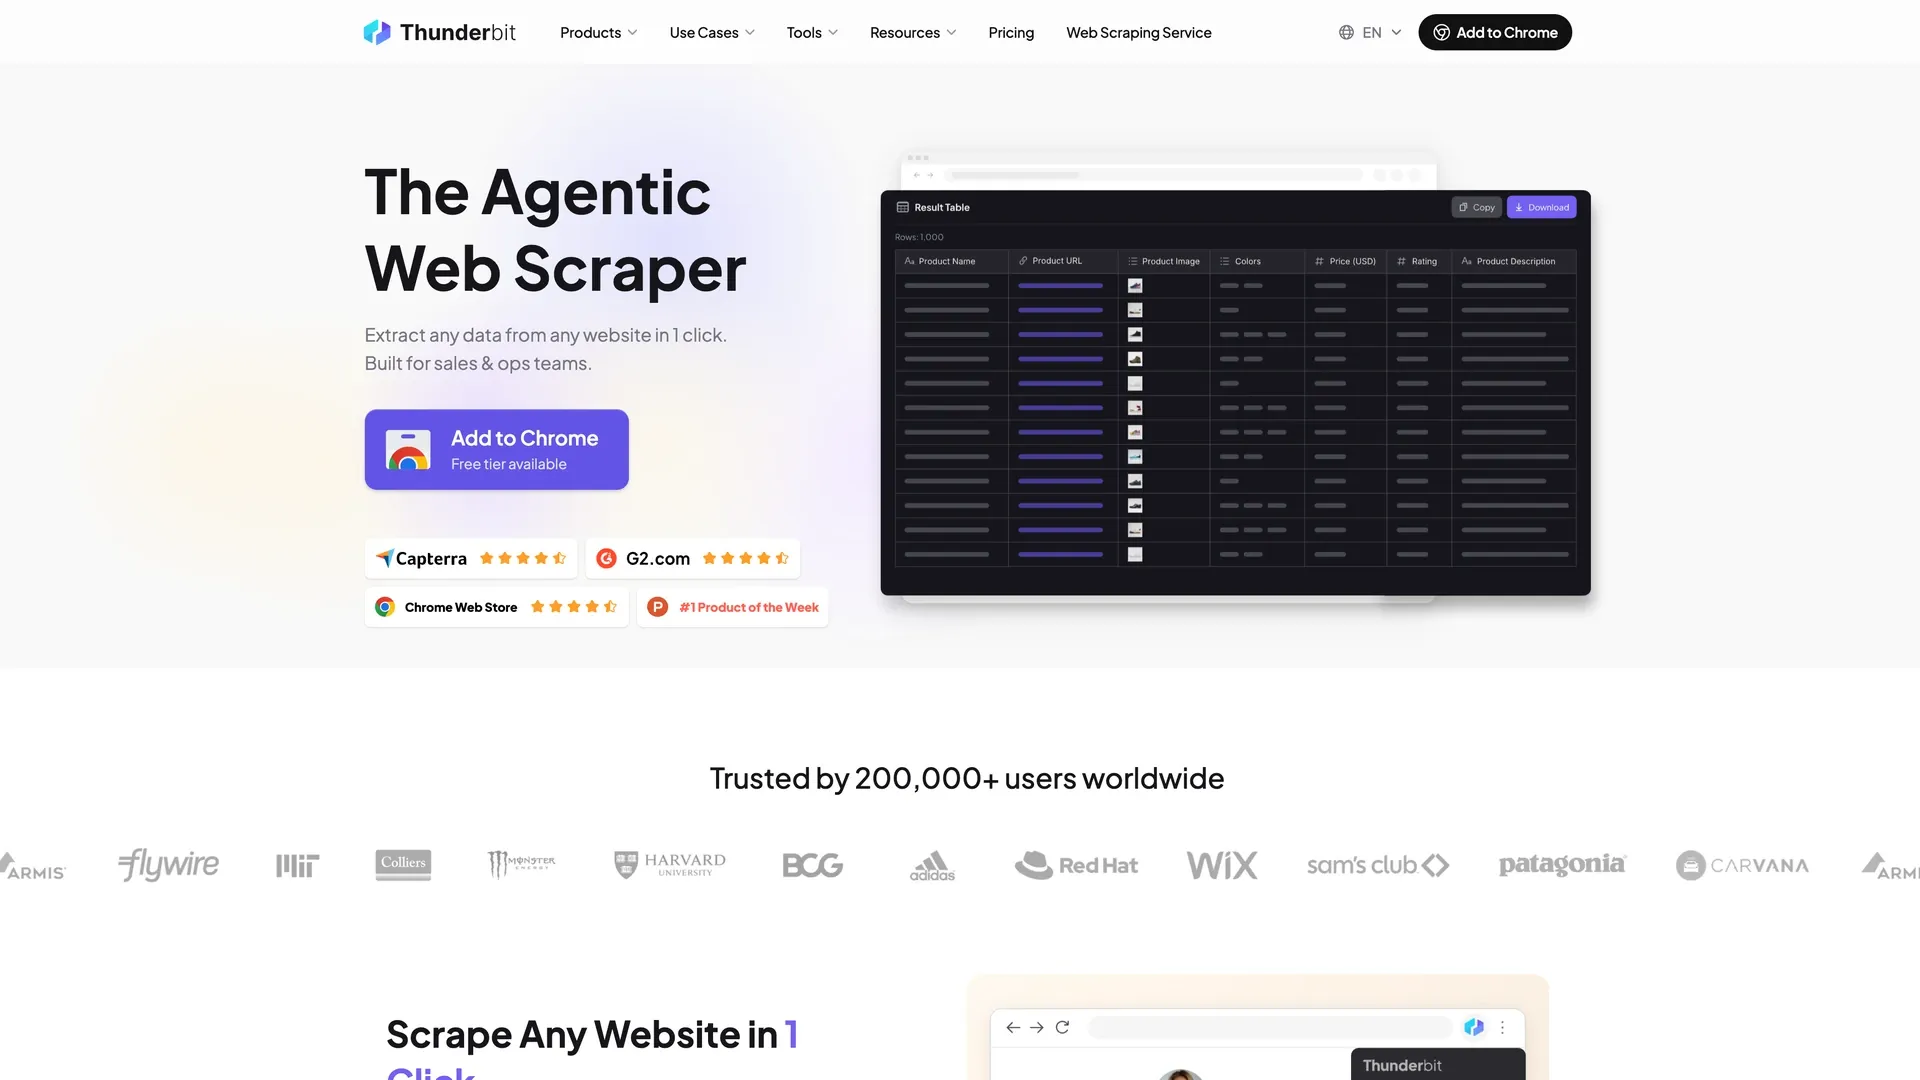 Thunderbit to najprostszy produkt z tej listy dla użytkowników nietechnicznych, którzy chcą przejść od strony internetowej do arkusza kalkulacyjnego bez dotykania choćby jednego selektora. Główny workflow jest wyjątkowo prosty: otwierasz rozszerzenie Chrome na dowolnej stronie i klikasz raz — AI samo wybiera pola warte pobrania i wykonuje zadanie, a jeśli chcesz coś konkretnego, po prostu opisujesz to zwykłym angielskim. W przypadku większości stron to naprawdę cały proces. Bez selektorów CSS. Bez XPath. Bez analizowania elementów.
To, co wyróżnia Thunderbit, to nie tylko sama ekstrakcja pól. Narzędzie może też etykietować, tłumaczyć, podsumowywać, kategoryzować i przekształcać dane już w trakcie scrapowania dzięki Field AI Prompts. Ma to znaczenie, bo dla użytkowników biznesowych prawdziwe wąskie gardło często nie leży w samej ekstrakcji, tylko w czyszczeniu danych po eksporcie. Z Thunderbit możesz pobrać francuską stronę produktową i od razu otrzymać wynik po angielsku wraz z etykietami sentymentu — w jednym przebiegu.
Najważniejsze funkcje:
- Konfiguracja bez selektorów — jedno kliknięcie i AI dobiera kolumny za Ciebie, albo po prostu mówisz, czego potrzebujesz
- Tryb przeglądarkowy dla stron po zalogowaniu oraz tryb chmurowy (50 stron jednocześnie) do szybkiego scrapowania publicznych witryn
- Scraping podstron do automatycznego wzbogacania list o dane ze stron szczegółowych
- Obsługa paginacji i infinite scroll wbudowana od razu
- Harmonogram w języku naturalnym do cyklicznego monitoringu (np. „każdy poniedziałek o 9:00”)
- Gotowe szablony scraperów dla popularnych serwisów, takich jak Amazon, Zillow, Google Maps i Indeed
- Open API z endpointami
DistilliExtractdo zastosowań developerskich - Wsparcie 34 języków, w tym tłumaczenie podczas ekstrakcji
Najmocniejszą stroną Thunderbit jest eksport. Oferuje darmowy, natywny eksport do Excel, CSV, JSON, Google Sheets, Airtable i Notion — także z obsługą obrazów w eksporcie do Airtable i Notion. Dla zespołu sprzedaży, który pracuje w Sheets, albo marketingu, który porządkuje research w Notion, eliminuje to cały etap przekształcania danych, który w narzędziach API-first trzeba robić samodzielnie.
Cennik: model oparty na kredytach. Darmowy plan obejmuje 6 stron miesięcznie, a także 7-dniowy okres próbny funkcji Pro. Płatne plany przeglądarkowe zaczynają się od $15/mies. w rozliczeniu miesięcznym lub $9/mies. przy płatności rocznej. API ma własny cennik: na start 600 darmowych jednostek, potem $29/mies. za 6,000 jednostek w Starter, $72/mies. za 60,000 w Pro 1, $120/mies. za 120,000 w Pro 2 oraz suwak sięgający 480,000 jednostek miesięcznie. Przy płatności rocznej to $16/mies. za 60,000 jednostek rocznie w Starter i $40/mies. za 600,000 w Pro 1.
Zalety:
- Najmniejsze tarcie przy konfiguracji w całym porównaniu
- Natywne eksporty do arkuszy, a nie „najpierw JSON, potem zobaczymy”
- Transformacja danych przez AI podczas ekstrakcji, nie tylko po niej
- Świetne dopasowanie do sprzedaży, e-commerce, researchu i nieruchomości
Wady:
- Dwa różne systemy kredytów: rozszerzenie liczy 1 kredyt za każdy wiersz wyjściowy (2 przy scrapowaniu podstron), a API liczy 1 jednostkę za stronę Distill i 20 za stronę Extract — trzeba planować to osobno
- Darmowy plan to 6 stron miesięcznie, czyli znacznie mniej niż oferują tu dostawcy API (Firecrawl 1,000 kredytów/mies., ZenRows 5,000, Diffbot 10,000)
- Samoobsługa kończy się przed skalą enterprise: najwyżej publikowany plan przeglądarkowy to Pro za $38/mies. przy płatności miesięcznej, a dalej jest już niestandardowa wycena Business
Najlepsze zastosowanie: generowanie leadów sprzedażowych, monitoring konkurencji w e-commerce, research marketingowy, scrapowanie ofert pracy i katalogów firm, ogłoszenia nieruchomości.
2. Bright Data
 Bright Data to wybór enterprise dla firm, które chcą jednego dostawcy proxy, API do scrapingu, datasetów, API do SERP i coraz częściej także ekstrakcji wspomaganej AI. To mniej pojedynczy produkt, a bardziej pełny stack do pozyskiwania danych.
Cennik Web Scraper API jest publiczny: darmowy plan obejmuje 5,000 rekordów miesięcznie, model pay-as-you-go to ok. $1.50 za 1,000 rekordów, a plan scale kosztuje $499/mies. i zawiera 384,000 rekordów, po czym kolejne kosztują $1.30 za 1,000. „Rekord” oznacza tu jeden wyekstrahowany element — jeden wiersz w tabeli — a nie jedną załadowaną stronę. Residential proxy zaczynają się od $4/GB. Dostępne są też strukturalne datasety, Scraper Studio, AI scrapers i obsługa MCP.
Najważniejsze funkcje:
- Bardzo mocna sieć proxy (residential, datacenter, mobile, ISP)
- Pełne renderowanie przeglądarki i rozwiązywanie CAPTCHA w cenie Web Scraper API
- Marketplace z datasetami gotowymi do użycia
- Enterprise’owe podejście do zgodności i Trust Center z certyfikacjami
Cennik: pay-as-you-go od ok. $1.50/1K rekordów; plan scale od $499/mies.
Zalety: niezrównana skala i infrastruktura proxy, szerokie governance enterprise.
Wady: większa złożoność niż potrzebuje większość średnich zespołów. Koszty rosną, gdy łączysz API, proxy i dodatkowe warstwy. Platforma nadal zakłada technicznego właściciela, nawet mimo nowszych funkcji AI.
Najlepsze zastosowanie: pipeline’y Fortune 500, zespoły danych scrapujące miliony stron, scraping między regionami, gdzie jakość proxy ma znaczenie, przedsiębiorstwa potrzebujące formalnej zgodności.
3. Oxylabs
 Oxylabs to najsilniejsza czysto enterprise’owa opcja proxy + scraping dla zespołów, którym najbardziej zależy na niezawodności na chronionych celach. Oferuje residential i datacenter proxies, Web Scraper API, SERP Scraper API, Web Unblocker oraz nowszą warstwę Headless Browser.
Cennik zaczyna się od $49/mies. za Web Scraper API, a stawka za wynik zależy zarówno od docelowej strony, jak i planu. W planie Micro za $49 zwykła strona — wszystko poza Amazon i Google — kosztuje $1.15 za 1,000 wyników bez renderowania JS i $1.35 z nim; w planie Advanced za $249 te dwie wartości to odpowiednio $0.95 i $1.25, a na wyższych progach nadal maleją. Residential proxy zaczynają się od $6/GB i spadają do $2.50/GB przy 1 TB.
Najważniejsze funkcje:
- Bardzo mocna infrastruktura proxy z automatyczną rotacją i zarządzaniem sesjami
- SERP Scraper API stworzone do monitoringu wyszukiwarek
- Model „płacisz tylko za sukces” dla głównych produktów
- Jasne podejście do zgodności i Trust Center
Cennik: od $49/mies.; brak stałego darmowego planu (tylko trial).
Zalety: niezawodne proxy, świetne do scraping SERP, mocna pozycja trust/compliance.
Wady: liczba wyników na poziomie planu zakłada Amazon bez renderowania JS — na zwykłej stronie plan Micro za $49 daje około 42,600 wyników, a nie 98,000. Ponieważ stawka za 1,000 wyników zmienia się w zależności od strony i poziomu planu, dwa zespoły scrapujące tę samą liczbę danych mogą dostać bardzo różne faktury.
Najlepsze zastosowanie: zespoły SEO, monitoring SERP na poziomie enterprise, duże workloady wymagające proxy.
4. Apify
 Apify to najbardziej elastyczna platforma w stylu marketplace na tej liście. Łączy wykonywanie w chmurze, storage, harmonogramy, logi, API i ogromny ekosystem gotowych „Actorów” — w Apify Store jest już ponad 59,000 Actorów. Zamiast budować każdy scraper od zera, często możesz zacząć od gotowego actor’a do Google Maps, Amazon, Instagrama, TikToka albo ogólnego crawlera treści.
Najważniejsze funkcje:
- Ogromny marketplace gotowych scraperów
- Apify SDK do tworzenia własnych actorów
- Wbudowane zarządzanie proxy i uruchomienia w chmurze
- Mocne API, storage, harmonogramy i logi
Cennik jest oparty na zużyciu: darmowy plan z $5 do wykorzystania, potem $29/mies. w Starter, $199 w Scale, $999 w Business — do tego dochodzi rozliczanie compute units. Ta elastyczność jest mocna, ale przewidywanie miesięcznych kosztów jest trudniejsze niż w prostszych produktach API.
Zalety: ogromna społeczność, wiele gotowych scraperów, dobre zarówno do hobby-to-production, jak i poważnej automatyzacji.
Wady: dostosowanie lub debugowanie actorów wymaga nauki. Koszt oparty na compute units + opłaty za actorów + proxy może być trudny do przewidzenia. Lepsze dla osób budujących niż dla użytkowników biznesowych myślących w arkuszach.
Najlepsze zastosowanie: developerzy i osoby tworzące automatyzacje, zespoły chcące używać istniejących scraperów, hybrydowe workflow build-and-buy.
5. ScrapingBee
 ScrapingBee to jedno z najprostszych API do scrapingu do zrozumienia i integracji. Skupia się na renderowaniu headless Chrome, rotacji proxy i czystej ergonomii API zamiast próbować być platformą wizualną.
Cennik zaczyna się od $49/mies. za 250,000 kredytów i 50 równoczesnych requestów, a plan Startup kosztuje $99/mies. za 1,000,000 kredytów i 100 równoczesnych requestów. Nowi użytkownicy dostają 1,000 darmowych kredytów API. Ważne: renderowanie JS, premium proxy, screenshoty i ekstrakcja AI zużywają kredyty według wyższych mnożników.
Najważniejsze funkcje:
- Bardzo czyste REST API
- Dedykowane endpointy dla Amazon, Google, YouTube, Walmart i ChatGPT
- Może zwracać HTML, JSON, Markdown albo zwykły tekst
- Dobry wybór do pipeline’ów AI/LLM, bo Markdown ogranicza czyszczenie danych
Zalety: przyjazny dla developerów, stabilne renderowanie JS, przejrzysty cennik bazowy.
Wady: plan za $49 daje 250,000 kredytów, ale to 250,000 zwykłych requestów — renderowanie JS, premium proxy, screenshoty i ekstrakcja AI kosztują więcej niż jeden kredyt za wywołanie, więc w realnych zastosowaniach liczba stron jest dużo niższa niż na banerze. Równoczesność jest powiązana z planem (50 requestów równoległych w Freelance), więc throughput może wymusić wyższy plan szybciej niż sam wolumen. Nadal wymaga odpowiedzialności za kod.
Najlepsze zastosowanie: developerzy osadzający scraping w backendzie, zespoły chcące prostego API, pipeline’y LLM nastawione na tekst.
6. ScraperAPI
 ScraperAPI pozostaje jedną z najmocniejszych ustrukturyzowanych opcji API do monitoringu e-commerce i cyklicznego scrapingu na dużą skalę. Produkt jest prosty: jeden endpoint, który łączy proxy, retry, renderowanie JS, geotargeting i ustrukturyzowane wyjście.
Cennik zaczyna się od $49/mies. za 100,000 kredytów i 20 wątków, a plan Startup kosztuje $149/mies. za 1,000,000 kredytów i 50 wątków. Dostępny jest też 7-dniowy trial z 5,000 kredytów bez karty. To, co wyróżnia ScraperAPI, to warstwa strukturalna: async API, dostarczanie przez webhooki, DataPipeline dla projektów low-code oraz ustrukturyzowane endpointy dla Amazon, eBay, Google, Redfin i Walmart.
Najważniejsze funkcje:
- Mocne ustrukturyzowane endpointy dla głównych serwisów e-commerce i search
- Dobre wsparcie async i webhooków
- Konkurencyjna opcja do monitoringu o dużej skali
- Szerokie możliwości geotargetingu i renderowania
Zalety: hojny trial, dobra dokumentacja, niezawodność w monitoringu e-commerce.
Wady: mnożniki kredytowe utrudniają modelowanie kosztów. Brak prawdziwej ekstrakcji AI dla dowolnych stron. Tylko dla developerów.
Najlepsze zastosowanie: monitoring cen w e-commerce, intelligence konkurencyjna, pipeline’y search i marketplace.
7. ZenRows
 ZenRows to specjalista od anty-botów. Skupia się na obchodzeniu Cloudflare, DataDome, Akamai, Imperva i podobnych zabezpieczeń, a jednocześnie zachowuje nowoczesne doświadczenie dla developerów.
Cennik zaczyna się od $19/mies. w planie Build (45,000 kredytów, 20 równoległych requestów). Build sam w sobie jest suwakiem — $29 za 80,000 kredytów, $39 za 120,000 — a wyżej są jeszcze Launch za $69/mies. za 250,000 kredytów i 50 requestów równoległych oraz Growth za $199/mies. za 1.2 miliona; to ceny przy płatności miesięcznej, a przy rocznej jest 17% zniżki. Model kosztów opiera się na mnożnikach: renderowanie JS to 5x, premium proxy 10x, a użycie obu naraz to 25x.
Najważniejsze funkcje:
- Bardzo mocny nacisk na strony mocno chronione
- Szeroka dokumentacja i pokrycie scenariuszy anty-bot
- Nowoczesny ekosystem integracji, w tym LangChain, LlamaIndex i MCP
- Płacisz tylko za udane requesty
Zalety: bardzo wysoki współczynnik sukcesu anty-bot na trudnych celach.
Wady: koszt rośnie bardzo szybko przy chronionych workloadach. Strona wymagająca zarówno renderowania JS, jak i premium proxy kosztuje 25 kredytów zamiast 1, więc plan za $19, który wygląda na 45,000 stron, na trudnych celach wystarcza na 1,800 stron.
Najlepsze zastosowanie: developerzy scrapujący trudne cele, zadania monitoringu z silną ochroną anty-bot, zespoły bardziej skupione na przejściu przez zabezpieczenia niż na UX arkusza.
8. Octoparse
 Octoparse to klasyczny desktopowy scraper no-code: wizualny kreator workflow, uruchamianie z desktopu, harmonogram w chmurze, wbudowana nawigacja przeglądarkowa i szerokie możliwości eksportu. Jeśli Thunderbit to opcja AI-first „jedno kliknięcie”, Octoparse jest narzędziem wizualnym dla osób, które chcą modelować logikę ekstrakcji krok po kroku.
Cennik jest bardziej złożony, niż wygląda na pierwszy rzut oka. Centrum pomocy podaje stawki miesięczne — Basic za $39/mies., Standard od $83/mies. i Professional za $299/mies. — podczas gdy główna strona cennika domyślnie pokazuje rozliczenie roczne, stąd widoczne tam ceny $69/mies. dla Standard i $249/mies. dla Professional. To te same plany, tylko w dwóch modelach rozliczeń, a nie dwie sprzeczne listy cen; jedyna realna luka to Basic, którego na głównej stronie w ogóle nie pokazano. Zawsze sprawdź więc, czy podana cena dotyczy rozliczenia miesięcznego czy rocznego. Strona cennika podkreśla też dodatki, takie jak residential proxy, rozwiązywanie CAPTCHA, konfiguracja crawlera i w pełni zarządzana usługa danych.
Najważniejsze funkcje:
- Dojrzały wizualny kreator workflow
- Szeroki eksport: Excel, CSV, JSON, HTML, XML, Google Sheets, bazy danych
- Harmonogram i automatyzacja w chmurze wbudowane od razu
- Szablony scraperów dla popularnych stron
Zalety: bez kodowania, dobre do regularnego scrapingu średniej skali, szerokie opcje eksportu.
Wady: większe potrzeby utrzymaniowe niż narzędzia AI-native, gdy układy stron się zmieniają (oparte na selektorach). Dynamiczne lub chronione strony nadal mogą sprawiać problemy. UX nastawiony na desktop bywa cięższy niż w narzędziach browser-first.
Najlepsze zastosowanie: użytkownicy no-code potrzebujący większej kontroli niż zwykły prompt AI, regularny scraping średniej skali, zespoły lubiące wizualne workflow.
9. Diffbot
 Diffbot to najbardziej enterprise’owa platforma ekstrakcji AI z całej listy. Jej obietnica nie brzmi „scrapuj tę stronę”, tylko „zrozum ten typ strony i zamień go na dane strukturalne na dużą skalę”. Produkty obejmują Extract, Crawl, Natural Language oraz Knowledge Graph.
Cennik zaczyna się od darmowego planu z 10,000 kredytów, potem $299/mies. za Startup (250,000 kredytów), $899 za Plus (1,000,000 kredytów) i niestandardowe plany enterprise. Standardowa wyekstrahowana strona kosztuje 1 kredyt; eksport rekordów do Knowledge Graph jest znacznie droższy.
Najważniejsze funkcje:
- Silne automatyczne rozpoznawanie typu strony (artykuły, produkty, dyskusje)
- Bardzo dobre dopasowanie do budowy knowledge graph i pipeline’ów encji
- Ekstrakcja oparta na NLP — bez potrzeby selektorów
- Premium support i pozycjonowanie enterprise
Zalety: bardzo mocne rozumienie struktury strony przez AI, świetne do budowy knowledge graph.
Wady: drogie w małych lub okazjonalnych projektach. Praca z DQL i Knowledge Graph wymaga nauki. Zbyt zaawansowane do prostego scrapowania do arkusza.
Najlepsze zastosowanie: przedsiębiorstwa budujące strukturalne zbiory danych, projekty knowledge graph i entity resolution, pipeline’y ingestujące dane z naciskiem na NLP.
10. Firecrawl
 Firecrawl to najbardziej naturalne dla developerów narzędzie do wprowadzania danych do LLM z całej grupy. Zamienia URL-e w czysty Markdown, HTML, zrzuty ekranu albo strukturalny JSON i opiera się na prostym API, a nie aplikacji wizualnej.
Cennik jest jasny: darmowy plan z 1,000 kredytów miesięcznie, Hobby z 5,000 kredytów, Standard z 100,000, Growth z 500,000, Scale z 1,000,000, a potem Enterprise. Plan wejściowy kosztuje $19/mies. lub $16/mies. przy rozliczeniu rocznym.
Najważniejsze funkcje:
- Czysty output Markdown do RAG i pipeline’ów LLM
- Wsparcie dla strukturalnego JSON z użyciem schematu lub promptu
- Dobra dokumentacja dla developerów i aktywna adopcja open-source
- Mocne limity współbieżnych przeglądarek na wyższych planach
Zalety: zaprojektowane do karmienia LLM danymi. Niska cena wejścia. Czyste wyjście.
Wady: stworzone dla developerów. Jest playground i zestaw darmowych narzędzi do pojedynczych stron, ale żadne z nich nie uruchamia powtarzalnych zadań — wszystko, co chcesz zaplanować, zbatchować lub wpiąć w pipeline, wymaga wywołania API lub SDK. Kredyty wygasają na koniec miesiąca w każdym planie poniżej poziomu Scale za $749. A drabinka planów ma lukę pośrodku: suwak kredytów przechodzi przez 5,000, 6,500, 8,000 stron miesięcznie, a potem przeskakuje od razu do 100,000 — plan Standard za $99.
Najlepsze zastosowanie: pipeline’y RAG, agenci AI, ingest i analiza treści.
11. Browse AI
 Browse AI najlepiej rozumieć jako produkt do monitoringu, który również scrapuje — a nie tylko jako scraper, który też monitoruje. Jego najmocniejszym zastosowaniem jest cykliczne wykrywanie zmian: cen, stanu magazynowego, tekstu, zrzutów ekranu i zmian stron w czasie.
Cennik zaczyna się od darmowego planu z 50 kredytami miesięcznie, potem Personal za $48/mies. i 2,000 kredytów oraz Professional w modelu suwakiem — $87 za 5,000 kredytów, $162 za 10,000, aż do $399 za 30,000 — a Premium zaczyna się od $500/mies. przy rozliczeniu rocznym. Przy płatności rocznej Personal kosztuje $19/mies., a Professional $69. Kredyty są zużywane zależnie od liczby wierszy i złożoności zadania: strona otwarta dla własnych danych to jedno zadanie z minimum jednego kredytu, 10 wierszy także kosztuje jeden kredyt, a strony premium kosztują dwa do dziesięciu razy więcej.
Najważniejsze funkcje:
- Bardzo dobre nastawienie na monitoring i alerty
- Świetne do cyklicznej kontroli cen lub stanu magazynowego
- Integracje z Sheets, Airtable, webhookami i workflow API
- Szybki pierwszy setup dla użytkowników nietechnicznych
Zalety: świetne do scenariuszy typu „co się zmieniło”, łatwa konfiguracja dla osób bez kodu.
Wady: mniej elastyczne niż ogólne scrapery przy nieznanych lub złożonych stronach. Ograniczona natywna transformacja AI w porównaniu z Thunderbit.
Najlepsze zastosowanie: zespoły e-commerce monitorujące ceny konkurencji, użytkownicy nietechniczni potrzebujący alertów o zmianach.
12. ScrapeHero
 ScrapeHero jest tu wyjątkiem, bo nie jest przede wszystkim narzędziem software’owym. To zarządzana usługa scrapingu. Mówisz im, jakich danych potrzebujesz, a ich zespół buduje rozwiązanie, utrzymuje je, sprawdza QA i dostarcza gotowy zbiór danych.
Cennik odzwierciedla ten model: projekty on-demand zaczynają się od $550 za stronę, plan miesięczny Business od $199 za maksymalnie dwa serwisy po 1–5 tys. stron każdy, Enterprise Basic od $1,500/mies. za maksymalnie cztery serwisy z pulą stron rozłożoną między nimi i dodatkowym wolumenem w cenie $650–$2,200 za milion, a Enterprise Premium od $8,000. W planach Business i Enterprise Basic osobno doliczana jest jednorazowa opłata za setup. Proces dostawy obejmuje dedykowane zespoły projektowe, ludzkie QA i niestandardowe formaty.
Najważniejsze funkcje:
- Niemal zerowe utrzymanie po stronie klienta
- Ludzki QA i niestandardowe formaty dostawy
- Dobre dopasowanie do złożonych projektów wielostronowych
- Podejście do zgodności dla wymagań enterprise
Zalety: brak utrzymania, obsługuje złożone projekty, obsługa premium.
Wady: drogie w porównaniu z narzędziami self-serve. Wolniejszy start niż przy samodzielnym działaniu. W ogóle nie jest self-serve.
Najlepsze zastosowanie: firmy outsourcingujące scraping, zespoły bardziej dbające o dostawę niż o posiadanie narzędzia, złożone projekty wielostronowe z częstymi zmianami.
Realny koszt usług web scrapingu przy 10 tys., 100 tys. i 1 mln stron
Porównywanie tych usług po cenie jest niewygodne, bo dostawcy rozliczają się w różnych jednostkach — stronach, rekordach, kredytach, czasie obliczeń, wierszach albo progach projektowych. Dlatego tabela poniżej pokazuje jedną liczbę, która przetrwa tłumaczenie: ile realnie zostanie pobrane z karty w danym miesiącu. Każda kwota to cena katalogowa month-to-month dla najtańszego planu, który obsługuje dany wolumen zwykłych stron — bez renderowania JavaScriptu i bez premium proxy — z odjętym już miesięcznym darmowym limitem dostawcy. Opłat za proxy, dodatków CAPTCHA i godzin pracy inżynierów nie wliczam do liczby; są opisane w ostatniej kolumnie. Tam, gdzie żaden publicznie podany plan nie sięga danego wolumenu, w komórce pojawia się Custom quote zamiast naciągania górnego planu. A tam, gdzie dostawca nie sprzedaje usługi w przeliczeniu na stronę, podaję, co sprzedaje zamiast tego, a nie wymyślam ceny za stronę.
| Usługa | Darmowy plan | Miesięczny rachunek przy 10K stron | Miesięczny rachunek przy 100K stron | Miesięczny rachunek przy 1M stron | Jak nalicza i czego ta liczba nie uwzględnia |
|---|---|---|---|---|---|
| Thunderbit API | 600 jednostek, jednorazowo | $72 Pro 1 | $120 Pro 2 | Custom quote | Distill liczy 1 jednostkę na stronę, Extract 20. Darmowe jednostki są jednorazowym grantem, a nie miesięcznym limitem, więc niczego nie odejmuję. Samoobsługa kończy się na 480,000 jednostek miesięcznie. |
| Bright Data | 5,000 rekordów/mies. | $7.50 za 10K rekordów | $142.50 za 100K rekordów | $1,293 za 1M rekordów | Naliczanie za rekord — jeden wyekstrahowany element, jeden wiersz w tabeli — a nie za załadowaną stronę, więc jedna strona listy może kosztować wiele rekordów. 5,000 darmowych rekordów odejmuję od wszystkich trzech progów. Przy 1M lepszy jest Scale niż pay-as-you-go: $499 plus 611,000 dodatkowych rekordów po $1.30/1K. |
| Oxylabs | Trial, 2K wyników | $49 Micro | $249 Advanced | $999 Business | Naliczanie za udany wynik według stawki zależnej od strony docelowej i poziomu planu. Liczby na banerze zakładają Amazon bez renderowania JS — na zwykłej stronie przy $1.15 za 1,000 plan Micro za $49 daje około 42,600 wyników, a nie 98,000. Wyniki z triala nie odnawiają się, więc niczego nie odejmuję. |
| Apify | $5 użycia/mies. | Od $29/mies. + usage | Od $29/mies. + usage | Od $29/mies. + usage | Nie rozlicza się za stronę. Opłata planu to przedpłacone usage — $29 Starter, $199 Scale, $999 Business — wydawane na compute units i actorów ze Store, którzy mają własną cenę za wynik, więc sam wolumen stron nie wyznacza rachunku. Proxy to osobny dodatek. |
| ScrapingBee | 1,000 kredytów, jednorazowo | $49 Freelance | $49 Freelance | $99 Startup | 1 kredyt za zwykły request. Renderowanie JS, premium proxy, screenshoty i ekstrakcja AI kosztują kilka kredytów, więc w realnym celu kupujesz dużo mniej stron niż sugeruje liczba na planie. Kredyty po rejestracji nie odnawiają się, więc niczego nie odejmuję. |
| ScraperAPI | Trial 7 dni, 5,000 kredytów | $49 Hobby | $49 Hobby | $149 Startup | 1 kredyt za zwykły request, ale 5 na Amazon i 25 na Google. Przy 100K stron plan Hobby jest wykorzystany w całości, bez rezerwy na retry. Kredyty z triala nie odnawiają się, więc niczego nie odejmuję. |
| ZenRows | 5,000 kredytów/mies. | $19 Build | $39 Build | $199 Growth | 1 kredyt za zwykłą stronę, 25 za stronę wymagającą JS plus premium proxy. 5,000 darmowych kredytów odejmuję najpierw — zostaje 5,000, 95,000 i 995,000 płatnych stron — co nie zmienia progu, na który wpadasz. |
| Octoparse | Darmowy plan, 10 zadań | Od $39/mies. | Od $39/mies. | Od $39/mies. | Cennik zależy od liczby zadań i współbieżności w chmurze, nie od stron, więc wolumen stron nie mapuje się bezpośrednio na plan: Basic $39, Standard $83, Professional $299 w rozliczeniu miesięcznym. Residential proxy i CAPTCHA są sprzedawane jako dodatki: $3/GB i $1–1.5 za tysiąc rozwiązań. |
| Diffbot | 10,000 kredytów/mies. | $0, darmowy plan wystarcza | $299 Startup | $899 Plus | 1 kredyt za wyekstrahowaną stronę. 10,000 darmowych kredytów miesięcznie odejmuję tak samo jak wszędzie: przy 10K pokrywają całość miesiąca, przy 100K zostaje 90,000 stron do kupienia, przy 1M zostaje 990,000. |
| Firecrawl | 1,000 kredytów/mies. | $99 Standard | $99 Standard | $749 Scale | 1 kredyt za scrapowaną stronę. Po odjęciu darmowych kredytów zostaje 9,000 stron do kupienia przy progu 10K, nadal powyżej 5,000 z Hobby, więc plan się nie zmienia. Kredyty poniżej Scale nie przechodzą na kolejny miesiąc. |
| Browse AI | 50 kredytów/mies. | $162 Professional | Custom quote | Custom quote | Rozliczanie w kredytach: strona szczegółowa to jedno zadanie z minimum jednym kredytem, a 10 wierszy także kosztuje jeden kredyt, więc lista 50 wierszy kosztuje pięć. Strony premium kosztują 2–10 razy więcej. Samoobsługa kończy się na 30,000 kredytów miesięcznie, więc wszystko powyżej wymaga wyceny. |
| ScrapeHero | Brak | Od $199/mies. | Od $1,500/mies. | Od $1,500/mies. | Wycena za stronę, złożoność i częstotliwość odświeżania, a nie za wolumen: Business obejmuje do 2 serwisów po 1–5K stron każdy, Enterprise Basic łączy strony na maksymalnie 4 serwisach i dolicza $650–$2,200 za każdy dodatkowy milion. Opłaty za setup są jednorazowe i osobne. |
Kilka ważnych uwag:
- Produkt przeglądarkowy Thunderbit jest liczony po wierszach i skierowany do użytkownika, dlatego w tabeli używam API — konkretnie endpointu Distill, 1 jednostka na stronę Markdown, bo tak działają pozostałe wiersze API. Structured Extract kosztuje 20 jednostek za stronę, co dałoby 10K stron za $240, a nie $72.
- Koszt Apify mocno zależy od runtime actorów, pamięci i dodatkowych usług, takich jak proxy.
- ZenRows, ScrapingBee i ScraperAPI wyglądają tanio na podstawowych publicznych stronach, ale szybko drożeją, gdy wchodzą renderowanie JS, premium proxy albo cele mocno chronione anty-botem.
- Ekonomia jednostkowa ScrapeHero jest inna, bo płacisz za inżynierię, QA i zarządzanie projektem, a nie tylko za compute.
Ukryty koszt, który prawie każda strona cenowa bagatelizuje, to utrzymanie. Same proxy wyglądają taniej na papierze, ale gdy doliczysz retry, utrzymanie parserów, blokowane sesje i godziny pracy inżynierów, bundle’owane usługi scrapingu często wygrywają całkowitym kosztem posiadania.
Jeśli scrapujesz tylko okazjonalnie, taniej jest zacząć po stronie no-code: darmowy plan Thunderbit obejmuje 6 stron miesięcznie, a płatne plany przeglądarkowe zaczynają się od $15/mies. albo około $9/mies. przy rozliczeniu rocznym. Usługi API nie są z wejścia droższe we wszystkich przypadkach — ZenRows i Firecrawl zaczynają się od $19/mies. — ale najmniejszy pakiet, jaki sprzedają, to zwykle tysiące stron miesięcznie, więc płacisz za pojemność, której nie wykorzystasz. Przy pipeline’ach enterprise na poziomie 1M+ stron bardziej opłacają się platformy full-stack lub usługi zarządzane, mimo wyższej ceny katalogowej, bo pakietują koszty proxy.
Dokąd trafiają zebrane dane? Porównanie eksportu i integracji
JSON to nie to samo co Google Sheets. Dla osób nietechnicznych miejsce docelowe danych jest równie ważne jak sama ekstrakcja.
| Usługa | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Natywnie | ✅ Natywnie | ✅ Natywnie | Dostępne API |
| Bright Data | ✅ | ✅ | ❌ Brak natywnego | Pośrednio | Pośrednio | Pośrednio | Mocne API/webhook |
| Oxylabs | ✅ | ✅ | ❌ Brak natywnego | Pośrednio | Pośrednio | Pośrednio | Mocne API |
| Apify | ✅ | ✅ | ✅ | Przez integracje | Przez integracje | Przez integracje | Mocne API |
| ScrapingBee | Przez narzędzia | ✅ | ❌ | ❌ | ❌ | ❌ | Mocne API |
| ScraperAPI | ✅ na endpointach strukturalnych | ✅ | ❌ | ❌ | ❌ | ❌ | Mocne API/webhook |
| ZenRows | Ograniczone | ✅ | ❌ | ❌ | ❌ | ❌ | Mocne API |
| Octoparse | ✅ | ✅ | ✅ | ✅ Natywnie | ⚠️ Przez Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Obsługiwane workflow | Pośrednio | Pośrednio | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Natywnie | ✅ Natywnie | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Dostawa niestandardowa | Dostawa niestandardowa | Dostawa niestandardowa | Niestandardowa dostawa API/DB |
To jedna z największych przewag Thunderbit. Jeśli pracujesz w zespole biznesowym i działasz w Google Sheets lub Notion, usługi API-first dokładają dodatkowe kroki: napisz kod do transformacji JSON, wgraj ręcznie, powtórz. Darmowy eksport Thunderbit do Sheets, Airtable i Notion — wraz z uploadem obrazów do Notion i Airtable — usuwa to tarcie całkowicie. W połączeniu z harmonogramem scrapingu dane mogą płynąć automatycznie do konkretnego miejsca w regularnym rytmie bez żadnego glue code.
Co się dzieje, gdy strona się zmienia? Utrzymanie i niezawodność
Scrapery się psują. To największy problem w tym rynku.
Rynek dzieli się na trzy profile utrzymaniowe:
- Narzędzia oparte na selektorach (Octoparse, wiele actorów Apify, szablony Browse AI): psują się, gdy strona zmienia układ, wymagają ręcznej aktualizacji reguł.
- Usługi API z abstrakcją parserów (structured endpoints ScraperAPI, strukturalne datasety Bright Data): dobrze radzą sobie z popularnymi stronami, ale mają trudniej na długim ogonie lub niszowych witrynach, dla których parser nie był przygotowany.
- Narzędzia AI (Thunderbit, Firecrawl, Diffbot): czytają stronę od nowa przy każdym uruchomieniu, więc większość zmian układu nie wymaga aktualizacji reguł. Tryb awarii zmienia się z „zepsuł się selektor” na „AI źle zinterpretowało stronę” — a to zwykle łatwiej naprawić poprawką promptu niż pełnym przepisaniem selektorów.
Jest też drugie wąskie gardło niezawodności poza driftami układu: radzenie sobie z anty-botami.
- Bright Data, Oxylabs i ZenRows są tu najmocniejsze.
- ScraperAPI i ScrapingBee dobrze radzą sobie z popularnymi, chronionymi celami.
- Browse AI i Octoparse częściej napotykają problemy na mocno chronionych, dynamicznych stronach.
- Tryb przeglądarkowy Thunderbit pomaga na stronach po zalogowaniu i spersonalizowanych, gdzie narzędzia API-only często dokładają złożoność.
Wniosek jest prosty: jeśli chcesz możliwie najmniejszego kosztu utrzymania, ekstrakcja oparta na AI (Thunderbit, Firecrawl, Diffbot) lepiej radzi sobie z driftami układu niż narzędzia selector-based. Jeśli Twoim głównym problemem jest ochrona anty-bot, najlepszym wyborem są Bright Data, Oxylabs i ZenRows. Większość zespołów mierzy się z obiema trudnościami, dlatego decyzja „jaki typ pasuje do Twojego zespołu” z początku artykułu jest ważniejsza niż jakiekolwiek pojedyncze porównanie funkcji.
Aspekty prawne i etyczne web scrapingu
Scraping publicznie dostępnych danych jest często legalny, ale to nie znaczy, że każdy przypadek użycia jest bezpieczny. Zespoły powinny nadal szanować robots.txt tam, gdzie to zasadne, sprawdzać warunki korzystania z serwisu i stosować się do przepisów o prywatności, takich jak GDPR i CCPA, gdy w grę wchodzą dane osobowe. Linia orzeczeń hiQ v. LinkedIn wspiera tezę, że scraping publicznych danych nie jest automatycznie naruszeniem CFAA w USA, ale ryzyka związane z umową, prawem autorskim i prywatnością pozostają osobnymi kwestiami. Dostawcy enterprise, tacy jak Bright Data, Oxylabs i ScrapeHero, wyraźnie komunikują funkcje zgodności i governance. Dla wszystkich pozostałych: przed scrapowaniem na dużą skalę skonsultuj się z prawnikiem w kontekście konkretnego use case’u. Więcej tła znajdziesz w naszym przewodniku o prawnych konsekwencjach web scrapingu.
Którą usługę web scrapingu naprawdę wybrać?
Dość tabel porównawczych. Oto skrót po przetestowaniu wszystkich 12:
Nietechniczne zespoły biznesowe (sprzedaż, operacje, marketing): Thunderbit. Jedno kliknięcie, scraping AI, darmowy eksport do Sheets/Airtable/Notion i dużo mniej poprawek, gdy strona zmienia układ. Usuwa jednocześnie dwa największe źródła tarcia — złożoność konfiguracji i tarcie po eksporcie.
Developerzy budujący pipeline’y scrapingu:
- ScrapingBee, jeśli chcesz najczystszego UX API
- ScraperAPI, jeśli potrzebujesz structured endpoints i cyklicznego monitoringu e-commerce
- ZenRows, jeśli Twoim realnym problemem jest ochrona anty-bot
Zespoły zasilające dane do workflow AI/LLM:
- Firecrawl, jeśli wyjście ma być w Markdown albo schematycznym JSON
- Thunderbit API, jeśli ten sam zespół potrzebuje też ścieżki no-code, bo rozszerzenie i API korzystają z tego samego modelu ekstrakcji
- Diffbot, jeśli budujesz enterprise’ową warstwę wiedzy
Enterprise potrzebujące ogromnej skali i infrastruktury proxy:
- Bright Data dla najszerszego stacku enterprise
- Oxylabs, jeśli najważniejsza jest niezawodność na chronionych celach
Zespoły chcące marketplace gotowych scraperów: Apify.
Firmy oczekujące dostawy bezobsługowej: ScrapeHero.
Zespoły budżetowe potrzebujące monitoringu no-code: Browse AI.
Użytkownicy no-code, którzy chcą wizualnego desktop buildera z większą kontrolą ręczną: Octoparse.
Dla najszerszego grona użytkowników biznesowych nadal wygrywa Thunderbit, bo usuwa dwie bariery, które najczęściej blokują adopcję: techniczną konfigurację i tarcie przy eksporcie. Wypróbuj darmowy plan albo pobierz rozszerzenie Chrome, żeby przekonać się samemu. A jeśli Thunderbit nie będzie idealnym dopasowaniem, sprawdź kilka innych narzędzi z tej listy — nigdy nie było lepszego momentu, żeby przestać kopiować i wklejać ręcznie. Jeśli chcesz zobaczyć, jak te narzędzia działają w praktyce, zajrzyj na kanał Thunderbit na YouTube.
Wypróbuj rozszerzenie Thunderbit do Chrome
FAQ
Czym jest usługa web scrapingu?
Usługa web scrapingu to narzędzie lub zarządzany dostawca, który zbiera dla Ciebie dane ze stron internetowych. Część z nich to aplikacje no-code uruchamiane w przeglądarce, część to API dla developerów, a część to w pełni zarządzane agencje, które dostarczają oczyszczone dane bez konieczności utrzymywania przez Ciebie infrastruktury.
Czy do korzystania z usług web scrapingu potrzebuję umiejętności programowania?
Nie zawsze. Narzędzia takie jak Thunderbit, Browse AI i Octoparse są tworzone z myślą o użytkownikach nietechnicznych. Usługi API, takie jak ScrapingBee, ScraperAPI, Firecrawl i ZenRows, zakładają udział developera. ScrapeHero jest po drugiej stronie — ich zespół prowadzi cały projekt za Ciebie.
Jaka usługa web scrapingu jest najlepsza dla małych firm?
Dla większości małych firm najbezpieczniejszą rekomendacją jest Thunderbit. Ma darmowy plan, który nie wygasa (6 stron miesięcznie), niskie tarcie przy starcie i bezpośrednie eksporty do przyjaznych biznesowi miejsc, takich jak Google Sheets, Airtable i Notion. Browse AI też jest dobrym wyborem, jeśli głównym zastosowaniem jest monitoring zmian w czasie.
Ile kosztują usługi web scrapingu?
Rozpiętość jest duża. Niektóre usługi oferują darmowe plany lub triale. API dla developerów z tej listy zaczynają się mniej więcej od $19 do $49 miesięcznie, a enterprise’owe platformy AI startują znacznie wyżej — Diffbot od $299. Narzędzia no-code zaczynają się zwykle od około $15 do $48 miesięcznie. Usługi enterprise i managed services mogą szybko wejść w setki lub tysiące dolarów miesięcznie. Największa historia kosztowa to nie tylko cena subskrypcji, ale też mnożniki za renderowanie JS, premium proxy oraz czas potrzebny wewnętrznie na utrzymanie scraperów.
Czy korzystanie z usług web scrapingu jest legalne?
Zwykle tak, jeśli chodzi o dane publiczne, ale legalność zależy od strony, typu danych, jurysdykcji i tego, co robisz z wynikami. Kwestie prywatności, praw autorskich i umów nadal mają znaczenie, nawet gdy scrapujesz publiczne strony. W konkretnym przypadku skonsultuj się z prawnikiem.
Wypróbuj Thunderbit do AI web scrapingu Get Started Free
Dowiedz się więcej



