
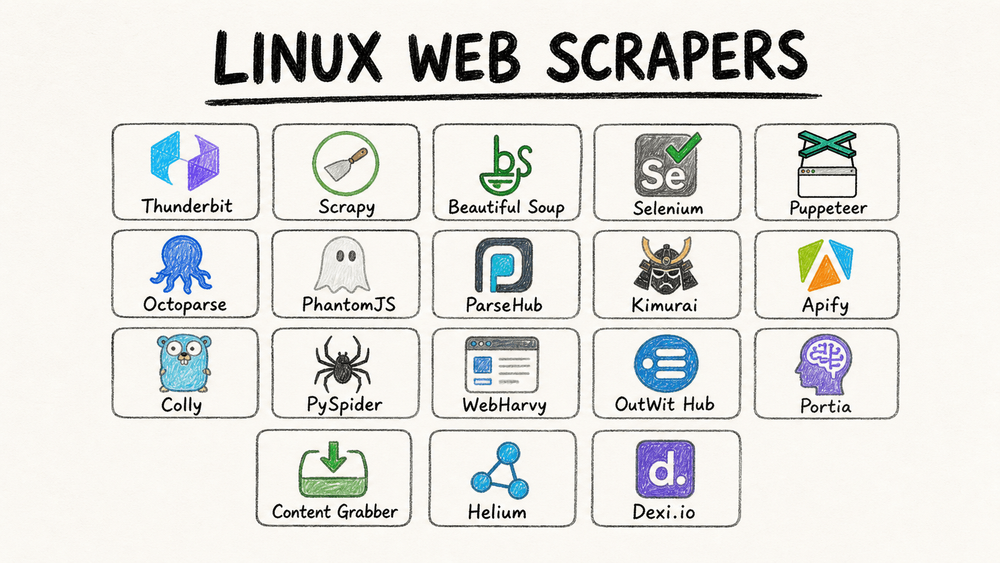
Sieć pęka w szwach od danych — i umówmy się, nikt nie ma czasu, żeby ręcznie kopiować i wklejać tysiące ofert produktowych albo stron z cenami konkurencji. Jeśli pracujesz na Linuxie (tak jak ja przy większości automatyzacji i pracy developerskiej), wiesz już, że ta platforma to prawdziwa potęga dla zespołów opartych na danych. W praktyce systemy z rodziny Unix obsługują 91,9% stron internetowych, dla których znany jest system operacyjny, a Linux jest zdecydowanie najczęściej rozpoznawaną odmianą. Problem zaczyna się jednak wtedy, gdy trzeba znaleźć odpowiedni web scraper dla Linuxa, który naprawdę pasuje do Twojego sposobu pracy — niezależnie od tego, czy jesteś nietechnicznym użytkownikiem biznesowym, czy zaprawionym w bojach programistą.
Właśnie dlatego przygotowałem ten przegląd 18 najlepszych narzędzi do web scrapingu na Linuxie w 2026 roku. Od rozwiązań AI bez kodowania, takich jak Thunderbit (tak, to to narzędzie, które zbudował mój zespół i ja), po klasyczne frameworki dla developerów, jak Scrapy czy Beautiful Soup — ta lista pomoże Ci szybko wybrać najlepszego web scrapera na Linuxa bez męczącego testowania metodą prób i błędów.
Dlaczego narzędzia do web scrapingu na Linuxie są ważne dla biznesu
Oszczędź sobie kopiowania i wklejania, zanim wybierzesz narzędzie Thunderbit działa w Chrome na Twoim Linuxie — bez pakietów, bez sterowników, po prostu uporządkowana tabela jednym kliknięciem. Get Started Free
Bądźmy szczerzy: ręczne zbieranie danych zabija produktywność. Badania pokazują, że zespoły polegające na kopiowaniu i wklejaniu tracą godziny każdego tygodnia i generują błędy na poziomie prawie 5% — a to prosta droga do kosztownych pomyłek i utraconych szans (Thunderbit Blog). Linux, dzięki stabilności, bezpieczeństwu i elastyczności, jest idealną platformą do uruchamiania scraperów, które muszą działać 24/7 — niezależnie od tego, czy pracujesz na komputerze, serwerze czy w chmurze.
Typowe zastosowania biznesowe narzędzi do web scrapingu na Linuxie:
- Pozyskiwanie leadów: zespoły sprzedaży pobierają dane z katalogów, mediów społecznościowych lub serwisów z opiniami, omijając ręczną żmudną pracę (Thunderbit Blog).
- Monitorowanie cen: zespoły e-commerce automatycznie pobierają ceny i stany magazynowe konkurencji, aby utrzymać własne oferty aktualne i konkurencyjne.
- Analiza konkurencji: marketing i operacje śledzą premiery produktów, recenzje i słowa kluczowe SEO — bez działania po omacku.
- Wywiad rynkowy: analitycy agregują wiadomości, fora i dane społecznościowe, aby w czasie rzeczywistym wyłapywać trendy.
- Automatyzacja procesów: niektóre narzędzia, zwłaszcza te oparte na AI, potrafią automatyzować też zadania webowe, takie jak wypełnianie formularzy czy poruszanie się po panelach, bezpośrednio z Twojego Linuxa.
Najlepsze w tym wszystkim jest to, że odpowiednie narzędzie do web scrapingu na Linuxie może dać przewagę także osobom nietechnicznym, a nie tylko programistom — umożliwiając szybsze i mądrzejsze decyzje biznesowe oparte na danych z sieci.
Jak wybraliśmy najlepszego web scrapera dla Linuxa
Nie każdy scraper jest taki sam, zwłaszcza na Linuxie. Oto, na co zwracałem uwagę:
- Zgodność z Linuxem: każde z tych narzędzi działa natywnie na Linuxie, przez przeglądarkę albo z prostym obejściem (np. Wine lub dostępem przez chmurę).
- Łatwość obsługi: od promptów AI w języku naturalnym po wizualne interfejsy typu point-and-click — priorytetem były narzędzia, które pozwalają szybko osiągać efekty osobom bez kodowania, ale nie pomijałem też zaawansowanych użytkowników.
- Moc ekstrakcji danych: czy narzędzie radzi sobie z dynamiczną treścią, paginacją, podstronami i różnymi typami danych? Czy wytrzymuje próby blokowania scrapingu?
- Skalowalność i automatyzacja: harmonogramy, scraping w chmurze, rozproszone crawlingi — to obowiązkowe funkcje w poważnych projektach danych.
- Integracje i eksport: CSV, Excel, Google Sheets, API — jeśli nie możesz wyciągnąć danych z narzędzia, to po co z niego korzystać?
- Cena i licencja: darmowe, open source lub płatne — znajdzie się coś na każdy budżet, od solowych founderów po zespoły enterprise.
- Społeczność i wsparcie: aktywna baza użytkowników, dobra dokumentacja i szybka pomoc techniczna robią ogromną różnicę, gdy pojawi się problem.
W zestawieniu uwzględniłem też opinie użytkowników, recenzje branżowe oraz własne doświadczenia z tymi narzędziami. Zaczynajmy.
1. Thunderbit
 Thunderbit to mój główny wybór dla użytkowników biznesowych, którzy chcą web scrapera dla Linuxa naprawdę prostego w obsłudze. Jako rozszerzenie Chrome oparte na AI działa bez problemu na Linuxie (wystarczy Chrome lub Chromium) i pozwala wyciągać dane z dowolnej strony jednym kliknięciem.
Co wyróżnia Thunderbit:
- Prompty w języku naturalnym: wystarczy opisać, czego potrzebujesz („Wyciągnij z tej strony wszystkie nazwy produktów i ceny”), a AI Thunderbit zrobi resztę.
- Sugestie pól przez AI: jedno kliknięcie i Thunderbit analizuje stronę, proponując kolumny i typy danych — bez ręcznego wybierania pól.
- Scraping podstron i paginacji: potrzebujesz więcej szczegółów? Thunderbit może odwiedzać kolejne podstrony (np. strony produktów) i automatycznie wzbogacać tabelę.
- Scraping w chmurze lub lokalnie: możesz pobierać do 50 stron naraz w chmurze albo użyć trybu przeglądarki dla witryn wymagających logowania.
- Błyskawiczny eksport: eksport jednym kliknięciem do Excel, Google Sheets, Airtable, Notion, CSV lub JSON — zawsze za darmo.
- Dodatkowe narzędzia: wyciąganie e-maili, numerów telefonów i obrazów jednym kliknięciem. AI autofill może też automatyzować wypełnianie formularzy.
Cennik: darmowy plan (6 stron/miesiąc), płatne plany od 15 USD/mies. za 500 wierszy (Thunderbit Pricing). Użytkownicy chwalą brak krzywej uczenia się i to, że narzędzie „zamienia godziny pracy w minuty” (Product Hunt Reviews). Przy większych zadaniach może być potrzebny podział na mniejsze uruchomienia, ale w większości zastosowań biznesowych oszczędza mnóstwo czasu.
Zgodność z Linuxem: 100%. Wystarczy uruchomić Chrome/Chromium na Linuxie, na komputerze albo serwerze.
Dla kogo najlepszy: dla nietechnicznych użytkowników biznesowych (sprzedaż, marketing, operacje), którzy chcą najszybszej i najłatwiejszej konfiguracji.
Wypróbuj Thunderbit za darmo na Linuxie Działa w Chrome na każdym Linuxie — bez budowania pakietów, bez instalowania sterowników, ekstrakcja jednym kliknięciem. Get Started Free
2. Scrapy
 Scrapy to złoty standard dla programistów Python, którzy chcą elastycznego i skalowalnego web scrapera dla Linuxa. Jest open source, błyskawiczny (asynchroniczny crawling) i radzi sobie zarówno z prostymi zadaniami, jak i ogromnymi, rozproszonymi crawlami.
Najważniejsze cechy:
- Asynchroniczny, szybki crawling — idealny do tysięcy stron.
- Duża rozszerzalność: wtyczki do proxy, CAPTCHA i wielu innych funkcji.
- Integracja ze stosem danych w Pythonie: eksport do JSON, CSV, baz danych lub pandas.
- Obsługa cookies, sesji i automatycznego throttlingu.
Cennik: w 100% darmowy i open source.
Zgodność z Linuxem: natywna (instalacja przez pip). Świetnie działa na serwerach i w kontenerach.
Dla kogo najlepszy: dla developerów tworzących własne, duże scrapers.
Warto wiedzieć: dla osób bez kodowania narzędzie ma sporą krzywą uczenia się, ale jeśli znasz Pythona, trudno znaleźć coś lepszego.
3. Beautiful Soup
 Beautiful Soup to lekka biblioteka Pythona do parsowania HTML i XML. To narzędzie pierwszego wyboru do szybkiego, prostego scrapingu albo porządkowania niechlujnych stron internetowych.
Najważniejsze cechy:
- Proste, przyjazne API — świetne dla początkujących.
- Dobrze współpracuje z requests przy pobieraniu stron.
- Radzi sobie z uszkodzonym HTML-em.
Cennik: darmowy i open source.
Zgodność z Linuxem: 100% (czysty Python).
Dla kogo najlepszy: dla developerów i data scientistów realizujących małe i średnie zadania scrapingu lub parsowania.
Ograniczenia: nie obsługuje JavaScriptu ani dynamicznej treści — jeśli tego potrzebujesz, połącz go z Selenium albo Puppeteer.
4. Selenium
 Selenium to klasyczny framework do automatyzacji przeglądarki. Pozwala sterować Chrome, Firefoxem i innymi przeglądarkami, aby scrapować strony dynamiczne i mocno oparte na JavaScript.
Najważniejsze cechy:
- Automatyzuje prawdziwe przeglądarki — może logować się, klikać, przewijać i wchodzić w interakcję jak człowiek.
- Obsługuje Python, Javę, C# i inne języki.
- Tryb headless do uruchamiania na serwerach Linux.
Cennik: darmowy i open source.
Zgodność z Linuxem: pełna (wystarczy zainstalować odpowiedni sterownik przeglądarki).
Dla kogo najlepszy: dla inżynierów QA, developerów scrapingu i wszystkich, którzy muszą symulować zachowanie użytkownika.
Warto wiedzieć: jest bardziej zasobożerny i wolniejszy niż scraper HTTP, ale czasem to jedyny sposób, by zdobyć potrzebne dane.
5. Puppeteer
 Puppeteer to biblioteka Node.js od Google do sterowania headless Chrome/Chromium. To coś w rodzaju Selenium, ale z nowoczesnym API w JavaScript i mocną integracją z funkcjami Chrome.
Najważniejsze cechy:
- Uruchamia JavaScript, obsługuje dynamiczną treść i robi zrzuty ekranu.
- Szybki, stabilny i wygodny dla developerów Node.js.
- Przechwytuje żądania sieciowe i blokuje niechciane zasoby.
Cennik: darmowy i open source.
Zgodność z Linuxem: instaluje Chromium automatycznie; domyślnie działa w trybie headless.
Dla kogo najlepszy: dla developerów scrapujących nowoczesne aplikacje webowe lub strony typu single-page.
6. Octoparse
 Octoparse to no-code web scraper z interfejsem drag-and-drop i ogromną liczbą gotowych szablonów. Choć aplikacja desktopowa działa tylko na Windows/Mac, użytkownicy Linuxa mogą korzystać z platformy chmurowej przez przeglądarkę albo uruchomić aplikację Windows przez Wine.
Najważniejsze cechy:
- Ponad 100 gotowych szablonów dla takich serwisów jak Amazon, eBay, Zillow i inne.
- Wizualny kreator workflow — budujesz scraper klikaniem.
- Scraping w chmurze i harmonogramy — pozwól, by serwery Octoparse zrobiły ciężką pracę.
- Eksport do Excel, CSV, JSON i baz danych.
Cennik: darmowy plan (10 zadań, ok. 50 tys. wierszy/mies.). Płatne plany zaczynają się od 69 USD/mies. za Standard (rozliczenie roczne); Professional kosztuje 249 USD/mies. (Octoparse Pricing)
Zgodność z Linuxem: dostęp przez chmurę/przeglądarkę; aplikacja desktopowa przez Wine.
Dla kogo najlepszy: dla osób bez kodowania, które szybko potrzebują danych z e-commerce lub marketplace’ów.
7. PhantomJS
 PhantomJS to headless browser WebKit, który kiedyś był popularnym wyborem do lekkiej automatyzacji przeglądarki. Dziś jest już przestarzały, ale nadal działa na Linuxie w starszych lub prostych projektach.
Najważniejsze cechy:
- Skryptowanie w JavaScript.
- Obsługuje umiarkowanie złożony JavaScript i robi zrzuty ekranu/PDF-y.
- Nie wymaga GUI.
Cennik: darmowy i open source.
Zgodność z Linuxem: natywny binarny plik.
Dla kogo najlepszy: dla projektów legacy albo środowisk, w których nie da się zainstalować Chrome.
Uwaga: oficjalnie wycofany w 2017 roku, rozwój zakończono w marcu 2018, a ostatnia wersja to v2.1.1. Brak poprawek bezpieczeństwa, brak nowoczesnego silnika JS, problemy na większości współczesnych stron. Do nowych projektów lepiej użyć Puppeteer albo Playwright. W tym zestawieniu pojawia się dlatego, że wciąż można go spotkać w starszych linuxowych stackach scrapingu, które możesz odziedziczyć.
8. ParseHub
 ParseHub to wizualny, wieloplatformowy web scraper z natywną aplikacją na Linuxa. To świetny wybór dla osób bez kodowania, które chcą scrapować złożone, dynamiczne strony.
Najważniejsze cechy:
- Interfejs point-and-click — wybierasz elementy i budujesz workflow wizualnie.
- Obsługuje dynamiczną treść, mapy, infinite scroll i wiele więcej.
- Uruchamianie w chmurze i harmonogramy.
- Eksport do CSV, JSON lub przez API.
Cennik: darmowy plan (5 projektów), płatne plany od 189 USD/mies.
Zgodność z Linuxem: natywna aplikacja na Linux, Windows i Mac.
Dla kogo najlepszy: dla analityków i użytkowników półtechnicznych, którzy chcą kontroli bez programowania.
9. Kimurai
 Kimurai to framework do web scrapingu w Ruby, który działa natywnie na Linuxie. To odpowiednik Scrapy, ale dla programistów Ruby.
Najważniejsze cechy:
- Obsługa wielu przeglądarek: headless Chrome, Firefox, PhantomJS albo zwykły HTTP.
- Asynchroniczne przetwarzanie dla wysokiej współbieżności.
- Czytelny Ruby DSL do pisania spiderów.
Cennik: darmowy i open source.
Zgodność z Linuxem: 100% (Ruby).
Dla kogo najlepszy: dla programistów Ruby albo zespołów Rails potrzebujących własnego, wydajnego scrapingu.
10. Apify
 Apify to platforma chmurowa do web scrapingu z open-source’owymi SDK i marketplace’em gotowych „actorów”. Możesz uruchamiać scrapers lokalnie na Linuxie albo w chmurze.
Najważniejsze cechy:
- SDK dla Node.js, Pythona i innych technologii.
- Marketplace gotowych scraperów.
- Uruchamianie w chmurze, harmonogramy i integracja z API.
Cennik: darmowy plan, płatność za użycie w chmurze.
Zgodność z Linuxem: CLI/SDK działa na Linuxie; platforma chmurowa dostępna przez przeglądarkę.
Dla kogo najlepszy: dla developerów, którzy chcą połączyć własny kod z gotową infrastrukturą chmurową.
11. Colly
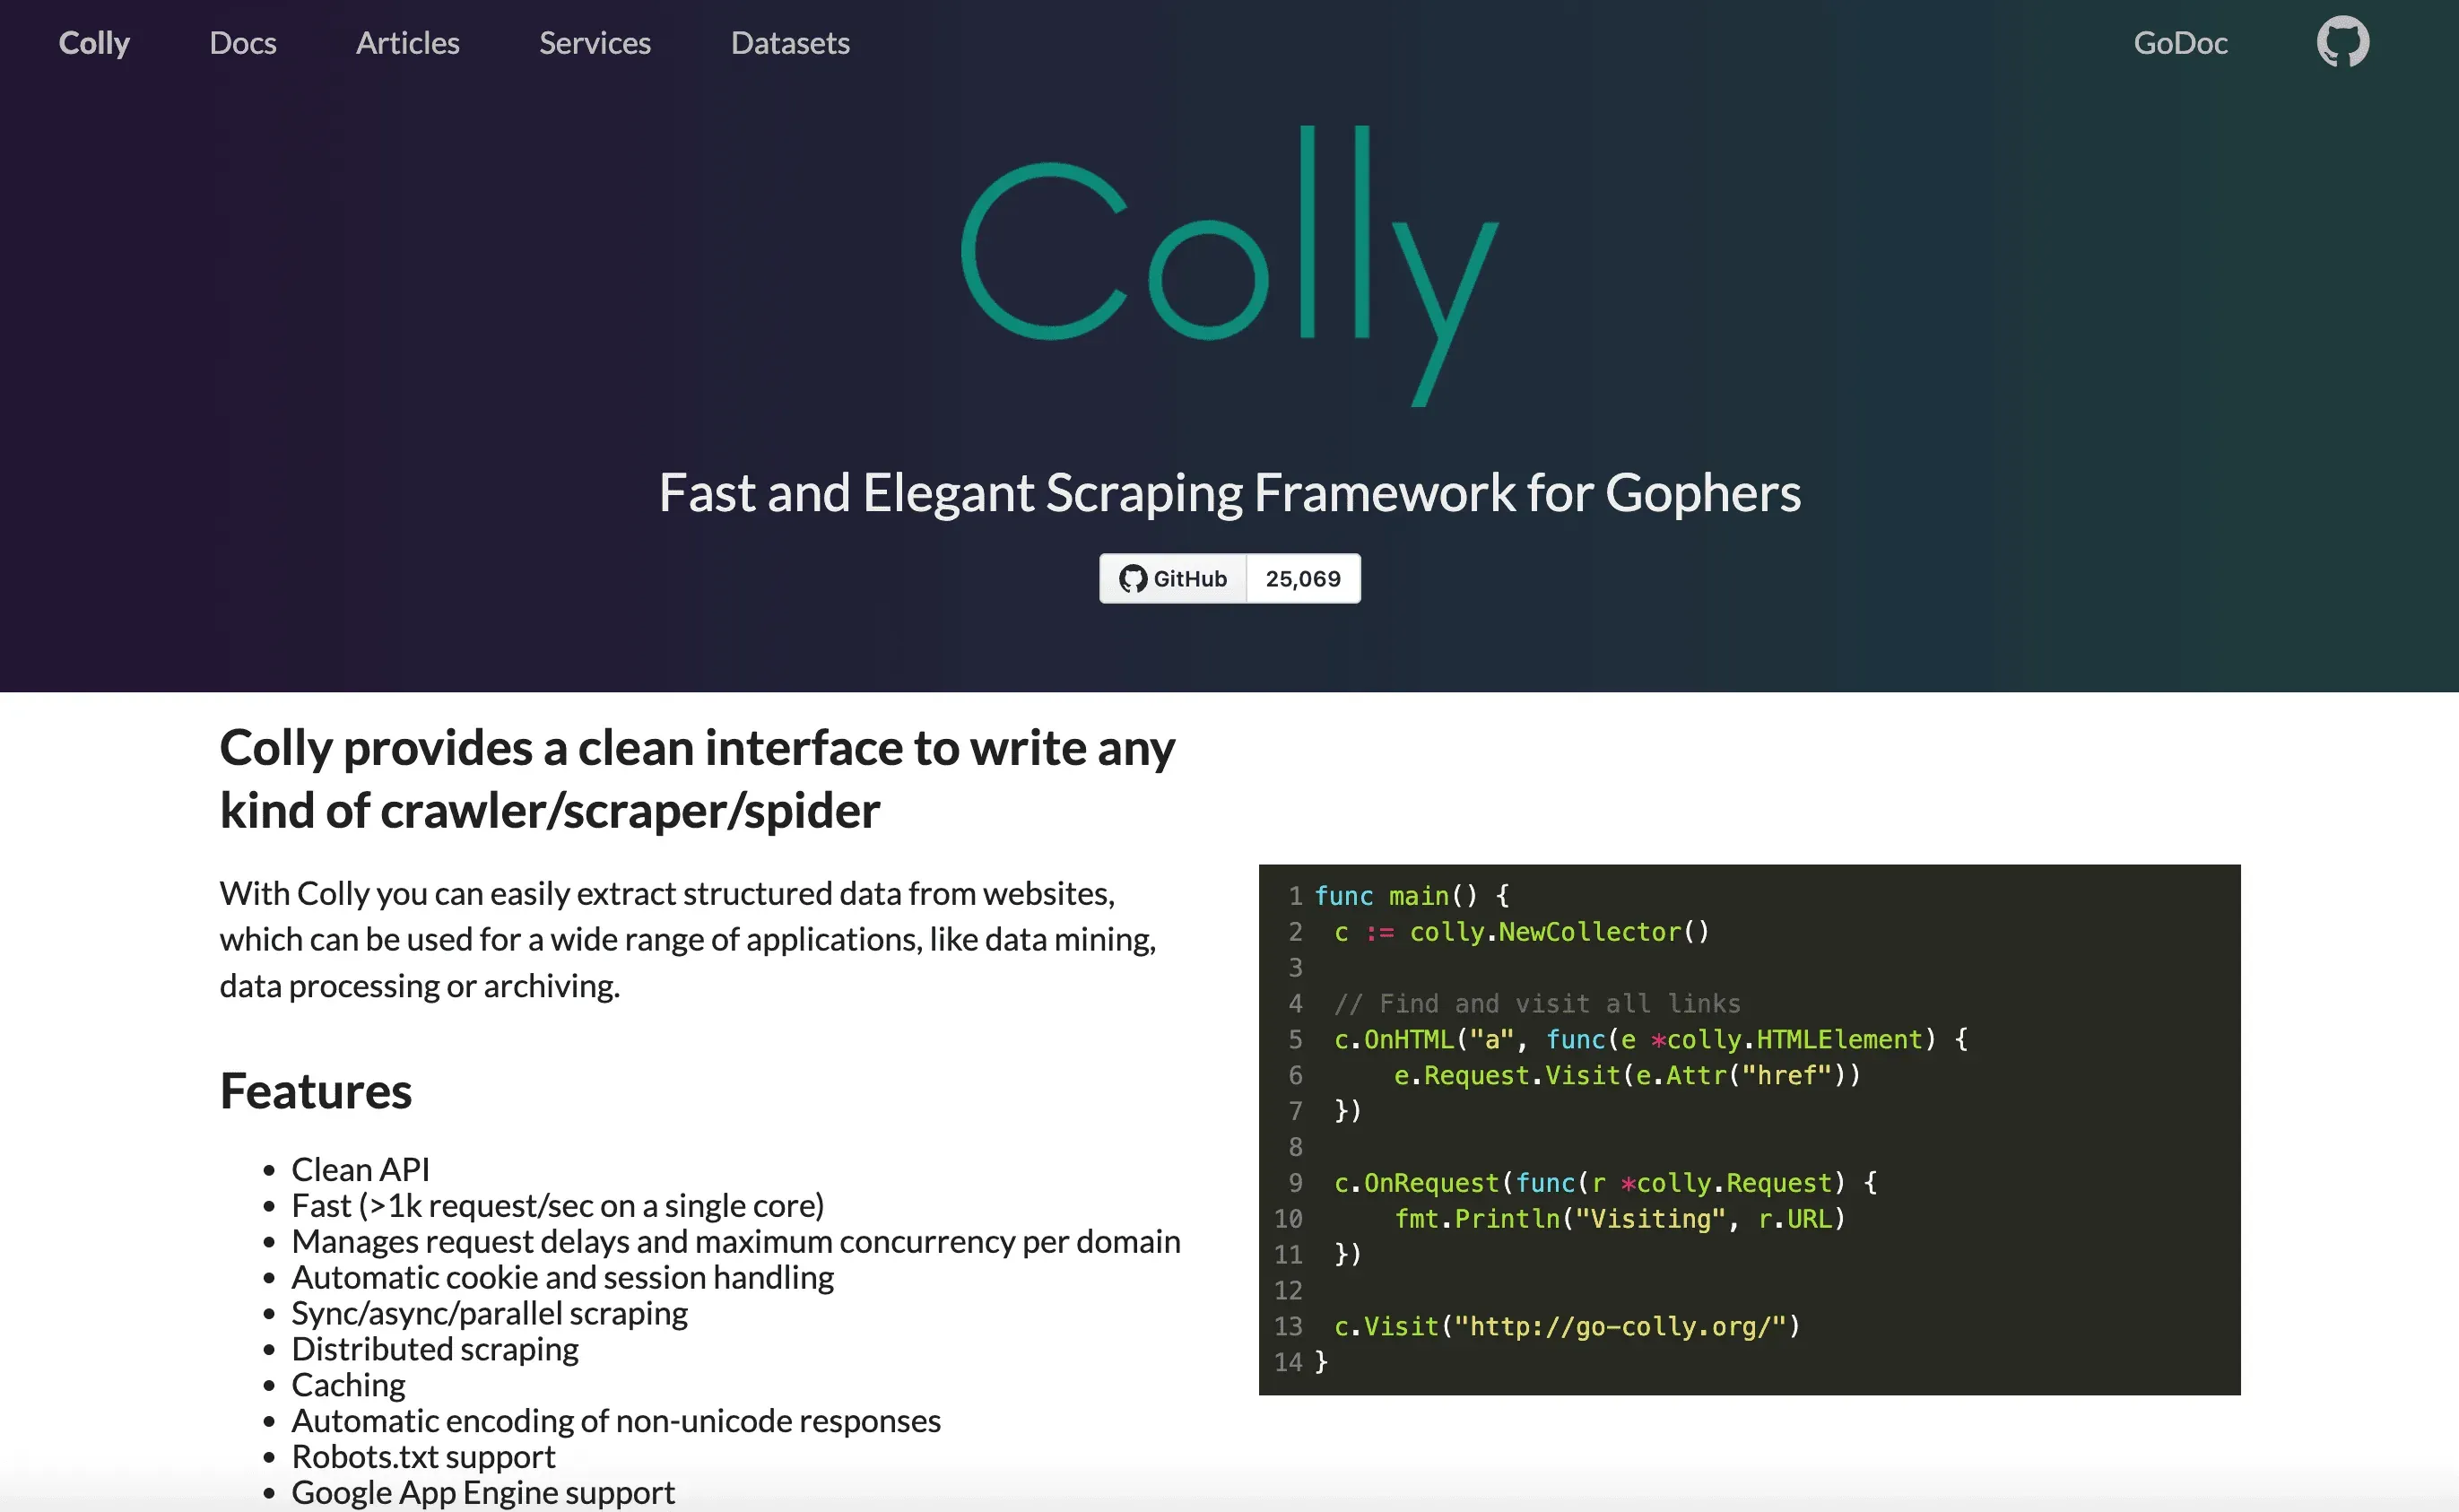 Colly to framework do web scrapingu w Go, stworzony z myślą o szybkości i efektywności. Jeśli programujesz w Go, to narzędzie dla Ciebie.
Najważniejsze cechy:
- Bardzo szybki, współbieżny scraping — ponad 1000 zapytań/s na jednym rdzeniu.
- Kulturalny crawling (respektuje robots.txt), zarządzanie sesjami i cookies.
- Niewielkie zużycie pamięci.
Cennik: darmowy i open source.
Zgodność z Linuxem: natywne binaria Go.
Dla kogo najlepszy: dla developerów Go potrzebujących wysokiej wydajności.
12. PySpider
 PySpider to system do crawlowania stron w Pythonie z interfejsem webowym — możesz zarządzać crawlami, planować je i monitorować z poziomu przeglądarki. Warto zaznaczyć od razu: repozytorium zostało oznaczone jako public archive na GitHubie, a oryginalny autor nie wydaje już nowych wersji, więc dostajesz dokładnie to, co jest dostępne teraz. Jeśli potrzebujesz tylko jego panelu UI na Linuxie, nadal działa; ale do długoterminowych projektów traktuj go jako rozwiązanie legacy.
Najważniejsze cechy:
- Interfejs webowy do skryptowania i monitoringu.
- Rozproszone crawlingi, harmonogramy i ponawianie prób.
- Integracja z bazami danych i kolejkami wiadomości.
Cennik: darmowy i open source.
Zgodność z Linuxem: zaprojektowany z myślą o wdrożeniach na Linuxie.
Dla kogo najlepszy: dla zespołów, które nie boją się forka i samodzielnego utrzymania web UI do wielu projektów scrapingu (nie licz na poprawki z upstreamu).
13. WebHarvy
 WebHarvy to wizualny scraper point-and-click dla Windows, ale użytkownicy Linuxa mogą uruchamiać go przez Wine. Jest znany z rozpoznawania wzorców i modelu jednorazowego zakupu.
Najważniejsze cechy:
- Przeglądasz i klikasz, aby wybrać dane — bez kodowania.
- Automatyczne wykrywanie wzorców list.
- Eksport do CSV, JSON, XML i SQL.
Cennik: około 129 USD za licencję jednorazową.
Zgodność z Linuxem: działa pod Wine lub w VM.
Dla kogo najlepszy: dla początkujących lub solowych profesjonalistów, którzy chcą szybkiego, wizualnego scrapera.
14. OutWit Hub
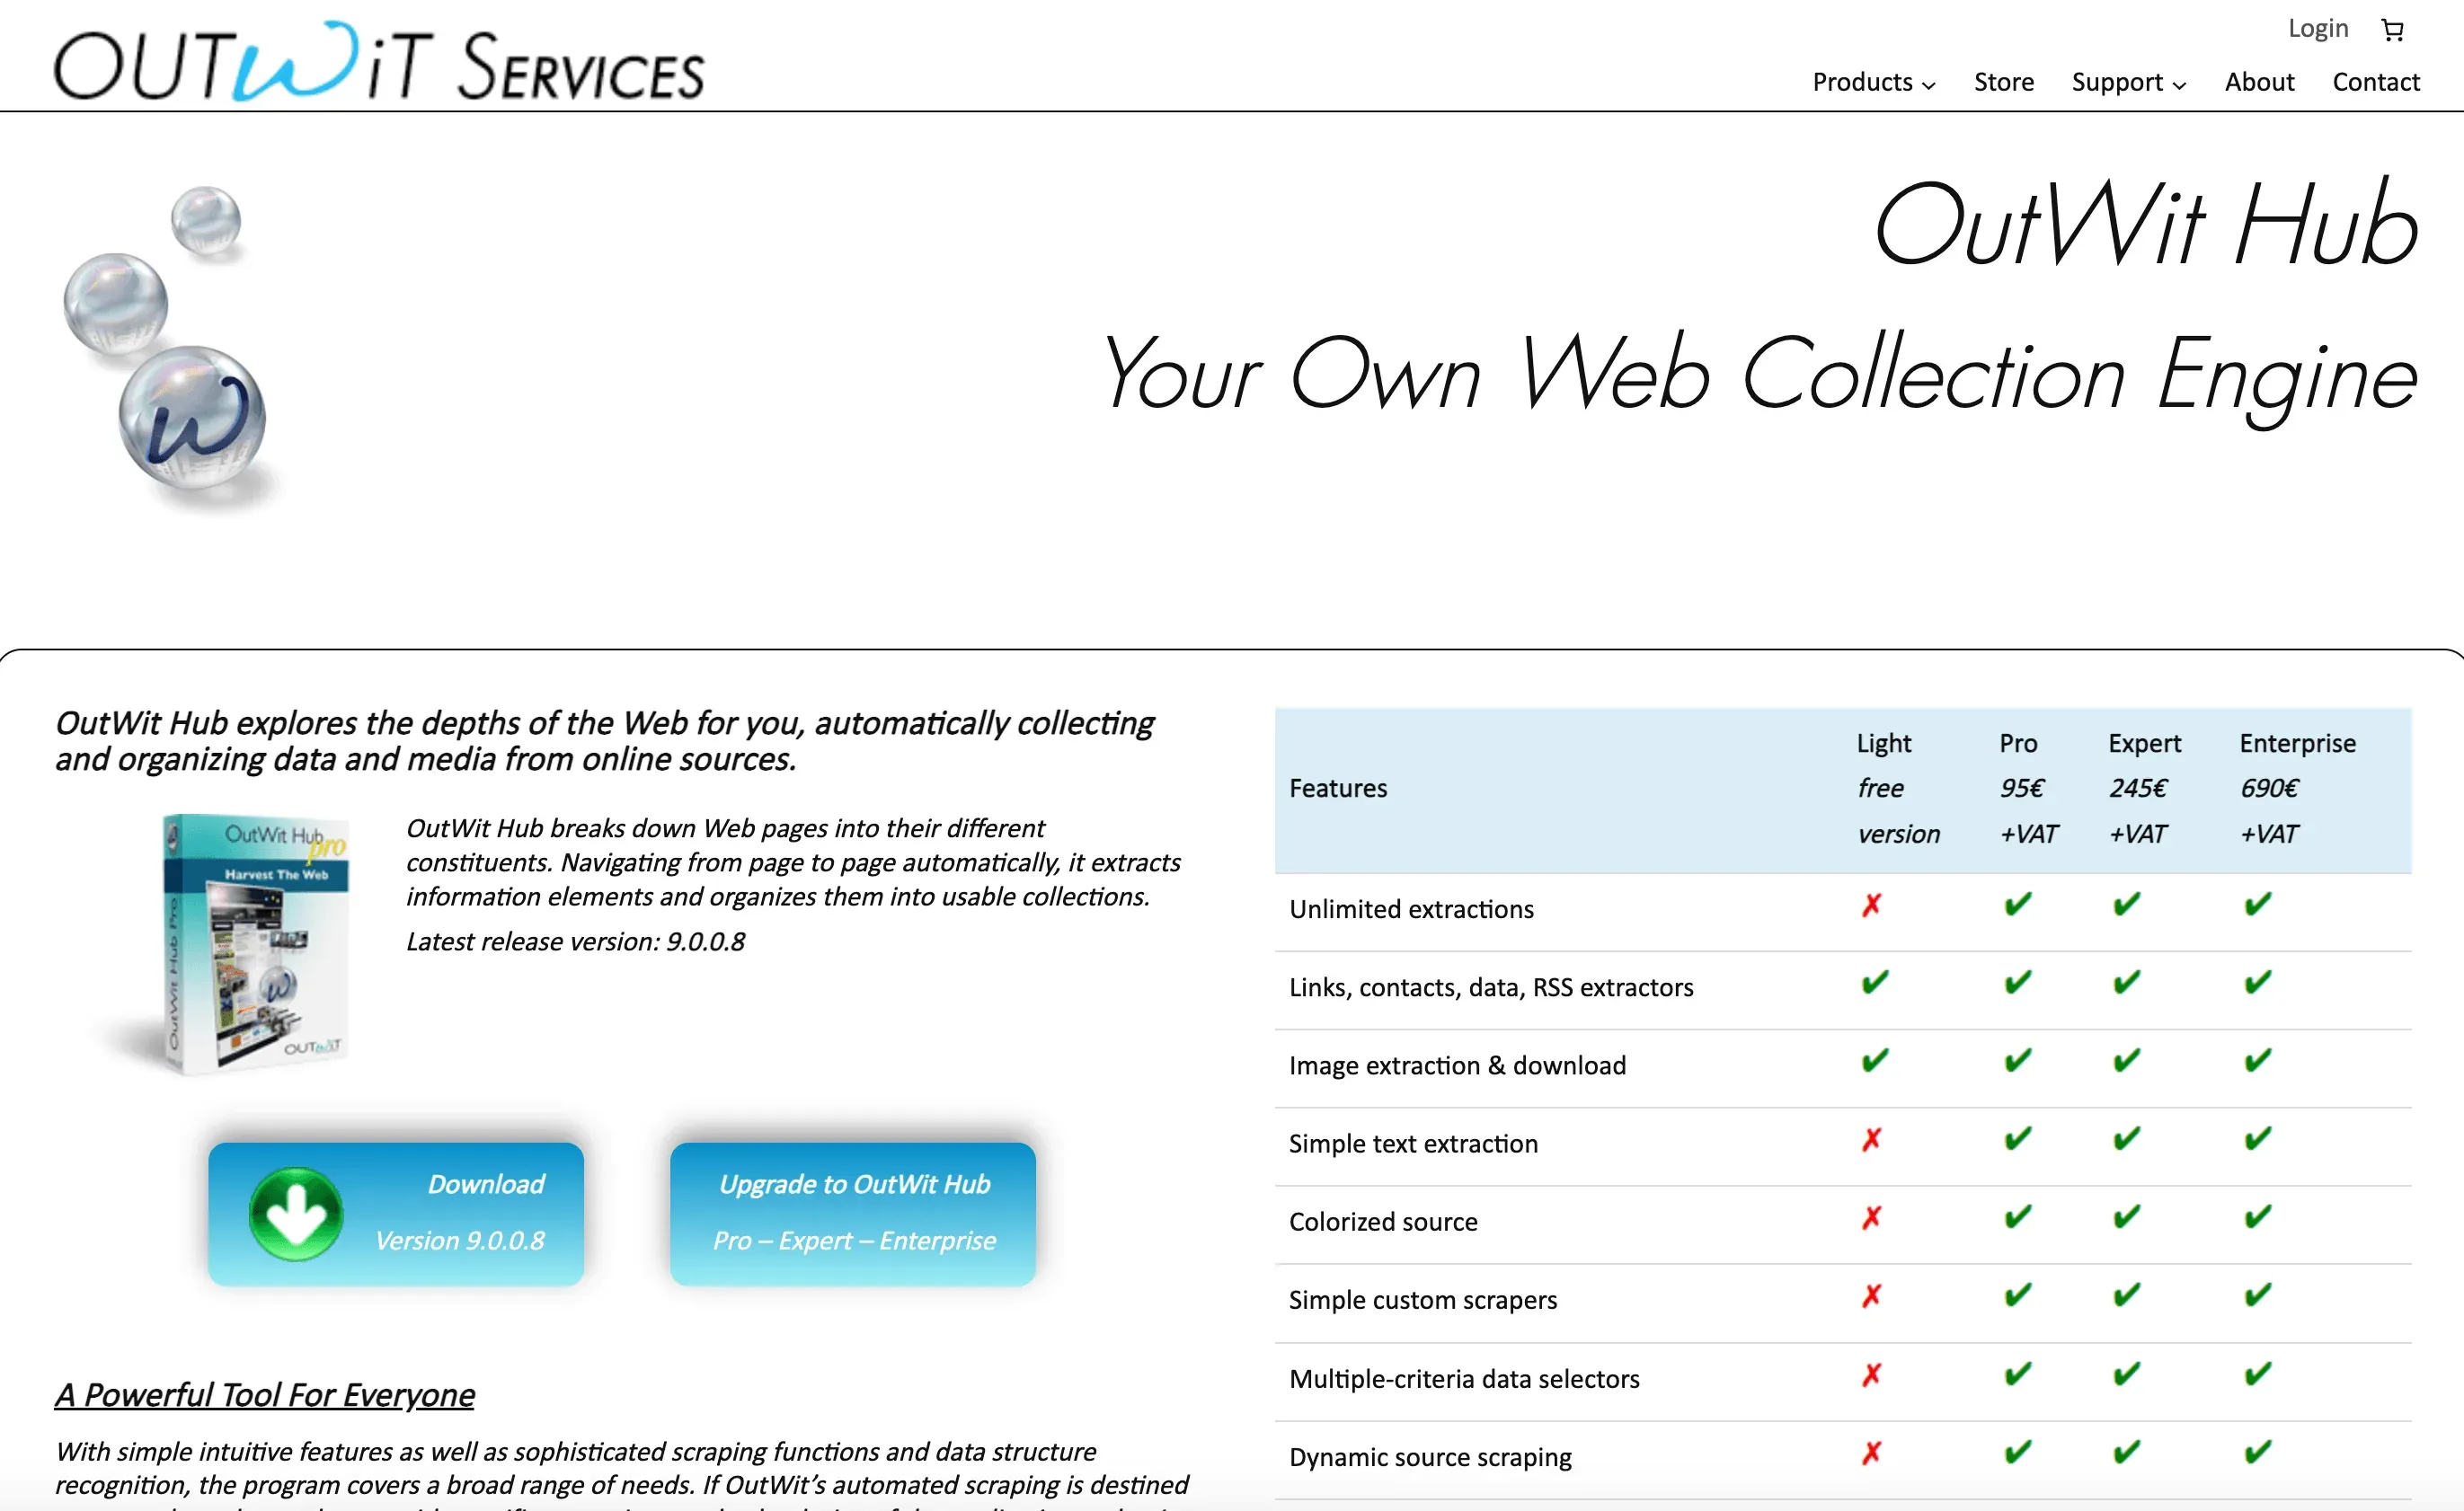 OutWit Hub to natywna aplikacja GUI na Linuxa do web scrapingu. Automatycznie rozpoznaje wzorce danych i oferuje mocne funkcje ekstrakcji oraz automatyzacji.
Najważniejsze cechy:
- Automatycznie wykrywa linki, obrazy, tabele, e-maile i wiele więcej.
- Edytor skryptów do własnych reguł ekstrakcji.
- Automatyzacja makr i harmonogramy.
Cennik: darmowa wersja (z ograniczeniami); płatna licencja Pro — aktualne ceny sprawdź w sklepie producenta.
Zgodność z Linuxem: natywna aplikacja na Linux, Windows i Mac.
Dla kogo najlepszy: dla osób bez kodowania, które mają trochę technicznego zacięcia i chcą desktopowego scrapera GUI.
15. Portia
 Portia to open-source’owy, wizualny web scraper od Scrapinghub. Działa w przeglądarce i pozwala oznaczać elementy na stronach, aby trenować scrapers — ale uwaga: repo nie było aktywnie rozwijane od ponad roku, więc jest już mocno „na własne ryzyko”. Jeśli chcesz podobny pomysł z aktywnym rozwojem, lepszym wyborem będą ParseHub albo Thunderbit.
Najważniejsze cechy:
- Interfejs przeglądarkowy do wizualnej ekstrakcji.
- Integracja ze Scrapy w projektach własnych.
- Open source i łatwo rozszerzalny.
Cennik: darmowy i open source.
Zgodność z Linuxem: oparty na przeglądarce; działa na każdym systemie.
Dla kogo najlepszy: dla osób szukających open source’owego, wizualnego scrapingu z integracją Scrapy.
16. Sequentum Enterprise (dawniej Content Grabber)
 Sequentum Enterprise to enterprise’owy wizualny scraper dla Windows, ale można go uruchamiać na Linuxie przez Wine lub wirtualizację.
Najważniejsze cechy:
- Edytor wizualny plus skrypty C# do zaawansowanej logiki.
- Zarządzanie wieloma agentami i harmonogramy.
- Integracja z bazami danych, API i nie tylko.
Cennik: licencjonowanie enterprise, wycena indywidualna per wdrożenie.
Zgodność z Linuxem: przez Wine lub VM.
Dla kogo najlepszy: dla agencji i dużych zespołów zarządzających wieloma projektami scrapingu.
17. Helium
 Helium to biblioteka Pythona upraszczająca automatyzację Selenium. Została stworzona po to, by skryptowanie przeglądarki było bardziej „ludzkie” i przystępne.
Najważniejsze cechy:
- Intuicyjne komendy, takie jak
click("Login")czywrite("email"). - Automatyzacja Chrome i Firefoksa.
- Świetne do szybkich skryptów i zadań automatyzacyjnych.
Cennik: darmowy i open source.
Zgodność z Linuxem: działa na Linuxie (bazuje na Selenium).
Dla kogo najlepszy: dla użytkowników Pythona, którzy uważają Selenium za zbyt ciężkie w obsłudze.
18. Dexi.io
 Dexi.io to platforma chmurowa do ekstrakcji danych i automatyzacji. Działa przez przeglądarkę, więc użytkownicy Linuxa mogą korzystać z niej bez instalacji.
Najważniejsze cechy:
- Wizualny kreator workflow do scrapingu i automatyzacji.
- Harmonogramy, transformacja danych i integracja z API.
- Skalowalność i wsparcie klasy enterprise.
Cennik: obecnie sprzedawane przez Mozenda: darmowy 14-dniowy trial, plan Pilot za 500 USD/mies., enterprise wycena indywidualna.
Zgodność z Linuxem: aplikacja webowa — działa na każdym systemie.
Dla kogo najlepszy: dla profesjonalistów i firm potrzebujących skalowalnej, zintegrowanej ekstrakcji danych z sieci.
Szybka tabela porównawcza: narzędzia do web scrapingu na Linuxie w skrócie
| Narzędzie | Typ / najważniejsze cechy | Dla kogo | Cena | Zgodność z Linuxem |
|---|---|---|---|---|
| Thunderbit | Rozszerzenie AI do Chrome, 1 kliknięcie, podstrony, cloud/local | Nietechniczni użytkownicy biznesowi | Darmowe, od 15 USD/mies. | ✔ Chrome na Linuxie |
| Scrapy | Framework Pythona, async, CLI, duża rozszerzalność | Developerzy, duże własne scrapers | Darmowe | ✔ Natywne |
| Beautiful Soup | Biblioteka Pythona, proste parsowanie HTML/XML | Developerzy, data science, małe zadania | Darmowe | ✔ Natywne |
| Selenium | Automatyzacja przeglądarki, strony z JS | QA, developerzy, dynamiczna treść | Darmowe | ✔ Natywne |
| Puppeteer | Node.js, headless Chrome, renderowanie JS | Developerzy Node, nowoczesne aplikacje web | Darmowe | ✔ Natywne |
| Octoparse | No-code, drag-and-drop, szablony w chmurze | Osoby bez kodowania, e-commerce | Darmowe, od 69 USD/mies. | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, skryptowalny JS | Legacy, lekkie zadania, bez Chrome | Darmowe | ✔ Natywne |
| ParseHub | Wizualny, wieloplatformowy, point-and-click | Analitycy, użytkownicy półtechniczni | Darmowe, od 189 USD/mies. | ✔ Natywne |
| Kimurai | Framework Ruby, wiele przeglądarek, async | Developerzy Ruby, wysoka współbieżność | Darmowe | ✔ Natywne |
| Apify | Platforma chmurowa, SDK, marketplace | Developerzy, hybryda własny kod/chmura | Darmowy plan, opłata za użycie | ✔ Natywne/Chmura |
| Colly | Framework Go, szybki, współbieżny | Developerzy Go, wysoka wydajność | Darmowe | ✔ Natywne |
| PySpider | Python, UI web, harmonogramy, rozproszony | Zespoły, wiele projektów | Darmowe | ✔ Natywne |
| WebHarvy | Wizualny, wykrywanie wzorców, jednorazowa licencja | Początkujący, osoby solo | Około 129 USD jednorazowo | ◐ Wine/VM |
| OutWit Hub | Natywne GUI, automatyczne wykrywanie danych, skrypty | Osoby bez kodowania, desktopowe GUI | Darmowe; Pro płatne | ✔ Natywne |
| Portia | Open source, wizualny, w przeglądarce | Open source, integracja ze Scrapy | Darmowe | ✔ Przeglądarka |
| Sequentum Enterprise | Enterprise, wizualny, skrypty, multi-agent | Agencje, duże zespoły | $$$, wycena indywidualna | ◐ Wine/VM |
| Helium | Python, uproszczone Selenium, intuicyjne API | Użytkownicy Pythona, szybka automatyzacja | Darmowe | ✔ Natywne |
| Dexi.io | Chmura, wizualny workflow, harmonogramy, API | Enterprise, skalowalna automatyzacja | Od 500 USD/mies. (przez Mozenda) | ✔ Przeglądarka |
Jak wybrać odpowiedni web scraper dla Linuxa: najważniejsze kryteria
Nie wiesz, jaki plan wybrać? Zacznij od najprostszego rozwiązania Jeśli nie chcesz utrzymywać selektorów, pozwól AI samo rozpoznać pola — jedno kliknięcie, a potem eksport do Sheets, Excel, Airtable lub Notion. Get Started Free
Dobór właściwego narzędzia sprowadza się do dopasowania go do Twoich potrzeb i umiejętności:
- Poziom techniczny: osoby bez kodowania powinny patrzeć w stronę Thunderbit, ParseHub, Octoparse lub OutWit Hub. Developerzy mogą wycisnąć więcej z Scrapy, Puppeteer, Colly czy Kimurai.
- Złożoność danych: dla statycznych stron wystarczą Beautiful Soup lub Colly. Dla dynamicznych stron opartych na JavaScript potrzebujesz Selenium, Puppeteer albo narzędzia wizualnego z obsługą JS.
- Skala i częstotliwość: do jednorazowych zadań wystarczą narzędzia no-code albo scrapers w chmurze. Do cyklicznych, dużych crawlów wybierz Scrapy, PySpider albo Apify.
- Potrzeby integracyjne: chcesz eksportować do Excel, Sheets albo bazy danych? Upewnij się, że narzędzie wspiera Twój workflow.
- Budżet: dla programistów dostępnych jest mnóstwo darmowych i open-source’owych opcji. Dla użytkowników biznesowych Thunderbit i ParseHub oferują przystępne progi wejścia, a zespoły enterprise mogą inwestować w Dexi.io lub Sequentum Enterprise.
- Wsparcie i społeczność: narzędzia open source mają duże społeczności; narzędzia komercyjne oferują dedykowane wsparcie.
Pro tip: nie bój się łączyć narzędzi. Użyj Thunderbit do prototypowania i wykrywania wzorców danych, a potem przejdź na Scrapy w produkcyjnej skali. Albo użyj Selenium do logowania i pobrania ciasteczek sesji, a następnie przekaż zadanie Colly lub Scrapy, żeby wykonywały szybki scraping.
Podsumowanie: znajdź najlepsze narzędzie do web scrapingu na Linuxa w 2026 roku
Użytkownicy Linuxa mają w 2026 roku naprawdę ogromny wybór. Niezależnie od tego, czy chcesz narzędzie no-code oparte na AI, które daje wyniki w kilka minut (Thunderbit), solidny framework dla developerów (Scrapy, Colly), czy platformę klasy enterprise (Dexi.io) — znajdziesz web scrapera dla Linuxa dopasowanego do Twoich potrzeb i sposobu pracy.
Najważniejsze wnioski:
- Linux jest fundamentem nowoczesnej infrastruktury danych — większość najlepszych scraperów działa natywnie albo przez przeglądarkę.
- Narzędzia AI i no-code demokratyzują web scraping dla użytkowników biznesowych.
- Frameworki dla developerów nadal wygrywają pod względem elastyczności, szybkości i skali.
- Zawsze testuj przed zakupem — większość narzędzi oferuje darmowe plany lub wersje próbne.
Gotowy, żeby zacząć? Pobierz Thunderbit albo sprawdź blog Thunderbit, aby znaleźć więcej poradników o web scrapingu, automatyzacji i rozwoju opartym na danych.
Poznaj AI Web Scraper od Thunderbit Omiń skrypty i cron joby — pozwól AI odczytać stronę i oddać Ci tabelę jednym kliknięciem. Get Started Free
FAQ
1. Jaki jest najprostszy web scraper na Linuxa, jeśli nie umiem programować?
Thunderbit to najlepszy wybór dla osób nietechnicznych. Działa jako rozszerzenie Chrome na Linuxie, wykorzystuje AI do automatyzacji wszystkiego i pozwala pobierać dane jednym kliknięciem.
2. Który web scraper na Linuxa jest najlepszy do dużych, własnych projektów?
Scrapy to standard dla developerów. Jest szybki, skalowalny i bardzo elastyczny — idealny do dużych, cyklicznych crawlów.
3. Czy mogę scrapować na Linuxie strony mocno oparte na JavaScript?
Tak! Użyj Selenium albo Puppeteer, aby sterować prawdziwą przeglądarką i pobierać dynamiczną treść. Narzędzia wizualne, takie jak ParseHub i Thunderbit, również obsługują dynamiczne strony.
4. Czy są darmowe narzędzia do web scrapingu na Linuxie do zastosowań biznesowych?
Jak najbardziej. Scrapy, Beautiful Soup, Selenium, Colly, PySpider i Kimurai są darmowe i open source. Thunderbit i ParseHub oferują darmowe plany dla mniejszych zadań.
5. Jak wybrać między scraperami no-code a kodowymi na Linuxie?
Jeśli zależy Ci na szybkości i prostocie, wybierz no-code (Thunderbit, ParseHub, Octoparse). Jeśli potrzebujesz elastyczności, automatyzacji lub integracji z innymi systemami, najlepsze będą narzędzia kodowe (Scrapy, Puppeteer, Colly).
Miłego scrapowania — niech Twoje projekty danych na Linuxie działają płynniej niż świeżo zainstalowany Ubuntu. Jeśli chcesz zobaczyć więcej wskazówek o web scrapingu, zajrzyj na blog Thunderbit albo zasubskrybuj nasz kanał YouTube, gdzie znajdziesz praktyczne tutoriale.
Wypróbuj AI Web Scraper na Linuxie Get Started Free
Dowiedz się więcej



