
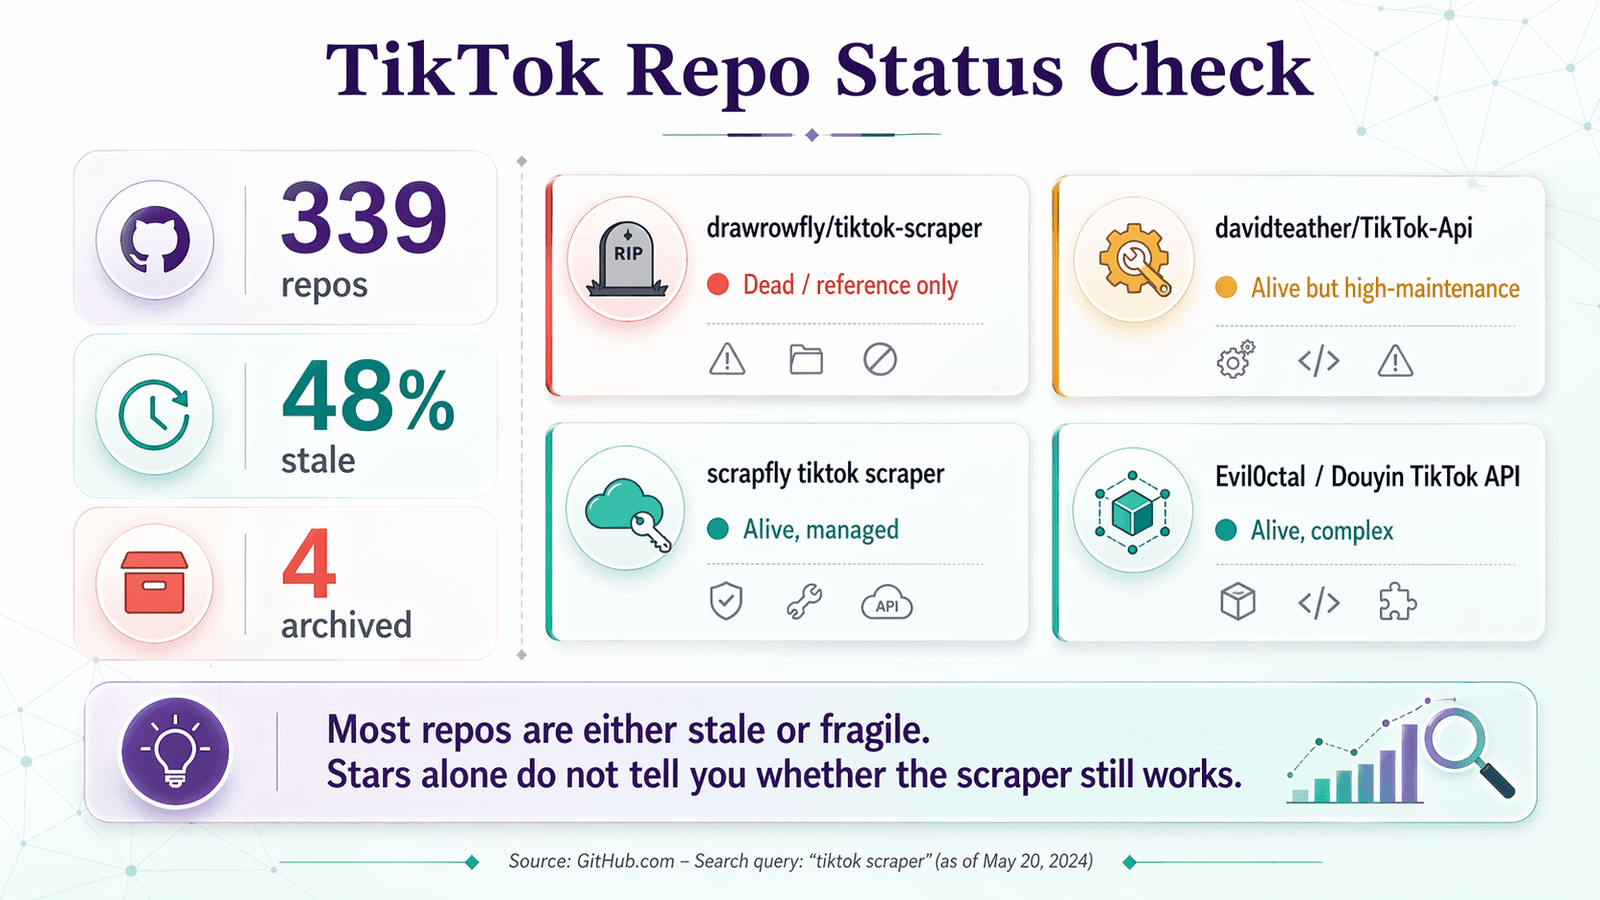
Wyszukiwanie na GitHubie frazy „tiktok scraper” zwraca 339 repozytoriów. Około 48% z nich nie było aktualizowanych od ponad roku, a co najmniej 4 są wyraźnie zarchiwizowane.
Jeśli kiedykolwiek sklonowałeś popularne repo z TikTok scraperem, spędziłeś godzinę walcząc z zależnościami, a potem dostałeś zero wyników — nie jesteś sam. Najpopularniejszy TikTok scraper na GitHubie, drawrowfly/tiktok-scraper, nadal ma ponad 5 000 gwiazdek. Tyle że w zgłoszeniach roi się od wątków typu #812: „czy to niesamowite narzędzie nadal działa?” oraz #824: „Czy to nadal działa?” — oba opisują brak jakichkolwiek wyników. W Thunderbit od miesięcy obserwuję stan repozytoriów do scrapowania TikToka i wzorzec jest aż nadto jasny: te narzędzia psują się szybko, a większości nikt już nie naprawia. Ten artykuł to praktyczny poradnik przetrwania, którego sam potrzebowałem, gdy zaczynałem oceniać te repozytoria. Pokażemy, co jeszcze żyje, co jest martwe, co robić zamiast tego i jak przestać marnować godziny na kod, który przestał działać, zanim w ogóle go znalazłeś.
Dlaczego większość TikTok scraperów na GitHubie się psuje (i ciągle psuje się dalej)
TikTok nie jest typowym celem do scrapowania. Jego warstwa webowa stale się zmienia. W przeciwieństwie do statycznej strony produktu w e-commerce czy katalogu firm, TikTok zmienia endpointy, aktualizuje zabezpieczenia anty-botowe, modyfikuje sposób renderowania stron i wprowadza nowe wymagania dotyczące sesji oraz tokenów — czasem w ciągu kilku tygodni od ostatniej zmiany.
Opiekunowie projektów open source są wolontariuszami. Gdy TikTok wypuści aktualizację, która psuje ścieżkę żądań scrapera, repo może pozostać zepsute przez dni, tygodnie albo na stałe. To nie jest przytyk do maintainerów — to po prostu strukturalna niezgodność między szybko zmieniającą się, świetnie finansowaną platformą a programistami pracującymi po godzinach.
Nawet najlepsze repozytoria TikTok scraperów funkcjonują w trybie ciągłego łatania. Jeśli chcesz z jednego skorzystać, potrzebujesz strategii oceny, diagnozowania problemów i planu awaryjnego.
Mechanizmy anty-botowe TikToka: z czym naprawdę walczysz
- Rate limiting. Oficjalna dokumentacja deweloperska TikToka wprost opisuje limity zapytań nawet dla zatwierdzonych integracji. Nieoficjalne scrapery trafiają w te limity znacznie szybciej.
- Wymóg cookies i sesji. Nowoczesne repozytoria, takie jak davidteather/TikTok-Api, wymagają
ms_token; starsze projekty, jak drawrowfly/tiktok-scraper, pokazują w przykładachtt_webid_v2; Evil0ctal/Douyin_TikTok_Download_API dokumentujemsToken,ttwid,X-BogusiA_Bogus. TikTok sprawdza, czy Twoje żądanie wygląda jak część prawdziwej sesji przeglądania. - Fingerprinting przeglądarki. Wytyczne ScrapFly dotyczące ochrony anty-botowej wyjaśniają, dlaczego serwisy porównują nagłówki, cookies, sygnatury TLS i cechy przeglądarki ujawniane przez JavaScript z ruchem realnych użytkowników. Ich opis browser fingerprintingu obejmuje Canvas, WebGL, WebRTC, fonty i sygnały środowiska wykonawczego. Fingerprinting działa jak sprawdzanie dowodu osobistego Twojej przeglądarki — jeśli przeglądarka, cookies, timing i sygnatura sieciowa nie pasują do siebie, żądanie wygląda na fałszywe jeszcze zanim zwróci jakąkolwiek treść.
- Wykrywanie behawioralne. Wątki na Reddicie dotyczące scrapowania TikToka często wspominają, że świeże sesje Playwright wywołują CAPTCHA. Posty społeczności z lat 2025–2026 coraz częściej opisują wykrywanie oparte nie tylko na IP, ale też na czasie wykonywania akcji i jakości interakcji.
- Szyfrowane/podpisywane parametry żądań. Evil0ctal dokumentuje
X-BogusiA_Bogus; starsze gisty społeczności kręcą się wokół podpisywania URL-i i generowania tokenów. TikTok coraz częściej oczekuje, że żądania będą miały te same „stemple”, które nosi jego własny ruch z przeglądarki lub aplikacji. - CAPTCHA i ścieżki weryfikacji. Istnienie repozytoriów do rozwiązywania CAPTCHA dla TikToka oraz wątków na Reddicie o zadaniach-puzzlach potwierdza, że CAPTCHA nadal jest częścią powierzchni anty-botowej.
Dlaczego opiekunowie open source nie nadążają
Cykl jest zawsze taki sam. Programista tworzy TikTok scrapera. Repo robi furorę na GitHubie. TikTok je łamie. Maintainer albo to naprawia, albo odpuszcza.
Dwa repozytoria świetnie pokazują ten schemat:
- drawrowfly/tiktok-scraper nadal ma 5 052 gwiazdki i 889 forków, ale jego ostatni push był 19 maja 2023. To najpopularniejszy dokładny wynik dla frazy „TikTok scraper” na GitHubie, ale dziś przypomina raczej zabytek: kiedyś ważny, dziś bez aktywnego utrzymania.
- davidteather/TikTok-Api ma 6 301 gwiazdek, 1 177 forków i ostatni push 1 kwietnia 2026. Jego feed wydań pokazuje realne aktualizacje w kwietniu 2025, lipcu 2025, październiku 2025 i kwietniu 2026 — w tym poprawki do pobierania filmów użytkowników oraz nowe opcje proxy/sesji. Ale nawet ten zdrowszy projekt otwarcie ostrzega, że TikTok blokuje żądania i że użytkownicy mogą potrzebować proxy, Playwrighta i własnej logiki sesji.
Wniosek jest prosty:
- Stare repo do scrapowania TikToka jest najpewniej martwe.
- Aktywne repo do scrapowania TikToka jest najpewniej nadal kruche.
- Jedyna realna różnica to to, czy ktoś jeszcze w tym miesiącu jest dostępny, żeby załatać awarię.
60-sekundowa checklista stanu repo: jak ocenić dowolny TikTok scraper na GitHubie
Zanim sklonujesz cokolwiek, przejdź przez tę checklistę. Zajmuje mniej niż minutę i oszczędza godziny frustracji.
| Sygnał | 🟢 Zdrowy | 🟡 Ryzykowny | 🔴 Martwy |
|---|---|---|---|
| Ostatni istotny push | < 3 miesiące temu | 3–12 miesięcy temu | 12+ miesięcy temu |
| Liczba otwartych issue | Niewielka, świeże zgłoszenia mają odpowiedzi | Rosnąca liczba z częściową aktywnością maintainerów | Dużo nierozwiązanych zgłoszeń typu „broken/blocked/not working” |
| Ostatnie skargi użytkowników | Głównie pytania instalacyjne | Mieszanka pytań i skarg na awarie | Powtarzające się „zero output”, „403”, „still working?” |
| Aktualny model auth/sesji | Udokumentowana ścieżka sesji/cookies | Oparta na tokenach, ale opisana | Oparty na starych web endpointach, bez aktualnych wskazówek autoryzacji |
| Powierzchnia instalacji | Powtarzalna, testowana konfiguracja | Kilka ręcznych kroków | Stare zależności, brak nowoczesnych instrukcji |
| CI/testy | Testy istnieją i są aktualne | Testy istnieją, ale zakres niejasny | Brak testów lub stare workflow Actions |
| Dopasowanie zakresu danych | Pokrywa Twój rzeczywisty use case | Obsługuje tylko część potrzeb | Rozwiązuje zupełnie inny problem |
Jak sprawdzić każdy sygnał w mniej niż 60 sekund
- Data ostatniego pusha: Spójrz na nagłówek repozytorium na GitHubie. Jeśli widzisz „last pushed 2 years ago”, temat jest zamknięty.
- Otwarte issue: Kliknij zakładkę Issues. Przejrzyj najnowsze tytuły. Wyszukaj
not working,403,blocked,captchaalbozero output. - Skargi użytkowników: Jeśli 5 najnowszych otwartych issue to różne wersje „to już nie działa”, to masz odpowiedź.
- Model auth/sesji: Otwórz README. Szukaj aktualnych wskazówek, takich jak
ms_token, konfiguracja Playwrighta czy informacje o proxy. Jeśli README odwołuje się do endpointów z 2023 roku, idź dalej. - Instalacja: Sprawdź plik z zależnościami, wsparcie dla Dockera albo jasne instrukcje wdrożenia. Jeśli README mówi „npm install”, a ostatnia testowana wersja Node to 14, spodziewaj się problemów.
- CI/testy: Wejdź w zakładkę Actions. Jeśli testy się sypią albo w ogóle ich nie ma, diagnozowanie będzie wróżeniem z fusów.
- Zakres danych: Czy repo rzeczywiście opisuje typy danych, których potrzebujesz (profile, metadane filmów, komentarze, hashtagi)? Wiele repo robi tylko pobieranie wideo, a nie strukturalną ekstrakcję danych.
Czerwone flagi oznaczające „odpuść”
- Repo jest zarchiwizowane.
- README mówi „no longer maintained”.
- Ostatni commit odnosi się do wersji API TikToka sprzed 2+ lat.
- Issue są zalane zgłoszeniami „doesn't work”, a maintainer nie odpowiada od miesięcy.
- Repo ma dużo gwiazdek, ale brak świeżych forków i pull requestów.
Mała wskazówka: przeszukaj zakładkę Issues hasłami is:issue is:open "not working" albo is:issue is:open "403". Jeśli wyników jest dużo i są świeże, repo prawdopodobnie jest zepsute.
Popularne repo TikTok scraperów na GitHubie: uczciwy status (2026)
Poniżej checklista stanu repo zastosowana do projektów, które rzeczywiście znajdziesz, szukając na GitHubie „tiktok scraper”:
| Repo | Ostatni push | Gwiazdek | Otwarte issue | Ocena | Uwagi |
|---|---|---|---|---|---|
| drawrowfly/tiktok-scraper | 2023-05-19 | 5,052 | 58 | 🔴 Martwe / tylko jako punkt odniesienia | Wciąż znane, ale zbyt stare do produkcyjnego użycia w 2026 |
| davidteather/TikTok-Api | 2026-04-01 | 6,301 | 134 | 🟡 Żywe, ale wymagające ciągłej opieki | Najmocniejszy wybór OSS; wymaga Playwrighta, tokenów i często proxy |
| scrapfly/scrapfly-scrapers/tiktok-scraper | 2026-04-21 | 938 (repo nadrzędne) | ~0 (monorepo) | 🟡 Żywe, ale nie czyste OSS | Aktualne i przydatne, ale wymaga klucza API ScrapFly |
| Evil0ctal/Douyin_TikTok_Download_API | 2025-10-12 | 17,397 | 135 | 🟡 Żywe, szerokie, złożone | Bogaty projekt wieloplatformowy, bliżej platformy dla zaawansowanych użytkowników |
| naseif/tiktok-scraper | 2024-07-26 | 107 | 13 | 🟡 Ryzykowne | Mniejsze repo z otwartymi skargami dotyczącymi danych użytkownika i hashtagów |
| loewehancara1rmyv/Tiktok-scraper | 2026-01-12 | 4 | 0 | 🔴 Zbyt nowe, by zaufać | Repo pokazowe, niepotwierdzone przez społeczność |
drawrowfly/tiktok-scraper
Przez lata ten scraper/downloader w TypeScript był domyślną odpowiedzią na pytanie „tiktok scraper github” — obsługiwał źródła użytkowników, trendy, hashtagi i muzykę. W 2026 najlepiej traktować go jako dokumentację historyczną. Ostatni push był w maju 2023, a kolejka issue nadal zawiera nierozwiązane zgłoszenia z lat 2023–2025, takie jak „still working?” i „zero output”. Jeśli czytasz ten artykuł, bo sklonowałeś to repo i nic nie dostałeś, jesteś w dobrym towarzystwie.
davidteather/TikTok-Api
Najbardziej wiarygodny open-source’owy wrapper danych z TikToka, który nadal żyje w 2026. Projekt jest aktywny, ma najnowsze wydania i wprost dokumentuje konfigurację Playwrighta, użycie asynchroniczne, obsługę tokenów, wsparcie proxy oraz mechanizmy odzyskiwania sesji. Ale to nie jest narzędzie typu „sklonuj i odpal”. Sam README mówi, że EmptyResponseException zwykle oznacza blokadę ze strony TikToka, a historia dyskusji pokazuje powtarzające się problemy z ms_token, błędami ekstrakcji komentarzy, KeyError: 'ItemModule' i awariami zależnymi od konkretnego endpointu. Werdykt: żywe, użyteczne, dla deweloperów i wymagające stałej opieki.
Inne warte uwagi repozytoria
- scrapfly/scrapfly-scrapers/tiktok-scraper: Aktualne i technicznie relewantne, ale README wymaga
SCRAPFLY_KEY. To przykład kodu dla zarządzanej platformy scrapingowej, a nie darmowe samodzielne narzędzie. - Evil0ctal/Douyin_TikTok_Download_API: Obejmuje TikToka i Douyin, dokumentuje logikę podpisów (
X-Bogus,A_Bogus,msToken) i obsługuje komentarze, followerów, playlisty i więcej. To projekt technicznie wymagający i coraz mocniej powiązany z płatnymi odniesieniami do API. Issue tracker pokazuje aktywne błędy w 2026 dotyczące linków do filmów i endpointów informacji o użytkowniku. Żywe i bogate w funkcje, ale złożone. - naseif/tiktok-scraper: Mniejsze, z otwartymi skargami. Ryzykowne do produkcji.
- loewehancara1rmyv/Tiktok-scraper: 4 gwiazdki, 0 issue, zbyt nowe, by zaufać. Artykuł Medium, który je promował, zrobił to bezkrytycznie.
Oficjalne API TikToka vs. scrapery z GitHuba vs. narzędzia no-code: ramy decyzyjne
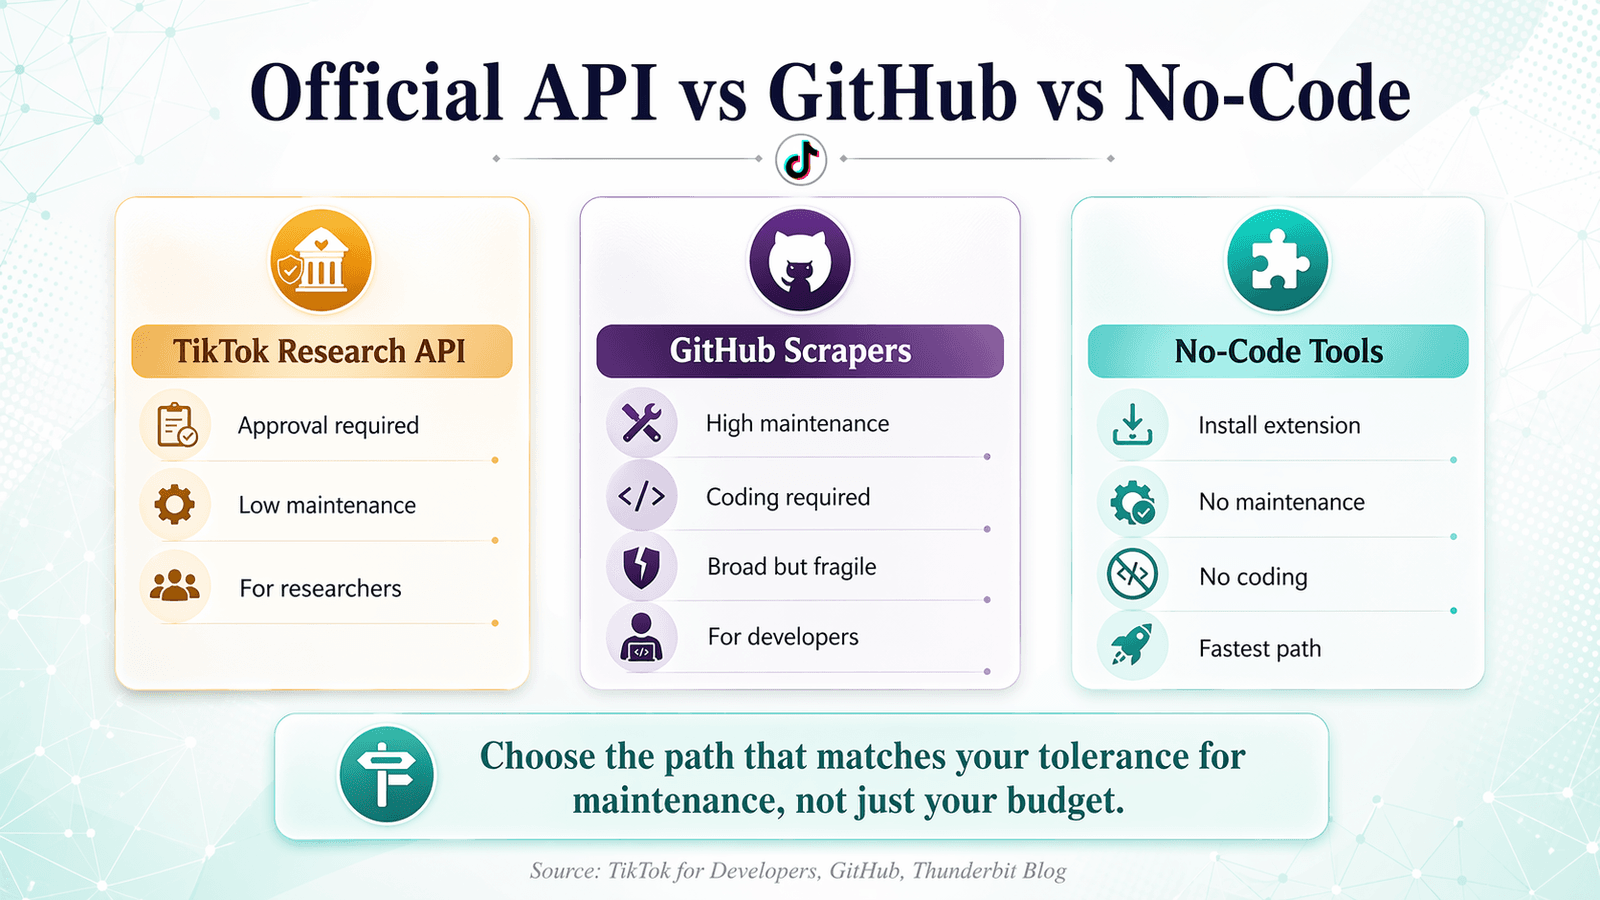
Większość artykułów porównawczych albo ignoruje oficjalne ścieżki dostępu do TikToka, albo przeskakuje od „użyj GitHuba” prosto do „kup naszą usługę”. Poniżej neutralne porównanie trzech podejść:
| Czynnik | TikTok Research API | GitHub Scrapery | Narzędzia no-code (np. Thunderbit) |
|---|---|---|---|
| Bariera dostępu | Wymagana aplikacja akademicka/biznesowa; ok. 4 tygodnie na akceptację | Git clone + konfiguracja | Instalacja rozszerzenia przeglądarki |
| Zakres danych | Tylko zatwierdzone endpointy (konta, filmy, komentarze, sklepy) | Szeroki (profile, filmy, komentarze, hashtagi, sklepy) | Widoczne dane ze stron (profile, filmy, engagement, hashtagi) |
| Koszt utrzymania | Niski (oficjalne, stabilne) | Wysoki (repo psują się po aktualizacjach TikToka) | Brak (AI adaptuje się do zmian layoutu) |
| Ryzyko bana | Brak (autoryzowany dostęp) | Wysokie | Niskie (bazuje na przeglądarce i zachowuje się jak realny użytkownik) |
| Koszt | Darmowe po akceptacji | Darmowe, ale czasochłonne | Dostępny darmowy plan; plany na kredyty od 15 USD/mies. |
| Wymagana umiejętność kodowania | Tak (Python/R) | Tak (Python/Node.js) | Nie |
| Najlepsze dla | Badaczy, akademików, zatwierdzonych organizacji | Programistów gotowych na utrzymanie | Marketingu, sprzedaży, operacji i osób nietechnicznych |
Kiedy ma sens TikTok Research API
Research API TikToka to najczystsza oficjalna ścieżka, jeśli kwalifikujesz się do programu. Uprawnieni badacze w USA, Europie i Brazylii mogą aplikować o dostęp do publicznych treści i danych kont. Dostępne kategorie danych obejmują konta, obserwujących/obserwowane, polubione filmy, przypięte filmy, udostępnione filmy, treści, komentarze i sklepy. Codebook udostępnia pola takie jak video_description, view_count, like_count, comment_count, share_count, a na poziomie komentarzy m.in. text, reply_count i create_time.
Minus: dostęp jest ograniczony do instytucji akademickich oraz uprawnionych badaczy nonprofit/independent w wybranych regionach, a także do zweryfikowanych badaczy w ramach procesu DSA w UE. Jeśli jesteś zespołem growth albo agencją i potrzebujesz szybkich danych operacyjnych, to nie jest Twoja droga.
TikTok oferuje też Commercial Content API dla reklam i danych reklamodawców, co przydaje się w badaniach przejrzystości, ale nie do ogólnego scrapowania.
Kiedy nadal ma sens scraper z GitHuba
Scrapery z GitHuba nadal mają sens dla programistów, którzy potrzebują nieoficjalnego dostępu do publicznych danych poza bramką akceptacji oficjalnego API i są gotowi utrzymywać cały stack. Dotyczy to takich use case’ów jak scrapowanie widocznych siatek profili, hashtagów, komentarzy, playlist czy metadanych wideo w niestandardowym pipeline, gdzie forking repo i patchowanie go jest akceptowalne.
Uczciwy haczyk: to nie jest jednorazowa konfiguracja. Nawet najbardziej niezawodne repo z 2026, davidteather/TikTok-Api, nadal informuje użytkowników, że mogą potrzebować Playwrighta, cookies/tokenów, proxy oraz własnych fabryk stron i sesji.
Kiedy ma sens narzędzie no-code jak Thunderbit
Scrape dane z TikToka z pomocą AI Get Started Free
Nie jesteś deweloperem? A może jesteś, ale masz dość niekończącego się łatania? Narzędzie AI działające w przeglądarce to najszybsza droga do strukturalnych danych z TikToka.
Zbudowaliśmy Thunderbit jako AI web scraper działający jako rozszerzenie do Chrome. Na TikToku odczytuje każdą widoczną stronę (profil, film, hashtag, wyniki wyszukiwania), sugeruje kolumny przez „AI Suggest Fields” i pozwala kliknąć „Scrape”, by wyciągnąć dane do tabeli. Strona narzędzia do scrapowania TikToka opisuje pola takie jak data publikacji, długość filmu, polubienia, udostępnienia, zapisy, komentarze, wyświetlenia i hashtagi. Szablon image scraper pokazuje, jak zbierać miniatury postów, URL-e, podpisy, nazwy twórców i sygnały zaangażowania z profili. Szablon hashtag scraper obejmuje URL filmu, nazwę użytkownika twórcy, opis, czas publikacji, wyświetlenia, polubienia, komentarze, udostępnienia, dźwięk/audio i URL obrazka okładki.
Scraping podstron pozwala wejść na każdą stronę filmu z listy profilu i wzbogacić tabelę o metryki zaangażowania, podpisy i hashtagi — przydatne dla marketerów budujących bazy influencerów lub audyty treści konkurencji.
Bez utrzymania, bez problemów instalacyjnych, bez konfiguracji anty-botowej. AI automatycznie dostosowuje się do zmian w układzie TikToka. Eksport jest darmowy do Google Sheets, Excela, Airtable, Notion, CSV lub JSON.
Jeśli zmarnowałeś godziny na zepsute repozytoria GitHuba, to jest to realna alternatywa — nie nachalna sprzedaż.
Wypróbuj Thunderbit do scrapowania TikToka
Triage instalacji: naprawa 5 najczęstszych awarii konfiguracji TikTok scraperów z GitHuba
Problemy instalacyjne to trzeci najczęściej wymieniany ból w forach o scrapowaniu TikToka, a żaden większy poradnik tak naprawdę nie pomaga ich rozwiązać. Oto, co zwykle idzie nie tak.
Konflikty wersji Node.js
Problem: Wiele starszych repo TikTok scraperów (zwłaszcza drawrowfly/tiktok-scraper) było tworzonych pod Node.js 14–16. Jeśli używasz Node 20+, npm install może zakończyć się cicho niepowodzeniem albo zainstalować niekompatybilne binaria.
Naprawa: Użyj nvm (Node Version Manager), aby zainstalować i przełączyć właściwą wersję:
nvm install 16
nvm use 16
npm install
Jeśli repo nie podaje wersji Node, sprawdź pole engines w package.json albo konfigurację CI.
Problemy z zależnościami Python i konfiguracją Playwrighta
Problem: davidteather/TikTok-Api wymaga Python 3.9+ oraz Playwrighta z konkretnymi binariami przeglądarki. Użytkownicy widzą błędy typu „browser not found” albo konflikty zależności.
Naprawa: Zawsze używaj wirtualnego środowiska, a potem zainstaluj przeglądarki Playwrighta wprost:
python -m venv .venv
source .venv/bin/activate   # Na Windows: .venv\Scripts\activate
pip install TikTokApi
python -m playwright install
Jeśli playwright install się nie powiedzie, sprawdź w systemowym menedżerze pakietów, czy nie brakuje zależności systemowych (np. libnss3 na Ubuntu).
Problemy z uprawnieniami w Linux/Ubuntu
Problem: sudo pip install psuje systemowe środowisko Pythona i prowadzi do kaskady konfliktów zależności.
Naprawa: Nigdy nie używaj sudo pip install. Zawsze najpierw twórz wirtualne środowisko:
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
To izoluje zależności scrapera od systemowego Pythona.
Problemy ze ścieżkami i kodowaniem na Windowsie
Problem: CMD na Windowsie ma problemy z kodowaniem i ograniczenia długości ścieżek, które psują instalację scraperów, zwłaszcza gdy Playwright pobiera binaria przeglądarki do głęboko zagnieżdżonych katalogów.
Naprawa: Użyj WSL (Windows Subsystem for Linux) albo Git Bash zamiast CMD. WSL daje pełne środowisko Linux wewnątrz Windows:
wsl --install
# Następnie otwórz terminal WSL i wykonaj kroki konfiguracji Linux
Skrót przez Docker: całkowite pominięcie problemów z zależnościami
Problem: Wszystko powyżej.
Naprawa: Jeśli znasz Dockera, zamknij środowisko scrapera w kontenerze. Prosty Dockerfile dla TikTok scrapera w Pythonie wygląda tak:
FROM python:3.11-slim
RUN apt-get update && apt-get install -y libnss3 libatk-bridge2.0-0 libdrm2 libxcomposite1 libxdamage1 libxrandr2 libgbm1 libasound2
RUN pip install TikTokApi playwright && python -m playwright install --with-deps chromium
WORKDIR /app
COPY . .
CMD ["python", "scrape.py"]
To gwarantuje powtarzalne środowisko niezależnie od systemu hosta. Jeśli scraper działa w Dockerze, każda awaria poza Dockerem to problem środowiska, nie kodu.
Schemat rozwiązywania problemów:
- Czy repo uruchamia własny przykład bez błędów? → Jeśli nie, sprawdź wersję runtime.
- Wersja runtime jest właściwa? → Sprawdź instalację przeglądarki/Playwrighta.
- Przeglądarka jest zainstalowana? → Sprawdź tokeny/cookies.
- Tokeny/cookies są poprawne? → Sprawdź, czy TikTok nie blokuje sesji.
- Wszystko powyżej zawodzi? → Załóż, że repo jest zepsute, a nie że to błąd użytkownika. Zmień narzędzie.
Dobre praktyki anty-ban dla scrapowania TikToka (bez płacenia za proxy)
Użytkownicy forów regularnie narzekają na bany i wykrywanie: „banują konta, więc to dodatkowy koszt” oraz „bez Apify albo drogich płatnych API”. Oto darmowe, praktyczne obejścia, które nie wymagają płatnej subskrypcji proxy.
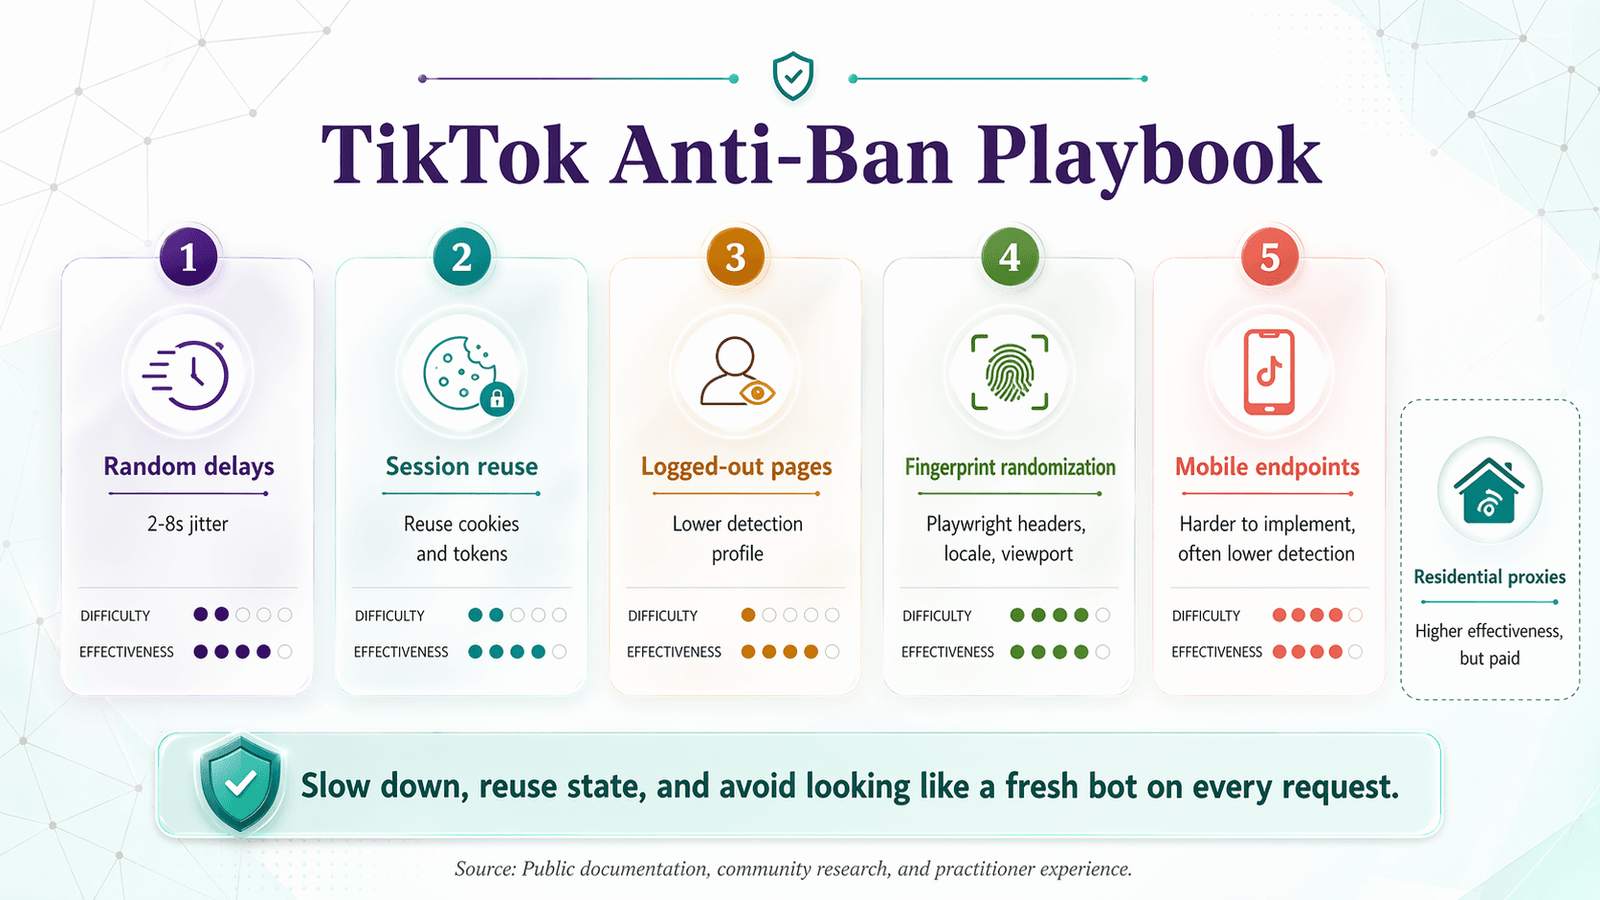
| Praktyka | Trudność | Koszt | Skuteczność |
|---|---|---|---|
| Losowe opóźnienia między żądaniami (jitter 2–8 s) | Łatwa | Darmowa | Umiarkowana |
| Rotacja sesji/cookies | Średnia | Darmowa | Umiarkowana |
| Scrapowanie wyłącznie publicznych stron bez logowania | Łatwa | Darmowa | Umiarkowana |
Przestrzeganie robots.txt + nagłówków rate-limit | Łatwa | Darmowa | Bazowa |
| Losowanie fingerprintu headless browsera (Playwright) | Średnia | Darmowa | Wysoka |
| Korzystanie z mobilnych endpointów API TikToka (mniejsza wykrywalność) | Trudna | Darmowa | Wysoka |
| Rotacja proxy residential | Średnia | 20–100 USD/mies. | Wysoka |
Darmowe techniki, które naprawdę pomagają
Losowe opóźnienia między żądaniami. Nie wysyłaj requestów w ciasnej pętli. Dodaj losowy odstęp 2–8 sekund między kolejnymi żądaniami. To najprostsza rzecz, jaką możesz zrobić:
import time, random
time.sleep(random.uniform(2, 8))
Ponowne używanie sesji i cookies. Nie twórz nowej sesji dla każdego żądania. Wykorzystuj te same cookies i stan sesji dla całej partii zapytań, a dopiero potem rotuj. Właśnie dlatego nowoczesne repo proszą o ms_token zamiast obiecywać bezstanowe scrapowanie.
Scrapowanie tylko publicznych stron bez logowania. TikTok-Api wprost mówi, że nie obsługuje tras wymagających uwierzytelnienia użytkownika i działa wyłącznie na danych widocznych po wylogowaniu. Scrapowanie bez logowania ma niższy profil wykrywalności niż sesje uwierzytelnione.
Przestrzeganie robots.txt. Aktualny robots.txt TikToka blokuje wiele agentów całkowicie i pozwala tylko na ograniczony zestaw publicznych ścieżek dla ogólnego crawlningu. To nie jest zielone światło do agresywnego scrapowania, ale respektowanie tych zasad zmniejsza ryzyko natychmiastowego blacklistingu IP.
Techniki średniozaawansowane dla lepszej skuteczności
Losowanie fingerprintu headless browsera. Jeśli używasz Playwrighta, losuj rozmiar viewportu, user-agent, strefę czasową i locale dla każdej sesji. Dzięki temu scraper wygląda jak inny realny użytkownik za każdym razem, a nie ten sam bot z nowym IP.
Korzystanie z mobilnych endpointów API TikToka. Część społeczności zgłasza niższą wykrywalność, gdy zamiast web frontendu używa endpointów w stylu mobilnym. Jest to trudniejsze do wdrożenia i słabiej udokumentowane, ale dla zaawansowanych użytkowników to realna technika.
Kiedy naprawdę potrzebujesz proxy (i jakie są rozsądne opcje)
Przy większej skali darmowe techniki nie wystarczą. Rotacja proxy residential to standardowe podejście przy dużych wolumenach scrapowania TikToka. Nie będę tu polecał konkretnego płatnego dostawcy proxy, ale ogólna rada brzmi: unikaj proxy datacenter (TikTok wykrywa je agresywnie) i szukaj pul proxy residential albo mobile z rotacją per request.
Alternatywnie narzędzia działające w przeglądarce, takie jak Thunderbit, omijają cały temat proxy, bo działają w Twojej własnej sesji przeglądarki i zachowują się jak realny użytkownik. Nie oznacza to pełnej odporności na wykrywanie przy dużej skali, ale przy typowych zastosowaniach marketingowych lub badawczych (dziesiątki czy setki stron, nie miliony) to dużo prostsza droga.
Jakie dane faktycznie dostaniesz? Przykładowe realne wyjścia z TikTok scraperów
Użytkownicy chcą wiedzieć, jakie dane naprawdę otrzymają, zanim zainwestują czas w narzędzie — a większość poradników pomija ten temat całkowicie. Oto reprezentatywne struktury pól, oparte na dokumentacji źródłowej.
Dane profilu
| Nazwa użytkownika | Nazwa wyświetlana | Obserwujący | Obserwowane | Łączne polubienia | Bio | Zweryfikowany | URL profilu |
|---|---|---|---|---|---|---|---|
| @examplecreator | Jane Doe | 1,240,000 | 312 | 48,700,000 | "Cooking + comedy 🍳" | ✅ | tiktok.com/@examplecreator |
| @travelwithmark | Mark S. | 890,000 | 150 | 22,100,000 | "Travel vlogger 🌍" | ❌ | tiktok.com/@travelwithmark |
| @fitnessmaya | Maya L. | 2,100,000 | 88 | 91,300,000 | "Workouts & wellness" | ✅ | tiktok.com/@fitnessmaya |
Dostępne z: GitHub scraperów (TikTok-Api, Evil0ctal), Research API, Thunderbit (z widocznych stron profilu).
Metadane wideo
| URL filmu | Opis | Wyświetlenia | Polubienia | Komentarze | Udostępnienia | Muzyka | Hashtagi | Data publikacji | Długość |
|---|---|---|---|---|---|---|---|---|---|
| tiktok.com/@ex/video/123 | "Best pasta trick ever 🍝" | 4,200,000 | 312,000 | 8,400 | 21,000 | "Italian Vibes – DJ Marco" | #pasta #cooking #hack | 2026-03-15 | 0:42 |
| tiktok.com/@ex/video/456 | "POV: your cat judges you" | 9,100,000 | 1,100,000 | 23,000 | 55,000 | "Original Sound" | #cat #pov #funny | 2026-04-01 | 0:18 |
| tiktok.com/@ex/video/789 | "Morning routine nobody asked for" | 1,800,000 | 98,000 | 3,200 | 7,500 | "Chill Morning – LoFi" | #routine #morning | 2026-04-10 | 1:02 |
Dostępne z: GitHub scraperów (TikTok-Api, Evil0ctal), Research API (pola obejmują video_description, view_count, like_count, comment_count, share_count, music_id, hashtag_names, video_duration), Thunderbit (pola na poziomie wideo).
Dane komentarzy
| Autor komentarza | Treść komentarza | Polubienia | Znacznik czasu | Odpowiedzi |
|---|---|---|---|---|
| @user_abc | "I tried this and it actually works 😂" | 1,200 | 2026-03-16T08:12:00Z | 14 |
| @chef_dan | "Add garlic next time, trust me" | 890 | 2026-03-16T09:45:00Z | 7 |
| @randomfan99 | "This is the content I'm here for" | 340 | 2026-03-16T11:30:00Z | 2 |
Dostępne z: GitHub scraperów (TikTok-Api, Evil0ctal), Research API (pola obejmują text, like_count, reply_count, create_time), Thunderbit (z widocznych sekcji komentarzy).
Dane hashtagów i wyszukiwania
| Hashtag | URL najlepszego filmu | Łączne wyświetlenia | Trend |
|---|---|---|---|
| #pasta | tiktok.com/@ex/video/123 | 4,200,000 | Tak |
| #cooking | tiktok.com/@chef/video/321 | 11,000,000 | Tak |
| #hack | tiktok.com/@tips/video/654 | 2,900,000 | Nie |
Dostępne z: GitHub scraperów (zależnie od repo), Thunderbit (szablon hashtag scraper).
Uwaga: żadne pojedyncze repo nie gwarantuje wszystkich pól przez cały czas. Struktury odpowiedzi TikToka się zmieniają, a nawet maintainerzy o tym ostrzegają. Traktuj te przykłady jako reprezentatywne, nie gwarantowane.
Jak scrapować dane z TikToka w 2 kliknięciach z Thunderbit (krok po kroku)
Masz dość cyklu łatania i naprawiania? Oto ścieżka no-code — wyjście awaryjne dla każdego, kto próbował i poległ z repozytoriami GitHuba.
- Zainstaluj rozszerzenie Thunderbit do Chrome.
- Wejdź na stronę TikToka, którą chcesz scrapować — profil, wyniki wyszukiwania, strona hashtagu albo pojedynczy film.
- Kliknij „AI Suggest Fields”. AI Thunderbit odczyta stronę i zaproponuje kolumny: nazwa użytkownika, obserwujący, podpis filmu, polubienia, hashtagi itd.
- Dostosuj pola, jeśli trzeba, a potem kliknij „Scrape”. Dane pojawią się w uporządkowanej tabeli.
- Użyj Subpage Scraping, aby wzbogacić dane. Wejdź w każdy film z listy profilu i pobierz dodatkowe pola: pełny opis, szczegóły muzyki, liczba komentarzy, liczba udostępnień.
- Wyeksportuj do Google Sheets, Excela, Airtable albo Notion — całkowicie za darmo.
Bez utrzymania, bez problemów z instalacją, bez konfiguracji anty-banowej. AI automatycznie dostosowuje się do zmian w layoutach TikToka.
Wzbogacanie danych z TikToka przez scrapowanie podstron
Po zebraniu listy filmów z profilu albo strony hashtagu kliknij „Scrape Subpages”, aby AI odwiedziło każdą stronę filmu i pobrało dodatkowe pola. To szczególnie przydatne dla marketerów budujących bazy influencerów albo robiących audyt treści konkurencji — dostajesz pełną tabelę danych engagement na poziomie wideo bez ręcznego klikania przez dziesiątki stron.
Eksport i wykorzystanie danych z TikToka
Thunderbit eksportuje do Google Sheets, Excela, Airtable, Notion, CSV lub JSON — wszystko za darmo. Typowe zastosowania:
- Wrzucenie danych do arkusza w celu analizy zaangażowania.
- Wysłanie do Airtable jako tracker influencerów w stylu CRM.
- Przesłanie do Notion dla współpracy zespołu nad badaniem treści.
Jeśli chcesz głębiej zrozumieć, jak Thunderbit radzi sobie z ekstrakcją danych z sieci, zajrzyj do naszego przewodnika dla początkujących o web scrapingu albo obejrzyj tutoriale na kanale Thunderbit na YouTube.
Jak pozostać po właściwej stronie prawa: regulamin TikToka i zgodność scrapowania
Stanowisko prawne TikToka jest jasne. Blog prywatności o scrapowaniu platformy mówi, że jej Warunki korzystania zabraniają zautomatyzowanych skryptów zbierających informacje lub wchodzących w interakcję z serwisem w nieautoryzowany sposób, i wprost wspomina o omijaniu ograniczeń dostępu. Zasady społeczności TikToka również zabraniają podstępnych prób uzyskania informacji za pomocą skryptów automatycznych lub crawlningu webowego.
Praktyczne wskazówki:
- Trzymaj się publicznie dostępnych danych. Nie scrapuj treści prywatnych ani ukrytych za logowaniem.
- Respektuj limity zapytań. Nie bombarduj serwerów TikToka.
- Przestrzegaj przepisów o prywatności danych. GDPR i CCPA nadal mają zastosowanie, jeśli zbierasz, przechowujesz lub analizujesz dane osobowe.
- Korzystaj z Research API, jeśli się kwalifikujesz. To najbezpieczniejsza ścieżka z punktu widzenia zgodności.
- To nie jest porada prawna. W swojej konkretnej sytuacji skonsultuj się ze specjalistą.
Więcej o krajobrazie prawnym znajdziesz w naszym przewodniku web scraping legal implications.
Co zrobić, gdy repo TikTok scrapera z GitHuba przestaje działać
Krótka wersja:
- Zawsze uruchamiaj 60-sekundową checklistę Repo Vitals przed sklonowaniem jakiegokolwiek TikTok scrapera z GitHuba. Większość repo jest już martwa.
- Zrozum swoje opcje. Oficjalne API, scrapery z GitHuba i narzędzia no-code służą różnym użytkownikom i różnym zastosowaniom.
- Jeśli wybierasz GitHuba, zaplanuj czas na rozwiązywanie problemów z instalacją i konfigurację anty-banową. Spodziewaj się stałego utrzymania.
- Sprawdź, jakie dane naprawdę dostaniesz zanim zainwestujesz w narzędzie. Patrz na pola wyjściowe, nie tylko na liczbę gwiazdek.
- Jeśli nie jesteś deweloperem (albo masz dość zepsutych repo), wypróbuj narzędzie no-code takie jak Thunderbit — dwa kliknięcia, dane strukturalne, darmowy eksport.
Dane z TikToka są dostępne. Pytanie brzmi, czy chcesz spędzać czas na utrzymaniu scrapera, czy faktycznie korzystać z danych. Wybierz podejście dopasowane do Twojego poziomu i use case’u i nie pozwól, żeby martwe repo z GitHuba zmarnowało Ci kolejny popołudnie.
Wypróbuj Thunderbit do danych z TikToka
FAQ
Czy na GitHubie są jeszcze jakieś TikTok scrapery, które działają w 2026?
Tak, ale lista jest krótka. davidteather/TikTok-Api to najbardziej wiarygodna opcja open source z aktywnym utrzymaniem na kwiecień 2026. Evil0ctal/Douyin_TikTok_Download_API też nadal działa, ale jest bardziej złożony. Najbardziej popularne repo, drawrowfly/tiktok-scraper, nie było aktualizowane od maja 2023 i praktycznie jest martwe. Zawsze przejdź przez checklistę Repo Vitals, zanim poświęcisz czas na jakiekolwiek repo.
Czy scrapowanie TikToka jest legalne?
Warunki korzystania TikToka wprost zabraniają automatycznego scrapowania. Publicznie widoczne dane znajdują się w prawnej szarej strefie, która różni się w zależności od jurysdykcji. Najbezpieczniejszą drogą jest oficjalne Research API dla uprawnionych badaczy. Jeśli scrapujesz dane publiczne, ogranicz się do treści dostępnych publicznie, przestrzegaj limitów zapytań i stosuj się do GDPR/CCPA. To nie jest porada prawna — skonsultuj swoją sytuację ze specjalistą.
Czy mogę scrapować TikToka bez kodowania?
Tak. Narzędzia AI działające w przeglądarce, takie jak Thunderbit, pozwalają wyciągać strukturalne dane z TikToka (profile, metadane filmów, hashtagi, metryki engagement) bez pisania kodu. TikTok Research API również wymaga minimalnej ilości kodu dla zatwierdzonych aplikantów. Dla osób nietechnicznych narzędzia no-code są najszybszą i najbardziej niezawodną opcją.
Jakie dane mogę dostać z TikTok scrapera?
Najczęściej są to: informacje o profilu (nazwa użytkownika, obserwujący, bio, status weryfikacji), metadane wideo (opis, wyświetlenia, polubienia, komentarze, udostępnienia, muzyka, hashtagi, długość, data publikacji), komentarze (treść, polubienia, timestamp, odpowiedzi) oraz dane hashtagów/wyszukiwania (najlepsze filmy, łączne wyświetlenia, status trendu). Dokładne pola zależą od narzędzia i metody — szczegóły znajdziesz w sekcji z przykładami wyjść powyżej.
Dlaczego mój TikTok scraper ciągle jest blokowany?
TikTok stosuje kilka warstw obrony anty-botowej: rate limiting, blokady oparte na cookies/sesji, fingerprinting przeglądarki, wykrywanie behawioralne, szyfrowane parametry żądań oraz CAPTCHA. Najczęstsze przyczyny blokady to zbyt szybkie wysyłanie żądań, używanie świeżej/czystej sesji dla każdego requestu, headless browser z domyślnym fingerprintem albo korzystanie z proxy datacenter. Zobacz sekcję o dobrych praktykach anty-ban powyżej, gdzie opisaliśmy darmowe i płatne obejścia.




