
Internet rozwija się szybciej niż moje uzależnienie od kawy – a to już coś znaczy! W 2026 roku ekstrakcja danych z sieci to nie tylko niszowa umiejętność dla garstki zapaleńców; to podstawa analityki biznesowej, szkolenia AI i automatyzacji. Niezależnie od tego, czy śledzisz trendy rynkowe, zasilasz swój nowej generacji LLM, czy po prostu próbujesz nadążyć za cenami konkurencji, potrzeba ustrukturyzowanych danych internetowych w czasie rzeczywistym nigdy nie była większa. A w sercu tej gorączki danych? Python. Dzięki swojemu ogromnemu ekosystemowi i przystępnej składni, Python pozostaje językiem numer jeden do web scrapingu, napędzając wszystko, od szybkich, jednorazowych skryptów po przemysłowe crawlery.
Ale jest pewien haczyk: wybór odpowiednich pakietów Pythona do web scrapingu może zadecydować o sukcesie lub porażce Twojego projektu. Widziałem zespoły marnujące dni na walkę z zabezpieczeniami antybotowymi za pomocą niewłaściwego narzędzia, lub spędzające godziny na parsowaniu chaotycznego HTML-a, gdy sprytniejsza biblioteka załatwiłaby sprawę w kilka minut. Jako ktoś, kto spędził lata w branży SaaS, automatyzacji i AI (i stworzył Thunderbit, aby ułatwić scraping każdemu), zebrałem 12 najlepszych pakietów Pythona do web scrapingu na rok 2026 – każdy z własnymi mocnymi stronami, dziwactwami i idealnymi zastosowaniami. Zanurzmy się i znajdźmy idealne rozwiązanie dla Twojej kolejnej przygody z danymi.
Dlaczego odpowiednie pakiety Pythona do web scrapingu są tak ważne
Pobieraj dane z dowolnej strony internetowej za pomocą AI Get Started Free
Bądźmy szczerzy: nie wszystkie projekty web scrapingu są sobie równe. Czasami wystarczy pobrać kilka cen produktów ze statycznej strony. Innym razem zmagasz się ze stroną mocno opartą na JavaScript, która jest bardziej uparta niż kot podczas kąpieli. Odpowiedni pakiet może zaoszczędzić Ci godzin (lub dni), zmniejszyć liczbę błędów i pomóc uniknąć typowych pułapek, takich jak blokady antybotowe czy uszkodzony HTML.
Popularność Pythona w web scrapingu to nie tylko szum. Biblioteki takie jak requests i urllib3 odnotowują ponad 1 miliard pobrań miesięcznie, a prawie każde główne narzędzie do scrapingu jest najpierw tworzone w Pythonie. Ale z wielką mocą wiąże się wielka odpowiedzialność: wybierz niewłaściwe narzędzie, a możesz utknąć w projekcie, który jest wolniejszy niż internet na modemie. Wybierz mądrze, a będziesz pływać w czystych, ustrukturyzowanych danych, zanim Twoja kawa ostygnie.
Jak wybraliśmy najlepsze pakiety Pythona do web scrapingu
Nie rzucałem po prostu rzutkami w wykres PyPI. Oto, jak oceniałem każdy pakiet:
- Wydajność i współbieżność: Czy potrafi szybko pobrać setki (lub tysiące) stron?
- Łatwość użycia: Czy jest przyjazny dla początkujących, czy wymaga doktoratu z informatyki?
- Moc parsowania HTML: Czy radzi sobie z uszkodzonym kodem, obsługuje selektory XPath/CSS i sprawia, że ekstrakcja danych jest bezbolesna?
- Obsługa treści dynamicznych: Czy radzi sobie ze stronami mocno opartymi na JavaScript, czy jest przeznaczony wyłącznie do stron statycznych?
- Społeczność i dokumentacja: Czy istnieje prężna baza użytkowników i solidna dokumentacja, czy utkniesz w czyśćcu Stack Overflow?
- Najlepsze zastosowanie: Czy jest przeznaczony do szybkich skryptów, dużych crawlerów, czy czegoś pomiędzy?
Uwzględniłem również rzeczywiste opinie deweloperów, najnowsze benchmarki i moje własne (czasami bolesne) doświadczenia w tej dziedzinie. Teraz poznajmy pretendentów.
1. Thunderbit
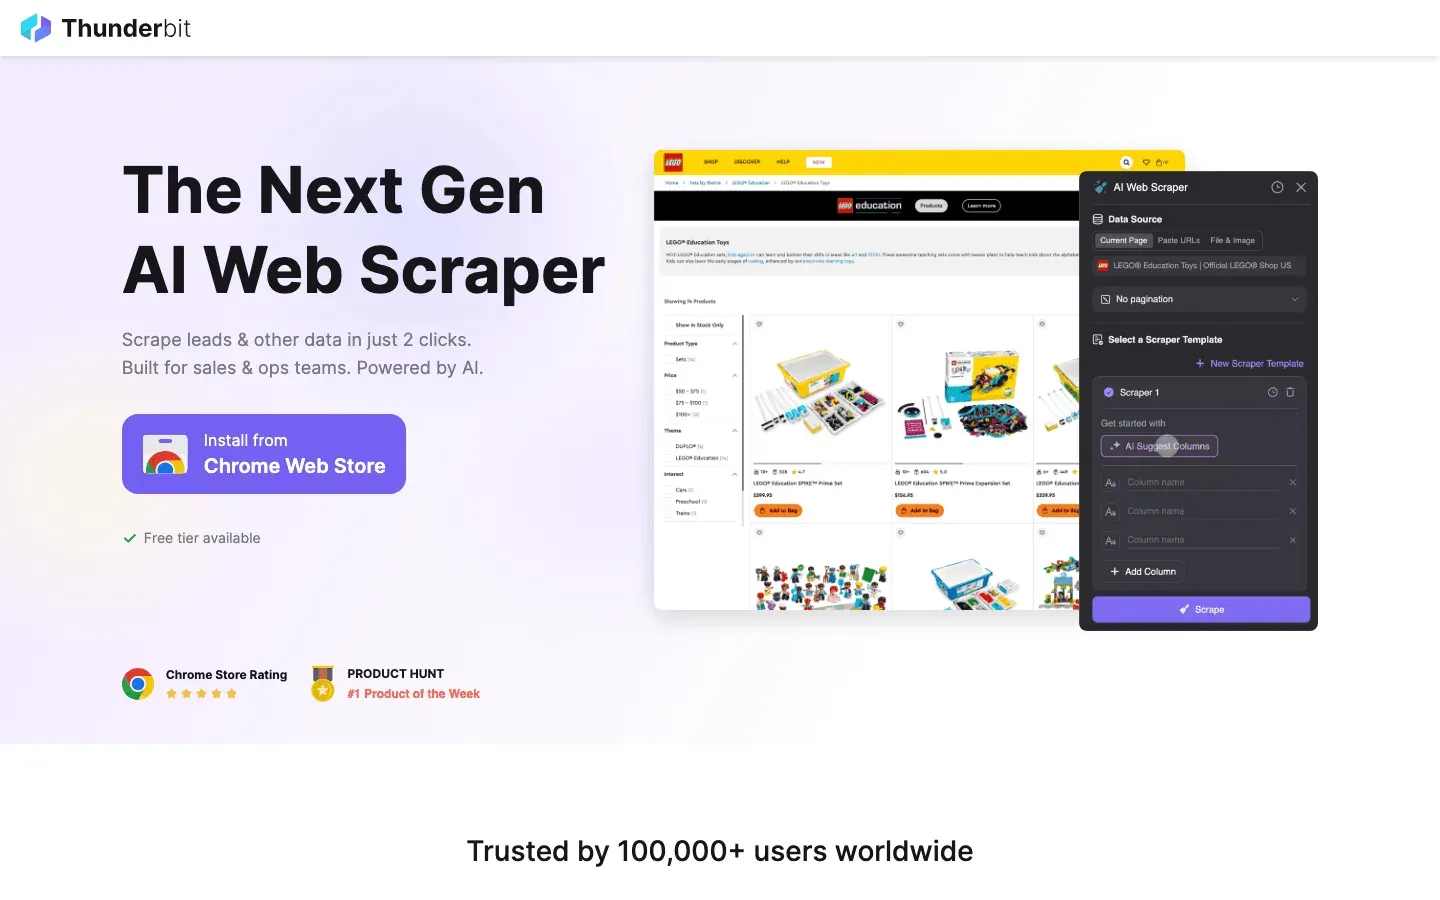 Thunderbit to nie jest typowa biblioteka Pythona – to rozszerzenie Chrome oparte na AI, które zmienia zasady gry w web scrapingu, zwłaszcza dla programistów Pythona, którzy chcą szybkości, dokładności i odrobiny magii AI. Co wyróżnia Thunderbit? Pozwala używać instrukcji w języku naturalnym, aby powiedzieć AI, jakie dane chcesz, a następnie zajmuje się wszystkim: sugestiami pól, nawigacją po podstronach, paginacją, a nawet eksportem do Excela, Google Sheets, Notion lub Airtable.
Thunderbit to ratunek dla scrapingu złożonych, nieustrukturyzowanych danych – pomyśl o chaotycznych katalogach, listach produktów lub stronach, gdzie HTML jest bardziej „sztuką abstrakcyjną” niż „ustrukturyzowanym dokumentem”. Funkcja AI Suggest Fields odczytuje stronę i proponuje najlepsze kolumny, podczas gdy Subpage Scraping pozwala wzbogacić zestaw danych poprzez automatyczne odwiedzanie połączonych stron szczegółów. A jeśli masz dość problemów z antybotami, opcje scrapingu Thunderbit oparte na przeglądarce i w chmurze zapewniają Ci ochronę.
Programiści Pythona uwielbiają Thunderbit za szybkie prototypowanie, generowanie leadów i badania rynku. Możesz używać jego danych wyjściowych bezpośrednio w swoim potoku danych Pythona, a nawet automatyzować przepływy pracy scrapingu za pomocą jego API. To nie jest tradycyjna biblioteka kodu, ale szybko staje się ulubionym narzędziem dla każdego, kto chce spędzać mniej czasu na kodowaniu, a więcej na analizowaniu danych.
Kluczowe cechy:
- Sugestie pól i ekstrakcja danych wspomagane przez AI
- Obsługuje podstrony, paginację, a nawet pliki PDF/obrazy
- Eksportuje do CSV, Excela, Google Sheets, Notion, Airtable
- Nie wymaga kodowania – idealne zarówno dla użytkowników nietechnicznych, jak i profesjonalistów Pythona, którzy chcą działać szybko
- Dostępna darmowa wersja; płatne plany skalują się wraz z Twoimi potrzebami
Najlepsze dla: Generowania leadów, badań rynku, szybkiego prototypowania i scrapingu złożonych lub nieuporządkowanych danych internetowych.
Wypróbuj Thunderbit AI Web Scraper za darmo
2. Beautiful Soup
 Beautiful Soup to klasyk parsowania HTML w Pythonie. Jeśli dopiero zaczynasz lub potrzebujesz wyodrębnić dane ze statycznych stron internetowych, to jest Twój najlepszy przyjaciel. Beautiful Soup doskonale radzi sobie z nawigacją i parsowaniem słabo ustrukturyzowanego HTML-a („zupy tagów”), co czyni go ratunkiem dla scrapingu stron, które nie przestrzegają zasad.
API jest przyjazne dla początkujących – pomyśl o .find(), .select() i .text – i doskonale współpracuje z requests do pobierania stron internetowych. Pod maską możesz wybrać różne parsery (takie jak lxml dla szybkości lub html5lib dla maksymalnej kompatybilności). Dokumentacja jest na najwyższym poziomie, a społeczność jest ogromna.
Kluczowe cechy:
- Intuicyjne, pythonowe API do nawigacji po HTML/XML
- Grzecznie radzi sobie z uszkodzonym lub niespójnym kodem
- Działa z wieloma parserami dla szybkości lub kompatybilności
- Ogromna społeczność i mnóstwo samouczków
Najlepsze dla: Szybkich skryptów, scrapingu statycznych stron i początkujących, którzy chcą łagodnej krzywej uczenia się.
Dowiedz się więcej o Beautiful Soup
3. Scrapy
 Scrapy to mistrz wagi ciężkiej w dziedzinie zautomatyzowanego, wielkoskalowego web crawlingu. Jeśli potrzebujesz scrapować setki lub tysiące stron, zarządzać potokami danych lub planować cykliczne zadania, Scrapy jest frameworkiem, na który decyduje się większość zespołów. Nadal działa na reaktorze Twisted, ale od wersji 2.14 duża część jego asynchronicznych wewnętrznych mechanizmów została przepisana jako natywne korutyny
asyncio, a teraz dostępne są punkty wejścia AsyncCrawlerProcess / AsyncCrawlerRunner, które dobrze współpracują z resztą nowoczesnego asynchronicznego ekosystemu Pythona. Jest szybki, obsługuje współbieżne crawling, potoki elementów do czyszczenia danych i eksportuje do JSON, CSV lub baz danych.
Scrapy jest rozszerzalny, z wtyczkami do proxy, buforowania, a nawet ograniczonego renderowania JavaScript (za pośrednictwem integracji ze Splash lub Selenium). Krzywa uczenia się jest bardziej stroma niż w przypadku Beautiful Soup, ale jeśli poważnie myślisz o danych internetowych na dużą skalę, Scrapy to narzędzie, do którego dojrzejesz.
Kluczowe cechy:
- Asynchroniczne crawling za pośrednictwem reaktora Twisted + natywne korutyny
asyncio(Scrapy 2.14+, Python 3.10+) - Wbudowane potoki do czyszczenia i przechowywania danych
- Eksport do wielu formatów (JSON, CSV, DB)
- Duża, aktywna społeczność i ekosystem wtyczek
Najlepsze dla: Wielkoskalowych, cyklicznych projektów scrapingu, potoków danych i każdego, kto potrzebuje szybkości i niezawodności.
4. Selenium
 Selenium to podstawowe narzędzie do scrapingu stron internetowych z dużą ilością JavaScriptu lub interaktywnych. Automatyzuje prawdziwe przeglądarki (Chrome, Firefox itp.), umożliwiając symulowanie działań użytkownika, takich jak kliknięcia, przewijanie i przesyłanie formularzy. Jeśli potrzebne dane pojawiają się dopiero po uruchomieniu JavaScriptu, Selenium może je pobrać – bez względu na to, jak uparta jest strona.
Jaki jest kompromis? Selenium jest wolne i zasobożerne. Uruchamiasz pełną przeglądarkę dla każdego scrapingu, więc nie spodziewaj się przetwarzania tysięcy stron na minutę. Ale w scenariuszach „żadne inne narzędzie tego nie potrafi”, Selenium jest ratunkiem.
Kluczowe cechy:
- Pełna automatyzacja przeglądarki (obsługuje Chrome, Firefox, Edge itp.)
- Obsługuje treści renderowane przez JavaScript i elementy interaktywne
- Obsługuje tryb headless dla szybszego scrapingu bez interfejsu użytkownika
- Duża społeczność i obszerna dokumentacja
Najlepsze dla: Scrapingu dynamicznych stron z dużą ilością JavaScriptu, automatyzacji procesów logowania i obsługi CAPTCHA lub złożonych interakcji użytkownika.
Przeczytaj więcej o mocnych i słabych stronach Selenium
5. PyQuery
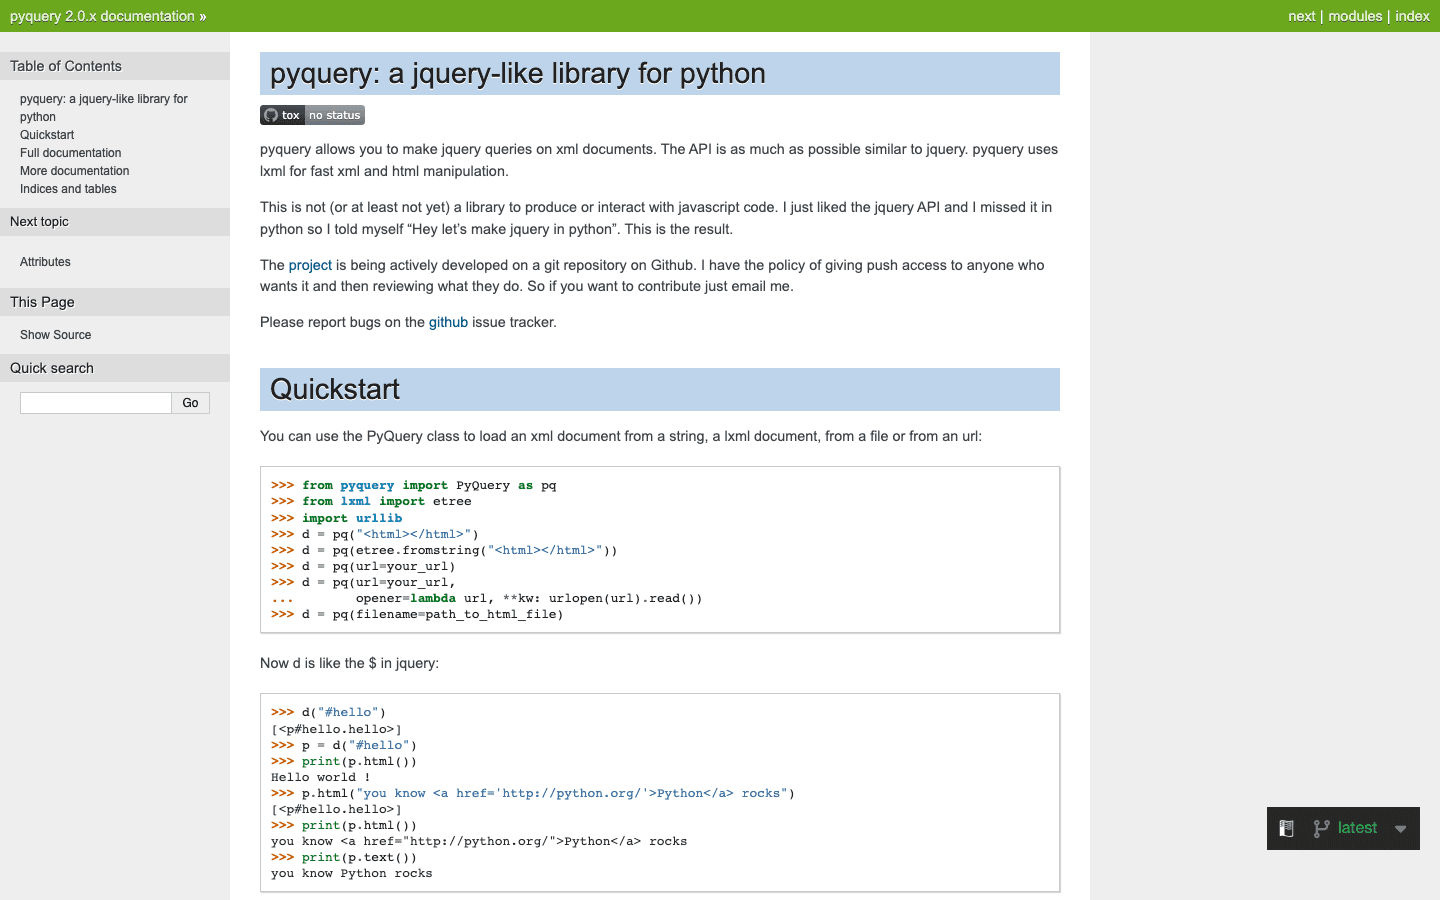 PyQuery wprowadza składnię w stylu jQuery do Pythona, sprawiając, że parsowanie HTML wydaje się znajome każdemu, kto pracował z jQuery w JavaScript. Opiera się na szybkim parserze
lxml i pozwala używać selektorów CSS, takich jak $('div.classname'), do znajdowania elementów.
PyQuery jest świetny do szybkiego prototypowania i dla programistów, którzy chcą zwięzłego, czytelnego kodu. Jest szybszy niż Beautiful Soup dla złożonych zapytań i łatwo integruje się z narzędziami asynchronicznymi lub Selenium dla bardziej zaawansowanych przepływów pracy.
Kluczowe cechy:
- Selektory i składnia podobne do jQuery w Pythonie
- Szybkie parsowanie z wykorzystaniem backendu lxml
- Świetne dla programistów przechodzących z JavaScriptu
- Obsługuje łańcuchowanie i zwięzłe zapytania
Najlepsze dla: Prototypowania, fanów jQuery i każdego, kto chce pisać mniej kodu do parsowania HTML.
Samouczek i porównanie PyQuery
6. LXML
 LXML to demon szybkości w parsowaniu HTML i XML w Pythonie. Zbudowany na bibliotekach C
libxml2 i libxslt, słynie z wydajności i potężnego wsparcia dla selektorów XPath i CSS. Jeśli masz do czynienia z dużymi dokumentami lub musisz uruchamiać złożone zapytania, lxml jest Twoim najlepszym wyborem.
Może być używany bezpośrednio lub jako backend dla Beautiful Soup lub PyQuery. API jest nieco bardziej zaawansowane, ale szybkość i elastyczność są tego warte w przypadku dużych zadań.
Kluczowe cechy:
- Najszybsze dostępne parsowanie w Pythonie
- Pełne wsparcie dla selektorów XPath i CSS
- Efektywnie obsługuje duże i złożone dokumenty
- Może być używany samodzielnie lub jako parser dla innych bibliotek
Najlepsze dla: Wysokowydajnego parsowania, wielkoskalowego scrapingu i projektów wymagających zaawansowanych zapytań.
Dlaczego lxml wyróżnia się w parsowaniu
7. Requests
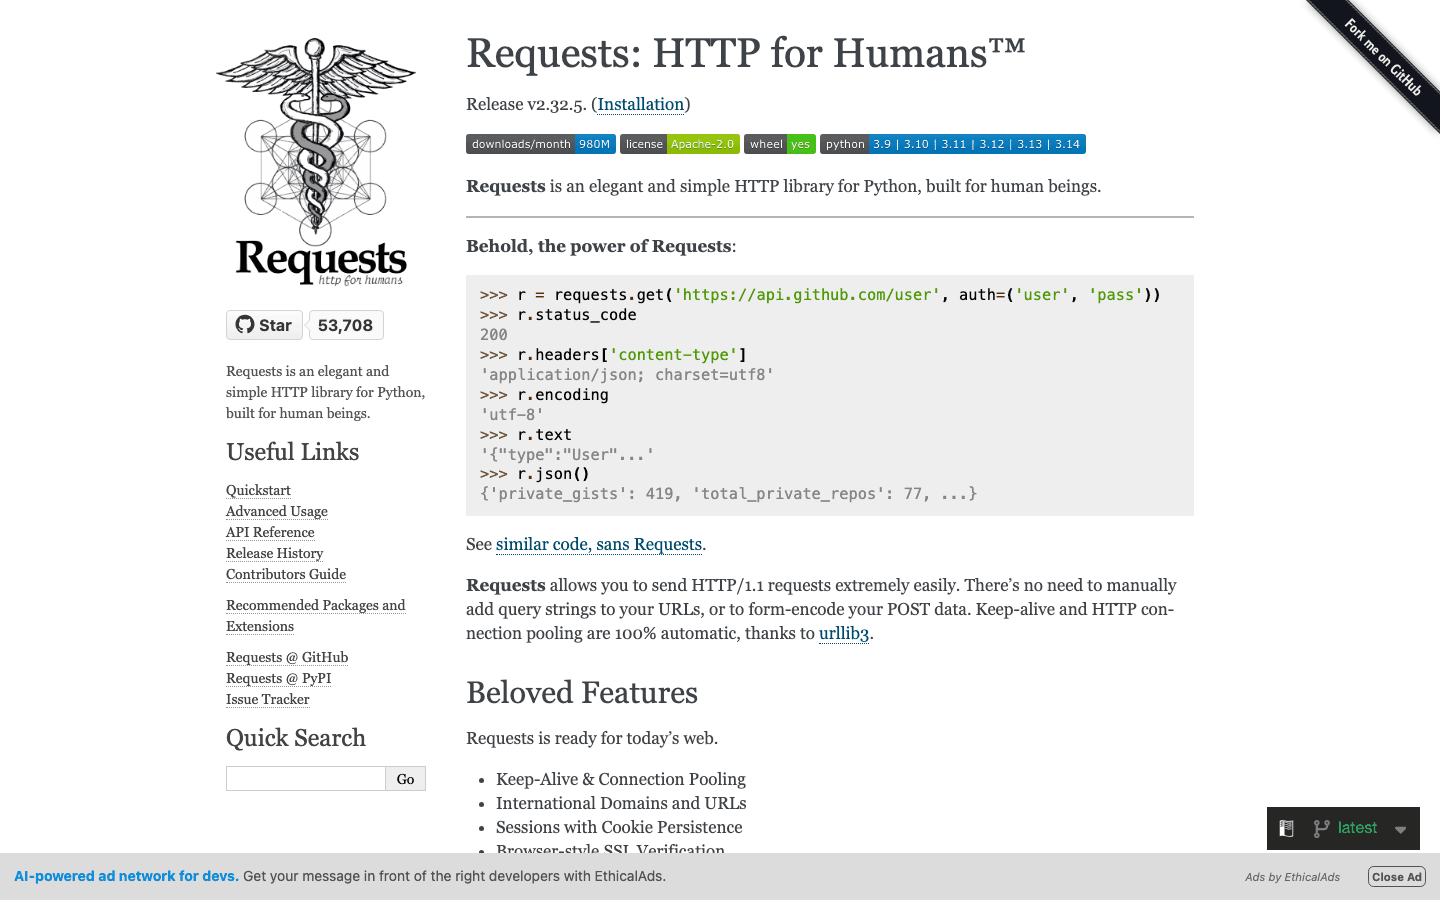 Requests to de facto standard do wykonywania żądań HTTP w Pythonie. Jego czyste, intuicyjne API sprawia, że pobieranie stron internetowych jest tak proste, jak
requests.get(url). Obsługuje pliki cookie, sesje, a nawet dekodowanie JSON od razu po wyjęciu z pudełka.
Chociaż Requests jest synchroniczne (każde żądanie czeka na zakończenie), jest idealne do szybkich skryptów i scrapingu na małą skalę. Połącz je z Beautiful Soup lub lxml, aby uzyskać klasyczny przepływ pracy scrapingu.
Kluczowe cechy:
- Proste, pythonowe API do żądań HTTP
- Obsługuje pliki cookie, sesje i przekierowania
- Bezproblemowo integruje się z bibliotekami parsowania
- Ogromna społeczność i dokumentacja
Najlepsze dla: Prostych skryptów, scrapingu statycznych stron i początkujących, którzy chcą szybko zacząć.
Zobacz, dlaczego Requests jest tak popularne
8. MechanicalSoup
 MechanicalSoup to lekka biblioteka, która automatyzuje proste interakcje z przeglądarką – takie jak wypełnianie formularzy lub nawigowanie po wieloetapowych procesach logowania – bez uruchamiania pełnej przeglądarki. Opiera się na
requests i Beautiful Soup, co czyni go znacznie szybszym i lżejszym niż Selenium dla stron, które nie opierają się w dużym stopniu na JavaScript.
Jeśli musisz się zalogować, przesłać formularze lub przeklikać kilka stron (a strona nie jest zbyt dynamiczna), MechanicalSoup to świetne rozwiązanie pośrednie.
Kluczowe cechy:
- Automatyzuje wypełnianie formularzy i nawigację
- Zbudowany na Requests i Beautiful Soup
- Lekki i szybki (bez narzutu przeglądarki)
- Łatwy w użyciu dla umiarkowanej interaktywności
Najlepsze dla: Stron wymagających logowania lub przesyłania formularzy, prostych zadań automatyzacji i każdego, kto chce uniknąć narzutu Selenium.
Samouczek MechanicalSoup
9. Aiohttp
 Aiohttp to asynchroniczna potęga do szybkich, współbieżnych żądań internetowych. Jeśli potrzebujesz szybko scrapować setki stron, aiohttp pozwala wysyłać żądania równolegle, drastycznie skracając całkowity czas wykonania. W jednym z testów, scraping 50 stron zajął tylko 3 sekundy z aiohttp, w porównaniu do 16 sekund przy użyciu synchronicznych żądań (zobacz różnicę w wydajności).
Aiohttp wymaga pisania kodu async def i używania await, ale zyski na szybkości są tego warte w przypadku dużych zadań.
Kluczowe cechy:
- Asynchroniczny framework klienta/serwera HTTP
- Obsługuje sesje, pliki cookie i HTTP/2
- Ogromne przyspieszenie dla współbieżnych żądań
- Integruje się z asynchronicznymi bibliotekami parsowania
Najlepsze dla: Szybkiego, wielkoskalowego scrapingu, zbierania danych z API i każdego, kto czuje się komfortowo z programowaniem asynchronicznym.
10. Twisted
 Twisted to silnik sieciowy oparty na zdarzeniach, który napędza Scrapy. Chociaż nie jest to biblioteka do scrapingu per se, zaawansowani użytkownicy mogą używać Twisted bezpośrednio do budowania niestandardowych crawlerów, obsługi protokołów innych niż HTTP lub implementowania hiper-współbieżnych pająków.
Twisted jest potężny, ale wiąże się ze stromą krzywą uczenia się. Jest najlepszy do wysoce niestandardowych scenariuszy lub podczas budowania frameworków od podstaw.
Kluczowe cechy:
- Sieciowanie oparte na zdarzeniach dla HTTP, WebSockets, SSH i innych
- Obsługuje SSL, współbieżność i niestandardowe protokoły
- Stanowi podstawę asynchronicznego silnika Scrapy
- Wysoce elastyczny dla zaawansowanych zastosowań
Najlepsze dla: Niestandardowych protokołów, budowania frameworków do scrapingu i zaawansowanych użytkowników, którzy potrzebują maksymalnej kontroli.
11. Grab
 Grab to kompleksowy zestaw narzędzi do scrapingu, który łączy żądania HTTP, parsowanie, automatyzację, rotację proxy i obsługę CAPTCHA. Jest podobny duchem do Scrapy, ale ma być łatwiejszy do nauczenia i użycia, z wbudowaną obsługą proxy, buforowania i asynchronicznych pająków.
Wyróżniającą się cechą Grab jest system Grab:Spider, który może uruchamiać tysiące żądań równolegle za pomocą multicurl. Jeśli potrzebujesz kompleksowego rozwiązania z mniejszą konfiguracją niż Scrapy, warto przyjrzeć się Grab.
Kluczowe cechy:
- Wbudowana obsługa proxy, rotacji user-agent i buforowania
- Asynchroniczny system pająków dla wysokiej współbieżności
- Parsowanie XPath i modułowa architektura
- Używany w produkcji do wielkoskalowego scrapingu
Najlepsze dla: Kompleksowych projektów scrapingu, zadań mocno obciążonych proxy i użytkowników, którzy chcą mocy bez złożoności Scrapy.
Wprowadzenie do frameworka Grab
12. Urllib3
 Urllib3 to niskopoziomowy silnik HTTP, który napędza wiele klientów Pythona, w tym Requests. Oferuje pulę połączeń, bezpieczeństwo wątków, ponowne próby i precyzyjną kontrolę nad połączeniami HTTP. Chociaż większość programistów używa go pośrednio, urllib3 jest Twoim wyborem, gdy potrzebujesz maksymalnej wydajności lub budujesz biblioteki wyższego poziomu.
Nie jest tak przyjazny dla początkujących jak Requests, ale jest sprawdzony w boju i bardzo niezawodny.
Kluczowe cechy:
- Pula połączeń i bezpieczeństwo wątków
- Precyzyjna kontrola nad połączeniami HTTP
- Używany jako podstawa dla wielu innych bibliotek
- Wysoka wydajność dla powtarzających się żądań
Najlepsze dla: Niestandardowych klientów HTTP, wielowątkowych crawlerów i programistów budujących na stosie HTTP Pythona.
Zobacz rolę urllib3 w scrapingu
Tabela porównawcza: Pakiety Pythona do web scrapingu w skrócie
| Pakiet | Łatwość użycia | Wydajność | Treść dynamiczna | Moc parsowania | Społeczność/Dokumentacja | Najlepsze dla |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Szybki (chmura/lokalnie) | Tak (przez AI) | Automatyczne pola, podstrony | Rosnąca (trend AI) | Generowanie leadów, badania rynku, użytkownicy bez kodu |
| Beautiful Soup | ★★★★★ (łatwy) | Średnia | Nie | HTML/XML, wyrozumiały | Ogromna | Strony statyczne, początkujący |
| Scrapy | ★★☆☆☆ (strome) | ★★★★★ (bardzo wysoka) | Tylko wtyczki | CSS/XPath, potoki | Duża, aktywna | Wielkoskalowe, cykliczne scraping |
| Selenium | ★★☆☆☆ (średnie) | ★☆☆☆☆ (wolne) | Tak (pełne) | Pełny DOM, JS | Dojrzała | Strony z dużą ilością JS, interaktywne |
| PyQuery | ★★★★☆ (jQuery) | Szybki (lxml) | Nie* | Selektory jQuery | Umiarkowana | Prototypowanie, deweloperzy jQuery |
| LXML | ★★★☆☆ (zaawansowane) | ★★★★★ (najszybszy) | Nie | XPath/CSS, XML | Umiarkowana | Duże dokumenty, zaawansowane zapytania |
| Requests | ★★★★★ (bardzo łatwy) | ★★☆☆☆ (synchroniczne) | Nie | HTTP, JSON | Ogromna | Proste skrypty, strony statyczne |
| MechanicalSoup | ★★★★☆ (łatwy) | ★★☆☆☆ (synchroniczne) | Nie | Formularze, nawigacja | Mała | Procesy logowania, automatyzacja formularzy |
| Aiohttp | ★★☆☆☆ (asynchroniczne) | ★★★★★ (współbieżne) | Nie | Asynchroniczne HTTP | Duża (asynchroniczne) | Szybkie, współbieżne scraping |
| Twisted | ★☆☆☆☆ (złożone) | ★★★★★ (niestandardowe) | Nie | Sieciowanie, protokoły | Niszowa | Niestandardowe frameworki, zaawansowani użytkownicy |
| Grab | ★★★☆☆ (modułowe) | ★★★★☆ (asynchroniczne) | Nie | Proxy, XPath | Mała | Kompleksowe, mocno obciążone proxy/captcha |
| Urllib3 | ★★★★☆ (niskopoziomowe) | ★★★★☆ (z pulą) | Nie | HTTP, pula | Ogromna | Niestandardowe klienty, wielowątkowe crawlery |
*PyQuery można połączyć z Selenium dla stron dynamicznych.
Jak wybrać odpowiedni pakiet Pythona do web scrapingu dla swoich potrzeb
Czym jest scraping danych i jak go wykonać w 2026 roku Get Started Free
Więc który pakiet powinieneś wybrać? Oto moja ściągawka:
- Strony statyczne, małe zadania lub jesteś początkujący w scrapingu: Zacznij od Requests + Beautiful Soup.
- Wielkoskalowe, cykliczne lub produkcyjne scraping: Scrapy lub Grab (dla kompleksowych potrzeb).
- Strony z dużą ilością JavaScriptu lub interaktywne: Selenium (lub Thunderbit, jeśli chcesz scrapingu opartego na AI, bez kodu).
- Szybkie, współbieżne scraping: Aiohttp (jeśli czujesz się komfortowo z asynchronicznym programowaniem).
- Automatyzacja formularzy lub procesów logowania: MechanicalSoup (dla prostych stron), Selenium (dla złożonych JS).
- Zaawansowane parsowanie lub ogromne dokumenty: LXML lub PyQuery.
- Niestandardowe sieciowanie lub praca z protokołami: Twisted.
- Szybkie prototypowanie, generowanie leadów lub nieuporządkowane dane: Thunderbit.
I nie bój się mieszać i dopasowywać – wiele przepływów pracy łączy te narzędzia dla maksymalnej wydajności. Na przykład, możesz użyć Selenium do renderowania strony, a następnie przekazać HTML do Beautiful Soup lub PyQuery do parsowania.
Podsumowanie: Zwiększ wydajność swojego web scrapingu dzięki odpowiednim narzędziom Pythona
Web scraping w 2026 roku jest potężniejsze – i bardziej potrzebne – niż kiedykolwiek. Dzięki odpowiednim pakietom Pythona do web scrapingu możesz przekształcić chaos sieci w czyste, użyteczne dane dla swojej firmy, badań lub kolejnego wielkiego pomysłu. Niezależnie od tego, czy jesteś doświadczonym programistą, czy dopiero zanurzasz się w basenie danych, na tej liście znajdziesz narzędzie, które odpowiada Twoim potrzebom.
Jeśli chcesz zobaczyć, jak wygląda scraping oparty na AI, bez kodu, wypróbuj Thunderbit. A jeśli masz ochotę na więcej wskazówek, dogłębnych analiz i samouczków, sprawdź Blog Thunderbit, aby znaleźć najnowsze informacje na temat web scrapingu, automatyzacji i przepływów pracy opartych na danych.
Wypróbuj Thunderbit AI Web Scraper
Udanych scrapingów – i niech Twoje selektory zawsze pasują, Twoje proxy nigdy nie zawiodą, a Twoje dane będą tak czyste, jak Twój kod.
Często zadawane pytania
1. Jaki jest najlepszy pakiet Pythona do web scrapingu dla początkujących? Dla większości początkujących, połączenie Requests i Beautiful Soup to najłatwiejszy sposób na rozpoczęcie. Oba mają intuicyjne API, mnóstwo samouczków i obsługują większość zadań scrapingu statycznych stron.
2. Jak scrapować strony internetowe z dużą ilością JavaScriptu za pomocą Pythona? Użyj Selenium, aby zautomatyzować prawdziwą przeglądarkę, lub wypróbuj Thunderbit do scrapingu opartego na AI, bez kodu, które może obsługiwać dynamiczną zawartość. W przypadku potrzeb na dużą skalę, Scrapy można połączyć ze Splash lub Selenium.
3. Który pakiet jest najlepszy do wielkoskalowego, szybkiego scrapingu? Scrapy jest zbudowany do wielkoskalowego, asynchronicznego crawlingu. Jeśli potrzebujesz jeszcze większej szybkości i czujesz się komfortowo z kodem asynchronicznym, aiohttp jest najlepszym wyborem do współbieżnych żądań.
4. Czy mogę łączyć te pakiety w moim przepływie pracy? Absolutnie! Wielu programistów używa Requests lub Selenium do pobierania stron, a następnie parsuje je za pomocą Beautiful Soup, lxml lub PyQuery. Dane wyjściowe Thunderbit można wprowadzać do skryptów Pythona w celu dalszej analizy.
5. Czy Thunderbit to biblioteka Pythona czy samodzielne narzędzie? Thunderbit to rozszerzenie Chrome i platforma oparta na AI, a nie tradycyjna biblioteka Pythona. Jednak jego dane wyjściowe (CSV, Excel, Sheets, Notion, Airtable) bezproblemowo integrują się z potokami danych Pythona, co czyni go potężnym towarzyszem dla programistów Pythona.
6. Czy agenci kodujący AI zastąpią biblioteki Pythona do scrapingu w 2026 roku? Jeszcze nie, ale warto o nich wiedzieć. Narzędzia takie jak Claude Code i OpenAI Codex mogą wygenerować działający skrypt Requests + Beautiful Soup lub Scrapy z prostego polecenia w języku angielskim w kilka sekund, co jest naprawdę przydatne do jednorazowych zadań i prototypowania. W przypadku przepływów przeglądarki w języku naturalnym (logowanie, dynamiczny JS, nawigacja wieloetapowa), Browser Use jest opcją open-source, po którą sięgają ludzie, a Firecrawl jest popularny, gdy celem jest dostarczanie czystego markdown do LLM. Żadne z nich nie eliminuje trudnych części – nadal obowiązują zabezpieczenia antybotowe, limity szybkości i warunki korzystania z usługi – a w przypadku produkcyjnych crawlerów na dużą skalę, Scrapy + aiohttp nadal wygrywają pod względem kosztów i kontroli. Traktuj agentów AI jako szybszy sposób na napisanie scrapingu, a nie jako zamiennik bibliotek z tej listy.
Chcesz być na bieżąco w świecie web scrapingu? Subskrybuj Kanał Thunderbit na YouTube i śledź Blog Thunderbit, aby uzyskać więcej przewodników, porównań i wskazówek dotyczących automatyzacji.
Wypróbuj Thunderbit AI Web Scraper za darmo Get Started Free
Dowiedz się więcej
- 10 najlepszych bibliotek Pythona do web scrapingu i alternatywa AI
- 7 najpopularniejszych narzędzi do web scrapingu w 2026 roku
- 5 najlepszych programów do scrapingu danych internetowych w 2026 roku
- Najlepsze narzędzia i oprogramowanie do web scrapingu w 2025 roku
- BeautifulSoup w Pythonie: Przewodnik dla początkujących




