
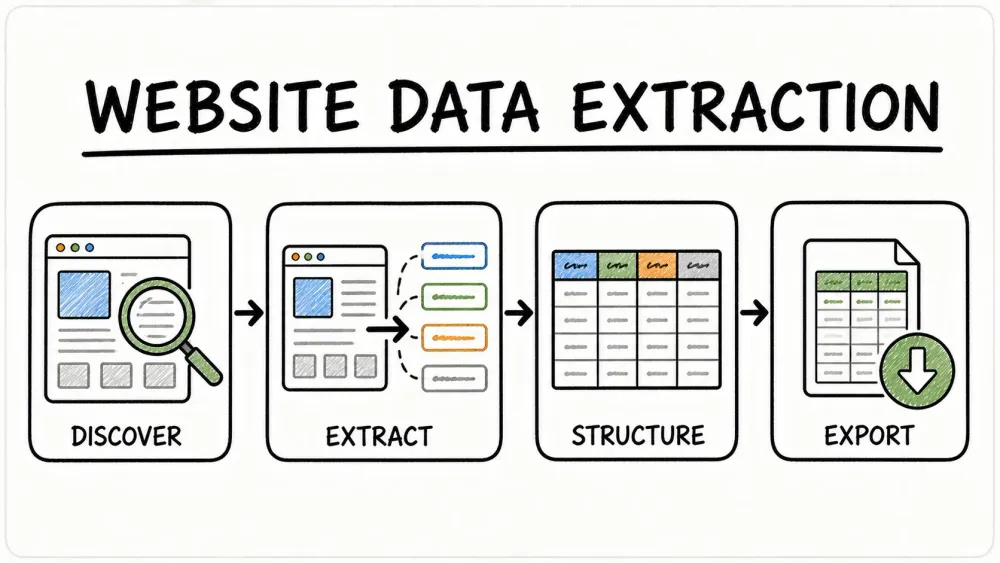
Sieć jest przepełniona informacjami, ale zamiana tego chaosu w dane biznesowe, na których naprawdę da się działać? To właśnie jest prawdziwe wyzwanie — i jednocześnie ogromna szansa. Przez lata tworzenia narzędzi SaaS i automatyzacji widziałem, jak świat odchodzi od decyzji podejmowanych „na wyczucie” w stronę wszystkiego opartego na danych. To już nie jest domena wyłącznie gigantów technologicznych; nawet małe zespoły ścigają się dziś w pozyskiwaniu danych ze stron internetowych, żeby napędzać sprzedaż, marketing, politykę cenową i rozwój produktu. Problem w tym, że wraz ze wzrostem złożoności i dynamiki sieci zdobycie z niej czystych, zgodnych z przepisami i naprawdę użytecznych danych staje się zupełnie nową grą.
Przejdźmy do konkretów: pokażę Ci, dlaczego pozyskiwanie danych ze stron internetowych jest dziś tak ważne dla nowoczesnego biznesu, jakie największe przeszkody napotkasz po drodze oraz jakie najlepsze praktyki — w tym kilka lekcji wyciągniętych przez zespół Thunderbit — pomogą Ci robić to dobrze, legalnie, efektywnie i na dużą skalę. Niezależnie od tego, czy zmagasz się z nieustrukturyzowanymi treściami, obawiasz się RODO, czy po prostu masz dość ręcznego kopiowania do arkuszy, ten poradnik jest dla Ciebie.
Dlaczego pozyskiwanie danych ze stron internetowych ma dziś znaczenie dla biznesu
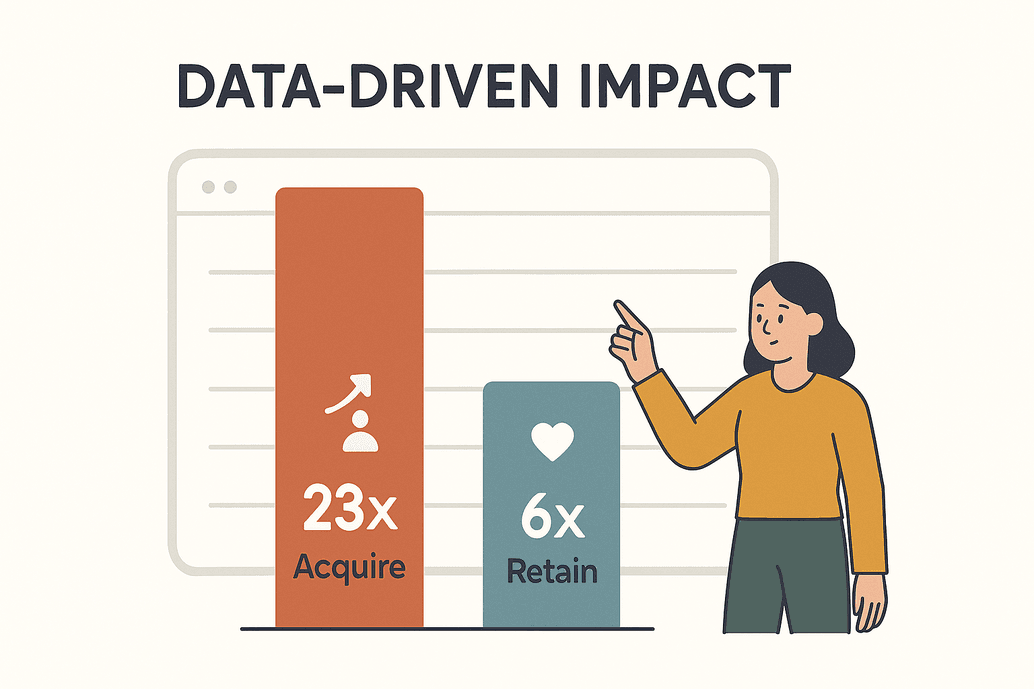 Dane to nie tylko modne hasło — to dziś krwiobieg konkurencyjnego biznesu. Jak wynika z badania McKinsey, organizacje oparte na danych są 23 razy bardziej skłonne pozyskiwać klientów i 6 razy bardziej skłonne ich utrzymywać. To nie jest tylko imponujący wynik — to kwestia przetrwania. Do 2025 roku firmy będą codziennie przetwarzać miliardy stron internetowych, aby zasilać analitykę, modele AI i podejmowanie decyzji w czasie rzeczywistym (kanhasoft.com).
Jak to wygląda w praktyce? Oto kilka scenariuszy, które widzę niemal co tydzień:
| Zastosowanie biznesowe | Opis i korzyści | Przykład / statystyka |
|---|---|---|
| Monitorowanie cen | Śledź ceny konkurencji, stany magazynowe i promocje w czasie rzeczywistym; dostosuj własną strategię, by utrzymać przewagę. | Ponad 80% największych sprzedawców online codziennie pobiera ceny konkurencji (kanhasoft.com). |
| Generowanie leadów | Pobieraj dane z katalogów, mediów społecznościowych lub serwisów z opiniami, aby zdobywać świeże leady i dane kontaktowe. | Zautomatyzowane pozyskiwanie danych zasila CRM szybciej niż jakiekolwiek ręczne researchowanie. |
| Analiza trendów rynkowych | Zbieraj recenzje, wpisy na forach i newsy, aby wcześnie wychwytywać trendy lub zmiany nastrojów. | 26% działań związanych z web scrapingiem koncentruje się na mediach społecznościowych w celu analizy trendów (blog.apify.com). |
| Agregacja treści | Zbieraj wiadomości, oferty produktowe lub wydarzenia z wielu witryn w jednym miejscu. | Zespoły medialne tworzą spersonalizowane feedy dla swoich odbiorców. |
| Dane produktowe i badawcze | Gromadź informacje o produktach, opinie lub dane badawcze do analizy i rozwoju. | 67% doradców inwestycyjnych korzysta z alternatywnych danych webowych (scrap.io). |
| Dane do trenowania AI | Pobieraj ogromne ilości tekstu, obrazów lub rekordów, aby trenować modele AI. | Około 70% dużych modeli AI opiera się na danych pozyskanych z sieci (kanhasoft.com). |
Jeśli nie pozyskujesz danych ze stron internetowych, to nie tylko zostajesz w tyle — stajesz się niewidoczny na swoim rynku. Widziałem zespoły e-commerce, które w ciągu sześciu miesięcy potroiły zwrot z inwestycji tylko dzięki automatyzacji pobierania cen konkurencji (kanhasoft.com). Wniosek jest prosty: dane webowe to strategiczny zasób, a umiejętne ich pozyskiwanie to dziś absolutna podstawa.
Największe wyzwania przy pozyskiwaniu danych z dowolnej strony internetowej
Oczywiście nie wszystko jest takie proste. Sieć to dzikie środowisko, a wyciąganie z niej danych wiąże się z realnymi przeszkodami:
- Nieustrukturyzowane dane: Około 80% danych online jest nieustrukturyzowanych — ukrytych w chaotycznym HTML-u, rozsianych po wielu podstronach albo schowanych za elementami interaktywnymi. Zamiana tego w przejrzystą tabelę to nie lada wyzwanie (scrapingapi.ai).
- Zmieniające się strony: Serwisy ciągle aktualizują układ i wygląd. Widziałem scraping, który psuł się 15 razy w ciągu jednego miesiąca tylko dlatego, że docelowa strona lekko zmieniła projekt (scrap.io).
- Skala i wolumen: Firmy muszą pozyskiwać dane z setek albo tysięcy stron — często według harmonogramu. Ręczne kopiowanie po prostu nie daje rady.
- Zabezpieczenia antyscrapingowe: CAPTCHA, limity zapytań, ekrany logowania… Serwisy coraz lepiej blokują boty. Już ponad jedna trzecia całego ruchu w sieci to boty (scrap.io), a technologie antybotowe rozwijają się błyskawicznie.
- Błędy ludzkie: Ręczne kopiowanie jest powolne i podatne na pomyłki. Jeden błędny selektor i pobierasz złe dane — albo nie pobierasz nic.
Tradycyjne metody po prostu nie skalują się tak, jak trzeba. Dlatego coraz więcej zespołów sięga po inteligentniejsze, zautomatyzowane rozwiązania — i dlatego tak mocno stawiam na narzędzia oparte na AI.
Najlepsze praktyki prawne, zgodnościowe i bezpieczeństwa przy pozyskiwaniu danych ze stron internetowych
Wyjaśnijmy to od razu: to, że możesz pobierać dane ze strony, nie oznacza jeszcze, że powinieneś — przynajmniej nie bez zastanowienia się nad aspektami prawnymi i etycznymi. Oto, co każda firma powinna wiedzieć:
- Dane publiczne vs prywatne: Pobieranie publicznie dostępnych informacji jest w wielu miejscach zazwyczaj legalne. Ale cokolwiek za logowaniem? To już strefa zakazana. Omijanie uwierzytelniania jest niedopuszczalne (xbyte.io).
- Regulamin serwisu: Zawsze sprawdzaj ToS strony. Jeśli scraping jest zabroniony, ryzykujesz pozew albo zablokowanie dostępu. Gdy masz wątpliwości, poproś o zgodę albo skorzystaj z oficjalnego API.
- Prawo prywatności (RODO, CCPA): Jeśli zbierasz dane osobowe, potrzebujesz legalnej podstawy (np. uzasadnionego interesu), musisz ograniczać zakres zbieranych danych i być gotowy je usunąć na żądanie. Brak zgodności może oznaczać ogromne kary (xbyte.io).
- Szanuj robots.txt: To nie jest dokument prawnie wiążący, ale dobra praktyka. Przestrzegaj opóźnień crawl i nie obciążaj serwerów.
- Bezpieczeństwo danych: Traktuj pobrane dane jak wrażliwe. Przechowuj je bezpiecznie, ogranicz dostęp i czyść je przed użyciem.
Lista kontrolna zgodności:
| Obszar | Najlepsza praktyka |
|---|---|
| Dostęp prawny | Pobieraj wyłącznie dane publiczne; nigdy nie omijaj logowania (xbyte.io). |
| Regulamin serwisu | Przejrzyj i respektuj ToS; jeśli scraping jest zakazany, użyj API. |
| Dane osobowe | Unikaj ich zbierania, jeśli to możliwe; jeśli to konieczne, minimalizuj zakres i działaj zgodnie z RODO/CCPA. |
| robots.txt i opóźnienia crawl | Przestrzegaj zasad serwisu; ograniczaj tempo zapytań. |
| Bezpieczeństwo danych | Szyfruj, ograniczaj dostęp i usuwaj dane, gdy nie są już potrzebne. |
Zwiększanie efektywności: jak AI usprawnia pozyskiwanie danych ze stron internetowych
A teraz robi się ciekawie. AI całkowicie zmieniło sposób, w jaki pozyskujemy dane ze stron internetowych. Zamiast walczyć z selektorami albo pisać kruche skrypty, możesz dziś używać narzędzi opartych na AI, które „czytają” stronę i same rozumieją, co należy pobrać — często wystarczy dosłownie kilka kliknięć.
Co to oznacza w praktyce?
- Minimalna konfiguracja: Narzędzia oparte na AI, takie jak Thunderbit, potrafią automatycznie wykrywać pola. Wystarczy kliknąć „One Click Extract”, a narzędzie zaproponuje właściwe kolumny — bez kodowania i bez prób oraz błędów.
- Elastyczność: Scrapery AI rozpoznają wzorce, a nie tylko sztywne układy. Jeśli strona się zmieni, AI często dostosowuje się samo. To mniej utrzymania i mniej nocnych akcji ratunkowych.
- Dokładność: AI może odfiltrowywać szum, usuwać duplikaty, a nawet porządkować chaotyczne dane już w trakcie pobierania. Niektóre zespoły raportują dokładność sięgającą 99,5% przy użyciu ekstraktorów opartych na AI (scrapingapi.ai).
- Dynamiczna treść: Scrapery AI radzą sobie z serwisami opartymi na JavaScript, nieskończonym przewijaniem, a nawet potrafią wyciągać tekst z obrazów czy PDF-ów.
- Przetwarzanie w locie: Potrzebujesz danych przetłumaczonych, sklasyfikowanych albo podsumowanych już w trakcie pobierania? AI zrobi to za jednym razem.
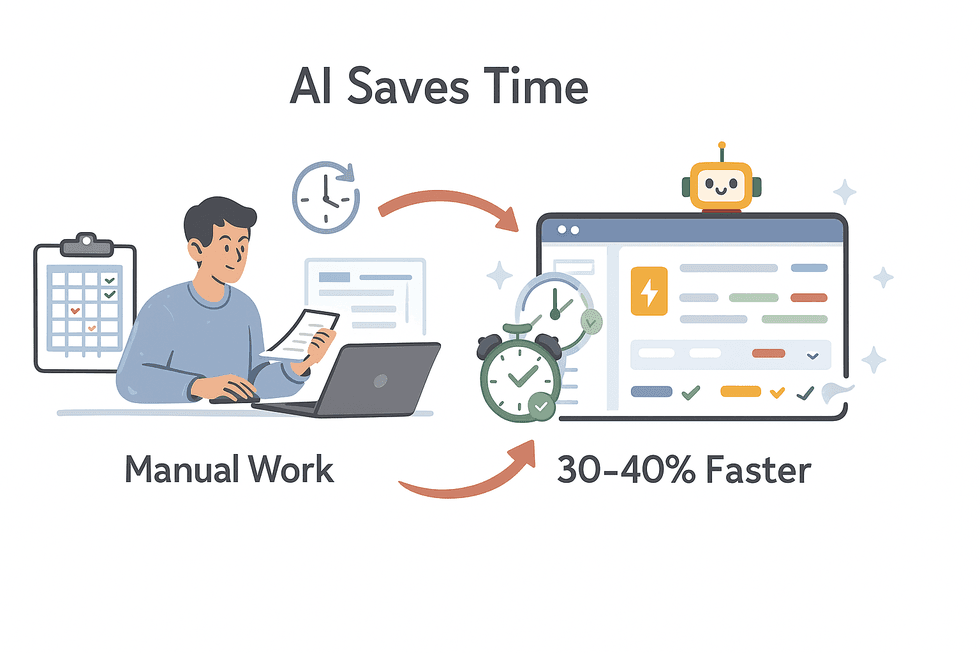 Widziałem zespoły, które dzięki przejściu na narzędzia AI oszczędzały 30–40% czasu poświęcanego na pozyskiwanie danych (scrapingapi.ai). To nie tylko wzrost produktywności — to realna przewaga konkurencyjna.
Pozyskuj dane z dowolnej strony z pomocą AI Agentowy web scraper Thunderbit samodzielnie czyta dowolną stronę i wybiera pola do pobrania — krok po kroku, jednym kliknięciem. Get Started Free
Thunderbit zostało stworzone po to, by pozyskiwanie danych było proste, dokładne i dostępne — nawet dla osób, które nigdy nie napisały ani jednej linijki kodu. (Tak, moja mama też potrafi z tego korzystać. Nadal jednak walczy z Netfliksem.)
Thunderbit Agentic Web Scraper: kluczowe funkcje dla użytkowników biznesowych
Pozwól, że trochę się pochwalę tym, co zbudowaliśmy w Thunderbit (hej, chyba mogę, prawda?). Thunderbit jest zaprojektowane z myślą o użytkownikach biznesowych — sprzedaży, operacjach, marketingu, nieruchomościach — którzy chcą efektów, a nie problemów. Oto, co je wyróżnia:
- One Click Extract: Klikasz raz, a AI Thunderbit analizuje stronę, proponuje kolumny i przygotowuje scraper za Ciebie. Koniec z ręcznym dłubaniem przy selektorach.
- Scraping w 2 kliknięciach: Gdy pola są ustawione, wystarczy kliknąć „Scrape” i otrzymujesz czystą tabelę — bez kodu, bez konfiguracji.
- Scraping podstron: Potrzebujesz więcej szczegółów? Thunderbit może automatycznie odwiedzać każdą podstronę (np. kartę produktu lub profil) i wzbogacać tabelę o dodatkowe informacje.
- Gotowe szablony: Dla popularnych serwisów (Amazon, Zillow, Instagram, Shopify itd.) wystarczy wybrać szablon i ruszyć — bez konfiguracji.
- Eksport gdzie chcesz: Darmowy eksport do Excel, Google Sheets, Airtable, Notion lub CSV. Bez ukrytych opłat.
- Planowane scrapowanie: Zautomatyzuj cykliczne pobieranie danych — po prostu opisz interwał („co poniedziałek o 8:00”), a Thunderbit zajmie się resztą.
- Scraping w chmurze lub w przeglądarce: Korzystaj z serwerów Thunderbit dla większej szybkości albo z własnej przeglądarki, jeśli strona wymaga logowania.
- Wsparcie wielu języków: Pobieraj dane w 34 językach, w tym po angielsku, hiszpańsku, chińsku i wielu innych.
Wypróbuj Thunderbit Agentic Web Scraper za darmo Darmowy plan obejmuje 6 stron miesięcznie i nie wymaga karty kredytowej — to dobry sposób, by przetestować ekstrakcję na swojej docelowej stronie. Get Started Free
Automatyzacja i skalowanie: jak używać harmonogramów i integracji do pozyskiwania danych
Ręczne scrapowanie to już historia. Prawdziwa wartość pojawia się wtedy, gdy automatyzujesz pozyskiwanie danych i włączasz je do swoich procesów:
- Planowane scrapowanie: Ustaw Thunderbit tak, aby uruchamiał pobieranie codziennie, co tydzień albo w dowolnym innym rytmie. Idealne do monitorowania cen, generowania leadów lub agregacji newsów.
- Bezpośrednia integracja: Eksportuj pobrane dane prosto do Google Sheets, Excela, Airtable lub Notion. Koniec z pobieraniem i ponownym wgrywaniem plików.
- Integracja z CRM i analityką: Przesyłaj dane do CRM lub narzędzi BI, aby tworzyć pulpity w czasie rzeczywistym, alerty albo automatyczne działania sprzedażowe.
Przykład: zautomatyzowany workflow monitorowania cen
- Skonfiguruj Thunderbit na stronie produktu konkurencji.
- Użyj „One Click Extract”, aby pobrać nazwę produktu, cenę i URL.
- Zaplanuj scraping codziennie rano o 7:00.
- Wyeksportuj wyniki do Google Sheets podpiętego do dashboardu.
- Osoba odpowiedzialna za ceny analizuje zmiany i dostosowuje strategię, zanim konkurencja zdąży się obudzić.
Dzięki automatyzacji nie tylko działasz szybciej — masz też zawsze aktualne dane.
Najlepsze praktyki pracy z nieustrukturyzowanymi danymi podczas pobierania ich ze stron
Spójrzmy prawdzie w oczy: większość danych webowych nie jest elegancka i uporządkowana. Są nieustrukturyzowane, niespójne, a czasem po prostu dziwne. Oto jak wycisnąć z nich sensowną formę:
- Pozwól AI zdefiniować strukturę: Użyj One Click Extract albo szablonu, by narzucić porządek — AI ustali kolumny i typy danych, a Ty w razie potrzeby dopracujesz szczegóły później.
- Prompty AI na poziomie pola: Thunderbit pozwala dodawać własne instrukcje dla każdego pola. Chcesz kategoryzować produkty, formatować numery telefonów albo tłumaczyć opisy? Po prostu powiedz AI, czego oczekujesz.
- Wykorzystaj NLP: W przypadku recenzji, komentarzy lub artykułów użyj wbudowanych funkcji NLP, by tworzyć podsumowania, oceniać sentyment lub wyciągać słowa kluczowe.
- Normalizuj dane: Ujednolicaj formaty (daty, ceny, numery telefonów) już w trakcie pobierania, a nie dopiero później. Spójność jest kluczowa.
- Usuwaj duplikaty i weryfikuj: Eliminuj powtórzenia i losowo sprawdzaj poprawność wyników. Jeśli coś wygląda podejrzanie, dopracuj prompty albo ustawienia.
Prompty AI na poziomie pola: jak dostosować ekstrakcję danych, by uzyskać lepsze wyniki
To jedna z moich ulubionych funkcji. Dzięki promptom AI dla poszczególnych pól możesz:
- Oznaczać i kategoryzować: „Zaklasyfikuj ten produkt jako Elektronika, Meble lub Odzież na podstawie opisu.”
- Wymuszać formaty: „Zwróć datę w formacie RRRR-MM-DD.” „Wyodrębnij tylko wartość liczbową ceny.”
- Tłumaczyć w locie: „Przetłumacz opis produktu na angielski.”
- Usuwać szum: „Wyciągnij bio użytkownika, ignorując linki typu ‘Read more’ i reklamy.”
- Łączyć pola: „Połącz linie adresowe w jedno pole.”
To jak mieć wbudowanego młodszego analityka w swoim scraperze — takiego, który nigdy nie narzeka na przerwy na kawę.
Zapewnienie jakości i spójności danych w procesie pozyskiwania danych ze stron
Dobre pozyskiwanie danych nie kończy się w momencie kliknięcia „Export”. Oto jak utrzymać dane w czystości i zapewnić ich wiarygodność:
- Walidacja: Używaj kontroli zakresu, wymaganych pól i unikalnych kluczy, aby wyłapywać błędy.
- Przegląd próbek: Ręcznie porównuj próbkę pobranych danych ze stroną źródłową — szczególnie po konfiguracji albo po zmianach na stronie.
- Obsługa błędów: Loguj nieudane scrapingi i ustawiaj alerty dla anomalii (np. nagłego spadku liczby wierszy).
- Ciągłe czyszczenie: Używaj arkuszy kalkulacyjnych lub skryptów, by usuwać spacje, naprawiać kodowanie i normalizować tekst.
- Spójność schematu: Utrzymuj stałe nazwy pól i formaty w czasie. Dokumentuj zmiany, żeby zespół nie musiał zgadywać.
Zaufanie do danych jest wszystkim. Odrobina staranności na początku oszczędza mnóstwo problemów później.
Zobacz, jak Thunderbit wypada na tle innych Sprawdź, gdzie jednoclickowa, oparta na AI ekstrakcja Thunderbit wpisuje się w krajobraz innych narzędzi do web scrapingu. Get Started Free
Porównanie narzędzi do ekstrakcji: na co zwrócić uwagę przy wyborze rozwiązania
Nie wszystkie narzędzia do web scrapingu są sobie równe. Oto, co warto wziąć pod uwagę:
Przejdźmy więc do konkretów: pokażę Ci, dlaczego pozyskiwanie danych ze stron internetowych jest dziś tak ważne dla nowoczesnego biznesu, jakie największe przeszkody możesz napotkać po drodze oraz jakie najlepsze praktyki — w tym kilka lekcji wyciągniętych przez zespół Thunderbit — pomogą Ci robić to dobrze, legalnie, skutecznie i na dużą skalę. Niezależnie od tego, czy walczysz z nieustrukturyzowanymi treściami, martwisz się o RODO, czy po prostu masz już dość ręcznego kopiowania do arkuszy, ten poradnik jest dla Ciebie.
Dlaczego pozyskiwanie danych ze stron internetowych ma dziś znaczenie dla biznesu
Dane to nie tylko modne hasło — to dziś krwiobieg konkurencyjnego biznesu. Jak pokazuje badanie McKinsey, organizacje oparte na danych są 23 razy bardziej skłonne pozyskiwać klientów i 6 razy bardziej skłonne ich utrzymywać. To nie jest tylko imponujący wynik — to kwestia przetrwania. Do 2025 roku firmy będą codziennie przetwarzać miliardy stron internetowych, by zasilać analitykę, modele AI i decyzje podejmowane w czasie rzeczywistym (kanhasoft.com).
Jak to wygląda w praktyce? Oto kilka scenariuszy, które widzę niemal co tydzień:
| Zastosowanie biznesowe | Opis i korzyści | Przykład / statystyka |
|---|---|---|
| Monitorowanie cen | Śledź ceny konkurencji, stany magazynowe i promocje w czasie rzeczywistym; dopasuj własną strategię, żeby utrzymać przewagę. | Ponad 80% największych sprzedawców online codziennie pobiera ceny konkurencji (kanhasoft.com). |
| Generowanie leadów | Pobieraj dane z katalogów, mediów społecznościowych albo serwisów z opiniami, aby zdobywać świeże leady i dane kontaktowe. | Zautomatyzowane pozyskiwanie danych zasila CRM szybciej niż jakiekolwiek ręczne researchowanie. |
| Analiza trendów rynkowych | Zbieraj recenzje, wpisy na forach i newsy, żeby wcześnie wyłapywać trendy lub zmiany nastrojów. | 26% działań związanych z web scrapingiem koncentruje się na mediach społecznościowych w celu analizy trendów (blog.apify.com). |
| Agregacja treści | Zbieraj wiadomości, oferty produktowe lub wydarzenia z wielu witryn w jednym miejscu. | Zespoły medialne tworzą spersonalizowane feedy dla swoich odbiorców. |
| Dane produktowe i badawcze | Gromadź informacje o produktach, opinie lub dane badawcze do analizy i rozwoju. | 67% doradców inwestycyjnych korzysta z alternatywnych danych webowych (scrap.io). |
| Dane do trenowania AI | Pobieraj ogromne ilości tekstu, obrazów lub rekordów, żeby trenować modele AI. | Około 70% dużych modeli AI opiera się na danych pozyskanych z sieci (kanhasoft.com). |
Jeśli nie pozyskujesz danych ze stron internetowych, to nie tylko zostajesz w tyle — stajesz się niewidoczny na swoim rynku. Widziałem zespoły e-commerce, które w ciągu sześciu miesięcy potroiły zwrot z inwestycji tylko dzięki automatyzacji pobierania cen konkurencji (kanhasoft.com). Wniosek jest prosty: dane webowe to strategiczny zasób, a umiejętne ich pozyskiwanie to dziś absolutna podstawa.
Największe wyzwania przy pozyskiwaniu danych z dowolnej strony internetowej
Oczywiście nie wszystko jest takie proste. Sieć to dzikie środowisko, a wyciąganie z niej danych wiąże się z bardzo realnymi przeszkodami:
- Nieustrukturyzowane dane: Około 80% danych online jest nieustrukturyzowanych — ukrytych w chaotycznym HTML-u, rozsianych po wielu podstronach albo schowanych za elementami interaktywnymi. Zamiana tego w przejrzystą tabelę to spore wyzwanie (scrapingapi.ai).
- Zmieniające się strony: Serwisy ciągle aktualizują układ i wygląd. Widziałem scraping, który psuł się 15 razy w ciągu jednego miesiąca tylko dlatego, że docelowa strona lekko zmieniła projekt (scrap.io).
- Skala i wolumen: Firmy muszą pozyskiwać dane z setek albo tysięcy stron — często według harmonogramu. Ręczne kopiowanie po prostu nie daje rady.
- Zabezpieczenia antyscrapingowe: CAPTCHA, limity zapytań, ekrany logowania… Serwisy coraz skuteczniej blokują boty. Już ponad jedna trzecia całego ruchu w sieci to boty (scrap.io), a technologie antybotowe rozwijają się błyskawicznie.
- Błędy ludzkie: Ręczne kopiowanie jest powolne i podatne na pomyłki. Jeden błędny selektor i pobierasz złe dane — albo nie pobierasz nic.
Tradycyjne metody po prostu nie skalują się tak, jak trzeba. Dlatego coraz więcej zespołów sięga po inteligentniejsze, zautomatyzowane rozwiązania — i właśnie dlatego tak mocno stawiam na narzędzia oparte na AI.
Najlepsze praktyki prawne, zgodnościowe i bezpieczeństwa przy pozyskiwaniu danych ze stron internetowych
Wyjaśnijmy to od razu: to, że możesz pobierać dane ze strony, nie znaczy jeszcze, że powinieneś — przynajmniej nie bez zastanowienia się nad aspektami prawnymi i etycznymi. Oto, co każda firma powinna wiedzieć:
- Dane publiczne vs prywatne: Pobieranie publicznie dostępnych informacji jest w wielu miejscach zazwyczaj legalne. Ale cokolwiek za logowaniem? To już strefa zakazana. Omijanie uwierzytelniania jest niedopuszczalne (xbyte.io).
- Regulamin serwisu: Zawsze sprawdzaj ToS strony. Jeśli scraping jest zabroniony, ryzykujesz pozew albo zablokowanie dostępu. Gdy masz wątpliwości, poproś o zgodę albo skorzystaj z oficjalnego API.
- Prawo prywatności (RODO, CCPA): Jeśli zbierasz dane osobowe, potrzebujesz legalnej podstawy (np. uzasadnionego interesu), musisz ograniczać zakres zbieranych danych i być gotowy je usunąć na żądanie. Brak zgodności może oznaczać bardzo wysokie kary (xbyte.io).
- Szanuj robots.txt: To nie jest dokument prawnie wiążący, ale dobra praktyka. Przestrzegaj opóźnień crawl i nie obciążaj serwerów.
- Bezpieczeństwo danych: Traktuj pobrane dane jak wrażliwe. Przechowuj je bezpiecznie, ogranicz dostęp i czyść je przed użyciem.
Lista kontrolna zgodności:
| Obszar | Najlepsza praktyka |
|---|---|
| Dostęp prawny | Pobieraj wyłącznie dane publiczne; nigdy nie omijaj logowania (xbyte.io). |
| Regulamin serwisu | Przejrzyj i respektuj ToS; jeśli scraping jest zakazany, użyj API. |
| Dane osobowe | Unikaj ich zbierania, jeśli to możliwe; jeśli to konieczne, minimalizuj zakres i działaj zgodnie z RODO/CCPA. |
| robots.txt i opóźnienia crawl | Przestrzegaj zasad serwisu; ograniczaj tempo zapytań. |
| Bezpieczeństwo danych | Szyfruj, ograniczaj dostęp i usuwaj dane, gdy nie są już potrzebne. |
Zwiększanie efektywności: jak AI usprawnia pozyskiwanie danych ze stron internetowych
A teraz robi się naprawdę ciekawie. AI całkowicie zmieniło sposób, w jaki pozyskujemy dane ze stron internetowych. Zamiast walczyć z selektorami albo pisać kruche skrypty, możesz dziś używać narzędzi opartych na AI, które „czytają” stronę i same rozumieją, co należy pobrać — często wystarczy dosłownie kilka kliknięć.
Co to oznacza w praktyce?
- Minimalna konfiguracja: Narzędzia oparte na AI, takie jak Thunderbit, potrafią automatycznie wykrywać pola. Wystarczy kliknąć „One Click Extract”, a narzędzie zaproponuje właściwe kolumny — bez kodowania i bez prób oraz błędów.
- Elastyczność: Scrapery AI rozpoznają wzorce, a nie tylko sztywne układy. Jeśli strona się zmieni, AI często dostosowuje się samo. To mniej utrzymania i mniej nocnych akcji ratunkowych.
- Dokładność: AI może odfiltrowywać szum, usuwać duplikaty, a nawet porządkować chaotyczne dane już w trakcie pobierania. Niektóre zespoły raportują dokładność sięgającą 99,5% przy użyciu ekstraktorów opartych na AI (scrapingapi.ai).
- Dynamiczna treść: Scrapery AI radzą sobie z serwisami opartymi na JavaScript, nieskończonym przewijaniem, a nawet potrafią wyciągać tekst z obrazów czy PDF-ów.
- Przetwarzanie w locie: Potrzebujesz danych przetłumaczonych, sklasyfikowanych albo podsumowanych już w trakcie pobierania? AI zrobi to za jednym razem.
Widziałem zespoły, które dzięki przejściu na narzędzia AI oszczędzały 30–40% czasu poświęcanego na pozyskiwanie danych (scrapingapi.ai). To nie tylko wzrost produktywności — to realna przewaga konkurencyjna.
Pozyskuj dane z dowolnej strony z pomocą AI Agentowy web scraper Thunderbit samodzielnie czyta dowolną stronę i wybiera pola do pobrania — krok po kroku, jednym kliknięciem. Get Started Free
Thunderbit zostało stworzone po to, by pozyskiwanie danych było proste, dokładne i dostępne — nawet dla osób, które nigdy nie napisały ani jednej linijki kodu. (Tak, moja mama też potrafi z tego korzystać. Nadal jednak walczy z Netfliksem.)
Thunderbit Agentic Web Scraper: kluczowe funkcje dla użytkowników biznesowych
Pozwól, że trochę się pochwalę tym, co zbudowaliśmy w Thunderbit (hej, chyba mogę, prawda?). Thunderbit jest zaprojektowane z myślą o użytkownikach biznesowych — sprzedaży, operacjach, marketingu, nieruchomościach — którzy chcą efektów, a nie problemów. Oto, co je wyróżnia:
- One Click Extract: Klikasz raz, a AI Thunderbit analizuje stronę, proponuje kolumny i przygotowuje scraper za Ciebie. Koniec z ręcznym dłubaniem przy selektorach.
- Scraping w 2 kliknięciach: Gdy pola są ustawione, wystarczy kliknąć „Scrape” i otrzymujesz czystą tabelę — bez kodu, bez konfiguracji.
- Scraping podstron: Potrzebujesz więcej szczegółów? Thunderbit może automatycznie odwiedzać każdą podstronę (np. kartę produktu lub profil) i wzbogacać tabelę o dodatkowe informacje.
- Gotowe szablony: Dla popularnych serwisów (Amazon, Zillow, Instagram, Shopify itd.) wystarczy wybrać szablon i ruszyć — bez konfiguracji.
- Eksport gdzie chcesz: Darmowy eksport do Excel, Google Sheets, Airtable, Notion lub CSV. Bez ukrytych opłat.
- Planowane scrapowanie: Zautomatyzuj cykliczne pobieranie danych — po prostu opisz interwał („co poniedziałek o 8:00”), a Thunderbit zajmie się resztą.
- Scraping w chmurze lub w przeglądarce: Korzystaj z serwerów Thunderbit dla większej szybkości albo z własnej przeglądarki, jeśli strona wymaga logowania.
- Wsparcie wielu języków: Pobieraj dane w 34 językach, w tym po angielsku, hiszpańsku, chińsku i wielu innych.
Wypróbuj Thunderbit Agentic Web Scraper za darmo Darmowy plan obejmuje 6 stron miesięcznie i nie wymaga karty kredytowej — to dobry sposób, by przetestować ekstrakcję na swojej docelowej stronie. Get Started Free
Automatyzacja i skalowanie: jak używać harmonogramów i integracji do pozyskiwania danych
Ręczne scrapowanie to już przeszłość. Prawdziwa wartość pojawia się wtedy, gdy automatyzujesz pozyskiwanie danych i włączasz je w swoje procesy:
- Planowane scrapowanie: Ustaw Thunderbit tak, aby uruchamiał pobieranie codziennie, co tydzień albo w dowolnym innym rytmie. Idealne do monitorowania cen, generowania leadów lub agregacji newsów.
- Bezpośrednia integracja: Eksportuj pobrane dane prosto do Google Sheets, Excela, Airtable lub Notion. Koniec z pobieraniem i ponownym wgrywaniem plików.
- Integracja z CRM i analityką: Przesyłaj dane do CRM lub narzędzi BI, aby tworzyć pulpity w czasie rzeczywistym, alerty albo automatyczne działania sprzedażowe.
Przykład: zautomatyzowany workflow monitorowania cen
- Skonfiguruj Thunderbit na stronie produktu konkurencji.
- Użyj „One Click Extract”, aby pobrać nazwę produktu, cenę i URL.
- Zaplanuj scraping codziennie rano o 7:00.
- Wyeksportuj wyniki do Google Sheets podpiętego do dashboardu.
- Osoba odpowiedzialna za ceny analizuje zmiany i dostosowuje strategię, zanim konkurencja zdąży się obudzić.
Dzięki automatyzacji nie tylko działasz szybciej — masz też zawsze aktualne dane.
Najlepsze praktyki pracy z nieustrukturyzowanymi danymi podczas pobierania ich ze stron
Spójrzmy prawdzie w oczy: większość danych webowych nie jest elegancka i uporządkowana. Są nieustrukturyzowane, niespójne, a czasem po prostu dziwne. Oto jak wycisnąć z nich sensowną formę:
- Pozwól AI zdefiniować strukturę: Użyj One Click Extract albo szablonu, by narzucić porządek — AI ustali kolumny i typy danych, a Ty w razie potrzeby dopracujesz szczegóły później.
- Prompty AI na poziomie pola: Thunderbit pozwala dodawać własne instrukcje dla każdego pola. Chcesz kategoryzować produkty, formatować numery telefonów albo tłumaczyć opisy? Po prostu powiedz AI, czego oczekujesz.
- Wykorzystaj NLP: W przypadku recenzji, komentarzy lub artykułów użyj wbudowanych funkcji NLP, by tworzyć podsumowania, oceniać sentyment lub wyciągać słowa kluczowe.
- Normalizuj dane: Ujednolicaj formaty (daty, ceny, numery telefonów) już w trakcie pobierania, a nie dopiero później. Spójność jest kluczowa.
- Usuwaj duplikaty i weryfikuj: Eliminuj powtórzenia i losowo sprawdzaj poprawność wyników. Jeśli coś wygląda podejrzanie, dopracuj prompty albo ustawienia.
Prompty AI na poziomie pola: jak dostosować ekstrakcję danych, by uzyskać lepsze wyniki
To jedna z moich ulubionych funkcji. Dzięki promptom AI dla poszczególnych pól możesz:
- Oznaczać i kategoryzować: „Zaklasyfikuj ten produkt jako Elektronika, Meble lub Odzież na podstawie opisu.”
- Wymuszać formaty: „Zwróć datę w formacie RRRR-MM-DD.” „Wyodrębnij tylko wartość liczbową ceny.”
- Tłumaczyć w locie: „Przetłumacz opis produktu na angielski.”
- Usuwać szum: „Wyciągnij bio użytkownika, ignorując linki typu ‘Read more’ i reklamy.”
- Łączyć pola: „Połącz linie adresowe w jedno pole.”
To jak mieć wbudowanego młodszego analityka w swoim scraperze — takiego, który nigdy nie narzeka na przerwy na kawę.
Zapewnienie jakości i spójności danych w procesie pozyskiwania danych ze stron
Dobre pozyskiwanie danych nie kończy się w momencie kliknięcia „Export”. Oto jak utrzymać dane w czystości i zapewnić ich wiarygodność:
- Walidacja: Używaj kontroli zakresu, wymaganych pól i unikalnych kluczy, aby wyłapywać błędy.
- Przegląd próbek: Ręcznie porównuj próbkę pobranych danych ze stroną źródłową — szczególnie po konfiguracji albo po zmianach na stronie.
- Obsługa błędów: Loguj nieudane scrapingi i ustawiaj alerty dla anomalii (np. nagłego spadku liczby wierszy).
- Ciągłe czyszczenie: Używaj arkuszy kalkulacyjnych lub skryptów, by usuwać spacje, naprawiać kodowanie i normalizować tekst.
- Spójność schematu: Utrzymuj stałe nazwy pól i formaty w czasie. Dokumentuj zmiany, żeby zespół nie musiał zgadywać.
Zaufanie do danych jest wszystkim. Odrobina staranności na początku oszczędza mnóstwo problemów później.
Zobacz, jak Thunderbit wypada na tle innych Sprawdź, gdzie jednoclickowa, oparta na AI ekstrakcja Thunderbit wpisuje się w krajobraz innych narzędzi do web scrapingu. Get Started Free
Porównanie narzędzi do ekstrakcji: na co zwrócić uwagę przy wyborze rozwiązania
Nie wszystkie narzędzia do web scrapingu są sobie równe. Oto, co warto wziąć pod uwagę:
| Narzędzie | Mocne strony | Na co uważać |
|---|---|---|
| Thunderbit | Najłatwiejsze dla osób nietechnicznych; wykrywanie pól przez AI; scraping podstron; gotowe szablony; darmowy eksport; przystępne plany (Thunderbit Blog). | Nie jest stworzone do ogromnych projektów prowadzonych głównie przez programistów; działa w modelu kredytowym. |
| Browse AI | No-code, dobre do monitorowania zmian; integracja z Google Sheets; zbiorcza ekstrakcja. | Wyższa cena startowa; konfiguracja może zająć sporo czasu. |
| Octoparse | Potężne narzędzie, dobrze radzi sobie z dynamicznymi stronami; zaawansowane funkcje dla technicznych użytkowników. | Stroma krzywa nauki; wyższe ceny. |
| Web Scraper (webscraper.io) | Darmowe przy mniejszych projektach; wizualna konfiguracja; aktywna społeczność. | Ręczna konfiguracja bywa myląca; ograniczone wsparcie AI. |
| Diffbot | Oparte na AI, analizuje nieustrukturyzowane strony przez API; świetne dla developerów. | Drogie, oparte na API, nie dla osób nietechnicznych. |
Moja rada: Jeśli jesteś użytkownikiem biznesowym i zależy Ci na szybkich, dokładnych wynikach, Thunderbit będzie świetnym wyborem. Dla power userów i developerów Octoparse albo Diffbot mogą być warte dodatkowej złożoności. Zawsze przetestuj darmowy plan lub wersję próbną, zanim podejmiesz decyzję.
Podsumowanie: jak wdrożyć najlepsze praktyki pozyskiwania danych ze stron w praktyce
Pozyskiwanie danych ze stron internetowych to już nie „miły dodatek” — to konieczność dla każdej firmy, która chce utrzymać konkurencyjność. Oto, co mam nadzieję wyniesiesz z tego artykułu:
- Wartość: Dane webowe napędzają szybsze i mądrzejsze decyzje. Nie zostawiaj ich na stole.
- Pokonywanie wyzwań: Korzystaj z narzędzi opartych na AI, aby radzić sobie z nieustrukturyzowanymi danymi, dużym wolumenem i zmianami na stronach.
- Legalność: Szanuj przepisy o prywatności, zasady serwisów i bezpieczeństwo danych.
- Automatyzacja: Planuj i integruj pozyskiwanie danych z codziennymi procesami.
- Jakość przede wszystkim: Waliduj, czyść i monitoruj dane, aby utrzymać do nich zaufanie.
Gotowy zobaczyć, jak proste to może być? Pobierz rozszerzenie Thunderbit do Chrome i przetestuj je przy swoim następnym projekcie danych. A jeśli chcesz wejść jeszcze głębiej, zajrzyj na Thunderbit Blog, gdzie znajdziesz więcej poradników, wskazówek i przykładów z życia.
Miłego scrapowania — i oby Twoje dane zawsze były uporządkowane, zgodne z przepisami i gotowe do działania.
Zacznij pozyskiwać dane z Thunderbit Zainstaluj darmowe rozszerzenie Thunderbit do Chrome i zacznij jednym kliknięciem wyciągać uporządkowane dane z dowolnej strony. Get Started Free
FAQ
1. Czy pozyskiwanie danych z dowolnej strony internetowej jest legalne?
Zasadniczo pobieranie publicznie dostępnych danych jest legalne w wielu jurysdykcjach, ale należy unikać omijania logowania i zabezpieczeń. Zawsze sprawdzaj regulamin serwisu i przestrzegaj przepisów o prywatności, takich jak RODO i CCPA (xbyte.io).
2. Jak AI usprawnia proces pozyskiwania danych ze stron internetowych?
Narzędzia oparte na AI, takie jak Thunderbit, potrafią automatycznie wykrywać pola, dostosowywać się do zmian układu, czyścić i formatować dane, a nawet obsługiwać dynamiczne treści lub tłumaczenia — przy minimalnej konfiguracji i wysokiej dokładności (scrapingapi.ai).
3. Jakie są najlepsze praktyki przy pracy z nieustrukturyzowanymi danymi?
Najpierw określ strukturę danych, używaj promptów AI na poziomie pól, aby kierować ekstrakcją, normalizuj formaty w trakcie pobierania i weryfikuj wyniki. Narzędzia takie jak Thunderbit ułatwiają kategoryzowanie, formatowanie i etykietowanie danych na bieżąco.
4. Jak mogę zautomatyzować i skalować pozyskiwanie danych ze stron internetowych?
Korzystaj z funkcji harmonogramu, aby uruchamiać pobieranie w regularnych odstępach, i integruj wyniki bezpośrednio z narzędziami takimi jak Google Sheets, Airtable lub CRM. Automatyzacja sprawia, że dane pozostają świeże i ogranicza pracę ręczną.
5. Jak zapewnić jakość i spójność pobranych danych?
Wdroż kontrolę walidacyjną, regularnie audytuj próbki, sensownie obsługuj błędy i utrzymuj spójny schemat w czasie. Ciągłe doskonalenie i monitoring są kluczowe dla utrzymania wiarygodności danych.
Chcesz zobaczyć te najlepsze praktyki w działaniu? Wypróbuj darmowy plan Thunderbit i przekonaj się, jak łatwe, legalne i skalowalne może być pozyskiwanie danych z sieci.
Wypróbuj agentowy Web Scraper Get Started Free
Dowiedz się więcej




