
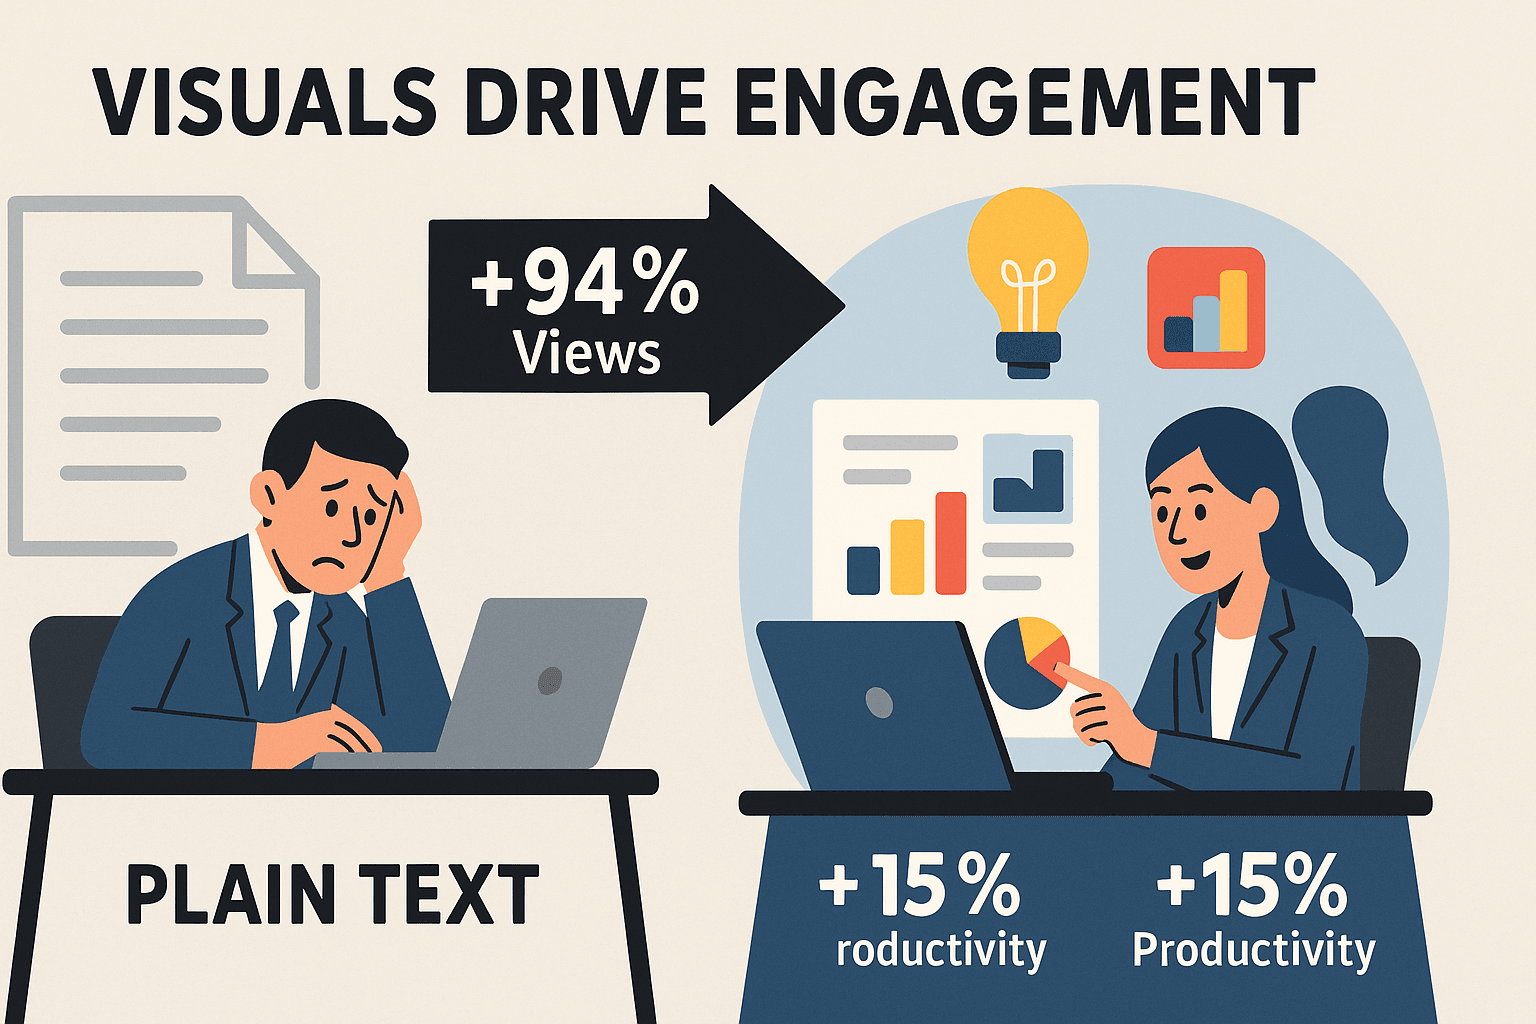
Sieć zmieniła się w prawdziwą wizualną dżunglę — obrazy są wszędzie: od galerii produktów i ofert nieruchomości, po feedy social media i katalogi konkurencji. Na co dzień widzę, jak zespoły sprzedaży, e-commerce i marketingu walczą nie tylko z tekstem i liczbami, ale też z lawiną zdjęć, które wpływają na decyzje i budują markę. Czy wiesz, że artykuły z obrazami mają o 94% więcej wyświetleń niż posty oparte wyłącznie na tekście? Albo że połączenie instrukcji z grafiką może zwiększyć produktywność o 15%? Dane wizualne to już nie „miły dodatek” — to nowa waluta biznesu.
Ale jest jeden haczyk: masowe wyodrębnianie obrazów potrafi być naprawdę uciążliwe. Ręczne klikanie prawym przyciskiem i zapisywanie każdego zdjęcia? To prosta droga do przeciążenia nadgarstka. A ponieważ strony są coraz bardziej dynamiczne — pomyśl o nieskończonym scrollu, wyskakujących galeriach i treściach ładowanych przez AJAX — stare, klasyczne scrapery po prostu nie nadążają. Dlatego przygotowałem listę 5 najlepszych narzędzi image crawler do efektywnego pozyskiwania danych w 2026 roku. Niezależnie od tego, czy jesteś osobą nietechniczną i po prostu chcesz wyników, programistą lubiącym grzebać w szczegółach, czy firmą z poważnymi potrzebami danych — znajdziesz tu coś dla siebie.
Sprawdźmy, co wyróżnia świetny image crawler, jak wypada każde z narzędzi i które z nich może okazać się brakującą przewagą w Twoim procesie pracy.
Dlaczego wybór najlepszego image crawlera ma znaczenie
Odkryj najlepsze narzędzia do web scrapingu Get Started Free
Obrazy są wszędzie, ale wyciągnięcie ich z internetu i włączenie do procesu pracy wcale nie jest proste. Firmy wykorzystują dane obrazowe do wszystkiego — od badań rynku i analizy konkurencji po trenowanie modeli AI i tworzenie treści. W handlu detalicznym i nieruchomościach obraz może przesądzić o sprzedaży — klienci chcą widzieć, nie tylko czytać. Zespoły marketingowe analizują obrazy publikowane przez użytkowników, żeby wyłapywać trendy, a badacze pobierają zdjęcia produktów, by analizować zmiany w designie.
Tu jednak zaczynają się schody:
- Treści dynamiczne: Wiele serwisów ładuje obrazy dopiero po przewinięciu strony lub kliknięciu — podstawowe scrapery całkiem to pomijają.
- Paginacja i nieskończony scroll: Galerie produktów często obejmują dziesiątki stron, a najlepsze narzędzia muszą automatycznie obsługiwać przycisk „Dalej” albo niekończące się przewijanie automatycznie.
- Filtrowanie właściwych obrazów: Nie każde zdjęcie jest przydatne — reklamy, ikony i dekoracyjne grafiki mogą zaśmiecać zbiór danych.
- Problemy z integracją: Po zeskrobaniu danych trzeba jeszcze wprowadzić obrazy (lub ich adresy URL) do Excela, Google Sheets, Notion albo bazy danych — najlepiej bez tygodnia kopiowania i wklejania.
Wybierz złe narzędzie, a ryzykujesz niekompletne dane, stratę czasu, a nawet blokadę przez witrynę. Dobrze dobrany image crawler może natomiast oszczędzić godziny, a nawet dni, poprawić dokładność i pomóc podejmować lepsze decyzje szybciej.
Jak wybraliśmy najlepsze narzędzia image crawler
Nie wszystkie image crawlery są sobie równe. Szukając najlepszych, zwracałem uwagę na:
- Łatwość obsługi: Czy osoby nietechniczne mogą szybko zacząć? Trzeba pisać kod czy wystarczy kilka kliknięć?
- Skalowalność: Czy narzędzie obsłuży setki albo tysiące stron? Czy może działać w chmurze dla większej szybkości?
- Dokładność i elastyczność: Czy potrafi pobierać obrazy z dynamicznych, ciężkich JavaScriptowo stron? Czy obsługuje podstrony, filtrowanie i własną logikę?
- Integracje i eksport: Jak łatwo przenieść dane do Excela, Google Sheets, Notion, Airtable lub własnej bazy danych?
- Cena i opłacalność: Czy jest darmowy plan? Czy koszt ma sens dla małych zespołów, czy raczej dla budżetów enterprise?
Wziąłem też pod uwagę różne potrzeby użytkowników — część osób chce rozwiązania no-code, inni potrzebują pełnej kontroli deweloperskiej, a niektóre firmy wymagają niezawodności i zgodności z rygorystycznymi standardami.
Oto mój wybór 5 najlepszych narzędzi image crawler na 2026 rok.
1. Thunderbit
Thunderbit to mój pierwszy wybór dla każdego, kto chce, żeby pozyskiwanie obrazów było szybkie, inteligentne i — odważę się powiedzieć — przyjemne. Jako współzałożyciel mam naturalnie pewną dozę stronniczości, ale stworzyłem Thunderbit, bo miałem dość patrzenia, jak zespoły męczą się z topornymi, przestarzałymi scraperami.
Dlaczego Thunderbit się wyróżnia:
- Prostota wspierana przez AI: Wystarczy opisać, czego potrzebujesz („pobierz wszystkie zdjęcia produktów i ceny”), a AI Thunderbit zajmie się resztą. Bez selektorów, bez kodu, bez zgadywania.
- Proces w 1 kliknięciu: Jedno kliknięcie i Thunderbit sam dobiera pola do zbudowania — adresy URL obrazów, tytuły i inne — po czym wypełnia tabelę i gotowe. Chcesz tylko zdjęcia produktów? Powiedz to, a resztę pominie.
- Scraping podstron: Potrzebujesz obrazów ze stron szczegółów? Thunderbit przejdzie przez każdą podstronę i pobierze wszystkie grafiki — idealne do e-commerce, nieruchomości i serwisów z galeriami.
- Obsługa dynamicznych treści i paginacji: Niezależnie od tego, czy chodzi o nieskończony scroll, przyciski „Load More” czy obrazy ładowane przez JavaScript, tryb przeglądarkowy i chmurowy Thunderbit ogarną wszystko (docs).
- Natychmiastowy eksport: Wyślij dane o obrazach — w tym same pliki graficzne, nie tylko URL-e — bezpośrednio do Excel, Google Sheets, Airtable lub Notion.
- Darmowe pobieranie obrazów: Funkcje ekstrakcji i eksportu obrazów są darmowe dla małych zadań (6–10 stron), a większe projekty działają w modelu kredytów za wiersz — bez ukrytych opłat i niespodzianek.
Najważniejsze funkcje Thunderbit do ekstrakcji obrazów:
- AI Field Detection: AI Thunderbit analizuje stronę i samodzielnie wybiera pola z obrazami, więc nie musisz szukać właściwego taga HTML (docs).
- Automatyzacja podstron i paginacji: Pobieraj obrazy ze stron list, a potem wchodź w każdą kartę szczegółów — wszystko w jednym przepływie.
- Scraping w chmurze vs. w przeglądarce: Użyj trybu chmurowego dla szybkości (do 50 stron jednocześnie) albo trybu przeglądarkowego dla serwisów wymagających logowania lub intensywnego JavaScriptu.
- Eksport i integracje: Eksport jednym kliknięciem do Excela, Sheets, Notion lub Airtable. Obrazy wyświetlają się natywnie w Notion/Airtable — bez dodatkowego uploadu (docs).
- Obsługa wielu języków: Thunderbit działa w 34 językach, więc jest gotowy dla globalnych zespołów.
Dla kogo?
- Dla zespołów sprzedaży, marketingu i badań, które chcą wyników bez kodowania.
- Dla każdego, kto potrzebuje szybko pobierać obrazy z nowoczesnych, dynamicznych stron.
Cena: Darmowy plan dla 6–10 stron. Płatne plany zaczynają się od 15 USD/miesiąc za 500 kredytów (wierszy), więc narzędzie jest dostępne dla małych zespołów i skalowalne przy większych projektach.
Wypróbuj Thunderbit za darmo do ekstrakcji obrazów
Jeśli chcesz zobaczyć, jak proste może być pobieranie obrazów, pobierz rozszerzenie Thunderbit do Chrome i przetestuj je samodzielnie.
2. Scrapy
Scrapy to szwajcarski scyzoryk web scrapingu dla programistów. To rozwiązanie open-source oparte na Pythonie, stworzone dla osób, które chcą mieć pełną kontrolę nad każdym etapem procesu.
Dlaczego Scrapy się wyróżnia:
- Maksymalna elastyczność: Piszesz własne „spiders” w Pythonie, aby crawlować dowolną stronę, obsługiwać logowanie, parsować trudny HTML i pobierać dokładnie te obrazy (lub dane), których potrzebujesz.
- Wysoka wydajność: Asynchroniczna architektura Scrapy pozwala równolegle crawlować tysiące stron i pobierać obrazy — idealne do dużych projektów.
- Images Pipeline: Scrapy ma wbudowany Images Pipeline, który nie tylko pobiera URL-e obrazów, ale też faktycznie ściąga pliki, generuje miniatury i filtruje po rozmiarze lub formacie.
- Rozszerzalność: Mnóstwo wtyczek do proxy, obsługi logowania i wielu innych funkcji. Duże wsparcie społeczności.
Możliwości Scrapy w zakresie obrazów:
- Własna logika: Chcesz pobierać tylko obrazy powyżej określonego rozmiaru? Pominąć duplikaty? Scrapy zrobi to wszystko w kodzie.
- Integracja: Zapis do własnej bazy danych, chmury lub dowolnego formatu.
- Open-source: Darmowe w użyciu — potrzebujesz tylko umiejętności Pythona i własnej infrastruktury.
Dla kogo?
- Dla programistów, inżynierów danych i zespołów technicznych, które chcą mieć pełną kontrolę.
- Dla projektów, w których scraping ma być elementem większego pipeline’u lub działać na dużą skalę.
Cena: Darmowe (open source), ale trzeba zainwestować w development i infrastrukturę.
3. Octoparse
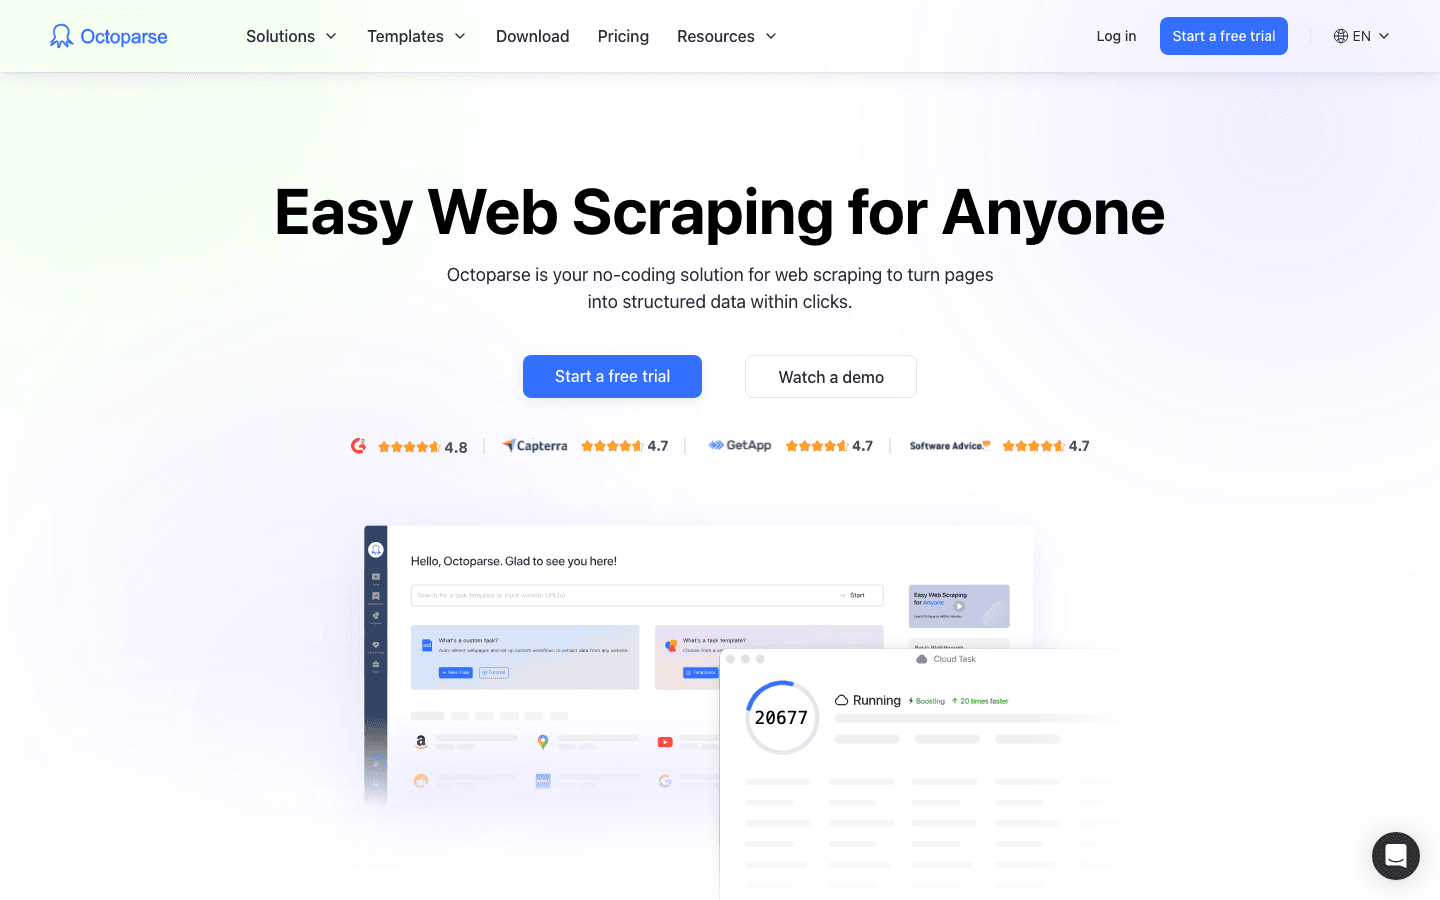
Octoparse to wizualne, no-code narzędzie do web scrapingu, które sprawia, że ekstrakcja obrazów jest dostępna dla każdego — nawet jeśli ostatni raz „kodowałeś” przy zmianie tła na MySpace.
Dlaczego Octoparse się wyróżnia:
- Interfejs point-and-click: Wystarczy kliknąć obrazy, które chcesz pobrać, a Octoparse automatycznie wykryje resztę. Bez kodu, bez XPath, bez bólu głowy.
- Auto-detection i szablony: Funkcja auto-detect analizuje stronę i podpowiada obrazy, listy i inne elementy. Szablony dla popularnych serwisów pozwalają zacząć w kilka sekund.
- Obsługa paginacji i nieskończonego scrollu: Wizualny workflow umożliwia dodanie kroku „Next Page” lub automatycznego przewijania w paru kliknięciach.
- Scraping w chmurze i harmonogram: Płatne plany umożliwiają uruchamianie zadań w chmurze, planowanie cyklicznych ekstrakcji i pracę na dużych wolumenach.
Wizualny workflow Octoparse do pozyskiwania obrazów:
- Masowa ekstrakcja: Pobierz tysiące adresów URL obrazów w kilka minut, a potem — jeśli trzeba — użyj rozszerzenia Chrome do pobrania plików.
- Opcje eksportu: Pobierz wyniki jako CSV, Excel albo wyślij je do bazy danych/API.
- Darmowy plan: Ograniczona liczba uruchomień dla mniejszych zadań; płatne plany zaczynają się od ok. 119 USD/miesiąc za większą moc.
Dla kogo?
- Dla zespołów nietechnicznych, marketerów, badaczy i małych firm.
- Dla każdego, kto chce pobierać obrazy bez pisania choćby jednej linijki kodu.
4. ParseHub
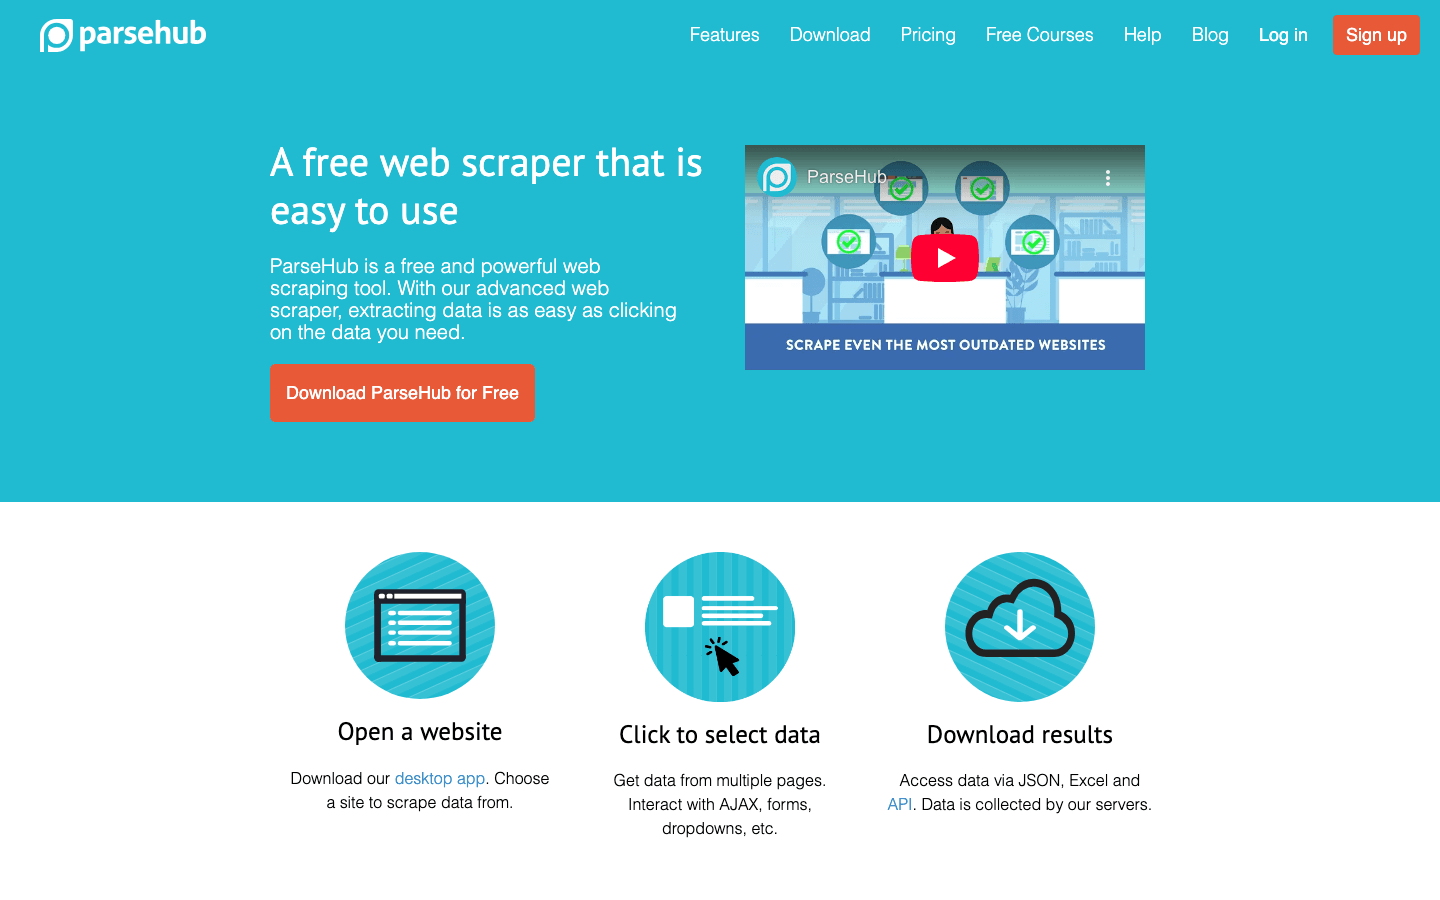
ParseHub to kolejny wizualny scraper, ale szczególnie dobrze radzi sobie ze złożonymi, dynamicznymi stronami — pomyśl o serwisach ciężkich od JavaScriptu, aplikacjach SPA czy stronach wymagających logiki warunkowej.
Dlaczego ParseHub się wyróżnia:
- Obsługa treści dynamicznych: ParseHub potrafi pracować z treściami ładowanymi przez AJAX, pop-upami i nawigacją wieloetapową. Jeśli obrazy pojawiają się dopiero po kliknięciu lub przewinięciu, ParseHub je pobierze.
- Wizualne skryptowanie z logiką: Dodawaj warunki, pętle i zmienne do procesu scrapingu — bez kodu, ale z dużą mocą dla zaawansowanych użytkowników.
- Ekstrakcja wielu typów danych: Pobieraj obrazy, tekst, linki i inne dane w jednym projekcie.
- Uruchamianie w chmurze i harmonogram: Uruchamiaj zadania w chmurze, planuj cykliczne scrapingi i integruj się przez API.
Zaawansowane funkcje ParseHub dla danych obrazowych:
- Paginacja i podstrony: Łatwo pobieraj obrazy z wielu stron lub wchodź głębiej w strony szczegółów.
- Eksport: Pobierz dane jako CSV, Excel lub połącz z narzędziami BI, takimi jak Tableau.
- Darmowy plan: Do 200 stron na jedno uruchomienie; płatne plany zaczynają się od ok. 189 USD/miesiąc przy większych wolumenach.
Dla kogo?
- Dla osób, które potrzebują no-code narzędzia, ale pracują z bardziej złożonymi lub nowoczesnymi stronami.
- Dla analityków danych i badaczy, którzy chcą większej kontroli bez kodowania.
5. Sequentum Enterprise
Sequentum Enterprise (wcześniej Sequentum Enterprise) to ciężka artyleria do image crawlingu na poziomie enterprise. Jeśli zarządzasz ogromnymi, ciągłymi projektami scrapingu z ostrymi wymaganiami zgodności, to jest narzędzie dla Ciebie.
Dlaczego Sequentum Enterprise się wyróżnia:
- Platforma klasy enterprise: Oprogramowanie Windows instalowane lokalnie, zaprojektowane do wysoko wolumenowego, krytycznego scrapingu.
- Edytor wizualny + skryptowanie: Buduj workflow wizualnie, ale dodawaj własne skrypty C#/VB.NET do zaawansowanych scenariuszy.
- Wielowątkowe crawlownie: Pobieraj obrazy z tysięcy stron równolegle.
- Solidna obsługa błędów i harmonogram: Wbudowany scheduler, odzyskiwanie po błędach i monitoring zapewniają stabilną, bezobsługową pracę.
- Integracja: Eksport do baz danych, API, chmury lub dowolnego formatu wymyślonego przez dział IT.
- Współpraca zespołowa: Kontrola wersji, uprawnienia użytkowników i centralne zarządzanie dla dużych zespołów.
Automatyzacja workflow obrazów w Sequentum Enterprise:
- Radzi sobie ze złożonymi serwisami: AJAX, JavaScript, pop-upy, CAPTCHA i więcej.
- Bezpieczeństwo i zgodność: Działa na Twojej infrastrukturze — dane nie opuszczają serwerów.
- Ceny indywidualne: Zwykle to spora inwestycja, ale uzasadniona dla firm z dużymi i ciągłymi potrzebami.
Dla kogo?
- Dla enterprise, dostawców danych i wszystkich, którzy uruchamiają duże, cykliczne pipeline’y do pozyskiwania obrazów i danych.
- Dla zespołów, które potrzebują niezawodności, zgodności i integracji na najwyższym poziomie.
Szybkie porównanie: najlepsze narzędzia image crawler w skrócie
| Narzędzie | Najważniejsze zalety | Najlepsze dla | Cena (orientacyjnie) |
|---|---|---|---|
| Thunderbit | AI, konfiguracja w 1 kliknięciu, podstrony/paginacja, natychmiastowy eksport | Osoby bez kodowania, szybkie wyniki, MŚP | Darmowe dla 6–10 stron, potem płatność za wiersz (od 15 USD/mies.) |
| Scrapy | Oparte na Pythonie, elastyczne, skalowalne, pobiera obrazy bezpośrednio | Programiści, projekty niestandardowe, duża skala | Darmowe (open source) |
| Octoparse | No-code, wizualne, auto-detekcja, szablony, scraping w chmurze | Zespoły nietechniczne, marketing, badania | Darmowy plan, płatne od ok. 69 USD/mies. |
| ParseHub | Wizualne, obsługuje dynamiczne strony, logikę/warunki, harmonogram w chmurze | Złożone strony, analitycy, zaawansowani użytkownicy no-code | Darmowy plan, płatne od ok. 189 USD/mies. |
| Sequentum Enterprise | Klasa enterprise, wizualne + skryptowanie, wielowątkowe, on-prem | Enterprise, duży wolumen, zgodność | Ceny indywidualne/enterprise |
Jak wybrać najlepszy image crawler do potrzeb Twojej firmy
Jak zeskrobać dowolną stronę z użyciem AI Get Started Free
Więc które narzędzie wybrać? Oto moja rekomendacja:
- Potrzebujesz wyników natychmiast, bez żadnej konfiguracji? Wybierz Thunderbit. To najprostszy sposób na pobieranie obrazów, zwłaszcza jeśli chcesz eksportować dane do Sheets, Notion lub Airtable.
- Masz programistę i chcesz pełnej kontroli? Scrapy jest bezkonkurencyjne przy niestandardowych, dużych projektach.
- Nie umiesz kodować, ale chcesz wizualny workflow? Octoparse świetnie sprawdzi się w małych i średnich zespołach, a ParseHub będzie lepszy dla złożonych, dynamicznych serwisów.
- Prowadzisz operację enterprise? Sequentum Enterprise jest stworzone dla Ciebie — duże dane, zgodność i automatyzacja.
Zawsze bierz pod uwagę umiejętności techniczne zespołu, złożoność stron docelowych i częstotliwość uruchamiania zadań. Większość tych narzędzi oferuje darmowe wersje próbne lub plany — więc warto testować i sprawdzić, co najlepiej pasuje do Twojego workflow.
Podsumowanie: efektywne pozyskiwanie danych dzięki najlepszym image crawlerom
Dane wizualne będą tylko zyskiwać na znaczeniu. Niezależnie od tego, czy śledzisz konkurencję, zasilasz modele AI, czy po prostu chcesz utrzymać aktualność katalogów produktów, odpowiedni image crawler może zamienić dni ręcznej pracy w minuty automatyzacji. Narzędzia takie jak Thunderbit sprawiają, że ta moc staje się dostępna dla wszystkich, a nie tylko dla programistów czy wielkich firm.
Zacznij pobierać obrazy z Thunderbit
Gotowy, by odmienić swój workflow pozyskiwania obrazów? Wypróbuj Thunderbit za darmo albo sprawdź jedno z innych narzędzi z tej listy. A jeśli chcesz zgłębić temat web scrapingu, zajrzyj na blog Thunderbit po więcej poradników, wskazówek i praktycznych zastosowań.
FAQ
1. Czym jest image crawler i dlaczego firmy go potrzebują?
Image crawler to narzędzie, które automatycznie pobiera obrazy (lub ich adresy URL) ze stron internetowych. Firmy używają image crawlerów do zbierania zdjęć produktów, monitorowania konkurencji, zasilania modeli AI i usprawniania operacji contentowych — oszczędzając czas i poprawiając jakość danych.
2. Co sprawia, że Thunderbit ułatwia ekstrakcję obrazów bardziej niż inne narzędzia?
Thunderbit używa AI do automatycznego wykrywania obrazów i innych pól, dzięki czemu scraping da się skonfigurować jednym kliknięciem — bez kodu i bez przygotowania technicznego. AI prowadzi cały proces, a jeśli chcesz tylko wybrane obrazy, po prostu je wskażesz. Narzędzie potrafi też przechodzić przez podstrony, obsługiwać dynamiczne treści i eksportować dane bezpośrednio do Excela, Sheets, Notion lub Airtable.
3. Czy mogę korzystać z tych narzędzi bez doświadczenia w programowaniu?
Oczywiście. Thunderbit, Octoparse i ParseHub są zaprojektowane dla osób bez kodowania i oferują interfejsy wizualne oraz funkcje oparte na AI. Scrapy najlepiej sprawdza się u osób znających Pythona, a Sequentum Enterprise jest skierowane do zespołów IT w firmach enterprise.
4. Na co zwrócić uwagę przy wyborze image crawlera?
Pomyśl o swoich umiejętnościach technicznych, złożoności stron docelowych (treści dynamiczne, logowania itd.), ilości danych, jakiej potrzebujesz, oraz o tym, jak chcesz eksportować lub integrować wyniki. Weź też pod uwagę cenę — część narzędzi jest darmowa, inne mają charakter enterprise.
5. Czy scrapowanie obrazów z dowolnej strony jest legalne?
Zawsze sprawdź regulamin strony i respektuj prawa autorskie. Pobieraj wyłącznie publicznie dostępne dane i nie zbieraj informacji osobowych ani wrażliwych bez zgody. Odpowiedzialny, etyczny scraping jest kluczowy, by pozostać zgodnym z przepisami i uniknąć problemów prawnych.
Chcesz zobaczyć Thunderbit w akcji? Pobierz rozszerzenie Chrome i spróbuj pobrać obrazy ze swojej ulubionej strony. A jeśli masz pytania albo szukasz kolejnych wskazówek dotyczących scrapingu, zajrzyj na blog Thunderbit po najnowsze poradniki i analizy.
Dowiedz się więcej Best 10 Free Website Crawler Online Options for 2025 Top 10 Automated Web Scraping Tools in 2025 Top 12 Free Data Scraper Tools in 2025 Top 10 AI Web Scraper Tools to Enhance Productivity in 2025
Wypróbuj Thunderbit AI Image Scraper Get Started Free




