
Craigslist wygląda tak, jakby zatrzymał się w 2003 roku, ale dane ukryte w tych prostych ogłoszeniach mają zaskakująco dużą wartość. Z około 127 milionami odwiedzin miesięcznie i dziesiątkami milionów nowych ogłoszeń każdego miesiąca, to wciąż jedna z największych platform ogłoszeniowych w USA — a do tego nie ma publicznego API, z którego można by skorzystać.
Od lat tworzę narzędzia automatyzujące w Thunderbit, i jedno słyszę nieustannie od zespołów sprzedaży, operacji i nieruchomości: „Potrzebuję danych z Craigslist w arkuszu i nie chcę przez trzy godziny kopiować i wklejać”. Problem w tym, że większość poradników o „najlepszym scraperze do Craigslist” jest nieaktualna, pomija trudniejsze aspekty (jak zabezpieczenia anty-bot), albo po prostu wymienia narzędzia bez realnego porównania.
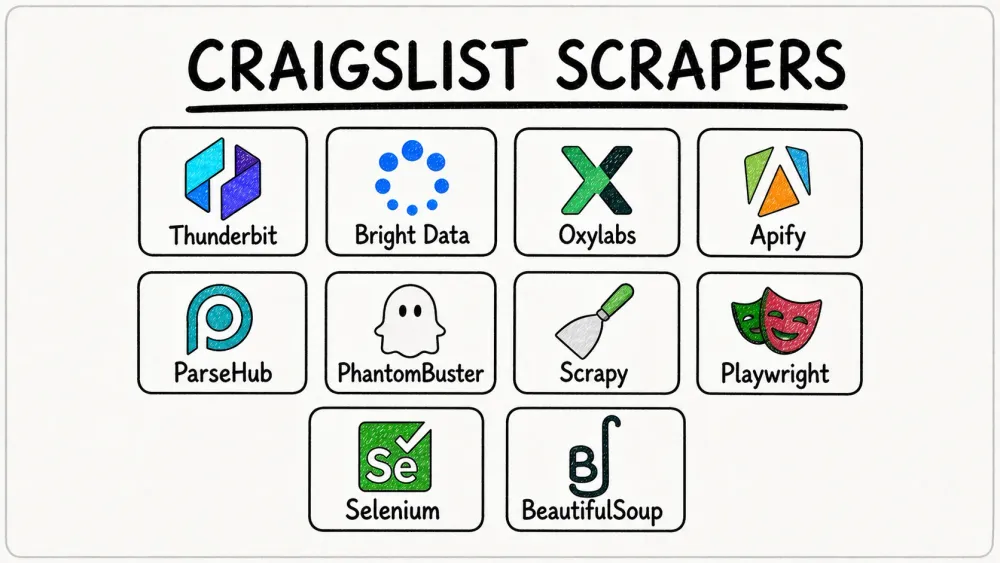
Dlatego przygotowałem ten przewodnik z 10 narzędziami, które naprawdę nadal działają w 2026 roku — od rozszerzeń Chrome bez kodowania, przez platformy enterprise z proxy, po otwartoźródłowe biblioteki Python. Niezależnie od tego, czy jesteś użytkownikiem biznesowym, który nigdy nie napisał ani linijki kodu, czy programistą myślącym w Pythonie, znajdziesz tu coś dla siebie.
Dlaczego warto scrapować Craigslist w 2026 roku? Najlepsze zastosowania dla zespołów biznesowych
Craigslist może wyglądać staroświecko, ale właśnie w tym tkwi jego urok — i wartość. Nadal zajmuje 3. miejsce na świecie wśród serwisów ogłoszeniowych, a w oficjalnym katalogu obejmuje 416 domen regionalnych w USA i terytoriach. To ogromna ilość lokalnych ofert, których nie znajdziesz w jednym miejscu nigdzie indziej.
Oto zastosowania, do których zespoły wracają raz za razem:
- Pozyskiwanie leadów: ogłoszenia w usługach i zleceniach często zawierają opis firmy, lokalizację i sposób kontaktu przez relay Craigslist — wystarczająco dużo, by zespół sprzedaży zbudował lokalną listę potencjalnych klientów.
- Monitoring rynku nieruchomości: oferty mieszkań pokazują czynsz, dzielnicę, liczbę sypialni i łazienek, metraż oraz datę publikacji — idealne do porównywania cen i śledzenia dostępności.
- Analiza konkurencyjnych cen: ogłoszenia sprzedażowe zawierają tytuł, cenę, stan i lokalizację, co jest bardzo cenne przy badaniach rynku wtórnego lub arbitrażu.
- Rekrutacja i monitoring rynku pracy: kategorie jobs i gigs ujawniają stawkę, typ zatrudnienia i opis roli, co pomaga analizować lokalny rynek talentów.
- Analiza wieloregionalna: ponieważ Craigslist jest podzielony na subdomeny i miasta, można analizować region po regionie pod kątem cen, wolumenu i struktury kategorii.
- Automatyzacja procesów: wielu użytkowników po prostu chce, aby dane z Craigslist trafiały do CSV, Google Sheets, Airtable albo CRM — bez ręcznego przeglądania stron.
Jeden z użytkowników zgłosił, że codzienne scrapowanie Craigslist, które wcześniej zajmowało 60–90 minut, po automatyzacji spadło do około 5 minut. To właśnie taki zysk czasu, który szybko robi różnicę.
Scrapuj dane z Craigslist z pomocą AI Agentowy scraper Thunderbit sam odczytuje strony z ogłoszeniami Craigslist i jednym kliknięciem pobiera ceny, opisy oraz dane kontaktowe. Get Started Free
Jak wybraliśmy najlepsze scrapery do Craigslist: nasze kryteria oceny
Nie każdy scraper do Craigslist jest taki sam, a „najlepsze” narzędzie w dużej mierze zależy od tego, kim jesteś i czego potrzebujesz. Każde narzędzie oceniłem w sześciu obszarach:
- Łatwość wdrożenia — czy jest przyjazne dla początkujących (no-code), czy wymaga programisty?
- Obsługa zabezpieczeń anty-bot Craigslist — czy ma wbudowaną rotację proxy, obsługę CAPTCHA albo fingerprinting przeglądarki?
- Model cenowy — darmowe, freemium, płatne czy enterprise?
- Opcje eksportu danych — CSV, Excel, Google Sheets, Airtable, Notion, JSON, baza danych?
- Wsparcie dla wielu regionów — czy potrafi scrapować wszystkie 416 amerykańskich serwisów Craigslist, czy tylko jedno miasto naraz?
- Nakład pracy przy utrzymaniu — czy narzędzie psuje się, gdy Craigslist zmienia układ strony, czy dostosowuje się automatycznie?
Żaden z konkurencyjnych artykułów, które znalazłem, nie robi takiego porównania obok siebie według spójnych kryteriów — więc jeśli masz dość ogólnikowych list „top 10”, ten tekst jest dla Ciebie.
10 najlepszych scraperów Craigslist w skrócie
Zanim przejdziemy do szczegółów, oto zbiorcza tabela porównawcza. Podzieliłem je na trzy grupy: narzędzia no-code dla biznesu, platformy enterprise do skali oraz biblioteki open source dla programistów.
| Narzędzie | Typ | Darmowy plan? | Wsparcie proxy / anty-bot | Obsługa CAPTCHA | Formaty eksportu | Najlepsze dla |
|---|---|---|---|---|---|---|
| Thunderbit | Rozszerzenie Chrome no-code | Tak (6 stron/mies.) | Tryb przeglądarkowy (bez proxy przy umiarkowanym użyciu) | N/D (sesja przeglądarki) | Excel, Sheets, Airtable, Notion, CSV, JSON | Nietechniczni użytkownicy biznesowi |
| Bright Data | Enterprise scraper + proxy + dataset | Trial | Zarządzane odblokowywanie, proxy, ponawianie prób, renderowanie | Tak (automatycznie rozwiązana) | JSON, NDJSON, CSV, Parquet, XLSX, API | Zbieranie danych na poziomie enterprise |
| Oxylabs | API + infrastruktura proxy | Trial | Zarządzane odblokowywanie, proxy residential/ISP | Tak | HTML, zrzuty ekranu, wyjście API | Programiści potrzebujący infrastruktury enterprise |
| Apify | Chmurowy marketplace actorów | Tak (kredyty 5 USD/mies.) | Rotacja proxy (zależna od aktora) | Częściowo / zależnie od aktora | JSON, CSV, XML, Excel, JSONL | Elastyczna automatyzacja cloud low-code |
| ParseHub | Wizualny scraper no-code | Tak | Płatna rotacja proxy, uruchomienia w chmurze | Nie jest kluczową funkcją | CSV, JSON, API/S3/Dropbox (płatne) | Użytkownicy no-code z mniejszym budżetem |
| Phantombuster | Platforma automatyzacji w chmurze | Tak (ograniczony) | Dostępne wsparcie proxy | Kredyty / workflow-based | CSV, JSON (płatne) | Automatyzacja sprzedaży na wielu platformach |
| Scrapy | Open-source’owy crawler Python | Free (OSS) | Własne proxy/middleware | Nie | JSON, JSONL, CSV, XML, DB | Crawlers produkcyjne |
| Playwright | Open-source’owa automatyzacja przeglądarki | Free (OSS) | Własna przeglądarka/proxy | Nie | Eksport własny | Kontrola na poziomie przeglądarki |
| Selenium | Open-source’owa automatyzacja przeglądarki | Free (OSS) | Własna przeglądarka/proxy | Nie | Eksport własny | Starsze stosy wielojęzyczne |
| BeautifulSoup | Open-source’owy parser HTML | Free (OSS) | Samo w sobie brak | Nie | Eksport własny | Lekkie parsowanie |
Wyraźnie widać tu trzy ścieżki:
- Narzędzia no-code (Thunderbit, ParseHub, Phantombuster) dla użytkowników biznesowych, którzy chcą danych bez obciążenia inżynieryjnego.
- Platformy enterprise (Bright Data, Oxylabs, Apify) dla zespołów potrzebujących skali, infrastruktury anty-bot i zarządzanego dostarczania danych.
- Narzędzia open source dla programistów (Scrapy, Playwright, Selenium, BeautifulSoup) dla maksymalnej kontroli — kosztem konfiguracji, utrzymania i zarządzania proxy.
Teraz czas na szczegóły.
1. Thunderbit
 Thunderbit to oparty na AI dodatek do Chrome, stworzony dla osób, które chcą otrzymywać dane w uporządkowanej formie z dowolnej strony — także z Craigslist — bez kodowania i bez konfiguracji proxy.
Jestem stronniczy (to my go zbudowaliśmy), ale umieszczam Thunderbit na pierwszym miejscu, ponieważ rozwiązuje konkretne problemy, jakie scrapowanie Craigslist stwarza dla użytkowników nietechnicznych: zmienne układy stron w różnych kategoriach, wzbogacanie danych ze stron szczegółowych oraz ciągłe psucie się scraperów, gdy zmieniają się selektory CSS.
Jak to działa w przypadku Craigslist:
- Zainstaluj rozszerzenie Thunderbit do Chrome i otwórz dowolną stronę z ogłoszeniami Craigslist (np. mieszkania w Twoim mieście).
- Kliknij „One Click Extract” — AI Thunderbit odczyta stronę, rozpozna jej strukturę, dobierze odpowiednie kolumny i pobierze dane do tabeli jednym przejściem. W przypadku nieruchomości dostaniesz m.in. tytuł, cenę, metraż, liczbę sypialni, lokalizację, datę publikacji i link. W przypadku ofert pracy — tytuł, wynagrodzenie, typ pracy itd. Bez ręcznego ustawiania selektorów.
- Obsłuż paginację — Thunderbit działa z klikalną paginacją Craigslist.
- Użyj „Scrape Subpages”, aby wejść w każdą pojedynczą ofertę i pobrać pola dostępne tylko na stronie szczegółów: pełny opis, wszystkie zdjęcia, osadzone dane kontaktowe i więcej.
- Eksportuj do Google Sheets, Excel, Airtable, Notion lub CSV — za darmo.
Najważniejsze funkcje:
- AI do wykrywania pól: automatycznie dopasowuje się do różnych kategorii Craigslist — nieruchomości dostają kolumny z metrażem i sypialniami, prace dostają wynagrodzenie i typ stanowiska, a ogłoszenia sprzedażowe stan i cenę. Bez ręcznej pracy z CSS.
- Scraping podstron: po zebraniu strony wyników narzędzie odwiedza każdą ofertę i pobiera pola ze strony szczegółów (pełny opis, obrazy, dane kontaktowe).
- Tryb scrapowania w przeglądarce: działa w Twojej własnej sesji Chrome, więc przy umiarkowanym wolumenie nie potrzebujesz proxy. To samo w sobie usuwa dużą część kosztów i złożoności.
- Brak utrzymania: AI za każdym razem odczytuje stronę na nowo. Gdy Craigslist zmieni układ (a robi to), scraper się nie psuje.
- Darmowy eksport: Excel, Google Sheets, Airtable, Notion, CSV, JSON — bez paywalla na eksport.
Cena: darmowy plan (6 stron/miesiąc), darmowy trial (10 stron), płatne plany dla większych wolumenów.
Najlepsze dla: zespołów sprzedaży pozyskujących leady z usług i zleceń na Craigslist, zespołów nieruchomości monitorujących ceny najmu, zespołów operacyjnych potrzebujących uporządkowanych danych z Craigslist bez wsparcia programisty oraz każdego, kto chce scrapować, opisywać i eksportować dane jednym krokiem.
Wypróbuj Thunderbit do scrapowania Craigslist Darmowy plan obejmuje 6 stron miesięcznie — to wystarczy, by przetestować scrapowanie Craigslist przed wyborem płatnej opcji. Get Started Free
2. Bright Data
 Bright Data to ciężka artyleria w segmencie enterprise. To jedyna platforma na tej liście, która ma zarówno dedykowaną stronę produktu Craigslist Scraper, jak i marketplace Craigslist Dataset.
Jeśli musisz scrapować tysiące ogłoszeń Craigslist dziennie we wszystkich regionach USA, Bright Data jest zbudowane właśnie do takiej skali. Jego Web Unlocker obsługuje IP, ponawianie prób, renderowanie i blokady — w tym automatyczne rozwiązywanie CAPTCHA domyślnie. Web Scraper IDE pozwala tworzyć własne przepływy zbierania danych z Craigslist, a programowo można przechodzić przez wszystkie 416 adresów regionalnych.
Najważniejsze funkcje:
- Ogromna sieć proxy residential (miliony adresów IP)
- Wbudowane rozwiązywanie CAPTCHA i omijanie mechanizmów anty-bot
- Produkty scraper i dataset specyficzne dla Craigslist
- Eksport: JSON, NDJSON, CSV, Parquet, XLSX, dostawa przez API, webhooki
Cena: scraper Craigslist kosztuje 0,5 USD za 1000 pobrań stron w modelu pay-as-you-go, a plany obejmują np. 380 tys. pobrań za 499 USD. Proxy residential zaczynają się od 4 USD/GB w modelu pay-as-you-go. Dostępny jest 1-tysięczny trial na tydzień.
Najlepsze dla: zespołów enterprise, które potrzebują dużych wolumenów, wieloregionalnego pobierania danych z Craigslist z gwarantowanym uptime i dedykowanym wsparciem. Małe, budżetowe zespoły powinny szukać gdzie indziej.
3. Oxylabs
 Oxylabs to premium dostawca proxy i infrastruktury scrapingu z dedykowanym Craigslist Scraper API oraz stroną Craigslist proxies.
Oxylabs jest bardziej nastawione na programistów niż podejście „all-in-one” Bright Data. Jego Web Scraper API i Web Unblocker obsługują renderowanie JS, ponawianie prób, zarządzanie sesjami, generowanie fingerprintów i szerszą obsługę anty-bot. Darmowy trial Craigslist Scraper API sięga 2 000 wyników.
Najważniejsze funkcje:
- Pule proxy residential i ISP (residential od 6 USD/GB, ISP od 0,60 USD/IP)
- Web Unblocker z automatycznym fingerprintem i zarządzaniem sesjami
- Dedykowany endpoint API dla Craigslist
- Dostępny 7-dniowy bezpłatny trial
Cena: API scraperów dla „innych stron” zaczyna się mniej więcej od 0,15 USD za 1000 wyników bez JS, 0,35 USD za 1000 z JS. Web Unblocker w mikropakiecie od około 75 USD/miesiąc. Proxy residential na dużą skalę mogą kosztować około 0,50 USD/GB przy 1 TB.
Najlepsze dla: zespołów deweloperskich, które chcą zarządzanej infrastruktury proxy i workflow opartych na API do stałego scrapowania Craigslist. Zespoły już korzystające z proxy Oxylabs w innych projektach łatwo dodadzą Craigslist do swojego stacku.
4. Apify
 Apify to chmurowa platforma do web scrapingu i automatyzacji z marketplace’em gotowych „Actorów” — czyli szablonów scraperów, które można uruchamiać bez kodowania.
Krajobraz Craigslist w Apify jest ciekawy: istnieje kilka utrzymywanych przez społeczność actorów do Craigslist, ale ich jakość bardzo się różni. Actor ivanvs/craigslist-scraper ma 829 użytkowników i ocenę 5.0, natomiast automation-lab/craigslist-scraper ma 44 użytkowników i ocenę 1.0. Jakość jest nierówna, więc przed wyborem koniecznie przetestuj.
Najważniejsze funkcje:
- Dostępnych jest wiele actorów Craigslist (niektóre pobierają około 120 ogłoszeń na stronę z wbudowanymi opóźnieniami)
- Uruchamianie w chmurze, harmonogramy, dostęp API, integracje webhook
- Dostępna rotacja proxy
- Eksport: JSON, CSV, XML, Excel, JSONL
Cena: Darmowy plan z kredytami 5 USD/miesiąc, płatne plany od około 49 USD/miesiąc. Cennik zależny od zużycia potrafi mocno wzrosnąć przy intensywnym użyciu — warto kontrolować zużycie CU.
Najlepsze dla: zespołów, które chcą rozwiązania hostowanego w chmurze bez zarządzania infrastrukturą, użytkowników komfortowo czujących się w low-code oraz zespołów potrzebujących cyklicznych, zaplanowanych zadań scrapingu Craigslist.
5. ParseHub
 ParseHub to desktopowe narzędzie wizualnego scrapingu, w którym klikasz elementy strony, aby określić, co ma zostać pobrane.
Aby skonfigurować scraping Craigslist w ParseHub, klikasz tytuły ogłoszeń, ceny i linki, ucząc narzędzie, co ma zebrać. Paginację obsługuje przez pętle kliknięć AJAX, a na płatnych planach oferuje uruchomienia w chmurze. Darmowy plan daje do 5 projektów, co jest całkiem przyzwoite przy małej skali pracy z Craigslist.
Najważniejsze funkcje:
- Wizualny kreator workflow typu point-and-click
- Obsługa paginacji i dynamicznej treści
- Uruchomienia w chmurze i harmonogramy w płatnych planach
- Eksport: CSV, Excel, JSON
Cena: darmowy plan (5 projektów), płatne plany od około 189 USD/miesiąc za większą liczbę stron i planowanie zadań.
Ograniczenia: może być wolny przy dużej skali, darmowy plan ma ograniczone uruchomienia cykliczne i — co najważniejsze — opiera się na selektorach CSS, więc wymaga ręcznego utrzymania, gdy Craigslist zmienia układ strony.
Najlepsze dla: indywidualnych użytkowników lub małych zespołów z umiarkowanymi potrzebami, którzy chcą wizualnego narzędzia no-code, ale nie potrzebują wykrywania pól opartego na AI.
6. Phantombuster
 Phantombuster to chmurowa platforma automatyzacji, popularna pierwotnie do scrapingu LinkedIna i mediów społecznościowych. Nie jest narzędziem natywnie stworzonym dla Craigslist, ale jego Web Element Extractor może scrapować publiczne strony za pomocą selektorów CSS.
Konfiguracja scrapingu Craigslist w Phantombuster wymaga więcej pracy niż w wyspecjalizowanym narzędziu — trzeba wskazać selektory, zbudować workflow i ustawić harmonogram. Ale jeśli już korzystasz z Phantombuster do LinkedIna lub pozyskiwania leadów z social mediów, dodanie Craigslist do pipeline’u jest proste.
Najważniejsze funkcje:
- Gotowe szablony automatyzacji i uruchamianie w chmurze
- Harmonogramy i integracje z CRM
- Dostępne wsparcie proxy i kredyty na rozwiązywanie CAPTCHA
- Eksport: CSV, JSON w płatnych planach (darmowy plan ogranicza do 10 wierszy)
Cena: darmowy plan z 5 slotami, 2 h/miesiąc i limitem eksportu do 10 wierszy. Płatne plany roczne zaczynają się od około 56 USD/miesiąc przy rozliczeniu rocznym.
Najlepsze dla: zespołów sprzedaży, które już używają Phantombuster do wieloplatformowego pozyskiwania leadów i chcą dodać Craigslist do swojego workflow.
7. Scrapy
 Scrapy to najpopularniejszy otwartoźródłowy framework Python do web scrapingu i oczywisty wybór dla zespołów deweloperskich, które chcą maksymalnej kontroli nad crawlingiem Craigslist.
Najnowsza stabilna wersja to 2.15.0 (9 kwietnia 2026). Scrapy obsługuje crawling wielu regionów (przechodzenie przez wszystkie regionalne URL-e), wbudowane planowanie i ograniczanie tempa żądań, middleware downloadera do rotacji proxy oraz eksport feedów do CSV, JSON, JSONL, XML i pipeline’ów bazodanowych. Wtyczka scrapy-playwright dodaje renderowanie na poziomie przeglądarki, gdy jest potrzebne.
Najważniejsze funkcje:
- Bardzo elastyczny crawler klasy produkcyjnej
- Middleware do proxy, ponawiania prób, ciasteczek i rotacji user-agentów
- Eksport feedów: JSON, JSONL, CSV, XML, pipeline’y bazodanowe
- Darmowy i open source
Ukryty koszt: sam Scrapy jest darmowy, ale uruchamianie go na dużą skalę dla Craigslist oznacza subskrypcje proxy (50–500+ USD/mies.), koszty hostingu/serwera i bieżące utrzymanie, gdy Craigslist zmienia strukturę HTML.
Najlepsze dla: zespołów deweloperskich z doświadczeniem w Pythonie, które potrzebują maksymalnej elastyczności, własnej infrastruktury proxy i dużej skali crawlowania Craigslist w wielu regionach.
8. Playwright
 Playwright to nowoczesna biblioteka do automatyzacji przeglądarki stworzona przez Microsoft, która programowo steruje Chromium, Firefoxem i WebKitem. Tempo wydań jest aktywne — v1.59.1 ukazał się 1 kwietnia 2026.
W społecznościach programistycznych Playwright jest coraz częściej polecany zamiast Selenium do scrapowania Craigslist. Jest szybszy, bardziej niezawodny i ma lepszą odporność na wykrywanie dzięki wtyczkom społecznościowym, takim jak playwright-extra. Obsługuje tryb headless i widoczny, automatyczne oczekiwanie na elementy, przechwytywanie ruchu sieciowego oraz zapis zrzutów ekranu i PDF.
Najważniejsze funkcje:
- Obsługa Python, JavaScript/TypeScript, Java i .NET
- Tryb headless i z interfejsem
- Automatyczne oczekiwanie na elementy, przechwytywanie sieci
- Darmowy i open source
Zaleta przy Craigslist: Playwright może lepiej imitować zachowanie prawdziwego użytkownika niż surowe zapytania HTTP, co zmniejsza ryzyko blokady. Na Reddicie społeczność konsekwentnie wybiera Playwright zamiast Selenium dla nowych projektów.
Ukryte koszty: takie same jak w Scrapy — koszty proxy, hostingu i utrzymania, gdy selektory przestają działać.
Najlepsze dla: programistów potrzebujących precyzyjnej kontroli przeglądarki, zespołów budujących scrapery dla treści renderowanych przez JavaScript oraz wszystkich, którzy wolą nowoczesną alternatywę dla Selenium.
9. Selenium
 Selenium to długo obecny i szeroko używany framework do automatyzacji przeglądarki. Najnowsza wersja to 4.43.0 (10 kwietnia 2026), a projekt nadal rozwija funkcje BiDi i kontroli sieci.
Selenium obsługuje wiele języków (Python, Java, C#, JavaScript) i wszystkie główne przeglądarki. Może symulować pełne sesje przeglądarkowe, obsługiwać logowanie, jeśli jest potrzebne, i przewijać strony. Ale w porównaniu z Playwright jest wolniejsze, bardziej rozwlekłe w kodzie i łatwiejsze do wykrycia jako bot bez dodatkowych bibliotek stealth, takich jak undetected-chromedriver.
Najważniejsze funkcje:
- Obsługa wielu języków (Python, Java, C#, JavaScript)
- Symulacja pełnej sesji przeglądarkowej
- Dojrzały ekosystem i bogata dokumentacja
- Darmowy i open source
Ograniczenia: w 2026 roku społeczność coraz częściej wybiera Playwright do nowych projektów. Jeden z wątków na Reddicie zauważył, że Cloudflare nadal wykrywa Selenium „także z proxy residential” — stealth jest tu trudniejszy z założenia.
Najlepsze dla: zespołów deweloperskich, które już inwestują w Selenium i nie chcą migrować, projektów wymagających wsparcia wielu języków (Java, C#) oraz starszych środowisk scrapingu.
10. BeautifulSoup
 BeautifulSoup to lekkka biblioteka Python do parsowania HTML i XML. Aktualna wersja na PyPI to 4.14.3 (30 listopada 2025).
Ważne doprecyzowanie: BeautifulSoup to parser, a nie pełny scraper. Nie pobiera stron internetowych ani nie obsługuje automatyzacji przeglądarki. Łączy się go z biblioteką requests do pobierania HTTP, a potem parsuje HTML, który mu podasz. To najprostszy punkt wejścia dla programistów, ale też najbardziej ograniczony.
Najważniejsze funkcje:
- Bardzo łatwy do nauki — wymaga minimalnej ilości kodu
- Świetny do małych lub jednorazowych scrapów Craigslist
- Darmowy i open source
Ograniczenia: brak wbudowanej obsługi paginacji, brak renderowania JavaScript, brak rotacji proxy — wszystko trzeba dodać ręcznie. Jeśli Craigslist zmieni strukturę HTML, selektory przestają działać i trzeba je poprawić ręcznie.
Najlepsze dla: początkujących w Pythonie, którzy chcą spróbować scrapowania Craigslist przy minimalnej konfiguracji, szybkich jednorazowych pobrań danych z jednej kategorii lub regionu oraz programistów potrzebujących lekkiego parsera.
Plan anty-ban dla Craigslist: proxy, limity zapytań i co grozi blokadą
To część, którą większość poradników o scrapowaniu Craigslist pomija, a to właśnie ona jest najważniejsza. Testy Scraperly z kwietnia 2026 klasyfikują Craigslist jako cel o trudności 3/5, wskazując na własną CAPTCHA, limity zapytań i blokady IP. Poradnik Bright Data kieruje użytkowników raczej do Web Unlocker lub Scraping Browser opartego na Playwright niż do zwykłego HTTP. Strona proxy Oxylabs podaje, że Craigslist potrafi wykrywać proxy i że proxy residential są najlepszym wyborem.
Oto, co faktycznie działa:
| Strategia | Skuteczność na Craigslist | Koszt | Złożoność |
|---|---|---|---|
| Proxy residential | ✅ Wysoka | $$ (4–6 USD/GB) | Średnia |
| Proxy ISP | ✅ Wysoka | $ (0,60–0,80 USD/IP) | Średnia |
| Proxy datacenter | ⚠️ Niska (często blokowane) | $ (0,20–0,40 USD/IP) | Niska |
| Scrapowanie w przeglądarce (własna sesja) | ✅ Średnio-wysoka | Darmowe | Niska |
| Limitowanie tempa + losowe opóźnienia | ✅ Niezbędna baza | Darmowe | Niska |
Praktyczne wskazówki:
- Opóźnienia między żądaniami: minimum 2–5 sekund pomiędzy requestami. Scraperly sugeruje utrzymywanie się w okolicach 5–10 żądań/minutę na IP i rotację po 20–30 żądaniach.
- Rotacja sesji: zmieniaj user-agent i fingerprint przeglądarki. Przewidywalne wzorce crawlowania są szybko wykrywane.
- Unikaj proxy datacenter: są tanie, ale na Craigslist szybko wpadają w blokady.
- Scrapowanie w przeglądarce całkowicie usuwa problem proxy przy umiarkowanym wolumenie. Tryb przeglądarkowy Thunderbit działa w Twojej własnej sesji Chrome — bez konfiguracji proxy, bez rotacji IP, bez kosztów. Dla większości użytkowników biznesowych scrapujących kilkaset ogłoszeń to aż nadto.
Jest jeszcze aspekt utrzymania, o którym wiele osób zapomina: gdy Craigslist zmienia CSS (a robi to okresowo), każdy scraper oparty na selektorach CSS się psuje. Trzeba sprawdzić stronę, znaleźć nowe selektory, zaktualizować kod i przetestować ponownie. Narzędzia AI, takie jak Thunderbit, omijają ten problem całkowicie — AI za każdym razem odczytuje strukturę strony od nowa, więc zmiany układu nie psują workflow.
Kod kontra no-code: dwa kompletne walkthrough scrapowania Craigslist
Wiem, że odbiorcy tego artykułu dzielą się mniej więcej po równo: nietechniczni użytkownicy biznesowi, którzy chcą po prostu dane, oraz początkujący i średnio zaawansowani programiści, którzy chcą działającego kodu. Oto więc obie ścieżki obok siebie.
No-code: jak scrapować Craigslist z Thunderbit (krok po kroku)
- Zainstaluj rozszerzenie Thunderbit do Chrome ze Chrome Web Store.
- Przejdź na stronę z ogłoszeniami Craigslist — na przykład mieszkania w Twoim mieście (
https://yourcity.craigslist.org/search/apa). - Kliknij „One Click Extract” — AI Thunderbit odczyta stronę, rozpozna jej strukturę, dobierze kolumny pasujące do kategorii i wypełni uporządkowaną tabelę jednym przejściem. W przypadku nieruchomości zobaczysz tytuł, cenę, metraż, liczbę sypialni, lokalizację, datę publikacji i link. Jeśli chcesz, później możesz zmienić dowolną kolumnę.
- Obsłuż paginację — przechodź między stronami ręcznie lub pozwól Thunderbit zrobić to za Ciebie.
- Użyj „Scrape Subpages”, aby wejść do każdej oferty i wzbogacić dane o pola ze strony szczegółów: pełny opis, wszystkie zdjęcia, osadzone dane kontaktowe.
- Wyeksportuj do Google Sheets, Excel, Airtable, Notion lub CSV — za darmo.
Cały proces zajmuje około 2 minut dla jednej strony wyników. Bez selektorów CSS, bez proxy, bez kodowania.
Ścieżka kodowa: jak scrapować Craigslist z Pythonem + Playwright
Playwright to w 2026 roku najczęściej polecana biblioteka do scrapowania Craigslist na forach deweloperskich. Oto działający fragment w Pythonie, który scrapuje stronę wyników Craigslist dla mieszkań, pobiera tytuł/cenę/link, obsługuje paginację i zwraca dane.
Podejście: najpierw próbuj danych strukturalnych JSON-LD (Craigslist czasem osadza schemat ItemList na niektórych stronach), a dopiero potem przechodź do selektorów DOM. Paginacja odbywa się przez s=120.
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # Try JSON-LD first
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # Fallback: DOM selectors
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # scrape 3 pages
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
Czego potrzebujesz poza tym skryptem: zainstalowanego Playwrighta (pip install playwright && playwright install), konfiguracji proxy przy dużych wolumenach oraz ręcznej obsługi CAPTCHA, jeśli trafisz na limity. To właśnie jest kompromis: pełna kontrola, ale i pełna odpowiedzialność.
Za darmo czy płatne: szczere zestawienie kosztów każdego scrapera Craigslist
To tabela, która przydałaby mi się na początku researchu tego tematu. „Darmowe” w web scrapingu to słowo bardzo względne.
| Narzędzie | Całkowicie darmowe? | Limity darmowego planu | Cena startowa planu płatnego | Ukryte koszty |
|---|---|---|---|---|
| Thunderbit | Darmowy plan (6 stron) | 6 stron/mies.; trial = 10 stron | Płatne plany dla większych wolumenów | Brak — eksport jest darmowy |
| Scrapy | ✅ Open source | Bez limitu | 0 USD | Koszty proxy, hostingu, utrzymania |
| BeautifulSoup | ✅ Open source | Bez limitu | 0 USD | Koszty proxy, hostingu, utrzymania |
| Playwright | ✅ Open source | Bez limitu | 0 USD | Koszty proxy, hostingu, utrzymania |
| Selenium | ✅ Open source | Bez limitu | 0 USD | Koszty proxy, hostingu, utrzymania |
| ParseHub | Darmowy plan | 5 projektów | ~189 USD/mies. | Ograniczone uruchomienia cykliczne w darmowym planie |
| Apify | Darmowy plan | Darmowe kredyty 5 USD/mies. | ~49 USD/mies. | Cennik zależny od zużycia może mocno wzrosnąć |
| Phantombuster | Darmowy plan | 5 slotów, 2 h/mies., eksport 10 wierszy | ~56 USD/mies. (rocznie) | Cennik za slot |
| Bright Data | Tylko trial | 1 tys. zapytań / 1 tydzień | ~500+ USD/mies. | Dodatkowe koszty proxy |
| Oxylabs | Tylko trial | 2 tys. wyników / 1 GB | ~75+ USD/mies. (Unblocker) | Cennik enterprise |
Największa gwiazdka przy „darmowych” narzędziach open source: Scrapy, Playwright, Selenium i BeautifulSoup kosztują 0 USD za instalację, ale uruchamianie ich na dużą skalę na Craigslist oznacza godziny pracy dewelopera przy konfiguracji, 50–500+ USD/mies. za proxy residential oraz ciągłe utrzymanie za każdym razem, gdy Craigslist zmienia HTML. AI Thunderbit odczytuje stronę od nowa przy każdym uruchomieniu (brak utrzymania), eksport jest darmowy, a scrapowanie w przeglądarce eliminuje koszty proxy przy umiarkowanych wolumenach. To realna przewaga dla osób nietechnicznych.
Co naprawdę da się wyciągnąć: pola danych Craigslist według kategorii
Różne kategorie Craigslist mają zupełnie różne struktury danych. Ogłoszenie o mieszkaniu nie wygląda jak ogłoszenie o pracy. Oto, co realnie można pobrać z najważniejszych sekcji:
| Kategoria Craigslist | Pola, które można pobrać | Dane kontaktowe dostępne? |
|---|---|---|
| Mieszkania / Apartments | Tytuł, cena, metraż, liczba sypialni, łazienek, lokalizacja, data, zdjęcia, opis, link do mapy, dostępność, polityka wobec zwierząt, pralnia/parking | ⚠️ Czasem (zanonimizowany relay e-mail) |
| Na sprzedaż | Tytuł, cena, stan, lokalizacja, data, zdjęcia, opis, marka/model/rok (zależnie od ogłoszenia) | ⚠️ Czasem |
| Praca | Tytuł, firma, wynagrodzenie, lokalizacja, typ pracy, poziom doświadczenia, data, opis | Rzadko (zwykle tylko link do aplikacji) |
| Usługi | Tytuł, lokalizacja, opis, zdjęcia | ⚠️ Czasem |
| Zlecenia / Gigs | Tytuł, wynagrodzenie, lokalizacja, data, opis | ⚠️ Czasem |
Kilka ważnych uwag:
- Dane kontaktowe: Craigslist używa zanonimizowanych relay e-mail właśnie po to, by utrudnić bezpośrednie scrapowanie adresów e-mail. Narzędzia, które twierdzą, że „wyciągają e-maile”, często pobierają adres relay (
reply+randomstring@craigslist.org), a nie prawdziwy e-mail autora. - Pola ze strony szczegółów — takie jak pełny opis, wszystkie obrazy i osadzone dane kontaktowe — pojawiają się dopiero po wejściu w konkretną ofertę, a nie na liście wyników.
- Thunderbit „One Click Extract” automatycznie wykrywa, które pola są dostępne na aktualnej stronie, i proponuje odpowiednią strukturę kolumn. Użytkownik scrapujący nieruchomości dostaje kolumny z metrażem i sypialniami; użytkownik scrapujący oferty pracy dostaje wynagrodzenie i typ stanowiska — bez ręcznej konfiguracji. Następnie scraping podstron odwiedza każdą ofertę, aby pobrać pola dostępne tylko na stronie szczegółów.
Rzeczywistość prawna: regulamin Craigslist, sprawa 3Taps i co warto wiedzieć
Nie jestem prawnikiem i nie jest to porada prawna. Ale wiem, że użytkownicy się tym martwią, i warto odpowiedzieć wprost.
Najważniejszy precedens: w sprawie Craigslist v. 3Taps (2013) Craigslist uzyskał nakaz sądowy przeciwko 3Taps za scrapowanie i ponowne publikowanie ogłoszeń po wysłaniu wezwania do zaprzestania. 3Taps miał podobno omijać blokady IP za pomocą serwerów proxy, a sąd uznał dostęp po blokadzie za potencjalnie „bez autoryzacji”. EFF zauważyło, że sprawa została zakończona ugodą w 2015 roku.
Warunki korzystania z Craigslist wyraźnie zabraniają używania „robotów, spiderów, skryptów, scraperów, crawlerów ani ich automatycznych lub manualnych odpowiedników” do interakcji z serwisem. Określają nawet zryczałtowane odszkodowanie w wysokości 0,25 USD za stronę po pierwszych 1000 odsłon w ciągu 24 godzin w przypadku naruszeń.
Praktyczne wskazówki:
- ✅ Scrapuj publicznie dostępne dane ogłoszeń do analiz rynkowych lub do własnego użytku
- ✅ Respektuj robots.txt i limity zapytań
- ⚠️ Nie publikuj masowo zeskrobanych ogłoszeń ponownie
- ⚠️ Nie używaj zeskrobanych danych kontaktowych do niechcianego marketingu
- ❌ Nie obchodź technicznych ograniczeń dostępu po zablokowaniu
Różnica ma znaczenie: scrapowanie publicznie widocznych danych do własnej analizy to co innego niż masowe republikowanie ogłoszeń czy zbieranie adresów e-mail do spamu. Trzeba jednak pamiętać, że Craigslist historycznie przechodził od egzekwowania regulaminu, przez blokady IP, aż po działania prawne.
Który scraper do Craigslist jest najlepszy dla Ciebie?
Po przetestowaniu i ocenie wszystkich 10 narzędzi, oto moja rekomendacja zależna od scenariusza:
- Nietechniczny użytkownik biznesowy, który szybko potrzebuje danych z Craigslist → Thunderbit. Bez kodu, wykrywanie pól przez AI, brak utrzymania, darmowy eksport. Najkrótsza droga od „potrzebuję tych danych” do „mam je w arkuszu”.
- Zespół enterprise scrapujący tysiące ogłoszeń dziennie we wszystkich regionach → Bright Data. Dedykowany scraper Craigslist, ogromna infrastruktura proxy, automatyczne CAPTCHA, wsparcie premium.
- Zespół deweloperski potrzebujący zarządzanej infrastruktury API/proxy → Oxylabs do workflow proxy-first, Apify dla elastyczności marketplace’u actorów.
- Programista, który chce pełnej kontroli i personalizacji → Scrapy + Playwright. Open source, maksymalna elastyczność, ale potrzebujesz własnych proxy i własnego utrzymania.
- Użytkownik oszczędny, ale z umiarkowanymi potrzebami → darmowy plan Apify (5 USD kredytów/mies.) albo darmowy plan ParseHub (5 projektów).
- Zespół sprzedaży już korzystający z narzędzi do lead gen na wielu platformach → Phantombuster. Dodaj Craigslist do istniejącego pipeline’u.
- Początkujący w Pythonie robiący jednorazowy scraping → BeautifulSoup + requests. Minimum kodu, minimum konfiguracji, minimum możliwości.
Dla większości nietechnicznych użytkowników biznesowych Thunderbit oferuje najlepszy balans prostoty, dokładności i kosztu. Dla programistów najpotężniejszym połączeniem będzie Scrapy + Playwright. Dla skali enterprise trudno pobić Bright Data.
Jeśli chcesz zobaczyć, jak wygląda scrapowanie Craigslist wspierane przez AI, wypróbuj Thunderbit — darmowy plan wystarczy, by przetestować go na własnym scenariuszu. A jeśli chcesz zgłębić techniki web scrapingu, zajrzyj do naszych poradników: jak scrapować do Google Sheets, najlepsze zautomatyzowane narzędzia do web scrapingu oraz jak scrapować bez blokad. Możesz też odwiedzić nasz kanał YouTube, gdzie znajdziesz instrukcje krok po kroku wideo.
Udanych scrapów — i oby Twoje dane zawsze były czyste, uporządkowane i gotowe do działania.
FAQ
Czy scrapowanie ogłoszeń Craigslist jest legalne?
Regulamin Craigslist wyraźnie zabrania automatycznego scrapowania, a sprawa Craigslist v. 3Taps jest najważniejszym precedensem prawnym. Scrapowanie publicznych ogłoszeń do użytku osobistego lub analitycznego jest zazwyczaj traktowane inaczej niż masowe republikowanie czy spam, ale zawsze należy respektować limity i zasady serwisu — to nie jest porada prawna.
Czy mogę scrapować Craigslist bez kodowania?
Tak. Narzędzia takie jak Thunderbit, ParseHub i Apify oferują opcje no-code lub low-code do pobierania danych z Craigslist. Thunderbit wyróżnia się szczególnie dzięki wykrywaniu pól przez AI — wystarczy kliknąć „One Click Extract” i „Scrape”.
Jaki jest najlepszy darmowy scraper do Craigslist?
Dla programistów Scrapy lub BeautifulSoup są całkowicie darmowe i open source (choć koszty proxy i utrzymania i tak się pojawiają). Dla osób niekodujących najlepszym punktem startowym jest darmowy plan Thunderbit (6 stron/miesiąc), a alternatywnie darmowy plan ParseHub (5 projektów).
Jak uniknąć blokady podczas scrapowania Craigslist?
Używaj limitowania tempa (minimum 2–5 sekund opóźnienia), rotuj user-agent, unikaj proxy datacenter (na Craigslist dużo lepiej działają proxy residential lub ISP) i nie twórz przewidywalnych wzorców crawlowania. Przy umiarkowanych wolumenach narzędzia do scrapowania w przeglądarce, takie jak Thunderbit, omijają problem proxy całkowicie, działając w Twojej własnej sesji Chrome.
Czy mogę scrapować wszystkie regiony Craigslist naraz?
W narzędziach deweloperskich, takich jak Scrapy lub Playwright, można programowo przechodzić przez wszystkie 416 regionalne URL-e USA/terytoriów. Narzędzia enterprise, takie jak Bright Data i Oxylabs, mają wieloregionalny scraping wbudowany. W Thunderbit możesz otwierać każdy regionalny serwis i scrapować go tym samym workflow — AI automatycznie dopasowuje się do każdej strony.
Wypróbuj Thunderbit do scrapowania Craigslist Get Started Free
Dowiedz się więcej



