Twitter-berichten scraper: houd tweets en threadcontext bij elkaar













Houd Twitter-berichten en gesprekscontext bij elkaar
Bekijk het bericht, de context eromheen en de betrokkenheid die je kunt inzien.
Zet elk bericht in één nette rij
Thunderbit leest de zichtbare onderdelen van een tweet en de context eromheen — auteur, tekst, aantallen, citaten of antwoorddoel en media — en zet alles tijdens het extraheren in kolommen. Geen patrooncode nodig.
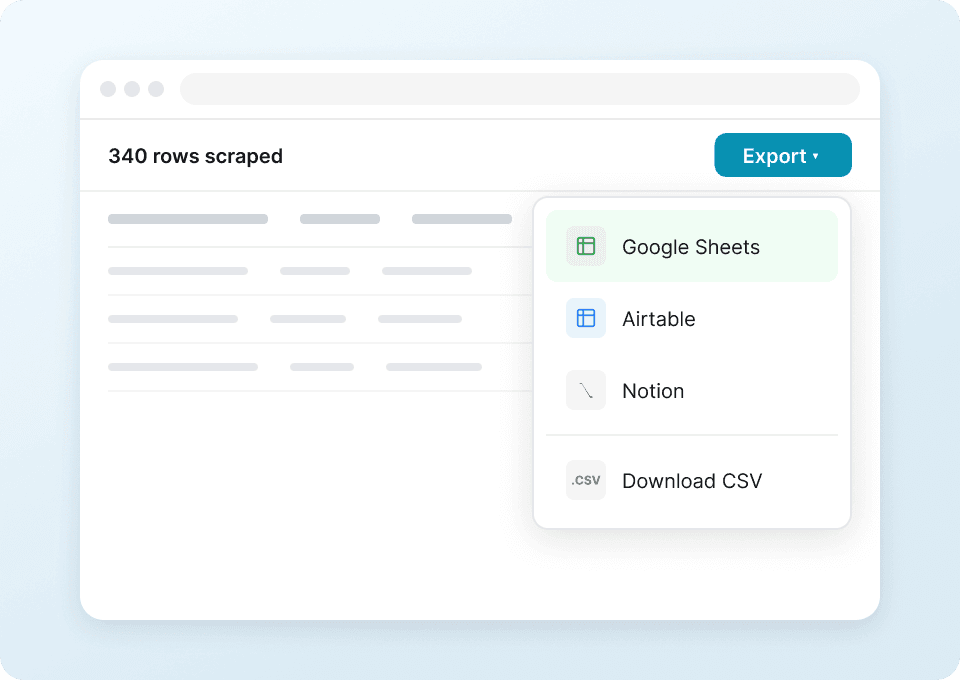
Exporteer Twitter-berichtgegevens direct
Exporteer de vastgelegde kolommen naar Google Sheets, Excel, Airtable of Notion. Je kunt ook een CSV behouden.
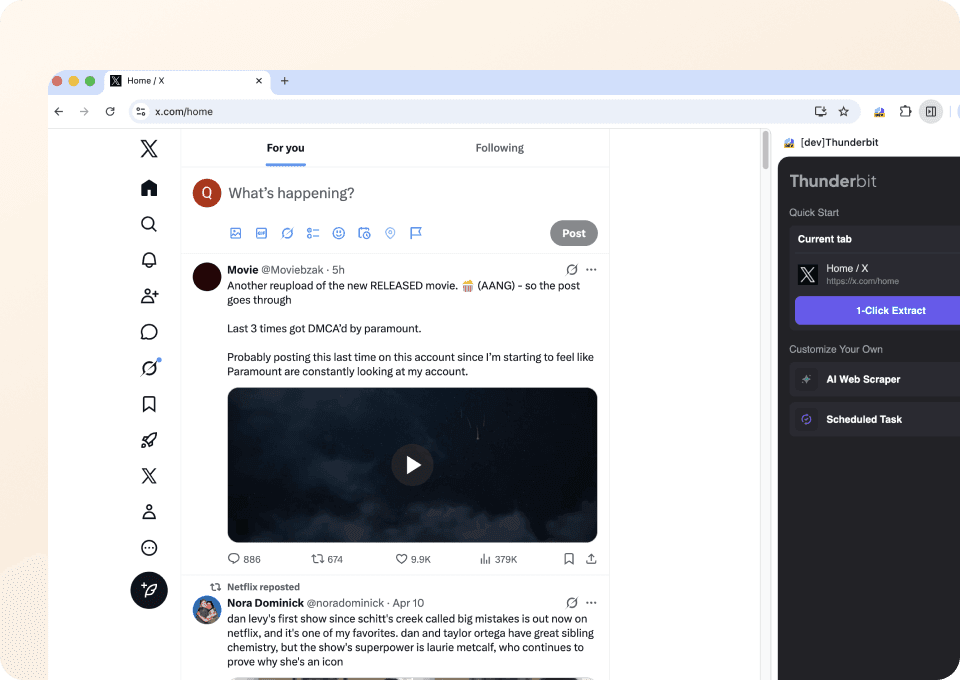
Extraheer Twitter-berichten met één klik
In Agent Mode worden voorgestelde velden en extractie in één keer uitgevoerd. Zeg vóór de start in gewone taal wat wel of niet meegenomen moet worden.
Een gekopieerde Twitter-thread verliest zijn betekenis
Handmatige notities scheiden posts van auteurs, media, citaten en antwoorden. Thunderbit houdt zichtbare context bij elkaar.
Verspreide notities uit een live thread
Links en aantallen raken los van elkaarPostrijen samengesteld door Thunderbit
Zichtbare context blijft bij het berichtKolommen voor posts, citaten en antwoorden
Alleen opgenomen wanneer zichtbaar op de pagina waartoe je toegang hebt.
- post_url
- post_text
- posted_datetime
- author_display_name
- author_username
- author_profile_url
- author_profile_image_url
- verified_badge
- pinned_label
- reply_count
- repost_count
- like_count
- quote_count
- view_count
- hashtags
- mentions
- cashtags
- media_type
- media_urls
- attached_media_count
- external_link_url
- link_domain
- card_title
- card_description
- card_thumbnail_url
- in_reply_to_username
- in_reply_to_post_url
- sensitive_content_warning
- poll_question
- location_name
See conversation research move into rows
In user videos, people show how Thunderbit turns posts, authors, links, and public response counts into clear rows.
FAQ’s voor onderzoek op postniveau
Antwoorden voor het bestuderen van openbare Twitter-posts die je kunt zien.
Study more of a Twitter conversation
Use ready‑made agents for profile bios, search results, thread steps, and media cards.
Minds Webscraper
Met de Thunderbit Minds-webscraper kun je moeiteloos data uit Minds-nieuwsfeeds en groepsleden halen dankzij slimme AI-veldherkenning. Verzamel posttitels, auteursnamen, likes, reacties en groepsinformatie voor onderzoek, marketing of community-analyses. Exporteer gestructureerde Minds-data snel en efficiënt.
Meer info ->
MeWe Scraper
Met de Thunderbit MeWe-webscraper kun je moeiteloos gegevens verzamelen uit MeWe-profielen en groepsberichten, dankzij AI-gestuurde veldsuggesties. Verzamel profielnamen, bio’s, lidmaatschapsdata, berichtinhoud, likes en reacties voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde MeWe-data willen verzamelen.
Meer info ->
Parler Webscraper
Met de Thunderbit Parler Webscraper kun je moeiteloos data verzamelen uit Parler zoekresultaten en hashtag-overzichten, dankzij AI-gestuurde veldsuggesties. Verzamel zoektermen, gebruikersberichten, hashtags, populariteitsscores en meer voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Parler-data willen verzamelen.
Meer info ->
Element Webscraper
Met de Thunderbit Element Webscraper kun je moeiteloos data uit de Element Synapse Admins Room halen, dankzij AI-gestuurde veldsuggesties. Verzamel bericht-ID's, namen van afzenders, tijdstempels, berichtinhoud en bijlagen voor analyse of monitoring. Perfect voor ontwikkelaars, communitymanagers en onderzoekers die gestructureerde Element-data nodig hebben.
Meer info ->
Odnoklassniki Webscraper
Met de Thunderbit Odnoklassniki-webscraper kun je moeiteloos data verzamelen uit Odnoklassniki-groepen en spellijsten, dankzij slimme AI-veldherkenning. Verzamel groepsnamen, beschrijvingen, ledenaantallen, spelinformatie, beoordelingen en meer voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Odnoklassniki-data nodig hebben.
Meer info ->
Triller Webscraper
Met de Thunderbit Triller-webscraper kun je moeiteloos gegevens verzamelen van Triller-blogpagina’s en profielen van creators. Dankzij AI-gestuurde veldsuggesties verzamel je snel blogtitels, publicatiedata, auteursnamen, bio’s van creators en het aantal volgers – ideaal voor onderzoek, marketing of analyse.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



