Telegram Scraper





Verzamel openbare Telegram-berichten zonder maatwerk-scraper
Extraheer de geopende kanaalweergave, onderzoek gelinkte bronnen en kom terug wanneer nieuwe berichten belangrijk zijn.
Zet het geopende kanaal om in een tabel
One Click Extract kan zichtbare berichttekst, gebruikersnamen, tijdstempels, reacties en mediagegevens op een openbare Telegram-pagina herkennen zonder de pagina eerst te hoeven mappen.
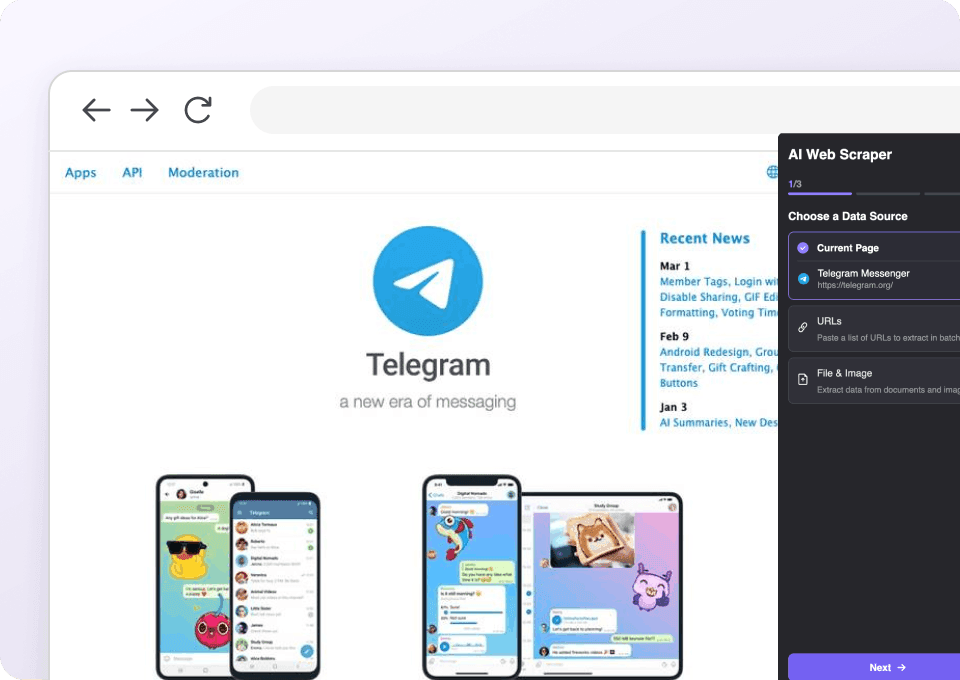
Ga vanuit Telegram door naar de gelinkte webpagina’s
Gebruik Thunderbit ook op openbare pagina’s die door een kanaal worden gedeeld. Eén workflow kan zowel het berichtenarchief als de externe bronnen omvatten die je vervolgens wilt onderzoeken.
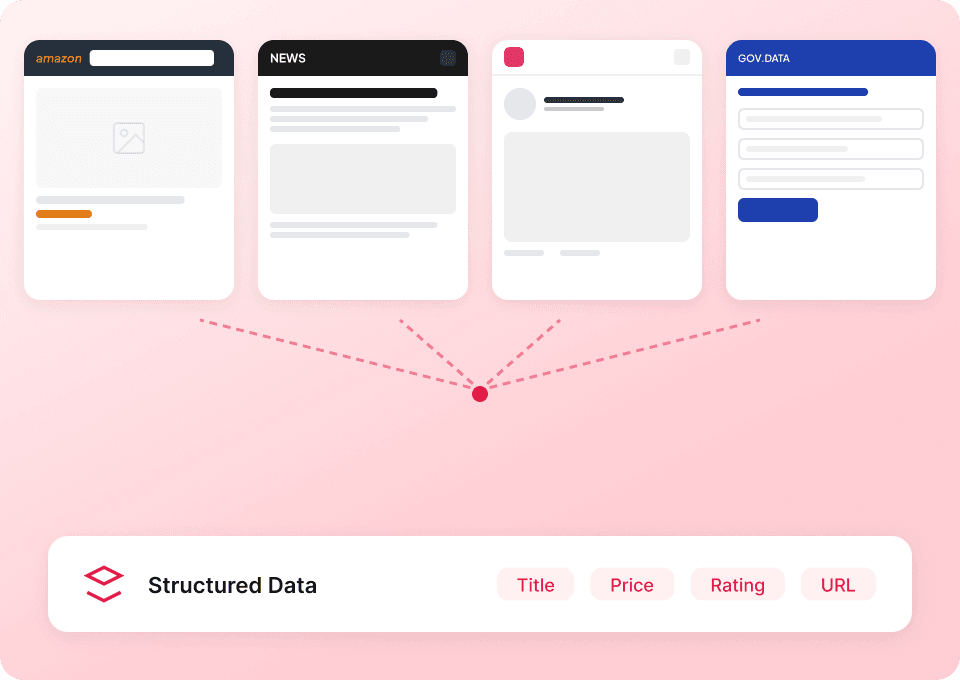
Plan nieuwe kanaalsnapshots in
Stel terugkerende runs in voor openbare kanalen die je volgt. Nieuwe zichtbare berichten, tijdstempels, weergaven of reacties kunnen rechtstreeks naar je spreadsheet worden gestuurd zonder het kanaal telkens opnieuw te openen.
Bespaar jezelf het onderhoud achter scrapen van openbare kanalen
Telegram-pagina’s blijven veranderen terwijl berichten en media zich opstapelen. Thunderbit handelt de browserzichtbare structuur voor je af.
Handmatig opgebouwde kanaalextractie
Elk contenttype voegt weer een nieuwe regel toeTelegram-rijen voorbereid door een AI-agent
Het open kanaal levert de contextVelden voor onderzoek naar openbare Telegram-kanalen
Leg kanaal-, bericht-, reactie-, poll- en mediagegevens vast die zichtbaar zijn in de browser. Privégesprekken, verborgen leden en afgeschermde bestanden worden niet meegenomen.
- Kanaaltitel
- Kanaalgebruikersnaam
- Kanaal-URL
- Kanaalbeschrijving
- Aantal abonnees
- Verificatiestatus van kanaal
- Link naar discussiegroep
- Bericht-ID
- Bericht-URL
- Datum van bericht
- Tijd van bericht
- Bewerkingsdatum
- Berichttekst
- Bijschrift van bericht
- Auteursignatuur
- Weergavenaam afzender
- Aantal weergaven van bericht
- Aantal doorsturingen
- Aantal reacties
- URL van discussiethread
- Status van vastgezet bericht
- Reactie-emoji
- Aantal reacties
- Vragen van poll
- Poll-opties
- Totaal aantal stemmers in poll
- Type media
- Foto-URL
- Video-URL
- URL van linkvoorbeeld
Watch real users hand repetitive browsing to Thunderbit
Their videos show where an AI web scraper fits into day-to-day research and monitoring.
Vragen over de Telegram-scraper
Wat een dataset van een openbaar kanaal kan bevatten en waar de grens ligt.
Research the links shared in Telegram
Use a page-specific scraper for recurring news, product, or community links instead of mixing external claims into the message archive.
Minds Webscraper
Met de Thunderbit Minds-webscraper kun je moeiteloos data uit Minds-nieuwsfeeds en groepsleden halen dankzij slimme AI-veldherkenning. Verzamel posttitels, auteursnamen, likes, reacties en groepsinformatie voor onderzoek, marketing of community-analyses. Exporteer gestructureerde Minds-data snel en efficiënt.
Meer info ->
MeWe Scraper
Met de Thunderbit MeWe-webscraper kun je moeiteloos gegevens verzamelen uit MeWe-profielen en groepsberichten, dankzij AI-gestuurde veldsuggesties. Verzamel profielnamen, bio’s, lidmaatschapsdata, berichtinhoud, likes en reacties voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde MeWe-data willen verzamelen.
Meer info ->
Parler Webscraper
Met de Thunderbit Parler Webscraper kun je moeiteloos data verzamelen uit Parler zoekresultaten en hashtag-overzichten, dankzij AI-gestuurde veldsuggesties. Verzamel zoektermen, gebruikersberichten, hashtags, populariteitsscores en meer voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Parler-data willen verzamelen.
Meer info ->
Element Webscraper
Met de Thunderbit Element Webscraper kun je moeiteloos data uit de Element Synapse Admins Room halen, dankzij AI-gestuurde veldsuggesties. Verzamel bericht-ID's, namen van afzenders, tijdstempels, berichtinhoud en bijlagen voor analyse of monitoring. Perfect voor ontwikkelaars, communitymanagers en onderzoekers die gestructureerde Element-data nodig hebben.
Meer info ->
Odnoklassniki Webscraper
Met de Thunderbit Odnoklassniki-webscraper kun je moeiteloos data verzamelen uit Odnoklassniki-groepen en spellijsten, dankzij slimme AI-veldherkenning. Verzamel groepsnamen, beschrijvingen, ledenaantallen, spelinformatie, beoordelingen en meer voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Odnoklassniki-data nodig hebben.
Meer info ->
Triller Webscraper
Met de Thunderbit Triller-webscraper kun je moeiteloos gegevens verzamelen van Triller-blogpagina’s en profielen van creators. Dankzij AI-gestuurde veldsuggesties verzamel je snel blogtitels, publicatiedata, auteursnamen, bio’s van creators en het aantal volgers – ideaal voor onderzoek, marketing of analyse.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.


