Slack-scraper voor berichten, threads en reacties













Houd Slack-berichten en threadcontext bij elkaar
Begin met één klik, behoud de zichtbare context en verfijn de taak in gewone taal.
Sla CSS-selector-instelling over
Thunderbit leest zichtbaar bericht, auteur, tijd, reactie en threadlabels op basis van betekenis, zodat je direct kunt beginnen zonder CSS-regels voor de Slack-weergave te bouwen.
Open threads voor volledige context
Voor berichten met threads kan Thunderbit de threadweergave openen om antwoorden, auteurs en tijdstempels vast te leggen. Zet gekoppelde paginawissels uit als je alleen de kanaalfeed nodig hebt.
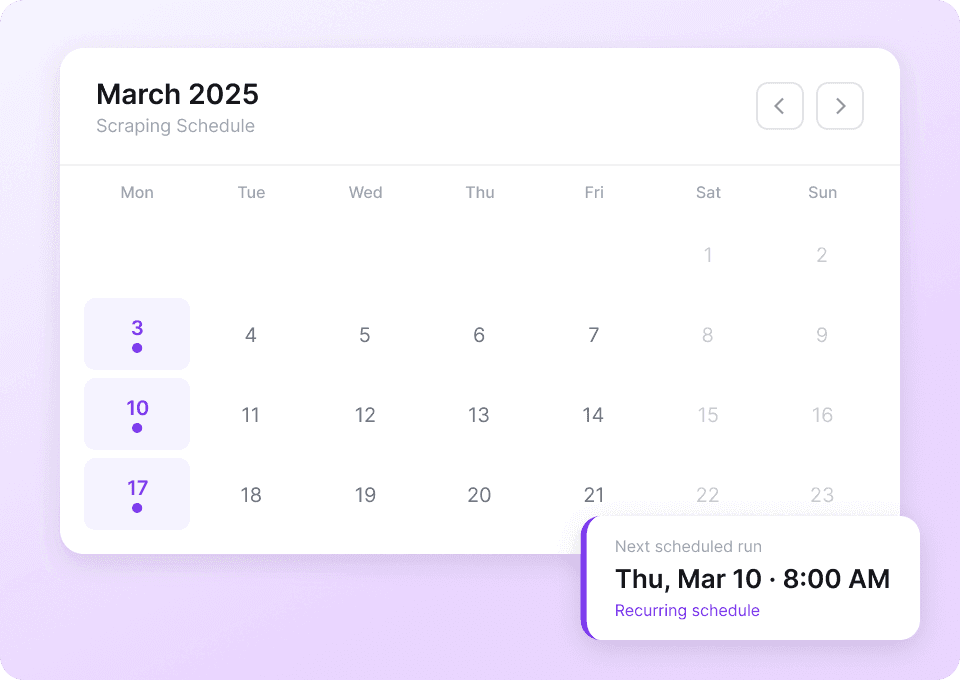
Vernieuw kanaalgegevens volgens schema
Plan runs in. Elke run legt vast wat op dat moment zichtbaar is in je sessie en kan rijen sturen naar Google Sheets, Notion, Airtable of CSV.
Houd Slack-threads bij elkaar zonder zelf een scraper te bouwen
Behoud zichtbare auteurs, tijden, reacties en antwoorden met het juiste bericht.
Handmatig kopiëren of selector-tools
Context gaat verlorenThunderbit AI-agent
Open een Slack-weergave en ga direct van startKolommen om spreker, tijd en context te bewaren
Alleen de velden die zichtbaar zijn in je huidige Slack-weergave worden vastgelegd; verborgen gegevens blijven leeg.
- channel_name
- channel_privacy
- channel_topic
- channel_purpose
- channel_member_count
- message_text
- sender_display_name
- sender_avatar_image
- message_date
- message_time
- message_edited_flag
- message_edited_time
- is_app_message
- app_name
- thread_reply_count
- thread_last_reply_time
- thread_participants_count
- reaction_emoji
- reaction_count
- reactions_total
- mentioned_users
- mentioned_channels
- attachments_count
- attachment_title
- attachment_filetype
- attachment_filesize
- attachment_uploader_name
- pinned_flag
- first_reply_text
- first_reply_sender
Hear users explain how they preserve page context
These Thunderbit videos show real projects where authors, dates, links, and surrounding details need to stay attached to the right row.
Behoud auteurs, tijden en threadlinks intact
Antwoorden voor kanalen en threads die je kunt openen.
Apply this to forums, support threads, and notes
Extract visible message lists from communities, help desks, and release‑note pages you can open in your session.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.


