Eenvoudige Reddit Scraper













Ontgrendel Reddit-data in twee klikken
Reddit-data extraheren in twee klikken
Genoeg van ingewikkelde scrapers waarvoor je moet coderen? Met Thunderbit haal je Reddit-data — zoals posttitels, tekst, auteurs, subreddits en upvotes — in slechts twee klikken op. Wijs simpelweg de gegevens aan die je nodig hebt, en Thunderbit herkent direct de velden en haalt ze op. Geen code, geen CSS-selectors, geen gedoe.
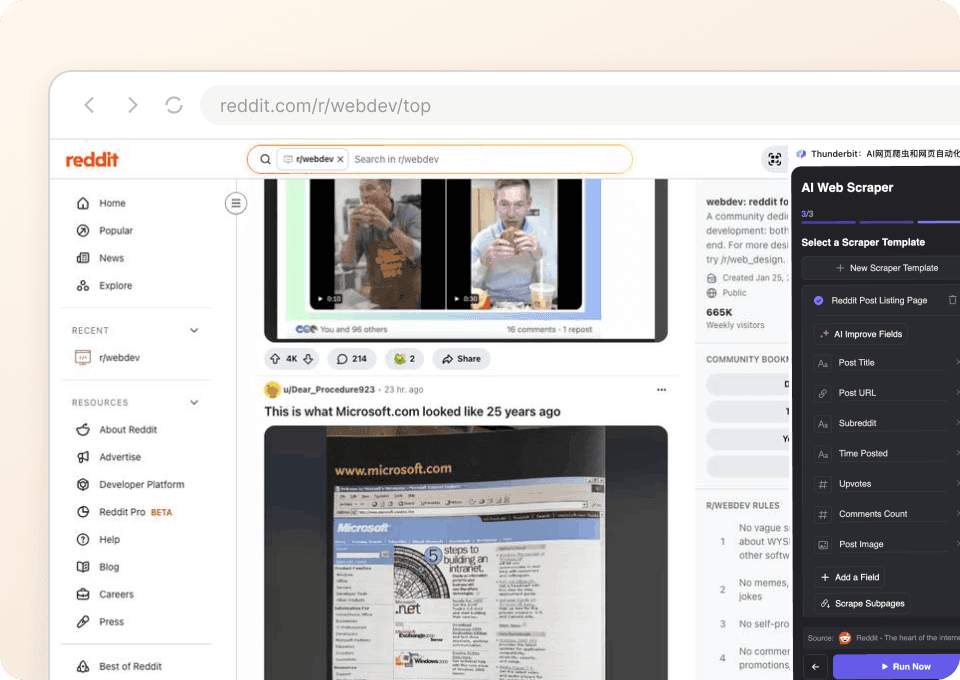
Past zich aan aan wijzigingen in de lay-out van Reddit
De lay-out van Reddit verandert regelmatig, en de meeste scrapers vallen dan uit. Thunderbit gebruikt semantische AI om pagina-inhoud op betekenis te begrijpen — niet op vaste selectors. Dus wanneer Reddit het design aanpast, schakelt Thunderbit automatisch mee en blijft je postdata, auteursinformatie en subreddit-details zonder onderbreking doorstromen.
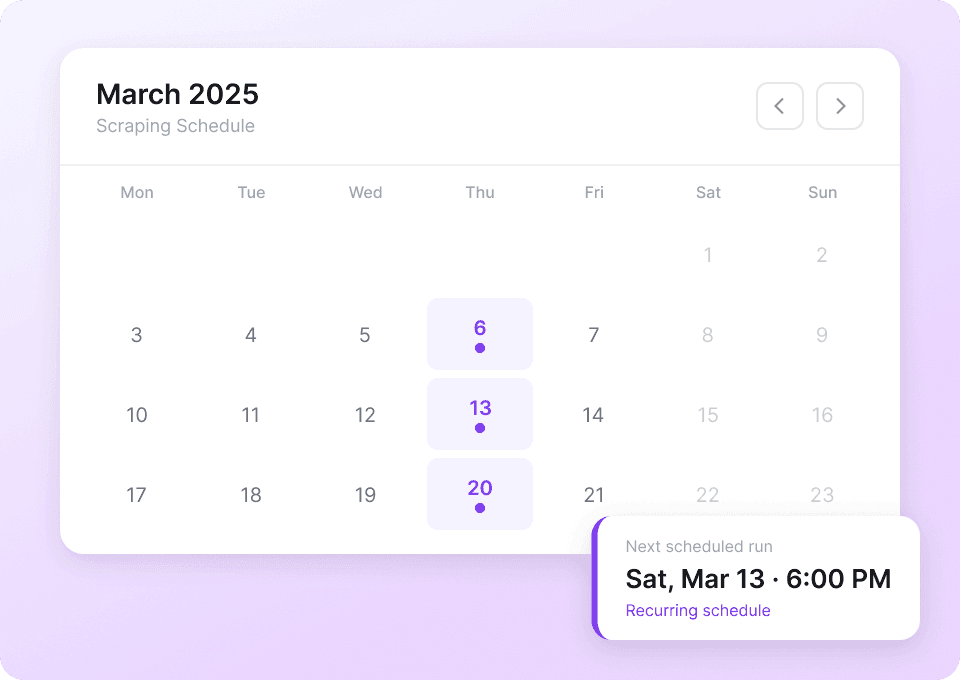
Automatiseer het verzamelen van Reddit-data
Reddit-data verandert continu — nieuwe posts, nieuwe upvotes, nieuwe reacties. Met Thunderbit kun je terugkerende verzameltaken inplannen, zodat je altijd de nieuwste posttitels, upvotes en threaddata direct ontvangt in Google Sheets, Notion of Airtable. Eenmalig instellen is genoeg; daarna blijft je data automatisch actueel.
Genoeg van gedoe met Reddit-scraping?
Ontdek waarom Thunderbit de makkelijkste manier is om Redfin-data te extraheren.
Traditionele scrapers
De oude manierThunderbit
De slimmere aanpakNeem niet alleen ons woord ervoor
Bekijk wat onze gebruikers over Thunderbit zeggen.
Veelgestelde vragen
Gerelateerd toepassingen
Ontdek meer toepassingen van Thunderbit’s webscraper.
Minds Webscraper
Met de Thunderbit Minds-webscraper kun je moeiteloos data uit Minds-nieuwsfeeds en groepsleden halen dankzij slimme AI-veldherkenning. Verzamel posttitels, auteursnamen, likes, reacties en groepsinformatie voor onderzoek, marketing of community-analyses. Exporteer gestructureerde Minds-data snel en efficiënt.
Meer info ->
MeWe Scraper
Met de Thunderbit MeWe-webscraper kun je moeiteloos gegevens verzamelen uit MeWe-profielen en groepsberichten, dankzij AI-gestuurde veldsuggesties. Verzamel profielnamen, bio’s, lidmaatschapsdata, berichtinhoud, likes en reacties voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde MeWe-data willen verzamelen.
Meer info ->
Parler Webscraper
Met de Thunderbit Parler Webscraper kun je moeiteloos data verzamelen uit Parler zoekresultaten en hashtag-overzichten, dankzij AI-gestuurde veldsuggesties. Verzamel zoektermen, gebruikersberichten, hashtags, populariteitsscores en meer voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Parler-data willen verzamelen.
Meer info ->
Element Webscraper
Met de Thunderbit Element Webscraper kun je moeiteloos data uit de Element Synapse Admins Room halen, dankzij AI-gestuurde veldsuggesties. Verzamel bericht-ID's, namen van afzenders, tijdstempels, berichtinhoud en bijlagen voor analyse of monitoring. Perfect voor ontwikkelaars, communitymanagers en onderzoekers die gestructureerde Element-data nodig hebben.
Meer info ->
Odnoklassniki Webscraper
Met de Thunderbit Odnoklassniki-webscraper kun je moeiteloos data verzamelen uit Odnoklassniki-groepen en spellijsten, dankzij slimme AI-veldherkenning. Verzamel groepsnamen, beschrijvingen, ledenaantallen, spelinformatie, beoordelingen en meer voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en bedrijven die gestructureerde Odnoklassniki-data nodig hebben.
Meer info ->
Triller Webscraper
Met de Thunderbit Triller-webscraper kun je moeiteloos gegevens verzamelen van Triller-blogpagina’s en profielen van creators. Dankzij AI-gestuurde veldsuggesties verzamel je snel blogtitels, publicatiedata, auteursnamen, bio’s van creators en het aantal volgers – ideaal voor onderzoek, marketing of analyse.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



