IMDb-scraper













Ontgrendel IMDb-data in twee klikken
Stuur IMDb-data direct naar je tools
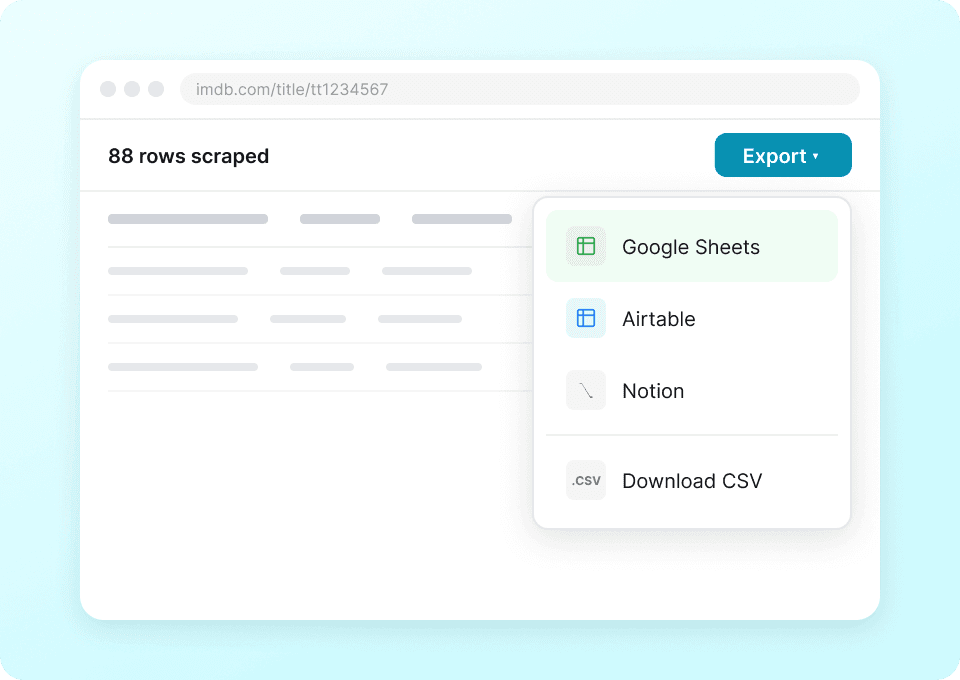
Ben je het zat om filmtitels, beoordelingen, genres en acteerrollen steeds handmatig van IMDb naar je spreadsheets te kopiëren? Thunderbit maakt een einde aan die eindeloze copy-paste. Stuur gestructureerde IMDb-data met één klik rechtstreeks naar Google Sheets, Notion of Airtable. Stop met tabbladen wisselen en begin met analyseren.
Scrape data van elke site, niet alleen IMDb
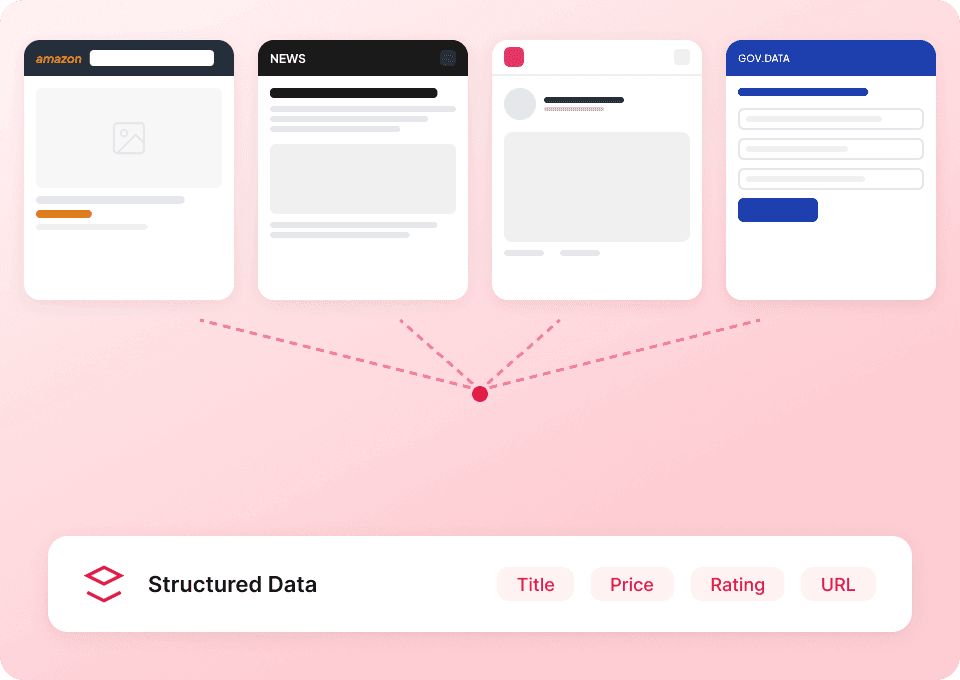
Waarom voor elke website een nieuwe tool leren? Thunderbit werkt overal. Gebruik onze 50+ kant-en-klare templates, of wijs en klik om data te extraheren van elke website, PDF, afbeelding of document. Of het nu gaat om filminformatie van IMDb of gegevens van een andere site, Thunderbit regelt het allemaal.
Werk je IMDb-data automatisch bij
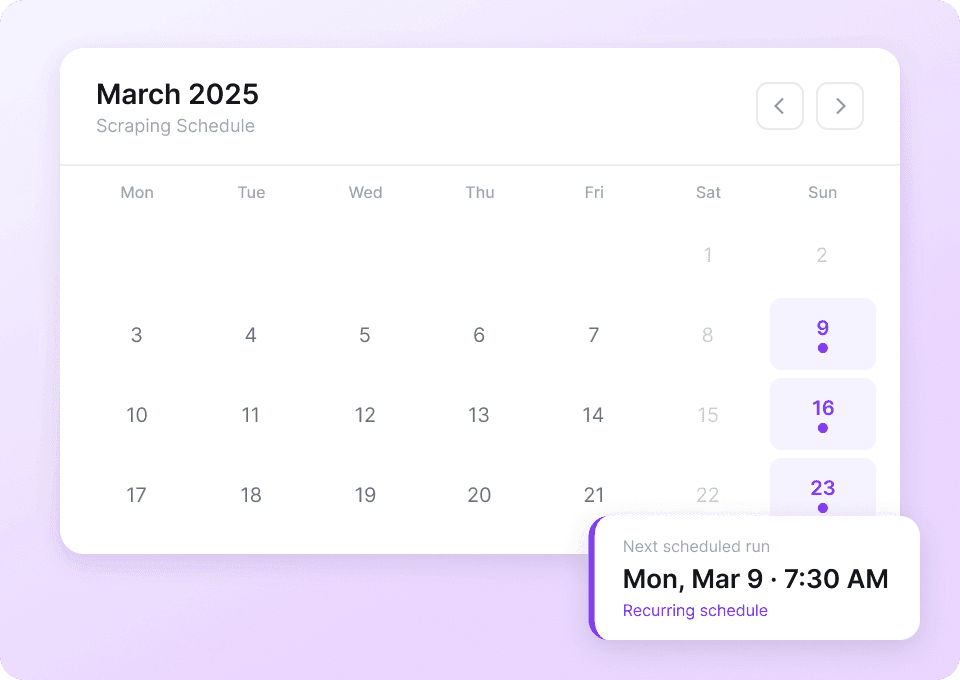
IMDb-data — zoals releasedata en beoordelingen — verandert voortdurend. Handmatig opnieuw scrapen kost tijd. Stel geplande scraping in Thunderbit in en laat het automatisch draaien. Krijg verse filmtitels, namen van regisseurs en genre-informatie direct geleverd in je Google Sheets- of Notion-werkruimte, zonder er zelf naar om te kijken.
Moeite met het scrapen van IMDb-data?
Bekijk hoe Thunderbit IMDb-scraping eenvoudiger maakt dan traditionele methoden.
Traditionele scrapers
De oude manier van werkenThunderbit
De slimmere aanpakNeem niet alleen ons woord ervoor
Bekijk wat onze gebruikers over Thunderbit zeggen.
Veelgestelde vragen
Gerelateerd toepassingen
Ontdek meer toepassingen van Thunderbit’s webscraper.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



