Goodreads-scraper













Haal Goodreads-data op in seconden, niet in uren
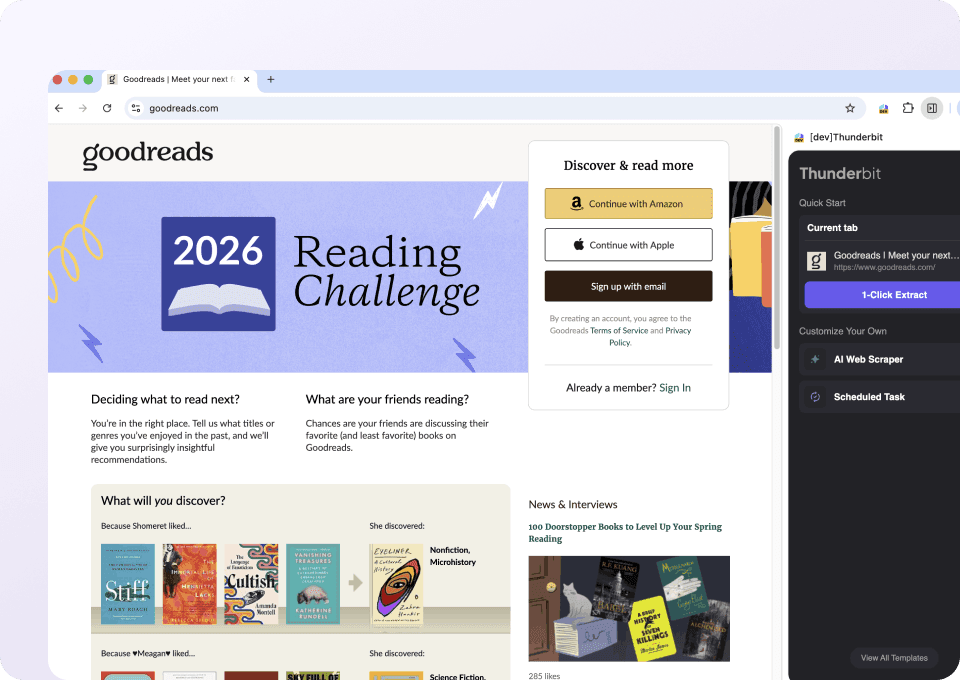
Scrape Goodreads-data in twee klikken
Ben je het zat om handmatig boektitels, auteursnamen, beoordelingen en paginatellingen van Goodreads te kopiëren? Met Thunderbit haal je de data die je nodig hebt in slechts twee klikken op — zonder code of technische setup. Wijs simpelweg de velden aan die je wilt, en de AI herkent en verzamelt ze automatisch.
Schone Goodreads-data, direct bruikbaar
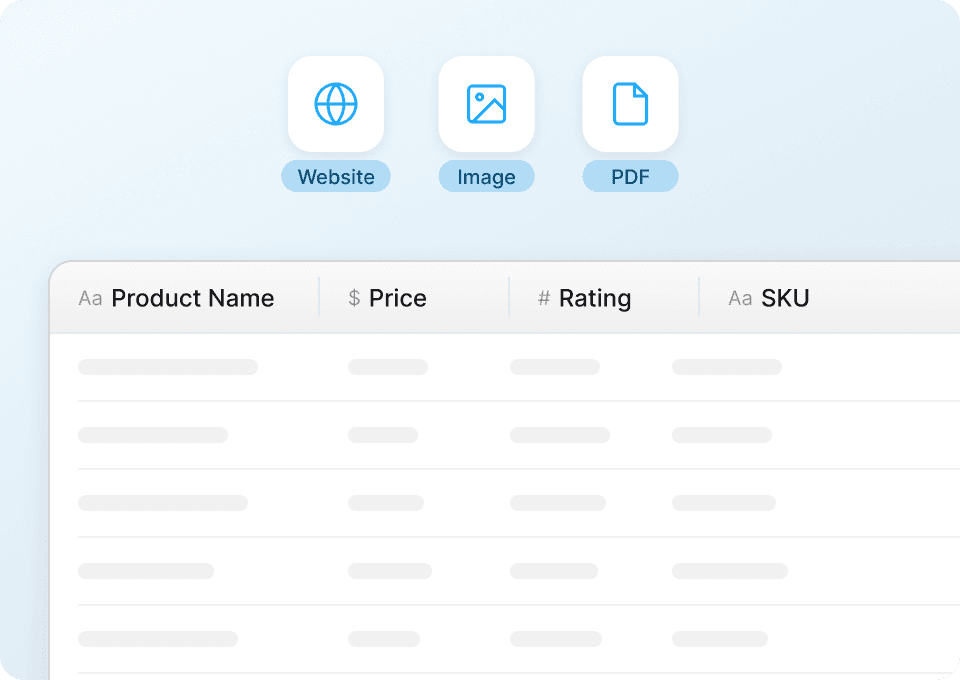
Goodreads-data kan rommelig en inconsistent zijn. Thunderbit maakt de data automatisch schoon en structureert die tijdens het extraheren — zodat je een perfect opgemaakt spreadsheet krijgt met boektitels, auteurs, gemiddelde beoordelingen, aantallen reviews en paginanummers, allemaal direct klaar voor analyse. Geen handmatige opschoning nodig.
Scrape honderden Goodreads-pagina's
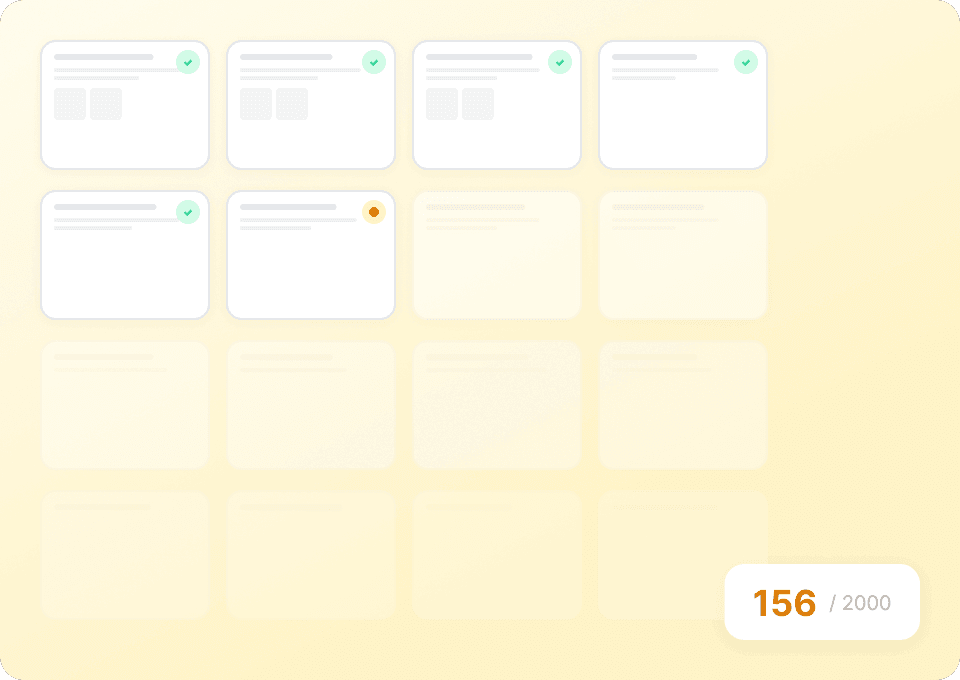
Handmatig Goodreads-pagina voor pagina bezoeken is traag en foutgevoelig. Thunderbit verwerkt bulk scraping automatisch — lever gewoon een lijst met URL's aan en het haalt in één keer boektitels, auteurs, beoordelingen en meer op uit honderden pagina's, snel en zonder onderbreking.
Heb je genoeg van Goodreads-scraping?
Bekijk hoe Thunderbit het extraheren van data uit Goodreads eenvoudiger maakt.
Traditionele scrapers
De oude manier van werkenThunderbit
De slimmere aanpakNeem niet alleen ons woord ervoor
Bekijk wat onze gebruikers over Thunderbit zeggen.
Veelgestelde vragen
Gerelateerd toepassingen
Ontdek meer toepassingen van Thunderbit’s webscraper.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



