Craigslist-scraper voor lokale advertenties













Zet zichtbare Craigslist-advertenties om in een tabel
Verzamel de details die op de pagina's staan die jij kiest, met het besef dat elke advertentie anders kan zijn.
Verzamel Craigslist-advertenties met één klik
Open een resultatenpagina of advertentiepagina. One Click Extract kan titel-, tekst-, prijs-, plaats-, datum- en URL-velden voorstellen. Je kunt de kolommen zonder code aanpassen.
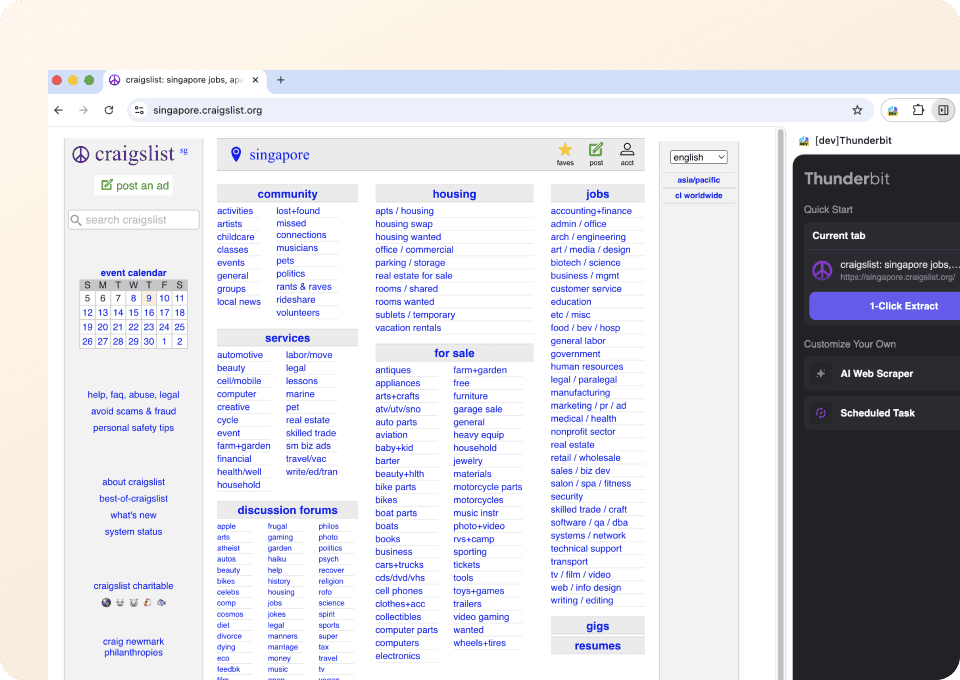
Lees velden uit verschillende advertentielay-outs
Craigslist-rubrieken en regionale sites tonen verschillende velden. Thunderbit leest zichtbare details op basis van betekenis, niet op vaste posities. Ontbrekende of verborgen informatie blijft leeg.

Exporteer zichtbare advertentiedetails direct
Zet elke rij over naar een lokaal overzichtsblad voor advertenties. Gevraagde prijzen, datums, gebieden en categoriedetails blijven gekoppeld aan de juiste woning-, vacature- of verkoopadvertentie.

Houd elk Craigslist-detail bij de juiste advertentie
Bij handmatig kopiëren raken prijzen, datums en plaatsen vaak los van de advertentie waar ze bij horen.
Handmatig gekopieerde advertenties
Nuttige context gaat verlorenGestructureerde advertentieregels
Zichtbare details blijven bij elke advertentieWelke gegevens kun je uit Craigslist halen?
Kies uit deze openbare advertentievelden. Wat je ziet, hangt af van de rubriek, het gebied, de categorie en de details die de plaatser toont.
- Berichttitel
- Berichttekst
- Plaatsingstype
- Categorie
- Craigslist-gebied
- Subgebied
- Buurt
- Gevraagde prijs
- Prijsstatus
- Plaatsingsdatum
- Advertentie-URL
- Afbeeldings-URL's
- Privacymodus voor antwoordmail
- Alternatieve contactgegevens
- Stad
- Staat
- Postcode
- Breedtegraad
- Lengtegraad
- Contactnaam
- Contacttelefoon
- Bezorging mogelijk
- Cryptovaluta geaccepteerd
- Taal
- Conditie
- Fabrikant
- Model
- Slaapkamers
- Badkamers
- Woonoppervlak
See how people build local listing shortlists
Watch short user videos about housing, job, and resale lists built from public Craigslist pages.
Vragen over het verzamelen van Craigslist-advertenties
Craigslist-velden verschillen per gebied, rubriek, categorie en wat een plaatser openbaar maakt.
Explore more ways to research public listings
Try other marketplace, housing, or local listing scrapers when your work goes beyond one Craigslist section or area.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.


