Bilibili Webscraper voor video's, reacties en danmaku













Houd Bilibili-videonderzoek in beweging terwijl cijfers veranderen
Gebruik één workflow voor openbare pagina's, verwerk videolijsten in bulk en vernieuw prestatie-snapshots volgens een schema.
Begin op Bilibili of een andere openbare pagina
Thunderbit is niet beperkt tot één videosite. Open de pagina die je nodig hebt, laat AI de zichtbare velden voorstellen en stem de uitvoer af in natuurlijke taal.
Verwerk Bilibili-videolijsten in bulk
Plak een reeks openbare video-URL's en verzamel in één run titels, BV-ID's, uploaddata, zichtbare weergaven, likes, coins, favorieten, reacties of danmaku-details.
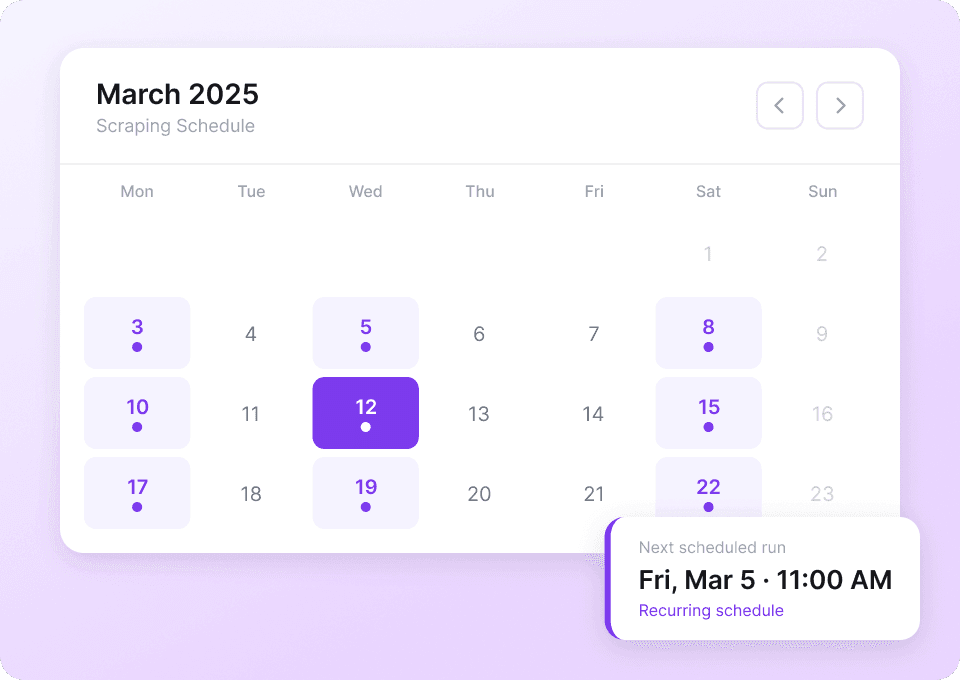
Ververs veranderende videometrieken volgens schema
Keer terug naar de geselecteerde video's op het interval dat jij kiest. Verse openbare cijfers kunnen naar je spreadsheet stromen, zodat elke monitoringsronde een nieuwe snapshot oplevert.
Volg Bilibili-video's zonder selectors te onderhouden
Traditionele scrapers zijn afhankelijk van vaste posities en laadregels. Thunderbit AI leest zichtbare videoinformatie op basis van betekenis.
Een scraper die vastzit aan één Bilibili-layout
Kleine wijzigingen zorgen voor herstelwerkBilibili-pagina's verwerkt door Thunderbit
AI neemt meer van de inrichting uit handenExportvelden voor Bilibili-video- en danmakugegevens
Afhankelijk van of je een kijkpagina, kanaalvideolijst of multi-part speler crawlt, kunnen sommige velden hieronder ontbreken; exports weerspiegelen wat tijdens je run publiek zichtbaar was.
- Videotitel
- BV-video-ID
- Video-URL
- Videocategorie
- Videobeschrijving
- URL van omslagafbeelding
- Uploaddatum
- Videoduur
- Naam uploader
- URL van uploaderprofiel
- Aantal volgers van uploader
- Aantal weergaven
- Aantal danmaku
- Aantal vind-ik-leuks
- Aantal coins
- Aantal favorieten
- Aantal reacties
- Aantal keer gedeeld
- Videotags
- Kennisgeving over auteursrecht of herplaatsing
- Kennisgeving over AI-gegenereerde inhoud
- Naam van serie of collectie
- Afleverings- of onderdeelnummer
- Reactietekst
- Naam van reageerder
- Aantal vind-ik-leuks op reactie
- Aantal antwoorden op reactie
- Reactiedatum
- Danmaku-tekst
- Video-tijdstempel van danmaku
See how users monitor changing web data with Thunderbit
Their videos show practical ways to turn repeated page checks into organized, exportable records.
Werken met Bilibili-video- en danmakugegevens
Antwoorden voor onderzoeksgerichte verzameling van openbare pagina's.
Need seeds? Gather BV IDs from Bilibili search or tag pages
First collect Video URL and BV Video ID from public search or tag listings to build a crawl queue, then return here to capture comments, danmaku, and recommendation context for each target video.
RUTUBE Webscraper
Met de Thunderbit RUTUBE-webscraper kun je moeiteloos gegevens verzamelen van populaire RUTUBE-kanalen en trending video's. Dankzij AI-gestuurde veldsuggesties verzamel je snel kanaalnamen, abonneeaantallen, videotitels, weergaven, likes en meer – ideaal voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde RUTUBE-data nodig hebben.
Meer info ->
Rumble Scraper
Met de Thunderbit Rumble Webscraper kun je moeiteloos gegevens van de Rumble-leaderboard en de online winkel verzamelen. Dankzij AI-gestuurde veldsuggesties verzamel je snel rangen, gebruikersnamen, scores, productnamen, prijzen en beschikbaarheid voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Rumble-data nodig hebben.
Meer info ->
eFind Webscraper
Met de Thunderbit eFind Webscraper kun je moeiteloos gegevens verzamelen van de video- en nieuwszoekresultaten op eFind. Dankzij AI-gestuurde veldsuggesties verzamel je snel videotitels, URL’s, duur, uploaddata, nieuwsdetails en meer – ideaal voor onderzoek, marketing of analyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde eFind-data willen verzamelen.
Meer info ->
Vimeo-scraper
Haal Vimeo-videotitels, aantal weergaven, uploaddata en meer binnen 2 klikken op — en exporteer daarna direct naar Excel, Google Sheets of Notion. Zonder code.
Meer info ->
FC2 Webscraper
Met de Thunderbit FC2 Webscraper kun je moeiteloos gegevens verzamelen van FC2-videolijsten en ranglijsten. Dankzij AI-gestuurde veldsuggesties verzamel je snel videotitels, URL’s, uploaders, weergaven, likes en ranginformatie voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde FC2-data nodig hebben.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.



