Baidu-scraper voor zoekresultaten en artikelen





Zet Baidu-resultaten om in schone, bruikbare data
Bewaar zoekresultaten en beschikbare artikelinformatie in één overzichtelijke tabel.
Werk Baidu-data direct netjes uit tijdens het verzamelen
Thunderbit plaatst zichtbare titels, URL's, snippets, datums en bronnen in overzichtelijke kolommen. Als een resultaat een veld niet toont, blijft de cel leeg.
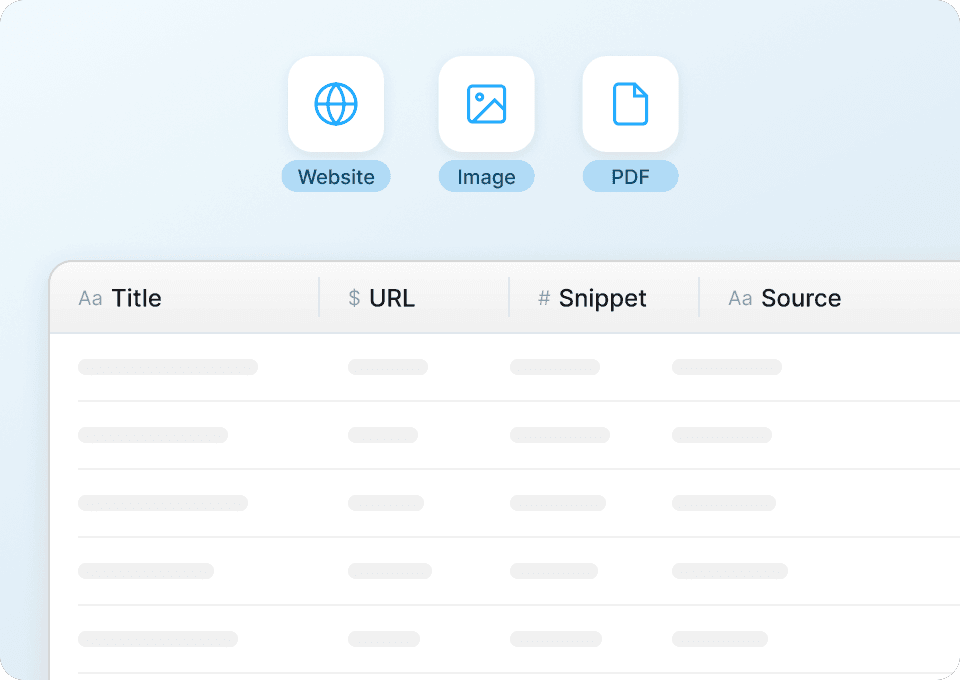
Exporteer Baidu-onderzoek met één klik
Stuur elke run naar een werkblad voor het beoordelen van zoekresultaten. Posities, bronnen, datums en details van gekoppelde pagina's blijven naast het bijbehorende Baidu-resultaat staan.

Gebruik dezelfde workflow op elke site
Thunderbit leest velden op betekenis, niet op één Baidu-layout. Gebruik dezelfde aanpak op elke toegankelijke openbare site wanneer je onderzoek een nieuwe bron bereikt.

Behoud de context rond elk Baidu-resultaat
Een lijst met links verliest context. Thunderbit houdt zichtbare details bij elk resultaat.
Gekopieerde links en losse notities
Resultaatdetails raken van elkaar gescheidenGestructureerd Baidu-onderzoek
Zichtbare context blijft bij elk resultaatWelke gegevens kun je uit Baidu halen?
Kies uit deze openbare, zichtbare velden. Resultaatmodules en gekoppelde pagina's tonen niet voor elke zoekopdracht alle velden.
- Zoekopdracht
- Resultaatpositie
- Resultaattitel
- Resultaat-URL
- Weergegeven URL
- Resultaatsnippet
- Resultaatdatum
- Pictogram van resultaatwebsite
- Gerelateerde zoekterm
- Spellingsuggestie
- Pinyin-suggestie
- Paginanummer van zoekresultaat
- Bronwebsite
- Brondomein
- Auteursnaam van artikel
- Publicatiedatum van artikel
- Artikel samenvatting
- Documentnaam
- Documentbeschrijving
- Documentbroodkruimelpad
- Documentgenre
- Documentbestandsformaat
- Aantal pagina's van document
- Uploadtijd van document
- Document-URL
- Inhoudstype van resultaat
- Miniatuurafbeelding
- Miniatuur van video
- Locatieadres
- Baidu-functiemodule
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Vragen over het verzamelen van Baidu-zoekdata
Beschikbare velden verschillen per zoekopdracht, resultaattype en de informatie die op gekoppelde pagina's wordt getoond.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Flixster Webscraper
Met de Thunderbit Flixster Webscraper kun je moeiteloos gegevens verzamelen van Flixster’s box office-lijsten en bioscopen in de buurt. Dankzij AI-gestuurde veldsuggesties verzamel je snel filmtitels, box office-opbrengsten, beoordelingen, releasedata, bioscoopnamen, locaties en het actuele filmaanbod voor analyse of onderzoek.
Meer info ->
olympustaff.com Webscraper
Met de Thunderbit olympustaff.com Webscraper kun je eenvoudig gegevens verzamelen uit stripboekenlijsten en reacties op olympustaff.com. Dankzij AI-gestuurde veldsuggesties verzamel je snel titels, auteurs, verschijningsdata en feedback van lezers voor analyse of onderzoek. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde data van olympustaff.com willen ophalen.
Meer info ->
Hatena Webscraper
Met de Thunderbit Hatena Webscraper kun je eenvoudig gegevens uit Hatena-blogs en onderwerplijsten halen dankzij AI-gestuurde veldsuggesties. Verzamel blogtitels, auteursnamen, publicatiedata, samenvattingen en populaire onderwerpen voor onderzoek, marketing of contentanalyse. Perfect voor marketeers, onderzoekers en contentmakers die gestructureerde Hatena-data willen verzamelen.
Meer info ->
namu.wiki Scraper
Met de Thunderbit namu.wiki Webscraper kun je moeiteloos gegevens van namu.wiki verzamelen, zoals relevante pagina's en actuele discussies. Dankzij AI-gestuurde veldsuggesties verzamel je snel paginatitels, URL's, laatste bewerkingsdata, discussieonderwerpen en deelnemersnamen – ideaal voor onderzoek, contentcreatie of community-analyses.
Meer info ->
NetEase Music Webscraper
Met de Thunderbit NetEase Music Webscraper kun je moeiteloos gegevens verzamelen uit NetEase Music zoekresultaten en artiestenpagina’s. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albumdetails, speelduur en song-URL’s voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en liefhebbers die gestructureerde NetEase Music data willen verzamelen.
Meer info ->
QQ Music Webscraper
Met de Thunderbit QQ Music Webscraper kun je moeiteloos gegevens uit QQ Music zoekresultaten en artiestenoverzichten halen. Dankzij AI-gestuurde veldsuggesties verzamel je snel songtitels, artiestnamen, albuminformatie, releasedata en meer voor analyse of onderzoek. Perfect voor muziekonderzoekers, marketeers en muziekliefhebbers die gestructureerde QQ Music data willen verzamelen.
Meer info ->Klaar om je data-extractie een boost te geven?
Sluit je aan bij 200.000+ professionals die Thunderbit al gebruiken om hun webscrapingworkflows te automatiseren.
De gratis proefperiode biedt onbeperkte credits voor 8 webpagina’s.


