
Vorige week stuurde een collega me een leverancierscontract van 47 pagina’s met het verzoek om “even de prijstabellen in een spreadsheet te zetten”. Ik keek ongeveer drie seconden naar de PDF, sloot hem toen weer af en opende in plaats daarvan een PDF scraper. Dat was geen luiheid, maar een reflex die voortkomt uit jarenlange ervaring met mensen die hele middagen verspillen aan het uit een bestand halen van data die daar eigenlijk nooit voor bedoeld was.
De cijfers bevestigen die frustratie. Uit de 2024-enquête van Airbase onder 745 finance professionals blijkt dat 38% van de teams meer dan een kwart van hun totale tijd kwijt is aan handmatige taken. Het AP-automatiseringsrapport van SAP Concur voegt daaraan toe dat 60% van de invoer van facturen in ERP- of boekhoudsystemen nog steeds met de hand gebeurt.
PDF’s zijn overal—facturen, contracten, financiële overzichten, gescande bonnen—en toch gebeurt een groot deel van het werk nog steeds via kopiëren en plakken. In 2026 variëren PDF scrapers van gratis Python-bibliotheken tot AI-gestuurde no-code tools, en de verkeerde keuze kan je juist dagen kosten in plaats van tijd besparen. Ik heb 12 van de beste PDF scrapers getest op tabelextractie, OCR, prijs en gebruiksgemak, zodat jij in minuten de juiste match kunt vinden.
Wat is een PDF scraper (en waarom zou je dat iets moeten schelen)?
Een PDF scraper is software die automatisch tekst, tabellen, velden en gestructureerde data uit PDF-bestanden haalt. Als je ooit hebt geprobeerd een tabel uit een PDF naar Excel te kopiëren en de kolommen in één rommelige regel zag veranderen, dan snap je het probleem al.
PDF scrapers en web scrapers worden vaak door elkaar gehaald, dus een kort onderscheid helpt. Een web scraper leest HTML, waarin in elk geval structuur zit zoals koppen, tabellen en divs. Een PDF scraper begint bij een visuele beschrijving van een pagina. Adobe’s eigen documentatie maakt duidelijk dat PDF bedoeld is om de opmaak van een pagina te behouden op elk apparaat, niet om nette tabulaire of semantische structuur bloot te leggen. Daarom vernielt kopiëren en plakken rijen, kolommen en leesvolgorde.
Waar bespaart PDF scraping nu echt tijd?
- Factuurverwerking: leveranciersnamen, factuurnummers, totalen, btw en regels uitlezen
- Financiële rapporten: tabellen uit jaarverslagen, overzichten en disclosures halen
- Gescande documenten: contactgegevens of transactiegegevens terugvinden in PDF’s met alleen afbeeldingen
- Migratie van oude archieven: oude dossiers omzetten naar doorzoekbare, gestructureerde records
De impact op het bedrijf gaat verder dan één workflow. Gartner beschouwt slechte datakwaliteit nog steeds als een kostenpost van gemiddeld minstens $12,9 miljoen per jaar. En in februari 2025 meldde Gartner dat 63% van de organisaties niet de juiste datamanagementpraktijken voor AI heeft, of niet zeker weet of ze die hebben. Tot en met 2026 zegt Gartner dat organisaties 60% van hun AI-projecten zullen laten vallen als die niet worden ondersteund door AI-ready data. Als PDF’s nog steeds een groot deel van de ruwe data bevatten, dan is de kwaliteit van documentextractie nu direct gekoppeld aan AI-geschiktheid.
Uit Adobe’s 2025-enquête onder financiële professionals blijkt dat 61% regelmatig PDF-gebaseerde documenten bewerkt en 64% ze regelmatig ondertekent. De PDF Association merkt bovendien op dat PDF in CommonCrawl-data werd gerangschikt als het 3e populairste bestandsformaat op het web. PDF’s verdwijnen dus niet.
Hoe we de beste PDF scrapers hebben beoordeeld
Voordat we in de tools duiken, is hier het raamwerk dat ik heb gebruikt. De acht criteria hieronder sluiten direct aan op de pijnpunten die ik het vaakst zie in forums, GitHub-issues en productreviews:
| Criteria | Wat het meet | Waarom gebruikers dit belangrijk vinden |
|---|---|---|
| Ondersteunde PDF-types | Natuurlijke tekst, gescand/afbeelding-only, gemengd | Veel tools vallen al vóór de extractie uit |
| Nauwkeurigheid van tabelextractie | Simpele tabellen, zonder randen, meerpagina-tabellen, tabellen met samengevoegde cellen | De belangrijkste klacht bij PDF-extractie |
| OCR-mogelijkheden | Ingebouwd, add-on of afwezig | Gescande PDF’s zijn zonder OCR onbruikbaar |
| Output-/exportformaten | Excel, CSV, JSON, Sheets, Notion, API’s | Data is waardeloos als die niet netjes uit de tool kan |
| Moeilijkheidsgraad van setup | No-code, low-code of code-first | Teams hebben heel verschillende niveaus van controle nodig |
| Prijs / gratis versie | Publieke prijs, proefversie, realistische instap | Factureringsmodellen verschillen enorm |
| Automatisering / integraties | Zapier, API, scheduling, webhooks | Handmatige exports schaal je niet op |
| Beste use case | Waar de tool in de praktijk echt goed in is | De meeste tools zijn niet universeel goed, maar workflow-specifiek |
Om het overzichtelijk te houden, heb ik de 12 tools in drie categorieën verdeeld: no-code AI scrapers, template-gebaseerde of SaaS document parsers, en developer libraries / API’s / open-source tools.
De 12 beste PDF scrapers in één oogopslag
Hier is de hoofdvergelijking, zodat je snel kunt scannen wat bij jouw situatie past:
| Tool | Type | Tabelextractie | Ingebouwde OCR | No-code | Gratis versie | Beste voor |
|---|---|---|---|---|---|---|
| Thunderbit | AI no-code scraper | ✅ AI-gestuurd | ✅ Ja | ✅ Ja | ✅ Gratis credits | Zakelijke gebruikers, wisselende layouts |
| Tabula | Open-source desktop | ✅ Goed (tekst-PDF’s) | ❌ Nee | ✅ GUI | ✅ Helemaal gratis | Eenvoudige tekst-PDF’s met veel tabellen |
| Parseur | Hybride SaaS | ⚠️ Template + AI | ✅ Ja | ✅ Ja | ⚠️ Beperkt | Terugkerende factuur-/e-mailverwerking |
| Nanonets | AI IDP SaaS | ✅ Sterk | ✅ Ja | ✅ Low-code | ⚠️ Proefcredits | Documentautomatisering op grote schaal |
| Adobe Acrobat | PDF-productiviteitssuite | ⚠️ Basis | ✅ Ja | ✅ Ja | ❌ Export is betaald | Af en toe PDF naar Excel |
| PyMuPDF | Python-bibliotheek | ⚠️ Handmatige parsing | ❌ Nee (Tesseract optioneel) | ❌ Code vereist | ✅ Helemaal gratis | Developers, tekstzware PDF’s |
| Camelot | Python tabelbibliotheek | ✅ Sterk (lattice + stream) | ❌ Nee | ❌ Code vereist | ✅ Helemaal gratis | Developers, complexe tabellen |
| Docparser | Template SaaS | ⚠️ Template-gebaseerd | ✅ Ja | ✅ Ja | ⚠️ Proefversie | Terugkerende documenten + Zapier-workflows |
| pdfplumber | Python-bibliotheek | ✅ Goed (fijnmazig) | ❌ Nee | ❌ Code vereist | ✅ Helemaal gratis | Developers, gedetailleerde controle |
| AWS Textract | Cloud API | ✅ Sterk | ✅ Ja | ❌ API vereist | ⚠️ Beperkte gratis laag | Pipelines op enterprise-schaal |
| Docling | Open-source Python | ✅ Goed | ✅ Via integratie | ❌ Code vereist | ✅ Helemaal gratis | LLM/RAG-pipelines |
| Parsio | Hybride SaaS | ⚠️ AI-ondersteund | ✅ Ja | ✅ Ja | ⚠️ Beperkt | Terugkerende documenttypes |
Wil je nul setup? Begin bij de no-code- of SaaS-rijen. Heb je maximale controle nodig? Kijk dan naar de developer-rijen. Werk je met gescande PDF’s? Streep dan alles weg waar OCR = Nee staat.
1. Thunderbit
 Thunderbit is de PDF scraper die ik zou geven aan iedereen die zegt: “Ik wil gewoon die data uit deze PDF hebben” en geen zin heeft in Python, templates of API-keys. Het is een AI-webdata-agent—een Chrome-extensie—die PDF’s, afbeeldingen en websites leest en daar gestructureerde data van maakt. Geen templates, geen code.
We hebben Thunderbit gebouwd voor precies het scenario dat de meeste tools laat struikelen: je krijgt PDF’s van vijf verschillende leveranciers, elk met een iets andere layout, en je wilt uit allemaal dezelfde velden halen. De AI leest elk document opnieuw, stelt kolomnamen en gegevenstypen voor via de functie "AI Suggest Fields", en zet de data in een gestructureerde tabel. Ingebouwde OCR verwerkt gescande PDF’s en afbeeldingen native, met ondersteuning voor 34 talen.
Belangrijkste functies:
- One Click Extract bepaalt automatisch kolommen en gegevenstypen uit elke PDF-layout — geen handmatige configuratie
- Ingebouwde OCR voor gescande PDF’s en afbeeldingen
- Export naar Excel, Google Sheets, Airtable, Notion, CSV en JSON — allemaal gratis
- AI-labeling en herformattering: de AI kan tijdens het extraheren vertalen, categoriseren of herstructureren, niet alleen achteraf
- Tabelextractie leest de opmaak visueel (zoals een mens dat doet) en past zich aan aan tabellen zonder randen, onregelmatige layouts en multi-vendor-formaten
Hoe scrape je een PDF met Thunderbit:
- Installeer de Thunderbit Chrome-extensie
- Open je PDF in de browser of upload hem
- Klik op "One Click Extract" — de AI leest het document en bepaalt kolomnamen en gegevenstypen
- Klik op "Scrape" — de data wordt naar een gestructureerde tabel gehaald
- Exporteer naar Google Sheets, Excel, Airtable, Notion, CSV of JSON
Prijs: Gratis versie met credits (ongeveer 6 pagina’s gratis, 10 met proefversie). Starter-abonnement vanaf ongeveer $15/maand of circa $9/maand bij jaarlijkse facturering. Credits zijn gebaseerd op rijen (1 credit = 1 outputrij). Zie Thunderbit Pricing voor details.
Beste voor: Niet-technische gebruikers die met uiteenlopende PDF-layouts werken (facturen van meerdere leveranciers, rapporten in gemengde formaten) en in één klik resultaat willen.
Pluspunten: Makkelijkste setup in deze lijst; ingebouwde OCR; directe export naar Sheets, Notion, Airtable en Excel; werkt zonder templates op verschillende layouts.
Minpunten: Credit-gebaseerde facturering vraagt even omrekening naar kosten per pagina; minder third-party reviews dan grotere SaaS-aanbieders.
Probeer Thunderbit voor PDF-extractie Upload facturen van vijf verschillende leveranciers en laat de AI per layout de kolommen bepalen — zonder per-template setup. Get Started Free
2. Tabula
 Tabula is de klassieke gratis oplossing voor tabelextractie uit tekst-PDF’s, maar het is inmiddels ook duidelijk een legacy-project. De repo vermeldt dat het een door vrijwilligers onderhouden project is, en de desktopapp zal waarschijnlijk niet meer snel worden bijgewerkt. De nieuwste desktoprelease is nog steeds 1.2.1 uit 2018, terwijl tabula-java de laatste release 1.0.5 in 2021 had.
Belangrijkste functies:
- Point-and-click GUI om tabelgebieden te selecteren
- Draait lokaal — data verlaat je machine niet
- Geen account, geen abonnement, geen aanmelding
Prijs: Helemaal gratis, voor altijd. Open source.
Beste voor: Gebruikers met simpele, op tekst gebaseerde PDF’s met duidelijk omlijnde tabellen die een gratis, lokale oplossing willen.
Pluspunten: Gratis; lokaal; heel simpel voor basistabellen.
Minpunten: Geen OCR (gescande PDF’s vallen meteen af); zwak bij tabellen zonder randen; geen automatisering of API; geen cloudoptie; feitelijk niet meer actief onderhouden.
3. Parseur
 Parseur is de sterkste hybride binnen de SaaS-groep, omdat het AI-parsing, template parsing en dynamic OCR combineert. Daardoor is het flexibeler dan een pure zonale parser, maar nog steeds meer gestructureerd dan een volledig algemene AI scraper.
Belangrijkste functies:
- Ingebouwde OCR met ondersteuning voor 60+ talen (160+ experimenteel)
- Integraties met Zapier, Make, Power Automate, API, webhooks en Google Sheets
- Geschikt voor facturen, verzendmeldingen, orderbevestigingen en terugkerende documenttypes
Prijs: Gratis laag van ongeveer 20 pagina’s per maand. Het laagste betaalde self-serve-abonnement begint rond ~$39/maand. De genormaliseerde kosten bij het kleinste plan komen neer op ongeveer $390 per 1.000 pagina’s, al dalen de effectieve tarieven bij hogere volumes.
Beste voor: Teams die steeds dezelfde soort documenten ontvangen en automatisering willen zonder te coderen.
Pluspunten: Ingebouwde OCR; sterke automatiseringsstack; goed voor terugkerende layouts.
Minpunten: Elke nieuwe of verschuivende layout kan templatewerk of AI-fallback nodig hebben; complexe tabellen blijven lastiger.
4. Nanonets
 Nanonets lijkt meer op een intelligent document processing (IDP)-platform dan op een simpele PDF scraper — en dat is tegelijk de kracht én de complexiteit. Het bedrijf paste de prijzen aan op 31 januari 2025 en stapte over op prepaid usage credits in plaats van een simpel pagina-abonnement.
Belangrijkste functies:
- AI-gestuurde tabelextractie en veldherkenning
- Ingebouwde OCR met ondersteuning voor 40+ talen
- Workflow-automatisering met goedkeuringsstappen
- Brede enterprise-integratiestack
Prijs: Credits bij aanmelding. Gebruik-gebaseerde facturering. Op basis van publieke block pricing-documentatie ligt een grove schatting rond $300–$380 per 1.000 pagina’s voor een eenvoudige extraction workflow.
Beste voor: Midden- tot grote teams die maandelijks duizenden documenten verwerken (AP-automatisering, logistiek, verzekeringsclaims).
Pluspunten: Sterke AI-extractie; enterprise-integraties; workflowautomatisering.
Minpunten: Prijs is lastiger te voorspellen; leercurve voor geavanceerde workflows; beperkte gratis versie.
5. Adobe Acrobat
 Adobe Acrobat is de standaard PDF-tool die bijna iedereen kent. Hij is sterk in OCR en conversie, maar is eigenlijk niet echt een scraper in dezelfde zin als de rest van deze lijst.
Belangrijkste functies:
- Ingebouwde OCR in Pro
- Export naar Word, Excel, PowerPoint, HTML, TXT en afbeeldingsformaten
- Brede OCR-ondersteuning voor meerdere talen
Prijs: Acrobat Standard vanaf $14,99/maand; Acrobat Pro vanaf $19,99/maand. Reader is gratis, maar exportfuncties vereisen een betaald abonnement.
Beste voor: Gebruikers die af en toe een PDF naar Word of Excel willen omzetten en al een Adobe-abonnement hebben.
Pluspunten: Breed vertrouwd; ingebouwde OCR; veel gebruikers hebben het al.
Minpunten: Tabelextractie is basic bij complexe layouts; geen automatisering of API voor batchverwerking; niet ontworpen als “scraper”.
6. PyMuPDF
 PyMuPDF (ook bekend als “fitz”) blijft de snelste algemene Python-bibliotheek voor PDF-extractie in deze vergelijking. De huidige release is 1.27.2.2 van maart 2026, en benchmarks laten nog steeds zien dat het aanzienlijk sneller is dan veel andere Python PDF-bibliotheken.
Belangrijkste functies:
- Extreem snelle extractie van ruwe tekst
- Extractie van afbeeldingen en toegang tot metadata
- Optionele OCR via Tesseract (al merkt de documentatie op dat OCR ongeveer 1.000x trager is dan standaardextractie)
- Tabelherkenning via
find_tables()
Prijs: Helemaal gratis, open source.
Beste voor: Developers die pipelines bouwen en vooral werken met tekstzware, native PDF’s.
Pluspunten: Zeer snel; lichtgewicht; actieve community; sterke tekstextractie.
Minpunten: Geen ingebouwde OCR; tabelextractie vereist handmatige parserlogica; code nodig.
7. Camelot
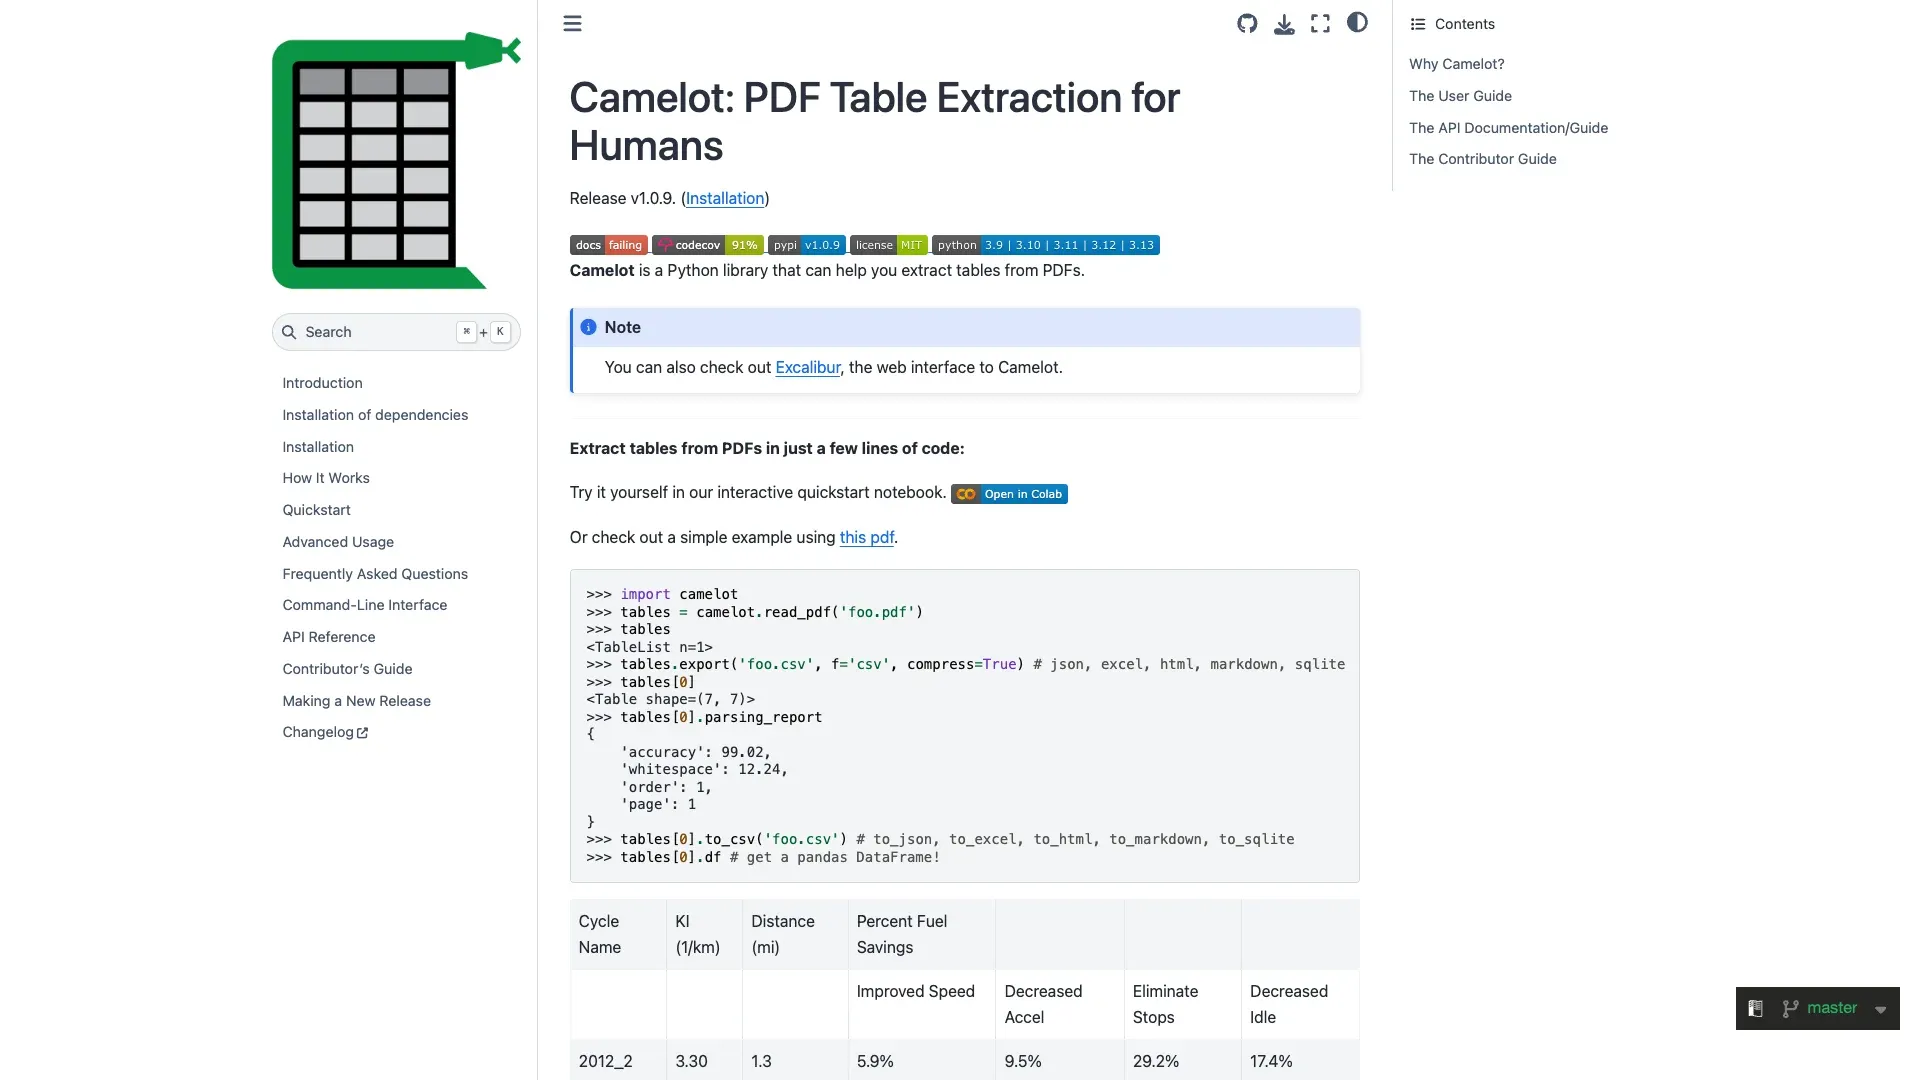 Camelot is nog steeds een van de bekendste Python-tools voor tabelextractie, juist omdat het table-first is in plaats van document-generalist. De huidige repo wordt onderhouden, met v1.0.9 uitgebracht in augustus 2025.
Belangrijkste functies:
- Twee extractiemodi:
latticevoor tabellen met randen,streamvoor tabellen zonder randen/spatie-gebaseerde tabellen - Nauwkeurigheidsmetingen in het parsing report — een van Camelots nuttigste functies voor automatiseringsworkflows
- Output naar pandas DataFrames, CSV, JSON en Excel
Prijs: Helemaal gratis, open source.
Beste voor: Developers die nauwkeurige tabelextractie nodig hebben uit gestructureerde, tekstgebaseerde PDF’s.
Pluspunten: Uitstekende tabelnauwkeurigheid; twee extractiemodi; nauwkeurigheidsscores.
Minpunten: Geen OCR; alleen tekst-PDF’s; code nodig; kan traag zijn bij grote documenten.
8. Docparser
 Docparser is de meest duidelijk regelgestuurde SaaS-tool in deze selectie. Het gebruikt zonale OCR, ankerwoorden en parsingregels voor vaste layouts in plaats van te proberen zich te gedragen als een algemene AI-lezer van layouts.
Belangrijkste functies:
- Ingebouwde OCR
- Integraties met Zapier, Workato, Power Automate, Google Sheets, Salesforce en REST API
- Geschikt om geëxtraheerde data door te sturen naar zakelijke workflows
Prijs: Starter vanaf $39/maand; Professional vanaf $74/maand; Business vanaf $159/maand. 14 dagen gratis proefperiode. Facturatie per document, dus de genormaliseerde kosten per 1.000 pagina’s hangen af van de documentlengte — grofweg $78–$390 in de starterlaag.
Beste voor: Teams die terugkerende documentworkflows willen automatiseren met strakke integratie in tools als Zapier of Salesforce.
Pluspunten: Ingebouwde OCR; sterke workflow-integraties; goed voor stabiele layouts.
Minpunten: Template-gebaseerd — elke nieuwe layout vraagt setup; tabelextractie hangt af van zonedefinities; het sterkst op pagina 1.
9. pdfplumber
 pdfplumber blijft de meest gedetailleerde developer-bibliotheek in deze selectie. De huidige release is 0.11.9 van januari 2026, en de repo geeft aan dat het actief wordt ontwikkeld.
Belangrijkste functies:
- Fijnmazige controle over karakters, lijnen, rechthoeken en strategieën voor tabelherkenning
- Filtering op basis van crop-regio’s en visuele debugging
- Output als Python-lijsten/dicts voor eenvoudige bewerking
Prijs: Helemaal gratis, open source.
Beste voor: Python-developers die gedetailleerde, aanpasbare logica voor tabelextractie nodig hebben.
Pluspunten: Uitstekende low-level controle; goede nauwkeurigheid bij complexe tabellen; actieve ontwikkeling.
Minpunten: Geen OCR; steilere leercurve dan Camelot; code nodig.
10. AWS Textract
 AWS Textract is de meest enterprise-native API in deze lijst. Hij is gebouwd voor schaal, documentdiversiteit en programmatisch gebruik, niet voor GUI-gemak.
Belangrijkste functies:
- AI-gestuurde extractie van tabellen en formulieren
- Ingebouwde OCR met ondersteuning voor handschrift (het dichtst in de buurt in deze lijst, maar nog steeds niet perfect)
- Schaalbaarheid op enterprise-niveau
- Nette integratie met het AWS-ecosysteem
Prijs: Prijzen per pagina. Gratis laag: 1.000 pagina’s/maand gedurende 3 maanden. Daarna: alleen tekst-OCR voor $1,50 per 1.000 pagina’s; tabellen voor $15 per 1.000 pagina’s; formulieren + tabellen voor $65 per 1.000 pagina’s; expense documents voor $10 per 1.000 pagina’s.
Beste voor: Enterprise-teams die 10.000+ documenten per maand verwerken via een API-pipeline.
Pluspunten: Nauwkeurige extractie van formulieren en tabellen; ingebouwde OCR; schaalbaarheid voor enterprise.
Minpunten: Alleen API; geen visuele interface; kosten lopen snel op bij geavanceerde modi; lock-in binnen het AWS-ecosysteem.
11. Docling
 Docling is hier de meest toekomstgerichte open-source tool, omdat hij rechtstreeks gericht is op document-to-LLM-pipelines. De huidige release is 2.90.0 van 17 april 2026, en het project ontwikkelt zich snel.
Belangrijkste functies:
- Output naar Markdown, HTML, WebVTT, DocTags en lossless JSON
- OCR-ondersteuning via meerdere geïntegreerde engines
- Gebouwd voor LangChain, LlamaIndex, CrewAI, Haystack en vergelijkbare ecosystemen
- Sterke groei van de community
Prijs: Helemaal gratis, open source.
Beste voor: Developers die LLM/RAG-applicaties bouwen en PDF’s willen omzetten naar gestructureerde, AI-ready Markdown.
Pluspunten: Schone Markdown-output; OCR via integratie; gemaakt voor moderne AI-workflows; actieve ontwikkeling.
Minpunten: Code vereist; vooral gericht op developers; minder gepolijste GUI of exportopties dan SaaS-tools.
12. Parsio
 Parsio is een hybride SaaS-parser die templates, OCR, AI-parsing en GPT-gestuurde parsing combineert. Qua insteek zit het tussen Parseur en Docparser in: flexibeler dan pure zones, maar nog steeds geoptimaliseerd voor terugkerende documentinvoer.
Belangrijkste functies:
- Ingebouwde OCR
- AI-ondersteunde veldherkenning
- Integraties met Google Sheets, webhooks, API, Zapier, Make, n8n en Pabbly
Prijs: Sandbox met 30 credits. Starter vanaf $41/maand voor 1.000 credits; Growth vanaf $124/maand; Business vanaf $249/maand. Eén geparset document of PDF-pagina kan 1, 2 of 5 credits kosten, afhankelijk van de parsermodus, dus de genormaliseerde schatting op het starterplan ligt ongeveer tussen $41 en $205 per 1.000 pagina’s.
Beste voor: Kleine tot middelgrote teams die terugkerende documenttypes verwerken (facturen, bonnetjes) en een no-code SaaS-oplossing met lichte AI willen.
Pluspunten: Ingebouwde OCR; brede dekking voor documenttypes; brede automatiseringsstack.
Minpunten: Beperkte diepgang in third-party reviews; prijzen worden minder transparant over verschillende parsermodi; niet zo duidelijk onderscheidend als Parseur of Nanonets.
Tabelextractie onder de loep: hoe de beste PDF scrapers omgaan met tabellen uit de praktijk
Tabelextractie is veruit het meest besproken pijnpunt onder gebruikers van PDF scrapers — en terecht. Recente benchmarks zoals OmniDocBench (1.651 pagina’s over 10 documenttypes) en academisch werk over heterogene tabelextractie bevestigen dat “tabelextractie” geen éénvormige taak is. Het is een spectrum.
Simpele tabellen (duidelijke randen, één pagina)
De meeste tools kunnen dit prima aan. Tabula, Camelot, pdfplumber, Thunderbit en AWS Textract presteren hier allemaal goed. Als je PDF’s alleen simpele tabellen met randen bevatten, werkt bijna elke tool op deze lijst.
Tabellen zonder randen en spatie-gebaseerde tabellen
Hier wordt het verschil duidelijk. Zonder lijnen hebben regelgebaseerde parsers moeite om kolomgrenzen te herkennen. De stream-modus van Camelot en de fijn afgestemde parameters van pdfplumber zijn sterk voor developers die instellingen kunnen tweaken. AI-tools zoals Thunderbit, Nanonets en AWS Textract interpreteren de layout visueel, wat doorgaans beter werkt voor niet-technische gebruikers die met inconsistente formaten werken.
Meerpagina-tabellen
Een veelvoorkomend faalscenario. Template-tools en eenvoudige extractors behandelen elke pagina vaak als een aparte tabel, tenzij de workflow ze expliciet weer aan elkaar koppelt. AI-first tools hebben hier een voorsprong, omdat ze continuïteit semantisch kunnen interpreteren in plaats van alleen geometrisch — al moet je geen enkele vendor als perfect zien op dit vlak.
Samengevoegde cellen en geneste koppen
Het lastigste scenario. Het EMNLP-paper uit 2024 over heterogene tabelinformatie-extractie rapporteert F1-bereiken van 74,2 tot 96,1, afhankelijk van methode en scenario. AI-gestuurde tools (Thunderbit, Nanonets, AWS Textract) presteren hier meestal beter dan regelgebaseerde parsers, omdat ze de layout semantisch interpreteren in plaats van alleen op lijnen te vertrouwen.
OCR vergeleken: welke PDF scrapers kunnen gescande documenten aan?
OCR is de scheidslijn tussen tools die echte zakelijke PDF’s aankunnen en tools die alleen ideale, machine-generated documenten verwerken. Hier is de matrix:
| Tool | Native OCR | Ondersteuning voor gescande PDF's | OCR voor meerdere talen | Ondersteuning voor handschrift |
|---|---|---|---|---|
| Thunderbit | ✅ Ingebouwd | ✅ Ja | ✅ 34 talen | ⚠️ Beperkt |
| Adobe Acrobat | ✅ Ingebouwd | ✅ Ja | ✅ Sterk | ⚠️ Beperkt |
| AWS Textract | ✅ Ingebouwd | ✅ Ja | ✅ Meerdere grote talen | ✅ Het dichtst erbij, maar niet perfect |
| Nanonets | ✅ Ingebouwd | ✅ Ja | ✅ 40+ talen | ⚠️ Beperkt |
| Parseur | ✅ Ingebouwd | ✅ Ja | ✅ 60+ talen | ❌ Nee |
| Parsio | ✅ Ingebouwd | ✅ Ja | ✅ Meertalig | ⚠️ Beperkt |
| Docparser | ✅ Ingebouwd | ✅ Ja | ✅ Ja | ⚠️ Beperkt |
| Docling | ✅ Via integratie | ✅ Ja | Hangt af van de engine | ⚠️ Beperkt |
| Tabula | ❌ Geen | ❌ Nee | N.v.t. | N.v.t. |
| PyMuPDF | ❌ Nee (Tesseract optioneel) | ❌ Externe add-on vereist | Hangt af van de engine | Hangt af van de engine |
| Camelot | ❌ Geen | ❌ Nee | N.v.t. | N.v.t. |
| pdfplumber | ❌ Geen | ❌ Nee | N.v.t. | N.v.t. |
Geen enkele tool kan handschrift in alle gevallen betrouwbaar aan in 2026. AWS Textract komt het dichtst in de buurt als enterprise API, maar handschrift blijft een functie die je met voorzichtigheid moet gebruiken. Zijn je PDF’s gescand maar getypt? Dan volstaat elke tool met ingebouwde OCR. Zijn ze handgeschreven? Stel dan realistische verwachtingen.
AI-gestuurd versus regelgebaseerd versus template-gebaseerd: drie generaties PDF scraping
De eenvoudigste manier om de PDF scraper-markt in 2026 te begrijpen, is door hem in drie generaties te verdelen:
Generatie 1: Regelgebaseerd (Tabula, Camelot, pdfplumber)
Deze werken het best op gestructureerde, tekstgebaseerde PDF’s met consistente layouts. Ze zijn krachtig in handen van developers, maar fragiel zodra layouts variëren. Als je documenten voorspelbaar zijn, blijven ze uitstekend — en gratis.
Generatie 2: Template-gebaseerd (Parseur, Docparser, Parsio)
Gebruikers definiëren zones of velden per documenttype. Ideaal voor terugkerende formats zoals facturen van dezelfde leverancier. Het nadeel: elke nieuwe layout of layout drift vereist setup of onderhoud.
Generatie 3: AI/LLM-gestuurd (Thunderbit, Nanonets, AWS Textract, Docling voor LLM-pipelines)
AI leest het document semantisch, past zich aan nieuwe layouts aan zonder templates en kan data tegelijk labelen en transformeren. Dat is de richting waar de markt naartoe beweegt. Zowel de 2025 IDP-beoordeling van Everest Group als ACL 2025 onderzoek naar multimodale tabellen wijst op LLM- en agent-gebaseerde extractie als de volgende standaard.
Voor niet-technische gebruikers is dit praktisch belangrijk: als je PDF’s uit veel verschillende bronnen komen (leveranciers, partners, klanten), worden template-tools een onderhoudslast. AI-gestuurde tools gaan direct om met variatie. Dat is precies de niche waarvoor Thunderbit is gebouwd—zakelijke gebruikers met uiteenlopende PDF’s en nul interesse in Python of onderhoud van extractietemplates.
AI PDF-extractie voor wisselende layouts Eén schema hoeft niet voor elke leverancier te werken — de AI leest elk document en bepaalt zelf de structuur. Get Started Free
Prijsvergelijking: wat kosten de beste PDF scrapers nu echt?
Dit is de vergelijking die niemand anders publiceert, en precies de vraag die gebruikers het vaakst stellen. Hier is het eerlijke plaatje:
| Tool | Gratis versie | Startprijs betaald | Geschatte kosten per 1.000 pagina's | Open source? |
|---|---|---|---|---|
| Thunderbit | ✅ Gratis credits | ~$15/maand ($9/maand jaarlijks) | ~$18–$30 | Nee |
| Tabula | ✅ Onbeperkt | Gratis voor altijd | $0 | Ja |
| Camelot | ✅ Onbeperkt | Gratis voor altijd | $0 | Ja |
| PyMuPDF | ✅ Onbeperkt | Gratis voor altijd | $0 | Ja |
| pdfplumber | ✅ Onbeperkt | Gratis voor altijd | $0 | Ja |
| Docling | ✅ Onbeperkt | Gratis voor altijd | $0 | Ja |
| Parseur | ⚠️ ~20 pagina's/maand | ~$39/maand | ~$390 (laagste tier) | Nee |
| Nanonets | ⚠️ Credits bij aanmelding | Gebruik-gebaseerd | ~$300–$380 | Nee |
| Docparser | ⚠️ 14-daagse proefversie | $39/maand | ~$78–$390 | Nee |
| Parsio | ⚠️ 30 credits | $41/maand | ~$41–$205 | Nee |
| Adobe Acrobat | ❌ (export is betaald) | $19,99/maand Pro | Niet per pagina afgerekend | Nee |
| AWS Textract | ⚠️ 1.000 pagina's/maand (3 maanden) | Pay-per-use | $1,50–$65 | Nee |
De verborgen kosten zijn belangrijker dan de stickerprijs. Open-source Python-tools zijn gratis in dollars, maar kosten ontwikkeltijd om in te stellen, te onderhouden en te debuggen. Template-SaaS-tools zijn eenvoudig bij lage variatie, maar duur zodra layouts verschuiven. AI no-code tools zoals Thunderbit kosten credits per rij, maar verminderen de setup-tijd enorm. Cloud API’s zoals AWS Textract zijn het goedkoopst op schaal — maar alleen als je al engineering-capaciteit hebt.
Als ik aan de “echte kosten” denk, tel ik ook het salaris mee van degene die het werk doet. Een uur van een data-analist die templates instelt of Python schrijft is niet gratis, zelfs als de software dat wel is.
Welke PDF scraper moet je kiezen?
Hier is een korte beslisgids:
| Jouw situatie | Aanbevolen tool(s) |
|---|---|
| Niet-technisch, wisselende PDF-layouts, snel resultaat nodig | Thunderbit, Nanonets |
| Terugkerende facturen/bonnen met hetzelfde formaat | Parseur, Docparser, Parsio |
| Developer die een datapipeline bouwt | PyMuPDF, Camelot, pdfplumber |
| Enterprise, 10.000+ documenten/maand, API nodig | AWS Textract, Nanonets |
| LLM/RAG-applicatie bouwen | Docling |
| Af en toe PDF naar Excel, al Adobe in gebruik | Adobe Acrobat |
| Gratis, lokaal, tabelgericht, zonder code | Tabula |
Ben je een zakelijke gebruiker die gewoon data uit PDF’s wil halen zonder code te schrijven of templates op te zetten, begin dan met Thunderbit. Het leest elke PDF opnieuw met AI en exporteert naar de tools die je al gebruikt. Als je documenten zich herhalen in herkenbare layouts, zijn Parseur of Docparser betere opties. En als je volledige engineeringcontrole wilt, blijft de open-source stack de ondergrens qua kosten.
Tot slot
PDF scraping is in 2026 niet langer één probleem met één oplossing. De juiste tool hangt af van of je een developer, business analyst of enterprise-team bent — en of je PDF’s nette tekstbestanden zijn of chaotische gescande afbeeldingen van tientallen leveranciers.
Wil je zien hoe AI-gestuurde PDF-extractie er in de praktijk uitziet, probeer dan de gratis versie van Thunderbit. Ik denk dat je verbaasd zult zijn hoeveel je met een paar klikken uit een PDF kunt halen. En als Thunderbit niet perfect past, probeer dan een paar andere tools uit deze lijst. Er is nog nooit een beter moment geweest om te stoppen met kopiëren en plakken uit PDF’s en daadwerkelijk gebruik te maken van de data erin.
Voor meer over data-extractie en automatisering kun je onze gidsen bekijken over data uit websites naar Excel halen, de beste data-extractietools, AI data-extractie voor bedrijven en hoe je afbeeldingen naar Excel omzet. Je kunt ook stap-voor-stap uitlegvideo’s bekijken op het Thunderbit YouTube-kanaal.
Probeer Thunderbit gratis Tabellen, OCR en gemengde rapporten in één keer verwerken. Het gratis plan is genoeg om te testen of het met jouw documenten werkt. Get Started Free
Veelgestelde vragen
1. Wat is de beste gratis PDF scraper?
Voor niet-developers is Tabula de eenvoudigste volledig gratis GUI-tool voor tekstgebaseerde PDF-tabellen. Voor developers zijn Camelot, pdfplumber, PyMuPDF en Docling allemaal sterke gratis opties. Voor een no-code optie met gratis versie is Thunderbit het beste startpunt.
2. Kunnen PDF scrapers gescande documenten verwerken?
Alleen tools met ingebouwde OCR kunnen gescande PDF’s direct aan. Daaronder vallen Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio en Docling (met geïntegreerde OCR-engines). Tabula, Camelot en pdfplumber kunnen gescande PDF’s niet zelfstandig verwerken — die hebben externe OCR zoals Tesseract nodig.
3. Hoe nauwkeurig is tabelextractie uit PDF’s?
Dat hangt sterk af van de complexiteit van de tabel. De meeste tools doen simpele tabellen met randen goed. Tabellen zonder randen, samengevoegde cellen en meerpagina-tabellen zijn veel lastiger. AI-gestuurde tools zoals Thunderbit, Nanonets en AWS Textract presteren meestal beter dan regelgebaseerde parsers bij wisselende layouts, terwijl regelgebaseerde tools nog steeds uitstekend kunnen zijn bij stabiele, tekstgebaseerde PDF’s.
4. Heb ik programmeerkennis nodig om PDF’s te scrapen?
Nee. Tools zoals Thunderbit, Parseur, Docparser, Parsio, Nanonets en Adobe Acrobat zijn zonder code te gebruiken. Tabula heeft ook een GUI. Python-bibliotheken zoals PyMuPDF, Camelot, pdfplumber en Docling vereisen code.
5. Kan ik PDF-data direct exporteren naar Excel of Google Sheets?
De meeste tools ondersteunen in elk geval export naar CSV of Excel. Thunderbit exporteert ook direct naar Google Sheets, Airtable en Notion zonder kosten. Parseur, Docparser en Parsio ondersteunen exports naar bedrijfsworkflows via integraties zoals Zapier, webhooks en API’s.
Probeer AI PDF-extractie met Thunderbit Get Started Free
Meer weten



