위키피디아 인포박스, 인용문, 섹션용 스크래퍼










Wikipedia 문서를 연구용으로 정리하기
문서 사실 정보, 인포박스 값, 인용문, 섹션 맥락을 각기 다른 필드로 나눠 관리하세요.
한 번의 클릭으로 Wikipedia 데이터 추출
열어둔 페이지에 맞는 컬럼을 제안하고, 한 번의 실행으로 수집을 마칩니다. 원하면 자연어로 필드를 수정하거나 이름을 바꾼 뒤 다시 실행할 수 있습니다.
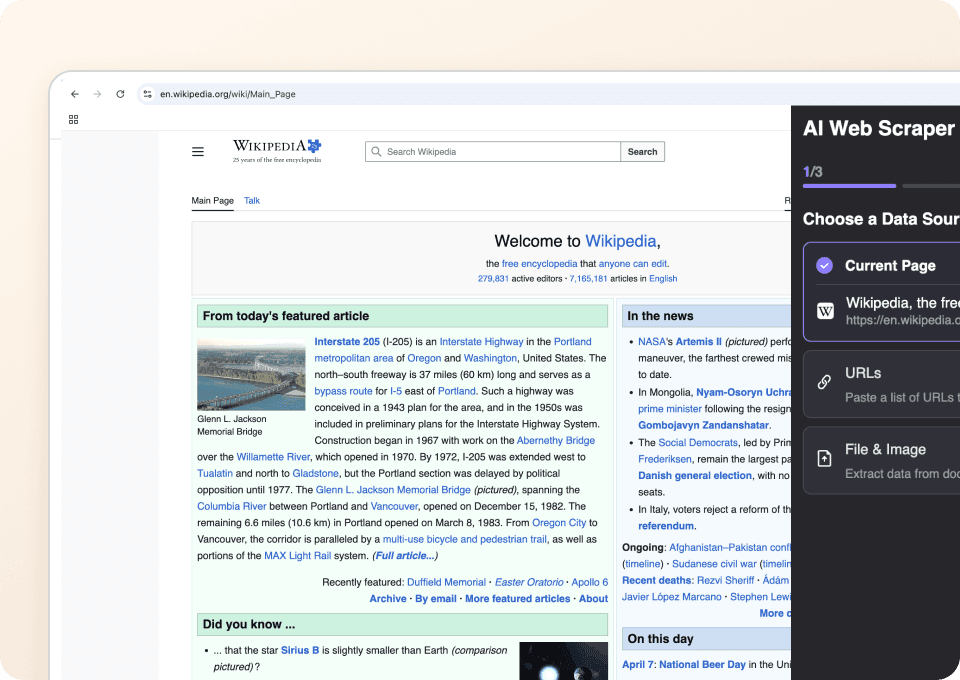
다양한 Wikipedia 페이지 유형에서 활용
에이전트는 보이는 레이블, 헤더, 섹션 제목을 읽어 접근 가능한 페이지의 값을 매핑합니다. 필드가 없으면 해당 컬럼은 비어 있게 유지됩니다.
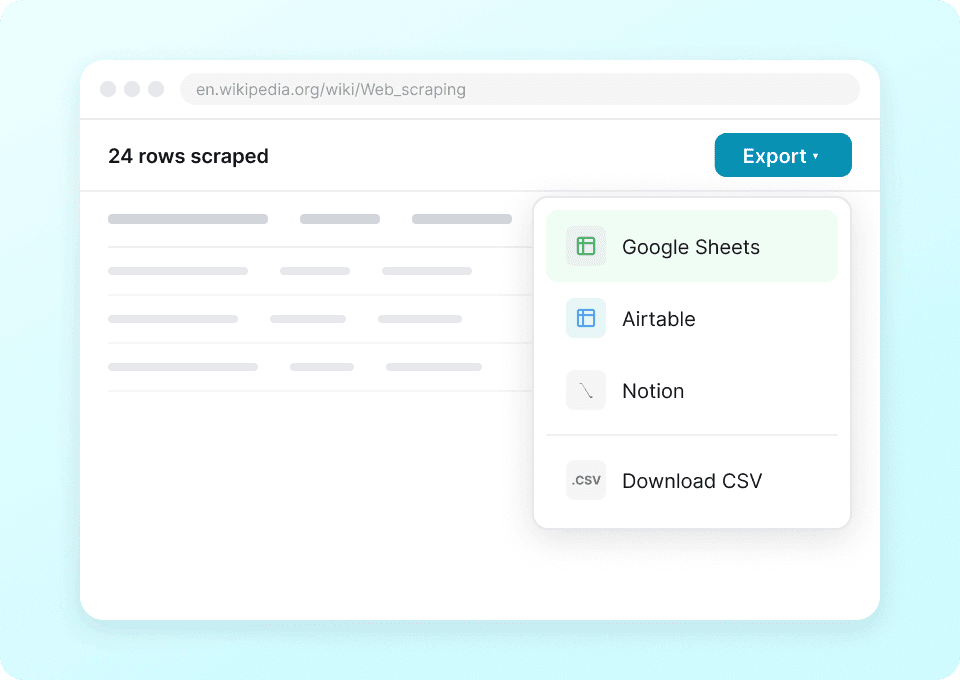
Wikipedia 데이터를 바로 내보내기
Google Sheets, Excel, Airtable, Notion 또는 다운로드한 CSV로 연구를 계속할 수 있습니다.
스크래퍼를 직접 만들지 않고 Wikipedia 연구 데이터 수집하기
Wikipedia 연구를 위한 셀렉터 유지보수를 줄이세요.
수동 또는 셀렉터 기반 설정
규칙을 유지보수하는 데 드는 시간Thunderbit AI 에이전트
필드 추천과 단일 실행문서 사실 정보, 인포박스, 인용문, 섹션용 컬럼
접근 가능한 페이지에 표시될 때에만 컬럼이 나타납니다.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.
Wikipedia 조사 작업에 관한 질문
Wikipedia에서 Agent Mode를 사용할 때 자주 묻는 질문에 대한 간단한 답변입니다.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Flixster 스크래퍼
Thunderbit Flixster 스크래퍼를 사용하면 Flixster의 박스오피스 순위와 인근 극장 정보를 손쉽게 수집할 수 있습니다. AI 기반 필드 추천 기능으로 영화 제목, 박스오피스 수익, 평점, 개봉일, 극장명, 위치, 상영작 등 다양한 데이터를 빠르게 모아 분석이나 리서치에 활용해보세요.
자세히 보기 ->
olympustaff.com 스크래퍼
Thunderbit olympustaff.com 웹 스크래퍼를 사용하면 olympustaff.com의 만화 목록과 댓글 데이터를 손쉽게 추출할 수 있습니다. AI 기반 필드 추천 기능으로 만화 제목, 작가, 발매일, 독자 피드백 등 필요한 정보를 빠르게 수집해 분석이나 연구에 활용할 수 있습니다. 마케터, 연구자, 콘텐츠 제작자 등 olympustaff.com에서 구조화된 데이터를 원하는 분들에게 최적의 도구입니다.
자세히 보기 ->
Hatena 스크래퍼
Thunderbit Hatena 웹 스크래퍼는 AI 기반 필드 추천 기능으로 Hatena 블로그와 주제 목록에서 데이터를 손쉽게 추출할 수 있도록 도와줍니다. 블로그 제목, 작성자명, 발행일, 요약 내용, 인기 주제 등 다양한 정보를 수집해 연구, 마케팅, 콘텐츠 분석에 활용할 수 있습니다. 체계적인 Hatena 데이터를 원하는 마케터, 연구자, 콘텐츠 제작자에게 최적의 도구입니다.
자세히 보기 ->
namu.wiki 스크래퍼
Thunderbit namu.wiki 웹 스크래퍼를 사용하면 namu.wiki에서 필요한 문서와 최근 토론 데이터를 손쉽게 추출할 수 있습니다. AI 기반 필드 추천 기능으로 페이지 제목, URL, 마지막 수정일, 토론 주제, 참여자 이름 등 다양한 정보를 빠르게 수집하여 연구, 콘텐츠 제작, 커뮤니티 분석 등에 활용해보세요.
자세히 보기 ->
네이버 뮤직 스크래퍼
Thunderbit NetEase Music 웹 스크래퍼를 사용하면 NetEase Music의 검색 결과와 아티스트 작품 페이지에서 데이터를 손쉽게 추출할 수 있습니다. AI 기반 필드 추천 기능으로 곡명, 아티스트명, 앨범 정보, 재생 시간, 곡 URL 등 필요한 정보를 빠르게 수집할 수 있어 분석이나 리서치에 유용합니다. 음악 데이터 분석가, 마케터, 음악 팬 등 NetEase Music의 체계적인 데이터를 원하는 분들에게 적합한 도구입니다.
자세히 보기 ->
QQ 뮤직 스크래퍼
Thunderbit QQ Music 웹 스크래퍼를 사용하면 QQ Music 검색 결과와 가수의 작품 목록에서 데이터를 손쉽게 추출할 수 있습니다. AI 기반 필드 추천 기능으로 곡명, 아티스트명, 앨범 정보, 발매일 등 다양한 데이터를 빠르게 수집하여 분석이나 리서치에 활용할 수 있습니다. 음악 데이터 분석가, 마케터, 음악 팬 등 QQ Music의 체계적인 데이터가 필요한 분들에게 최적의 도구입니다.
자세히 보기 ->데이터 추출 속도를 확 끌어올릴 준비가 되셨나요?
이미 20만 명 이상의 전문가가 Thunderbit로 웹 스크래핑 워크플로를 자동화하고 있습니다.
무료 체험에서는 8개 웹페이지에 대해 무제한 크레딧을 제공합니다.


