
세상은 그 어느 때보다 더 많은 데이터를 원하고 있고, 2026년에는 Node.js가 더 똑똑하고 더 효율적으로 스크래핑하려는 팀들의 중심에 서 있습니다. 영업, 이커머스, 혹은 저처럼 데이터 덕후라면, 이제 스크래핑이 단순히 “데이터를 가져오는 일”이 아니라는 걸 이미 느끼셨을 겁니다. 얼마나 빠르게, 얼마나 크게, 그리고 IP가 디지털 감옥에 들어가지 않게 하느냐가 핵심이죠. 수요도 여전히 식지 않고 있습니다. 공개 웹 데이터는 조용히 현대 팀들이 만드는 거의 모든 시스템의 입력값이 되었고, 가격 인텔리전스부터 LLM 학습 파이프라인까지 활용 범위는 계속 넓어지고 있습니다. 경쟁도, 이해관계도 그 어느 때보다 치열합니다.
하지만 문제는 여기서 끝나지 않습니다. 요즘 웹은 동적 콘텐츠, 봇 차단 장치, 계속 바뀌는 레이아웃까지 갖춘 일종의 요새 같습니다. 저도 셀 수 없을 만큼 많은 스크래퍼가 무너지는 걸 봤는데, 대부분은 베스트 프랙티스를 무시했거나 안티 스크래핑 방어가 얼마나 영리해졌는지를 너무 얕봤기 때문이었습니다. 그래서 이번 글에서는 실제 현장에서 통하는 Node.js 웹 스크래핑 효율화 베스트 프랙티스를, 경험담과 약간의 유머, 그리고 바로 써먹을 수 있는 팁까지 묶어서 정리해보겠습니다.
웹 스크래핑 효율에 Node.js를 선택해야 하는 이유
수백 개, 많게는 수천 개의 페이지를 한꺼번에 스크래핑해본 적이 있다면, 속도와 동시성이 전부라는 걸 잘 아실 겁니다. 바로 그 지점에서 Node.js가 진가를 발휘합니다. 비동기 논블로킹 I/O 모델 덕분에 엄청난 수의 동시 네트워크 요청을 처리하는 데 최적화되어 있죠. 웹을 위한 궁극의 멀티태스커라고 보면 됩니다(Node.js Docs). 다른 언어들이 각 요청이 끝나길 기다리느라 묶여 있을 때, Node.js는 이벤트 루프를 계속 돌리면서 요청들을 마치 카페인 충전된 서커스 단원처럼 동시에 처리합니다.
특히 대상 사이트가 JavaScript로 무겁게 짜여 있을 때, 실시간 업데이트와 대규모 추출이 필요한 상황에서 Node.js가 Python이나 Java보다 더 좋은 성능을 보이는 경우를 많이 봤습니다. 실제로 개발자의 약 40%가 백엔드와 자동화 작업에 Node.js를 사용하고 있으며, 이는 Node.js가 전 세계에서 가장 널리 쓰이는 웹 기술 중 하나라는 점을 보여줍니다.
Node.js와 다른 웹 스크래핑 프레임워크 비교
잠깐 기술 덕후 모드로 들어가 보겠습니다. Node.js가 경쟁 도구들과 비교했을 때 어떤 위치에 있는지 보면:
| 프레임워크 | 강점 | 약점 | 주요 활용 사례 |
|---|---|---|---|
| Node.js | 비동기 처리, 뛰어난 동시성, 방대한 npm 생태계, 동적 사이트에 강한 네이티브 JS | 메모리를 많이 쓸 수 있음, async/await 없이 쓰면 콜백 지옥이 생길 수 있음 | 실시간 스크래핑, JavaScript 중심 사이트, 확장 가능한 마이크로서비스 |
| Python | 스크래핑 라이브러리 풍부(BeautifulSoup, Scrapy), 쉬운 문법 | 대규모 동시 처리에서 느릴 수 있음, JS 렌더링 사이트에 약함 | 정적 HTML, 리서치, 프로토타이핑 |
| Java | 강한 타입, 엔터프라이즈 환경에 강함 | 코드가 길고 장황함, 빠른 스크립트 작성에는 덜 유연함 | 대규모 엔터프라이즈 스크래핑 |
| Go | 빠르고 효율적인 동시성 | 생태계가 작고 학습 곡선이 더 높음 | 고성능, 저지연 스크래핑 |
대부분의 비즈니스 사용자에게 Node.js는 속도, 유연성, 그리고 JavaScript 기반 현대 웹에 맞춘 균형이 가장 좋습니다(Thunderbit Blog).
탄탄한 Node.js 웹 스크래핑 환경 구축하기
좋은 스크래퍼는 단단한 기반에서 시작됩니다. 제가 추천하는 기본 구성은 다음과 같습니다.
- 프로젝트 구조: 모듈형으로 나누세요.
/src,/libs,/config같은 폴더를 쓰고, API 키나 프록시 같은 민감 정보는dotenv로 환경 변수에 보관하세요(Thunderbit Guide). - HTTP 클라이언트: 요청에는 axios, got, 또는 node-fetch를 사용하세요.
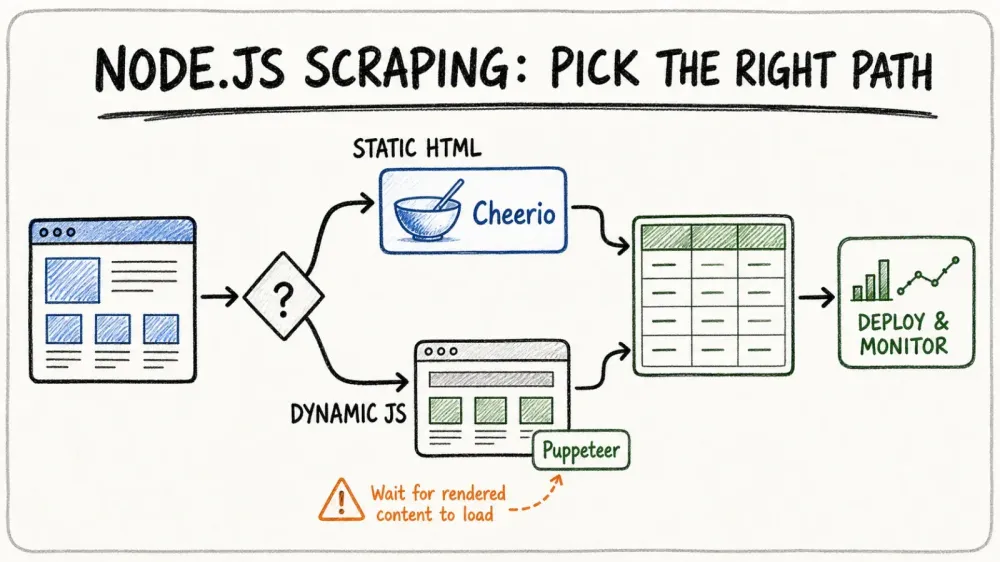
- HTML 파싱: 정적 HTML에는 Cheerio, 동적 콘텐츠에는 Puppeteer 또는 Playwright를 쓰세요.
- 유틸리티: 데이터 가공에는 Lodash, 데이터 검증에는 validator.js 또는 Joi를 활용하세요.
- 테스트 & 린팅: 테스트는 Mocha, 코드 품질 관리는 ESLint를 쓰면 좋습니다(LogRocket).
꼭 알아야 할 Node.js 웹 스크래핑 라이브러리
- HTTP 클라이언트(axios / got / 내장
fetch): 요청을 보낼 때 사용합니다. 미리 짚고 넘어가자면, Node.js v18부터는 별도 설치 없이 네이티브fetch를 사용할 수 있고, Node.js v22에서는 안정화되었습니다. 최신 Node 버전으로 새 프로젝트를 시작한다면node-fetch패키지가 아예 필요 없을 수도 있습니다. 그냥fetch를 바로 호출하면 됩니다. 저는 인터셉터, 자동 JSON 처리, 그리고 Node와 브라우저 모두에서 익숙한 Promise API가 필요할 때는 여전히 axios를 선호하고, 재시도, 스트림, HTTP/2 지원이 기본으로 필요할 때는 got을 사용합니다. 스택에 맞는 걸 고르세요. 간단한 스크립트라면 네이티브fetch만으로도 충분합니다. - Cheerio: 빠르고 jQuery처럼 쓰기 쉬운 HTML 파서입니다. 정적 페이지에 특히 좋고, 약 0.5초 수준으로 파싱합니다(Oxylabs).
- Playwright / Puppeteer: 동적이고 JavaScript 의존도가 높은 사이트를 위한 헤드리스 브라우저 자동화 도구입니다. 페이지당 약 4초 정도로 느릴 수 있지만, 로딩 후에 콘텐츠가 만들어지는 사이트에는 꼭 필요합니다(Bright Data). 2026년에 새로 시작한다면 기본값은 Playwright입니다. Chromium / Firefox / WebKit을 기본 지원하고, 내장 트레이스 뷰어가 있으며, 원래 Puppeteer를 만들었던 팀이 지금은 Microsoft에서 Playwright를 이끌고 있습니다. Puppeteer도 여전히 Chrome 전용 작업에는 유효하지만, 최근 릴리즈 노트는 새 기능보다 Chrome 호환성 업데이트 쪽에 더 치우쳐 있는 편입니다.
- dotenv: 환경 변수를 관리할 때 사용합니다.
- csv-writer/jsonfile: 데이터를 내보낼 때 유용합니다.
흔한 Node.js 웹 스크래핑 함정 피하기
스크래퍼가 차단되거나, 에러로 멈추거나, 아니면 지저분한 데이터만 쏟아내는 경우를 너무 많이 봤습니다. 다음 사항들은 특히 조심하세요.
- robots.txt와 이용약관 무시: 스크래핑 전에 반드시 확인하세요. 이를 어기면 IP가 차단될 수 있고, 더 심하면 법적 문제가 생길 수도 있습니다(ScraperAPI).
- 서버 과부하: 요청을 무작정 쏘지 마세요. 랜덤 딜레이(1~3초)로 속도를 조절하고, 동시성 제한을 걸어 지나치게 공격적인 봇처럼 보이지 않게 해야 합니다(ScrapeGraphAI).
- 에러 처리 누락: 요청은 항상 try/catch로 감싸고, HTTP 오류를 처리하고, 실패 로그를 남기세요. 일시적인 오류는 지수 백오프로 재시도하는 것이 좋습니다(ScrapeGraphAI).
- 요청 헤더를 깜빡함: 현실적인 User-Agent 문자열을 쓰고 로테이션하세요. Accept-Language, Referer 등 실제 브라우저처럼 보이게 하는 헤더도 함께 넣어야 합니다(ScrapeGraphAI).
안티 스크래핑 메커니즘 우회하는 방법
요즘 웹사이트는 봇 차단 기술로 꽉 무장되어 있습니다. 저는 다음 방법으로 디지털 지뢰밭을 피해갑니다.
- 프록시/IP 로테이션: 프록시 풀을 사용해 IP를 바꿔가며 차단을 피하세요(Medium).
- 헤더 무작위화: 요청마다 User-Agent, Accept-Language 같은 헤더를 바꾸세요.
- 헤드리스 브라우저 스텔스:
puppeteer-extra-plugin-stealth같은 플러그인으로 자동화 흔적을 가리세요. - 사람처럼 행동하기: 랜덤 딜레이, 마우스 움직임, 스크롤, 심지어 타이핑 실수까지 흉내 내세요(ZenRows).
Node.js 스크래퍼에서 사람 행동을 흉내 내는 법
이 부분이 가장 재미있으면서도 약간 이상한 영역입니다. 스크립트가 바로 클릭하고 바로 스크롤하지 않도록, 다음처럼 동작을 설계하세요.
- 작업 사이에 랜덤 대기(
await page.waitForTimeout(randomDelay)) - 마우스를 작은 간격으로 불규칙하게 이동(
page.mouse.move(x, y)) - 랜덤 지연과 가끔의 오타를 섞어 입력(
page.type(selector, text, {delay: random(100,200)})) - 아래로만 곧장 내리지 말고, 들쭉날쭉하게 스크롤
이런 테크닉은 보호 장치가 있는 사이트에서 성공률을 꽤 높여줍니다(ScraperAPI).
Thunderbit으로 복잡한 데이터 추출 단순화하기
AI로 어떤 웹사이트든 데이터 추출 복잡한 보일러플레이트는 건너뛰세요. Thunderbit의 에이전틱 웹 스크래퍼는 어떤 페이지든 읽고 한 번의 클릭으로 데이터를 추출합니다. Node.js 코드를 따로 유지보수할 필요가 없습니다. Get Started Free
이제 다들 아는 그 문제를 이야기해볼까요. 스크래핑은 어렵습니다. 하지만 꼭 그래야만 하는 건 아닙니다. 그래서 저희는 Thunderbit를 만들었습니다.
Thunderbit은 일반 영어로 웹사이트의 데이터를 추출할 수 있는 에이전틱 웹 스크래퍼 Chrome 확장 프로그램입니다. “One Click Extract”를 누르고, AI가 페이지 내용을 파악하게 한 뒤 “Scrape”를 클릭하면 됩니다. 마치 잠도 안 자고 연봉 인상도 요구하지 않는 주니어 개발자를 하나 둔 것과 같습니다.
더 좋은 점은, Thunderbit이 API도 제공한다는 것입니다. 즉, Node.js 워크플로우에 바로 연결할 수 있습니다. 수천 줄의 스크래핑 코드를 직접 짜는 대신, 동적 콘텐츠, 하위 페이지, 페이지네이션 같은 무거운 일은 Thunderbit에 맡기세요. 여러분은 구조화된 데이터(CSV, JSON, 또는 Google Sheets, Airtable, Notion으로 바로 전송)를 받아 업무를 계속하면 됩니다(Thunderbit Blog).
Thunderbit Chrome 확장 프로그램 무료로 체험하기 무료 Chrome 확장 프로그램을 설치하고 구조화된 데이터를 한 번에 추출해보세요. 또는 Node.js 앱에서 Thunderbit API를 호출할 수도 있습니다. Get Started Free
Thunderbit과 전통적인 Node.js 스크래핑 비교
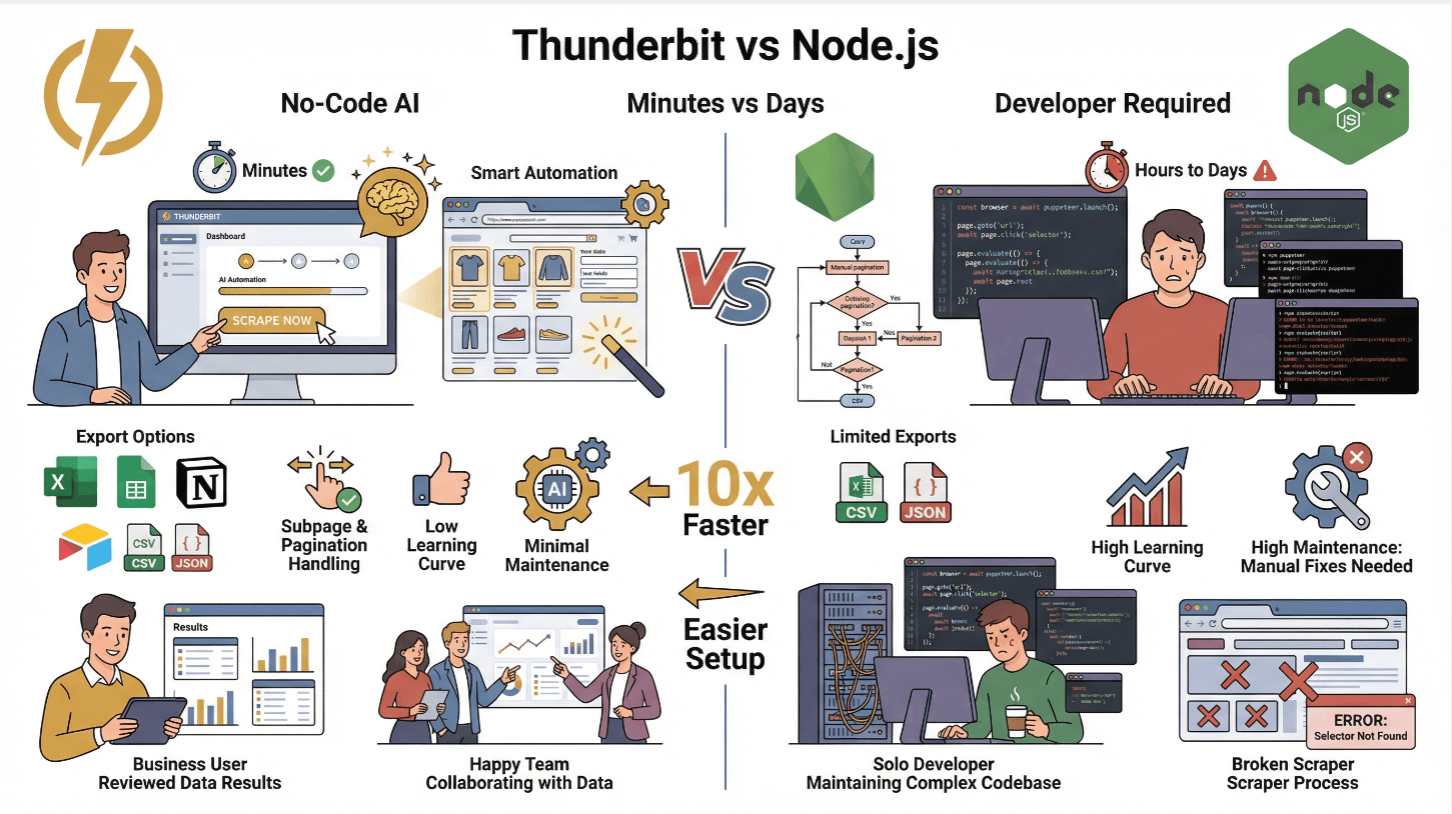
| 기능 | Thunderbit | 전통적인 Node.js 스크래퍼 |
|---|---|---|
| 설정 시간 | 몇 분(코드 불필요) | 몇 시간~며칠(개발, 테스트 필요) |
| 동적 콘텐츠 처리 | 예(AI + 브라우저) | 예(Puppeteer/Playwright 사용 시) |
| 하위 페이지 & 페이지네이션 | 원클릭 | 수동 코딩 필요 |
| 데이터 내보내기 | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON(커스텀 코드 필요) |
| 학습 난이도 | 낮음(비개발자도 가능) | 높음(개발자 대상) |
| 유지보수 | 최소(AI가 적응) | 높음(사이트 변경 시 수동 수정 필요) |
Thunderbit은 비기술 팀이나, 힘든 작업은 건너뛰고 인사이트에 집중하고 싶은 사람에게 딱 맞습니다. 고급 사용자라면 Thunderbit API를 활용해 대규모 스크래핑을 자동화할 수도 있습니다(Thunderbit Docs).
Cheerio와 Puppeteer를 결합해 동적 콘텐츠 처리하기
제가 가장 좋아하는 Node.js 스크래핑 조합입니다. 방식은 다음과 같습니다.
- Puppeteer로 페이지를 열고 JavaScript를 실행합니다(
networkidle까지 기다려 모든 콘텐츠가 로드됐는지 확인). await page.content()로 HTML을 가져옵니다.- Cheerio로 파싱: HTML을 Cheerio에 넣어 아주 빠른 jQuery 스타일 파싱과 데이터 추출을 수행합니다.
이 하이브리드 방식은 두 세계의 장점을 모두 가져옵니다. 동적 콘텐츠는 Puppeteer의 힘으로 처리하고, 파싱 속도는 Cheerio로 챙기는 방식입니다(Browserless).
성능 팁: 필요한 요소만 선택하세요. Cheerio는 전체 DOM을 메모리에 올리기 때문에 범위가 넓은 셀렉터는 피하고, 같은 페이지를 반복해서 스크래핑한다면 결과를 캐시하세요(Oxylabs).
HTML 파싱과 데이터 추출 최적화하기
- 구체적인 셀렉터를 사용:
$('body *')처럼 전부 잡지 말고, 필요한 요소만 정확히 지정하세요. - 큰 페이지는 스트리밍 처리: HTML이 아주 크다면 스트리밍이나 작업 분할을 고려하세요.
- 렌더링된 HTML 캐시: 같은 URL을 다시 방문한다면 HTML을 캐시해서 중복 요청을 줄이세요.
- 데이터 검증과 정제: 검증 라이브러리를 써서 데이터베이스에 쓰레기 데이터가 쌓이지 않도록 하세요(ScrapeGraphAI).
클라우드에서 확장 가능한 Node.js 웹 스크래퍼 배포하기
대규모 스크래핑을 하려면? 이제 클라우드 네이티브로 가야 할 때입니다.
- 스크래퍼를 Docker로 패키징:
Dockerfile을 작성하고, 코드를 복사하고, 의존성을 설치한 뒤 엔트리포인트를 설정하세요. - 클라우드에 배포: 단순한 작업이라면 AWS EC2, Google Cloud Compute, Azure VM을 사용하세요. 진짜 대규모라면 Kubernetes 또는 AWS ECS/EKS, Google Cloud Run, Azure Kubernetes Service 같은 관리형 서비스를 활용하세요(DigitalOcean).
- Kubernetes로 오케스트레이션: 여러 Pod를 실행하고, 수요에 따라 자동 확장하며, 로드 밸런서로 URL을 분산하세요.
- 작업 스케줄링: CloudWatch Events, Cloud Scheduler 같은 클라우드 스케줄러나 cron 작업으로 주기적인 스크래핑을 실행하세요.
실제 사례에서는 Kubernetes Pod를 5개에서 10개로 늘렸더니 400페이지 스크래핑 시간이 몇 분에서 1분도 안 되는 수준으로 줄었습니다(DigitalOcean).
스크래핑 인프라 모니터링과 자동 확장
- 로깅: 로그를 CloudWatch, Stackdriver, Datadog으로 스트리밍하세요. 오류나 지연이 생기면 알림을 설정하세요.
- 헬스 체크: Prometheus와 Grafana로 분당 스크래핑 페이지 수, 오류율, Pod 상태 같은 지표를 확인하세요.
- 오토스케일링: CPU 또는 요청 수를 기준으로 Pod를 확장하는 Kubernetes HPA(Horizontal Pod Autoscaler)를 설정하세요.
네트워크 문제나 일시적 차단에서 복구할 수 있도록 항상 지수 백오프 재시도를 구현하세요.
데이터 저장과 후처리 베스트 프랙티스
스크래핑한 뒤에는 저장하고 정리해야 합니다.
- 작은 작업: CSV, JSON으로 내보내거나 Google Sheets, Airtable, Notion으로 전송하세요(Thunderbit은 기본으로 지원합니다).
- 큰 작업: 구조화된 데이터에는 SQL(MySQL/PostgreSQL)을, 반정형이거나 스키마가 자주 바뀌는 데이터에는 NoSQL(MongoDB, DynamoDB)을 사용하세요(ScrapeHero).
- 클라우드 저장소: 원본 파일과 백업은 S3 또는 Google Cloud Storage에 보관하세요.
- 데이터 정제: 필드를 검증하고, 날짜와 숫자 형식을 통일하고, 중복 항목을 제거하세요. 데이터 품질을 강제하려면 스키마 검증기를 사용하세요(ScrapeGraphAI).
원본 데이터와 정제된 데이터를 모두 보관하세요. 나중에 다시 처리하거나 디버깅해야 할 일이 언제 생길지 모르니까요.
결론: Node.js 웹 스크래핑 효율을 위한 핵심 정리
스크래퍼 코드 작성은 이제 그만 Thunderbit의 에이전틱 웹 스크래퍼가 직접 스크래핑 스크립트를 작성하고 유지보수하는 방식과 어떻게 다른지 확인해보세요. Get Started Free
핵심만 다시 정리해보겠습니다.
- Node.js의 비동기 성능을 적극 활용하세요. 특히 JavaScript 중심 사이트에서 대규모 동시 스크래핑에 아주 강합니다.
- 적절한 도구를 조합하세요. 요청에는 axios/got, 정적 HTML에는 Cheerio, 동적 콘텐츠에는 Puppeteer를 쓰고, 속도와 유연성을 맞춰가며 섞으세요.
- 봇 차단 장치를 피하는 습관을 들이세요. 프록시와 헤더를 로테이션하고, 사람처럼 행동을 시뮬레이션하며, robots.txt를 존중하세요.
- Thunderbit으로 단순화하세요. 비즈니스 사용자나 빠른 프로토타이핑에는 Thunderbit가 AI로 복잡한 데이터를 추출해주고 API로 Node.js 스택에 연결할 수 있습니다.
- 대규모 배포를 준비하세요. Docker로 패키징하고, Kubernetes로 오케스트레이션하며, 안정성을 위해 전부 모니터링하세요.
- 데이터를 저장하고 정제하세요. 목적에 맞는 저장소를 고르고, 사용 전에 항상 검증하세요.
웹은 점점 더 복잡해지고 있지만, 이런 베스트 프랙티스를 적용하면 Node.js 스크래퍼를 빠르고 안정적으로 유지하면서 안티봇 경쟁에서도 한발 앞설 수 있습니다. 그리고 새벽 2시에 셀렉터 디버깅이 너무 지겹다면, 기억하세요. Thunderbit의 AI는 언제나 깨어 있습니다.
더 배우고 싶으신가요? Thunderbit Blog에서 더 깊이 있는 글을 읽어보거나, Thunderbit의 Chrome 확장 프로그램을 직접 써보면서 스크래핑이 얼마나 쉬운지 확인해보세요.
Thunderbit 에이전틱 웹 스크래퍼로 스크래핑하기 Thunderbit의 Web Scraper API를 사용하면 여러분의 Node.js 코드에서 바로 추출을 시작할 수 있으며, 무료 플랜으로 시작할 수 있습니다. Get Started Free
자주 묻는 질문
1. 2025년 기준으로 Node.js가 웹 스크래핑에 특히 좋은 이유는 무엇인가요?
Node.js의 비동기 이벤트 기반 모델은 수천 개의 동시 요청을 처리할 수 있어, 대량 데이터나 실시간 업데이트를 스크래핑하는 데 이상적입니다. 방대한 npm 생태계와 네이티브 JavaScript 지원도 현대적인 JavaScript 중심 사이트에 잘 맞습니다(Node.js Docs).
2. Node.js로 스크래핑할 때 차단을 피하려면 어떻게 해야 하나요?
프록시를 로테이션하고, 요청 헤더를 무작위화하며, 랜덤 딜레이로 요청 속도를 조절하세요. Puppeteer 같은 도구를 사용해 마우스 움직임, 스크롤, 타이핑 같은 사람 행동도 시뮬레이션할 수 있습니다. 항상 robots.txt와 사이트 약관을 지켜야 합니다(Medium).
3. Node.js 스크래퍼에서 Cheerio와 Puppeteer는 언제 각각 써야 하나요?
정적 HTML을 빠르게 파싱할 때는 Cheerio를 사용하세요(데이터가 원본 HTML 안에 있을 때). JavaScript로 동적으로 콘텐츠를 불러오는 사이트에는 Puppeteer가 적합합니다. 가장 좋은 방법은 Puppeteer로 페이지를 렌더링한 뒤 Cheerio로 HTML을 파싱하는 것입니다(Bright Data).
4. Thunderbit은 Node.js 웹 스크래핑을 어떻게 단순화하나요?
Thunderbit은 AI와 자연어 프롬프트를 사용해 어떤 웹사이트에서든 구조화된 데이터를 추출할 수 있게 해주며, 코딩이 필요 없습니다. 동적 콘텐츠, 하위 페이지, 페이지네이션을 처리하고, Node.js 연동을 위한 API도 제공합니다. 데이터는 Excel, Google Sheets, Airtable, Notion으로 바로 내보낼 수 있습니다(Thunderbit Blog).
5. 클라우드에서 Node.js 스크래퍼를 확장하고 모니터링하는 가장 좋은 방법은 무엇인가요?
스크래퍼를 Docker로 패키징하고, Kubernetes 또는 관리형 클라우드 서비스에 배포한 뒤, 오토스케일링으로 수요 급증에 대응하세요. CloudWatch나 Prometheus 같은 도구로 로그와 지표를 모니터링하고, 오류나 지연에 대한 알림을 설정하세요(DigitalOcean).
웹 스크래핑 실력을 한 단계 끌어올릴 준비가 되셨나요? Thunderbit을 사용해 보세요. 여러분의 스크래퍼가 빠르고, 은밀하고, 언제나 한 발 앞서 있길 바랍니다.
에이전틱 웹 스크래퍼 체험하기 Get Started Free
더 알아보기




