

지난주, 영업팀 동료 한 명이 데이터 벤더에서 사 온 4,000명 연락처가 들어 있는 스프레드시트를 보여줬습니다. 2주 동안 아웃리치를 보낸 뒤 결과는 어땠냐고요? 답장률은 0.3%였고, 반송률은 12%를 훌쩍 넘겼습니다. 그 리스트에 적지 않은 돈을 썼지만, 돌아온 건 거의 없었습니다.
2026년의 대부분 리드 리스트는 시작하자마자 이미 죽은 목록입니다. 2025년에 발송된 3,100만 통의 이메일을 바탕으로 한 Hunter의 State of Email Outreach에 따르면, 콜드 이메일 시퀀스의 평균 답장률은 고작 4.5%입니다. 이 수치조차 평균일 뿐이라 실제로는 이보다 훨씬 낮은 캠페인도 많다는 뜻이죠. 한편 Salesforce의 2026 State of Sales에 따르면, 일반적인 세일즈 담당자는 업무 시간의 40%만 실제 판매 활동에 쓰고 나머지 60%는 행정, 리서치, 그리고 말 그대로 리드 발굴에 씁니다.
그러니까, 그 시간을 들여 리스트를 만든다면 적어도 답장이 오는 리스트여야 합니다. 이 가이드는 2026년 기준 전체 워크플로를 하나씩 짚습니다. ICP 정의부터 LinkedIn을 넘어선 리드 찾기, 제대로 된 템플릿 구성, 반송률이 발신자 평판을 망치지 않도록 데이터 검증하기, 발송 전 리드 스코어링, 그리고 시간이 지나도 최신 상태를 유지하는 방법까지 정리했습니다. 게다가 예산 기준으로 나눴기 때문에, 오늘 바로 0달러로 시작할 수도 있습니다.
- 난이도: 초급
- 소요 시간: 첫 50
100개 리드 기준 약 23시간 - 준비물: Chrome 브라우저, Thunderbit 확장 프로그램, Google Sheet 또는 스프레드시트, 그리고 문서화한 ICP
AI 스크래핑으로 리드 리스트 만들기 Get Started Free
리드 리스트란 무엇이며, 왜 대부분의 리스트는 실패할까?
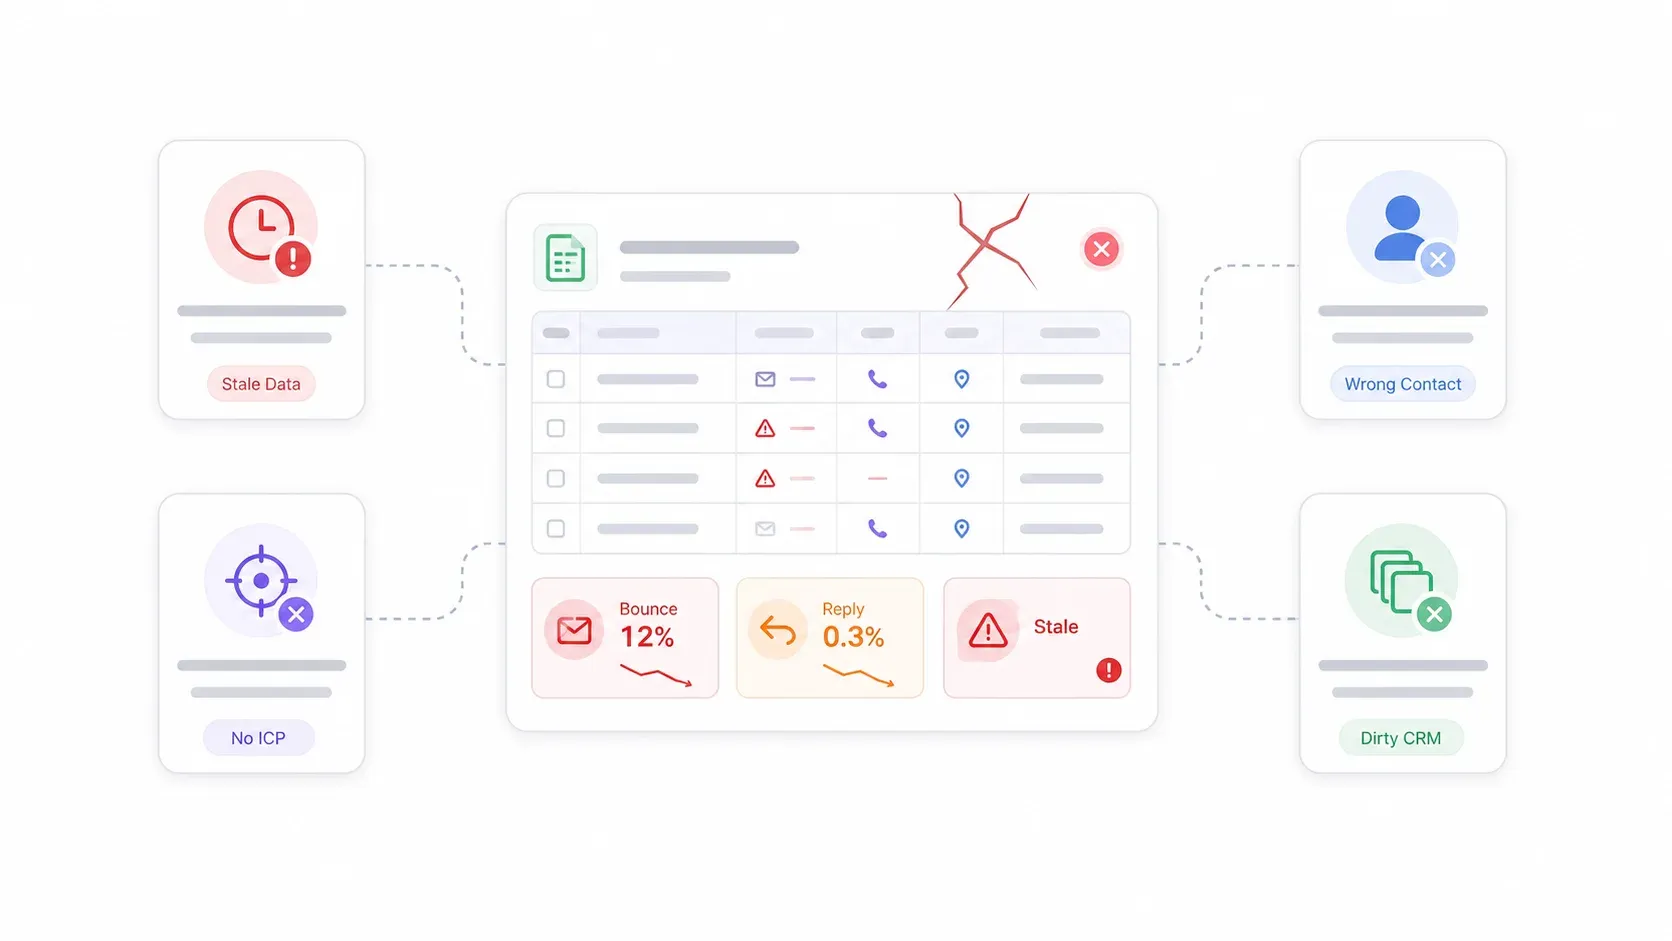
리드 리스트는 잠재 고객의 구조화된 데이터셋입니다. 다시 말해, 우리가 접촉하고 싶은 사람과 회사를 정리해 둔 목록이죠. 보통 개인 정보 항목(이름, 직함, 이메일, 전화번호, LinkedIn URL)과 회사 정보 항목(산업군, 규모, 매출, 지역)을 포함합니다. 아웃바운드 세일즈의 모든 활동은 여기서 출발합니다.
대부분의 팀이 실수하는 지점은 리드 리스트와 단순 연락처 덤프를 혼동한다는 겁니다. 쓸모 있는 리드 리스트는 왜 이 회사인가, 왜 지금 이 사람인가에 답해야 합니다. 반면 무작위 벤더에서 산 리스트는 대개 “아마 아직 존재할 수도 있는 이메일 주소” 정도만 알려줍니다. 결과 차이는 엄청납니다.
리드 리스트는 더 큰 라이프사이클 안에 들어갑니다. 리드는 우리 시장에 맞을 가능성이 있는 사람입니다. MQL은 마케팅 관점에서 적합하거나 어느 정도 반응을 보인 리드입니다. SQL은 세일즈가 직접 후속 조치를 취할 준비가 된 리드입니다. Opportunity는 실제 진행 중인 딜이죠. 리드 리스트는 이 퍼널의 맨 위입니다. 그리고 맨 위가 쓰레기로 가득하면 아래 단계 전체가 망가집니다.
리드 리스트가 실패하는 가장 흔한 이유는 다음과 같습니다.
- 오래된 데이터: ZeroBounce 보고서에 따르면 이메일 리스트의 최소 23%는 1년 안에 소멸합니다. 즉, 12개월마다 연락처의 거의 4분의 1이 무용지물이 된다는 뜻입니다.
- 잘못된 연락처: info@, sales@ 같은 역할 기반 이메일만 수집하거나, 의사결정 권한을 전혀 알 수 없는 “Staff” 같은 애매한 직함을 넣는 경우입니다.
- 타깃 기준 부재: 전략인 척하는 물량주의입니다. 한 포럼 사용자가 말했듯, “우리는 자주 양과 질을 헷갈립니다.”
- 검증 누락: Validity의 2024 CRM 데이터 리포트에 따르면 CRM 관리자 24%가 CRM 데이터의 절반도 정확하고 완전하지 않다고 답했고, 31%는 부실한 CRM 데이터가 연 매출의 최소 20%를 갉아먹는다고 말했습니다.
- 물량 우선 사고: Hunter의 데이터에 따르면 21~50명에게 보낸 캠페인의 평균 답장률은 6.2%인 반면, 501명 이상에게 보낸 캠페인은 평균 2.4%에 그칩니다. 더 작고 더 정교한 리스트가 더 크고 더 조잡한 리스트를 이깁니다.
리드 리스트 템플릿: 스프레드시트는 실제로 어떻게 생겨야 할까?
저는 “리드 리스트 만드는 법” 가이드를 수십 개 읽어봤는데, 늘 답답했던 점이 있습니다. 다들 “연락처 정보, firmographics, 리드 점수를 포함하라”고만 하지, 정작 스프레드시트가 어떤 모습이어야 하는지는 보여주지 않습니다. 그래서 여기, 모두가 놓치고 있는 실물 예시를 정리했습니다.
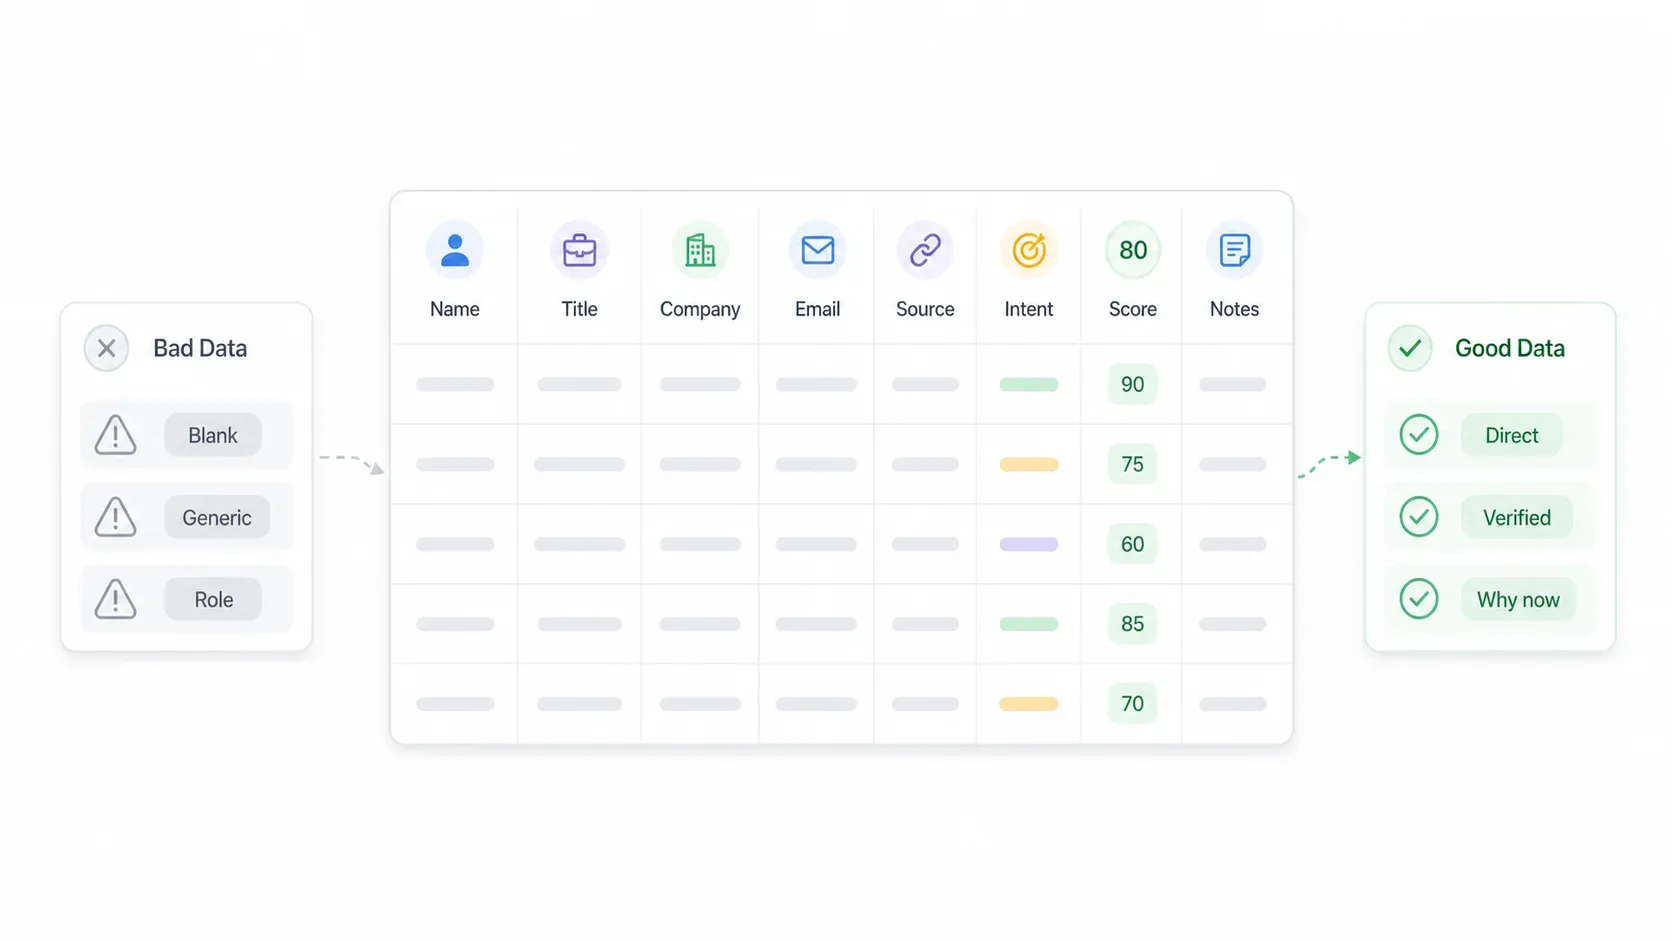
추천 시작 컬럼
리드 리스트 스프레드시트에는 처음부터 아래 컬럼이 있어야 합니다.
| 컬럼 | 입력할 내용 | 좋은 데이터 예시 | 나쁜 데이터 예시 |
|---|---|---|---|
| 성명 | 실제 사람 이름 | "Jordan Lee" | "Sales Team" |
| 직함 | 현재의 구체적 역할 | "VP of Sales" | "Staff" |
| 회사 | 법인명 또는 통상명 | "Acme Logistics" | "Acme?" |
| 산업군 | 표준화된 카테고리 | "B2B SaaS" | "Tech-ish" |
| 회사 규모 | 직원 수 구간 | "51-200" | 공란 |
| 이메일 | 직접 업무용 이메일 | "jordan@acme.com", 검증 완료 | "info@acme.com" |
| 전화번호 | 직접 번호 또는 대표번호, 형식 통일 | E.164 형식 | 지역 형식 혼재 |
| LinkedIn URL | 프로필 또는 회사 페이지 | 전체 URL | 검색 결과 URL |
| 리드 소스 | 어디에서 가져왔는지 | "G2 카테고리 페이지, 2026년 5월" | "인터넷" |
| 인텐트 신호 | 지금 필요한 이유 | "SDR 3명 채용", "신규 투자" | 공란 |
| 리드 점수 | 숫자 기반 우선순위 | 규칙 기반 70/100 | 감으로 결정 |
| 마지막 접촉일 | 아웃리치 날짜 | "2026-05-26" | "최근" |
| 메모 | 관련 맥락 | "Shopify Plus 사용" | 긴 비정형 붙여넣기 |
리드 리스트 예시(익명 처리)
아래는 실제로 채워진 리스트가 어떤 모습인지 보여주는 10개 행 예시입니다. 서로 다른 페르소나를 포함했습니다.
| 성명 | 직함 | 회사 | 산업군 | 규모 | 이메일 | 소스 | 인텐트 신호 | 점수 |
|---|---|---|---|---|---|---|---|---|
| Alex M. | VP Sales | Mid-market SaaS vendor | SaaS | 201-500 | direct verified | G2 category | Hiring AEs | 78 |
| Priya S. | Head of Ops | DTC apparel brand | Ecommerce | 51-200 | direct verified | Shopify showcase | Expanding fulfillment | 72 |
| Marcus T. | Founder | Local agency | Professional services | 11-50 | direct verified | Clutch | New reviews | 66 |
| Elena R. | Revenue Ops Manager | Cybersecurity startup | SaaS | 51-200 | catch-all flagged | Conference speakers | Series A | 61 |
| Ben C. | Owner | HVAC contractor | Local services | 11-50 | main office email | Google Business | High review volume | 48 |
| Mina K. | Director of Partnerships | Marketplace company | Ecommerce | 201-500 | direct verified | Event agenda | Sponsoring event | 74 |
| Diego P. | Real Estate Broker | Regional brokerage | Real estate | 11-50 | direct verified | Association directory | New office page | 58 |
| Sarah N. | Customer Support Lead | B2B software company | SaaS | 51-200 | role-based removed | Capterra | Low support reviews | 44 |
| Omar A. | IT Manager | Manufacturing firm | Manufacturing | 501-1000 | direct verified | Company team page | ERP migration mention | 69 |
| Lena W. | Growth Marketing Lead | Fintech startup | SaaS | 51-200 | direct verified | Product Hunt | New launch | 71 |
각 컬럼의 의미와 “좋은” 데이터란 무엇인가
몇몇 컬럼은 조금 더 설명이 필요합니다.
- 직함: "VP of Sales"는 예산 권한이 있는 사람이라는 뜻입니다. "Staff"는 아무 정보도 주지 않습니다. 의사결정 권한이나 영향력을 보여주는 구체적 직함을 우선하세요.
- 이메일: 개인 업무 이메일(jordan@acme.com)은 정말 가치가 높습니다. 역할 기반 주소(sales@acme.com)는 콜드 아웃리치에는 거의 쓸모가 없습니다. 여러 사람이 공유하는 받은편지함에 들어가 아무도 보지 않을 가능성이 높기 때문입니다.
- 리드 소스: 대부분 건너뛰는 컬럼이지만, 장기적으로는 가장 중요한 컬럼입니다. 각 리드가 어디서 왔는지 추적하면 어떤 채널이 행(row)만 늘리는지, 어떤 채널이 실제 답장을 만드는지 알 수 있습니다. "G2 카테고리 페이지, 2026년 5월"은 유용합니다. "인터넷"은 아닙니다.
- 인텐트 신호: 이건 "왜 지금인가"를 보여주는 컬럼입니다. 방금 Series A 투자를 받았거나, SDR 채용 공고를 3개 올렸거나, 새 제품을 출시한 회사는 조용히 있는 회사보다 훨씬 뜨거운 리드입니다. 인텐트 신호를 찾을 수 없다면, 우선순위를 낮춰도 됩니다.
Thunderbit의 AI Suggest Fields가 템플릿을 대신 만들어 주는 방식
Thunderbit를 쓰면서 제가 특히 자랑스럽게 생각하는 점 중 하나는, 어떤 컬럼을 만들어야 할지 더 이상 감으로 추측할 필요가 없다는 겁니다. 디렉터리 목록, 회사 팀 페이지, 컨퍼런스 발표자 리스트처럼 정보가 많은 페이지에서 Thunderbit를 열고 **"AI Suggest Fields"**를 클릭하면, AI가 페이지를 읽고 적절한 컬럼명과 데이터 타입을 자동으로 제안합니다. 페이지에 이름, 이메일, 직함, 회사 정보가 있으면 Thunderbit도 그에 맞춰 정확히 같은 컬럼을 제안합니다.
특히 빈 스프레드시트를 보며 “도대체 어떤 필드를 잡아야 하지?” 하고 막막해하는 초보자에게 유용합니다. Thunderbit는 소스 페이지에 실제로 있는 데이터를 바탕으로 답을 줍니다. 그 다음 **"Scrape"**를 누르면 데이터를 바로 Google Sheets, Excel, Airtable, Notion으로 내보낼 수 있습니다.
Thunderbit AI Suggest Fields 사용해 보기
리드 리스트를 만들기 전에 이상적인 고객 프로필(ICP)부터 정의하는 법
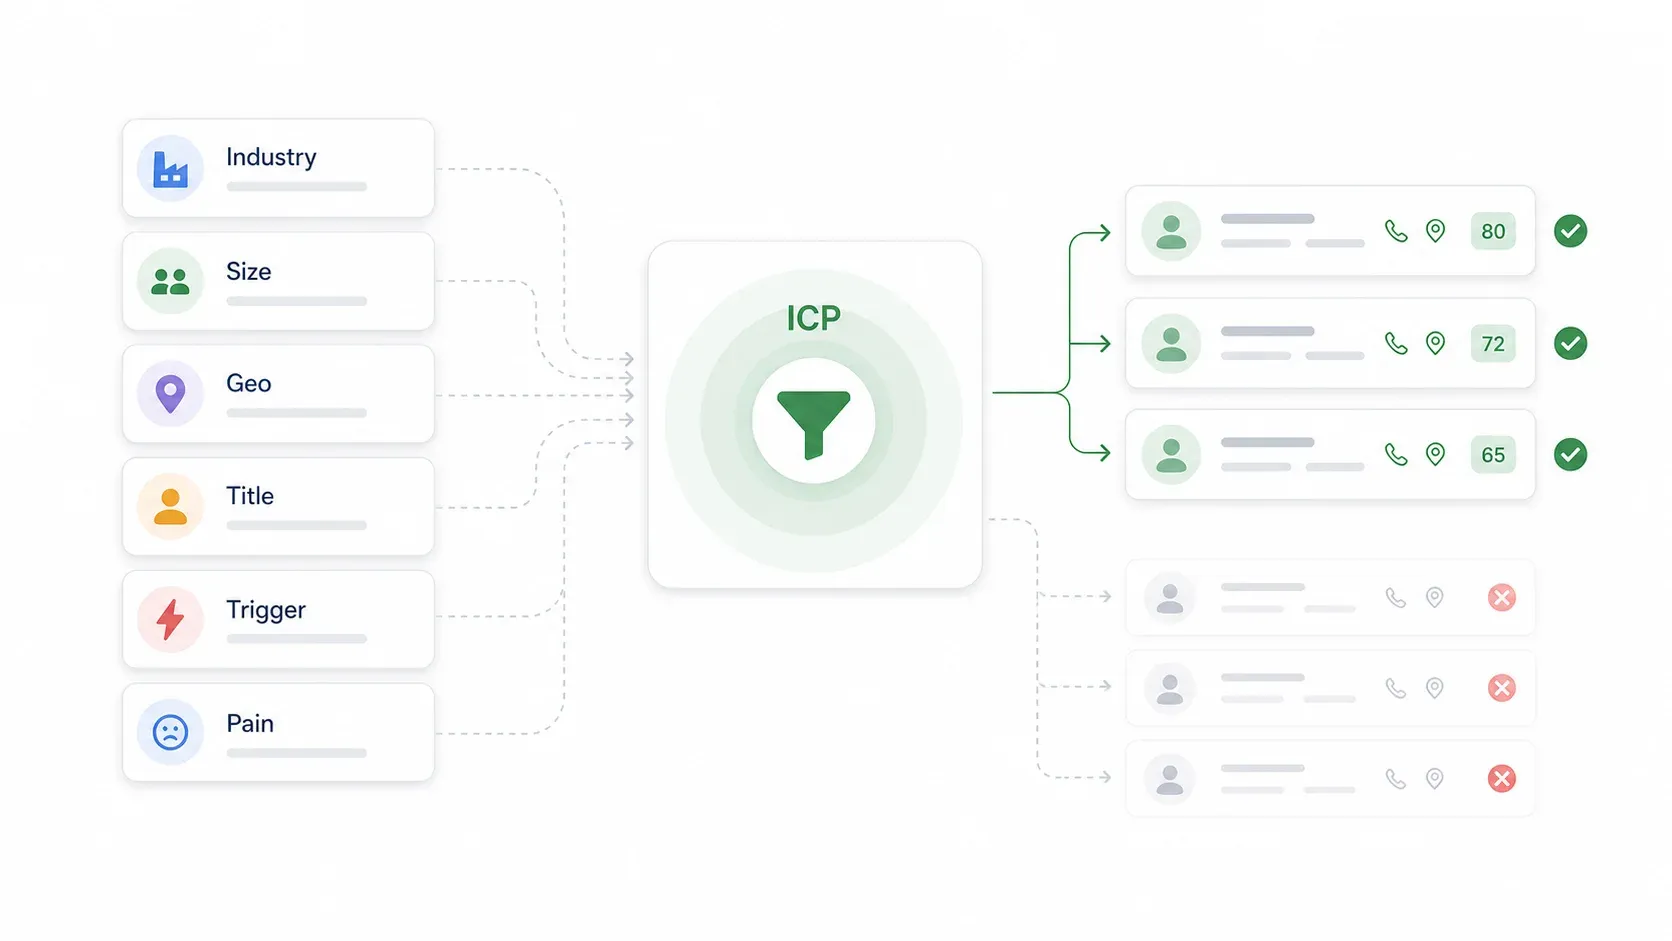
제가 팀들이 가장 자주, 그리고 저도 예전에 했던 가장 큰 실수는 누구를 리스트에 넣을지도 정하지 않은 채 먼저 리스트를 만드는 것입니다. 그러면 이름은 가득한데, 왜 그 사람들에게 우리 제품이 의미 있는지 아무런 기준이 없는 스프레드시트만 남습니다.
ICP는 우리 제품을 구매할 가능성이 높고, 실제로 가치를 얻으며, 오래 함께할 가능성이 큰 회사와 사람의 조건을 설명합니다. 페르소나 연습이 아니라 타깃팅 필터입니다.
ICP 구성 요소
| ICP 항목 | 질문 | 예시 |
|---|---|---|
| 산업군 | 어떤 카테고리에서 문제가 발생하나? | B2B SaaS, ecommerce, professional services |
| 회사 규모 | 어떤 구간이 지금 구매할 수 있나? | 51-500명 |
| 지역 | 어디서 판매하고 지원하기 가장 좋은가? | 미국, 캐나다, 영국 |
| 매출 범위 | 어떤 매출대가 맞는가? | ARR 500만~1억 달러 |
| 구매자 직함 | 누가 문제와 예산을 쥐고 있나? | VP Sales, RevOps, Head of Ops |
| 트리거 | 언제가 특히 급한가? | 채용, 투자, 마이그레이션, 낮은 리뷰 |
| 페인포인트 | 어떤 문제를 체감하는가? | 수동 리스트 빌딩, 오래된 데이터, 느린 보강 |
| 제외 대상 | 누구를 빼야 하는가? | 학생, 취미 사업자, 경쟁사 |
실습 팁: 기존의 가장 좋은 고객 510명을 살펴보세요. 공통점이 뭔가요? 산업군? 규모? 계약서에 서명한 사람의 직함? 공통된 특성 35개를 적어 보세요. 그게 ICP 초안입니다.
Firmographics와 Demographics: 무엇이 더 중요할까?
Firmographics는 회사 수준 데이터입니다. 산업군, 규모, 매출, 지역이 여기에 해당합니다. B2B 맥락에서 Demographics는 사람 수준 데이터입니다. 직함, 시니어리티, 직무, 부서가 들어갑니다. B2B 리드 리스트에서는 firmographics가 회사를 좁혀 주고, demographics가 사람을 좁혀 줍니다. 둘 다 필요합니다. 완벽한 회사에 잘못된 연락처를 붙여 놓으면 그 행은 낭비입니다. 완벽한 연락처라도 잘못된 회사라면 역시 소용이 없습니다.
한 가지 더 덧붙이면, Sopro의 2025 prospecting 데이터는 1억 1,957만 개의 prospecting 터치포인트를 분석한 결과 평균 의사결정 단위가 약 4.14명이라고 밝혔습니다. 즉, 좋은 리드 리스트는 보통 타깃 계정당 한 명 이상을 포함합니다. 다만 너무 많아지면 아웃리치가 스팸처럼 보일 수 있으니 주의해야 합니다.
LinkedIn을 넘어: 웹사이트, 디렉터리, 소셜 미디어에서 리드 찾기
이 주제를 조사하면서 놀랐던 콘텐츠 공백이 하나 있었습니다. 상위권에 랭크된 “리드 리스트 만드는 법” 글 6개 중 5개가 독자를 결국 LinkedIn Sales Navigator로 유도하더군요. Sales Navigator가 강력한 건 사실입니다. 하지만 Core 기준 월 약 120달러로 비싸기도 하고, 실제 사용자들은 export 제한, 복잡한 인터페이스, 스크래핑의 번거로움을 자주 불평합니다.
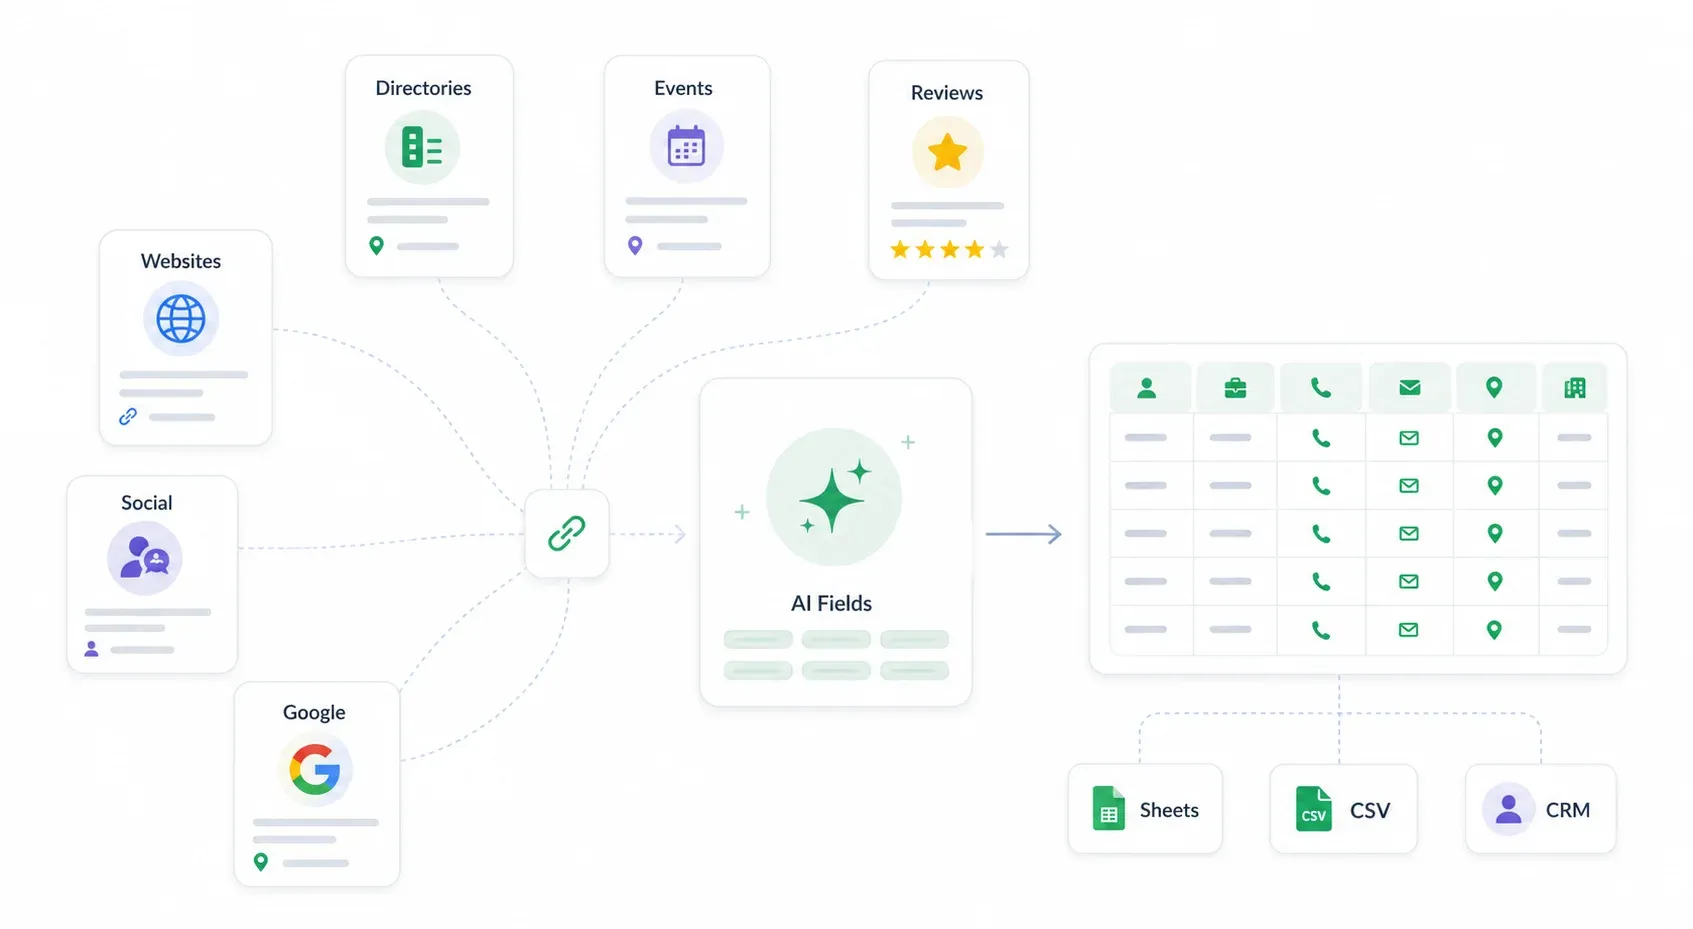
2026년의 현실은 리드가 LinkedIn에만 있는 게 아니라는 점입니다. 회사 웹사이트, 산업 디렉터리, 이벤트 페이지, 리뷰 사이트, 심지어 소셜 미디어 프로필까지도 훌륭한 연락처 소스입니다. 유료 데이터베이스보다 더 최신이고 더 구체적인 정보를 주는 경우도 많습니다.
리드 소스 비교
| 리드 소스 | 적합한 용도 | 방법 | 비용 |
|---|---|---|---|
| 회사 웹사이트 / About 페이지 | 니치 B2B, 로컬 서비스, 에이전시 | 팀/연락처 페이지 방문, 이름/이메일/전화 추출 | 무료 |
| 산업 디렉터리(Clutch, G2, Yelp) | 서비스형 리드, 업종 생태계 | 카테고리/지역 필터링, 리스트 스크래핑 | 무료~저비용 |
| 이벤트 참가자/발표자 리스트 | 의도가 높은 B2B 잠재고객 | 컨퍼런스 아젠다, 스폰서 페이지, 웨비나 등록자 | 무료~유료 이벤트 접근 |
| 리뷰 사이트(G2, Capterra, Google Business) | SaaS 및 로컬 비즈니스 | 카테고리 탐색, 회사 연락처 추출 | 무료 |
| 소셜 미디어(Instagram, X) | B2C, 개인 브랜드, 로컬 비즈니스 | 공개 바이오, 비즈니스 페이지 | 무료 |
| Google site: 연산자 | 롱테일 탐색, 타깃 연락처 페이지 | 고급 검색 쿼리 | 무료 |
| LinkedIn(기본) | 전문직 검색 | 수동 검색, 공개 프로필 | 무료 |
| LinkedIn Sales Navigator | 성숙한 아웃바운드 팀 | 고급 필터, 저장된 리드, TeamLink | 월 $99+ |
업종별 유용한 디렉터리
| 업종 | 스크래핑할 가치가 있는 소스 |
|---|---|
| SaaS | G2, Capterra, Product Hunt, SaaSworthy, AWS Marketplace, Chrome Web Store 카테고리 |
| Ecommerce | Shopify 스토어/쇼케이스, BuiltWith 리스트, Klaviyo 파트너 디렉터리 |
| Real estate | Realtor 디렉터리, brokerage office 페이지, 지역 MLS 공개 페이지, 상공회의소 디렉터리 |
| Professional services | Clutch, DesignRush, UpCity, GoodFirms, 지역 변호사/회계사 디렉터리 |
| Local business | Google Business 결과, Yelp, Yellow Pages, BBB, 지역 상공회의소 페이지 |
| Events | 스폰서/전시자 페이지, 발표자 리스트, 아젠다 페이지, 웨비나 랜딩 페이지 |
리드 발굴을 위한 Google 고급 검색 연산자
이 방법은 무료이면서도 놀라울 정도로 강력합니다. 몇 가지 예를 보겠습니다.
site:clutch.co/agencies "B2B SaaS" "United States"— Clutch에서 카테고리와 지역으로 필터링된 에이전시 목록을 찾습니다.site:company.com ("email" OR "contact") "VP Sales"— 특정 회사 사이트에서 VP Sales가 언급된 연락처 페이지를 찾습니다.intitle:"sponsors" "SaaS" "2026" "conference"— 2026년 SaaS 이벤트의 컨퍼런스 스폰서 페이지를 찾습니다.site:g2.com/categories "sales engagement" "mid-market"— 미드마켓 세일즈 툴 관련 G2 카테고리 페이지를 찾습니다.
Google의 검색 도움말에는 정확히 일치하는 따옴표와 site: 같은 연산자가 문서화되어 있으니, 문법은 그쪽에서 확인하면 됩니다.
AI 웹 스크래퍼로 어떤 웹사이트든 연락처를 추출하는 법
여기서 Thunderbit가 워크플로에 자연스럽게 들어갑니다. 위에서 언급한 어떤 소스든 — Clutch 디렉터리, 회사 팀 페이지, 컨퍼런스 발표자 리스트 — 방식은 같습니다.
- Thunderbit 확장 프로그램을 설치한 Chrome에서 페이지를 엽니다.
- **"AI Suggest Fields"**를 클릭합니다. Thunderbit의 AI가 페이지를 읽고 Name, Email, Phone, Title, Company 같은 컬럼을 제안합니다.
- 제안된 필드를 검토하고, 필요에 따라 추가하거나 제거합니다.
- **"Scrape"**를 클릭합니다.
- Google Sheets, Excel, Airtable, Notion으로 내보냅니다.
핵심 장점은 Thunderbit가 미리 만들어진 템플릿으로는 대응하기 어려운 지저분하고 비표준적인 사이트에서도 잘 작동한다는 점입니다. AI가 페이지를 매번 새로 읽고, 그때그때 구조에 맞춰 적응합니다. Thunderbit의 무료 Email Extractor와 Phone Number Extractor는 어떤 페이지에서든 1번 클릭으로 추출할 수 있으며, 무료 요금제에서도 무제한으로 사용할 수 있습니다.
하위 페이지 스크래핑으로 리드 리스트를 더 풍부하게 만들기
제가 자주 쓰는 워크플로 하나는 먼저 디렉터리 목록 페이지를 스크래핑하는 것입니다(예: Clutch의 회사 목록). 그다음 Thunderbit의 Subpage Scraping으로 각 회사의 개별 페이지를 방문해 이메일, 전화번호, 인원 규모, 기술 스택, 설명 등 추가 데이터를 가져옵니다.
이렇게 하면 단순한 디렉터리 리스트가 수작업 클릭 없이도 조사 가능한 풍부한 리드 리스트로 바뀝니다. "회사 이름 50개"에서 "연락 이메일, 팀 규모, 설명이 포함된 회사 50개"로 한 번에 바꿀 수 있습니다. 코딩 없이 웹 스크래핑하는 법에 대해 더 알고 싶다면, 관련 가이드도 자세히 다뤄 두었습니다.
2026년 워크플로 기준, 리드 리스트를 단계별로 만드는 법
아래는 오늘 당장 실제 리드 리스트를 만들고 싶은 비기술 영업/운영 담당자를 위한 전체 워크플로입니다.
1단계: ICP를 정확히 정리하기
어떤 도구를 열기 전에 ICP 기준을 먼저 적습니다(위 ICP 섹션을 참고하세요). 산업군, 회사 규모, 지역, 구매자 직함, 트리거, 제외 대상까지요. 이 작업은 15~30분이면 끝나고, 헛수고로 스크래핑하는 시간을 크게 줄여 줍니다.
2단계: 리드 소스 선택하기
ICP와 예산을 기준으로 비교 표에서 2~3개의 리드 소스를 고릅니다. 제 추천은 무료 소스부터 시작하는 것입니다. SaaS 회사를 타깃한다면 G2 카테고리 페이지와 회사 팀 페이지를 먼저 보세요. 로컬 비즈니스를 타깃한다면 Google Business 결과와 Yelp부터 시작하세요. Sales Navigator 같은 유료 소스는 무료 소스를 다 소진한 뒤에 추가해도 충분합니다.
3단계: AI 스크래핑 또는 수동 검색으로 리드 추출하기
소스별 추출 방법은 다음과 같습니다.
- 웹사이트와 디렉터리: Thunderbit의 AI 웹 스크래퍼를 사용합니다. 페이지를 열고 "AI Suggest Fields"를 클릭한 뒤 컬럼을 검토하고 "Scrape"를 누릅니다. 인기 사이트의 경우 Thunderbit에 즉시 사용 가능한 데이터 스크래퍼 템플릿이 있어 필드가 자동으로 설정됩니다.
- LinkedIn: Sales Navigator에서 검색 후 export하거나, Thunderbit로 공개 LinkedIn 프로필 스크래핑을 사용할 수 있습니다.
- Google: 고급 검색 연산자를 실행한 뒤 결과 페이지를 스크래핑하거나 개별 페이지를 방문합니다.
내보내기 형식: Google Sheets, Excel, Airtable, Notion, CSV, JSON.
4단계: 데이터 검증 및 정리하기
이 단계는 선택이 아닙니다. 아래 전용 섹션에서 전체 검증 워크플로를 설명하겠지만, 핵심만 말하면 역할 기반 이메일 제거, 중복 제거, 검증 도구 통과, catch-all 도메인 표시, 캠페인 직전 재검증이 필요합니다.
5단계: 리드 점수화와 우선순위 정하기
아웃리치를 시작하기 전에 간단한 스코어링 모델을 적용하세요(아래에서 자세히 설명). 그러면 그냥 스프레드시트 맨 위에 있는 사람이 아니라, 가장 가치 있는 리드부터 먼저 연락하게 됩니다.
6단계: CRM 또는 아웃리치 툴로 내보내기
정리되고 점수화된 리스트를 CRM(HubSpot, Salesforce, Pipedrive)이나 아웃리치 플랫폼(lemlist, Mailshake, Apollo)으로 옮깁니다. Thunderbit는 Google Sheets, Airtable, Notion으로 바로 내보낼 수 있고, 이 데이터는 네이티브 연동이나 Zapier를 통해 CRM과 동기화할 수 있습니다.
7단계: 아웃리치를 시작하고 결과를 추적하기
수집한 데이터에 기반해 아웃리치를 개인화하세요. 잠재고객의 산업군을 언급하고, 인텐트 신호(“SDR을 채용 중인 걸 봤습니다”)를 참조하며, 그들의 페인포인트에 맞는 가치 제안을 넣어야 합니다. 답장률, 반송률, 전환율을 추적하고, 다음 라운드를 위해 그 데이터를 다시 ICP와 점수 모델에 반영하세요.
예산 우선 접근: 0달러에서 엔터프라이즈까지 리드 리스트 만드는 법
초기 창업자와 작은 영업팀에서 가장 많이 듣는 고민은 이겁니다. “비싼 툴 없이 리드 리스트를 어떻게 만들죠?” 충분히 타당한 질문입니다. ZoomInfo 계약은 연간 수만 달러부터 시작하고, Sales Navigator는 월 99달러 이상입니다. Apollo와 Lusha는 무료 플랜이 있지만 좋은 기능은 유료 벽 뒤에 있습니다.
솔직한 답은, 무료로도 생각보다 멀리 갈 수 있다는 겁니다. 다만 확장하려면 어느 정도 투자가 필요합니다. 아래처럼 단계별로 생각하면 됩니다.
| 티어 | 비용 | 방법 | 도구 |
|---|---|---|---|
| 무료 ($0) | $0 | Google 연산자, 수동 LinkedIn, 회사 웹사이트, Thunderbit 무료 요금제(6페이지 + 무료 이메일/전화 추출기) | Thunderbit Free, Google, 기본 LinkedIn |
| 저비용 (<$50/월) | $0-50 | 대량 AI 스크래핑, 기본 데이터 보강, 이메일 검증 | Thunderbit Starter/Pro, Hunter Starter ($34/월), Bouncer/NeverBounce 종량제 |
| 중간 ($50-200/월) | $50-200 | Sales Navigator, 더 풍부한 필터, CRM 연동 | Sales Navigator Core($119.99/월, 연간 청구 시 $89.99), Apollo 유료, Lusha |
| 엔터프라이즈 ($200+/월) | $200+ | 인텐트 데이터, 보강 스위트, 컴플라이언스 워크플로 | ZoomInfo(견적형), Cognism(견적형), Clearbit |
가격은 2026년 5월 기준입니다. 구매 전 최신 요금을 확인하세요.
무료로 어디까지 할 수 있고, 어디서 한계가 오는가
Thunderbit의 무료 요금제(월 6페이지 AI 스크래핑), 무료 Email Extractor와 Phone Number Extractor(무제한, 1클릭), Google 검색 연산자, 기본 LinkedIn 검색만으로도 솔로 창업자는 오후 한나절에 50~100개짜리 리드 리스트를 현실적으로 만들 수 있습니다. 실제로 우리 팀에서도 그렇게 하는 걸 봤습니다.
한계는 분명 있습니다. 무료 요금제의 페이지 수, 인텐트 데이터나 기술 스택 정보 같은 보강 깊이, 그리고 대량 이메일 검증입니다. 무료 검증 도구는 보통 소량만 처리 가능합니다. 이런 제한이 답답해지기 시작하면 저비용 티어로 넘어갈 시점입니다. Thunderbit 유료 플랜을 사용하면 하위 페이지 스크래핑, 대량 스크래핑, 페이지네이션, 예약 스크래퍼를 이용할 수 있습니다.
반송률 해결: 실제로 작동하는 데이터 검증 워크플로
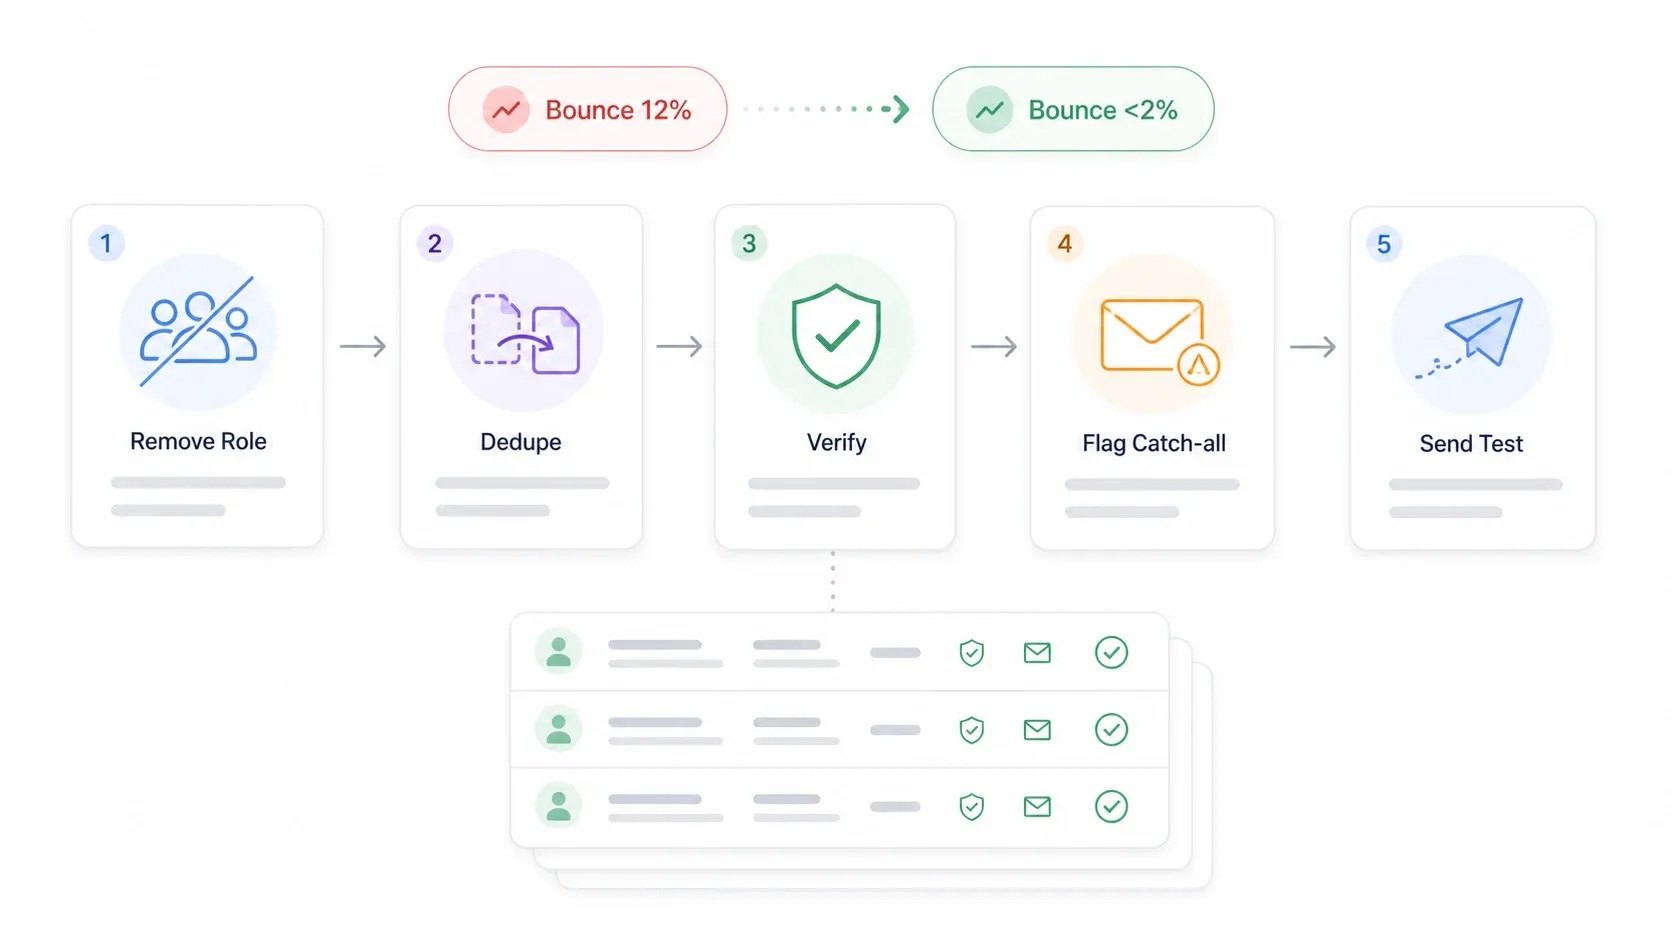
구매한 리스트에서 거의 70% 반송률을 경험했다는 포럼 글도 봤습니다. 이건 단순히 시간 낭비가 아닙니다. 꽤 위험합니다. 반송률이 높으면 발신자 평판이 크게 떨어지고, 그러면 좋은 이메일까지 스팸으로 들어가기 시작합니다.
lemlist 벤치마크에 따르면 건강한 반송률은 2% 미만, 1% 이하면 매우 좋습니다. Mailshake의 2025 설문에서는 발신자의 절반 가까이가 2~5% 반송률을 보고했고, 15%는 6%를 초과했다고 나왔습니다. 5%를 넘는다면 발신자 평판이 위험합니다.
제가 추천하는 검증 워크플로는 다음과 같습니다.
- 역할 기반 이메일 제거: info@, sales@, support@, admin@ 주소는, 의도적으로 공유 받은편지함을 노리는 경우가 아니라면 삭제합니다(콜드 아웃리치에서는 거의 예외입니다).
- 형식 오류 제거: 중복, 오타, 누락된 도메인, 죽은 도메인을 정리합니다. 스프레드시트에서 간단히 정렬과 필터만 해도 대부분 잡을 수 있습니다.
- 이메일 검증 도구 사용: Hunter, ZeroBounce, NeverBounce, Bouncer, Kickbox 등을 사용합니다. 이 도구들은 이메일을 실제로 보내지 않고도 메일 서버에 ping을 보내 해당 받은편지함이 존재하는지 확인합니다.
- catch-all 도메인 표시 또는 제거: ZeroBounce 보고서에 따르면 catch-all 주소는 대표적인 위험군입니다. 특정 받은편지함이 존재함을 증명하지 않은 채 서버 수준에서 메일을 받아들이기 때문입니다. 개별 받은편지함을 검증할 수 없다면 해당 레코드를 표시해 두고 신뢰도를 낮게 보세요.
- 캠페인 전 재검증: 데이터는 빠르게 낡습니다. 리스트가 30~90일 이상 됐다면 발송 전에 다시 검증하세요.
- 처음엔 소량 발송: 첫 50~100건에서 반송률과 불만 신고율을 확인합니다. 품질이 유지될 때만 규모를 키우세요.
리드 소스가 데이터 품질에 영향을 주는 이유
모든 리드 데이터가 같은 품질은 아닙니다. 회사의 공개 팀 페이지에서 직접 가져온 이메일, 즉 본인이 일부러 연락처를 공개한 경우의 데이터는 보통 몇 달간 업데이트되지 않은 집계형 데이터베이스보다 더 최신이고 정확합니다.
제가 정적 데이터베이스에만 의존하지 않고 살아 있는 공개 페이지를 스크래핑하는 이유도 여기에 있습니다. Thunderbit의 AI는 오래된 데이터베이스가 아니라 실제 웹사이트를 매번 새로 읽기 때문에, 추출되는 이메일과 전화번호가 더 최신인 경우가 많습니다. Phone Number Extractor는 번호를 E.164 표준으로 다시 포맷해 주므로, CRM으로 가져올 때 생기는 형식 오류를 줄여 줍니다.
물론 최신 소스를 스크래핑하는 것이 검증을 대체하는 건 아닙니다. 다만 시작점이 훨씬 깨끗해진다는 뜻입니다.
캠페인 전 체크리스트
어떤 캠페인이라도 "발송"을 누르기 전에 아래를 확인하세요.
- 모든 이메일이 최근 30일 이내에 검증됨
- 발송 리스트에 역할 기반 주소(info@, sales@) 없음
- 중복 없음
- 지난 캠페인의 반송률 검토 완료
- 옵트아웃/수신 거부 메커니즘 준비 완료
- suppression list 동기화 완료(이전 옵트아웃 모두 존중)
Build-Then-Score: 소규모 팀을 위한 간단한 리드 스코어링 모델
제가 읽은 모든 가이드는 “리드를 우선순위화하라”고 말합니다. 그런데 방법은 안 알려줍니다.
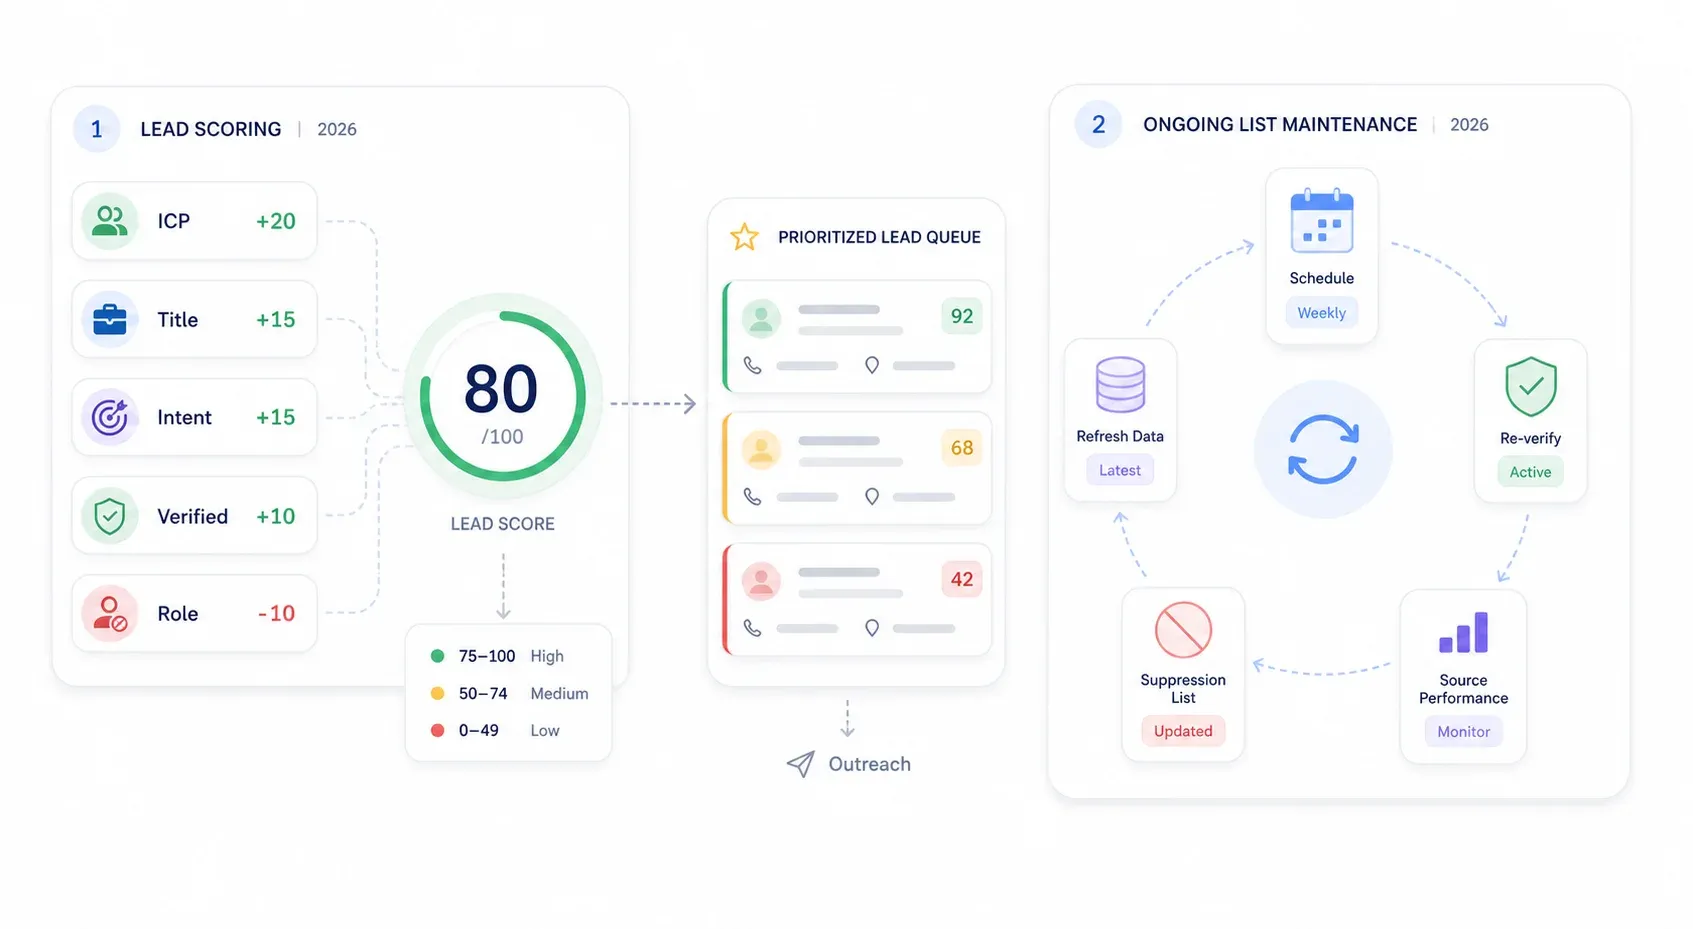
혼자 일하는 창업자든 3인 세일즈 팀이든, Salesforce Einstein이나 예측형 스코어링 엔진은 필요 없습니다. 투명한 수식이 들어간 스프레드시트 컬럼만 있으면 됩니다.
스코어링 프레임워크
| 신호 | 점수 | 예시 | |---|---|---|---| | ICP 산업군과 일치 | +20 | SaaS, mid-market | | 회사 규모 적합 | +10 | 51-500명 | | 의사결정자 직함 | +15 | VP Sales, Head of Ops | | 명확한 인텐트 신호 | +15 | 채용, 투자, 툴 마이그레이션 | | 이메일 검증 완료 | +10 | 검증 통과 | | 직접 소스 품질 | +10 | 회사 페이지, 이벤트 발표자 페이지 | | 우리 콘텐츠와의 상호작용 | +10 | 가이드 다운로드, 웨비나 참석 | | catch-all / 미검증 이메일 | -10 | 위험한 검증 상태 | | 역할 기반 이메일 | -10 | info@, sales@ | | 일반적인 직함(역할 불명확) | -5 | "Staff" |
계산 예시
리드 A: 120명 규모의 SaaS 회사 VP Sales, SDR 채용 중, 이메일 검증 완료, 회사 채용/팀 페이지에서 확보.
점수: 20(산업군) + 10(규모) + 15(직함) + 15(인텐트) + 10(검증) + 10(소스) = 80 → 이번 주 아웃리치 우선 대상.
리드 B: 5명 규모의 취미성 비즈니스에 있는 "Staff", 역할 기반 이메일, 인텐트 신호 없음.
점수: 0 + 0 + 0 + 0 + 0 - 10(역할 기반) - 5(일반 직함) = -15 → 제외하거나 삭제.
이건 Google Sheets의 간단한 수식으로도 충분합니다. 예를 들면:
=IF(D2="SaaS",20,0)+IF(AND(E2>=51,E2<=500),10,0)+IF(REGEXMATCH(B2,"VP|Head|Director|Founder"),15,0)+IF(J2<>"",15,0)+IF(K2="Verified",10,IF(K2="Catch-all",-10,0))
Salesforce는 필요 없습니다.
스크래핑 중 AI로 리드 라벨링과 스코어링을 하는 법
제가 Thunderbit에 넣은 기능 중 실제로 스코어링에 아주 유용하다고 느끼는 기능이 있습니다. 바로 Field AI Prompts입니다. 스크래핑을 설정할 때 어떤 컬럼이든 프롬프트를 추가할 수 있습니다. 예를 들면, "직함과 페이지 문맥을 바탕으로 이 리드의 시니어리티를 Decision-Maker, Influencer, Individual Contributor 중 하나로 분류하세요." 같은 식입니다.
Thunderbit는 데이터를 추출한 뒤가 아니라 추출하는 과정에서 라벨을 붙입니다. 그래서 Sheets로 내보낼 때는 시니어리티 분류, 회사 유형, 산업 태그가 이미 채워져 있고, 바로 스코어링 수식에 넣을 수 있습니다. 이 과정이 수작업 태깅을 없애 주기 때문에 스코어링이 훨씬 덜 번거롭게 느껴집니다.
또한 Subpage Scraping을 사용해 원본 목록 데이터를 보강할 수도 있습니다. 먼저 디렉터리를 스크래핑한 다음 각 회사 페이지를 방문해 직원 수, 투자 단계, 기술 스택 등을 가져오는 방식인데, 이 모든 정보가 스코어링 모델에 들어갑니다.
점수를 언제 다시 살펴봐야 할까?
리드 점수는 한 번 정해두고 끝나는 게 아닙니다. 매달, 또는 중요한 캠페인 후마다 다시 평가하세요. 리드가 긍정적으로 답장했다면 그 사람은 더 이상 콜드 리드가 아니라 활성 대화 중인 상대입니다. 이메일이 반송되면 점수를 조정해야 합니다. 6개월 전에는 채용 중이던 회사가 이후 감원을 했다면, 인텐트 신호도 달라진 겁니다.
리드 리스트를 신선하게 유지하는 법: 자동화와 관리
리드 리스트는 한 번 만들고 끝나는 프로젝트가 아닙니다.
앞서 말했듯이 이메일 리스트의 23%는 매년 소멸합니다. 연락처는 직장을 옮기고, 회사는 방향을 바꾸고, 이메일은 낡습니다. 5월에 훌륭한 리스트를 만들어 놓고 10월까지 손대지 않으면, 그중 상당수는 이미 죽은 데이터입니다.
유지보수 주기
| 작업 | 빈도 | 이유 |
|---|---|---|
| 이메일 검증 | 매 캠페인 전(또는 최소 월 1회) | 하드 바운스 방지 |
| 연락처 중복 제거 | 활성 리서치 기간에는 매주 | 중복 아웃리치 방지 |
| 인텐트 신호 갱신 | 매월 | 채용/투자/리뷰는 빠르게 변함 |
| 회사 firmographics 업데이트 | 분기별 또는 반기별 | 규모, 매출, 기술 스택은 변동됨 |
| suppression list 동기화 | 매일 또는 실시간 | 옵트아웃 존중 및 불만 감소 |
| 소스 성과 검토 | 매월 | 단순 행이 아니라 답장을 만드는 채널 찾기 |
지속적인 리드 생성을 위한 예약 스크래퍼 설정
여기서 Thunderbit의 Scheduled Scraper가 빛을 발합니다. 매달 디렉터리를 직접 다시 방문하는 대신 반복 스크래핑을 설정할 수 있습니다. 설정은 간단합니다. 시간 간격을 자연어로 설명하면 됩니다(예: “매주 월요일 오전 8시”), 웹사이트 URL을 넣고 “Schedule”을 클릭하면 됩니다. Thunderbit의 AI가 당신의 문장을 일정으로 바꾸고, 스크래핑을 자동 실행한 뒤 연결된 Google Sheet 또는 Airtable base로 최신 결과를 내보냅니다.
잘 맞는 사용 사례는 다음과 같습니다.
- 세일즈 팀이 매달 Clutch 카테고리 페이지를 다시 스크래핑해 새로 진입한 에이전시를 포착함
- Ecommerce 운영팀이 경쟁사 디렉터리를 매주 모니터링해 새 상품 등록을 확인함
- SaaS 창업자가 월별 아웃리치 배치 전에 G2 카테고리 페이지를 새로고침해 신규 등록 회사를 찾음
Thunderbit의 클라우드 모드는 한 번에 최대 50페이지까지 스크래핑할 수 있어서, 대형 디렉터리도 빠르게 갱신됩니다. 설정 방법이 더 궁금하다면 AI 리드 제너레이션 가이드를 참고하세요.
컴플라이언스와 데이터 프라이버시에 대한 짧은 메모
이 가이드의 핵심 주제는 아니지만, 매우 중요하므로 짧게 짚고 넘어가겠습니다.
- CAN-SPAM(미국): B2B를 포함한 모든 상업용 이메일에 적용됩니다. FTC에 따르면 위반 이메일 한 통마다 최대 $53,088의 벌금이 부과될 수 있습니다. 요구사항은 정확한 헤더, 오해를 부르는 제목 금지, 유효한 우편 주소, 명확한 옵트아웃, 그리고 10영업일 내 옵트아웃 준수입니다.
- GDPR(EU/UK): 이름이 포함된 업무 이메일도 개인정보로 볼 수 있습니다. ICO는 B2B 마케팅이 신원을 숨기면 안 되고, 유효한 옵트아웃을 제공해야 하며, 이의를 존중해야 한다고 말합니다.
- CCPA/CPRA(캘리포니아): 고지, 목적 제한, 데이터 최소화, 소비자 권리를 강조합니다. 최신 내용은 California Privacy Protection Agency FAQ를 확인하세요.
- Google과 Yahoo의 발신 규칙: Google은 대량 발신자가 스팸 비율을 0.30% 미만으로 유지하고, SPF/DKIM/DMARC로 인증하며, 원클릭 구독 취소를 지원해야 한다고 요구합니다. Yahoo도 유사한 규칙을 적용합니다.
핵심은 이겁니다. 공개적으로 이용 가능한 데이터만 스크래핑하고, 허가 없이 로그인 장벽을 우회하지 말고, 항상 옵트아웃 메커니즘을 넣고, suppression list를 유지하며, 지역별 법적 요건을 확인해야 합니다. Thunderbit는 공개 페이지를 스크래핑하는 도구일 뿐이며, 데이터를 어떻게 사용할지는 사용자 책임입니다.
결론과 핵심 요약
2026년의 리드 리스트 워크플로는 더 많은 이름을 찾는 일이 아닙니다. 실제로 답장이 오는, 더 작고 더 최신이며, 검증되고, 소스까지 추적 가능한 아웃리치 데이터셋을 만드는 일입니다.
전체 워크플로를 요약하면 다음과 같습니다.
- 어떤 도구를 열기 전에 ICP부터 정의합니다.
- 리드 소스 2~3개를 선택합니다. 유료 데이터베이스를 사기 전에 무료 소스(디렉터리, 회사 페이지, Google 연산자)부터 시작하세요.
- AI 스크래핑으로 리드를 추출합니다. Thunderbit의 2번 클릭 프로세스는 사실상 모든 공개 페이지에 작동합니다.
- 제대로 된 템플릿을 구성합니다. 소스 추적, 인텐트 신호, 스코어링 컬럼을 포함하세요.
- 검증하고 정리합니다. 역할 기반 이메일 제거, 중복 제거, 검증 실행, catch-all 표시를 하세요.
- 점수화하고 우선순위를 정합니다. 감이 아니라 투명한 스프레드시트 모델을 쓰세요.
- CRM/아웃리치 툴로 내보냅니다. 수집한 데이터를 바탕으로 개인화하세요.
- 결과를 추적합니다. 반송률, 답장률, 전환율을 리드 소스별로 보세요.
- 지속적으로 갱신합니다. 캠페인 전에 다시 검증하고, 고가치 소스는 일정에 따라 재스크래핑하세요.
데이터도 이를 뒷받침합니다. 더 타이트한 세그먼트는 넓게 뿌리는 캠페인보다 답장률이 거의 3배 더 좋습니다. 검증된 200개짜리 리스트는 5,000개 연락처가 들어 있는 오래된 데이터베이스보다 거의 항상 더 나은 성과를 냅니다.
첫 리스트를 만들 준비가 되셨나요? Thunderbit 무료 요금제는 월 6페이지의 AI 스크래핑, 무제한 무료 이메일/전화 추출, 그리고 Google Sheets나 Excel로의 내보내기를 제공합니다. 오늘 오후에 첫 50~100개 리드를 만들기에는 충분합니다.
리드 리스트용 AI 웹 스크래퍼 사용해 보기 Get Started Free
자주 묻는 질문
첫 리드 리스트에는 몇 개의 리드가 있어야 할까요?
수천 개의 부적합한 연락처보다, 잘 타깃팅되고 검증된 50100개의 리드로 시작하세요. Hunter 데이터에 따르면 2150명 수준의 더 작고 정교한 수신자 리스트는 평균 6.2% 답장률을 보이며, 501명 이상 리스트보다 거의 3배 높습니다. 품질은 복리처럼 쌓이고, 물량은 오히려 희석시킵니다.
리드 리스트를 사는 게 좋을까요, 직접 만드는 게 좋을까요?
직접 만드는 편이 거의 항상 더 낫습니다. 구매 리스트는 오래된 데이터, 스팸 트랩, 출처 불명확성, 컴플라이언스 리스크가 더 큽니다. AI 스크래핑과 수동 리서치로 만든 리스트는 공개 페이지의 최신 정보를 직접 가져오기 때문에 더 신선하고 더 관련성 높은 데이터를 얻을 수 있습니다. 꼭 사야 한다면 수집 날짜, 검증 날짜, 동의 근거, 갱신 프로세스의 투명성을 요구하세요.
가장 좋은 무료 리드 리스트 구축 방법은 무엇인가요?
Google 고급 검색 연산자(site:, intitle:, 정확히 일치하는 검색어)와 Thunderbit의 무료 요금제 — 월 6페이지 AI 스크래핑과 무제한 무료 이메일/전화 추출 — 그리고 기본 LinkedIn 검색을 함께 쓰면 됩니다. 이 조합이면 회사 페이지, 디렉터리, 이벤트 리스트, 프로필을 돈 한 푼 안 쓰고 확보할 수 있습니다.
리드 리스트는 얼마나 자주 업데이트해야 하나요?
매 캠페인 전에 이메일을 재검증하세요. 특히 리스트가 30일 이상 됐다면 더 중요합니다. 최소 분기마다 한 번은 전체 갱신을 하세요. 소스를 다시 스크래핑하고, firmographics를 업데이트하고, 죽은 리드를 제거해야 합니다. ZeroBounce에 따르면 이메일 리스트의 최소 23%는 1년 안에 소멸하므로, 한 번 해두고 잊어버리는 방식은 반송률 상승의 지름길입니다.
리드 리스트를 활용한 콜드 아웃리치의 좋은 답장률은 어느 정도인가요?
20252026년 벤치마크 기준으로 보면, 긍정 답장률 35%는 괜찮고, 5~8%는 강하며, 8% 이상은 매우 훌륭합니다. 가장 큰 요인은 리스트 품질입니다. 타깃팅, 검증, 개인화가 핵심입니다. 검증된 이메일, 명확한 인텐트 신호, 개인화 메시지가 있는 잘 만든 리스트는, 일반적인 연락처와 뻔한 문구만 들어간 더 큰 리스트보다 꾸준히 더 좋은 성과를 냅니다.
더 알아보기



