
Craigslist는 2003년 이후 거의 바뀐 게 없어 보이지만, 단순한 텍스트 목록 안에 숨어 있는 데이터 가치는 생각보다 훨씬 큽니다. 월간 약 1억 2,700만 방문과 매달 수천만 건의 신규 게시물을 바탕으로 미국에서 가장 큰 분류 광고 플랫폼 중 하나로 여전히 굳건히 자리하고 있지만, 공용 API는 따로 제공하지 않습니다.
저는 Thunderbit에서 오랫동안 자동화 도구를 만들어 왔는데, 영업·운영·부동산 팀에서 제일 자주 듣는 말은 늘 비슷했습니다. “Craigslist 데이터를 스프레드시트로 옮겨야 하는데, 복사 붙여넣기만 3시간씩 하고 싶지는 않습니다.” 문제는 대부분의 “최고의 Craigslist 스크래퍼” 가이드가 너무 오래됐거나, 핵심 난관인 봇 차단 대응을 슬쩍 넘기거나, 그냥 도구 이름만 나열하고 실제 비교는 하지 않는다는 점입니다.
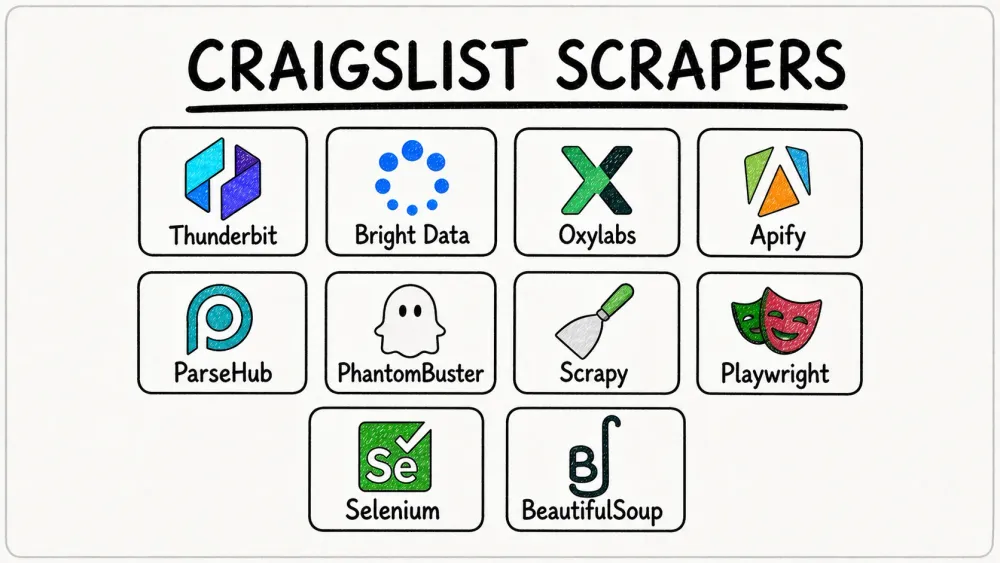
그래서 저는 2026년에도 실제로 잘 돌아가는 10가지 도구를 한자리에 모았습니다. 노코드 Chrome 확장 프로그램부터 엔터프라이즈급 프록시 플랫폼, 오픈소스 Python 라이브러리까지 전부 포함했습니다. 코드를 한 줄도 짜본 적 없는 비즈니스 사용자든, Python으로 작업하는 개발자든 여기서 필요한 도구를 찾을 수 있을 겁니다.
2026년에 왜 Craigslist를 스크래핑해야 할까? 비즈니스 팀을 위한 핵심 활용 사례
Craigslist는 오래된 서비스처럼 보이지만, 바로 그 점이 오히려 강점이자 가치입니다. 여전히 전 세계 분류 광고 사이트 순위 3위를 유지하고 있고, 공식 디렉터리 기준 미국 본토 및 지역 416개 사이트에서 운영됩니다. 다른 곳에서는 한 번에 찾기 어려운 초지역(local) 재고가 그만큼 많다는 뜻입니다.
제가 팀들에서 반복해서 본 활용 사례는 아래와 같습니다.
- 리드 생성: 서비스 및 구인 관련 게시물에는 업체 설명, 지역 정보, Craigslist 연락 경로가 들어 있는 경우가 많아 영업팀이 로컬 리드 리스트를 만들기에 충분합니다.
- 부동산 모니터링: 주거 페이지에는 임대료, 동네, 침실/욕실 수, 면적, 게시 시점이 보여서 임대 비교와 공실 추적에 딱 맞습니다.
- 경쟁 가격 조사: 판매 게시물에는 제목, 가격, 상태, 위치가 표시되어 중고 재판매나 차익거래 리서치에 아주 유용합니다.
- 채용 및 노동 시장 모니터링: Jobs와 gigs 카테고리에서는 보상, 고용 형태, 역할 설명을 확인할 수 있어 지역 인재 시장을 살피는 데 도움이 됩니다.
- 다지역 시장 분석: Craigslist는 서브도메인과 도시별로 나뉘어 있어, 지역별 가격·물량·카테고리 구성을 분석하기 좋습니다.
- 워크플로 자동화: 많은 사용자는 단순히 Craigslist 데이터를 CSV, Google Sheets, Airtable, CRM으로 넘기고 싶어 합니다. 수동으로 브라우징하는 것은 원하지 않습니다.
한 사용자는 매일 하던 Craigslist 스크래핑 작업이 예전에는 60~90분 걸렸는데, 자동화를 도입한 뒤 약 5분으로 줄었다고 했습니다. 이런 시간 절약은 금방 누적됩니다.
AI로 Craigslist 데이터 스크래핑하기 Thunderbit의 에이전틱 웹 스크래퍼가 Craigslist 목록 페이지를 직접 읽고, 가격·설명·연락처 정보를 1클릭으로 뽑아냅니다. Get Started Free
최고의 Craigslist 스크래퍼를 고른 기준: 평가 방법
모든 Craigslist 스크래퍼가 같은 수준은 아니고, “최고”의 기준은 사용자와 목적에 따라 달라집니다. 저는 각 도구를 다음 6가지 기준으로 살펴봤습니다.
- 설정 난이도 — 초보자도 바로 쓸 수 있는 노코드인지, 아니면 개발자가 필요한지?
- Craigslist 봇 차단 대응 — 내장 프록시 로테이션, CAPTCHA 처리, 브라우저 핑거프린팅 기능이 있는지?
- 가격 정책 — 무료, 프리미엄, 유료, 엔터프라이즈 중 어디에 해당하는지?
- 내보내기 옵션 — CSV, Excel, Google Sheets, Airtable, Notion, JSON, 데이터베이스 등을 지원하는지?
- 다지역 지원 — 미국 Craigslist 416개 사이트 전체를 스크래핑할 수 있는지, 아니면 도시 하나씩만 가능한지?
- 유지보수 부담 — Craigslist가 페이지 레이아웃을 바꾸면 깨지는지, 아니면 자동으로 적응하는지?
제가 찾은 다른 경쟁 글들 중에는 이렇게 같은 기준으로 나란히 비교한 자료가 거의 없었습니다. 그래서 막연한 “Top 10” 리스트에 지치셨다면, 이 글이 훨씬 도움이 될 겁니다.
한눈에 보는 최고의 Craigslist 스크래퍼 10선
각 도구를 자세히 보기 전에 전체 비교표부터 보겠습니다. 비즈니스 사용자용 노코드 도구, 확장성이 필요한 엔터프라이즈 플랫폼, 개발자용 오픈소스 라이브러리의 세 갈래로 나눴습니다.
| 도구 | 유형 | 무료 플랜? | 프록시 / 봇 차단 지원 | CAPTCHA 처리 | 내보내기 형식 | 추천 대상 |
|---|---|---|---|---|---|---|
| Thunderbit | 노코드 Chrome 확장 프로그램 | 예 (월 6페이지) | 브라우저 모드(중간 규모 작업은 프록시 불필요) | 해당 없음(브라우저 세션) | Excel, Sheets, Airtable, Notion, CSV, JSON | 비전문 비즈니스 사용자 |
| Bright Data | 엔터프라이즈 스크래퍼 + 프록시 + 데이터셋 | 체험판 | 관리형 차단 우회, 프록시, 재시도, 렌더링 | 예(자동 해결) | JSON, NDJSON, CSV, Parquet, XLSX, API | 엔터프라이즈 규모 수집 |
| Oxylabs | API + 프록시 스택 | 체험판 | 관리형 차단 우회, 주거용/ISP 프록시 | 예 | HTML, 스크린샷, API 출력 | 엔터프라이즈 인프라가 필요한 개발자 |
| Apify | 클라우드 액터 마켓플레이스 | 예($5/월 크레딧) | 프록시 로테이션(액터별 상이) | 부분적 / 액터별 | JSON, CSV, XML, Excel, JSONL | 유연한 로우코드 클라우드 자동화 |
| ParseHub | 노코드 시각적 스크래퍼 | 예 | 유료 프록시 로테이션, 클라우드 실행 | 핵심 기능 아님 | CSV, JSON, API/S3/Dropbox(유료) | 예산이 제한된 노코드 사용자 |
| Phantombuster | 클라우드 자동화 플랫폼 | 예(제한적) | 프록시 지원 있음 | 크레딧 / 워크플로 기반 | CSV, JSON(유료) | 멀티플랫폼 영업 자동화 |
| Scrapy | 오픈소스 Python 크롤러 | 무료(OSS) | 직접 프록시/미들웨어 구성 | 없음 | JSON, JSONL, CSV, XML, DB | 프로덕션 크롤러 |
| Playwright | 오픈소스 브라우저 자동화 | 무료(OSS) | 직접 브라우저/프록시 구성 | 없음 | 사용자 정의 내보내기 | 브라우저 수준 제어 |
| Selenium | 오픈소스 브라우저 자동화 | 무료(OSS) | 직접 브라우저/프록시 구성 | 없음 | 사용자 정의 내보내기 | 레거시 멀티언어 스택 |
| BeautifulSoup | 오픈소스 HTML 파서 | 무료(OSS) | 자체 기능 없음 | 없음 | 사용자 정의 내보내기 | 가벼운 파싱 |
여기서 세 가지 흐름이 딱 보입니다.
- 노코드 도구(Thunderbit, ParseHub, Phantombuster): 엔지니어링 부담 없이 데이터를 얻고 싶은 비즈니스 사용자용.
- 엔터프라이즈 플랫폼(Bright Data, Oxylabs, Apify): 대규모 처리, 봇 차단 대응, 관리형 전달이 필요한 팀용.
- 오픈소스 개발자 도구(Scrapy, Playwright, Selenium, BeautifulSoup): 제어력은 가장 높지만 설정·유지보수·프록시 관리 부담도 큽니다.
이제 본격적으로 보겠습니다.
1. Thunderbit
 Thunderbit은 Craigslist를 포함한 어떤 웹사이트든 코드나 프록시 설정 없이 구조화된 데이터를 얻고 싶은 사람들을 위해 만든 AI 기반 Chrome 확장 프로그램입니다.
조금 편파적일 수도 있습니다. 저희가 직접 만든 도구이기 때문입니다. 하지만 Thunderbit을 1순위로 둔 이유는 Craigslist 스크래핑에서 비전문 사용자가 겪는 핵심 문제를 정확히 풀어주기 때문입니다. 카테고리마다 다른 페이지 구조, 상세 페이지 추가 추출, CSS 선택자가 바뀔 때마다 생기는 반복적인 오류까지 해결해 줍니다.
Craigslist에서의 사용 방식:
- Thunderbit Chrome Extension을 설치하고 Craigslist 목록 페이지를 엽니다(예: 내 도시의 아파트).
- **"One Click Extract"**를 클릭합니다. Thunderbit의 AI가 페이지를 읽고 구조를 파악한 뒤, 알맞은 열을 판단해서 한 번에 표로 추출합니다. 주거 카테고리라면 Title, Price, Sqft, Bedrooms, Location, Date Posted, Link가 나옵니다. 구인 카테고리라면 Title, Compensation, Job Type 등이 추출됩니다. 수동 셀렉터 설정은 필요 없습니다.
- 페이지네이션을 처리합니다. Thunderbit은 Craigslist의 클릭 기반 페이지 이동과 잘 맞습니다.
- **"Scrape Subpages"**를 사용해 각 개별 게시글로 들어가 상세 페이지 전용 항목을 추출합니다. 전체 설명, 모든 이미지, 포함된 연락처 정보 등이 여기에 해당합니다.
- Google Sheets, Excel, Airtable, Notion 또는 CSV로 내보냅니다. 무료로 가능합니다.
핵심 기능:
- AI 기반 필드 감지: 카테고리에 맞춰 자동으로 적응합니다. 주거는 면적/침실 열, 구인은 보상/직무 유형 열, 판매는 상태/가격 열을 자동으로 구성합니다. CSS 작업이 전혀 필요 없습니다.
- 서브페이지 스크래핑: 결과 페이지를 스크래핑한 뒤 각 게시글로 들어가 상세 페이지 필드까지 추출할 수 있습니다(전체 설명, 이미지, 연락처 등).
- 브라우저 기반 스크래핑 모드: 본인 Chrome 세션 안에서 실행되므로 중간 규모 작업에서는 프록시가 필요 없습니다. 비용과 복잡성을 크게 줄여 줍니다.
- 유지보수 거의 없음: AI가 매번 페이지를 새로 읽습니다. Craigslist가 레이아웃을 바꿔도 스크래퍼가 쉽게 깨지지 않습니다.
- 무료 내보내기: Excel, Google Sheets, Airtable, Notion, CSV, JSON까지 모두 가능하며, 내보내기 자체에는 별도 유료 장벽이 없습니다.
가격: 무료 플랜(월 6페이지), 무료 체험(10페이지), 더 많은 작업량을 위한 유료 플랜.
추천 대상: Craigslist의 서비스/구인 게시물에서 리드를 추출하는 영업팀, 임대 가격을 모니터링하는 부동산 팀, 개발자 도움 없이 구조화된 Craigslist 데이터가 필요한 운영팀, 그리고 한 번에 스크래핑·라벨링·내보내기를 끝내고 싶은 사용자.
Craigslist 스크래핑용 Thunderbit 체험하기 무료 플랜으로 월 6페이지까지 지원하므로, 유료 전환 전에 Craigslist 스크래핑을 테스트하기에 충분합니다. Get Started Free
2. Bright Data
 Bright Data는 대형 엔터프라이즈용 옵션입니다. 이 리스트에서 Craigslist Scraper 제품 페이지와 Craigslist Dataset 마켓플레이스를 모두 갖춘 유일한 플랫폼입니다.
전 미국 지역을 대상으로 매일 수천 건의 Craigslist 게시물을 스크래핑해야 한다면, Bright Data는 그 규모를 전제로 설계되어 있습니다. Web Unlocker는 IP, 재시도, 렌더링, 차단 대응을 처리하고, 기본적으로 CAPTCHA 자동 해결까지 지원합니다. Web Scraper IDE로 맞춤형 Craigslist 수집 워크플로를 만들 수 있고, 416개 지역 URL을 프로그램적으로 순회할 수도 있습니다.
핵심 기능:
- 대규모 주거용 프록시 네트워크(수백만 개 IP)
- 내장 CAPTCHA 해결 및 봇 차단 우회
- Craigslist 전용 스크래퍼 및 데이터셋 제품
- 내보내기: JSON, NDJSON, CSV, Parquet, XLSX, API 전달, 웹훅
가격: Craigslist 스크래퍼는 페이지 로드 1,000회당 $0.5 수준의 사용량 기반 요금이며, 38만 페이지 로드가 $499인 플랜도 있습니다. 주거용 프록시는 GB당 $4부터 사용량 기반으로 책정됩니다. 1주일간 1,000건 요청 무료 체험도 제공합니다.
추천 대상: 고가용성 보장과 전담 지원이 필요한 엔터프라이즈 팀, 특히 다지역·고용량 Craigslist 수집이 필요한 경우. 예산이 빠듯한 소규모 팀에는 적합하지 않습니다.
3. Oxylabs
 Oxylabs는 프리미엄 프록시 및 스크래핑 인프라 제공업체로, 전용 Craigslist Scraper API와 Craigslist proxies 페이지를 운영합니다.
Oxylabs는 Bright Data보다 올인원보다는 개발자 지향에 가깝습니다. Web Scraper API와 Web Unblocker는 JS 렌더링, 재시도, 세션 처리, 핑거프린트 생성, 폭넓은 봇 차단 대응을 지원합니다. Craigslist Scraper API 무료 체험은 최대 2,000개 결과까지 가능합니다.
핵심 기능:
- 주거용 및 ISP 프록시 풀(주거용은 GB당 $6부터, ISP는 IP당 $0.60부터)
- 자동 핑거프린트 및 세션 관리가 포함된 Web Unblocker
- Craigslist 전용 API 엔드포인트
- 7일 무료 체험 제공
가격: “Other sites”용 scraper API는 JS 없이 1,000 결과당 약 $0.15, JS 포함 시 약 $0.35부터 시작합니다. Web Unblocker 미니 티어는 월 약 $75부터입니다. 대규모 주거용 프록시는 1TB 기준 GB당 $0.50 수준까지 내려갈 수 있습니다.
추천 대상: 관리형 프록시 인프라와 API 기반 워크플로로 꾸준히 Craigslist를 스크래핑하고 싶은 개발팀. 다른 프로젝트에서도 이미 Oxylabs 프록시를 쓰고 있다면 Craigslist를 추가하기도 쉽습니다.
4. Apify
 Apify는 사전 제작된 “Actors”(코드 없이 실행 가능한 스크래퍼 템플릿) 마켓플레이스를 갖춘 클라우드 기반 웹 스크래핑 및 자동화 플랫폼입니다.
Apify의 Craigslist 환경은 꽤 흥미롭습니다. 커뮤니티가 관리하는 Craigslist 액터가 여러 개 있는데, 품질 차이가 꽤 큽니다. ivanvs/craigslist-scraper 액터는 누적 사용자 829명에 평점 5.0인 반면, automation-lab/craigslist-scraper는 사용자 44명에 평점 1.0입니다. 편차가 큰 만큼, 본격 도입 전에는 반드시 테스트해 봐야 합니다.
핵심 기능:
- 다양한 Craigslist 액터 제공(일부는 페이지당 약 120개 목록을 내장 지연과 함께 추출)
- 클라우드 실행, 예약 실행, API 접근, 웹훅 연동
- 프록시 로테이션 지원
- 내보내기: JSON, CSV, XML, Excel, JSONL
가격: 월 $5 크레딧이 포함된 무료 플랜, 유료 플랜은 약 월 $49부터 시작합니다. 다만 사용량이 많아지면 컴퓨트 기반 요금이 빠르게 올라갈 수 있으니 CU 소비량을 꼭 살펴봐야 합니다.
추천 대상: 인프라를 직접 관리하지 않는 클라우드형 솔루션이 필요한 팀, 로우코드 설정에 익숙한 사용자, 예약·반복 스크래핑이 필요한 팀.
5. ParseHub
 ParseHub는 페이지 요소를 클릭해서 추출 대상을 지정하는 데스크톱 기반 시각적 웹 스크래핑 도구입니다.
ParseHub에서 Craigslist 스크래핑을 설정하려면 목록 제목·가격·링크를 클릭해서 도구에 무엇을 가져와야 하는지 알려주면 됩니다. AJAX 클릭 루프로 페이지 이동을 처리하고, 유료 플랜에서는 클라우드 실행도 지원합니다. 무료 플랜은 최대 5개 프로젝트까지 제공되어 소규모 Craigslist 작업에는 꽤 괜찮습니다.
핵심 기능:
- 시각적 포인트 앤 클릭 워크플로 빌더
- 페이지네이션 및 동적 콘텐츠 처리
- 유료 플랜의 클라우드 실행 및 예약 기능
- 내보내기: CSV, Excel, JSON
가격: 무료 플랜(5개 프로젝트), 더 많은 페이지와 예약 실행이 필요하면 월 약 $189부터 시작하는 유료 플랜.
한계: 대규모 스크래핑에서는 느릴 수 있고, 무료 플랜의 예약 실행이 제한적이며, 무엇보다 CSS 선택자 기반이라 Craigslist 레이아웃이 바뀌면 수동 유지보수가 필요합니다.
추천 대상: 중간 규모 수요가 있는 개인 사용자나 소규모 팀으로, AI 기반 필드 감지는 필요 없지만 시각적 노코드 도구를 원하는 경우.
6. Phantombuster
 Phantombuster는 원래 LinkedIn과 소셜 미디어 스크래핑으로 유명해진 클라우드 자동화 플랫폼입니다. Craigslist 전용 도구는 아니지만, Web Element Extractor로 CSS 선택자를 이용해 공개 페이지를 스크래핑할 수 있습니다.
Phantombuster에서 Craigslist 스크래핑을 설정하려면 전용 도구보다 손이 더 갑니다. 셀렉터를 지정하고, 워크플로를 구성하고, 예약도 설정해야 합니다. 하지만 이미 LinkedIn이나 소셜 미디어 리드 생성용으로 Phantombuster를 쓰고 있다면, Craigslist를 파이프라인에 추가하는 건 어렵지 않습니다.
핵심 기능:
- 사전 제작된 자동화 템플릿과 클라우드 실행
- 예약 기능 및 CRM 연동
- 프록시 지원과 CAPTCHA 해결 크레딧 제공
- 내보내기: 유료 플랜에서 CSV, JSON 지원(무료 플랜은 10행 제한)
가격: 5개 슬롯, 월 2시간, 10행 내보내기 제한이 있는 무료 플랜. 연간 청구 기준 유료 플랜은 월 약 $56부터 시작합니다.
추천 대상: 이미 Phantombuster로 멀티플랫폼 리드 생성을 하고 있고, Craigslist도 같은 워크플로에 넣고 싶은 영업팀.
7. Scrapy
 Scrapy는 가장 널리 쓰이는 오픈소스 Python 웹 스크래핑 프레임워크로, Craigslist 크롤링을 최대한 세밀하게 제어하고 싶은 개발팀에 가장 무난한 선택입니다.
최신 안정 버전은 2.15.0(2026년 4월 9일)입니다. Scrapy는 다지역 크롤링(모든 지역 URL 순회), 기본 요청 스케줄링 및 스로틀링, 프록시 로테이션을 위한 다운로더 미들웨어, CSV·JSON·JSONL·XML·데이터베이스 파이프라인으로의 피드 내보내기를 지원합니다. 필요할 때는 scrapy-playwright 플러그인으로 브라우저 수준 렌더링도 추가할 수 있습니다.
핵심 기능:
- 고도로 커스터마이징 가능한 프로덕션급 크롤러
- 프록시, 재시도, 쿠키, user-agent 로테이션용 미들웨어
- 피드 내보내기: JSON, JSONL, CSV, XML, 데이터베이스 파이프라인
- 무료 및 오픈소스
숨은 비용: Scrapy 자체는 무료지만, Craigslist에서 대규모로 돌리려면 프록시 구독료(월 $50~500+), 호스팅/서버 비용, 그리고 Craigslist가 HTML 구조를 바꿀 때마다 들어가는 유지보수가 필요합니다.
추천 대상: Python 경험이 있는 개발팀, 최대한의 유연성과 기존 프록시 인프라가 필요한 경우, 고용량 다지역 Craigslist 크롤링을 해야 하는 경우.
8. Playwright
 Playwright는 Microsoft가 만든 현대적인 브라우저 자동화 라이브러리로, Chromium, Firefox, WebKit을 프로그램적으로 제어합니다. 현재 배포 속도도 활발해서 v1.59.1은 2026년 4월 1일에 출시되었습니다.
2026년 개발자 커뮤니티에서는 Craigslist 스크래핑용으로 Selenium보다 Playwright를 더 많이 추천하는 분위기입니다. 더 빠르고, 더 안정적이며, playwright-extra 같은 커뮤니티 플러그인을 활용하면 탐지 회피도 더 좋습니다. headless/헤드풀 모드, 요소 자동 대기, 네트워크 가로채기, 스크린샷/PDF 캡처를 지원합니다.
핵심 기능:
- Python, JavaScript/TypeScript, Java, .NET 지원
- 헤드리스 및 헤드풀 브라우저 모드
- 요소 자동 대기, 네트워크 가로채기
- 무료 및 오픈소스
Craigslist에서의 장점: Playwright는 단순 HTTP 요청보다 실제 사용자 행동을 더 자연스럽게 흉내 낼 수 있어 차단 위험을 줄여 줍니다. Reddit에서도 신규 프로젝트에서는 Playwright를 선호하는 흐름이 꾸준합니다.
숨은 비용: Scrapy와 마찬가지로 프록시 비용, 호스팅, 셀렉터가 깨질 때 들어가는 유지보수가 필요합니다.
추천 대상: 정교한 브라우저 제어가 필요한 개발자, JavaScript 렌더링 콘텐츠를 다루는 스크래퍼를 만드는 팀, Selenium의 현대적 대안을 찾는 사용자.
9. Selenium
 Selenium은 오래전부터 널리 쓰여 온 브라우저 자동화 프레임워크입니다. 최신 릴리스는 4.43.0(2026년 4월 10일)이며, BiDi와 네트워크 제어 기능도 계속 확장되고 있습니다.
Selenium은 여러 언어(Python, Java, C#, JavaScript)와 주요 브라우저를 모두 지원합니다. 전체 브라우저 세션을 시뮬레이션하고, 필요하면 로그인도 처리하고, 페이지를 스크롤하는 데 적합합니다. 다만 Playwright와 비교하면 더 느리고, 코드가 장황하며, undetected-chromedriver 같은 추가 스텔스 라이브러리 없이는 봇으로 탐지되기 쉽습니다.
핵심 기능:
- 멀티언어 지원(Python, Java, C#, JavaScript)
- 전체 브라우저 세션 시뮬레이션
- 문서가 풍부한 성숙한 생태계
- 무료 및 오픈소스
한계: 2026년 커뮤니티 분위기는 신규 프로젝트에서 Playwright를 더 선호합니다. 한 Reddit 스레드에서는 주거용 프록시를 써도 Cloudflare가 Selenium을 여전히 탐지했다고 언급하기도 했습니다. 기본적인 스텔스는 쉽지 않다는 뜻입니다.
추천 대상: 이미 Selenium에 투자해 있어 마이그레이션하고 싶지 않은 개발팀, 멀티언어 지원(Java, C#)이 필요한 프로젝트, 레거시 스크래핑 환경.
10. BeautifulSoup
 BeautifulSoup은 HTML과 XML을 파싱하는 가벼운 Python 라이브러리입니다. 현재 PyPI 버전은 4.14.3(2025년 11월 30일)입니다.
중요한 점 하나: BeautifulSoup은 파서이지, 완전한 스크래퍼가 아닙니다. 웹페이지를 가져오거나 브라우저 자동화를 처리하지 않습니다. 보통 requests 라이브러리와 함께 사용해 HTML을 받아오고, 그 HTML을 파싱합니다. 그래서 개발자 입장에서는 가장 쉽게 시작할 수 있지만, 기능은 가장 제한적입니다.
핵심 기능:
- 배우기 매우 쉬움 — 최소한의 코드로 시작 가능
- 소규모 또는 일회성 Craigslist 스크래핑에 적합
- 무료 및 오픈소스
한계: 페이지네이션 처리, JavaScript 렌더링, 프록시 로테이션이 내장되어 있지 않아 전부 직접 붙여야 합니다. Craigslist가 HTML 구조를 바꾸면 셀렉터가 깨지고, 직접 고쳐야 합니다.
추천 대상: 최소한의 설정으로 Craigslist 스크래핑을 한번 시도해 보고 싶은 Python 초보자, 단일 카테고리나 지역에서 빠르게 한 번만 데이터를 뽑아야 하는 경우, 가벼운 파서만 필요한 개발자.
Craigslist 차단 회피 전략: 프록시, 속도 제한, 그리고 막히는 이유
이 부분은 대부분의 Craigslist 스크래핑 가이드가 빼먹지만, 사실 가장 중요한 내용입니다. Scraperly의 2026년 4월 테스트는 Craigslist를 난이도 3/5 대상으로 분류하면서, 커스텀 CAPTCHA, 속도 제한, IP 차단을 이유로 들었습니다. Bright Data의 튜토리얼도 일반 HTTP 요청보다 Web Unlocker나 Playwright 기반 Scraping Browser를 권장합니다. Oxylabs의 프록시 페이지 역시 Craigslist가 프록시를 탐지할 수 있으며, 주거용 프록시가 가장 좋은 선택이라고 설명합니다.
실제로 잘 먹히는 방법은 다음과 같습니다.
| 전략 | Craigslist에서의 효과 | 비용 | 복잡도 |
|---|---|---|---|
| 주거용 프록시 | ✅ 높음 | $$ (GB당 $4~6) | 중간 |
| ISP 프록시 | ✅ 높음 | $ (IP당 $0.60~0.80) | 중간 |
| 데이터센터 프록시 | ⚠️ 낮음(자주 차단됨) | $ (IP당 $0.20~0.40) | 낮음 |
| 브라우저 기반 스크래핑(자체 세션) | ✅ 중간~높음 | 무료 | 낮음 |
| 속도 제한 + 랜덤 지연 | ✅ 필수 기본값 | 무료 | 낮음 |
실행 팁:
- 요청 간 지연: 최소 2
5초는 두어야 합니다. Scraperly는 IP당 분당 510회 요청 수준을 유지하고, 20~30회마다 로테이션하라고 권장합니다. - 세션 로테이션: user-agent와 브라우저 핑거프린트를 바꿔야 합니다. 예측 가능한 크롤링 패턴은 빠르게 잡힙니다.
- 데이터센터 프록시는 피하기: 싸긴 하지만 Craigslist에서는 금방 막힙니다.
- 중간 규모 작업에서는 브라우저 기반 스크래핑이 프록시 문제를 거의 없앱니다. Thunderbit의 브라우저 모드는 본인 Chrome 세션 안에서 작동하므로 프록시 설정, IP 로테이션, 추가 비용이 필요 없습니다. 수백 개 정도의 게시물을 스크래핑하는 대부분의 비즈니스 사용자에게는 충분합니다.
그리고 많은 사람이 놓치는 유지보수 이슈가 하나 더 있습니다. Craigslist가 CSS를 바꾸면(실제로 주기적으로 바꿉니다), CSS 선택자 기반 스크래퍼는 전부 깨집니다. 페이지를 열어 새 선택자를 찾고, 코드를 수정하고, 다시 테스트해야 합니다. Thunderbit 같은 AI 기반 도구는 이 문제를 피합니다. AI가 매번 페이지 구조를 새로 읽기 때문에 레이아웃 변경이 워크플로를 망치지 않습니다.
코드 vs. 노코드: Craigslist 스크래핑 전체 실습 2가지
이 글의 독자는 대략 반반이라고 봅니다. 데이터를 빨리 얻고 싶은 비전문 비즈니스 사용자와, 실제로 돌아가는 코드를 원하는 초중급 개발자입니다. 그래서 두 경로를 나란히 소개하겠습니다.
노코드: Thunderbit로 Craigslist 스크래핑하는 방법(단계별)
- Chrome Web Store에서 Thunderbit Chrome Extension을 설치합니다.
- Craigslist 목록 페이지로 이동합니다. 예를 들어 내 도시의 아파트 페이지(
https://yourcity.craigslist.org/search/apa)를 엽니다. - **"One Click Extract"**를 클릭합니다. Thunderbit의 AI가 페이지를 읽고 구조를 파악한 뒤, 카테고리에 맞는 열을 결정해 구조화된 표를 한 번에 채웁니다. 주거 카테고리라면 Title, Price, Sqft, Bedrooms, Location, Date Posted, Link가 보입니다. 원하면 이후 열을 조정할 수 있습니다.
- 페이지네이션을 처리합니다. 페이지를 넘기거나 Thunderbit이 자동으로 처리하게 둘 수 있습니다.
- **"Scrape Subpages"**를 사용해 각 게시글로 들어가 상세 페이지 필드를 더합니다. 전체 설명, 모든 이미지, 포함된 연락처 정보가 여기에 해당합니다.
- Google Sheets, Excel, Airtable, Notion 또는 CSV로 내보냅니다. 무료입니다.
전체 과정은 결과 페이지 한 장 기준 약 2분 정도면 끝납니다. CSS 선택자도, 프록시도, 코드도 필요 없습니다.
코드 경로: Python + Playwright로 Craigslist 스크래핑하는 방법
2026년 개발자 커뮤니티에서 Craigslist 스크래핑용으로 가장 많이 추천되는 라이브러리는 Playwright입니다. 아래는 Craigslist 주거용 결과 페이지에서 제목/가격/링크를 추출하고, 페이지네이션을 처리해 결과를 출력하는 Python 예제입니다.
접근 방식은 이렇습니다. 먼저 JSON-LD 구조화 데이터를 시도하고(일부 페이지에는 Craigslist가 ItemList 스키마를 넣어 둡니다), 실패하면 DOM 셀렉터로 넘어갑니다. 페이지네이션은 s=120으로 진행합니다.
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # 먼저 JSON-LD 시도
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # DOM 셀렉터로 폴백
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # 3페이지 스크래핑
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
이 스크립트 외에 필요한 것: Playwright 설치(pip install playwright && playwright install), 고용량 작업용 프록시 설정, 그리고 속도 제한에 걸릴 경우 수동 CAPTCHA 처리입니다. 즉, 완전한 제어를 얻는 대신 완전한 책임도 져야 한다는 뜻입니다.
무료 vs. 유료: 각 Craigslist 스크래퍼의 솔직한 비용 분석
이 주제를 조사하기 시작했을 때 이런 표가 있었으면 좋겠다고 느꼈습니다. 웹 스크래핑에서 “무료”는 꽤 복잡한 말입니다.
| 도구 | 완전 무료? | 무료 플랜 제한 | 유료 시작가 | 숨은 비용 |
|---|---|---|---|---|
| Thunderbit | 무료 플랜 있음(6페이지) | 월 6페이지; 무료 체험은 10페이지 | 고용량용 유료 플랜 | 없음—내보내기 무료 |
| Scrapy | ✅ 오픈소스 | 무제한 | $0 | 프록시, 호스팅, 유지보수 비용 |
| BeautifulSoup | ✅ 오픈소스 | 무제한 | $0 | 프록시, 호스팅, 유지보수 비용 |
| Playwright | ✅ 오픈소스 | 무제한 | $0 | 프록시, 호스팅, 유지보수 비용 |
| Selenium | ✅ 오픈소스 | 무제한 | $0 | 프록시, 호스팅, 유지보수 비용 |
| ParseHub | 무료 플랜 있음 | 5개 프로젝트 | 약 $189/월 | 무료 플랜의 예약 실행 제한 |
| Apify | 무료 플랜 있음 | 월 $5 크레딧 포함 | 약 $49/월 | 컴퓨트 기반 요금이 급증할 수 있음 |
| Phantombuster | 무료 플랜 있음 | 5개 슬롯, 월 2시간, 10행 내보내기 | 약 $56/월(연간) | 슬롯 기반 과금 |
| Bright Data | 체험판만 | 1,000 요청/1주 | 약 $500+/월 | 프록시 비용 별도 |
| Oxylabs | 체험판만 | 2,000 결과 / 1GB | 약 $75+/월(Unblocker) | 엔터프라이즈 요금제 |
오픈소스 도구의 “무료”에는 꼭 별표가 붙습니다. Scrapy, Playwright, Selenium, BeautifulSoup은 설치 비용은 $0이지만, Craigslist를 대규모로 돌리려면 설정에 들어가는 개발자 시간, 주거용 프록시 비용(월 $50~500+), 그리고 Craigslist가 HTML을 바꿀 때마다 들어가는 유지보수가 필요합니다. Thunderbit은 AI가 매번 페이지를 새로 읽기 때문에 유지보수가 거의 없고, 내보내기도 무료이며, 브라우저 기반 스크래핑으로 중간 규모 작업에서는 프록시 비용도 아낄 수 있습니다. 비개발자에게는 꽤 큰 장점입니다.
실제로 추출 가능한 것: Craigslist 카테고리별 데이터 필드
Craigslist의 카테고리마다 데이터 구조는 완전히 다릅니다. 주거용 목록은 구인 공고와 아예 다릅니다. 아래는 각 주요 섹션에서 현실적으로 추출할 수 있는 항목입니다.
| Craigslist 카테고리 | 추출 가능한 필드 | 연락처 정보 제공? |
|---|---|---|
| 주거 / 아파트 | 제목, 가격, 면적, 침실 수, 욕실 수, 위치, 날짜, 이미지, 설명, 지도 링크, 가능 여부, 반려동물 정책, 세탁/주차 정보 | ⚠️ 때때로(익명 이메일 릴레이) |
| 판매 | 제목, 가격, 상태, 위치, 날짜, 이미지, 설명, 제조사/모델/연식(카테고리별 상이) | ⚠️ 때때로 |
| 채용 | 제목, 회사, 보상, 위치, 고용 형태, 경력 수준, 날짜, 설명 | 드묾(지원 링크만 있는 경우가 많음) |
| 서비스 | 제목, 위치, 설명, 이미지 | ⚠️ 때때로 |
| Gigs | 제목, 보상, 위치, 날짜, 설명 | ⚠️ 때때로 |
몇 가지 꼭 알아둘 점이 있습니다.
- 연락처 정보: Craigslist는 직접 이메일 스크래핑을 막기 위해 익명화된 이메일 릴레이를 사용합니다. “이메일 추출”을 한다고 하는 도구는 실제 이메일이 아니라 릴레이 주소(
reply+randomstring@craigslist.org)를 가져오는 경우가 많습니다. - 상세 페이지 필드인 전체 설명, 모든 이미지, 포함된 연락처 정보는 검색 결과 페이지가 아니라 각 게시글을 직접 열어야만 보입니다.
- **Thunderbit의 "One Click Extract"**는 현재 페이지에서 사용할 수 있는 필드를 자동으로 감지하고, 알맞은 열 구성을 제안합니다. 주거 페이지를 스크래핑하면 면적/침실 열이 나오고, 구인 페이지를 스크래핑하면 보상/직무 유형 열이 자동으로 맞춰집니다. 수동 설정은 필요 없습니다. 이후 서브페이지 스크래핑을 통해 각 게시글을 방문해 상세 페이지 전용 필드를 가져옵니다.
법적 현실 체크: Craigslist 이용약관, 3Taps 사건, 그리고 알아야 할 것들
저는 변호사가 아니며, 이것은 법률 자문이 아닙니다. 하지만 많은 사용자가 이 부분을 걱정하므로, 솔직하게 짚고 넘어가겠습니다.
핵심 판례: Craigslist v. 3Taps(2013)에서 Craigslist는 중단 및 금지 요청 이후 3Taps가 게시글을 스크래핑하고 재게시한 행위에 대해 금지 명령을 받아냈습니다. 3Taps는 프록시 서버를 이용해 IP 차단을 우회한 것으로 알려졌고, 법원은 차단 이후의 접근을 잠재적으로 “무단”으로 판단했습니다. EFF는 이 사건이 2015년에 합의로 끝났다고 언급했습니다.
Craigslist 이용약관은 사이트와 상호작용할 때 “robots, spiders, scripts, scrapers, crawlers, or any automated or manual equivalent” 사용을 명시적으로 금지합니다. 또 24시간 동안 처음 1,000페이지를 넘겨 위반할 경우 페이지당 $0.25의 손해배상액까지 규정하고 있습니다.
실무 가이드:
- ✅ 공개 게시글 데이터를 시장 조사나 개인 용도로 수집
- ✅ robots.txt와 속도 제한 준수
- ⚠️ 스크래핑한 게시글을 대량 재게시하지 말 것
- ⚠️ 스크래핑한 연락처를 무단 마케팅에 사용하지 말 것
- ❌ 차단된 뒤 기술적 접근 제한을 우회하지 말 것
중요한 차이는 분명합니다. 공개된 데이터를 본인 분석용으로 수집하는 것과, 대량 재게시나 스팸용 이메일 수집은 다릅니다. 다만 Craigslist는 과거에 약관 집행에서 IP 차단, 그리고 법적 조치까지 수위를 높여 온 전례가 있다는 점은 꼭 알아둬야 합니다.
그렇다면 어떤 Craigslist 스크래퍼가 당신에게 맞을까?
10개 도구를 모두 테스트하고 평가한 뒤, 저는 시나리오별로 이렇게 추천합니다.
- 코드 없이 빠르게 Craigslist 데이터가 필요한 비전문 비즈니스 사용자 → Thunderbit. 노코드, AI 기반 필드 감지, 유지보수 거의 없음, 무료 내보내기. “이 데이터를 구해야 해”에서 “스프레드시트에 들어갔네”까지 가장 빠른 경로입니다.
- 전 지역에서 매일 수천 건을 스크래핑하는 엔터프라이즈 팀 → Bright Data. Craigslist 전용 스크래퍼, 대규모 프록시 인프라, 자동 CAPTCHA 해결, 전담 지원.
- 관리형 API/프록시 인프라가 필요한 개발팀 → 프록시 우선 워크플로에는 Oxylabs, 액터 마켓플레이스의 유연성이 필요하면 Apify.
- 완전한 제어와 커스터마이징이 필요한 개발자 → Scrapy + Playwright. 오픈소스이며 가장 유연하지만, 프록시와 유지보수는 직접 챙겨야 합니다.
- 예산이 빠듯하지만 중간 규모 수요가 있는 사용자 → Apify 무료 플랜($5/월 크레딧) 또는 ParseHub 무료 플랜(5개 프로젝트).
- 이미 멀티플랫폼 리드 생성 도구를 쓰는 영업팀 → Phantombuster. 기존 파이프라인에 Craigslist를 추가하면 됩니다.
- 한 번만 스크래핑하려는 Python 초보자 → BeautifulSoup + requests. 코드도, 설정도, 기능도 최소화됩니다.
대부분의 비전문 비즈니스 사용자에게는 Thunderbit이 편의성, 정확도, 비용의 균형이 가장 좋습니다. 개발자라면 Scrapy + Playwright 조합이 가장 강력합니다. 엔터프라이즈 규모에서는 Bright Data를 넘기 어렵습니다.
AI 기반 Craigslist 스크래핑이 실제로 어떤 모습인지 보고 싶다면 Thunderbit을 한번 사용해 보시기 바랍니다. 무료 플랜만으로도 본인 사례에 충분히 테스트할 수 있습니다. 더 깊이 있는 웹 스크래핑 기법이 궁금하다면 Google Sheets로 스크래핑하는 방법, 최고의 자동 웹 스크래핑 도구, 차단 없이 웹 스크래핑하는 방법 가이드를 참고하시기 바랍니다. YouTube 채널에서 단계별 영상도 볼 수 있습니다.
즐거운 스크래핑 되시길 바랍니다. 데이터는 언제나 깔끔하고, 구조화되어 있으며, 바로 활용 가능한 상태이길!
자주 묻는 질문
Craigslist 목록을 스크래핑하는 것은 합법입니까?
Craigslist 이용약관은 자동 스크래핑을 명시적으로 금지하고, Craigslist v. 3Taps 사건이 대표적인 법적 선례입니다. 공개 목록 데이터를 개인적 또는 분석용으로 스크래핑하는 것과 대량 재게시나 스팸은 보통 다르게 취급되지만, 항상 속도 제한과 사이트 규칙을 지켜야 하며, 이 내용은 법률 자문이 아닙니다.
코딩 없이 Craigslist를 스크래핑할 수 있습니까?
네. Thunderbit, ParseHub, Apify 같은 도구는 Craigslist 데이터를 추출할 수 있는 노코드 또는 로우코드 옵션을 제공합니다. 특히 Thunderbit의 AI 기반 필드 감지는 정말 쉽습니다. 그냥 “One Click Extract”를 누르고 “Scrape” 하면 됩니다.
가장 좋은 무료 Craigslist 스크래퍼는 무엇입니까?
개발자라면 Scrapy나 BeautifulSoup가 완전히 무료이고 오픈소스입니다(다만 프록시와 유지보수 비용은 듭니다). 비개발자라면 Thunderbit의 무료 플랜(월 6페이지)이 가장 좋은 출발점이고, ParseHub 무료 플랜(5개 프로젝트)도 대안이 됩니다.
Craigslist에서 차단을 피하려면 어떻게 해야 합니까?
속도 제한(최소 2~5초 지연), user-agent 로테이션, 데이터센터 프록시 회피(Craigslist에서는 주거용 또는 ISP 프록시가 훨씬 유리함), 예측 가능한 크롤링 패턴 피하기가 중요합니다. 중간 규모 작업에서는 Thunderbit 같은 브라우저 기반 도구를 쓰면 본인 Chrome 세션 안에서 작동하므로 프록시 문제를 아예 우회할 수 있습니다.
Craigslist의 모든 지역을 한 번에 스크래핑할 수 있습니까?
Scrapy나 Playwright 같은 개발자 도구를 쓰면 미국/지역 416개 URL을 프로그램적으로 순회할 수 있습니다. Bright Data와 Oxylabs 같은 엔터프라이즈 도구는 다지역 스크래핑이 기본입니다. Thunderbit에서는 각 지역 사이트를 열어 같은 워크플로로 스크래핑하면 되고, AI가 각 페이지에 자동으로 적응합니다.
Craigslist 스크래핑용 Thunderbit 체험하기 Get Started Free
더 알아보기



