
지난달에 제 친구 Stripe 연동이 금요일 밤 11시에 별다른 경고도 없이 503 오류를 내기 시작했습니다. 아무도 몰랐고, 토요일 아침이 되어서야 상황을 파악했는데, 그때는 이미 결제 실패에 화가 난 고객 이메일이 200통 넘게 지원 메일함에 쏟아진 뒤였습니다.
이런 얘기는 전혀 낯설지 않습니다. 널리 인용되는 벤치마크에 따르면 평균 다운타임 비용은 분당 5,600달러에 이르고, 큰 장애는 시간당 수백만 달러까지 번질 수 있습니다. 실제 손실 규모는 트래픽, 전환율, 주문 금액, SLA 노출, 복구 비용에 따라 달라지지만, 방향은 분명합니다. 모니터링되지 않는 API는 단순한 개발 불편이 아니라 비즈니스 리스크입니다. 게다가 현재 조직들은 평균 131개의 서드파티 API를 운영하고 있고, 서드파티 API 리스크를 충분히 완화할 수 있다고 답한 비율은 16%에 불과합니다. 이제 API 모니터링은 선택이 아닙니다. 이 가이드에서 제가 하고 싶었던 일은 다른 곳에서 잘 보지 못한 방식으로 도구를 정리하는 것이었습니다. 즉, 용도별로 도구를 나누고, 알림이 있는지만 보지 말고 알림 품질을 평가하고, 2026년 기준 실제 가격을 보여주고, 실제로 얼마나 빨리 시작할 수 있는지도 비교하는 것입니다. 단순히 로고만 나열한 리스트는 아닙니다.
또 하나 짚고 넘어가야 할 점이 있습니다. API 작업이 웹 데이터 수집, LLM 입력, RAG 시스템 구축, 경쟁사 페이지 모니터링, 또는 웹사이트의 가격/상품 데이터 추출과 관련되어 있다면, "API 도구" 얘기는 단순한 업타임 모니터링에서 끝나면 안 됩니다. 지저분한 웹페이지를 구조화된 데이터로 바꿀 믿을 만한 방법도 필요합니다. 그 역할을 하는 게 Thunderbit Open API입니다. 이 도구는 업타임 모니터는 아니지만, 웹사이트를 깔끔한 Markdown 또는 스키마 기반 JSON으로 API를 통해 가장 빠르게 바꾸는 방법 중 하나입니다.
API 모니터링이란 무엇이고, 왜 팀이 신경 써야 할까?
API 모니터링은 API 엔드포인트가 사용 가능한지, 빠른지, 그리고 올바른 데이터를 반환하는지를 계속 확인하는 작업입니다. 단순히 "서버가 살아 있나?"만 보는 게 아닙니다. 좋은 모니터는 HTTP 상태 코드, 응답 페이로드, 지연 시간, SSL 인증서, 로그인 → 검색 → 결제 같은 다단계 워크플로우, 심지어 스키마의 정확성까지 검증합니다.
이것은 일반 웹사이트 모니터링(페이지가 로드되는지 확인하는 것)과도 다르고, APM(Application Performance Monitoring)과도 다릅니다. APM은 코드 수준 추적, 데이터베이스 쿼리, 런타임 내부를 더 깊게 들여다봅니다. API 모니터링은 그 중간 지점에 있습니다. 즉, 사용자, 파트너, 통합 시스템이 실제로 엔드포인트를 호출할 때 어떤 경험을 하는지를 테스트합니다.
연관해서 꼭 짚어야 할 범주가 하나 더 있습니다. 바로 웹 데이터 API입니다. 이런 API는 자기 API 상태를 감시하는 게 아니라, 제품이나 워크플로우가 외부 웹 데이터를 안정적으로 수집하도록 돕습니다. 예를 들어 Thunderbit Open API는 웹페이지를 깔끔한 Markdown으로 정리하고, 구조화된 필드를 JSON으로 추출하며, 여러 URL에 걸친 배치 작업도 실행할 수 있습니다. "API" 프로젝트가 최신 공급사 데이터, 상품 페이지, 공개 목록, 문서 페이지, 리서치 소스에 의존한다면, 이런 데이터 추출 API는 업타임 체크만큼이나 운영상 중요할 수 있습니다.
비개발자도 왜 신경 써야 할까요? API는 동적 웹 트래픽의 71%를 차지하고, API 전문가의 62%는 API가 직접적으로 매출을 만들어낸다고 답했기 때문입니다. 결제 게이트웨이, 인증 서비스, 배송 API가 멈추면 그건 추상적인 인프라 문제가 아닙니다. 매출 손실, 파트너 계약 차질, 고객 문의 폭증, 신뢰 하락으로 이어집니다. 제품, 영업, 운영, 고객 성공 팀 모두 이 문제와 직결됩니다.
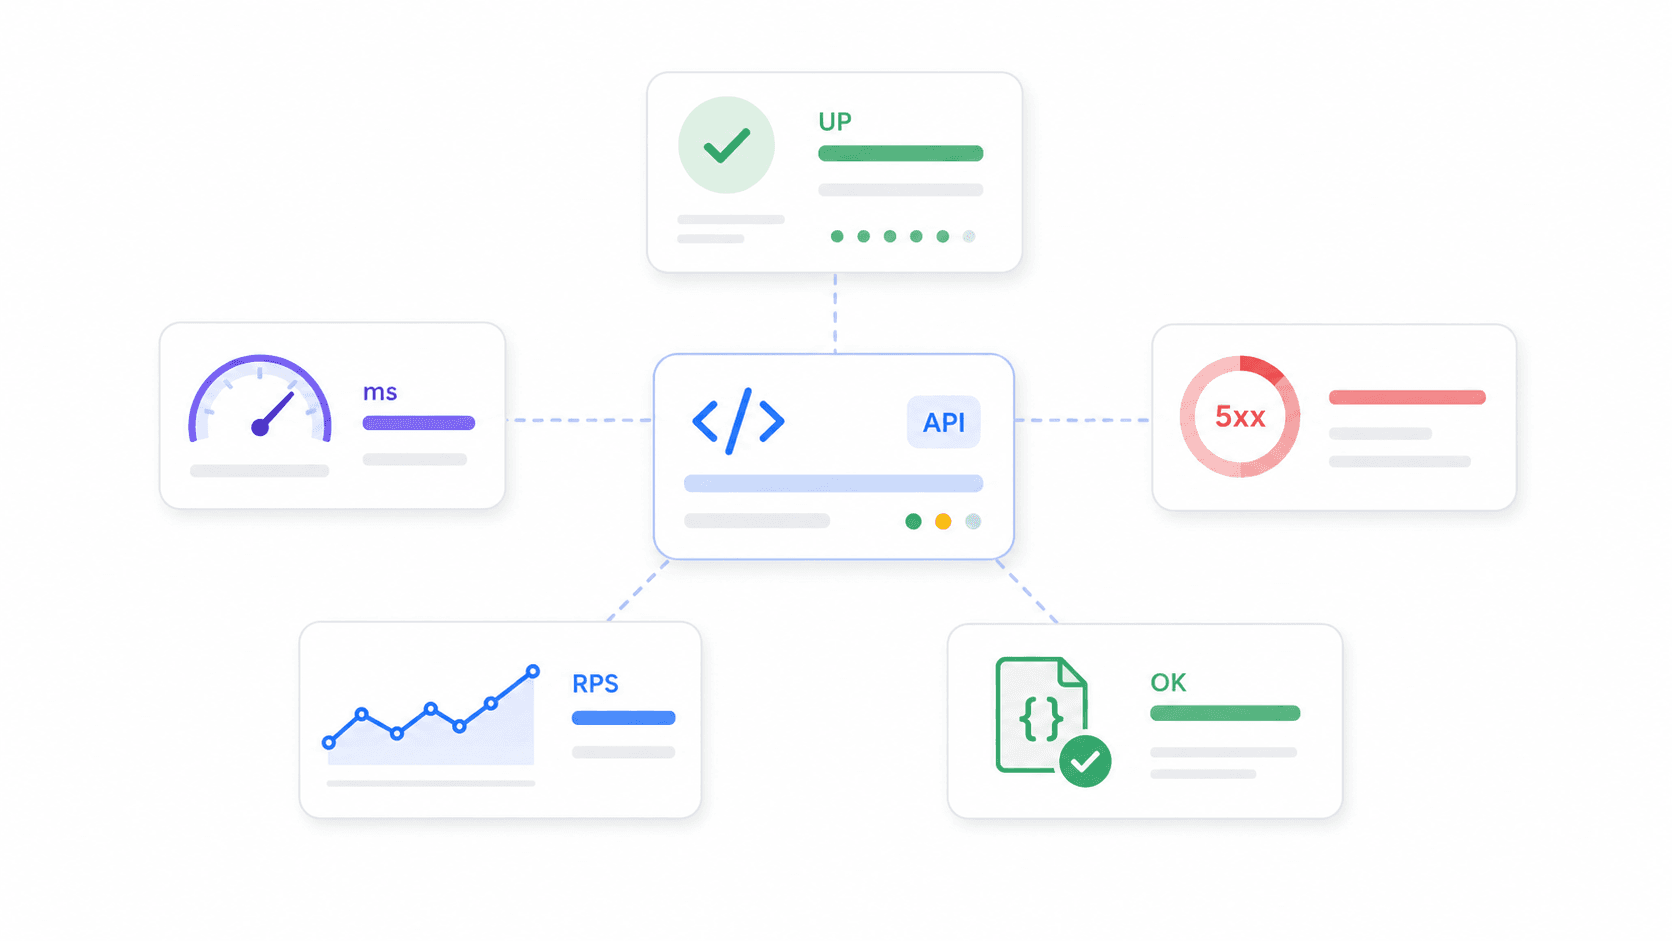
중점적으로 봐야 할 지표는 다음과 같습니다.
- 가동률(Uptime): 엔드포인트가 사용 가능한 시간의 비율
- 응답 시간 / 지연 시간(Latency): 엔드포인트가 응답하는 데 걸리는 시간(평균, p95, p99)
- 오류율: 5xx, 타임아웃, 검증 실패로 끝난 요청 비율
- 처리량(Throughput): 초/분당 요청 수
- 정확성(Correctness): 단순히 200 OK가 아니라 기대한 데이터를 반환하는지 여부
2026년 최고의 API 모니터링 도구를 평가한 기준
대부분의 "최고의 API 모니터링 도구" 글은 공급사 이름과 기능을 그냥 늘어놓는 수준입니다. 저는 조금 더 의도적으로 기준을 세우고 싶었습니다. 개발자 포럼을 오래 읽어온 것도 한 이유고, Thunderbit 팀이 공급사 사이트에서 가격과 기능 데이터를 대량 추출하도록 도와준 것도 또 다른 이유였습니다. 덕분에 실제 비교표를 만들 수 있었습니다. 그 워크플로우는 뒤에서 더 설명하겠습니다.
평가 기준은 다음과 같습니다.
| 평가 기준 | 중요한 이유 |
|---|---|
| 설정 난이도 / 첫 알림까지 걸리는 시간 | 작은 팀은 플랫폼 프로젝트가 끝난 뒤가 아니라 오늘 당장 커버리지가 필요함 |
| 알림 지능화 & 노이즈 감소 | 알림이 시끄러우면 팀은 무시하게 되고, 정작 중요한 장애를 놓침 |
| 무료 플랜의 넉넉함 | 사이드 프로젝트나 초기 스타트업은 무료로 시작하는 경우가 많음 |
| 가격 투명성 | 호스트, 시트, 로그, synthetic 실행, 데이터 수집 때문에 비용이 눈덩이처럼 불어날 수 있음 |
| 연동 범위 | 알림은 팀이 이미 일하는 곳(Slack, PagerDuty 등)으로 들어와야 함 |
| 확장성 & 데이터 깊이 | 성숙한 팀은 trace, log, APM, RBAC, SSO, 보관 기간까지 필요함 |
| 커뮤니티 & 지원 품질 | 오픈소스는 릴리스 주기가 중요하고, 엔터프라이즈는 SLA가 중요함 |
| 웹 데이터 추출 능력 | AI 앱, RAG 워크플로우, 시장조사 도구는 단순 엔드포인트 업타임보다 깔끔한 외부 데이터가 더 중요할 때가 많음 |
또한 추천을 사용 사례별로 나눴습니다. 개인 개발자, 스타트업, 이커머스/SaaS, 엔터프라이즈, 오픈소스 지향 팀, API 제품 팀, 웹 데이터/AI 앱 팀으로 구분해서, 14개 도구 설명을 전부 읽으며 어떤 게 맞는지 추측할 필요 없이 자기 상황에 맞는 섹션으로 바로 갈 수 있게 했습니다. Grafana의 2025년 설문에서는 응답자의 46%가 상호운용성을, 35%가 향후 전환의 용이성을 선택 기준으로 꼽았습니다. 이런 요소들이 단순한 있으면 좋은 기능이 아니라는 점도 보여줍니다.
사용 사례별 최고의 API 모니터링 도구: 빠른 선택표
이 표가 가장 빠른 지름길입니다. 자기 상황을 찾고, 아래 도구 섹션에서 자세한 설명을 보세요.
| 사용 사례 | 추천 도구 | 핵심 차별점 |
|---|---|---|
| 웹 데이터 / AI 앱 팀 | Thunderbit Open API, Moesif, Apitally | 웹사이트를 LLM, RAG, 가격 비교, 리서치 워크플로우용 깔끔한 Markdown 또는 구조화 JSON으로 변환 |
| 개인 개발자 / 사이드 프로젝트 | UptimeRobot, Uptime Kuma, Gatus | 무료 또는 셀프호스트, 최소 설정, 빠른 시작 |
| 스타트업(5~15인 팀) | Checkly, Better Stack, Postman | 스마트 알림, 빠른 설정, 합리적인 가격, 상태 페이지 |
| 이커머스 / SaaS | Datadog, New Relic, Moesif, Checkly | 비즈니스 지표, APM/추적, SDK 깊이, 다단계 synthetic |
| 엔터프라이즈 / 멀티클라우드 | Datadog, New Relic, Splunk, Grafana Cloud | 분산 추적, 컴플라이언스, 하이브리드, RBAC/SSO |
| 오픈소스 지향 팀 | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | 완전한 제어권, OTel 네이티브, 벤더 종속 없음 |
| API 제품 팀 | Moesif, Apitally, New Relic | 고객별 사용량, 엔드포인트 트렌드, 이상 징후 알림 |
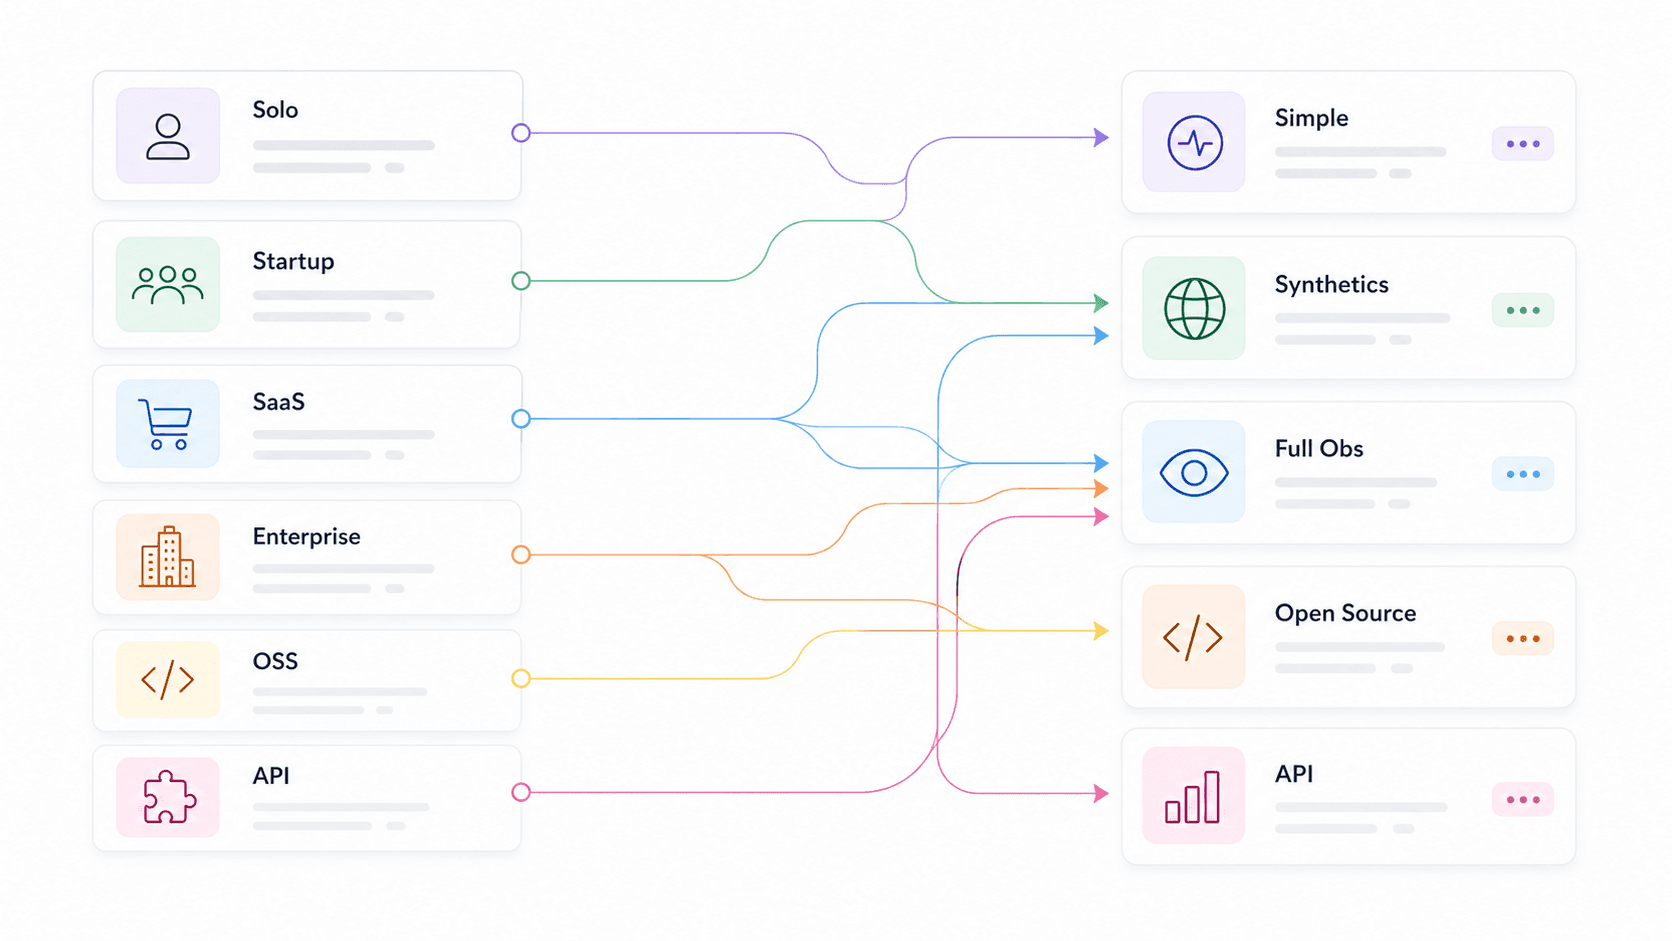
가장 큰 패턴은 이렇습니다. 빨리 설치되는 도구일수록 분석 기능은 가벼운 편이고, 깊이 있는 플랫폼일수록 설정과 비용 관리가 더 필요합니다. 이건 결함이 아니라 트레이드오프입니다. Thunderbit은 조금 다른 영역에 있습니다. 다운타임 알림을 보내는 도구가 아니라, 웹페이지를 API에 넣을 수 있는 데이터로 바꾸는 데 가장 빠른 도구입니다.
Thunderbit Open API: 웹사이트를 구조화된 API 데이터로 바꾸는 데 가장 적합
Thunderbit Open API로 바로 개발을 시작하세요 페이지를 Markdown으로 정리하고, 구조화 JSON을 추출하며, 스크래핑 인프라를 직접 운영하지 않고도 URL 배치를 처리할 수 있습니다. Get Started Free
Thunderbit Open API는 외부 웹 데이터에 의존하는 모니터링 또는 리서치 워크플로우를 가진 팀에게 제가 가장 먼저 추천하고 싶은 API입니다. Checkly나 UptimeRobot 같은 전통적인 업타임 모니터링 도구는 아닙니다. 대신 Thunderbit은 어떤 웹페이지든 앱, 에이전트, 대시보드, LLM 파이프라인이 실제로 사용할 수 있는 깔끔하고 구조화된 데이터로 바꿔줍니다.
이 API에는 세 가지 핵심 워크플로우가 있습니다. Distill은 페이지를 LLM 친화적인 깔끔한 Markdown으로 바꿉니다. Extract는 스키마를 넣으면 상품명, 가격, 재고 여부, 회사 규모, 투자 단계, 리뷰 평점 같은 구조화된 JSON 필드를 반환합니다. Batch는 웹훅을 이용해 최대 100개의 URL을 비동기적으로 처리할 수 있어, 가격 페이지, 경쟁사 카탈로그, 공급사 문서, 뉴스 소스, 대규모 리서치 목록을 모니터링할 때 유용합니다.
이 도구가 API 툴 가이드에 들어갈 이유는, 많은 팀이 "이 페이지 좀 긁어와"가 얼마나 많은 인프라를 요구하는지 과소평가하기 때문입니다. JavaScript가 많은 사이트는 렌더링이 필요하고, 어떤 페이지는 지역 라우팅이 필요합니다. HTML은 LLM에 넣기 전에 네비게이션 바, 광고, 모달, 반복 문구를 제거해야 합니다. 레이아웃이 바뀌면 셀렉터가 깨집니다. 프록시 회전, 봇 차단 대응, 재시도, 큐, 결과 폴링까지 직접 만들다 보면 작은 데이터 워크플로우가 유지보수 프로젝트로 바뀝니다. Thunderbit은 이런 작업의 상당 부분을 하나의 API 뒤로 감춰줍니다.
추천 대상: AI 앱 빌더, RAG 팀, 이커머스 운영, 세일즈 운영, 성장팀, 시장 조사 담당자, 그리고 스크래핑 스택을 직접 만들고 관리하지 않고도 API로 웹사이트 데이터를 얻고 싶은 개발자.
가격: 무료: 일회성 API 유닛 600개. 최대 600개의 Distill 페이지 또는 30개의 Extract 페이지, 동시 요청 2개 포함. Starter는 연간 청구 기준 월 $16로, 연간 60,000 API 유닛과 동시 요청 30개를 제공합니다. Pro는 연간 청구 기준 월 $40로, 연간 600,000 API 유닛과 동시 요청 50개를 제공합니다.
설정 속도: API 키를 발급받고 cURL, SDK, 또는 Thunderbit CLI로 첫 Distill 또는 Extract 요청을 보내기까지 약 5~15분.
아쉬운 점: Thunderbit은 업타임 점검, 장애 에스컬레이션, trace, log, 온콜 라우팅에서는 Datadog, New Relic, Better Stack, Checkly를 대체하지 못합니다. 공급사 가격, 문서, 경쟁사 페이지, 상품 목록, 공개 데이터셋을 포함한 웹 데이터를 수집하고 구조화하는 용도로 생각하세요. 온콜 엔지니어에게 전화를 거는 시스템이 아닙니다.
Datadog: 풀스택 가시성에 가장 적합
Datadog은 엔터프라이즈와 미드마켓 SaaS 스택에서 계속 보이는 도구입니다. 그럴 만한 이유가 있습니다. 단순한 API 모니터링을 넘어, synthetic API 테스트를 분산 추적, 로그, 인프라 지표, 실사용자 모니터링과 한 화면에서 연결하는 완전한 옵저버빌리티 플랫폼이기 때문입니다.
API 모니터링만 놓고 봐도 Datadog은 HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC, 그리고 다단계 API 테스트를 지원합니다. 이상 탐지 모니터는 기대 패턴을 학습하고 정적 임계치가 아니라 편차를 기준으로 알림을 보냅니다. 이는 단순히 "지연 시간이 500ms 넘으면 알림"보다 훨씬 진화한 방식입니다. 또한 지표가 임계치를 넘을 시점을 예측하는 forecast 모니터, 여러 조건을 결합하는 composite 모니터도 제공합니다.
추천 대상: API, 인프라, 로그, trace를 한 화면에서 보고 싶은 이커머스, SaaS, 엔터프라이즈 팀.
가격: 무료 티어는 제품별로 다릅니다. Infrastructure Pro는 호스트당 월 $15부터 시작하며, API synthetic 테스트는 10,000회 실행당 $5입니다. 800개 이상의 연동을 제공합니다.
설정 속도: 에이전트 설치와 기본 synthetic 테스트까지 약 15~30분.
아쉬운 점: 규모가 커질수록 비용이 빠르게 올라갈 수 있습니다. 해커뉴스와 Reddit에서 반복적으로 보이는 주제가 바로 "빌 쇼크"입니다. 호스트, 로그, 커스텀 메트릭, synthetic, 사용자 등 SKU가 너무 많아서 대시보드만 볼 게 아니라 청구서도 관리해야 합니다. 전체 플랫폼을 익히는 데 학습 곡선도 분명합니다.
Checkly: 개발자 중심 synthetic 체크에 가장 적합
Checkly는 API 체크를 코드 가까이에 두고 싶은 스타트업 엔지니어링 팀에 추천하고 싶은 도구입니다. 핵심 아이디어는 "코드로 하는 모니터링"입니다. API와 브라우저 체크를 프로그램 방식으로 정의하고, 전 세계 위치에서 실행하며, CI/CD 파이프라인에 통합하고, Git으로 전부 관리합니다.
알림 품질 측면도 강력합니다. Checkly의 재시도 로직은 거짓 양성 대응의 "첫 번째 방어선"으로 명확히 설명됩니다. 고정/선형/지수 재시도를 설정할 수 있고, 같은 지역 또는 다른 지역에서 재시도할 수도 있으며, 알림 전에 최대 재시도 시간을 정할 수 있습니다. 또한 degraded, failed, recovered 상태를 구분해 시끄러운 페이지 알림을 줄여 줍니다.
추천 대상: 프로그램 방식 API 체크, Playwright 기반 브라우저 체크, CI/CD 연동, 빠른 설정이 필요한 스타트업과 개발팀.
가격: 최근 공개 데이터 기준 무료 플랜은 uptime 모니터 10개, 브라우저 체크 1,000회, API 체크 10,000회를 제공합니다. Starter는 연간 청구 기준 월 약 $24입니다. 구매 전에는 공식 가격 페이지를 꼭 확인하세요.
설정 속도: 첫 API 체크와 알림 채널 구성까지 약 10~20분.
아쉬운 점: synthetic 체크에 집중되어 있습니다. 깊은 APM, 로그 분석, 분산 추적을 대체하지는 못합니다. API 장애를 데이터베이스 병목과 연결해 보고 싶다면 다른 도구가 함께 필요합니다.
UptimeRobot: 단순하고 저렴한 업타임 추적에 가장 적합
UptimeRobot은 API 모니터링의 혼다 시빅 같은 존재입니다. 한 가지를 잘합니다. HTTP, keyword, ping, port, SSL, heartbeat 모니터를 만들고, 주기를 정한 뒤, 실패하면 알림을 받는 것입니다. 끝입니다.
추천 대상: 개인 개발자, 소규모 팀, 에이전시, 또는 복잡함 없이 기본 업타임과 지연 시간 추적이 필요한 사람.
가격: 무료: 모니터 50개, 5분 간격. 유료 Solo는 연간 청구 기준 월 약 $7입니다. 무료 사용 시 신용카드가 필요하지 않습니다. 설정 속도: 약 2~5분으로, 이 목록에서 가장 빠릅니다.
아쉬운 점: 알림 지능화가 제한적입니다. 기본 임계치 알림은 있지만 이상 탐지, 분산 추적, 깊은 분석은 없습니다. 엔드포인트가 왜 느린지(느리다는 사실이 아니라) 알고 싶다면 UptimeRobot만으로는 부족합니다.
Uptime Kuma: 가장 좋은 무료 셀프호스트 API 모니터링 도구
Uptime Kuma는 셀프호스팅 커뮤니티에서 큰 사랑을 받는 도구입니다. GitHub 수치가 이를 보여 줍니다. 별 86,637개, 포크 7,831개, 기여자 1,060명, 그리고 2026년 5월 기준 release 2.3.2입니다. MIT 라이선스이고, HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, 다중 상태 페이지, 90개 이상의 알림 서비스를 지원합니다.
추천 대상: 서버만 있다면, 완전한 제어권과 프라이버시, 반복 구독 비용 0원을 원하는 개인 개발자와 팀.
가격: 무료입니다. 실제 비용은 VM/컨테이너, 백업, 업데이트, 그리고 모니터 자체의 가동 상태를 유지하는 데 들어갑니다. 설정 속도: 기본 체크는 Docker로 약 515분, 알림과 상태 페이지를 다듬으면 1530분 정도.
아쉬운 점: 유지보수는 직접 해야 합니다. 그리고 중요한 함정이 하나 있습니다. Uptime Kuma를 감시 대상과 같은 인프라에 올리면, 클라우드나 DNS 장애가 앱과 모니터를 동시에 다운시킬 수 있습니다. 외부에 호스팅하거나 SaaS 체크와 함께 쓰는 게 좋습니다.
Better Stack: 빠른 장애 대응에 가장 적합
Better Stack(사용자들 사이에서는 여전히 Better Uptime이라고 불리는 경우가 많음)은 업타임 모니터링, 인시던트 관리, 온콜 스케줄링, 에스컬레이션 정책, 상태 페이지를 하나의 플랫폼으로 묶습니다. 분석 도구라기보다, 모니터링 위에 얹힌 장애 대응 워크플로우 도구로서 강합니다.
에스컬레이션 정책은 누가, 어떤 순서로, 어떤 지연을 두고 알림을 받을지 정합니다. 메타데이터 기반 라우팅은 심각도나 소유권에 따라 인시던트를 보냅니다. Slack, Teams, 웹훅, Zapier와 연동됩니다.
추천 대상: 모니터링 + 인시던트 대응 + 상태 페이지를 따로 연결하지 않고 한 번에 쓰고 싶은 스타트업과 중견 팀.
가격: 무료 티어: 모니터/heartbeat 10개, 상태 페이지 1개. Team은 연간 청구 기준 월 약 $29입니다. 설정 속도: GUI 위저드로 약 5~10분.
아쉬운 점: Datadog, New Relic, Moesif보다 API 페이로드 분석, 분산 추적, 비즈니스 KPI 분석의 깊이는 낮습니다.
Prometheus + Grafana: 최고의 오픈소스 API 모니터링 스택
이 조합은 업계 표준 오픈소스 스택입니다. Prometheus는 시계열 지표를 수집하고 저장합니다. Grafana(GitHub 별 73,705개, 기여자 3,010명)는 대시보드와 알림을 제공합니다. Alertmanager는 라우팅, 그룹화, 중복 제거, 음소거, 억제를 처리합니다. API 엔드포인트 점검을 위해 팀들은 HTTP, HTTPS, DNS, TCP, ICMP, gRPC 프로빙을 위한 Blackbox Exporter를 추가합니다.
추천 대상: 오픈소스 지향 팀, Kubernetes/SRE 팀, 이미 Prometheus 메트릭을 표준으로 쓰는 조직.
가격: 셀프호스트는 무료입니다. Grafana Cloud는 무료 티어(월 10만 API 테스트 실행)와 사용량 기반 유료 플랜을 제공합니다.
설정 속도: 기본적인 Blackbox + Prometheus + Grafana + Alertmanager 구성은 1~4시간. 프로덕션용 HA와 알림 튜닝은 며칠이 걸릴 수 있습니다.
아쉬운 점: PromQL, YAML, relabeling, 대시보드 설계, 보관, 스토리지, HA, 알림 튜닝은 실제 운영 업무입니다. 반복되는 트레이드오프는 "UI는 적고 YAML은 많다"입니다. 이 스택은 이미 메트릭 중심으로 사고하고 하나의 제어 평면을 원하는 팀에 적합하지, 점심 전에 바로 모니터링을 띄우고 싶은 팀용은 아닙니다.
New Relic: SaaS 애플리케이션 성능에 가장 적합
New Relic은 APM, 인프라 모니터링, 로그, 분산 추적, synthetic 모니터링, 알림, 대시보드, AI 보조 장애 분석을 하나로 묶습니다. 무료 티어도 꽤 넉넉합니다. 월 100GB 데이터 수집과 풀 플랫폼 사용자 1명은 소규모 팀에게 꽤 인상적입니다.
알림 피로 문제에서는 New Relic의 알림 지능이 특히 빛납니다. incident intelligence에는 이벤트 상관관계, 이상 탐지, 예측 알림, 근본 원인 분석, flapping 억제가 포함됩니다. New Relic은 97.2% flapping 효과가 1,000건의 flapping 장애 중 단 28건만 표면화한다는 예시도 공개했습니다. 이는 노이즈 감소를 수치로 보여 주는 사례입니다.
추천 대상: API 모니터링을 애플리케이션 trace, 에러, 처리량, 사용자 영향과 촘촘히 연결하고 싶은 SaaS 팀과 이커머스 플랫폼.
가격: 무료: 월 100GB, 풀 사용자 1명. 유료는 사용자별 + 데이터 기반 가격 체계입니다.
설정 속도: 에이전트 설치와 가이드 설정까지 약 15~30분.
아쉬운 점: 규모가 커지면 가격 구조가 복잡해질 수 있습니다. 알림 설정에도 학습 곡선이 있습니다. 강력하지만 바로 직관적이진 않습니다.
Moesif: API 분석과 비즈니스 지표에 가장 적합
Moesif는 전통적인 업타임 모니터가 아닙니다. API 분석과 제품 인텔리전스 도구입니다. 즉, API 사용량을 고객, 엔드포인트, 코호트, 회사, 지역, SDK, 플랜, 행동별로 이해하는 데 초점을 맞춥니다. 질문이 "엔드포인트가 살아 있나?"가 아니라 "어떤 고객이 영향을 받았나?"라면 Moesif가 맞습니다.
정적 임계치 알림과 동적 이상 알림을 모두 지원하며, 트래픽 급증/급감, 지연 시간, 행동 변화 같은 API 지표를 추적합니다. 동적 알림은 며칠간의 API 행동 데이터를 학습해야 하지만, 일단 학습되면 정적 규칙이 놓치는 변화를 잡아냅니다.
추천 대상: API 제품 팀, SaaS 회사, API 성능을 매출, 참여도, 유지율과 연결해야 하는 이커머스 플랫폼.
가격: 무료/체험 가능. 유료는 API 이벤트 볼륨에 따라 확장됩니다. 셀프서비스 금액은 조사 중 완전히 크롤링되지 않았으니 현재 페이지를 확인하세요.
설정 속도: 약 20~45분(SDK/프록시/게이트웨이 연동은 외부 ping보다 깊음).
아쉬운 점: 전통적인 업타임 모니터링보다는 분석 중심입니다. 외부 가용성 체크는 Checkly, UptimeRobot, Datadog synthetic과 함께 쓰는 편이 좋습니다.
Splunk: 엔터프라이즈 로그 분석과 컴플라이언스에 가장 적합
Splunk는 로그 집계, 검색, 상관분석, 감사 추적 가능성, 하이브리드/멀티클라우드 지원이 꼭 필요할 때 선택하는 도구입니다. Splunk Observability Cloud는 인프라, APM, synthetic, 실사용자 모니터링, 로그, 인시던트 대응을 다룹니다. ITSI/Event Analytics는 중요한 이벤트를 에피소드로 묶어 여러 모니터링 사일로의 노이즈를 줄일 수 있습니다.
Splunk 자체 2025년 옵저버빌리티 리서치는 꽤 충격적입니다. ITOps/엔지니어링 응답자의 73%가 무시되거나 억제된 알림 때문에 장애를 경험했다고 답했고, 59%는 너무 많은 분산 도구 때문에 어려움을 겪고 있으며, 52%는 거짓 알림에 어려움을 겪고 있다고 답했습니다.
추천 대상: 강한 컴플라이언스, 보안, 감사, 로그 검색 요구가 있는 엔터프라이즈 및 멀티클라우드 팀.
가격: 사용량 기반이며 견적 중심입니다. 간단한 프로덕션 무료 티어는 없습니다.
설정 속도: 클라우드 온보딩은 더 빠를 수 있지만, 엔터프라이즈 배포는 보통 며칠에서 몇 주가 걸립니다.
아쉬운 점: 규모가 커질수록 비쌉니다. 설정도 복잡합니다. 개인 개발자와 작은 스타트업에는 과합니다.
Postman: 이미 API를 테스트하고 있는 팀에 가장 적합
Postman은 기본적으로 API 개발 및 테스트 플랫폼이지만, 모니터링 제품을 사용하면 팀이 Postman 컬렉션을 스케줄링해 클라우드 위치에서 실행할 수 있습니다. 가장 강력한 이유는 재사용성입니다. QA나 개발 팀이 이미 assertion이 들어간 Postman 컬렉션을 가지고 있다면, 이를 모니터로 바꾸는 건 아주 자연스러운 다음 단계입니다.
추천 대상: 이미 Postman 컬렉션을 쓰고 있고, 별도 synthetic 도구를 사지 않고 정기 체크를 하고 싶은 개발/QA 팀.
가격: 무료 티어가 있습니다. 모니터링 초과분은 1,000회 호출당 $0.75이며, 50,000회 호출 추가 블록은 월 $20입니다. Postman은 패키징이 자주 바뀌므로 현재 플랜 페이지를 확인하세요.
설정 속도: 컬렉션이 이미 있다면 약 10분.
아쉬운 점: Checkly, Datadog, New Relic 같은 전용 도구보다 모니터링 기능은 가볍습니다. 알림 옵션도 기본적인 수준입니다.
살펴볼 만한 다른 API 모니터링 도구
Gatus: 가볍고 셀프호스트 가능한 설정 중심 health 대시보드. GitHub 별 10,906개, HTTP, ICMP, TCP, DNS, Prometheus 친화적 메트릭, 상태 배지를 지원합니다. Prometheus보다 단순하지만 Uptime Kuma의 UI보다 YAML/config-as-code를 선호하는 개인 개발자에게 좋습니다.
Apitally: 스타트업을 위한 API 트래픽 분석과 품질 추적에 초점을 둔 비교적 새로운 도구. 14개 메트릭에 걸친 커스텀 알림과 함께 5분 이내 설정을 내세웁니다. 전체 옵저버빌리티 플랫폼을 도입하지 않고 가볍게 API 분석을 하고 싶을 때 적합합니다.
Sematext: 로그, synthetic, 인프라 가시성을 갖춘 풀스택 모니터링. synthetic은 HTTP 모니터당 약 $2, 브라우저 모니터당 $7, 최소 월 $5 수준입니다. 미드마켓 팀을 위한 저비용 Datadog 대안입니다.
Uptrace: OpenTelemetry 네이티브 APM, tracing, metrics, logs 백엔드. GitHub 별 4,198개. 순수 업타임 체커는 아니지만, OTel 표준화를 진행 중이며 오픈소스 친화적인 tracing 백엔드를 원하는 팀에 이상적입니다.
직접 만들까, 구매할까: API 모니터링을 직접 구축해야 할까?
"엔드포인트를 ping하는 스크립트를 직접 만들까, 아니면 전용 도구를 쓸까?"
개발자 포럼에서 정말 자주 나오는 질문입니다. Reddit 스레드를 충분히 읽어 보면 패턴이 보입니다. 팀은 curl + cron으로 시작합니다. 한동안은 잘 됩니다. 그러다 대시보드, 히스토리 데이터, 멀티 리전 체크, 신뢰할 수 있는 알림 라우팅, 팀 간 가시성이 필요해지는 순간 전용 도구로 옮깁니다.
솔직한 결정 매트릭스는 이렇습니다.
| 요인 | 커스텀 스크립트 | 전문 도구 |
|---|---|---|
| 설정 시간 | 1~4시간(기본), 며칠(견고하게) | 5~30분 |
| 유지보수 | 영구적으로 직접 책임 | 공급사가 업데이트 처리 |
| 알림 품질 | 기본적(up/down) | 스마트함(지연 추세, 이상 징후, 재시도) |
| 비용 | 무료(대신 내 시간) | 월 $0~$500+ |
| 대시보드 | 직접 구축 | 미리 준비됨, 커스터마이즈 가능 |
| 적합한 경우 | 엔드포인트 3개 이하, 개발자 중심 팀, 취미 프로젝트 | 엔드포인트 5개 이상, 운영/제품 팀, 매출이 걸린 상황 |
포럼에서 반복해서 보이는 핵심 인사이트는 이렇습니다. 직접 만든 사람들은 대시보드나 히스토리 데이터, 팀 간 가시성이 필요해지는 순간 후회하는 경우가 많습니다. 게다가 "모니터링을 위한 모니터링"이라는 문제도 있습니다. 셀프호스트 모니터, 데이터베이스, 백업, 네트워크 경로, 알림 공급자까지 모두 안정적이어야 합니다.
엔드포인트가 2개뿐이고 만지작거리는 걸 즐긴다면 직접 만드세요. 제품을 출시해야 한다면 구매하세요.
웹 데이터 추출에도 같은 논리가 적용됩니다. 물론 스크립트를 쓰고, 헤드리스 브라우저를 돌리고, 프록시를 회전시키고, 셀렉터를 유지하고, HTML을 정리하고, 큐를 직접 만들 수도 있습니다. 하지만 작업 목적이 웹 데이터를 API 제품, AI 에이전트, 리서치 워크플로우에 안정적으로 공급하는 것이라면, Thunderbit Open API를 쓰는 편이 직접 스크래핑 인프라를 만드는 것보다 대체로 훨씬 빠릅니다.
알림 피로: 알림 개수보다 알림 품질이 중요한 이유
API 모니터링 도구를 고를 때 가장 과소평가되는 기준일지도 모릅니다. 알림 피로는 팀이 너무 많은 노이즈성, 중복성, 실행 불가능한 알림을 받다 보면 결국 모든 알림을 무시하게 되고, 그러다 실제 장애를 놓치는 현상입니다.
수치도 꽤 충격적입니다. BigPanda의 2025년 보고서에 따르면 중앙값 기준 조직은 하루 2,350건의 알림과 연간 803,406건의 알림을 생성했습니다. 인시던트의 실행 가능성 중앙값은 18%에 불과했습니다. 즉, 알림에서 비롯된 인시던트 중 5건 중 1건도 실제로 조치 가능한 수준이 아니었다는 뜻입니다. NeuBird의 2026년 설문에서는 온콜 팀의 77%가 하루 최소 10건 이상의 알림을 받는다고 답했고, 80%는 그 알림의 절반 이하만 실행 가능하다고 답했습니다.
가장 좋은 모니터링 도구는 알림을 실제로 신뢰할 수 있는 도구입니다. 각 도구가 알림 지능을 어떻게 다루는지 비교하면 다음과 같습니다.
| 도구 | 알림 유형 | 노이즈 감소 방식 | 알림 채널 |
|---|---|---|---|
| Datadog | ML 이상 탐지, 예측, composite | 과거 이상 범위, 동적 기준선, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20개 이상 |
| Checkly | 임계치 + 성능 저하 기반 | 알림 전 재시도, 동일/다른 위치 재시도 | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI 이슈 그룹화, 이상 탐지, 예측 | 이벤트 상관관계, flapping 억제, 근본 원인 컨텍스트 | Slack, PagerDuty, Teams, 웹훅 |
| Moesif | 행동 이상 탐지 | 며칠간의 행동 데이터를 바탕으로 한 동적 모델 | Slack, PagerDuty, 이메일, SMS |
| Better Stack | 업타임/인시던트/온콜 | 에스컬레이션 정책, 소유권 라우팅, 지연 | Slack, Teams, 웹훅, Zapier |
| Prometheus + Alertmanager | PromQL 규칙 알림 | 그룹화, 중복 제거, 음소거, 억제 | 이메일, PagerDuty, Opsgenie, 웹훅 |
| Splunk | 이벤트, 에피소드, 서비스 상태 | ITSI Event Analytics, 에피소드 그룹화, 티켓팅 | Splunk On-Call, ServiceNow, 웹훅 |
| Thunderbit Open API | 알림 플랫폼 아님 | 자체 스케줄러, 워크플로우 도구, 모니터링 스택과 함께 사용 | 배치 작업용 웹훅; 알림은 외부 시스템에서 처리 |
실전 조언: 더 적고 더 신뢰도 높은 알림부터 시작하세요. 재시도 후 알림, 멀티 리전 확인, SLO burn-rate 알림, 중복 제거, 소유권 라우팅을 쓰세요. 내부 증상이 아니라 사용자 영향과 비즈니스 핵심 흐름(결제 실패, 인증 실패, 결제 5xx)에 알림을 맞추세요.
2026년 무료 티어와 가격: 실제로 얼마를 내게 될까?
가격 페이지는 바뀝니다. 무료 티어도 바뀝니다. 호스트, 시트, 로그, synthetic 실행, 데이터 수집 같은 숨은 비용은 예상 밖일 수 있습니다. 이 섹션은 제가 모든 "최고의 도구" 글에 있었으면 좋겠다고 생각한 부분입니다. 2026년 기준 스냅샷은 다음과 같습니다.
| 도구 | 무료 티어 | 유료 시작가 | 신용카드 필요? | 무료로 쓰기 좋은 용도 |
|---|---|---|---|---|
| Thunderbit Open API | 일회성 API 유닛 600개 | 연간 청구 기준 약 $16/월 | 아니오 | LLM, RAG, 가격, 리서치용 웹 데이터 추출 |
| Uptime Kuma | 무제한(셀프호스트) | — | 아니오 | 완전한 모니터링, 자체 서버 |
| UptimeRobot | 모니터 50개, 5분 간격 | 약 $7/월 | 아니오 | 기본 업타임 체크 |
| Better Stack | 모니터 10개, 상태 페이지 1개 | 약 $29/월 | 아니오 | 스타트업 업타임 + 상태 페이지 |
| Checkly | uptime 10개, API 체크 1만 회 | 약 $24/월 | 예 | synthetic API 체크 |
| Postman | 무료 계정 + 모니터링 허용량 | 약 $14/사용자/월 | 아니오 | 기존 컬렉션 재사용 |
| Prometheus + Grafana | 무제한(셀프호스트) | — | 아니오 | 메트릭 + 시각화 |
| Grafana Cloud | 월 10만 API 테스트 실행 | 플랫폼 $29/월 + 사용량 | 확인 필요 | 관리형 synthetic 체험 |
| New Relic | 월 100GB, 풀 사용자 1명 | 사용자별 + 데이터 요금 | 일부 플랜 | APM + 기본 옵저버빌리티 |
| Datadog | 체험/제품별 상이 | $15/호스트/월(Infrastructure Pro) | 대체로 예 | 풀스택 평가 |
| Moesif | 무료/체험 가능 | 사용량 기반 | 확인 필요 | API 분석 평가 |
| Splunk | 체험 가능 | 견적 기반 | 영업 진행 | 엔터프라이즈 PoC |
| Gatus | 무제한(셀프호스트) | — | 아니오 | YAML 기반 상태 대시보드 |
| Apitally | 무료/체험 가능 | 확인 필요 | 확인 필요 | 가벼운 API 분석 |
| Sematext | 체험/무료는 다양함 | HTTP 모니터 약 $2 | 확인 필요 | 저비용 synthetic/logs |
| Uptrace | 무료 셀프호스트 | 클라우드 티어 상이 | 확인 필요 | OTel APM 평가 |
숨은 비용 참고: Uptime Kuma, Prometheus, Gatus 같은 셀프호스트 도구는 라이선스상 무료지만, 작은 VM, 백업, 유지보수 시간, 외부 장애 대비 체계가 실제 비용이 될 수 있습니다. 웹 데이터 API의 숨은 비용은 보통 다릅니다. 헤드리스 브라우저 유지, 깨진 셀렉터, 프록시 풀, 봇 차단 우회, HTML 정리에 비용이 들어갑니다.
소규모 팀 예산 감각: API 엔드포인트 10개와 팀원 3명 기준으로 보면, 가장 저렴한 SaaS 경로는 보통 UptimeRobot 무료 또는 저가 플랜, Better Stack 무료/Team, 또는 실행량이 맞는다면 Checkly입니다. Datadog과 New Relic은 평가용으로는 꽤 합리적일 수 있지만, 실제 청구서는 호스트, 사용자, 로그, trace, synthetic 실행량에 따라 달라집니다. 프로젝트가 웹 데이터를 API 형태로 필요로 한다면, Thunderbit의 무료 API 유닛만으로도 유료 플랜 결제 전에 워크플로우를 시험해 볼 수 있습니다.
설정 복잡도 점수표: 첫 알림까지 얼마나 걸릴까?
제가 찾아본 경쟁사 글 중에는 시간 대비 가치(time-to-value)를 평가하는 곳이 거의 없었습니다. 즉, 가입부터 첫 의미 있는 알림을 받기까지 얼마나 걸리는지입니다. 작은 팀일수록 이건 기능 깊이보다 더 중요할 수 있습니다.
| 도구 | 첫 알림까지 시간 | 필요 기술 수준 | 설정 방식 |
|---|---|---|---|
| Thunderbit Open API | 약 5~15분 | 낮음~중간 | API 키, cURL/SDK/CLI |
| UptimeRobot | 약 2~5분 | 낮음 | GUI, 추가 클릭 |
| Better Stack | 약 5~10분 | 낮음 | GUI 위저드 |
| Checkly | 약 10~20분 | 낮음~중간 | 코드 또는 GUI |
| Postman | 약 10분(컬렉션이 있다면) | 낮음~중간 | 컬렉션 스케줄러 |
| Uptime Kuma | 약 5~30분 | 중간 | Docker + GUI |
| Gatus | 약 15~45분 | 중간 | YAML + Docker |
| Datadog | 약 15~30분 | 중간 | 에이전트 설치 + GUI |
| New Relic | 약 15~30분 | 중간 | 에이전트 + 가이드 설정 |
| Moesif | 약 20~45분 | 중간 | SDK/프록시 연동 |
| Grafana Cloud Synthetics | 약 15~45분 | 중간 | GUI, Terraform 선택 가능 |
| Prometheus + Grafana | 1~4시간 | 중간~높음 | YAML, PromQL |
| Uptrace | 30~90분 | 중간~높음 | OTel SDK 연동 |
| Splunk | 몇 시간~몇 주 | 높음 | 엔터프라이즈 온보딩 |
모니터링이 오늘 안에 살아 있어야 한다면, 이 표의 위쪽부터 시작하세요. 목표가 견고한 플랫폼 옵저버빌리티라면 아래쪽 항목은 별도 프로젝트로 잡는 게 좋습니다. 그리고 첫 마일스톤이 "이 웹페이지 100개에서 깨끗한 데이터를 앱으로 가져오기"라면, 커스텀 스크래핑 인프라를 만들기 전에 Thunderbit부터 시작하세요.
최고의 API 모니터링 도구 비교: 한눈에 보는 전체 표
결정 전에 한 번 훑어볼 표입니다.
| 도구 | 최적 사용 사례 | 무료 티어 | 알림 지능화 | 설정 시간 | 호스팅 | 두드러진 기능 |
|---|---|---|---|---|---|---|
| Thunderbit Open API | 웹 데이터 추출/API 데이터 파이프라인 | API 유닛 600개 | 알림 도구 아님 | 5~15분 | 클라우드 | 페이지를 Markdown으로 정리하거나 스키마 기반 JSON 추출 |
| Datadog | 풀스택 엔터프라이즈/SaaS | 체험/제품별 상이 | 이상 탐지, 예측, AI | 15~30분 | 클라우드 | synthetic을 logs/traces/infra와 연계 |
| Checkly | 개발자 중심 synthetic | 넉넉한 체크 기반 | 재시도, degradation | 10~20분 | 클라우드 | Monitoring as code + Playwright |
| UptimeRobot | 단순 업타임 | 모니터 50개 | 기본 임계치 | 2~5분 | 클라우드 | 가장 빠른 저비용 기본 모니터 |
| Uptime Kuma | 무료 셀프호스트 | 무제한 | 기본 상태/임계치 | 5~30분 | 셀프호스트 | 깔끔한 UI, SaaS 비용 없음 |
| Better Stack | 인시던트 대응/상태 페이지 | 모니터 10개 | 에스컬레이션, 라우팅 | 5~10분 | 클라우드 | 모니터링 + 온콜 + 상태 페이지 |
| Prometheus + Grafana | 오픈소스 메트릭 스택 | 무제한(셀프호스트) | Alertmanager 그룹화 | 1~4시간 | 셀프호스트/클라우드 | PromQL 생태계의 깊이 |
| New Relic | SaaS APM + API 체크 | 월 100GB, 사용자 1명 | AI 그룹화, flapping 억제 | 15~30분 | 클라우드 | 강력한 APM + synthetic 동시 제공 |
| Moesif | API 분석/비즈니스 지표 | 무료/체험 | 행동 이상 탐지 | 20~45분 | 클라우드 | 고객별 API 행동 분석 |
| Splunk | 엔터프라이즈 로그/컴플라이언스 | 체험 | ITSI 에피소드, AIOps | 몇 일 이상 | 클라우드/셀프관리 | 엔터프라이즈 로그 검색과 거버넌스 |
| Postman | 이미 API를 테스트 중인 팀 | 무료 계정 | 기본 모니터 알림 | 10분 | 클라우드 | API 테스트 컬렉션 재사용 |
Thunderbit이 API 도구 평가를 더 빠르게 만드는 방법
명확히 말씀드리면, Thunderbit은 API 모니터링 도구가 아닙니다. 웹페이지를 깔끔한 Markdown 또는 구조화 JSON으로 바꾸는 에이전틱 웹 스크래퍼이자 Open API입니다. 하지만 이건 모니터링 도구를 고르는 과정의 다른 부분에서 큰 도움이 됩니다. 즉, 플랫폼을 선택하기 전에 공급사 가격, 플랜 제한, 기능 주장, 문서 세부사항, 연동 목록을 수집하는 일입니다.
10개가 넘는 공급사의 가격 페이지를 하나하나 열고, 플랜 이름, 모니터 한도, 체크 간격, 연동, 신용카드 필요 여부를 스프레드시트에 옮겨 적는 대신, 저희는 Thunderbit Chrome Extension을 사용해 각 도구의 가격 페이지와 기능 페이지에서 구조화된 데이터를 추출했습니다. Thunderbit의 AI는 각 페이지를 읽고 플랜 이름, 무료 티어 상세, 유료 가격, 지원 연동 같은 필드를 제안한 뒤, 내보낼 수 있는 스프레드시트 형태로 구조화합니다.
개발자 워크플로우에서는 Thunderbit Open API가 같은 아이디어를 프로그램 방식으로 제공합니다. LLM이나 RAG용 깔끔한 Markdown이 필요하면 Distill을 쓰세요. 특정 필드를 JSON으로 받고 싶으면 Extract를 쓰세요. 가격 페이지, 문서 URL, 상품 페이지, 경쟁사 페이지 같은 URL 목록을 처리하고 비동기 결과를 받으려면 Batch를 쓰세요.
워크플로우는 다음과 같습니다.
- 공급사의 가격 페이지를 엽니다(Datadog, Checkly, UptimeRobot 등)
- "One Click Extract"를 누릅니다. Thunderbit의 AI가 페이지를 읽고 구조를 파악해 한 번에 표를 채웁니다
- 서브페이지 스크래핑으로 각 공급사의 가격, 기능, 문서 페이지를 가져옵니다
- Google Sheets, Excel, Airtable, Notion 또는 CSV로 내보냅니다
API 우선 팀이라면 API 방식도 아주 간단합니다.
- Thunderbit에서 무료 API 키를 받습니다
- Distill 엔드포인트를 호출해 공개 페이지를 깔끔한 Markdown으로 바꿉니다
- Extract 엔드포인트에 스키마 설명을 넣어 구조화 JSON을 받습니다
- Batch 엔드포인트와 웹훅으로 더 큰 URL 목록을 처리합니다
- 결과를 앱, 스프레드시트, 데이터 웨어하우스, 벡터 DB, 모니터링 워크플로우로 보냅니다
10개 이상 공급사를 비교할 때, 가격 하위 페이지, 문서, 연동 페이지까지 포함하면 수작업 복붙만으로도 23시간이 금방 걸립니다. Thunderbit은 첫 추출 시간을 대략 1530분으로 줄여주고, 나머지는 검증과 판단에 쓰면 됩니다. 운영, 구매, 리서치, AI 제품 팀이 시간 압박 속에서 도구를 평가해야 한다면 꽤 실용적인 지름길입니다. 이런 워크플로우에 대해서는 코딩 없이 웹 스크래핑하기 가이드를 보거나, Thunderbit API 가격을 확인하거나, 안내 영상이 필요하면 YouTube 채널을 참고하세요.
우리 팀에 맞는 API 모니터링 도구 고르는 법
"최고의" API 모니터링 도구는 팀 규모, 기술 수준, 예산, 그리고 실패가 제품에 어떤 의미인지에 따라 달라집니다.
개인 개발자에게 Splunk는 필요 없습니다. 규제가 있는 엔터프라이즈는 cron 작업 하나에 기대면 안 됩니다. API 제품 팀은 업타임 ping보다 Moesif 스타일의 고객 분석이 더 필요할 수 있습니다. 이커머스 팀은 로그인, 검색, 장바구니 담기, 결제, 결제 승인 같은 핵심 경로 체크를 우선해야 합니다. AI나 데이터 제품 팀은 완전한 옵저버빌리티보다 먼저 Thunderbit 같은 웹 데이터 추출이 필요할 수 있습니다.
제가 조사 전반에서 일관되게 확인한 세 가지 원칙은 다음과 같습니다.
- 도구를 사용 사례에 맞추세요. 빠른 선택표가 있는 이유가 있습니다. 거기서 시작하세요.
- 알림 수보다 알림 품질을 우선하세요. 팀이 알림을 무시한다면, 그건 모니터링이 아니라 소음입니다.
- 설정 속도를 과소평가하지 마세요. 오늘 바로 가동되고 신뢰할 수 있는 알림을 주는 모니터가, 결제 실패를 한 달 더 방치하게 만드는 완벽한 플랫폼 계획보다 낫습니다.
여러 도구를 동시에 비교하고 리서치를 더 빨리 끝내고 싶다면, Thunderbit을 써서 공급사 데이터를 한 스프레드시트로 대량 추출해 보세요. API 제품, RAG 파이프라인, AI 에이전트, 시장 인텔리전스 워크플로우처럼 깨끗한 웹 데이터가 필요하다면 Thunderbit Open API부터 시작하세요. 모니터링 도구를 대신 골라주지는 않지만, 의사결정까지 훨씬 빨리 도달하게 해주고, 여러분의 제품에도 신뢰할 수 있는 웹 데이터 계층을 제공할 수 있습니다.
최고의 API 모니터링 도구 FAQ
2026년 가장 좋은 무료 API 모니터링 도구는 무엇인가요?
SaaS의 단순함을 원한다면 UptimeRobot이 5분 간격의 무료 모니터 50개를 제공하며 신용카드도 필요 없습니다. 셀프호스트 제어권을 원한다면 Uptime Kuma가 오픈소스에 무제한, 그리고 90개 이상의 알림 서비스를 갖춘 깔끔한 UI를 제공합니다. 이미 기술 역량이 있고 메트릭 깊이가 중요한 팀이라면 Prometheus + Grafana + Alertmanager가 최고의 오픈소스 스택입니다. 다만 설정은 몇 분이 아니라 몇 시간이 걸립니다.
목표가 업타임 모니터링이 아니라 API를 통해 웹 데이터를 추출하는 것이라면, Thunderbit Open API는 600개의 일회성 API 유닛을 제공하는 무료 티어가 있어 페이지를 Markdown으로 정리하거나 스키마 기반 JSON을 추출해 보기에 충분합니다.
API 모니터링과 APM의 차이는 무엇인가요?
API 모니터링은 외부에서 엔드포인트의 가용성, 응답 시간, 오류, 정확성을 확인합니다. 사용자나 통합 시스템이 어떤 경험을 하는지 시뮬레이션하는 셈입니다. APM(Application Performance Monitoring)은 애플리케이션 내부로 더 깊이 들어가 코드 수준 추적, 데이터베이스 쿼리, 런타임 오류, 큐 지연, 서비스 종속성을 봅니다. Datadog과 New Relic 같은 도구는 둘 다 제공하고, UptimeRobot과 Uptime Kuma는 외부 업타임 체크에 집중합니다.
Thunderbit Open API는 이 둘과도 다릅니다. 웹 데이터 추출 API입니다. 외부 웹사이트를 Markdown 또는 구조화 JSON으로 바꿔 주므로, LLM 앱, 리서치 워크플로우, 가격 인텔리전스, 데이터 파이프라인에 유용합니다.
API는 얼마나 자주 모니터링해야 하나요?
프로덕션의 매출 핵심 API(결제, 인증, 페이먼트)는 보통 1분마다 체크하는 것이 좋습니다. 내부용 또는 트래픽이 적은 API는 5분마다 체크해도 충분한 경우가 많습니다. 하지만 빈도만이 전부는 아닙니다. 재시도, 다중 리전, 의미 있는 assertion을 사용해 각 체크가 빠르면서도 신뢰할 수 있어야 합니다. 1분 간격인데 오탐이 많은 체크보다, 5분 간격이지만 믿을 수 있는 체크가 낫습니다.
웹 데이터 추출 워크플로우의 경우 소스가 얼마나 자주 바뀌는지에 따라 다릅니다. 가격 페이지는 일간 또는 주간 추출이면 충분할 수 있습니다. 재고, 여행, 마켓플레이스 같은 빠르게 변하는 데이터는 시간 단위 또는 그보다 더 자주 갱신해야 할 수도 있습니다. Thunderbit의 배치 API와 웹훅은 많은 URL을 스케줄대로 처리해야 할 때 유용합니다.
코드를 쓰지 않고도 API를 모니터링할 수 있나요?
네. UptimeRobot, Better Stack, Uptime Kuma는 전부 GUI만으로 사용할 수 있습니다. Checkly는 GUI와 코드 기반 설정을 모두 지원합니다. Postman은 컬렉션 기반 인터페이스를 사용합니다. Prometheus/Grafana는 보통 YAML과 PromQL이 필요합니다. Datadog과 New Relic은 가이드형 설정으로 시작할 수 있지만, 더 깊은 계측을 할수록 더 강력해집니다.
코딩 없이 웹사이트 데이터를 추출하고 싶다면, Thunderbit Chrome Extension이 노코드 경로입니다. 같은 워크플로우를 애플리케이션에서 자동화하고 싶다면, Thunderbit Open API가 Distill, Extract, Batch 엔드포인트를 제공합니다.
API 모니터링 알림 피로는 어떻게 줄이나요?
이상 탐지(Datadog, New Relic), 알림 전 재시도(Checkly), 행동 이상(Moesif), 그룹화/음소거(Prometheus Alertmanager) 같은 스마트 알림 기능이 있는 도구를 고르세요. 사용자 영향이 큰 알림 위주로 더 적고 더 신뢰도 높은 알림부터 시작하세요. 정적 임계치 대신 SLO burn-rate 알림을 쓰고, 서비스 간 중복을 제거하고, 소유권 기준으로 라우팅하며, 실행 가능성을 측정하세요. 알림 중 20% 미만만 실제 조치로 이어진다면, 먼저 노이즈부터 줄여야 합니다.
웹 데이터 추출을 위해 Thunderbit Open API를 사용해 보세요 Get Started Free
더 알아보기



