Estrattore di articoli per testo, autori e date













Raccogli dati dagli articoli anche quando il layout cambia
Leggi i campi in base al significato, programma esecuzioni ricorrenti e usa lo stesso flusso di lavoro su siti pubblici diversi.
Adattati ai cambiamenti di layout degli articoli
Thunderbit legge titoli, byline, date, riassunti e testo dell’articolo visibili in base al significato. Quando un sito di news cambia layout, il flusso dipende meno dalle posizioni fisse della pagina.
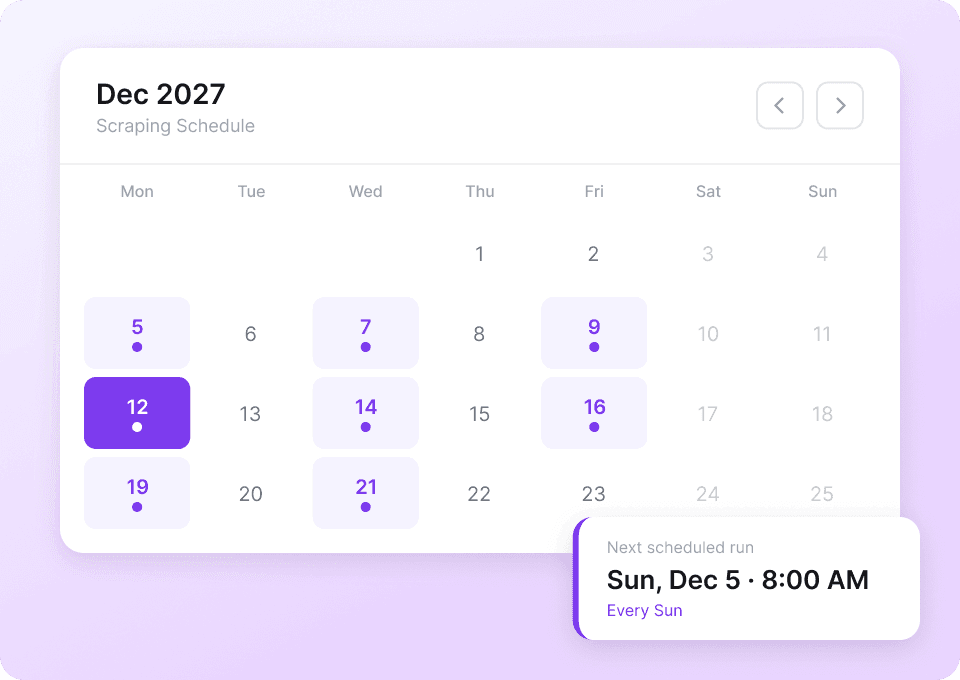
Esegui lo scraping degli articoli secondo pianificazione
Imposta un’esecuzione ricorrente per una pagina pubblica di news, blog o sezione che controlli spesso. Thunderbit può raccogliere gli ultimi articoli visibili e inviare nuove righe al file o all’app che hai scelto.
Usa un solo flusso di lavoro su qualsiasi sito pubblico
Usa lo stesso flusso di lavoro su qualsiasi sito pubblico con articoli. Indica i campi che ti servono, poi lascia che Thunderbit inserisca ogni pagina nelle stesse colonne.
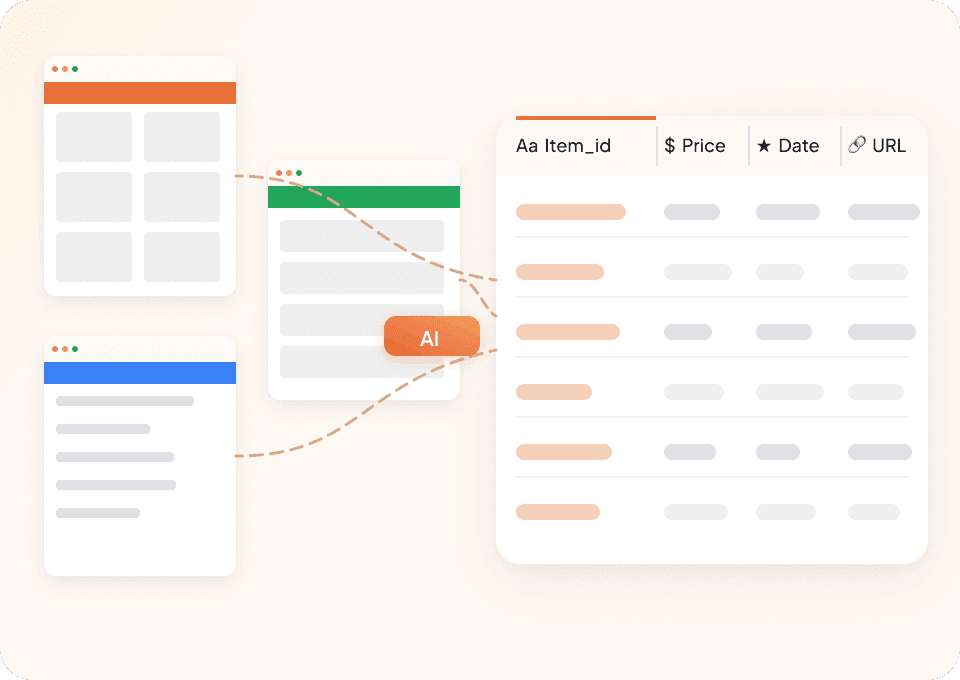
Un unico flusso di lavoro per articoli su layout diversi
I selettori fissi seguono le posizioni. L’AI di Thunderbit cerca i campi dell’articolo che hai indicato.
Una mappa di selettori per ogni editore
Ogni design della pagina richiede manutenzione separataCampi dell'articolo organizzati da Thunderbit
Il record richiesto resta coerenteQuali dati puoi estrarre da un articolo?
Scegli tra 30 campi visibili di contenuto, autore, editore, data, link, argomento, media e metadati della pagina.
- Titolo
- Titolo alternativo
- Testo dell'articolo
- Riassunto dell'articolo
- Nome autore
- URL autore
- Organizzazione dell'autore
- Nome editore
- URL editore
- Data di pubblicazione
- Data di modifica
- Sezione dell'articolo
- Parole chiave
- Conteggio parole
- Lingua
- URL canonico
- URL entità principale
- URL immagine
- Didascalia immagine
- Credito immagine
- URL video
- URL audio
- Indicazione di località
- Argomenti trattati
- Citazioni
- Link di citazione
- URL licenza
- Link ad articoli correlati
- Titolo della pagina
- Meta description
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.




Domande sullo scraping di articoli pubblici
I siti di news usano layout e dettagli di pagina diversi, quindi i campi disponibili dipendono dalla pagina dell’articolo che acquisisci.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Estrattore 4PDA
L'Estrattore 4PDA di Thunderbit ti permette di raccogliere dati da articoli di notizie e discussioni del forum 4PDA grazie all'intelligenza artificiale. Puoi velocemente ottenere titoli degli articoli, date di pubblicazione, autori e contenuti dei post per ricerche, analisi o monitoraggio delle conversazioni tech. Perfetto per appassionati di tecnologia, ricercatori e marketer che desiderano dati strutturati da 4PDA.
Scopri di più ->
Estrattore Ptt
L'Estrattore Ptt di Thunderbit ti permette di raccogliere dati da board e post di Ptt grazie a suggerimenti intelligenti basati sull'AI. Puoi ottenere nomi e URL delle board, popolarità, titoli dei post, autori e commenti, utili per ricerche, marketing o analisi dei contenuti. Perfetto per marketer, ricercatori e content creator che desiderano dati strutturati da Ptt.
Scopri di più ->
Estrattore Pizza Marketplace
L'Estrattore Web Pizza Marketplace di Thunderbit ti permette di raccogliere dati dalle sezioni notizie e dalle directory dei fornitori di Pizza Marketplace. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle notizie, date di pubblicazione, autori, nomi dei fornitori, sedi e contatti utili per ricerche, marketing o analisi.
Scopri di più ->
Estrattore Failory
L'Estrattore Failory di Thunderbit ti permette di raccogliere dati strutturati dal cimitero delle startup e dagli articoli di news di Failory. Grazie ai suggerimenti AI per i campi, puoi facilmente ottenere nomi di startup, anni, cause di fallimento, titoli degli articoli, autori e molto altro per ricerche o analisi. Perfetto per imprenditori, investitori e ricercatori che vogliono approfondire i dati di Failory.
Scopri di più ->
Investing.com scraper
Estrai dati di borsa — simboli, prezzi, volumi e capitalizzazione di mercato — da Investing.com in 2 clic, poi esportali direttamente su Google Sheets, Notion o Excel. Apri qualsiasi pagina di Investing.com e lascia che l’AI individui automaticamente i campi per te.
Scopri di più ->
Scraper per Substack
Estrai in 2 clic il numero di iscritti su Substack, i titoli degli articoli e le descrizioni delle pubblicazioni — poi esporta tutto in Excel, Google Sheets o Notion. Non serve alcun codice: l’AI di Thunderbit si occupa automaticamente di strutturare i dati.
Scopri di più ->Pronto a dare una spinta all'estrazione dati?
Unisciti a oltre 200.000 professionisti che già usano Thunderbit per automatizzare i loro flussi di web scraping.
La prova gratuita offre crediti illimitati per 8 pagine web.



