ESPN scraper yang mudah













Ekstrak data ESPN tanpa ribet
Thunderbit memudahkan Anda mengambil data olahraga dari ESPN hanya dalam beberapa klik.
Dua klik untuk scraping ESPN
Lupakan kode dan pengaturan yang rumit. Dengan Thunderbit, sorot data yang Anda butuhkan — nama atlet, skor, tanggal pertandingan, atau statistik apa pun — lalu ekstrak hanya dalam dua klik. Tanpa CSS selector, tanpa API yang merepotkan. Cukup arahkan, klik, dan dapatkan data ESPN yang Anda inginkan.
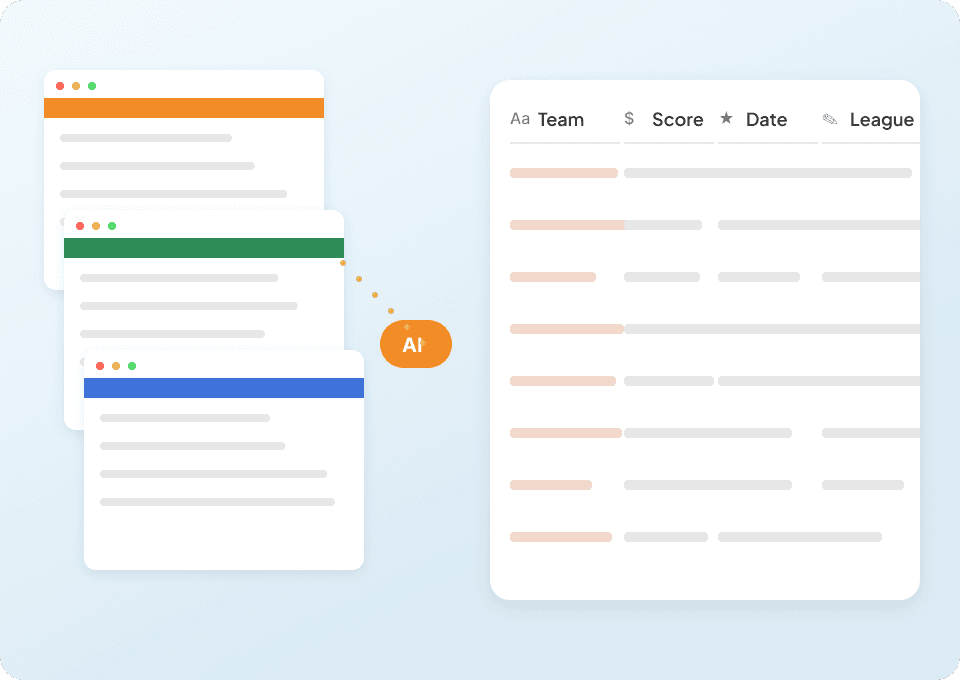
Data ESPN yang rapi, langsung jadi
Data mentah dari ESPN sering kali tidak konsisten dan sulit digunakan. Thunderbit otomatis membersihkan dan menyusun semuanya saat proses scraping berlangsung — statistik atlet, nama tim, status pertandingan — sehingga output langsung siap dianalisis atau dilaporkan begitu ekstraksi selesai. Tidak perlu pemformatan ulang manual.
Scrape banyak halaman ESPN sekaligus
Scraping ESPN satu halaman demi satu halaman hanya membuang jam kerja yang tidak Anda punya. Thunderbit otomatis mengunjungi dan mengekstrak data dari ratusan halaman ESPN dalam satu kali proses, mengikuti tautan ke halaman tim, profil pemain, atau rincian pertandingan individu. Cukup berikan URL awal, dan Thunderbit akan menangani sisanya.
Mengapa Thunderbit berbeda dari scraper ESPN tradisional?
Ekstrak data olahraga dengan mudah, bahkan saat tata letak ESPN berubah tanpa pemberitahuan.
Scraper tradisional
Cara lama dalam mengerjakan sesuatuThunderbit AI
Pendekatan yang lebih cerdas

Pertanyaan yang sering diajukan
Terkait use case
Jelajahi lebih banyak use case dari web scraper Thunderbit.

Investing.com scraper
Ambil data saham — simbol, harga, volume, dan kapitalisasi pasar — dari Investing.com hanya dalam 2 klik, lalu ekspor langsung ke Google Sheets, Notion, atau Excel. Buka halaman Investing.com mana saja dan biarkan AI mengenali field yang Anda butuhkan.
Pelajari lebih lanjut ->
Substack scraper
Ekstrak jumlah subscriber Substack, judul artikel, dan deskripsi publikasi hanya dengan 2 klik — lalu ekspor ke Excel, Google Sheets, atau Notion. Tanpa perlu coding; AI Thunderbit akan menangani struktur datanya untuk Anda.
Pelajari lebih lanjut ->
TechCrunch scraper
Ekstrak artikel TechCrunch, update startup, judul, tautan, tanggal, penulis, dan ringkasan hanya dalam 2 klik — tanpa perlu coding. Ekspor langsung ke Excel, Google Sheets, atau Notion, lalu ubah berita mentah menjadi data terstruktur yang siap dipakai.
Pelajari lebih lanjut ->
PubMed Scraper
PubMed Scraper dari Thunderbit membantu Anda mengekstrak data terstruktur dari hasil pencarian dan halaman artikel PubMed dengan bantuan AI. Ambil riset medis yang sedang tren, bukti uji klinis, abstrak, penulis, afiliasi, tanggal publikasi, dan tautan, lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion.
Pelajari lebih lanjut ->
Article Scraper untuk Teks, Penulis, dan Tanggal
Kumpulkan judul artikel, nama penulis, tanggal, ringkasan, isi artikel, tautan, dan media dari halaman artikel publik. Setiap detail artikel tetap rapi dalam satu baris yang jelas, meskipun situs berita menggunakan tata letak yang berbeda-beda.
Pelajari lebih lanjut ->
News Scraper: Hubungkan Judul Berita ke Detail Artikel Lengkap
Kumpulkan judul dari halaman topik, kategori, atau hasil pencarian, lalu buka tautan artikel untuk mengambil byline yang terlihat, tanggal terbit, ringkasan, bagian artikel, dan URL sumber. Beri tahu Thunderbit detail artikel mana yang Anda perlukan dalam bahasa sehari-hari sebelum proses dimulai.
Pelajari lebih lanjut ->Siap meningkatkan ekstraksi datamu?
Bergabunglah dengan 200.000+ profesional yang sudah menggunakan Thunderbit untuk mengotomatiskan workflow web scraping mereka.
Uji coba gratis memberi kredit tak terbatas untuk 8 halaman web.



