PubMed Scraper dari Thunderbit membantu Anda mengubah halaman PubMed menjadi dataset yang rapi dan terstruktur dengan AI. Anda bisa mengekstrak riset medis yang sedang tren, bukti uji klinis, abstrak, penulis, afiliasi, tanggal publikasi, PMID, dan tautan artikel, lalu mengekspornya ke Excel, Google Sheets, Airtable, atau Notion. Cukup buka PubMed di Chrome, biarkan AI menyarankan kolom terbaik, lalu lakukan scraping.
🧬 Apa itu PubMed Scraper
PubMed Scraper adalah AI Web Scraper yang dibuat untuk PubMed | US National Library of Medicine. Dengan Thunderbit (ekstensi Chrome AI web scraper), Anda bisa membuka halaman hasil PubMed apa pun, klik AI Suggest Columns, lalu klik Scrape untuk mengekstrak data terstruktur tanpa perlu menulis kode.
🔎 Apa yang bisa Anda scrape dari PubMed
PubMed menyimpan banyak metadata biomedis bernilai tinggi, tetapi hasilnya tidak selalu siap dianalisis. AI Web Scraper dari Thunderbit (https://thunderbit.com/) membantu Anda mengumpulkan dan menyusun daftar PubMed, lalu memperkaya datanya dengan detail level artikel melalui Subpage Scraping (membuka tiap halaman artikel dan menambahkan field seperti abstrak, afiliasi, DOI, dan lainnya).
Berikut dua workflow umum yang bisa Anda jalankan dalam hitungan menit.
📈 Scrape Pemantauan Riset Medis Tren di PubMed
Gunakan workflow ini untuk memantau topik yang sedang naik daun di riset medis pada halaman trending PubMed. Ini berguna untuk mengikuti perkembangan terbaru, membuat ringkasan internal, memantau publikasi kompetitor, atau memberi makan pipeline pemantauan literatur.
Contoh halaman tujuan: PubMed Trending
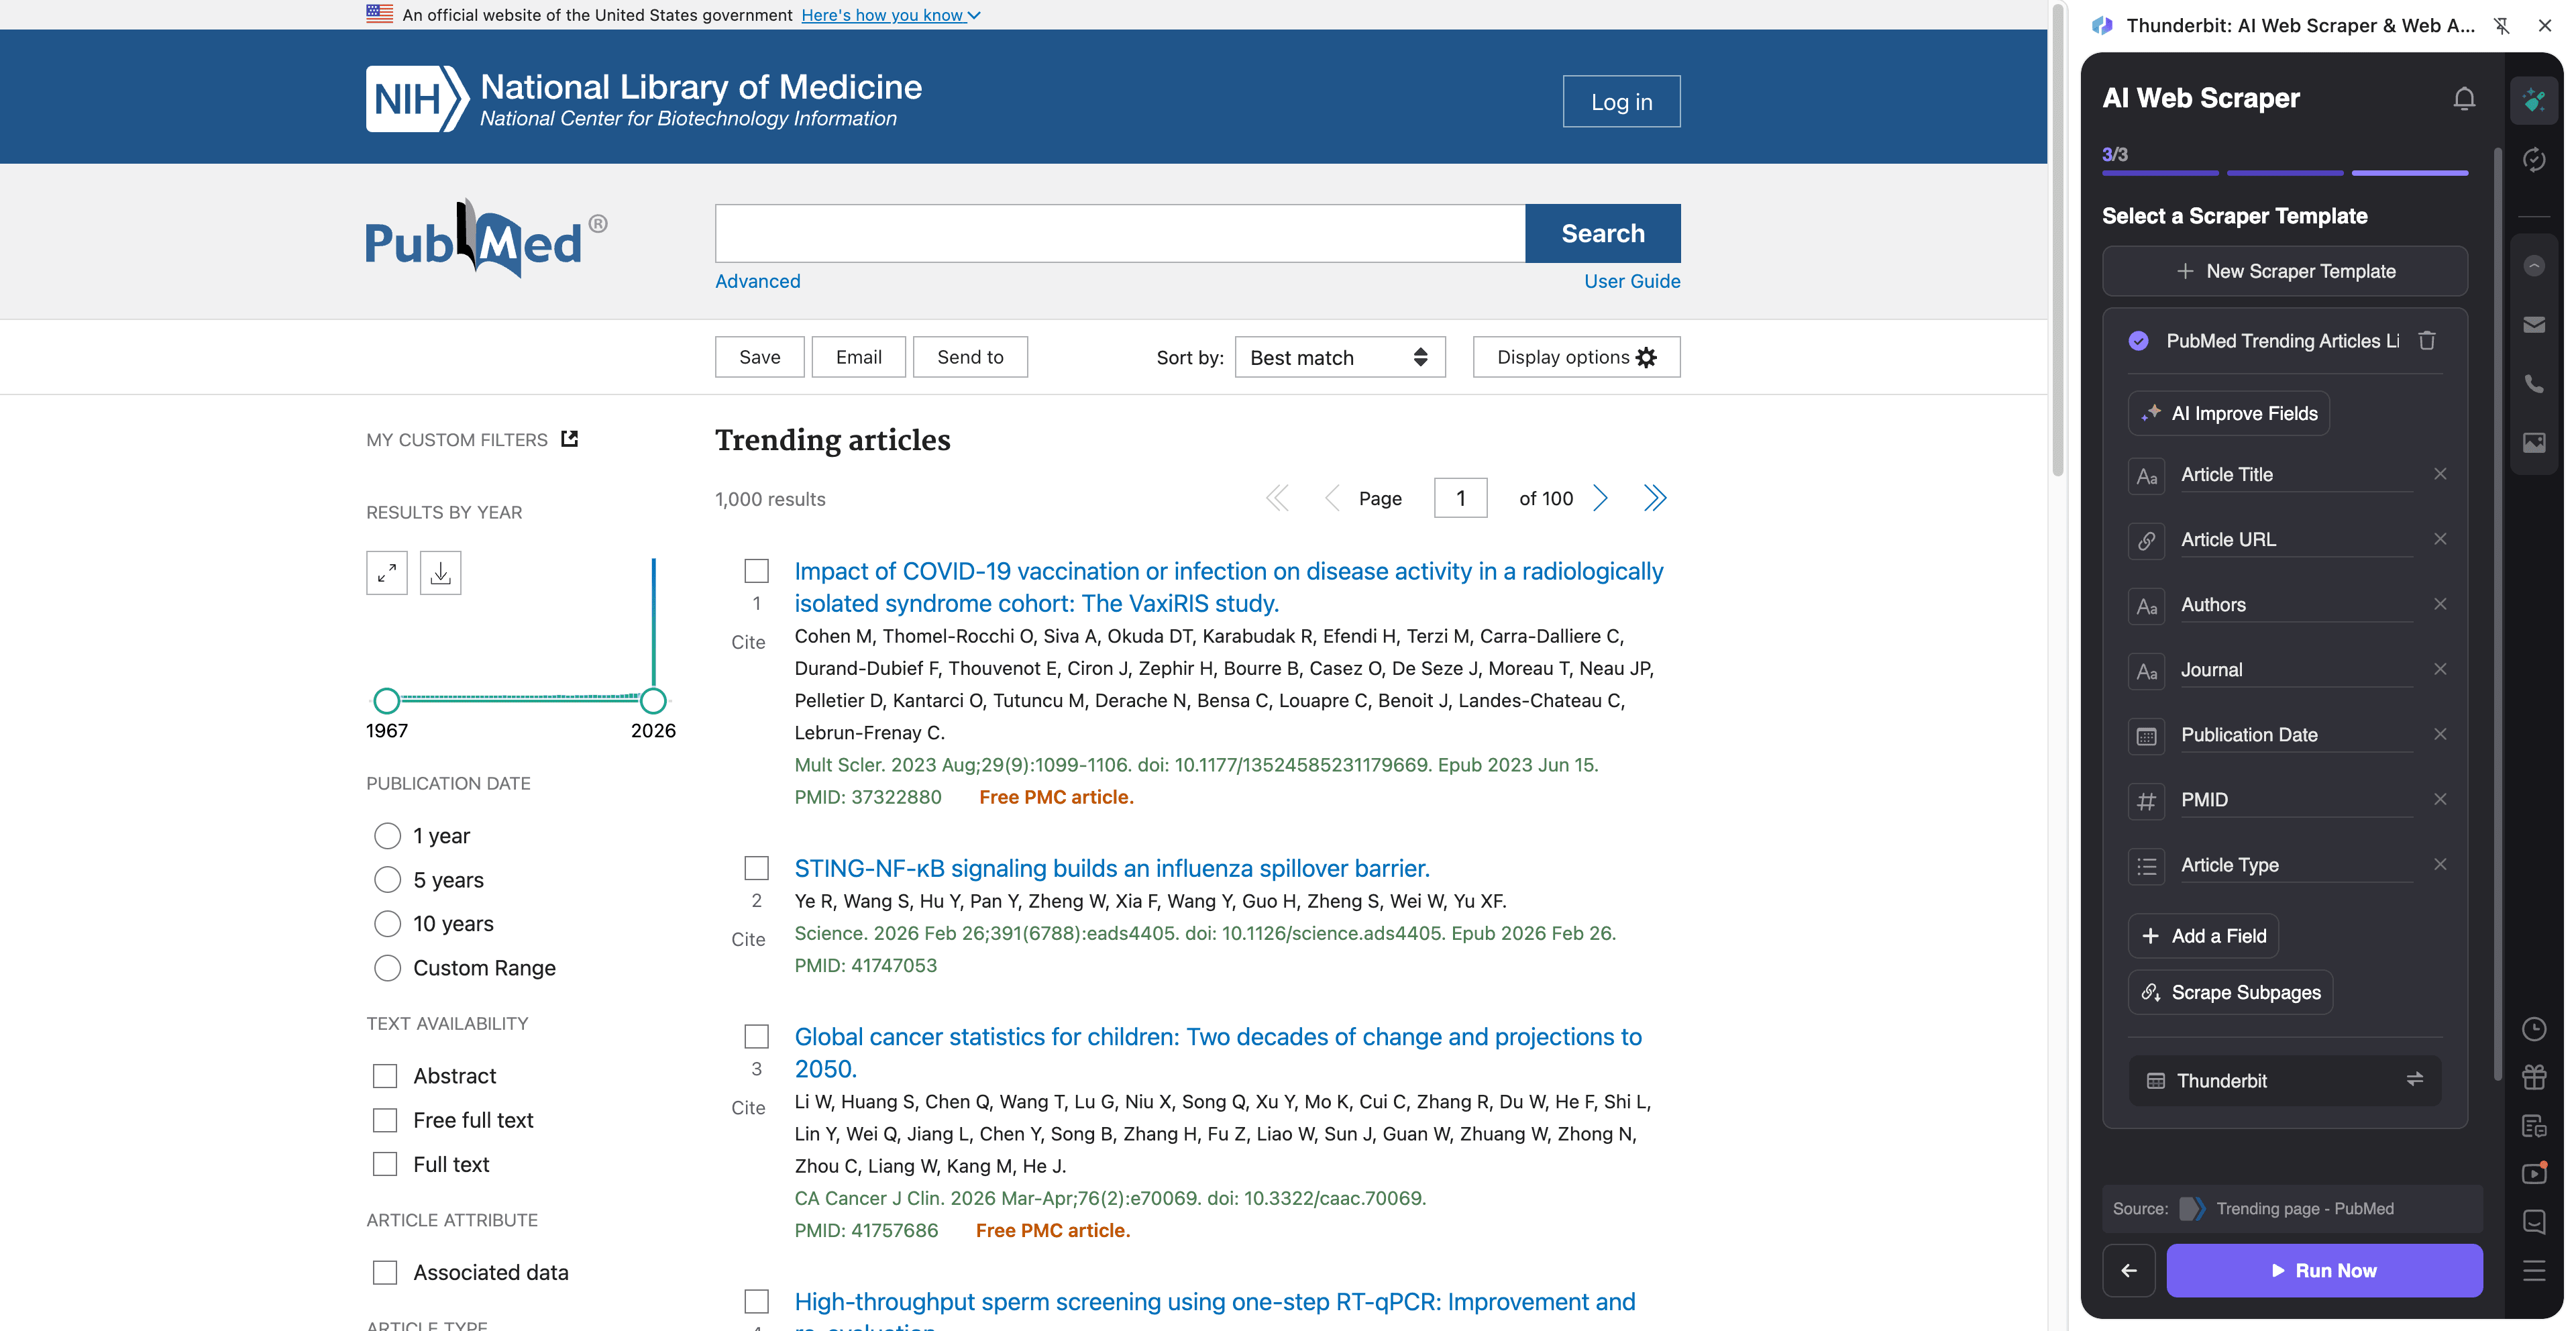
Langkah-langkah:
- Unduh Thunderbit Chrome Extension dan daftar akun.
- Buka halaman tujuan, misalnya: PubMed Trending.
- Klik AI Suggest Columns agar AI merekomendasikan nama kolom dan tipe data terbaik.
- Klik Scrape untuk mengekstrak data, lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion.
Nama kolom
| Kolom | Deskripsi |
|---|---|
| 🧾 Article Title | Judul artikel PubMed yang sedang tren. |
| 🔗 Article URL | Tautan langsung ke halaman record PubMed. |
| 🆔 PMID | Identitas PubMed untuk record tersebut (berguna sebagai kunci yang stabil). |
| 🏛️ Journal | Nama jurnal tempat artikel diterbitkan. |
| 📅 Publication Date | Tanggal publikasi yang ditampilkan di daftar. |
| ✍️ Authors | Rangkaian nama penulis yang tampil di kartu hasil. |
| 🧪 Article Type | Tipe publikasi jika tersedia (misalnya Review, Clinical Trial). |
| 🏷️ Keywords / Topics | Tag topik atau kata kunci yang terlihat di daftar (jika ada). |
| 📝 Snippet / Summary | Teks ringkas yang tampil di daftar (jika ada). |
| 🧷 DOI | DOI jika tersedia (biasanya paling baik diambil lewat subpage scraping). |
| 🧑🔬 Affiliations | Afiliasi penulis (umumnya diekstrak lewat subpage scraping). |
| 📄 Abstract | Teks abstrak (umumnya diekstrak lewat subpage scraping). |
🧫 Scrape Ekstraksi Bukti Uji Klinis di PubMed
Gunakan workflow ini untuk mengekstrak bukti terkait uji klinis dari hasil pencarian PubMed, lalu perkaya setiap baris dengan membuka halaman artikel untuk mengambil abstrak, sinyal uji klinis, dan metadata yang Anda perlukan untuk review.
Contoh halaman tujuan: Clinical trial search results
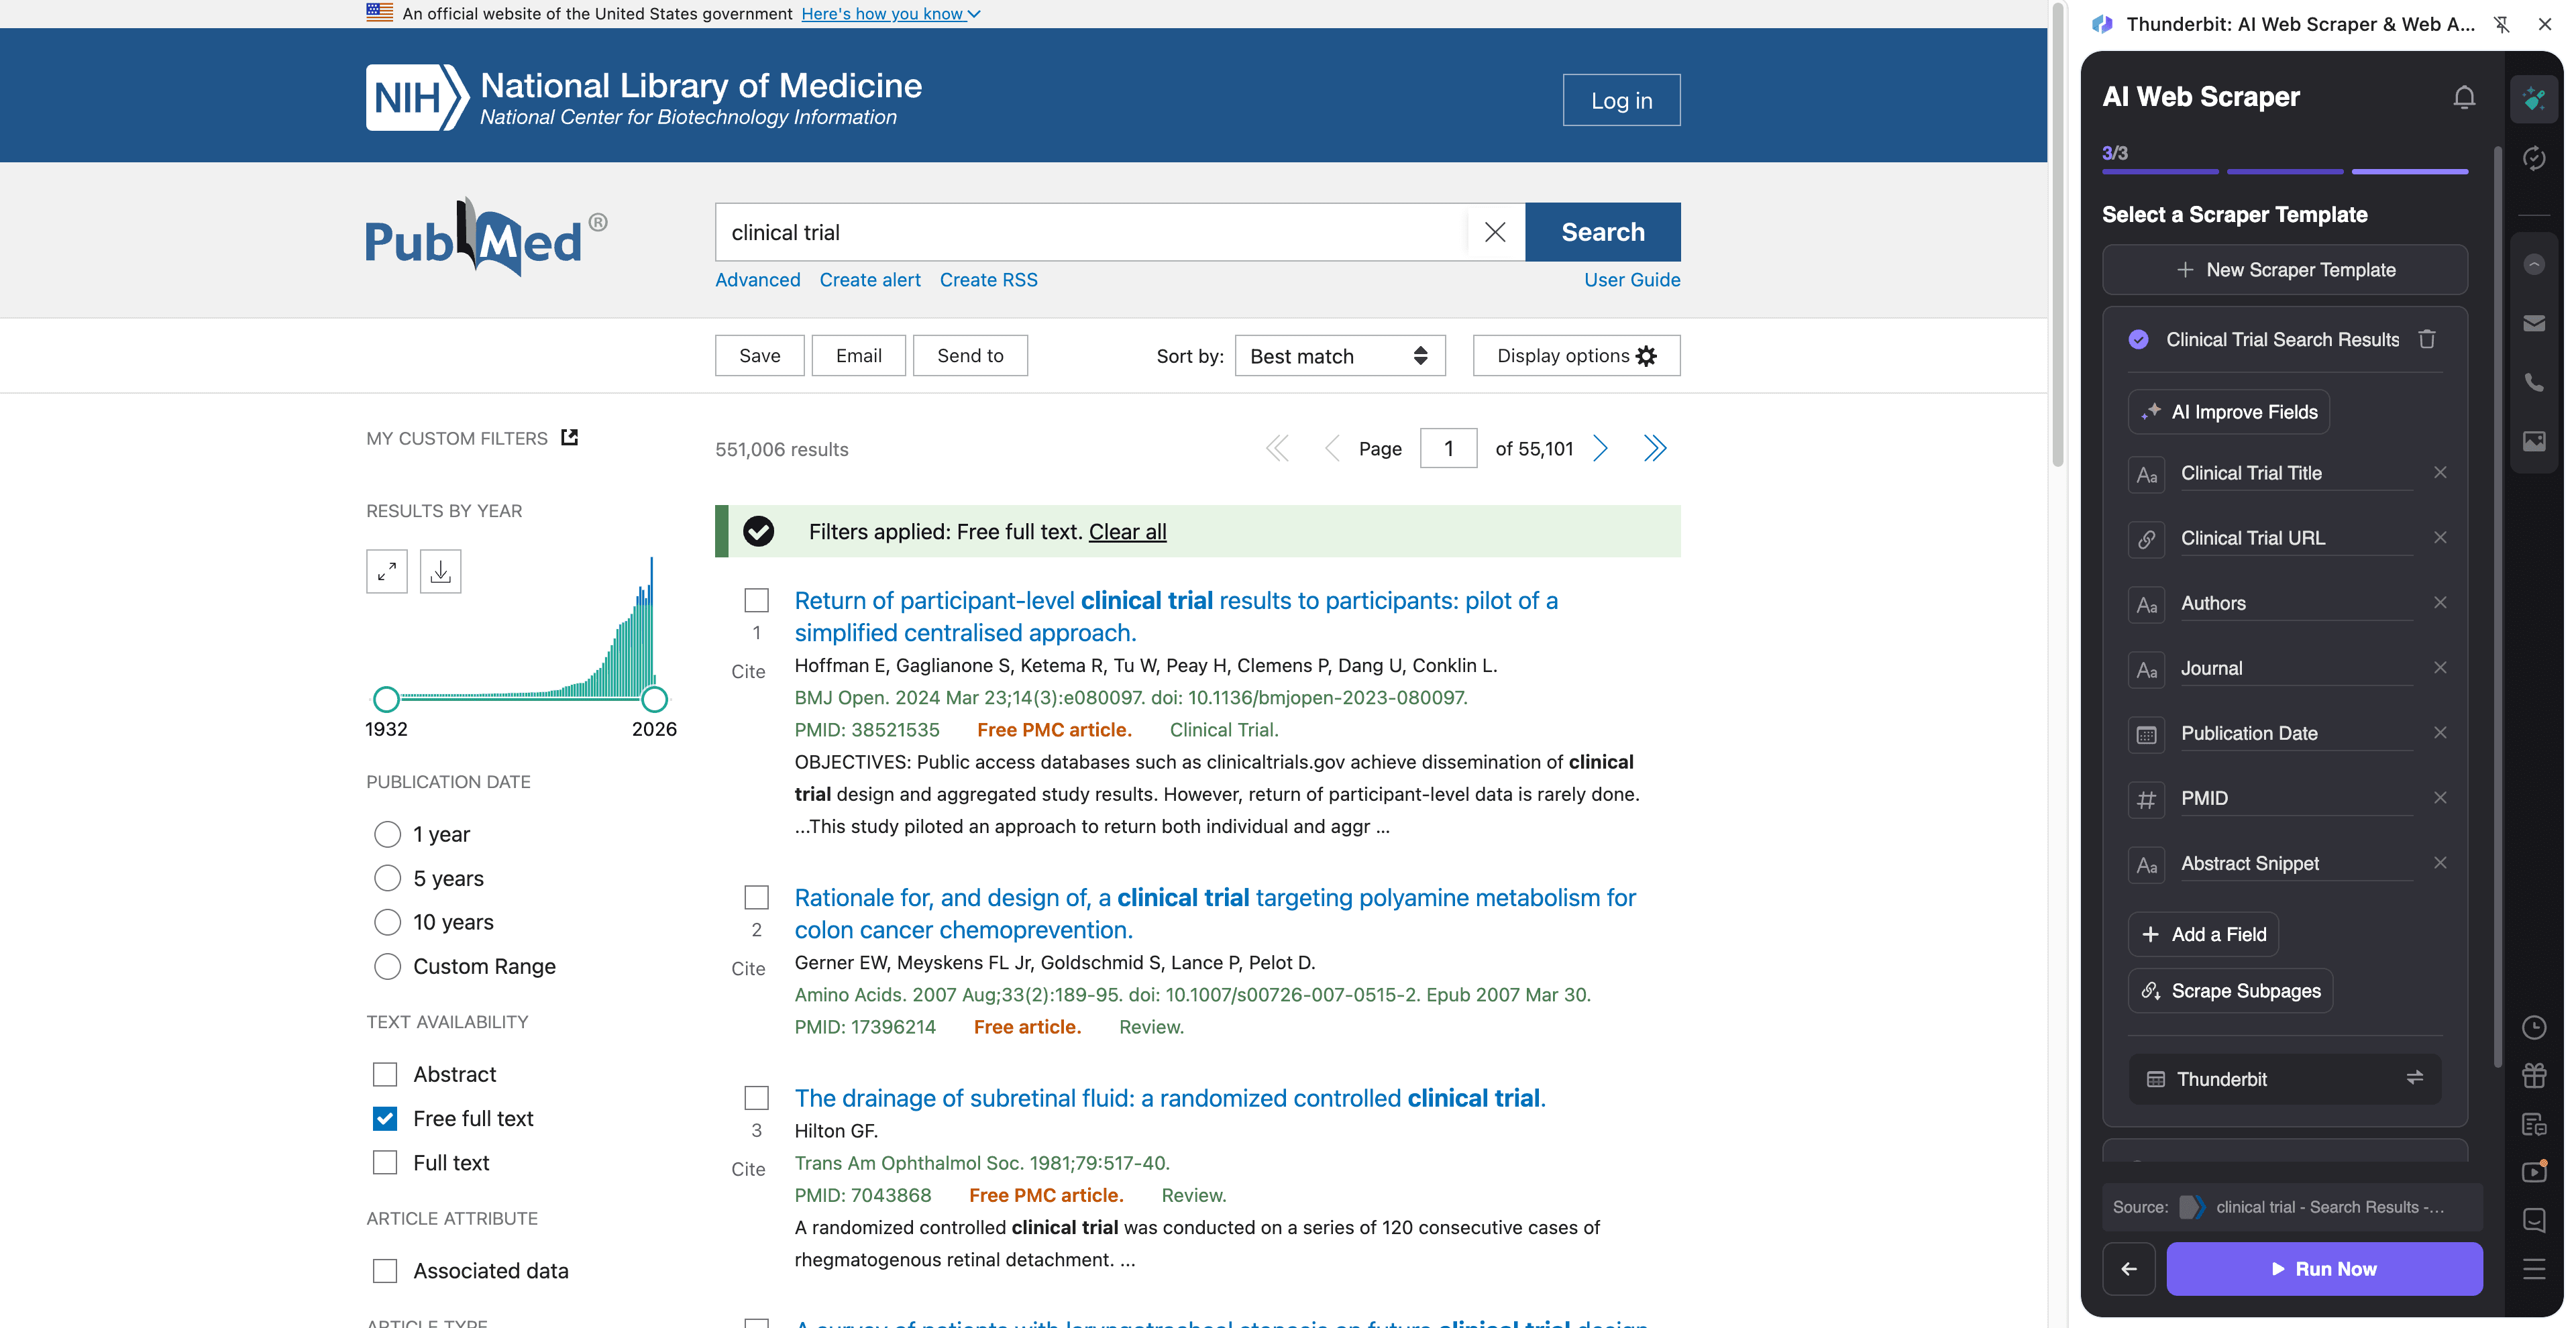
Langkah-langkah:
- Unduh Thunderbit Chrome Extension dan daftar akun.
- Buka halaman tujuan, misalnya: Clinical trial search results.
- Klik AI Suggest Columns untuk menghasilkan field yang direkomendasikan (Anda bisa mengganti nama atau menambah field sendiri).
- Klik Scrape untuk mengumpulkan hasil, lalu gunakan Scrape Subpages untuk memperkaya tiap baris dengan abstrak, afiliasi, DOI, dan lainnya.
Nama kolom
| Kolom | Deskripsi |
|---|---|
| 🧾 Title | Judul artikel dari hasil pencarian. |
| 🔗 PubMed URL | Tautan ke halaman artikel PubMed untuk enrichment subpage. |
| 🆔 PMID | Identitas PubMed untuk deduplikasi dan referensi. |
| 🧑⚕️ Authors | Penulis yang tercantum di cuplikan hasil. |
| 🏛️ Journal | Nama jurnal dan informasi sitasi yang tampil di hasil. |
| 📅 Date | Tanggal publikasi (atau tanggal ePub) yang ditampilkan di daftar. |
| 🧪 Publication Type | Penanda seperti Clinical Trial, Randomized Controlled Trial, Meta-Analysis (sering kali lebih jelas di halaman artikel). |
| 🧾 Abstract | Teks abstrak lengkap (terbaik melalui subpage scraping). |
| 🧬 MeSH Terms | Medical Subject Headings jika tersedia (sering kali ada di halaman artikel). |
| 🧷 DOI | DOI untuk menghubungkan ke halaman penerbit dan reference manager. |
| 🏥 Affiliations | Afiliasi penulis untuk analisis institusi (subpage scraping). |
| 🌍 Country / Institution | Diurai dari afiliasi menggunakan Field AI Prompts (opsional). |
| 🔍 Clinical Trial Keywords | Penanda berbasis AI seperti “randomized”, “double-blind”, “placebo” (opsional via Field AI Prompt). |
| 📎 Full Text Links | Tautan keluar ke penerbit atau full text gratis jika tersedia. |
🎯 Mengapa Menggunakan Tool PubMed
Scraping PubMed soal kecepatan, konsistensi, dan membuat data riset lebih mudah dipakai di seluruh workflow Anda. Alih-alih menyalin sitasi satu per satu, Anda bisa membangun dataset terstruktur yang bisa difilter, diberi tag, dan dibagikan.
Alasan umum tim melakukan scraping PubMed:
- Tim medical affairs & pharma: Melacak publikasi baru dalam area terapeutik, memantau uji kompetitor, dan membuat tabel bukti untuk review internal.
- Biotech & clinical operations: Mengumpulkan publikasi terkait uji klinis, memetakan institusi dan peneliti, serta menjaga bibliografi yang terus diperbarui.
- Tim marketing & content kesehatan: Mengidentifikasi topik yang sedang tren, jurnal berdampak tinggi, dan keyword baru untuk perencanaan konten.
- Peneliti akademik & pustakawan: Menyusun dataset untuk literature review, deduplikasi berdasarkan PMID, dan mengekspor ke spreadsheet untuk screening.
- Tim data: Membuat input terstruktur untuk analitik lanjutan, dashboard, atau knowledge base internal.
Thunderbit sangat membantu saat Anda membutuhkan lebih dari sekadar halaman daftar. Dengan Subpage Scraping, Anda bisa mengekstrak abstrak, afiliasi, DOI, MeSH terms, dan tautan full text dalam skala besar.
🧩 Cara Menggunakan Ekstensi Chrome PubMed
- Install Thunderbit Chrome Extension: Dapatkan dari Chrome Web Store dan buat akun Anda.
- Buka halaman PubMed: Buka PubMed, halaman trending seperti Trending, atau kueri seperti clinical trial results.
- Aktifkan AI-Powered Scraper: Klik AI Suggest Columns untuk menghasilkan field, sesuaikan tipe data (text/date/url), dan tambahkan Field AI Prompts opsional (untuk pelabelan, formatting, atau mengekstrak sinyal uji klinis).
- Scrape dan ekspor: Klik Scrape. Jika Anda membutuhkan abstrak/afiliasi/MeSH, jalankan Scrape Subpages untuk memperkaya tiap baris, lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion.
Bacaan yang berguna jika Anda sedang membangun workflow yang berulang:
- How to Scrape Any Website Using AI
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- What Is List Crawling and How to Do It Using AI
💳 Harga untuk PubMed
Thunderbit menggunakan sistem kredit yang sederhana:
- 1 kredit = 1 baris output di tabel hasil Anda (misalnya satu record PubMed).
- Ekspor data gratis: unduh CSV/JSON atau kirim ke Excel, Google Sheets, Airtable, atau Notion.
Anda bisa memulai dengan:
- Free tier: scrape 6 halaman per bulan (alokasi berbasis halaman di Free).
- Free trial: scrape 10 halaman gratis, cocok untuk menguji halaman PubMed trending dan beberapa halaman hasil uji klinis.
Jika Anda melakukan scraping secara rutin (monitoring mingguan, pembaruan bukti, atau kueri besar), paket berbayar memberi lebih banyak kredit. Paket tahunan biasanya lebih hemat karena ada diskon dibanding bayar per bulan.
Anda bisa melihat opsinya di Thunderbit Pricing.
❓ FAQ
-
Apa itu AI Powered PubMed Scraper?
AI Powered PubMed Scraper adalah workflow di Thunderbit yang mengekstrak data terstruktur dari hasil pencarian dan halaman artikel PubMed. Anda bisa menggunakan AI untuk menyarankan kolom, melakukan scraping daftar hasil, dan memperkaya tiap baris dengan membuka subpage artikel untuk mengambil abstrak, afiliasi, DOI, dan lainnya. -
Apa itu Thunderbit?
Thunderbit adalah ekstensi Chrome AI web scraper yang dirancang untuk workflow bisnis dan riset yang membutuhkan data terstruktur dari website. Thunderbit membantu Anda mengekstrak, memberi label, dan mengekspor data dengan cepat tanpa perlu membuat atau memelihara script scraping. -
Apakah bisa scrape halaman trending PubMed dan hasil pencarian biasa?
Ya. Anda bisa scrape halaman PubMed Trending, pencarian kata kunci standar, dan halaman hasil yang difilter (misalnya kueri yang fokus pada clinical trial). AI Thunderbit beradaptasi dengan tata letak yang berbeda dengan membaca halaman dan mengusulkan field. -
Bisakah Thunderbit mengekstrak abstrak, afiliasi, dan MeSH terms?
Ya, dan di sinilah Subpage Scraping paling membantu. Anda bisa scrape daftar hasil terlebih dahulu, lalu minta Thunderbit membuka tiap halaman record PubMed untuk mengekstrak teks abstrak, afiliasi, MeSH terms, DOI, dan metadata lain ke tabel yang sama. -
Bagaimana pagination dan infinite scroll bekerja di PubMed?
Thunderbit mendukung scraping pagination, termasuk navigasi model “next page”. Jika PubMed mengubah cara hasil dimuat, ekstraksi berbasis AI dirancang lebih tahan terhadap perubahan dibanding selector yang kaku, karena ia membaca ulang struktur halaman setiap kali berjalan. -
Format apa saja yang bisa digunakan untuk ekspor data PubMed?
Anda bisa mengekspor ke CSV atau JSON, atau mengirim dataset ke Excel, Google Sheets, Airtable, atau Notion. Ini berguna untuk workflow screening, tabel bukti, dashboard, dan berbagi dengan kolaborator. -
Berapa banyak record PubMed yang bisa saya scrape gratis?
Pada Free tier, Anda bisa scrape 6 halaman per bulan, yang sering kali cukup untuk tugas monitoring kecil. Dengan free trial, Anda bisa scrape 10 halaman gratis untuk memvalidasi pengaturan kolom dan strategi enrichment subpage. -
Apakah saya bisa menyesuaikan kolom untuk kebutuhan ekstraksi bukti tertentu?
Ya. Anda bisa mengganti nama kolom, menentukan tipe data (text/date/url), dan menambahkan Field AI Prompts untuk mengekstrak atau memberi label informasi seperti keyword desain uji, populasi, intervensi, pembanding, outcome, atau negara dari afiliasi. Ini membantu Anda melampaui scraping mentah menuju persiapan bukti yang terstruktur. -
Apakah boleh melakukan scraping PubMed?
PubMed adalah sumber publik, dan banyak tim mengumpulkan metadata bibliografis untuk riset dan analisis. Meski begitu, Anda tetap harus mematuhi hukum yang berlaku, menghormati ketentuan situs, dan menggunakan praktik scraping yang bertanggung jawab, terutama jika menjalankan proses besar dan sering.
📚 Pelajari Lebih Lanjut
- Dapatkan ekstensi: Thunderbit Chrome Extension Download Page
- Jelajahi panduan di Thunderbit Blog
- Pelajari dasar-dasarnya: What Is Data Scraping and How to Do It in 2025
- Bangun workflow list: What Is List Crawling and How to Do It Using AI
- Ekspor ke spreadsheet: How to Scrape Website Data into Excel using AI
- Jika Anda juga melakukan scraping PDF dalam research ops: How to Scrape Data from PDF using AI