Article Scraper untuk Teks, Penulis, dan Tanggal













Kumpulkan data artikel di berbagai tata letak halaman
Baca bidang berdasarkan makna, jadwalkan repeat run, dan gunakan alur kerja yang sama di berbagai situs publik.
Beradaptasi saat tata letak artikel berubah
Thunderbit membaca judul, byline, tanggal, ringkasan, dan teks artikel yang terlihat berdasarkan maknanya. Alur kerja ini tidak terlalu bergantung pada posisi tetap di halaman ketika situs berita mengubah tata letaknya.
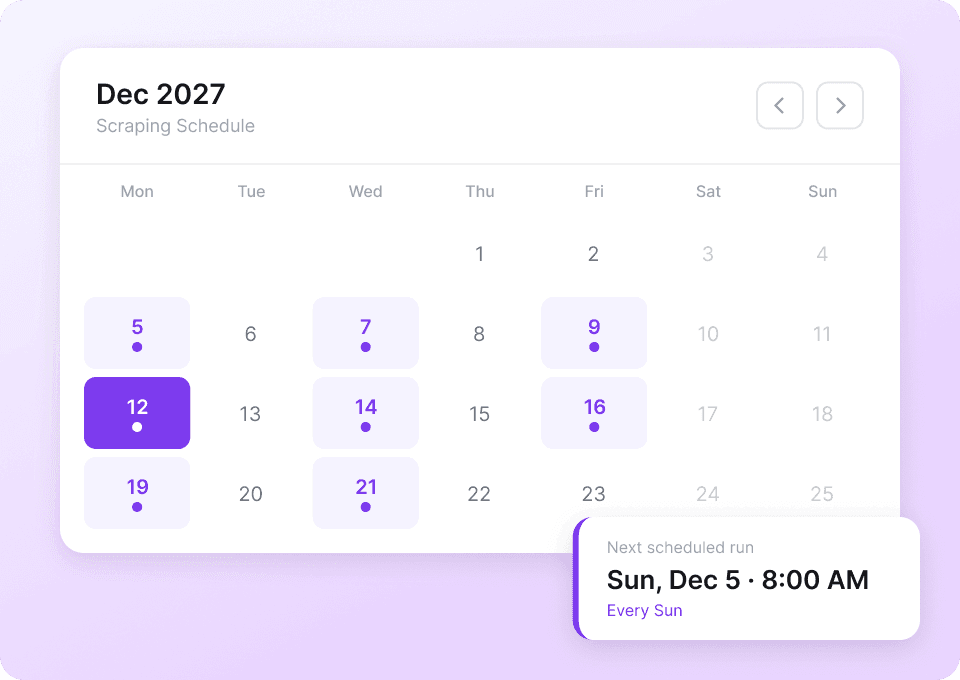
Jalankan scraping artikel sesuai jadwal
Atur repeat run untuk halaman berita, blog, atau bagian publik yang sering Anda kunjungi. Thunderbit dapat mengumpulkan artikel terbaru yang terlihat dan mengirim baris baru ke file atau aplikasi pilihan Anda.
Gunakan satu alur kerja di situs publik mana pun
Gunakan alur kerja yang sama di situs publik mana pun yang berisi artikel. Tentukan bidang yang Anda butuhkan, lalu biarkan Thunderbit menempatkan setiap halaman ke kolom yang sama.
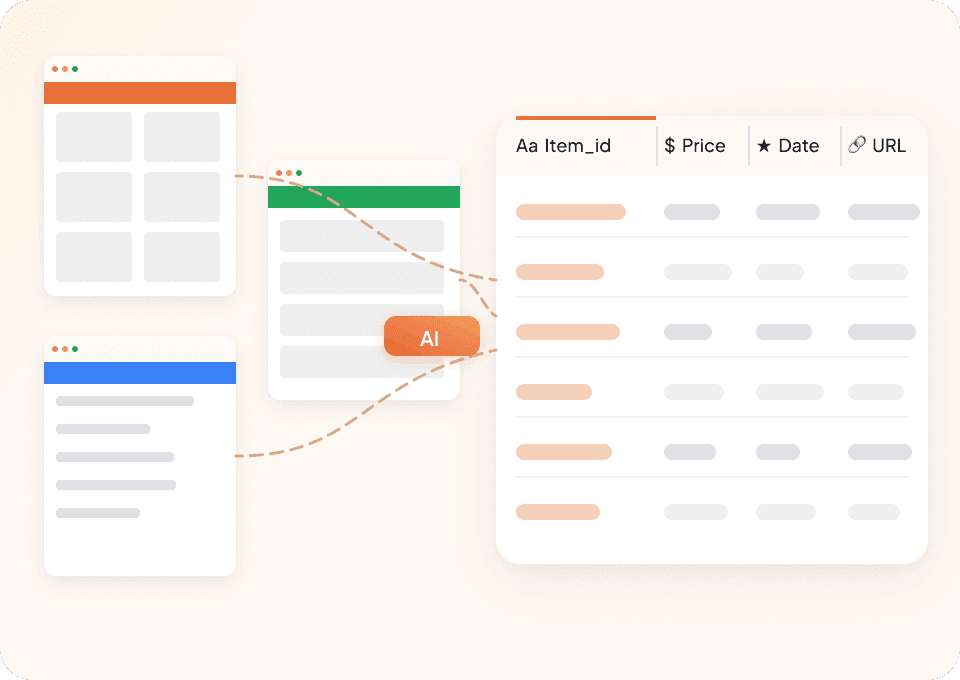
Satu alur kerja artikel untuk berbagai tata letak halaman
Selector tetap mengikuti posisi. AI Thunderbit mencari bidang artikel yang Anda sebutkan.
Peta selector untuk setiap penerbit
Setiap desain halaman butuh pemeliharaan terpisahBidang artikel diatur oleh Thunderbit
Catatan yang diminta tetap konsistenData apa saja yang bisa diekstrak dari sebuah artikel?
Pilih dari 30 bidang yang terlihat untuk konten, penulis, penerbit, tanggal, tautan, topik, media, dan metadata halaman.
- Judul
- Judul Alternatif
- Isi Artikel
- Ringkasan Artikel
- Nama Penulis
- URL Penulis
- Organisasi Penulis
- Nama Penerbit
- URL Penerbit
- Tanggal Terbit
- Tanggal Diubah
- Bagian Artikel
- Kata Kunci
- Jumlah Kata
- Bahasa
- URL Kanonik
- URL Entitas Utama
- URL Gambar
- Keterangan Gambar
- Kredit Gambar
- URL Video
- URL Audio
- Garis Tanggal
- Topik Tentang
- Penyebutan
- Tautan Sitasi
- URL Lisensi
- Tautan Artikel Terkait
- Judul Halaman
- Meta Deskripsi
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.

Pertanyaan tentang scraping artikel publik
Situs berita memakai tata letak dan detail halaman yang berbeda, jadi bidang yang Anda dapat bergantung pada halaman artikel yang diambil.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Investing.com scraper
Ambil data saham — simbol, harga, volume, dan kapitalisasi pasar — dari Investing.com hanya dalam 2 klik, lalu ekspor langsung ke Google Sheets, Notion, atau Excel. Buka halaman Investing.com mana saja dan biarkan AI mengenali field yang Anda butuhkan.
Pelajari lebih lanjut ->
Substack scraper
Ekstrak jumlah subscriber Substack, judul artikel, dan deskripsi publikasi hanya dengan 2 klik — lalu ekspor ke Excel, Google Sheets, atau Notion. Tanpa perlu coding; AI Thunderbit akan menangani struktur datanya untuk Anda.
Pelajari lebih lanjut ->
TechCrunch scraper
Ekstrak artikel TechCrunch, update startup, judul, tautan, tanggal, penulis, dan ringkasan hanya dalam 2 klik — tanpa perlu coding. Ekspor langsung ke Excel, Google Sheets, atau Notion, lalu ubah berita mentah menjadi data terstruktur yang siap dipakai.
Pelajari lebih lanjut ->
ESPN scraper yang mudah
Lacak nama atlet, tanggal pertandingan, dan skor dari ESPN hanya dalam 2 klik dengan AI Thunderbit — tanpa coding, tanpa pengaturan. Ekspor langsung ke Excel, Google Sheets, atau Notion dan manfaatkan data olahraga Anda seketika.
Pelajari lebih lanjut ->
PubMed Scraper
PubMed Scraper dari Thunderbit membantu Anda mengekstrak data terstruktur dari hasil pencarian dan halaman artikel PubMed dengan bantuan AI. Ambil riset medis yang sedang tren, bukti uji klinis, abstrak, penulis, afiliasi, tanggal publikasi, dan tautan, lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion.
Pelajari lebih lanjut ->
News Scraper: Hubungkan Judul Berita ke Detail Artikel Lengkap
Kumpulkan judul dari halaman topik, kategori, atau hasil pencarian, lalu buka tautan artikel untuk mengambil byline yang terlihat, tanggal terbit, ringkasan, bagian artikel, dan URL sumber. Beri tahu Thunderbit detail artikel mana yang Anda perlukan dalam bahasa sehari-hari sebelum proses dimulai.
Pelajari lebih lanjut ->Siap meningkatkan ekstraksi datamu?
Bergabunglah dengan 200.000+ profesional yang sudah menggunakan Thunderbit untuk mengotomatiskan workflow web scraping mereka.
Uji coba gratis memberi kredit tak terbatas untuk 8 halaman web.



