
Kalau Anda pernah mencari alat web scraping lalu menemukan Thunderbit dan Bright Data sekaligus, Anda mungkin langsung sadar: keduanya bukan produk yang sejenis. Memang karena memang bukan.
Satu adalah ekstensi browser berbasis AI yang dirancang untuk pengguna bisnis yang ingin mendapatkan data terstruktur dari halaman web dalam hitungan menit. Yang satunya lagi adalah platform web data infrastructure modular dengan jaringan proxy di 195+ negara, berbagai scraper API, browser terkelola, dan sertifikasi kepatuhan enterprise. Mereka memang muncul di hasil pencarian yang sama, tetapi mereka menyelesaikan masalah yang sangat berbeda untuk orang yang sangat berbeda. Saya sudah banyak membedah keduanya — cara kerjanya, biayanya, di mana mereka unggul, dan di mana mereka kurang — dengan tujuan membantu Anda menentukan mana yang benar-benar cocok untuk kebutuhan Anda. Bukan kebutuhan ideal di atas kertas. Tapi alur kerja Anda yang benar-benar dipakai.
Thunderbit vs Bright Data Sekilas
Sebelum masuk lebih dalam, ini ringkasan cepatnya.
| Dimensi | Thunderbit | Bright Data |
|---|---|---|
| Jenis produk | Ekstensi browser AI + web app + API | Platform web data infrastructure (proxy, API, scraper, dataset) |
| Pengguna utama | Pengguna bisnis, sales ops, marketer, freelancer | Developer, data engineer, tim data enterprise |
| Model setup | Pasang ekstensi, buka halaman, scraping | Pilih produk, konfigurasi kredensial/scraper, jalankan |
| Ramah no-code | Alur utama memang no-code | Ada jalur no-code (Scraper Studio AI Agent, kolektor siap pakai, dataset), tapi fitur yang lebih dalam butuh setup teknis |
| Model harga | Kredit (baris) untuk ekstensi; unit API untuk API | Per request, per record, per GB, atau per IP tergantung produk |
| Pendekatan skala | Per halaman atau terjadwal; API untuk pekerjaan lebih besar | API berkonkurensi tinggi, browser terkelola, jaringan proxy |
| Ekspor/pengiriman | Google Sheets, Excel, Airtable, Notion, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, cloud storage, SFTP, email, warehouse |
| Cocok untuk | Ekstraksi ad-hoc, daftar prospek, riset cepat, monitoring volume sedang | Pipeline skala besar, target dengan anti-bot berat, kepatuhan enterprise, aliran data berkelanjutan |
Terus baca untuk pembahasan lengkap — fitur, harga, use case nyata, dan matriks keputusan di bagian akhir.
Apa Itu Thunderbit?

Thunderbit adalah agentic web scraper dan platform otomasi yang dibuat untuk pengguna bisnis. Wajah utamanya adalah ekstensi browser Chrome/Edge, yang dilengkapi dengan web app, Open API, MCP Server untuk alur kerja AI agent, dan CLI.
Thunderbit adalah agentic web scraper: pada halaman yang kompatibel dan berizin, klik One Click Extract dan agent akan mendeteksi, membaca, lalu menganalisis halaman untuk menentukan apa yang perlu diambil. Run Now bisa langsung memulai, tetapi jika Anda tidak melakukan apa-apa, tugas akan berjalan otomatis — jadi pengalaman default-nya hanya butuh satu klik yang disengaja, tanpa kode, selector, atau setup skema.
Alur intinya sederhana: buka halaman di browser lalu klik One Click Extract. Agent akan mendeteksi, membaca, dan menganalisis halaman; Run Now bisa langsung memulai, sedangkan jika tidak, ekstraksi berjalan otomatis sebelum Anda mengekspor ke Google Sheets, Excel, Airtable, atau Notion. Anda juga bisa memakai Cloud Mode untuk halaman publik, membuat jadwal berulang, dan memanfaatkan template untuk situs populer. AI-nya bukan hanya menyarankan field — AI juga bisa mengubah, menerjemahkan, mengelompokkan, meringkas, atau memformat nilai saat ekstraksi lewat Field AI Prompts.
Thunderbit juga punya Open API yang mendukung Distill (konten halaman mentah), Extract terstruktur, batch asinkron, kontrol render, target negara, dan webhook. Tapi pengalaman utamanya — hal yang paling sering dipakai pengguna — tetap alur no-code di dalam browser.
Apa Itu Bright Data?
Bright Data adalah platform infrastruktur dan delivery data web publik yang luas. Ini bukan satu alat tunggal; melainkan sistem modular di mana Anda memilih produk yang sesuai dengan kebutuhan pengumpulan data Anda.
Keluarga produknya meliputi:
- Unlocker API — akses HTML/JSON yang sudah dibuka untuk halaman terlindungi
- SERP API — hasil mesin pencari yang terstruktur
- Browser API / Agent Browser — Chromium terkelola lewat Puppeteer, Playwright, atau Selenium
- Crawl API — crawling, parsing, dan pengiriman berbasis cloud
- Scraper APIs — kolektor terstruktur siap pakai untuk domain populer
- Scraper Studio — AI Agent (no-code) atau JavaScript IDE untuk scraper kustom
- Datasets dan Data Firehose — aliran data siap pakai atau berkelanjutan
- Jaringan proxy — residential (Bright Data mengklaim 400M+ IP residential per bulan di 195+ negara), datacenter, ISP, dan mobile
- MCP Server — untuk alur kerja yang berorientasi agent
Basis pelanggan Bright Data lebih condong ke tim enterprise dan developer. Mereka mendokumentasikan ISO 27001/27017/27018, SOC 2 Type II (di bawah NDA), SOC 3 publik, CSA STAR, dan proses KYC/review use case. Platform ini dirancang untuk tim yang membutuhkan kontrol proxy, browser, geo, session, dan compliance secara mendalam dalam skala besar.
Browser Extension vs. Proxy Infrastructure: Dua Pendekatan yang Berbeda untuk Web Scraping
Banyak artikel perbandingan melewatkan perbedaan arsitektur ini — padahal inilah yang benar-benar menentukan alat mana yang Anda butuhkan.
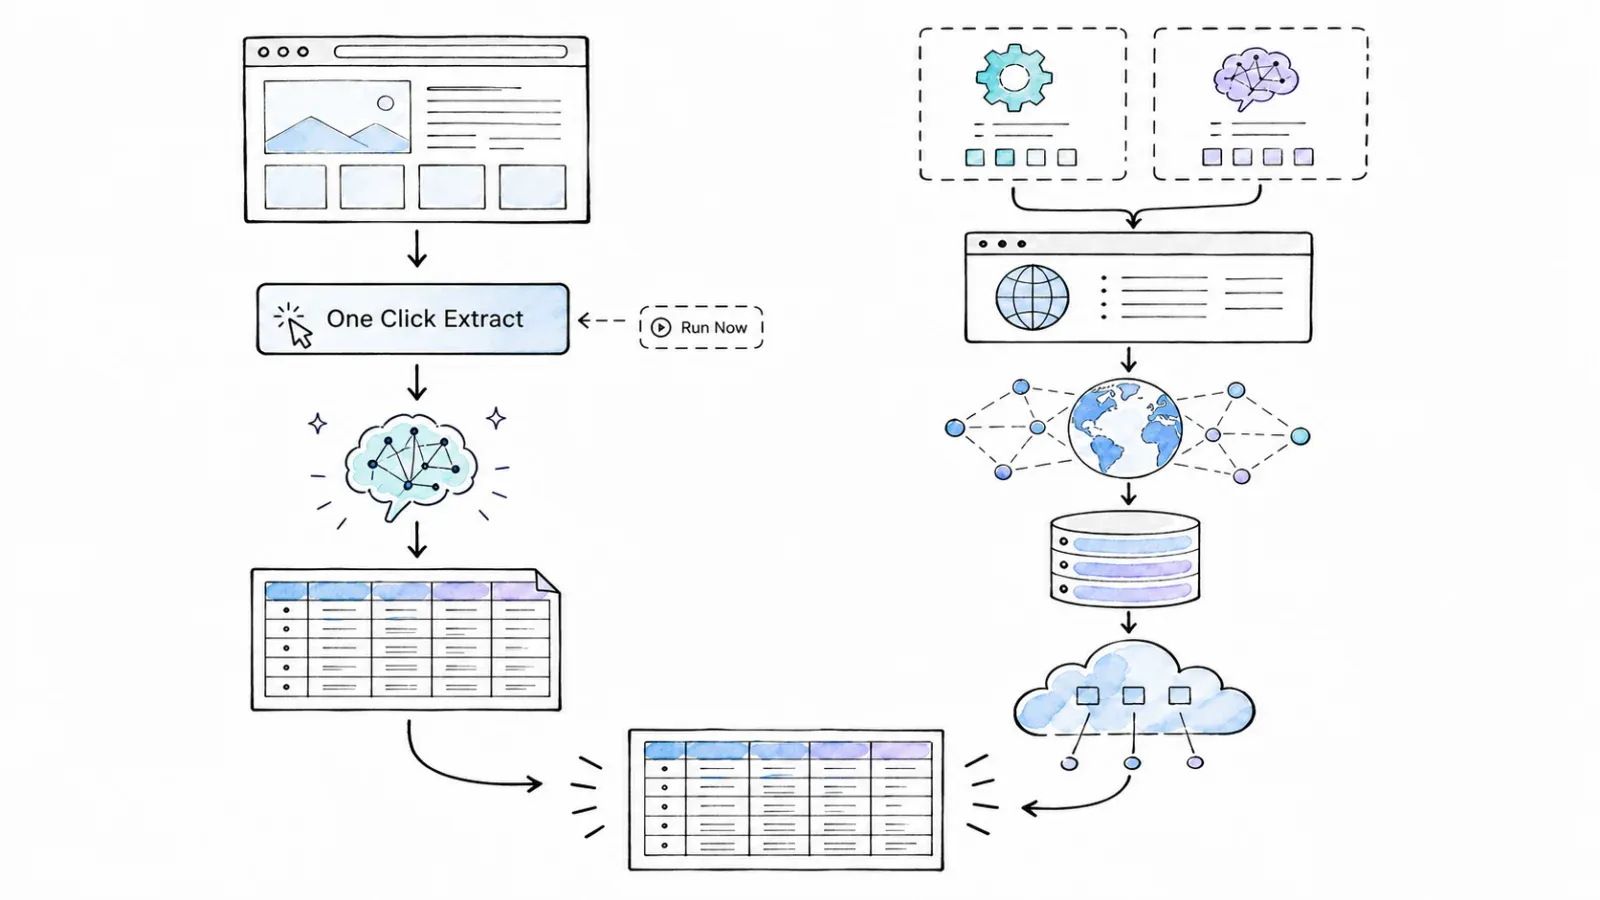
Model Thunderbit: Anda memasang ekstensi browser, membuka halaman yang ingin diambil datanya, lalu mengekstrak data terstruktur dari apa yang Anda lihat. AI akan menyarankan kolom. Anda bisa scraping dari halaman saat ini (Browser Mode dapat memakai sesi browser aktif Anda pada halaman yang kompatibel) atau lewat Cloud Mode untuk halaman publik. Anggap saja ini seperti lapisan copy-paste pintar di atas browser Anda — yang paham tabel, daftar, dan struktur halaman.
Model Bright Data: Anda memilih produk dari platform modular, mengonfigurasi kredensial dan logika scraper (atau memakai AI Agent untuk membuatnya), lalu menjalankan ekstraksi melalui infrastruktur cloud Bright Data. Permintaan bisa diarahkan lewat jutaan IP, browser terkelola menangani rendering dan tantangan anti-bot, lalu data dikirim lewat API, webhook, cloud storage, atau tujuan lain. Anggap saja ini seperti infrastruktur pipa untuk pengumpulan data skala besar — Anda memilih jalurnya, tekanannya, dan tujuannya.
Begini perbandingan arsitekturnya:
| Dimensi | Thunderbit | Bright Data |
|---|---|---|
| Lingkungan eksekusi | Browser pengguna (Browser Mode) atau cloud (Cloud Mode) | Infrastruktur cloud Bright Data |
| Prasyarat setup | Pasang ekstensi, buka halaman | Pilih produk, buat akun, konfigurasi kredensial/scraper |
| Pendekatan anti-bot | Rendering terkelola pada halaman yang didukung | Rotasi proxy, Unlocker, Browser API, pemecahan CAPTCHA, manajemen fingerprint |
| Interaksi utama | Visual, di browser, dibantu AI | Programatik (API/SDK) atau Scraper Studio (AI Agent/IDE); plus dashboard untuk beberapa produk |
| Model skala | Per halaman, run terjadwal, atau batch API | Request API berkonkurensi tinggi, browser terkelola, jaringan proxy |
Tidak ada pendekatan yang selalu lebih baik. Keduanya menyelesaikan masalah yang berbeda untuk orang yang berbeda. Kalau Anda ingin mengambil tabel dari halaman yang sedang Anda lihat, model Thunderbit akan membawa Anda ke hasil lebih cepat. Kalau Anda perlu mengirim 50.000 request lewat rotasi IP residential dengan rendering browser terkelola, model Bright Data memang dibangun khusus untuk itu.
Pengalaman No-Code: Seperti Apa Masing-Masing Alat untuk Pengguna Bisnis
Seperti apa pengalaman nyatanya bagi orang yang belum pernah menyentuh API? Karena banyak pengguna yang membandingkan alat ini bukan developer — mereka marketer, manajer sales ops, pengumpul data lepas, atau pemilik bisnis kecil.
Thunderbit: Dibuat untuk Browser
Alur Thunderbit untuk pengguna non-teknis seperti ini:
- Pasang ekstensi dari Chrome Web Store.
- Buka halaman yang ingin Anda ambil datanya (direktori, daftar produk, hasil pencarian, dan sebagainya).
- Klik ekstensi lalu jalankan One Click Extract. AI membaca halaman dan menyarankan kolom (misalnya "Company Name," "Price," "Rating").
- Tinjau, ganti nama, tambahkan, atau hapus kolom. Anda juga bisa menambahkan Field AI Prompts untuk mengubah data saat ekstraksi — misalnya menerjemahkan ke bahasa lain, mengelompokkan, meringkas, memformat nomor telepon, dan sebagainya.
- Atur pagination atau enrichment subpage jika Anda butuh data dari beberapa halaman atau halaman detail.
- Run Now bersifat opsional. Klik untuk langsung mulai; jika tidak, ekstraksi akan berjalan otomatis. Pilih Browser Mode (memakai sesi aktif Anda) atau Cloud Mode (untuk halaman publik).
- Ekspor langsung ke Google Sheets, Excel, Airtable, Notion, CSV, atau JSON.
Semuanya terjadi di browser Anda. Tidak perlu API key, tidak perlu konfigurasi proxy, tidak perlu kode. Anda melihat halaman, Anda melihat datanya, lalu Anda ekspor. Untuk orang yang hanya butuh daftar prospek atau tabel harga kompetitor, ini sangat minim hambatan.
Yang masih butuh sedikit pemikiran: mengustomisasi Field AI Prompts untuk format yang kompleks, menangani halaman dengan struktur yang tidak biasa, dan memahami kapan Cloud Mode tersedia serta kapan harus memakai Browser Mode.
Bright Data: Infrastruktur dengan Titik Masuk No-Code
Bright Data bukan hanya untuk developer — itu salah kaprah yang cukup umum. Mereka memang punya jalur no-code yang nyata:
- Scraper Studio AI Agent: Anda memberi URL target dan menjelaskan apa yang Anda inginkan dengan bahasa natural. AI akan mengajukan pertanyaan klarifikasi, menyusun skema, menghasilkan scraper, lalu memungkinkan Anda menguji, mem-publish, dan menjadwalkannya — semuanya dari dashboard. Dokumentasi Bright Data sendiri memperkirakan proses pembuatan scraper sekitar 10–15 menit.
- Scraper API siap pakai: Pilih kolektor yang didukung untuk domain populer, masukkan input Anda, lalu jalankan dari control panel atau lewat API. Record terstruktur langsung dikembalikan tanpa membangun apa pun dari nol.
- Dataset: Pilih dataset yang sudah ada, tentukan kebutuhan sample/pengiriman/refresh, lalu terima data tanpa perlu membuat scraper sama sekali.
- Control panel Crawl API: Masukkan domain atau URL, atur output, mulai crawl, lalu ambil hasil lewat unduhan, webhook, atau storage.
Tapi bagian jujurnya: sebagian besar fitur lanjutan Bright Data — Unlocker, Browser API, raw proxy zones, SERP API, scraper IDE kustom — tetap memerlukan pemilihan produk, manajemen kredensial, dan setidaknya sedikit konfigurasi teknis. Permukaan no-code-nya memang ada, tetapi berada di atas platform yang sejak awal memang dibuat untuk engineer.
| Aspek | Thunderbit | Bright Data |
|---|---|---|
| Langkah sampai ekstraksi pertama | Pasang ekstensi → buka halaman → AI Suggest → Scrape → ekspor | Buat akun → pilih produk → konfigurasi atau pakai AI Agent → jalankan → ambil hasil |
| Pengetahuan teknis yang dibutuhkan | Tidak ada untuk ekstraksi dasar; sedikit untuk prompt lanjutan | Tidak ada untuk AI Agent/dataset; menengah hingga tinggi untuk API, proxy, IDE |
| Waktu ke hasil pertama | Menit (alur kerja yang didokumentasikan vendor) | Bervariasi tergantung produk; AI Agent diperkirakan 10–15 menit oleh vendor; jalur API/proxy lebih lama |
Time-to-First-Scrape: Seberapa Cepat Anda Bisa Mendapat Data?
"Bright Data lebih kompleks untuk disetup" — Anda akan membaca itu di hampir semua artikel perbandingan, tetapi jarang ada yang mengukurnya. Saya tidak melakukan uji terkontrol pada target yang sama, jadi saya tidak akan mengarang angka. Yang bisa saya lakukan adalah membandingkan alur kerja terdokumentasi untuk tugas umum: mengekstrak daftar produk dari halaman e-commerce publik.
Thunderbit: Alur Kerja Terdokumentasi
| Langkah | Yang terjadi |
|---|---|
| 1. Pasang ekstensi | Sekali saja, sekitar 1 menit |
| 2. Buka halaman | Buka URL target di browser Anda |
| 3. One Click Extract | Klik sekali; agent mendeteksi, membaca, dan menganalisis halaman |
| 4. Tinjau/edit field | Ganti nama, tambah, hapus, atau tambahkan prompt |
| 5. Atur pagination | Aktifkan bila perlu |
| 6. Mulai otomatis | Run Now langsung jalan; kalau tidak, tugas dimulai otomatis |
| 7. Ekspor | Sekali klik ke Sheets, Excel, Airtable, Notion, CSV, atau JSON |
Prasyarat: Browser Chrome atau Edge, ekstensi Thunderbit terpasang, akun Thunderbit (tersedia paket gratis).
Bright Data: Alur Kerja Terdokumentasi (Dua Jalur)
Scraper Studio AI Agent (no-code):
| Langkah | Yang terjadi |
|---|---|
| 1. Buat akun | Daftar, verifikasi identitas |
| 2. Buka Scraper Studio | Masuk ke dashboard Studio |
| 3. Masukkan URL + deskripsi | Jelaskan kebutuhan Anda dengan bahasa natural |
| 4. Persiapan otomatis | Agent menentukan rencana ekstraksi; kontrol opsional dapat menyempurnakan output khusus |
| 5. Uji scraper | Jalankan tes; periksa output |
| 6. Publish + run | Jadwalkan atau jalankan manual |
| 7. Ambil data | Unduh dari dashboard, API, webhook, atau storage |
Scraper API (kolektor siap pakai):
| Langkah | Yang terjadi |
|---|---|
| 1. Buat akun | Daftar, verifikasi identitas |
| 2. Pilih kolektor | Pilih domain yang didukung dari katalog |
| 3. Masukkan input | URL, istilah pencarian, atau parameter |
| 4. Jalankan | Dari dashboard atau API |
| 5. Ambil data | Record terstruktur lewat dashboard, API, atau tujuan pengiriman |
Prasyarat: Akun Bright Data (beberapa produk punya free tier), pemilihan produk, dan — untuk jalur API/proxy — pembuatan API key serta konfigurasi.
Intinya: Thunderbit dibuat untuk kecepatan menuju nilai guna pada tugas ad-hoc — Anda mengambil data dari halaman yang sedang dibuka, dengan keputusan seminimal mungkin. Jalur AI Agent Bright Data memang ada, tetapi platform ini tetap mengharuskan Anda memilih produk, memahami unit billing, dan menavigasi dashboard yang lebih besar. Untuk tugas sekali pakai? Jalur Thunderbit lebih pendek. Untuk membangun scraper yang tahan lama dan terjadwal dengan pengiriman ke warehouse? Jalur Studio Bright Data lebih masuk akal sebagai investasi.
Thunderbit vs Bright Data: Perbandingan Fitur per Fitur
| Fitur | Thunderbit | Bright Data |
|---|---|---|
| analisis halaman agentic | One Click Extract + Field AI Prompts opsional | Scraper Studio AI Agent (bahasa natural → skema → scraper) |
| Enrichment subpage | Didukung (data halaman detail digabung ke tabel utama) | Didukung lewat workflow Studio/Browser/Crawl kustom dan beberapa kolektor siap pakai |
| Penanganan pagination | Pagination dan infinite scroll didukung | Didukung di Studio, Crawl API, dan kolektor siap pakai |
| Ekstraksi terjadwal | Jadwal berulang (Starter: hingga 5; Pro: hingga 25, frekuensi minimum 5 menit) | Jadwal hourly/daily/weekly/custom di Studio; monitoring/alert operasional |
| Tujuan ekspor | Google Sheets, Airtable, Notion, Excel, CSV, JSON | JSON, NDJSON, CSV, XLSX, Parquet, HTML, Markdown + API, webhook, cloud storage, SFTP, email, warehouse |
| Eksekusi browser vs cloud | Browser Mode (sesi aktif) dan Cloud Mode (halaman publik, klaim vendor hingga 50 sekaligus) | Cloud-only; browser terkelola, request lewat proxy |
| Infrastruktur proxy/IP | Terkelola pada surface yang didukung; API punya kontrol render/negara/header/cookie | Residential (400M+ IP bulanan menurut klaim vendor), datacenter, ISP, mobile; kontrol geo/session/ASN/operator |
| Penanganan anti-bot | Rendering/anti-bot terkelola pada halaman yang didukung dan API | Unlocker, Browser API, proxy, CAPTCHA/fingerprint/retry tooling |
| Scraper/template siap pakai | Template situs + extractor khusus email/phone/image | Scraper API siap pakai untuk domain populer (angka vendor bervariasi; beberapa halaman resmi menyebut 100+ hingga 600+) |
| Akses API | Open API: Distill, Extract, Suggest Fields, batch asinkron, webhook | Berbagai API produk: Crawl, Unlocker, Browser, Scraper, SERP, Dataset, Proxy |
| Dukungan MCP/agent | MCP open-source resmi + CLI | MCP hosted resmi, Agent Browser, Search & Extract |
| Ekstraksi dokumen/gambar | Alat untuk PDF dan gambar terdokumentasi | Bukan fokus utama; ada parsing data di Crawl/Studio |
| Dukungan multi-bahasa | Field AI Prompts bisa menerjemahkan saat ekstraksi | Bahasa output mengikuti sumber; tidak ada translate-on-extract bawaan |
| Sertifikasi compliance | Peran GDPR/CCPA, DPA atas permintaan, TLS/AES; tidak ditemukan SOC 2 publik | ISO 27001/27017/27018, SOC 2 Type II (di bawah NDA), SOC 3 publik, CSA STAR, KYC |
Di Mana Thunderbit Lebih Menonjol
- One Click Extract dan alur visual di browser. Anda melihat halaman, melihat kolom yang dideteksi agent, lalu menyesuaikan dan scraping. Loop umpan baliknya sangat cepat.
- Ekstraksi sekali klik dengan template bernama untuk situs populer serta extractor khusus email/phone/image.
- Ekspor langsung ke tools bisnis — Google Sheets, Airtable, Notion, Excel — tanpa langkah perantara.
- Field AI Prompts yang mengubah, menerjemahkan, mengelompokkan, atau memformat data saat ekstraksi. Ini benar-benar berguna untuk pengguna bisnis yang butuh output rapi dan siap pakai.
- Waktu menuju nilai yang cepat untuk tugas scraping ad-hoc dan sesekali. Kalau Anda butuh tabel dari sebuah halaman sekarang juga, Thunderbit sangat sulit dikalahkan dari sisi kecepatan.
Di Mana Bright Data Lebih Menonjol
- Web data infrastructure yang sangat besar. Bright Data mengklaim 400M+ IP residential per bulan di 195+ negara, plus jaringan datacenter, ISP, dan mobile. Kalau Anda butuh request dengan target geo, kontrol session, atau keragaman IP yang tinggi, ini adalah toolkit yang lebih dalam.
- Produk anti-bot dan unblocking. Unlocker, Browser API, pemecahan CAPTCHA, manajemen fingerprint, dan retry logic memang dibangun untuk situs yang sangat terlindungi (Cloudflare, DataDome, PerimeterX, dan lainnya). Keberhasilan tetap bergantung pada target dan waktu, tetapi tool-nya lebih lengkap.
- Ekstraksi API-driven berkonkurensi tinggi dalam skala besar. FAQ Scraper Studio mendokumentasikan hingga 1.000 batch job paralel per scraper sebelum antre. Banyak API produk mendukung arsitektur pipeline yang kompleks.
- Scraper API siap pakai untuk domain populer, plus dataset, Data Firehose, dan pengadaan data terkelola untuk tim yang ingin data dikirim, bukan harus scraping sendiri.
- Sertifikasi compliance enterprise. ISO 27001, SOC 2 Type II (di bawah NDA), SOC 3, CSA STAR, dan KYC terdokumentasi dan relevan untuk industri teregulasi serta procurement enterprise.
Thunderbit vs Bright Data Pricing: Berapa Biaya Nyata yang Akan Anda Bayar
Harga adalah salah satu pertanyaan tersulit di sini untuk dijawab dengan jujur. Kedua alat mengukur penggunaan dengan cara yang sangat berbeda, jadi perbandingan sederhana "per halaman" tidak bisa dipakai.
Harga Thunderbit (per Agustus 2026)
Ekstensi no-code Thunderbit memakai sistem kredit. Scraping standar menghabiskan 1 kredit per baris output; subpage enrichment menghabiskan 2 kredit per baris; Personal Data Enrichment menghabiskan 30 kredit per query yang berhasil.
| Paket | Harga bulanan | Kredit/bulan |
|---|---|---|
| Free | $0 | 6 halaman/bulan, maksimal 30 kredit/halaman |
| Starter | $15/bulan | 500/bulan |
| Pro Tier 1 | $38/bulan | 3.000/bulan |
| Pro Tier 2 | $75/bulan | 6.000/bulan |
| Pro Tier 3 | $125/bulan | 10.000/bulan |
| Pro Tier 4 | $249/bulan | 20.000/bulan |
| Business | Kustom | Kustom |
Penagihan tahunan jauh lebih murah (misalnya, Starter turun menjadi $108/tahun untuk 5.000 kredit tahunan).
Open API punya meter terpisah: Distill menghabiskan 1 unit API per halaman; Extract menghabiskan 20 unit per halaman. Paket API dimulai dari $16/bulan (ditagih tahunan) untuk 60.000 unit/tahun.
Harga Bright Data (per Agustus 2026)
Harga Bright Data bervariasi tergantung produk dan meternya. Berikut tarif entry-level pay-as-you-go untuk produk utama:
| Produk | Free tier | Tarif PAYG awal | Meter |
|---|---|---|---|
| Unlocker API | 5K request/bulan | $1.50 / 1K request berhasil | Request berhasil |
| SERP API | 5K request/bulan | $1.50 / 1K request berhasil | Request berhasil |
| Scraper APIs | 5K record/bulan | $1.50 / 1K record terkirim | Record |
| Scraper Studio | 5K page load/bulan | $1.50 / 1K page load | Page load |
| Browser API | Trial bervariasi | $8 / GB | Bandwidth tertransfer |
| Residential proxies | PAYG | $8 / GB | Bandwidth |
| Datasets | Sample bervariasi | Mulai dari $250 / 100K record | Record + cakupan refresh |
Navigasi global Bright Data kadang menampilkan nilai "mulai dari" yang lebih rendah, tetapi biasanya itu mengacu pada tier volume tinggi atau promo. Selalu cek halaman harga live untuk produk spesifik yang sedang Anda evaluasi.
Mengapa Tidak Ada Pemenang Biaya yang Sederhana
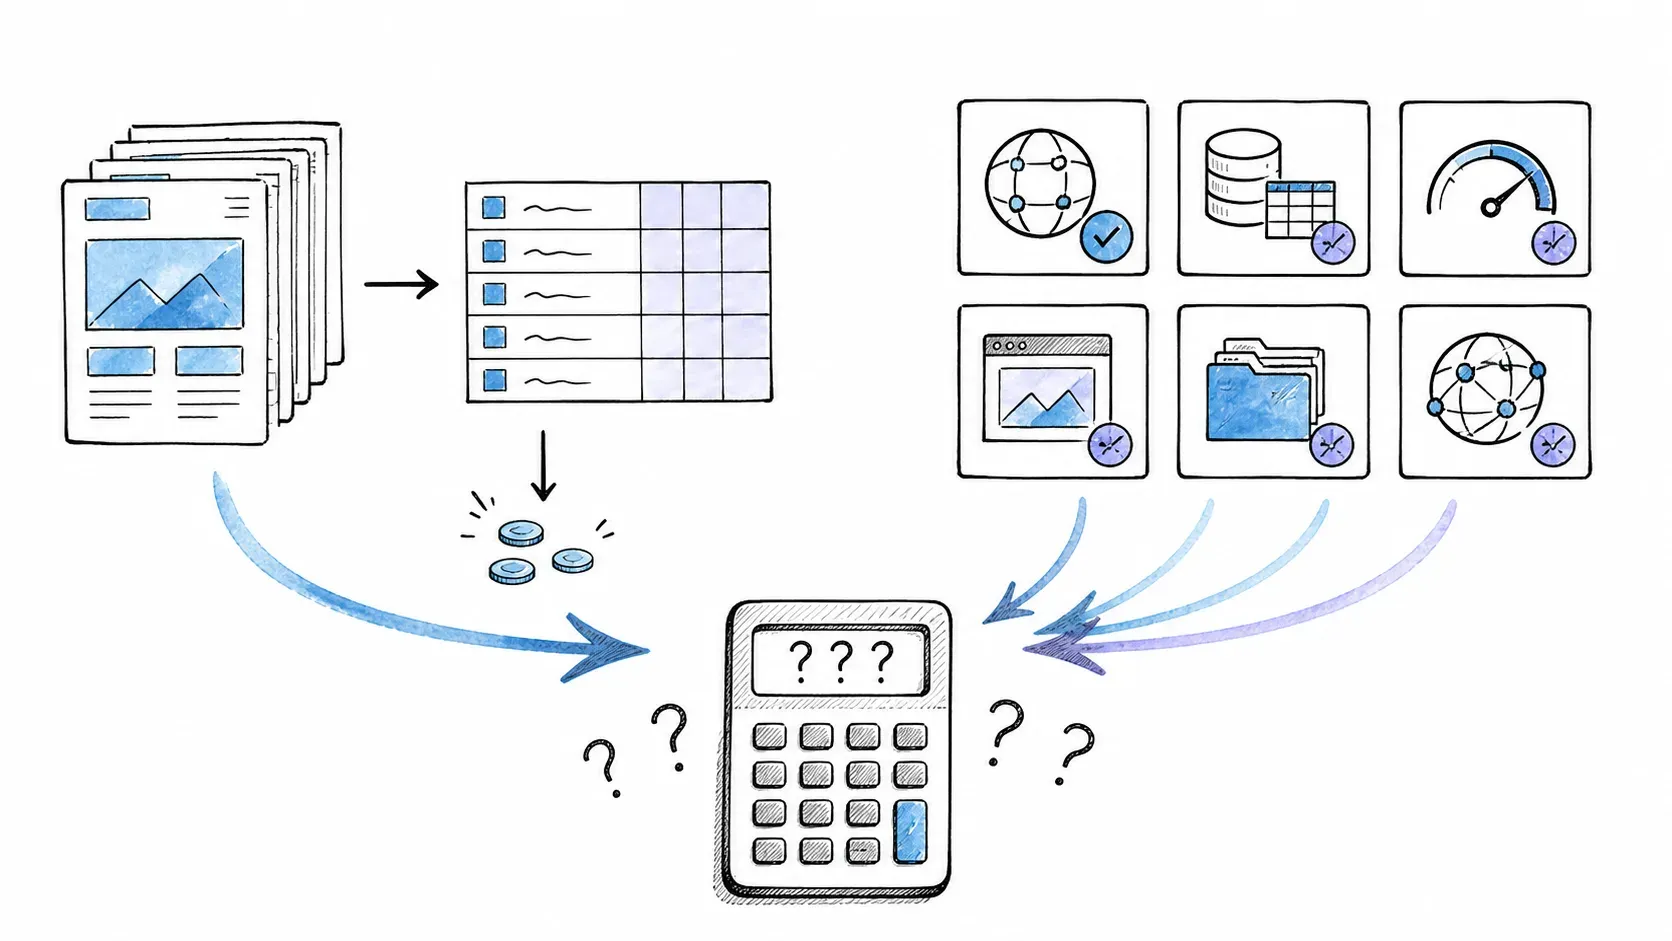
Seratus halaman kategori dengan masing-masing 50 baris bisa berarti 5.000 kredit no-code Thunderbit (di level Pro Tier 1, kira-kira $38/bulan). Tugas yang sama di Bright Data bisa jadi 100 page load di Scraper Studio, 5.000 record terkirim lewat Scraper API, atau bandwidth Browser API yang berubah-ubah — masing-masing dengan harga berbeda. Jadi alat yang "lebih murah" sepenuhnya bergantung pada:
- Produk/surface mana yang Anda pakai di tiap platform
- Berapa banyak output baris per URL input
- Apakah Anda butuh pagination, subpage, atau rendering browser
- Penagihan bulanan vs tahunan
- Retry, tingkat field yang hilang, dan kebijakan overage
Untuk penggunaan ringan hingga menengah oleh tim non-teknis (beberapa ratus hingga beberapa ribu baris per bulan), paket berbasis kredit Thunderbit umumnya lebih mudah diprediksi dan lebih terjangkau. Untuk pipeline volume tinggi yang berbasis API dengan kebutuhan delivery yang kompleks, harga per-record atau per-request Bright Data bisa lebih hemat pada skala besar — tetapi Anda perlu memodelkan produk dan meternya secara spesifik.
Selalu verifikasi harga terbaru di halaman harga Thunderbit dan halaman harga Bright Data yang relevan sebelum berkomitmen.
Use Case Nyata: Thunderbit vs Bright Data dalam Aksi
Fitur di lembar spesifikasi tidak menutup deal — alur kerja yang melakukannya. Berikut lima skenario umum dan bagaimana masing-masing alat menanganinya.
Membuat Daftar Prospek dari Situs Direktori
Skenario: Seorang manajer sales ops butuh 200 kontak dari direktori industri niche, lalu mengekspornya ke Google Sheets.
Kecocokan Thunderbit: Ini adalah sweet spot Thunderbit. Buka direktori di browser, jalankan One Click Extract, biarkan agent menganalisis dan mulai otomatis, lalu ekspor langsung ke Sheets. Tanpa API, tanpa proxy, tanpa kode. Kalau halaman butuh sesi login, Browser Mode bisa memakai sesi aktif Anda pada halaman yang kompatibel.
Kecocokan Bright Data: Bisa dilakukan lewat Scraper API siap pakai (jika direktori tersebut didukung) atau scraper kustom di Scraper Studio. Tetapi untuk 200 kontak dari satu situs, overhead setup — membuat akun, memilih produk, mengonfigurasi scraper — biasanya terlalu berat. Bright Data memang dirancang untuk tugas semacam ini dalam skala yang jauh lebih besar (ribuan atau puluhan ribu record).
Memantau Harga Kompetitor di Ratusan SKU
Skenario: Tim operasi e-commerce melacak 500+ harga produk setiap minggu di beberapa situs kompetitor.
Kecocokan Thunderbit: Ekstraksi terjadwal di halaman yang didukung bisa bekerja baik untuk volume menengah. Siapkan scraper untuk tiap kompetitor, atur pagination, jadwalkan run mingguan, lalu ekspor ke Sheets atau Airtable. Untuk 500 SKU, Anda kemungkinan membutuhkan paket Pro.
Kecocokan Bright Data: Untuk situs e-commerce yang sangat terlindungi (misalnya toko yang dilindungi Cloudflare), Unlocker atau Browser API Bright Data yang digabung dengan workflow Scraper Studio atau Scraper API biasanya lebih tahan banting. Kalau Anda melacak ribuan SKU di puluhan situs dengan mekanisme anti-bot yang kompleks, web data infrastructure Bright Data memang dibangun untuk itu. Konsekuensinya adalah setup yang lebih banyak dan kurva belajar yang lebih curam.
Riset Sekali Pakai untuk Laporan Pasar
Skenario: Seorang analis marketing butuh data dari 5 website untuk laporan triwulanan — daftar produk, jumlah ulasan, tier harga.
Kecocokan Thunderbit: Ideal. Pasang ekstensi, kunjungi tiap situs, scraping, ekspor. Tidak perlu investasi infrastruktur, tidak ada biaya berulang selain paket yang sudah Anda miliki. Ini jenis tugas yang membuat Thunderbit unggul dalam kecepatan menuju hasil.
Kecocokan Bright Data: Terlalu berlebihan. Waktu setup dan proses pemilihan produk tidak sebanding untuk tugas sekali pakai di 5 situs. Kecuali situs-situs itu sangat terlindungi dan Anda tidak bisa mendapat datanya dengan cara lain, Bright Data lebih banyak fitur daripada yang Anda butuhkan di sini.
Pipeline Data Skala Besar untuk Tim Engineering
Skenario: Tim data engineering membangun pipeline otomatis untuk mengumpulkan 100K+ halaman/hari dari beberapa sumber, dengan delivery ke cloud warehouse.
Kecocokan Thunderbit: Open API mendukung batch asinkron, webhook, dan skala yang diklaim vendor hingga jutaan halaman dengan sampai 50 request paralel pada paket Pro API. Untuk pipeline skala menengah, ini masih masuk akal. Tetapi pusat desain utama Thunderbit adalah ekstensi browser dan alur kerja pengguna bisnis, bukan infrastruktur berkonkurensi tinggi.
Kecocokan Bright Data: Ini dibangun khusus untuk itu. Berbagai API produk (Crawl, Unlocker, Browser, Scraper, SERP), browser terkelola, jaringan proxy, dan delivery ke webhook, cloud storage, SFTP, dan warehouse. Scraper Studio mendokumentasikan hingga 1.000 batch job paralel per scraper. Kalau Anda butuh kontrol proxy yang dalam, geo-targeting, manajemen session, dan bukti compliance enterprise, Bright Data adalah kandidat evaluasi yang lebih natural.
Pengumpulan Data Training AI/ML
Skenario: Seorang ML engineer membutuhkan data training terstruktur dari ratusan domain, diperbarui setiap bulan.
Kecocokan Thunderbit: API-nya bisa menangani ekstraksi terstruktur dalam skala menengah, dan integrasi MCP/CLI membuatnya mudah diakses dari alur kerja AI agent. Untuk dataset yang lebih kecil dan jelas definisinya, alat ini bekerja dengan baik.
Kecocokan Bright Data: Dataset, Data Firehose, dan Scraper API memang dirancang untuk ini — data terstruktur skala besar, multi-domain, dan diperbarui terus-menerus. MCP Server dan Agent Browser menambah akses yang berorientasi agent. Untuk data training dalam skala besar, Bright Data punya lebih banyak surface dan opsi delivery.
Pilih Thunderbit Saat… / Pilih Bright Data Saat…
Temukan posisi Anda di matriks di bawah ini. Jujurlah tentang mana yang benar-benar Anda butuhkan.
| Jika Anda… | Dan Anda butuh… | Pertimbangkan… |
|---|---|---|
| Marketer atau sales ops (non-teknis) | Daftar prospek cepat atau data kompetitor, diekspor ke Sheets/Excel | Thunderbit — ekstensi browser, One Click Extract, ekspor langsung |
| Solo founder atau freelancer | Ekstraksi ad-hoc tanpa investasi infrastruktur | Thunderbit — free tier, setup cepat, tanpa biaya infrastruktur berulang |
| Tim operasi dengan volume menengah | Monitoring mingguan beberapa ratus hingga beberapa ribu baris | Thunderbit — ekstraksi terjadwal, paket Pro, ekspor ke tools bisnis |
| Developer yang membangun pipeline data | Ekstraksi volume tinggi berbasis API dengan rotasi proxy dan delivery ke warehouse | Bright Data — Crawl/Unlocker/Browser APIs, jaringan proxy, delivery via webhook/storage |
| Tim data enterprise | Pengumpulan skala besar multi-sumber dengan sertifikasi compliance dan kebutuhan procurement | Bright Data — sertifikasi ISO/SOC, KYC, kontrol enterprise, pengadaan terkelola |
| AI/ML engineer | Data training terstruktur skala besar, diperbarui terus-menerus | Bright Data — Dataset, Firehose, Scraper API, MCP; evaluasi Thunderbit API untuk pekerjaan yang lebih kecil |
| Siapa pun yang menghadapi situs sangat terlindungi | Data dari target yang dilindungi Cloudflare/DataDome/PerimeterX dalam skala besar | Bright Data — Unlocker, Browser API, rotasi proxy, tooling CAPTCHA/fingerprint |
Keputusannya bukan soal alat mana yang "lebih baik." Kekuatan Thunderbit adalah kesederhanaan no-code dan kecepatan menuju nilai bagi pengguna bisnis. Kekuatan Bright Data adalah kedalaman web data infrastructure, ketahanan anti-bot, kepatuhan enterprise, dan skala untuk tim teknis. Memakai satu untuk pekerjaan yang cocok untuk yang lain ibarat membawa gergaji mesin untuk membuka surat.
Kepatuhan dan Privasi Data: Yang Perlu Diketahui Pengguna Bisnis
Tidak ada program keamanan atau compliance dari vendor yang otomatis memberi izin untuk scraping sebuah target. Pengguna tetap bertanggung jawab atas akses yang diizinkan, hukum yang berlaku, kewajiban data pribadi, dan syarat penggunaan website. Kedua alat juga menuntut kepatuhan terhadap hukum privasi data seperti GDPR dan CCPA.
Bright Data mendokumentasikan ISO/IEC 27001:2022, ISO 27017, ISO 27018, SOC 2 Type II (di bawah NDA), laporan SOC 3 publik, CSA STAR, TLS 1.3, AES-256 saat tersimpan, dan proses KYC/review use case. Ini penting untuk industri teregulasi dan tim procurement enterprise yang membutuhkan bukti audit.
Thunderbit menjelaskan peran GDPR/CCPA/CPRA, DPA atas permintaan, SCCs, TLS 1.2+, dan AES-256 saat tersimpan di terms dan privacy policy. Hingga tulisan ini dibuat, tidak ditemukan attestasi SOC 2 publik.
Kalau Anda mengumpulkan data pribadi atau beroperasi di industri teregulasi, konsultasikan dengan penasihat hukum. Tool compliance adalah titik awal, bukan garis akhir.
Thunderbit vs Bright Data: Pilih Alat yang Tepat untuk Kebutuhan Nyata Anda
Thunderbit adalah ekstensi browser berbasis AI untuk pengguna bisnis yang ingin mendapatkan data terstruktur dengan cepat, tanpa kode dan dengan setup minimal. Bright Data adalah platform web data infrastructure modular untuk developer dan tim enterprise yang membutuhkan skala, ketahanan anti-bot, kontrol proxy yang dalam, dan bukti compliance pada volume tinggi.
- Kalau Anda ingin data dari halaman di browser Anda, lalu diekspor ke Sheets dalam hitungan menit: coba Thunderbit.
- Kalau Anda sedang membangun pipeline data jangka panjang dengan resource engineering dan kebutuhan enterprise: evaluasi Bright Data.
- Kalau posisi Anda ada di tengah-tengah: mulai dari alat yang lebih sederhana, lalu naik ke alat yang lebih berat saat kebutuhan Anda sudah melampauinya. Itu bukan alasan menghindar — itu memang cara kebanyakan tim mengembangkan workflow data mereka.
FAQ
Mana yang lebih murah, Thunderbit atau Bright Data?
Untuk penggunaan ringan hingga menengah oleh tim non-teknis (beberapa ratus hingga beberapa ribu baris per bulan), paket berbasis kredit Thunderbit umumnya lebih terjangkau dan lebih mudah diprediksi. Harga Bright Data dirancang untuk penggunaan volume tinggi di level infrastruktur dan bervariasi berdasarkan produk dan meter (per-request, per-record, per-GB, per-IP). Perbandingan biaya langsung hanya bisa dilakukan jika Anda mencocokkan produk, volume, dan unit penagihan yang sama. Selalu cek halaman harga Thunderbit dan halaman harga Bright Data yang relevan untuk tarif terbaru.
Apakah saya bisa memakai Thunderbit dan Bright Data bersama-sama?
Ya. Sebagian tim memakai Thunderbit untuk ekstraksi cepat dan ad-hoc (pencarian prospek, riset sekali pakai, tugas monitoring kecil) dan Bright Data untuk target skala besar atau yang sangat terlindungi dan membutuhkan infrastruktur proxy. Pendekatan "hybrid" ini memungkinkan Anda menyesuaikan alat dengan tugasnya tanpa terlalu banyak investasi setup untuk pekerjaan sederhana atau kekurangan infrastruktur untuk pekerjaan kompleks.
Apakah saya perlu skill coding untuk memakai Thunderbit atau Bright Data?
Thunderbit: Tidak perlu coding untuk alur kerja ekstensi browser. Tetapi Open API, MCP, dan CLI memang membutuhkan pengetahuan teknis. Bright Data: Scraper Studio AI Agent, kolektor siap pakai, dan dataset adalah opsi low-code yang tidak mengharuskan Anda menulis skrip. Namun sebagian besar fitur lanjutan — Unlocker, Browser API, raw proxy zones, scraper IDE kustom — tetap membutuhkan keterlibatan developer. Power penuh Bright Data berarti konfigurasi teknis.
Mana yang lebih baik untuk scraping LinkedIn, Thunderbit atau Bright Data?
Thunderbit bisa mengekstrak data dari halaman yang memang Anda punya akses berizin di browser Anda (misalnya sesi LinkedIn Anda sendiri pada halaman yang kompatibel). Bright Data menawarkan Scraper API siap pakai untuk LinkedIn lewat API mereka. Keduanya mengharuskan pengguna mematuhi syarat layanan LinkedIn dan hukum yang berlaku. LinkedIn sangat agresif dalam penegakan, jadi tetap berhati-hati apa pun alat yang Anda pilih. Untuk informasi lebih lanjut tentang pendekatan lead generation, lihat panduan kami.
Bagaimana kalau saya sudah berkembang melebihi Thunderbit — apakah nanti bisa pindah ke Bright Data?
Tentu saja. Thunderbit mengekspor ke format standar (CSV, JSON, Excel, Google Sheets) yang bisa diimpor ke pipeline apa pun. Kalau kebutuhan data Anda tumbuh melampaui kemampuan ekstensi atau API Thunderbit — atau kalau Anda butuh infrastruktur proxy, anti-bot, atau compliance yang lebih dalam — Anda bisa beralih ke Bright Data (atau menambahkannya berdampingan dengan Thunderbit) tanpa kehilangan data atau workflow yang sudah ada. Kedua alat ini tidak mengunci Anda.
Pelajari Lebih Lanjut




