
Kalau scraper Glassdoor Anda dulu masih lancar di 2022 tapi sekarang cuma balas 403, Anda tidak sendirian. Di berbagai forum, pertanyaan yang sama terus muncul: "Ada yang tahu kenapa scraper ini sudah tidak jalan lagi?"
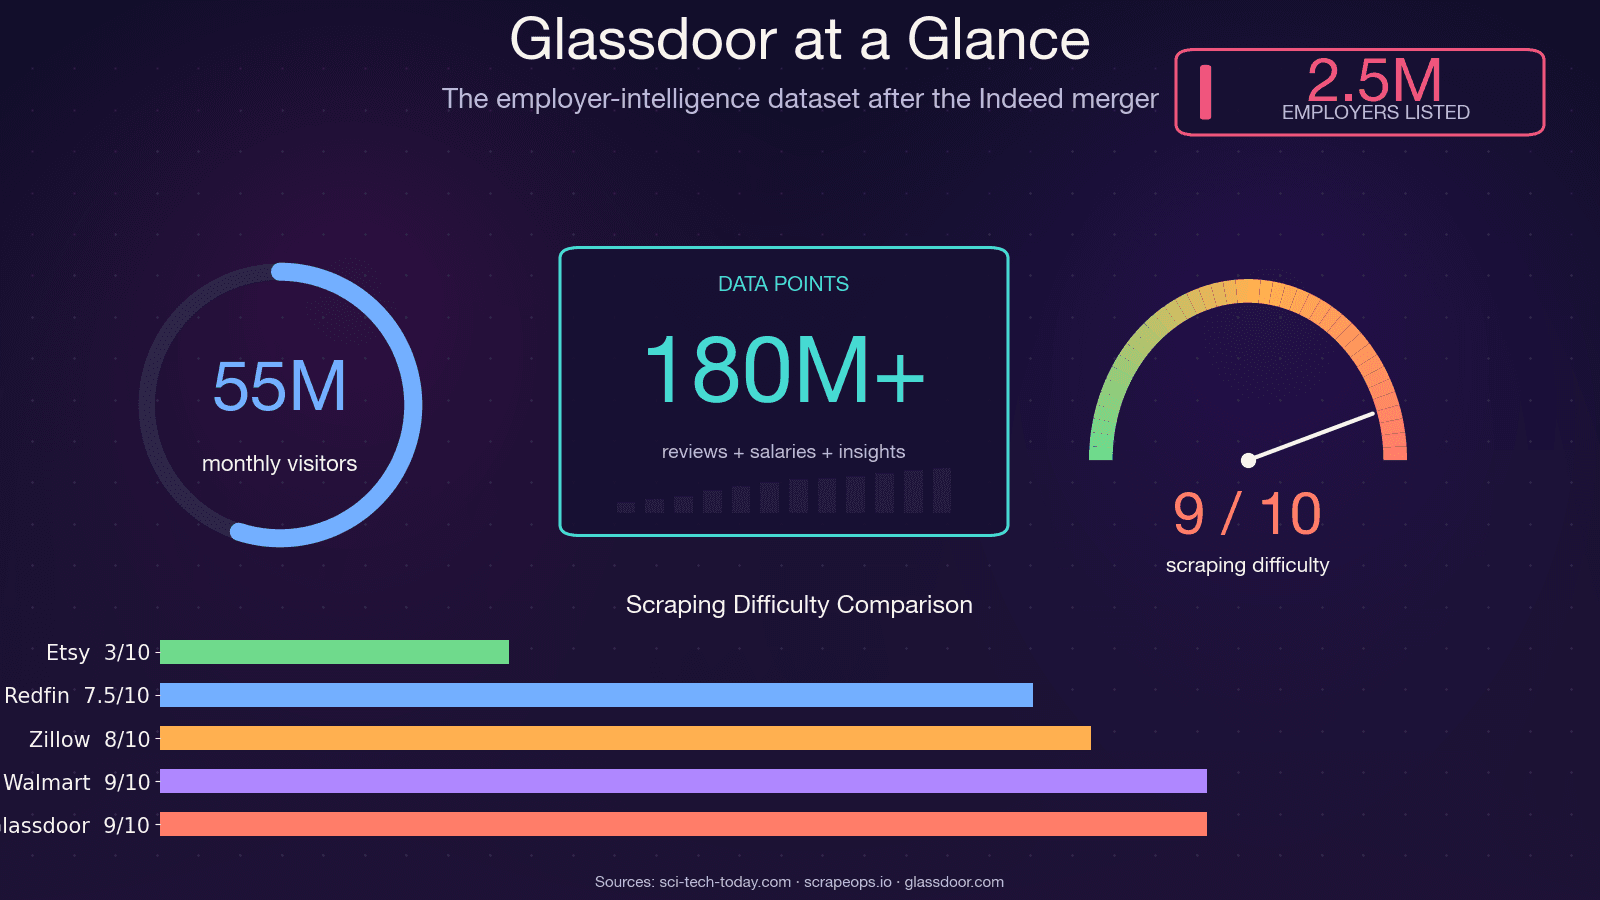
Jawaban singkatnya: Glassdoor mengubah semuanya. Recruit Holdings menggabungkan Glassdoor ke Indeed pada Juli 2025, memangkas 1.300 karyawan, dan memperketat lapisan anti-bot sampai scraper berbasis Selenium biasa dan requests diblokir bahkan sebelum byte pertama HTML dimuat. Per Februari 2026, proses login Glassdoor sepenuhnya ditangani lewat Indeed Login — jadi tutorial apa pun yang masih mengandalkan form login khusus Glassdoor sudah rusak dari akarnya. Sementara itu, platform ini masih menyimpan lebih dari 180 juta ulasan, data gaji, dan insight gabungan dari 2,5 juta perusahaan. Datanya sangat berharga untuk benchmarking HR, intelijen kompetitor, dan prospecting penjualan — kalau Anda memang bisa mengaksesnya. Panduan ini adalah versi yang tetap bekerja setelah semua perubahan itu terjadi, dan mencakup ketiga jenis data Glassdoor (lowongan, ulasan, DAN gaji) dalam satu tempat. Saya akan menunjukkan pendekatan Python dengan kode 2025 yang masih berfungsi, menjelaskan dengan tepat apa yang memblokir Anda dan cara mengatasinya, serta memperlihatkan jalur no-code bagi siapa pun yang ingin melewati sisi engineering sama sekali.
Kenapa Scrape Glassdoor dengan Python di 2025?
Glassdoor bukan sekadar papan lowongan kerja. Ini adalah salah satu kumpulan data intelijen perusahaan paling kaya di web — dipakai oleh sekitar sepertiga perusahaan Fortune 500 dan menarik sekitar 55 juta pengunjung unik per bulan. Data yang ada di balik halaman-halaman itu mendorong keputusan bisnis nyata di banyak tim.
Begini cara berbagai tim benar-benar memanfaatkan data Glassdoor:
| Use Case | Jenis Data yang Dibutuhkan | Siapa yang Diuntungkan |
|---|---|---|
| Benchmarking gaji | Distribusi gaji, ukuran sampel | HR, Total Rewards, Operasional |
| Melacak perekrutan kompetitor | Daftar lowongan, kecepatan posting | Sales, Strategy, VC/Corp Dev |
| Memantau employer brand | Teks ulasan, tren rating, persetujuan CEO | HR, Marketing, Komunikasi |
| Lead generation (perusahaan yang sedang tumbuh) | Daftar lowongan + info perusahaan | Tim sales, SDR |
| Riset pasar/akademik | Ketiganya | Analis, Konsultan, Peneliti |
Saat BLS tidak bisa merilis data pekerjaan selama shutdown pemerintah Oktober 2025, tim Economic Research Glassdoor sendiri menerbitkan laporan pekerjaan alternatif dari dataset mereka. Begitu seriusnya analis institusi memandang data ini sekarang.
Python tetap jadi pilihan utama karena ekosistemnya sulit ditandingi — Playwright untuk otomasi browser, parsel/lxml untuk parsing, curl_cffi untuk melewati fingerprint TLS, plus komunitas besar yang terus berbagi pola kerja yang benar-benar berfungsi. Masalahnya bukan Python. Masalahnya, Glassdoor sekarang jauh lebih sulit untuk di-scrape.
Scrape data Glassdoor dengan AI Get Started Free
Kalau Anda ingin opsi no-code untuk ekstraksi data Glassdoor, Thunderbit bisa membantu Anda mengambil data lowongan, ulasan, dan halaman gaji tanpa perlu membangun dan memelihara stack Python sendiri.
Data Glassdoor Apa Saja yang Sebenarnya Bisa Di-scrape?
Kebanyakan tutorial cuma membahas daftar lowongan. Padahal, berdasarkan thread forum, issue GitHub, dan pertanyaan Reddit yang saya pantau, permintaan tertinggi justru ada pada dua jenis data yang hampir tidak pernah diajarkan: ulasan dan gaji. Berikut rincian lengkap data yang bisa diekstrak dari ketiga kategori tersebut.
Daftar Lowongan
Jenis data yang paling mudah diakses. Anda bisa mengambil: judul pekerjaan, nama perusahaan, lokasi, estimasi gaji, rating perusahaan, tanggal posting, badge easy-apply, dan tautan lowongan. Daftar lowongan sebagian bisa diakses tanpa login, meski Glassdoor mungkin memunculkan popup login setelah beberapa halaman.
Ulasan Perusahaan
Di sinilah analisis employer brand jadi menarik. Field yang bisa diekstrak meliputi: rating keseluruhan, sub-rating (work-life balance, culture & values, diversity & inclusion, career opportunities, comp & benefits, senior management), teks kelebihan, teks kekurangan, jabatan reviewer, tanggal ulasan, dan status kerja. Teks ulasan lengkap dikunci login — Anda hanya akan melihat cuplikan, sedangkan pros/cons penuh butuh autentikasi.
Data Gaji
Jenis data yang paling sering diminta sekaligus paling menyebalkan. Anda bisa mengekstrak: jabatan, rentang gaji pokok, rentang total kompensasi, jumlah laporan gaji, dan lokasi. Namun halaman gaji sepenuhnya dikunci login, dan Glassdoor kadang menambahkan alur "contribute to unlock" di mana Anda harus mengirim gaji sendiri sebelum bisa melihat data orang lain. Tidak ada tutorial pesaing yang memberi kode kerja untuk ini — kita akan perbaiki itu.
Mana yang Butuh Login dan Mana yang Tidak
Tabel ini akan menyelamatkan Anda dari harus menemukan sendiri halaman mana yang akan mengembalikan data kosong:
| Jenis Data | Bisa Diakses Tanpa Login? | Catatan |
|---|---|---|
| Judul daftar lowongan & info dasar | Sebagian besar ya | Popup bisa muncul setelah beberapa halaman |
| Deskripsi lowongan lengkap | Sebagian | Sering dikunci setelah 2–3 tampilan |
| Ulasan perusahaan (teks lengkap) | Tidak — perlu login | Cuplikan terlihat, teks penuh dikunci |
| Data gaji | Tidak — perlu login | Bisa juga memerlukan "contribute to unlock" |
Kenapa Scraper Glassdoor Lama Anda Kemungkinan Besar Rusak
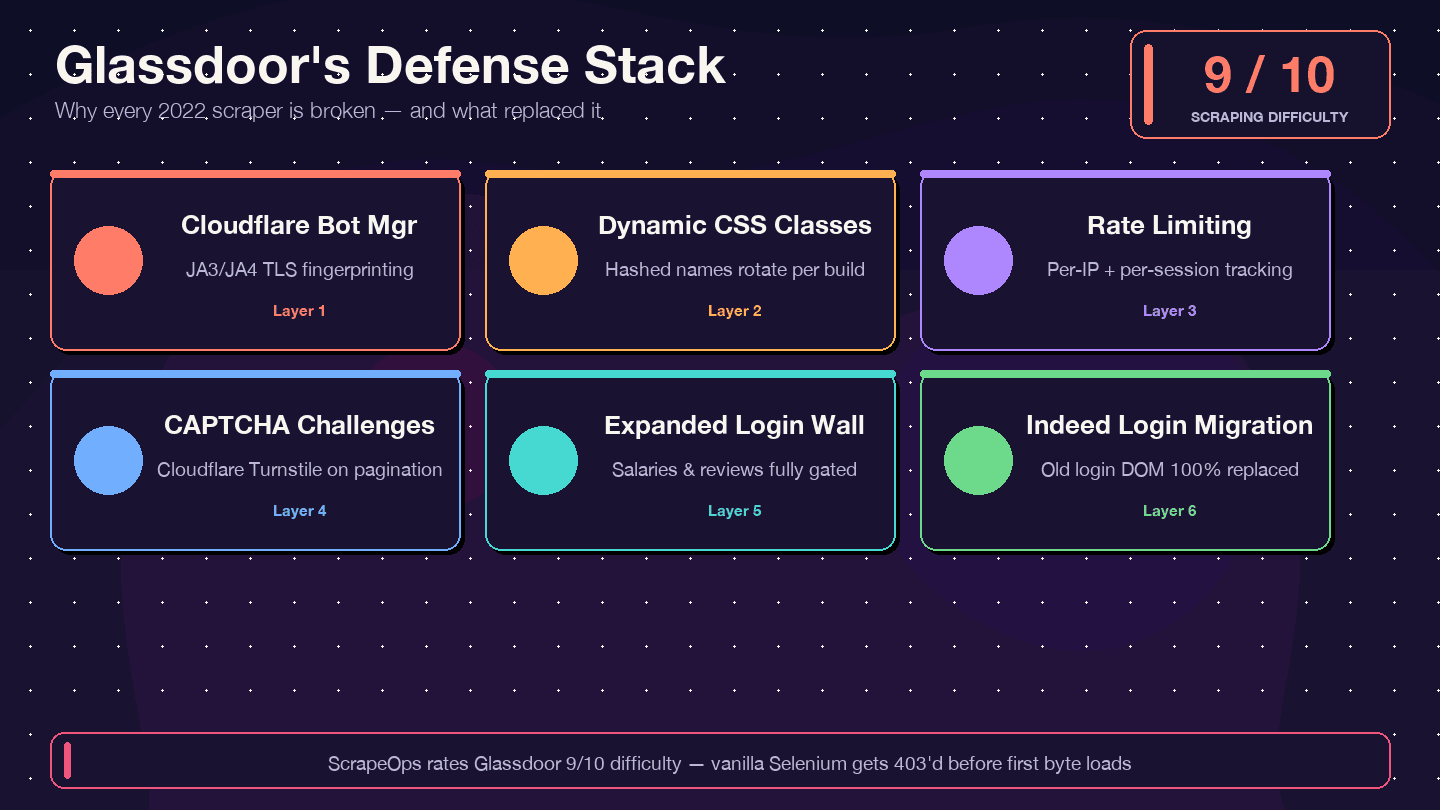
Saya ingin jujur soal ini: kalau Anda menyalin kode dari tutorial tahun 2021–2023, kemungkinan besar itu tidak akan jalan. Scraper Selenium Glassdoor legendaris di GitHub yang paling banyak mendapat bintang (MatthewChatham/glassdoor-review-scraper, sekitar 1,4k bintang) punya 12+ issue terbuka yang belum terselesaikan — termasuk "Glassdoor new UI design," "Cloudflare anti-bot protection," dan "NoSuchElementException." Repo itu praktis ditinggalkan. Actor glassdoor-jobs-scraper milik Apify ditandai DEPRECATED. ScrapeOps memberi Glassdoor tingkat kesulitan scraping keseluruhan 9/10 dan 8/10 untuk kesulitan bypass.
Berikut yang berubah dan kenapa kode lama gagal:
| Lapisan Pertahanan | Apa yang Berubah | Dampak pada Scraper Lama |
|---|---|---|
| Cloudflare Bot Management | Fingerprinting JA3/JA4 makin ketat sejak 2024 | Script requests/Selenium dasar langsung kena 403 |
| Nama class CSS dinamis | Nama class diacak pada setiap build | Selector CSS lama dari tutorial gagal diam-diam |
| Rate limiting + pelacakan sesi | Batas per-IP dan per-sesi makin ketat | Scraper diblokir setelah lebih sedikit halaman |
| Tantangan CAPTCHA (kemungkinan Cloudflare Turnstile) | Lebih sering muncul, terutama saat pagination | Browser headless memicu tantangan |
| Login wall yang meluas | Lebih banyak jenis halaman butuh autentikasi | Halaman gaji dan ulasan mengembalikan data kosong |
| Migrasi ke Indeed Login (Feb 2026) | Form login Glassdoor diganti total | Kode yang menarget DOM login lama tidak berguna lagi |
Panduan 2026 dari Scrapfly menyertakan peringatan tegas: "Glassdoor dikenal punya tingkat blocking yang tinggi, jadi kalau Anda mendapat nilai None saat menjalankan kode Python, kemungkinan besar Anda sedang diblokir." Dan artikel DEV.to dari Maret 2026 menyatakan dengan blak-blakan: "HTTP requests sederhana dengan requests atau httpx langsung diblokir."
Langkah-langkah penangkal yang akan saya tunjukkan — Patchright (fork Playwright yang stealth), selector atribut data-test, rotating residential proxies, dan sesi persisten yang sudah terautentikasi — dirancang khusus untuk menangani setiap lapisan ini.
Glassdoor API vs. Scraping Python: Pilih Pendekatan yang Tepat Dulu
Banyak thread forum bertanya, "Kalau begitu, pakai Glassdoor API saja?" — jawabannya: tidak bisa.
Glassdoor Partner API versi lama sudah ditutup untuk pendaftar baru. Portal developer-nya masih ada secara teknis, tetapi mengembalikan HTTP 403. Tidak pernah ada endpoint publik untuk ulasan — scraper MatthewChatham dibuat justru "karena Glassdoor tidak punya API untuk ulasan." Dan tidak ada jalur migrasi untuk ulasan atau gaji lewat Indeed Publisher API.
Berikut perbandingan yang jujur:
| Faktor | Glassdoor Partner API v1 | Scraping Python | Thunderbit (no-code) |
|---|---|---|---|
| Akses | Ditutup untuk pendaftar baru | Terbuka (Anda yang implementasi) | Ekstensi Chrome |
| Daftar lowongan | Terbatas/akan dihentikan | Tersedia dengan usaha | Tersedia |
| Ulasan perusahaan | Tidak pernah tersedia publik | Ya (perlu login) | Ya (via Browser Mode) |
| Data gaji | Tidak pernah tersedia publik | Ya (perlu login) | Ya |
| Rate limit | Tidak didokumentasikan | Anda yang mengatur | Berbasis kredit |
| Usaha setup | Tidak bisa daftar app baru | Beberapa jam sampai hari | ~2 menit |
| Beban maintenance | N/A | Tinggi (perubahan HTML memecah kode) | Rendah (AI menyarankan field lagi) |
Kalau Anda butuh data ulasan atau gaji — dan kebanyakan pembaca artikel ini memang begitu — scraping Python atau tools no-code adalah satu-satunya opsi yang realistis.
Sebelum Anda Mulai
- Tingkat kesulitan: Menengah (Anda sebaiknya nyaman dengan Python dan terminal)
- Waktu yang dibutuhkan: ~30–60 menit untuk setup penuh; ~10 menit per jenis data setelah itu
- Yang Anda perlukan:
- Python 3.10+ (disarankan 3.11 atau 3.12)
- Browser Chrome terpasang
- Akun Glassdoor (gratis — dibutuhkan untuk data gaji dan ulasan)
- Rotating residential proxies (untuk scraping lebih dari beberapa halaman)
- Opsional: Thunderbit Chrome Extension kalau Anda ingin jalur no-code
Tools dan Library untuk Scraping Glassdoor dengan Python di 2025
Peta tooling sudah berubah drastis. Berikut yang benar-benar bekerja melawan pertahanan Glassdoor saat ini.
Kenapa Patchright Jadi Pilihan Terbaik untuk Glassdoor
Patchright adalah fork stealth dari Playwright yang menambal kebocoran Runtime.Enable CDP — alasan teknis spesifik kenapa Playwright biasa gagal di situs yang dilindungi Cloudflare. API-nya persis sama dengan Playwright, jadi kalau Anda sudah bisa Playwright, Anda juga bisa Patchright. Versi 1.58.2 (Maret 2026) adalah versi terbaru dan masih aktif dipelihara.
Dibanding alternatif lain:
- Playwright biasa: Terdeteksi di halaman login Glassdoor karena kebocoran Runtime.Enable
- Selenium + undetected-chromedriver: Rilis terakhir undetected-chromedriver adalah Februari 2024 — praktis sudah legacy. Benchmark Scrapfly menemukan bahwa tool ini "gagal di setiap domain dalam pengujian kami"
- requests + BeautifulSoup: Tidak bisa merender JavaScript, langsung diblokir oleh fingerprinting TLS Cloudflare
- curl_cffi: Sangat bagus untuk jalur cepat (10–20x lebih cepat daripada browser) ketika halaman mengirim
__NEXT_DATA__di HTML awal, tetapi tidak bisa menangani login atau tantangan interstitial
Library Pendukung
- parsel (1.11.0) atau lxml (6.0.4): Parsing HTML/XPath yang cepat
- csv atau pandas: Ekspor data
- asyncio: Scraping async untuk pagination yang lebih cepat
Proxy: Hanya Residential
Lapisan Cloudflare Glassdoor sangat agresif terhadap ASN datacenter. Residential proxies dilaporkan menurunkan tingkat blok dari 20–30% menjadi di bawah 5%. Harga awal sekitar $1,75/GB dari IPRoyal (promosi) atau $3,00/GB dari Decodo. Untuk scraping produksi, siapkan anggaran $3–8/GB tergantung volume.
Jeda acak antar permintaan (minimal 3–8 detik, 5–15 detik untuk run yang lebih panjang) sangat penting, terlepas dari kualitas proxy.
Langkah 1: Siapkan Environment Python Anda
Buat folder project dan instal stack yang disarankan:
mkdir glassdoor-scraper && cd glassdoor-scraper
python3.11 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# Core stack
pip install patchright==1.58.2 parsel==1.11.0

# Install browser binaries
patchright install chromium

# Opsional: jalur cepat untuk ekstraksi __NEXT_DATA__
pip install "curl_cffi==0.15.0"
Anda seharusnya akan melihat Patchright mengunduh binary Chromium. Kalau patchright install chromium gagal, periksa apakah ruang disk Anda cukup (~300MB) dan pastikan versi Python Anda 3.10+.
Langkah 2: Jalankan Patchright dan Buka Glassdoor
Berikut pola dasar peluncuran yang bekerja melawan lapisan Cloudflare Glassdoor:
from patchright.sync_api import sync_playwright
import random, time

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=False,          # headless masih lebih mudah terdeteksi
        channel="chrome",        # pakai Chrome asli, bukan Chromium bawaan
    )
    context = browser.new_context(
        viewport={"width": 1440, "height": 900},
        locale="en-US",
        timezone_id="America/New_York",
        user_agent=(
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/134.0.0.0 Safari/537.36"
        ),
    )
    page = context.new_page()
    page.goto(
        "https://www.glassdoor.com/Job/new-york-data-engineer-jobs-"
        "SRCH_IL.0,8_IC1132348_KO9,22.htm"
    )

    # Tutup overlay login — kontennya masih ada di DOM
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)

    page.wait_for_selector("[data-test='jobListing']")
    print("Halaman termuat — kartu lowongan terlihat.")
Ada beberapa hal penting di sini. Flag channel="chrome" memberi tahu Patchright untuk memakai binary Chrome yang sudah terpasang, bukan Chromium bawaan — ini menghasilkan fingerprint browser yang lebih autentik. Trik add_style_tag menyembunyikan modal login Glassdoor (disebut #HardsellOverlay) tanpa perlu klik apa pun. Scrapfly mengonfirmasi bahwa "semua konten itu masih ada, hanya tertutup overlay" — HTML tetap memuat data meski modal terlihat.
Anda seharusnya akan melihat jendela Chrome terbuka, masuk ke halaman pencarian kerja Glassdoor, dan menampilkan kartu lowongan tanpa popup login yang menghalangi.
Langkah 3: Scrape Daftar Lowongan Glassdoor
Identifikasi Selector yang Stabil
Glassdoor mengacak nama class CSS di setiap build — jadi selector .jobCard_xyz123 dari tutorial 2023 akan diam-diam tidak mengembalikan apa pun hari ini. Sebagai gantinya, gunakan atribut data-test, yang merupakan konvensi QA internal Glassdoor dan relatif stabil lintas deploy.
Berikut referensi selector untuk field daftar lowongan:
| Field | Selector |
|---|---|
| Container kartu lowongan | [data-test="jobListing"] |
| Judul pekerjaan | [data-test="job-title"] |
| Tautan lowongan | a[data-test="job-link"] |
| Nama perusahaan | [data-test="employer-name"] |
| Lokasi | [data-test="emp-location"] |
| Rentang gaji | [data-test="detailSalary"] |
| Rating perusahaan | [data-test="rating"] |
| Tanggal posting | [data-test="job-age"] |
| Pagination berikutnya | [data-test="pagination-next"] |
Ekstrak Data Lowongan
from parsel import Selector
import csv, random, time

def scrape_jobs(page, max_pages=5):
    all_jobs = []

    for page_num in range(1, max_pages + 1):
        html = page.content()
        sel = Selector(text=html)
        cards = sel.css('[data-test="jobListing"]')

        if not cards:
            print(f"Halaman {page_num}: Tidak ada kartu ditemukan — kemungkinan diblokir atau selector berubah.")
            break

        for card in cards:
            job = {
                "title": card.css('[data-test="job-title"]::text').get("").strip(),
                "company": card.css('[data-test="employer-name"]::text').get("").strip(),
                "location": card.css('[data-test="emp-location"]::text').get("").strip(),
                "salary": card.css('[data-test="detailSalary"]::text').get("").strip(),
                "rating": card.css('[data-test="rating"]::text').get("").strip(),
                "link": card.css('a[data-test="job-link"]::attr(href)').get(""),
                "posted": card.css('[data-test="job-age"]::text').get("").strip(),
            }
            if job["link"] and not job["link"].startswith("http"):
                job["link"] = "https://www.glassdoor.com" + job["link"]
            all_jobs.append(job)

        print(f"Halaman {page_num}: berhasil scrape {len(cards)} lowongan")

        # Pagination
        next_btn = page.query_selector('[data-test="pagination-next"]')
        if next_btn and page_num < max_pages:
            next_btn.click()
            time.sleep(random.uniform(3, 8))
            page.wait_for_selector("[data-test='jobListing']")
        else:
            break

    return all_jobs
Simpan ke CSV
def save_to_csv(jobs, filename="glassdoor_jobs.csv"):
    if not jobs:
        print("Tidak ada data lowongan untuk disimpan.")
        return
    keys = jobs[0].keys()
    with open(filename, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(jobs)
    print(f"Berhasil menyimpan {len(jobs)} lowongan ke {filename}")
Catatan tentang batas pagination: Glassdoor membatasi hasil pencarian sekitar 30 halaman, berapa pun total jumlahnya. Kalau Anda butuh cakupan lebih luas, gunakan filter (lokasi, tipe pekerjaan, kisaran gaji) untuk mempersempit tiap pencarian, bukan memaksa pagination melewati batas itu.
Dalam pengujian saya, scraping 5 halaman daftar lowongan (sekitar 75 pekerjaan) memakan waktu sekitar 45 detik dengan jeda acak. Mengerjakan hal yang sama secara manual akan memakan waktu setidaknya 20 menit copy-paste.
Langkah 4: Scrape Ulasan Perusahaan Glassdoor
Ini bagian yang tidak disediakan secara bekerja oleh tutorial lain mana pun. Ulasan adalah tempat intelijen employer yang paling berharga berada — analisis sentimen, sinyal budaya kerja, red flag manajemen.
Buka Halaman Ulasan
URL ulasan mengikuti pola ini: /Reviews/{Company}-Reviews-E{id}.htm. Anda bisa menemukan employer ID dengan mencari perusahaan di Glassdoor lalu memeriksa URL-nya.
def navigate_to_reviews(page, company_reviews_url):
    page.goto(company_reviews_url)
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)
    page.wait_for_selector('[data-test="review"]', timeout=15000)
Endpoint BFF Tersembunyi (Jalur Paling Bersih)
Ini temuan terbesar dari riset saya: ulasan Glassdoor punya API JSON internal yang benar-benar berfungsi dan melewati parsing HTML sepenuhnya. Repositori scraper Scrapfly mendokumentasikan endpoint ini, dan hasilnya jauh lebih andal dibanding scraping DOM.
import json, re, requests

def get_review_ids(page):
    """Ambil employerId dan dynamicProfileId dari HTML halaman ulasan."""
    html = page.content()
    sel = Selector(text=html)
    script_text = sel.xpath(
        "//script[contains(text(), 'profileId')]/text()"
    ).get("")
    employer_match = re.search(r'"employer"\s*:\s*(\{[^}]+\})', script_text)
    if employer_match:
        meta = json.loads(employer_match.group(1))
        return meta.get("id"), meta.get("profileId")
    return None, None

def fetch_reviews_bff(page, employer_id, profile_id, max_pages=5):
    """Panggil endpoint BFF internal Glassdoor untuk data ulasan terstruktur."""
    all_reviews = []
    cookies = {c["name"]: c["value"] for c in page.context.cookies()}

    for pg in range(1, max_pages + 1):
        payload = {
            "applyDefaultCriteria": True,
            "employerId": employer_id,
            "dynamicProfileId": profile_id,
            "employmentStatuses": ["REGULAR", "PART_TIME"],
            "language": "eng",
            "onlyCurrentEmployees": False,
            "page": pg,
            "pageSize": 10,
            "sort": "DATE",
            "textSearch": "",
        }
        resp = requests.post(
            "https://www.glassdoor.com/bff/employer-profile-mono/employer-reviews",
            json=payload,
            cookies=cookies,
            headers={"Content-Type": "application/json"},
        )
        if resp.status_code != 200:
            print(f"BFF mengembalikan {resp.status_code} pada halaman {pg}")
            break

        data = resp.json()
        reviews = data.get("data", {}).get("employerReviews", {}).get("reviews", [])
        total_pages = data.get("data", {}).get("employerReviews", {}).get("numberOfPages", 1)

        for r in reviews:
            all_reviews.append({
                "title": r.get("summary", ""),
                "rating": r.get("ratingOverall"),
                "pros": r.get("pros", ""),
                "cons": r.get("cons", ""),
                "author_role": r.get("jobTitle", {}).get("text", ""),
                "date": r.get("reviewDateTime", ""),
                "recommend": r.get("isRecommend"),
            })

        print(f"Halaman ulasan {pg}/{total_pages}: mendapatkan {len(reviews)} ulasan")
        if pg >= total_pages:
            break
        time.sleep(random.uniform(3, 6))

    return all_reviews
Endpoint BFF memberi Anda JSON bersih dengan semua field ulasan — tanpa parsing HTML, tanpa selector CSS yang mudah pecah. Anda membutuhkan session cookie dari konteks Playwright yang sudah terautentikasi (dibahas di Langkah 6 di bawah), dan Anda perlu mengambil employerId dan dynamicProfileId dari HTML halaman ulasan terlebih dahulu.
Selector HTML Cadangan untuk Ulasan
Kalau endpoint BFF berubah atau Anda lebih suka parsing DOM, berikut selector data-test yang stabil:
| Field | Selector |
|---|---|
| Container ulasan | [data-test="review"] |
| Judul ulasan | [data-test="review-title"] |
| Rating keseluruhan | [data-test="overall-rating"] |
| Kelebihan | [data-test="pros"] |
| Kekurangan | [data-test="cons"] |
| Tanggal | [data-test="review-date"] |
| Jabatan penulis | [data-test="author-jobTitle"] |
Langkah 5: Scrape Data Gaji Glassdoor
Halaman gaji sepenuhnya dikunci login. Anda harus punya sesi yang terautentikasi (Langkah 6) sebelum kode apa pun di bawah ini mengembalikan data nyata.
Buka Halaman Gaji
URL gaji mengikuti pola: /Salary/{Company}-Salaries-E{id}.htm, dengan pagination _P{n}.htm.
def scrape_salaries(page, salary_url, max_pages=3):
    all_salaries = []

    for pg in range(1, max_pages + 1):
        url = salary_url if pg == 1 else salary_url.replace(".htm", f"_P{pg}.htm")
        page.goto(url)
        page.add_style_tag(content="""
            #HardsellOverlay { display: none !important; }
            body { overflow: auto !important; position: initial !important; }
        """)
        time.sleep(random.uniform(3, 7))

        html = page.content()
        sel = Selector(text=html)
        items = sel.css('[data-test="salary-item"]')

        if not items:
            print(f"Halaman gaji {pg}: Tidak ada item — kemungkinan login gate atau blokir.")
            break

        for item in items:
            salary = {
                "job_title": item.css('[class*="SalaryItem_jobTitle__"]::text').get("").strip(),
                "salary_range": item.css('[class*="SalaryItem_salaryRange__"]::text').get("").strip(),
                "count": item.css('[class*="SalaryItem_salaryCount__"]::text').get("").strip(),
            }
            all_salaries.append(salary)

        print(f"Halaman gaji {pg}: berhasil scrape {len(items)} entri")

    return all_salaries
Perhatikan pola prefix-match [class*="SalaryItem_jobTitle__"]. Halaman gaji Glassdoor memakai class CSS-module yang di-hash (misalnya SalaryItem_jobTitle__XWGpT) di mana suffix hash berubah setiap deploy. Prefix-nya tetap stabil — hash-nya tidak. Jangan pernah hardcode nama class lengkap.
Langkah 6: Lewati Login Wall Glassdoor
Ini bagian penting yang membuka data gaji dan teks ulasan lengkap. Caranya: login sekali secara manual di browser yang terlihat, simpan state sesi yang terautentikasi, lalu gunakan kembali untuk semua run scraping berikutnya.
Simpan Sesi yang Sudah Terautentikasi
Jalankan skrip ini sekali. Ia akan membuka jendela Chrome, menuju halaman login Glassdoor (yang sekarang akan redirect ke Indeed Login), lalu menunggu Anda login secara manual:
import asyncio
from pathlib import Path
from patchright.async_api import async_playwright

STATE_FILE = Path("glassdoor_state.json")

async def login_and_save():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=False, channel="chrome")
        context = await browser.new_context(
            viewport={"width": 1366, "height": 800},
            locale="en-US",
        )
        page = await context.new_page()
        await page.goto("https://www.glassdoor.com/profile/login_input.htm")
        print("Login di jendela browser, lalu tekan Enter di sini...")
        input()
        await context.storage_state(path=str(STATE_FILE))
        print(f"Sesi disimpan ke {STATE_FILE}")
        await browser.close()

asyncio.run(login_and_save())
Setelah Anda login dan menekan Enter, Patchright akan menyimpan semua cookie dan local storage ke glassdoor_state.json. File ini berisi gdId, GSESSIONID, cf_clearance, dan token autentikasi Anda.
Gunakan Kembali Sesi untuk Scraping
Setiap run scraping berikutnya memuat state yang tersimpan — tidak perlu login manual lagi:
async def scrape_with_auth(target_url):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, channel="chrome")
        context = await browser.new_context(
            storage_state="glassdoor_state.json"
        )
        page = await context.new_page()
        await page.goto(target_url)
        await page.add_style_tag(
            content="#HardsellOverlay{display:none!important}"
        )
        await page.wait_for_load_state("networkidle")
        html = await page.content()
        await browser.close()
        return html
Sesi yang disimpan biasanya bertahan 20–30 menit penggunaan aktif sebelum Glassdoor memunculkan tantangan lagi. Untuk run scraping yang lebih lama, buat pengecekan: kalau Anda mendapat nol hasil dari halaman yang seharusnya punya data, jalankan ulang skrip login untuk menyegarkan state file Anda.
Mendeteksi dan Menutup Popup Login
Untuk halaman yang hanya dikunci sebagian (daftar lowongan yang menampilkan data tetapi menutupi modal), pendekatan injeksi CSS dari langkah sebelumnya bekerja:
page.add_style_tag(content="""
    #HardsellOverlay, .LoginModal { display: none !important; }
    body { overflow: auto !important; position: initial !important; }
""")
Ini hanya bekerja ketika HTML memang sudah memuat data di bawah overlay. Untuk halaman yang sepenuhnya dikunci di sisi server (gaji, halaman ulasan yang lebih dalam), sesi terautentikasi dari Langkah 6 adalah satu-satunya jalan.
Tips Agar Scraper Glassdoor Anda Tetap Jalan
Glassdoor sering memperbarui frontend-nya. Berikut cara membangun ketahanan di scraper Anda.
Utamakan Atribut data-test daripada Nama Class
Glassdoor mengacak nama class CSS tetapi cenderung mempertahankan atribut data-test tetap stabil. Selalu prioritaskan [data-test="jobListing"] daripada .jobCard_abc123. Saat data-test tidak tersedia (seperti pada class field gaji), gunakan pola prefix-match: [class*="SalaryItem_jobTitle__"].
Rotasi Proxy dan Acak Jeda
Gunakan rotating residential proxies — IP datacenter hampir langsung mendapat tantangan. Tambahkan jeda acak 3–8 detik antar pemuatan halaman (5–15 detik untuk run yang lebih panjang). Hindari scraping pada jam kerja bisnis AS jika memungkinkan, karena deteksi perilaku Cloudflare biasanya lebih agresif.
Pantau Jika Terjadi Kerusakan
Tambahkan pengecekan sederhana ke scraper Anda: kalau halaman yang seharusnya berisi data justru mengembalikan nol record, anggap itu kegagalan selector, bukan hasil kosong, lalu kirim peringatan ke diri sendiri. Jalankan test scrape kecil setiap minggu untuk menangkap kerusakan lebih awal — Glassdoor merilis perubahan frontend tanpa pengumuman.
Gunakan Jalur Cepat __NEXT_DATA__ Jika Memungkinkan
Glassdoor adalah aplikasi Next.js + Apollo GraphQL. Banyak halaman mengirim tag <script id="__NEXT_DATA__"> yang berisi cache GraphQL lengkap dalam bentuk JSON. Mem-parsing ini jauh lebih tahan banting daripada scraping DOM dan sepenuhnya melewati Hardsell overlay:
import json

def extract_next_data(html):
    sel = Selector(text=html)
    raw = sel.css("script#__NEXT_DATA__::text").get()
    if raw:
        return json.loads(raw)["props"]["pageProps"].get("apolloCache", {})
    return None
Ini mengembalikan cache Apollo terstruktur dengan semua field lowongan, ulasan, dan gaji — tanpa perlu selector CSS. Ini strategi ekstraksi paling tahan banting yang tersedia, karena data yang dipakai sama dengan yang menggerakkan frontend React Glassdoor.
Lewati Kode: Scrape Glassdoor dengan Thunderbit (Tanpa Python)
Tidak semua pembaca artikel ini adalah developer. Tim HR, recruiter, analis sales ops, dan peneliti pasar juga butuh data Glassdoor — dan mereka tidak seharusnya harus mengelola konteks Playwright dan rotasi proxy hanya untuk mendapatkannya.
Thunderbit adalah Ekstensi Chrome AI Web Scraper yang bisa mengekstrak data lowongan, ulasan, dan gaji yang sama tanpa menulis satu baris kode pun. Saya bekerja di tim Thunderbit, jadi saya akan jujur soal itu — tetapi alasan saya memasukkannya di sini adalah karena Thunderbit benar-benar menyelesaikan dua masalah tersulit dalam scraping Glassdoor.
Cara Thunderbit Bekerja di Glassdoor
Alurnya cuma dua klik:
- Buka halaman Glassdoor apa pun di Chrome (pencarian kerja, ulasan perusahaan, halaman gaji)
- Klik AI Suggest Fields di sidebar Thunderbit — AI membaca DOM halaman dan mengusulkan kolom (judul pekerjaan, perusahaan, rating, rentang gaji, pros, cons, dll.)
- Klik Scrape — data diekstrak ke tabel tanpa selector CSS atau kode otomasi browser
Thunderbit punya template scraper perusahaan Glassdoor bawaan yang mengekstrak lebih dari 23 field per perusahaan dalam satu kali run. Untuk daftar lowongan, ulasan, atau gaji, workflow umum AI Suggest Fields bisa menangani URL Glassdoor apa pun.
Menangani Login Wall Tanpa Kode
Di sinilah keunggulan struktural Thunderbit untuk Glassdoor. Browser Mode berjalan di dalam sesi Chrome Anda sendiri — kalau Anda sudah login ke Glassdoor di Chrome, Thunderbit otomatis mewarisi cookie tersebut. Login wall untuk gaji dan ulasan yang menghalangi scraper sisi server jadi tidak relevan. Tidak perlu manajemen cookie, tidak perlu persistent context, tidak perlu kode sesi.
Scraping Subpage untuk Enrichment
Mulai dari halaman daftar (misalnya 30 perusahaan dari sebuah pencarian), biarkan Thunderbit mengekstrak baris-barisnya, lalu aktifkan subpage scraping untuk mengunjungi setiap halaman ulasan atau gaji perusahaan dan memperkaya tabel dengan deskripsi lengkap, teks ulasan, atau detail gaji.
Ekspor ke Tools Bisnis
Berbeda dengan script Python yang output-nya CSV atau JSON, Thunderbit mengekspor langsung ke Google Sheets, Airtable, Notion, atau Excel — gratis di semua paket. Sangat berguna untuk tim yang perlu berbagi dan menganalisis data secara kolaboratif.
Python vs. Thunderbit: Kapan Pakai yang Mana
| Skenario | Pendekatan yang Disarankan |
|---|---|
| Membangun pipeline data berulang | Python + Patchright |
| Riset sekali jalan atau proyek kecil tim | Thunderbit |
| Perlu kontrol programatik atas setiap field | Python |
| Non-developer yang butuh data Glassdoor hari ini | Thunderbit |
| Scraping 1.000+ halaman dalam satu run | Python + proxy |
| Scraping 30 perusahaan dengan enrichment | Keduanya bisa — Thunderbit lebih cepat disiapkan |
Harga Thunderbit dimulai dari gratis (6 halaman/bulan), dengan paket Pro seharga $38/bulan untuk 3.000 kredit. Dengan 1 kredit per baris output (2 kredit untuk subpage scraping), itu cukup untuk sekitar 33 run dengan 30 perusahaan yang diperkaya per bulan.
Coba Thunderbit untuk scraping Glassdoor
Apakah Legal Scrape Glassdoor?
Saya akan singkat dan faktual. Ketentuan Layanan Glassdoor secara eksplisit melarang scraping otomatis: "Anda tidak boleh menggunakan robot, spider, scraper... untuk mengakses Layanan apa pun tanpa izin tertulis dari kami."
Namun, lanskap hukumnya lebih bernuansa daripada satu klausul ToS:
- Meta v. Bright Data (N.D. Cal., Jan 2024): Pengadilan memutuskan bahwa kalau Anda tidak pernah login, Anda tidak pernah menyetujui ToS, dan scraping data publik saat tidak login tidak melanggarnya
- hiQ Labs v. LinkedIn (9th Cir.): CFAA tidak berlaku untuk pengumpulan otomatis data yang bisa diakses publik — tetapi akun palsu dan scraping saat login adalah cerita berbeda
- Van Buren v. United States (Mahkamah Agung, 2021): Mempersempit arti "exceeds authorized access" di bawah CFAA
Kesimpulan praktisnya: scraping daftar lowongan publik tanpa login berada di zona hukum yang relatif lebih aman. Scraping dengan sesi yang login berarti Anda menerima ToS saat mendaftar, dan ToS tersebut secara eksplisit melarangnya. Ini berlaku sama untuk skrip Python maupun Browser Mode Thunderbit.
Pedoman etis yang tetap layak diikuti:
- Batasi rate jauh di bawah kecepatan browsing manusia
- Jangan scrape atau menjual ulang informasi identitas pribadi reviewer
- Hormati arahan robots.txt
- Ambil hanya field yang benar-benar Anda butuhkan
Kesimpulan: Metode Mana yang Tepat untuk Anda?
Panduan ini membahas ketiga jenis data Glassdoor — lowongan, ulasan, dan gaji — dengan kode 2025 yang bekerja dan sudah memperhitungkan migrasi ke Indeed Login, Cloudflare Bot Management, serta rotasi nama class CSS-module yang mematahkan semua tutorial lama.
Berikut kerangka keputusannya:
| Situasi Anda | Jalur Terbaik |
|---|---|
| Developer yang membangun pipeline data | Python + Patchright (ikuti langkah demi langkah di atas) |
| Riset sekali jalan atau pengambilan kecil berulang | Thunderbit (tanpa kode, berbasis browser) |
| Hanya butuh daftar lowongan dasar dalam skala kecil | Cek dulu apakah akses Glassdoor API masih tersedia (kemungkinan tidak) |
| Butuh data gaji atau ulasan secara spesifik | Harus pakai scraping Python atau Thunderbit — API tidak pernah mencakup ini |
| Tim non-developer yang perlu data bersama | Thunderbit → ekspor ke Google Sheets |
Pertahanan Glassdoor akan terus berkembang. Selector akan rusak. Tantangan baru akan muncul. Simpan panduan ini — dan kalau Anda ingin melihat lebih dalam tools serta teknik web scraping, baca juga artikel kami tentang best automated web scraping tools, cara scrape data dari website dengan Python, dan best job scraping tools. Anda juga bisa menonton panduan di Thunderbit YouTube Channel.
Coba Thunderbit untuk ekstraksi data Glassdoor Get Started Free
FAQ
1. Bisakah scrape Glassdoor tanpa login?
Ya, untuk sebagian besar data daftar lowongan dan rating perusahaan tingkat atas. Tidak, untuk rincian gaji lengkap atau teks ulasan penuh di luar beberapa halaman pertama. #HardsellOverlay hanyalah modal berbasis CSS — HTML yang mendasarinya masih menyimpan data halaman pertama — tetapi konten yang lebih dalam dikunci di sisi server di balik wall "give-to-get" Glassdoor.
2. Library Python apa yang paling bagus untuk scraping Glassdoor di 2025?
Patchright (fork stealth dari Playwright) adalah rekomendasi default. Ia menambal kebocoran Runtime.Enable CDP yang dimiliki Playwright biasa dan yang secara eksplisit dicek oleh Cloudflare. Untuk halaman daftar yang sudah mengirim __NEXT_DATA__ di HTML awal, curl_cffi dengan impersonate="chrome124" 10–20x lebih cepat, tetapi tidak bisa menangani halaman yang dikunci login.
3. Bagaimana cara menghindari blokir saat scraping Glassdoor?
Gunakan Patchright atau rebrowser-playwright (bukan Playwright biasa atau Selenium). Rotasi residential proxies — IP datacenter langsung ditantang. Tambahkan jeda acak 3–8 detik antar halaman. Simpan cookie (gdId, cf_clearance, GSESSIONID) lintas request. Harapkan jendela sesi 20–30 menit sebelum ditantang lagi.
4. Ada API Glassdoor yang bisa dipakai sebagai pengganti scraping?
Praktis tidak ada. Partner API lama ditutup untuk pendaftar baru, endpoint ulasan publik tidak pernah ada, dan tidak ada jalur migrasi lewat Indeed Publisher API. Scraping atau tool no-code seperti Thunderbit adalah satu-satunya opsi praktis untuk data ulasan dan gaji.
5. Seberapa sering scraper Glassdoor rusak?
Sangat sering. Glassdoor merilis perubahan frontend tanpa pengumuman, dan hash class CSS-module berputar pada setiap build. Strategi ekstraksi yang paling stabil adalah: (1) selector atribut data-test, (2) blob JSON __NEXT_DATA__, dan (3) endpoint ulasan BFF internal. Tambahkan pemeriksaan nol-hasil dan jalankan test scrape kecil setiap minggu agar kerusakan terdeteksi lebih awal.
Pelajari Lebih Lanjut



