
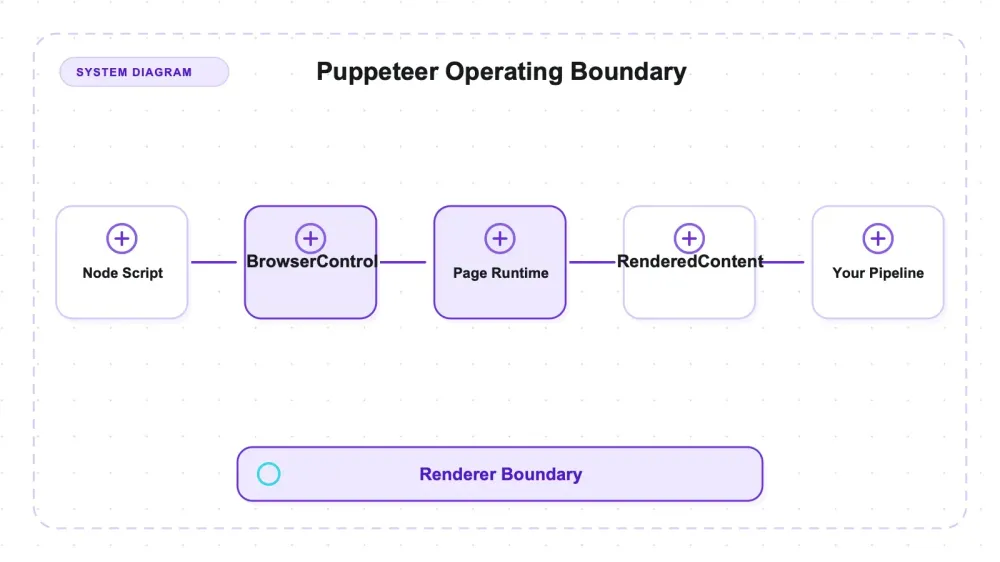
Puppeteer adalah library Node milik Google untuk mengendalikan Chrome sungguhan dari JavaScript — kamu menulis automasinya, Chrome DevTools Protocol yang membawa perintahnya, dan browser penuh merender halaman sebelum kamu membaca satu byte pun. Proyek ini berada di puppeteer/puppeteer di GitHub: berlisensi Apache-2.0, ditulis dengan TypeScript, dan saat snapshot saya diambil memiliki sekitar 95,3 ribu bintang (95.307 pada hari saya menarik snapshot tersebut). Posisi resminya memang sengaja dibuat sempit — "sebuah JavaScript API untuk mengontrol Chrome (dan secara eksperimental Firefox)" — jadi dari situ kamu tahu apa yang bisa dilakukan, dan sama pentingnya, apa yang bukan tujuan utamanya.
Saya menjalankan Puppeteer 24.16.0 lewat server fixture dan demo publik yang sama seperti yang kami pakai untuk setiap library otomatisasi browser: katalog statis dengan pagination, artikel, katalog yang dirender JavaScript, API JSON, rute yang mengembalikan 500, grafik crawl kecil, plus Books to Scrape dan Quotes to Scrape. Tugas render-nya selesai dengan rapi dan tanpa drama. Tapi ada satu hal yang tetap tertinggal di meja saya — sama seperti yang ditinggalkan setiap library headless-browser — dan jujur soal celah itu adalah pembeda utama antara ulasan yang berguna dan sekadar siaran pers.
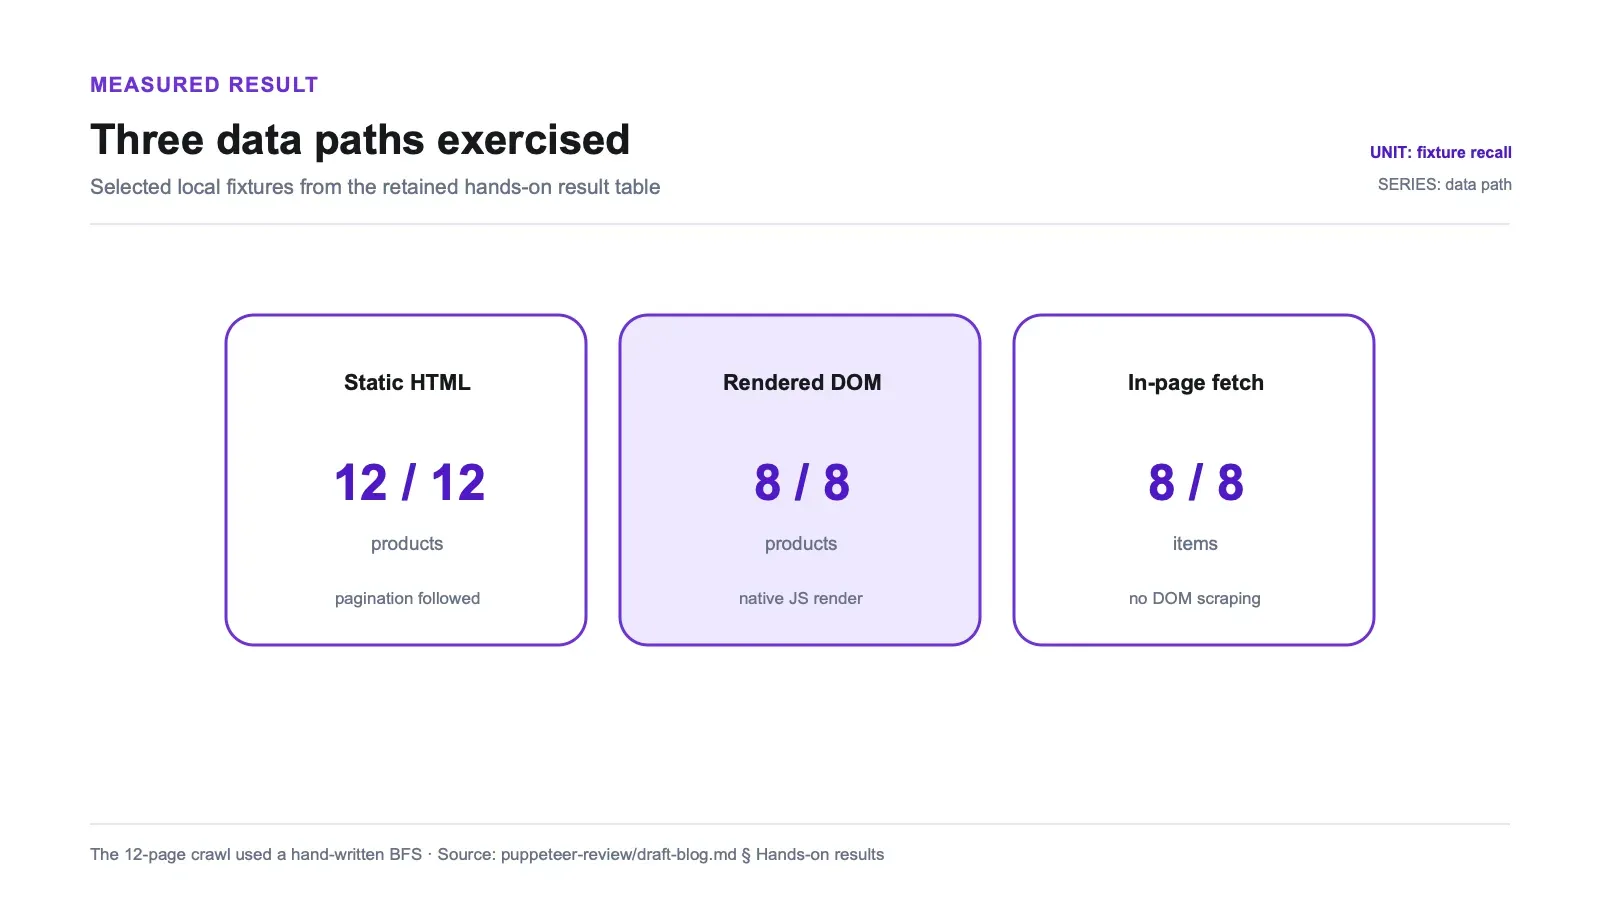
Ada satu angka yang lebih menonjol daripada metrik recall. Pada halaman yang datanya datang dari endpoint JSON, Puppeteer mengambil semua 8 record tanpa meng-scrape DOM sama sekali — ia menjalankan fetch di dalam halaman dan membaca objek respons secara langsung. Itulah bentuk alat ini: renderer Chrome yang matang, bukan framework crawler, dan perbedaan itu penting bahkan sebelum kamu menulis satu baris kode.
Sebenarnya apa itu Puppeteer (dan dengan apa ia bersaing)
Label kategorinya memang benar-benar penting di sini, jadi kita mulai dari situ. Puppeteer adalah library otomatisasi browser. Ia menjalankan Chrome, membuka halaman, membiarkan JavaScript halaman bekerja, lalu memberi kamu hasil render untuk dibaca atau di-screenshot. Itulah alasan kamu memilihnya alih-alih client HTTP plus parser HTML: kamu ingin halaman setelah skripnya berjalan, bukan shell kosong yang pertama kali dikirim server.
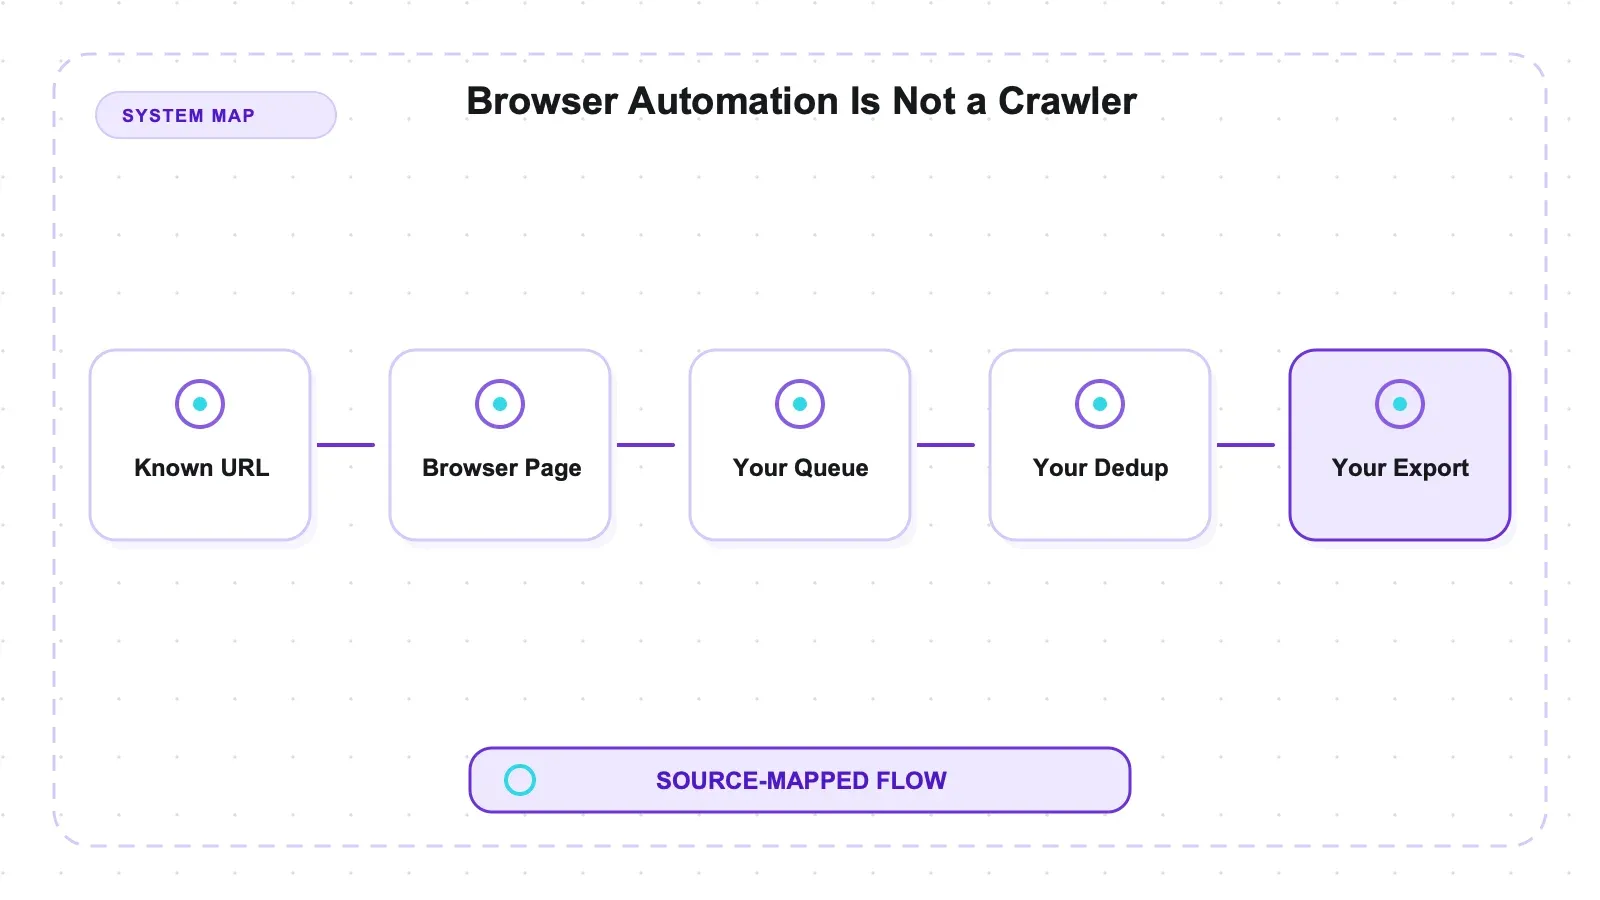
Dari bentuknya, ia bersaing dengan library browser sungguhan lain — Playwright dan Selenium — bukan dengan framework crawler seperti Scrapy atau dengan alat Markdown berbasis LLM. Kalau kamu mengarahkan Puppeteer ke seribu URL lalu berharap ia mengantrikan, mendeduplikasi, membatasi laju secara sopan, dan menulis dataset, berarti kamu membawa renderer ke masalah crawling. Ia akan merender setiap halaman dengan indah, tetapi tidak mengelola orkestrasinya. (Itu batasan cakupan, bukan bug — saya akan kembali ke ini, karena inilah hal paling penting yang harus dipahami sebelum mengadopsi alat ini.)
Puppeteer lahir dari tim Chrome Google, karena itulah ia Chrome-first secara desain dan API-nya terasa seperti sarung tangan tipis yang pas di atas protokol debugging browser itu sendiri. Usianya sudah cukup matang sampai terasa enak dipakai: metode yang kamu butuhkan sudah stabil selama bertahun-tahun, dokumentasinya lengkap, dan ekosistem di sekelilingnya sangat dalam.
Rendering native dan pola fetch di dalam halaman
Ada dua perilaku yang layak diangkat dari tabel hasil karena keduanya menjelaskan bagaimana alat ini akan benar-benar dipakai.
Pertama, rendering native. Katalog yang dirender JavaScript — halaman yang membangun grid produknya di sisi klien setelah load — kembali dengan 8/8, disertai screenshot penuh halaman yang disimpan ke disk. Setup-nya minimal, tetapi memang menunggu konten target setelah goto. Halaman Quotes to Scrape JS publik mengembalikan semua sepuluh kutipan dengan pola yang sama. Ini adalah hasil pada fixture, bukan skor recall rendering untuk penggunaan umum.
Kedua, fixture API JSON memuat produk dari /api/dynamic-products. Menjalankan fetch same-origin lewat page.evaluate menghasilkan semua delapan record tanpa perlu mem-parsing baris yang sudah dirender. Ini adalah pola evaluasi browser yang umum, bukan temuan khusus Puppeteer. Pendekatan ini bisa menyederhanakan ekstraksi ketika endpoint dan kontrak request sudah diketahui; header autentikasi, token runtime, kebijakan kredensial, CORS/CSP, service worker, dan pagination tetap bisa membuat request aplikasi berbeda dari yang diharapkan.
Hal ketiga yang perlu dibawa ke depan adalah kerangkanya, bukan angkanya: Puppeteer adalah renderer Chrome yang matang, dan ia bukan crawler. Dua-duanya benar, dan bagian kedua itulah yang sering diabaikan tulisan-tulisan lain.
Cara Puppeteer berbicara dengan Chrome
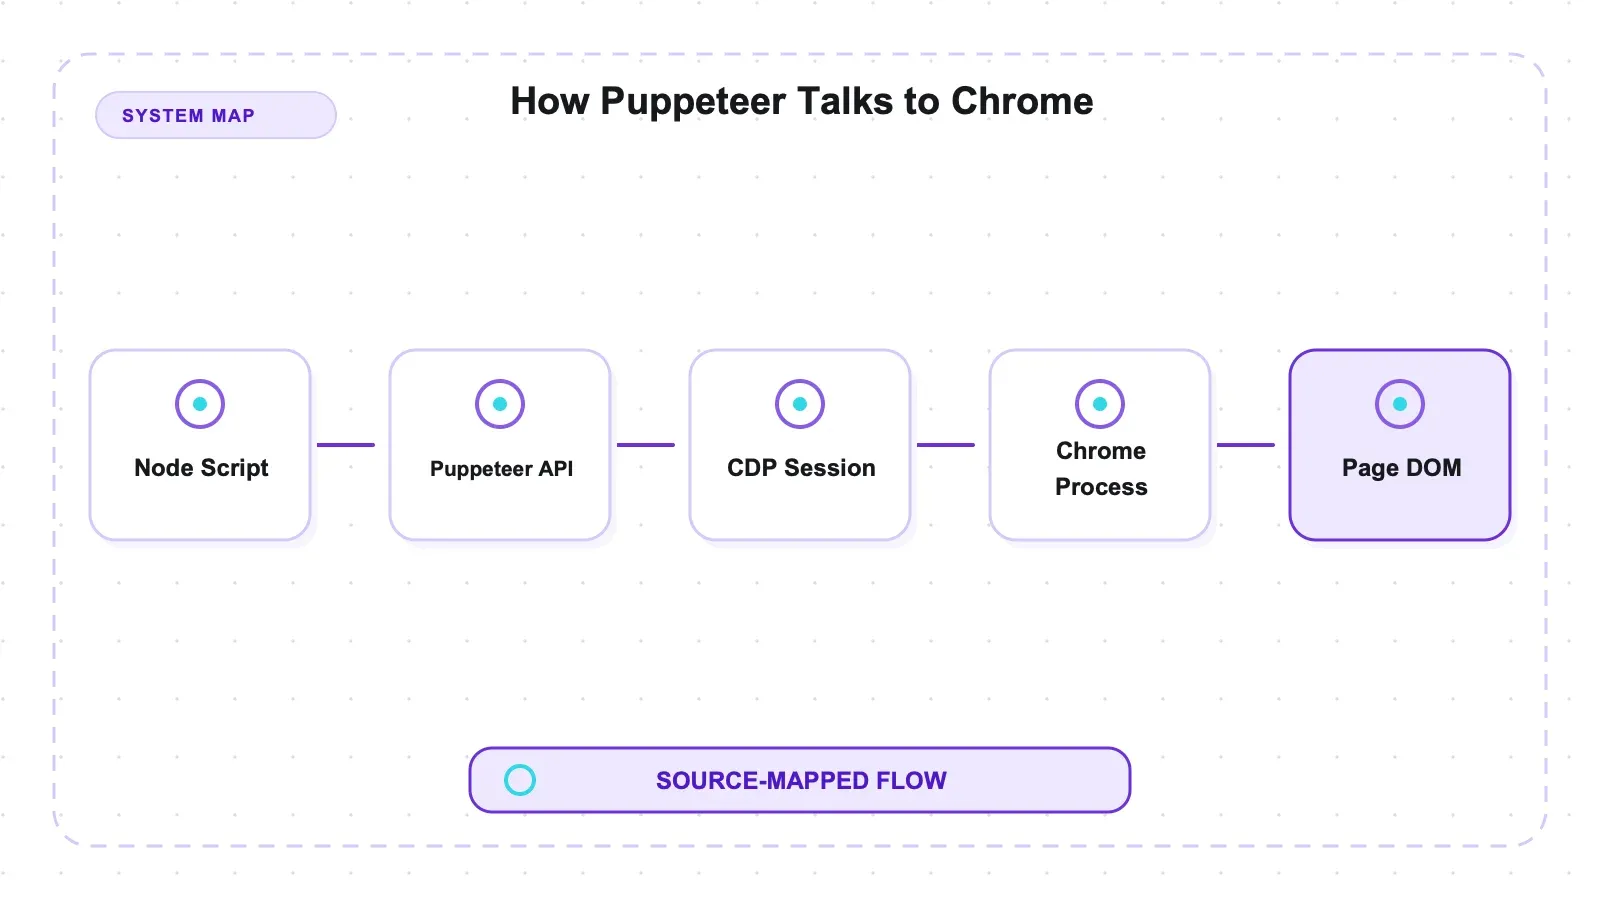
Di Chrome, Puppeteer memakai Chrome DevTools Protocol (CDP), kanal JSON-over-WebSocket yang juga dipakai DevTools browser. puppeteer.launch() menjalankan Chrome dan membuka koneksi protokol itu; panggilan seperti goto, $$eval, dan screenshot mengekspos operasi browser melalui API level yang lebih tinggi. Dukungan Firefox mengikuti jalur WebDriver BiDi yang dijelaskan di bawah, jadi tidak semua operasi Puppeteer selalu merupakan perintah CDP.
page.evaluate menjalankan fungsi di konteks halaman, jadi fetch('/api/...') yang relatif akan memakai origin halaman tersebut dan mungkin kembali memakai cookie serta state sesi yang memenuhi syarat. Ia tidak otomatis meniru header otorisasi buatan aplikasi, opsi request, token, atau perilaku service worker. Pada fixture same-origin ini hasilnya JSON langsung; request produksi tetap perlu diperiksa kontraknya yang sebenarnya.
Itulah juga alasan Puppeteer terasa berat. Setiap halaman adalah tab browser sungguhan dengan mesin rendering asli di belakangnya. Itu memberi kamu akurasi pada halaman yang banyak JavaScript-nya, tetapi juga menambah memori dan waktu startup dibanding fetch HTTP-only. Tidak ada rendering gratis; CDP hanya membuat biayanya lebih jelas.
Soal engine, dijelaskan apa adanya
Ada penyederhanaan populer bahwa Puppeteer itu "hanya Chrome." Untuk versi yang saya uji, itu tidak tepat, dan memperbaiki pemahaman ini mengubah perbandingan.
| Engine | Cara Puppeteer 24.16.0 mengendalikannya | Diuji dalam rangkaian ini |
|---|---|---|
| Chrome | Chrome-first lewat CDP — default, jadi automasi yang sudah ada tetap jalan | ya |
| Firefox | Dukungan terdokumentasi lewat WebDriver BiDi sejak v23 | tidak |
| WebKit | Tidak dikendalikan sama sekali | — |
Baik Chrome for Developers maupun Mozilla menulis soal dukungan Firefox ketika fitur itu dirilis. Build yang saya jalankan, 24.16.0, sudah jauh di atas v23, jadi klaim "hanya Chrome" meremehkan isi paketnya. Ketidakhadiran WebKit, ditambah usia dukungan lintas-engine yang masih lebih muda dibanding Playwright, adalah perbedaan cakupan yang sebenarnya — bukan "satu engine versus tiga."
Jalur Firefox/BiDi memang terdokumentasi dan tersedia di versi yang saya uji, tetapi saya tidak menjalankan fixture saya lewat jalur itu, jadi yang saya laporkan adalah kapabilitas, bukan hasil pengukuran. Jika rendering Firefox adalah hal penting untuk target kamu, validasikan dulu dengan halaman kamu sendiri sebelum memutuskan. Untuk pembaca yang ingin perbandingan head-to-head lengkap soal engine dan scope bahasa, perbandingan Playwright-vs-Puppeteer kami menjalankan kedua library lewat tes yang sama dan menjawab pertanyaan "mana yang dipilih" di sana; di sini fokusnya adalah Puppeteer saja.
Realitas setup dan instalasi: browser adalah bagian terberat
Jalur default npm install puppeteer akan mengunduh build Chrome for Testing yang kompatibel. Perilaku ini bisa dilewati atau diarahkan lewat konfigurasi, dan pengguna juga dapat menunjuk Puppeteer ke executable lain, jadi kecocokan versi bergantung pada pilihan deployment. Unduhan browser adalah bagian paling berat dari instalasi ini; snapshot audit dari package manager tidak dianggap sebagai properti keamanan yang tahan lama.
Bundling otomatis itu benar-benar unggul dari sisi ergonomi, tapi juga ada biaya footprint yang nyata, dan kedua sisi ini layak disebut. Keunggulannya: kamu tidak perlu mencari browser yang cocok atau mengunci versi secara manual; npm install langsung memberi pasangan yang siap pakai. Biayanya: kamu sedang mengunduh browser, jadi siapkan disk dan bandwidth, terutama di CI ketika cache dingin harus membayar harga itu di setiap runner baru.
Ini juga kontras yang nyata dengan Playwright, yang memisahkan dua langkah — kamu install library-nya, lalu menjalankan npx playwright install terpisah untuk menarik build browser-nya. Tidak ada pendekatan yang menyakitkan; mereka hanya gagal dengan cara yang berbeda. Perintah tunggal Puppeteer bisa mengejutkan karena ukurannya di koneksi berkuota, sementara langkah kedua Playwright bisa mengejutkan karena mudah terlupakan. Ketahui dulu kamu sedang memakai yang mana.
Hasil langsung dari pengujian
Semua tes dijalankan terhadap server fixture lokal di 127.0.0.1 serta dua situs latihan publik, pada Node v22.22.3, macOS arm64, dengan Puppeteer 24.16.0 dan Chrome bawaannya. Kebenaran acuan untuk setiap fixture dicatat sebelum pengujian, jadi recall diukur terhadap set ekspektasi yang tetap, bukan terhadap apa pun yang kebetulan dicetak Puppeteer.
Paket riset publik mencakup fixture server, test runner, dan ground truth. Lock dependency dan ringkasan mentah hasil run sengaja tidak disertakan dalam bundel publik karena review keamanan yang ketat menolak data lock dependency dan material endpoint yang spesifik lingkungan. Untuk mereproduksi fixture lokal yang aman, jalankan npm install lalu node run_puppeteer_material_tests.mjs di dalam tools/puppeteer/tests, lalu bandingkan hasilnya dengan ground truth yang dipublikasikan. Halaman demo publik bisa berubah, jadi fixture lokal adalah basis yang stabil untuk pengecekan jumlah yang diharapkan.
Untuk rekonstruksi historis dependency yang benar-benar presisi, buat dan audit lockfile baru secara lokal, jangan memperlakukan lock yang tidak dipublikasikan sebagai bukti publik.
| Tes | Target | Hasil |
|---|---|---|
| Katalog statis + pagination | fixture lokal | 12/12, recall 1.0 |
| Ekstraksi artikel | fixture lokal | judul + 3/3 paragraf, boilerplate terpisah |
| Halaman JS dinamis (render native) | fixture lokal | 8/8, recall 1.0, screenshot full-page tersimpan |
API JSON dinamis (fetch di dalam halaman) | fixture lokal | 8/8, recall 1.0, tanpa scraping DOM |
| Penanganan HTTP 500 | fixture lokal | status 500 dapat diperiksa, tidak melempar error |
| Grafik crawl (BFS buatan sendiri) | fixture lokal | 12 halaman, depth {0:1, 1:4, 2:7} |
| Books to Scrape | demo publik | 20 produk |
| Quotes JS | demo publik | 10 kutipan, dirender secara native |
Beberapa hal ini layak diberi penjelasan lebih dari sekadar tabel.
Kode pagination yang ditulis khusus berhasil mengambil semua 12 item katalog yang diharapkan. Selector artikel mengambil judul dan tiga paragraf isi yang diharapkan; boilerplate di sekitarnya tetap tersedia di DOM. Puppeteer menyediakan DOM yang sudah dirender, sementara logika selector-lah — bukan Puppeteer sendiri — yang menentukan apa yang dihitung sebagai isi artikel.
Pada rute HTTP 500 yang diuji, goto mengembalikan objek respons dengan status 500 yang bisa diperiksa dan tidak melempar exception. Itu tidak mengatakan apa-apa tentang timeout, kegagalan DNS, crash browser, frame yang terlepas, atau error navigasi lain, yang tetap perlu ditangani secara eksplisit.
Grafik crawl adalah yang paling menjelaskan keseluruhan cerita. Menelusuri link internal fixture sampai 12 halaman, sambil melacak depth agar URL tidak dikunjungi ulang, membutuhkan breadth-first search buatan sendiri — karena Puppeteer tidak punya crawl queue bawaan. Proses itu menemukan semua 12 halaman di depth {0:1, 1:4, 2:7}, artinya BFS yang saya tulis bekerja. Tapi BFS itu milik saya. Puppeteer merender tiap halaman; logika berjalan menyusuri situs adalah kode yang saya buat sendiri. Untuk dua belas halaman, itu cuma belasan baris dan bukan masalah besar. Untuk ribuan URL dengan dedup, retry, dan jeda sopan, belasan baris itu berubah jadi proyek.
Satu peringatan yang akan saya ulangi karena mudah disalahgunakan: artefak memang menyertakan waktu per tes, tetapi itu observasi satu kali, pada satu mesin, bukan benchmark. Saya tidak sedang membandingkan kecepatan Puppeteer dengan alat lain berdasarkan satu laptop dan satu kali run. Angka-angka itu mendukung recall dan perilaku di delapan tipe halaman berbeda — bukan klaim stopwatch.
Apa yang tidak saya uji
Agar hasil ini tidak dibaca lebih luas daripada yang semestinya, berikut hal-hal yang berada di luar run pengujian, dan karenanya di luar angka-angka ini:
| Di luar run pengujian | Status |
|---|---|
| Firefox via WebDriver BiDi | Terdokumentasi, tersedia di 24.16.0, tidak diuji di sini |
| Proxying dan request interception | Belum diuji; keduanya didukung tetapi tidak saya jalankan |
| Skala halaman paralel | Saya menjalankan skala kecil; perilaku browser fleet di concurrency nyata belum diukur |
| Uji ulang pada rilis terbaru | Saya menguji 24.16.0; npm latest adalah 25.3.0, satu major version lebih baru, per 2026-07-09. API yang saya gunakan (launch, goto, $$eval, screenshot, dan fetch di dalam halaman) stabil dari 24→25, tetapi langkah jujurnya adalah menjalankan ulang di 25.3.0 sebelum bertaruh pada angka yang presisi |
Tidak ada satu pun dari ini yang menjatuhkan reputasi alatnya. Itu hanya batas dari apa yang bisa diklaim secara jujur oleh satu kali run fixture.
Kelebihan dan kekurangan
Kelebihan:
- Rendering JavaScript native dengan tunggu konten yang eksplisit: 8/8 pada fixture dinamis dan seluruh sepuluh kutipan pada demo publik, lengkap dengan screenshot.
- Selector pagination dan artikel yang dibuat khusus berhasil mengambil item fixture yang diharapkan.
fetchdi dalam halaman mengembalikan semua delapan record dari endpoint same-origin yang diketahui tanpa parsing DOM.- HTTP 500 yang diuji kembali sebagai respons yang bisa diperiksa tanpa exception.
- Instalasi default mengunduh build Chrome for Testing yang kompatibel; konfigurasi untuk executable alternatif dan skip-download tetap tersedia.
- API yang matang, berfokus ke Chrome, lewat CDP, dengan ekosistem yang dalam dan dokumentasi lengkap. Apache-2.0.
- Lebih luas dari reputasinya: dukungan Firefox terdokumentasi lewat WebDriver BiDi sejak v23.
Kekurangan:
- Tidak ada crawl queue bawaan, writer dataset, atau throttle — kebutuhan skala crawl harus ditangani sendiri atau lewat wrapper.
- Tidak mendukung WebKit, dan cerita lintas-engine-nya masih lebih muda daripada Playwright.
- Bobot browser sungguhan: Chrome bawaan yang harus diunduh dan biaya memori per halaman dibanding alat HTTP-only.
- Berbasis Node; jika dipakai dari bahasa lain, kamu harus membangun dan memelihara bridge.
- Versi yang saya jalankan (24.16.0) tertinggal satu major version dari npm latest (25.3.0) — verifikasi ulang pada versi terkini sebelum mempercayai angka tepatnya.
Cocok untuk siapa, dan siapa yang sebaiknya melewatkannya
Pilih Puppeteer jika kamu bekerja di Node, target kamu dirender dengan baik di Chrome (kebanyakan memang begitu), dan kamu ingin library yang matang dan fokus yang mengubah "halaman setelah JavaScript-nya berjalan" menjadi sesuatu yang bisa kamu baca dan screenshot. Untuk scraping sejumlah halaman dinamis, atau mengambil API JSON dengan sesi halaman sendiri, atau menangkap screenshot hasil render sebagai bukti, ini adalah pilihan default yang kuat dan minim drama. Opsi Firefox lewat BiDi tersedia jika kebutuhan kamu berkembang ke sana, dan ekosistemnya membuat sebagian besar masalah yang kamu temui kemungkinan sudah pernah dihadapi orang lain.
Pikirkan dua kali jika masalah kamu adalah orkestrasi crawl, bukan rendering. Kalau kamu perlu menelusuri ratusan atau ribuan URL dengan deduplikasi, retry, dan rate limit, Puppeteer saja akan memaksa kamu membangun crawler sendiri — itu bukan level yang tepat untuknya. Hindari headless browser sama sekali jika halaman kamu sebenarnya tidak butuh JavaScript untuk menampilkan datanya; ketika request HTTP plus parser sudah mengembalikan konten, browser sungguhan menjadi overkill mahal yang hanya menghabiskan memori dan waktu setup. Dan kalau kamu membutuhkan fidelitas WebKit atau client dalam bahasa non-JavaScript, ini bukan alat yang tepat untuk poros itu.
Alternatif, dan posisi Thunderbit
Kerangka jujurnya begini dulu: Puppeteer gratis, berlisensi Apache-2.0, self-hosted, dan kamu memegang semua bagian operasionalnya sendiri — fleet browser, kode crawl yang kamu tambahkan, dan perlombaan tanpa henti melawan anti-bot. Untuk banyak proyek, kepemilikan seperti ini memang tepat, dan tidak ada managed service yang bisa merender halaman berizin lebih murah daripada browser yang sudah kamu miliki.
Di ranah open source, perbandingan yang berguna adalah berdasarkan tugas, bukan merek. Untuk skala crawl, Crawlee adalah pasangan yang alami: PuppeteerCrawler-nya membungkus Puppeteer dengan request queue, dataset, dan throttling yang memang sengaja tidak disertakan library ini, jadi kamu tetap mendapatkan rendering dan sekaligus orkestrasi. Jika tujuan output kamu adalah Markdown bersih untuk pipeline LLM, bukan DOM yang dirender, Crawl4AI menggerakkan browser sungguhan dan menghasilkan itu persis. Jika halaman kamu tidak memerlukan browser sama sekali, framework yang mengutamakan HTTP seperti Scrapy adalah kategori yang berbeda dan lebih ringan. Saat kamu menimbang beberapa alat sekaligus, ringkasan open-source scraper kami menaruh kategori-kategori itu berdampingan.
Layanan terkelola seperti Thunderbit memindahkan operasi browser dan ekstraksi ke belakang API. Layanan ini tidak dijalankan melalui fixture Puppeteer ini, jadi ulasan ini tidak membuat klaim yang disamakan soal rendering, blocking, kualitas ekstraksi, atau biaya. Batas keputusan ada pada kepemilikan operasional: memelihara sendiri browser dan kode crawl, atau membayar penyedia untuk menjalankan sebagian lapisan itu.
Dengan Puppeteer, tidak ada biaya penggunaan vendor, tetapi komputasi, bandwidth, pemeliharaan browser, orkestrasi, dan operasi tetap menjadi tanggungan kamu. Jalur managed mengenakan biaya berdasarkan penggunaan dan memindahkan sebagian tanggung jawab itu ke penyedia. Eksperimen ini tidak membandingkan hasilnya.
Coba Thunderbit untuk Ekstraksi Data Web
Kesimpulan
Puppeteer 24.16.0 layak dievaluasi jika kamu bekerja di Node dan membutuhkan otomatisasi browser yang Chrome-first. Kode fixture yang ditulis khusus berhasil mengambil 12 item statis, delapan item dinamis, dan sepuluh kutipan demo publik; API same-origin yang sudah diketahui mengembalikan delapan record lewat page.evaluate; screenshot berfungsi; dan HTTP 500 yang diuji tetap bisa diperiksa. Hasil ini berlaku untuk fixture yang disebutkan dan versi major yang lebih lama, bukan untuk recall ekstraksi secara umum.
Namun, ukuran klaimnya harus tepat. Puppeteer adalah renderer, bukan crawler: penelusuran 12 halaman saya membutuhkan BFS buatan sendiri karena tidak ada queue bawaan, dan pada skala besar celah itu berarti pekerjaan nyata — serahkan ke Crawlee atau bangun mesinnya sendiri. Ia Chrome-first dengan dukungan Firefox yang terdokumentasi lewat BiDi tetapi tanpa WebKit, jadi bukan alat untuk cakupan lintas-engine. Ia membawa bobot browser sungguhan. Dan saya menguji 24.16.0 sementara latest sudah 25.3.0, jadi jalankan ulang di versi terkini sebelum kamu mempercayai angka tepatnya. Pahami empat hal itu sejak awal, maka Puppeteer adalah library otomasi Chrome yang sangat baik. Jika kamu berharap ia melakukan crawling situs untukmu, kamu akan malah menulis crawler yang kamu kira sedang kamu unduh.
Coba Thunderbit untuk Ekstraksi Data Web Get Started Free
FAQ
Apakah Puppeteer bisa merender halaman JavaScript, atau perlu plugin?
Ia merender secara native, tanpa plugin. Pada fixture dinamis saya, ia mengembalikan 8 dari 8 produk yang dibangun di sisi klien dengan recall 1.0 dan screenshot full-page, dan halaman Quotes to Scrape JS publik mengembalikan semua 10 kutipan dengan cara yang sama — cukup goto, lalu baca DOM yang sudah dirender. Karena Puppeteer mengendalikan Chrome sungguhan lewat DevTools Protocol, skrip halaman benar-benar berjalan sebelum kamu membaca apa pun.
Bisakah Puppeteer mengambil data dari API JSON tanpa mem-parsing HTML?
Bisa, jika endpoint dan kontrak request memungkinkan. page.evaluate dapat mengirim request dari origin halaman dan mungkin memakai ulang cookie yang memenuhi syarat, tetapi ia tidak otomatis meniru header, token, opsi, atau perilaku service worker yang dibuat aplikasi. Pada fixture same-origin, ia mengembalikan semua delapan record tanpa parsing DOM.
Apakah Puppeteer itu web crawler?
Tidak — ini library otomatisasi browser, bukan framework crawler. Tidak ada request queue bawaan, writer dataset, atau throttle, jadi crawl saya yang 12 halaman (depth {0:1, 1:4, 2:7}) membutuhkan breadth-first search buatan sendiri. Itu batas cakupan, bukan kekurangan. Untuk skala crawl, padukan dengan wrapper seperti PuppeteerCrawler milik Crawlee, yang menambahkan queue dan mekanisme dataset yang tidak disediakan Puppeteer.
Apakah Puppeteer hanya untuk Chrome?
Tidak lagi. Ia Chrome-first lewat CDP, tetapi sejak v23 ia punya dukungan Firefox yang terdokumentasi melalui WebDriver BiDi, dan versi yang saya uji (24.16.0) sudah jauh melewatinya. Yang tidak ia dukung adalah WebKit, dan cerita lintas-engine-nya masih lebih muda daripada Playwright — itulah batas yang akurat, bukan "hanya Chrome." Saya hanya menguji Chrome di sini, jadi saya melaporkan Firefox lewat BiDi sebagai dokumentasi, bukan sebagai sesuatu yang saya ukur.
Apa yang sebenarnya diunduh saat menginstal Puppeteer?
Secara default, npm install puppeteer mengunduh build Chrome for Testing yang kompatibel. Unduhan ini bisa dilewati atau diarahkan, dan executable lain bisa dikonfigurasi, jadi kecocokan versi bergantung pada pilihan deployment. Siapkan disk dan bandwidth untuk browser-nya, terutama pada runner CI yang belum punya cache. Ulasan ini menguji 24.16.0; jalankan ulang fixture inti pada rilis yang berlaku saat publikasi.




