

Web scraping telah berubah dari keterampilan niche menjadi kemampuan wajib bagi siapa pun yang bekerja di bidang sales, operations, atau riset pasar. Dengan volume data web yang terus meledak—pembuatan data global naik hampir 193% dari 2019 ke 2023—tidak heran 81% perusahaan kini menganggap data sebagai “jantung” pengambilan keputusan mereka. Tapi ada kendalanya: 95% organisasi mengatakan bahwa menangani data tidak terstruktur (seperti HTML yang berantakan) adalah tantangan besar. Saya sudah melihat banyak tim tenggelam dalam maraton copy-paste, berusaha merapikan info website ke spreadsheet—percayalah, hasilnya jauh dari menyenangkan.
Ekstrak data dari situs web apa pun menggunakan AI Get Started Free
Di sinilah BeautifulSoup dari Python berperan. Dalam tutorial praktis ini, saya akan memandu Anda memakai BeautifulSoup untuk web scraping, lengkap dengan contoh Python Beautiful Soup yang bisa Anda sesuaikan untuk kebutuhan bisnis Anda sendiri. Dan karena saya suka bekerja lebih cerdas, bukan lebih keras, saya juga akan menunjukkan cara menggabungkan BeautifulSoup dengan Thunderbit, ai web scraper kami, untuk mempercepat alur kerja Anda dan mendapatkan data yang lebih bersih serta lebih terstruktur—apa pun level coding Anda.
Apa Itu BeautifulSoup dan Mengapa Menggunakannya untuk Web Scraping?
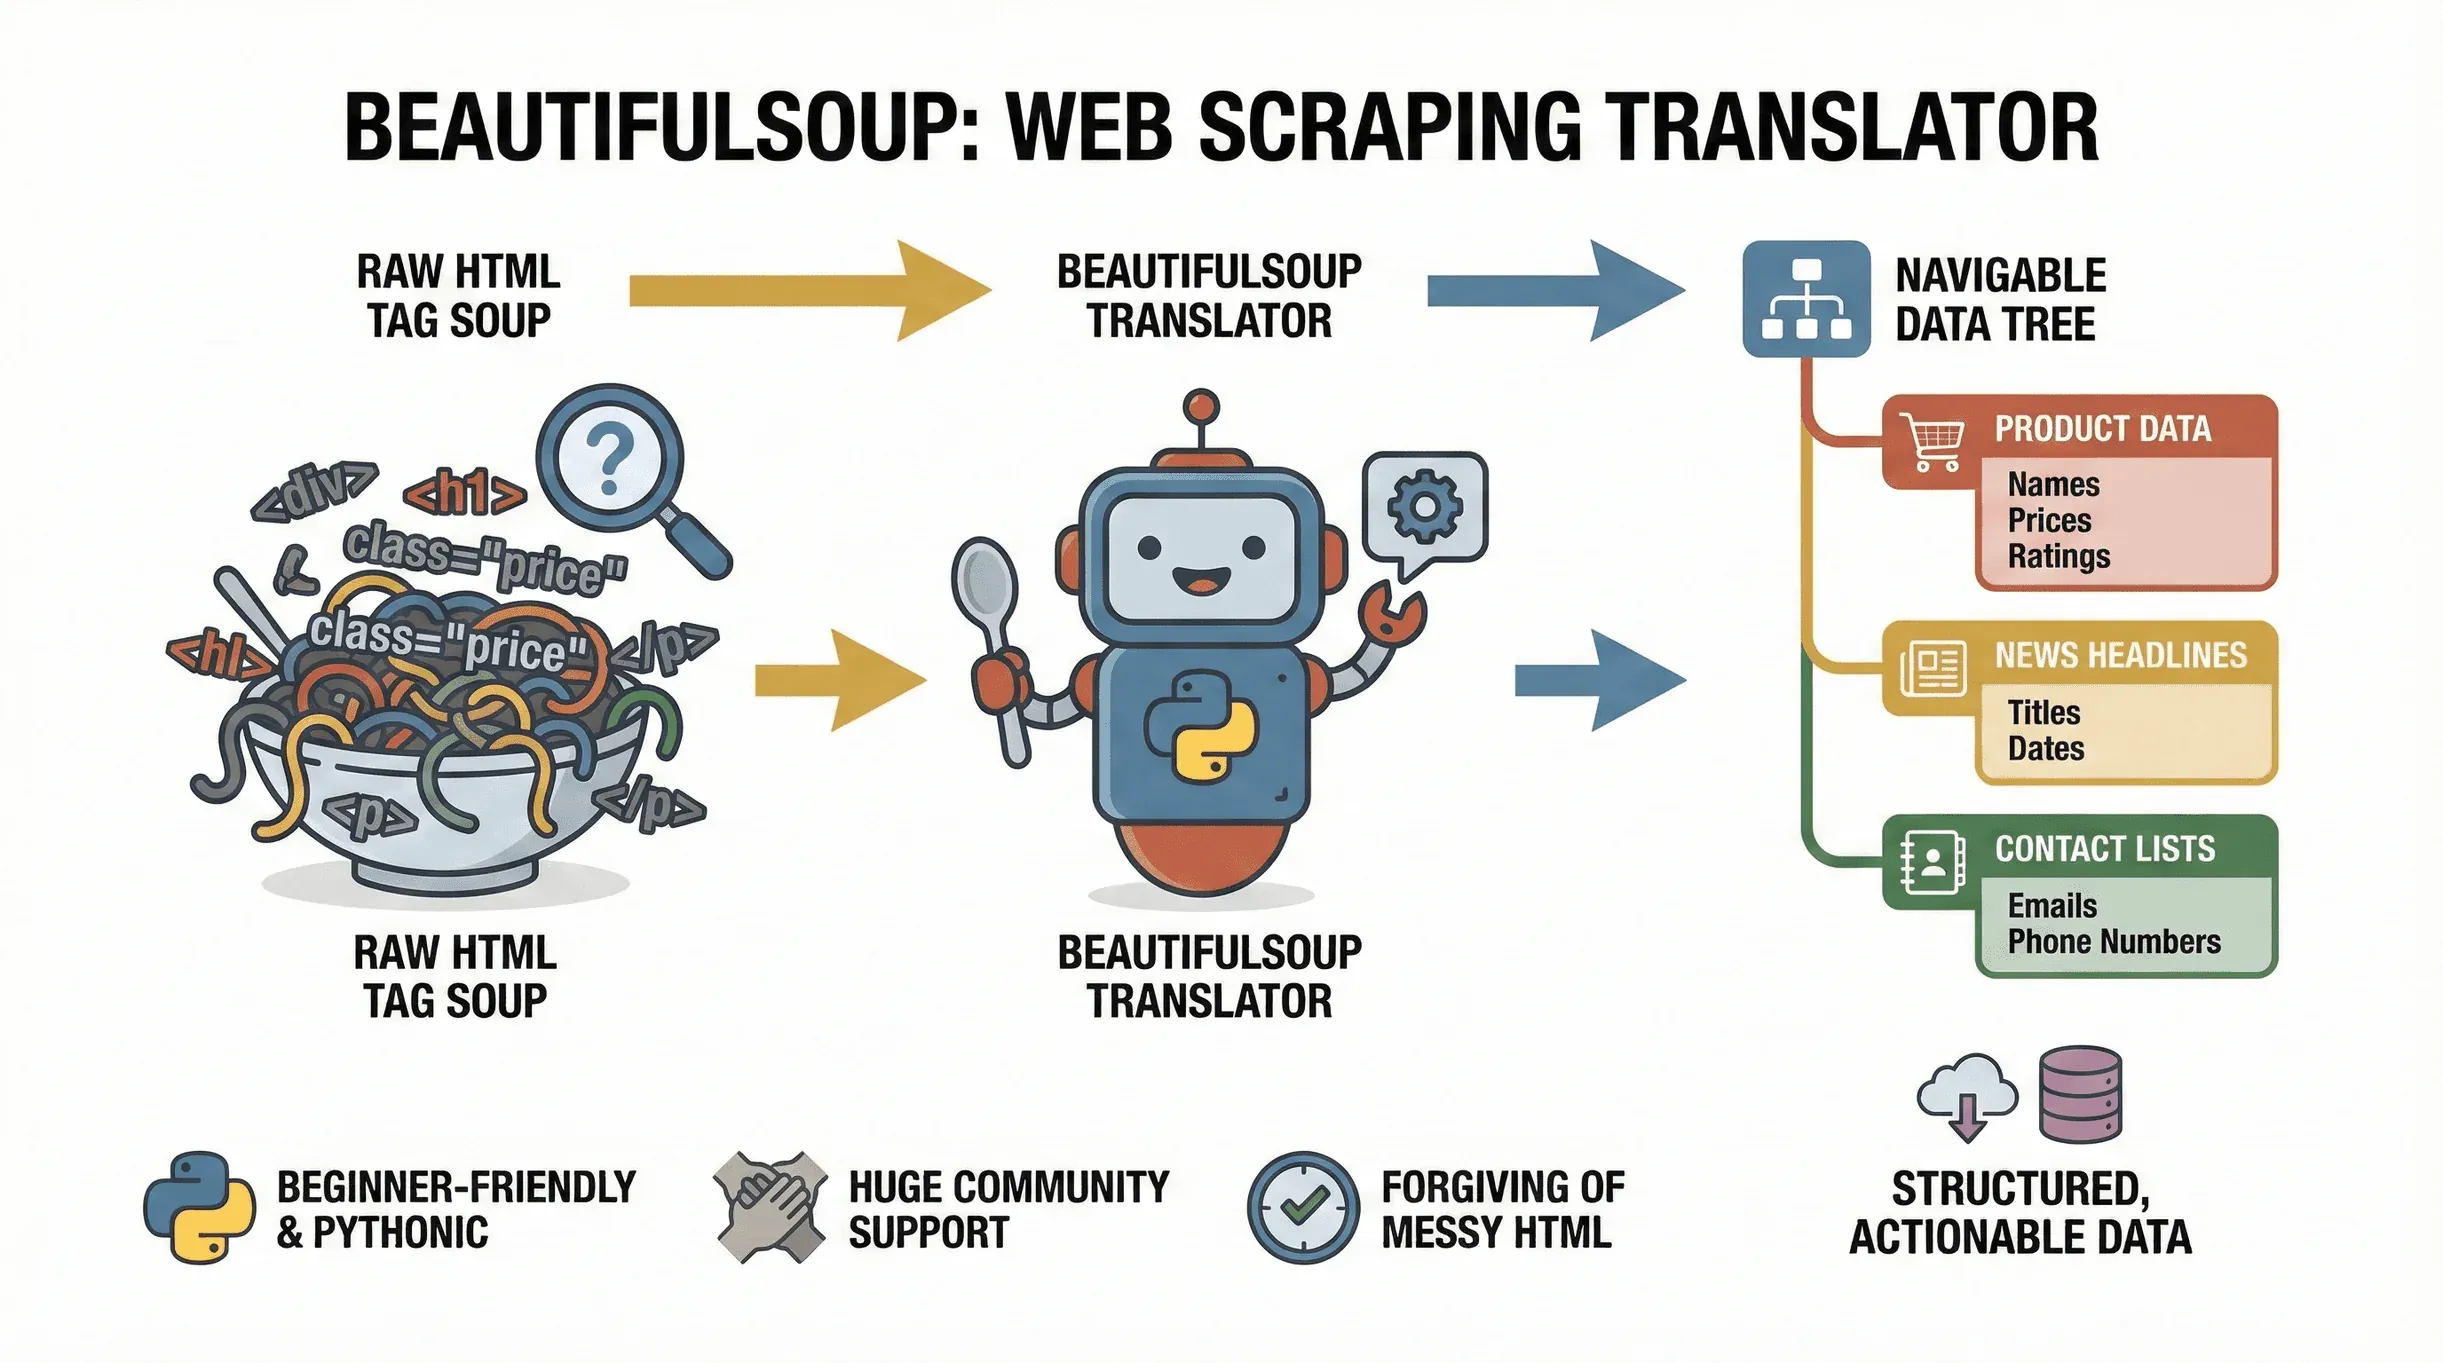 Mari mulai dari dasar. BeautifulSoup adalah library Python yang memudahkan parsing dokumen HTML dan XML. Anggap saja seperti penerjemah: ia mengubah “tag soup” dari halaman web menjadi pohon yang bisa dinavigasi, sehingga Anda dapat dengan mudah menemukan, mengekstrak, dan memodifikasi data yang dibutuhkan. Proyek ini masih aktif dipelihara —
beautifulsoup4 4.14.3 dirilis di PyPI pada akhir 2025 — jadi apa pun yang Anda pelajari di sini tetap relevan. Entah Anda ingin mengambil harga produk dari situs e-commerce, mengumpulkan judul berita, atau scraping direktori bisnis untuk mencari lead, BeautifulSoup adalah alat andalan untuk mengubah halaman web menjadi data terstruktur yang bisa ditindaklanjuti.
Mengapa begitu populer? Pertama, sangat ramah untuk pemula. BeautifulSoup cukup toleran terhadap HTML yang berantakan (dan jujur saja, web memang penuh dengan itu), dan sintaksnya yang mirip Python membuat Anda bisa mulai scraping hanya dengan beberapa baris kode. Selain itu, dukungannya sangat luas, dengan jutaan unduhan dan komunitas besar—jadi kalau Anda buntu, bantuan biasanya tinggal cari di Google.
Contoh penggunaan umum BeautifulSoup meliputi:
- Mengekstrak nama produk, harga, dan rating dari halaman e-commerce
- Mengambil judul berita, nama penulis, dan tanggal publikasi dari situs berita
- Parsing tabel atau direktori (misalnya daftar perusahaan atau kontak)
- Mengumpulkan email atau nomor telepon dari situs listing
- Memantau pembaruan (perubahan harga, lowongan baru, dan lain-lain)
Kalau data Anda ada di HTML statis, BeautifulSoup adalah sahabat terbaik Anda untuk web scraping.
Keunggulan Unik BeautifulSoup untuk Web Scraping
Ada banyak library web scraping Python di luar sana—jadi mengapa memilih BeautifulSoup? Berikut perbandingannya:
- Sederhana: BeautifulSoup ringan dan mudah dipelajari. Anda tidak perlu menyiapkan framework besar atau menulis banyak boilerplate code. Sangat cocok untuk tugas scraping cepat satu kali pakai atau untuk pemula yang baru mulai.
- Toleran: Mampu menangani HTML yang rusak atau tidak rapi, yang ternyata lebih sering terjadi daripada yang Anda kira.
- Fleksibel: Anda tidak dipaksa mengikuti arsitektur crawling yang kaku. Cukup masukkan HTML dan ambil data yang Anda butuhkan.
- Integrasi: BeautifulSoup cocok dipakai bersama library Python lain seperti
requests(untuk mengambil halaman web),csv(untuk menyimpan data), danpandas(untuk analisis data).
Bagaimana perbandingannya dengan alat lain?
| Alat | Paling Cocok Untuk | Kelebihan | Kekurangan |
|---|---|---|---|
| BeautifulSoup | Parsing HTML statis, pemula | Sederhana, setup cepat, toleran, fleksibel | Tidak cocok untuk situs yang berat JavaScript |
| Scrapy | Tugas skala besar, asinkron | Kuat, skalabel, crawling bawaan | Kurva belajar lebih curam, setup lebih banyak |
| Selenium | Konten JavaScript/dinamis | Bisa berinteraksi dengan JS, mengisi formulir, klik tombol | Lebih lambat, lebih berat, lebih boros sumber daya |
Kalau Anda baru mulai atau perlu cepat mem-parsing halaman statis, BeautifulSoup adalah “pisau Swiss Army” dunia web scraping (medium.com). Untuk situs yang lebih kompleks atau dinamis, Anda mungkin perlu menggabungkannya dengan Selenium atau Scrapy—tetapi BeautifulSoup adalah cara terbaik untuk belajar dasar-dasarnya.
Menyiapkan Lingkungan Python Anda untuk BeautifulSoup
Siap mulai? Begini cara menyiapkan lingkungan Anda:
-
Instal Python: Unduh versi terbaru dari python.org.
-
Siapkan virtual environment (opsional, tetapi disarankan):
python -m venv venv source venv/bin/activate # Di Windows: venv\Scripts\activate -
Instal BeautifulSoup dan dependensinya:
pip install beautifulsoup4 requests lxml html5libbeautifulsoup4: Library utamarequests: Untuk mengambil halaman weblxmlatauhtml5lib: Parser HTML yang lebih cepat/lebih andal
-
Tips troubleshooting:
- Jika muncul error “pip not found”, coba
pip3ataupy -m pip. - Di Mac/Linux, Anda mungkin perlu
sudountuk izin akses. - Jika Anda memakai Windows, pastikan Python sudah ditambahkan ke PATH.
- Jika muncul error “pip not found”, coba
Untuk memverifikasi setup Anda, jalankan tes singkat ini:
from bs4 import BeautifulSoup
import requests

html = requests.get("http://example.com").text
soup = BeautifulSoup(html, "html.parser")
print(soup.title)
Kalau Anda melihat <title>Example Domain</title>, berarti semuanya siap (Thunderbit Blog).
Contoh Python Beautiful Soup Langkah demi Langkah
Mari masuk ke contoh Python Beautiful Soup yang nyata. Bayangkan Anda ingin mengekstrak judul berita terbaru dari situs berita publik. Begini caranya:
1. Ambil Halaman Web
import requests
from bs4 import BeautifulSoup

url = "https://www.bbc.com/news"
response = requests.get(url)
html = response.text
2. Parse HTML
soup = BeautifulSoup(html, "html.parser")
3. Periksa Struktur HTML
Buka Developer Tools di browser Anda (klik kanan → Inspect) dan cari tag yang berisi judul berita. Di banyak situs berita, judul ada di tag <h3> dengan class tertentu.
Sebagai contoh, Anda mungkin melihat:
<h3 class="gs-c-promo-heading__title">Headline Title</h3>
4. Ekstrak Datanya
headlines = soup.find_all("h3", class_="gs-c-promo-heading__title")
for h in headlines:
    print(h.get_text(strip=True))
Ini akan mencetak semua judul berita di halaman.
5. Simpan Data ke CSV
Mari simpan judul-judul itu untuk analisis nanti:
import csv

with open("headlines.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["headline"])
    for h in headlines:
        writer.writerow([h.get_text(strip=True)])
Sekarang Anda punya file CSV yang siap dibuka di Excel atau Google Sheets.
Memahami Struktur HTML untuk Ekstraksi Data yang Efektif
Sebelum menulis kode apa pun, selalu periksa HTML halaman. Begini caranya:
- Buka Developer Tools: Klik kanan pada halaman lalu pilih “Inspect.”
- Temukan Datanya: Arahkan kursor ke elemen untuk melihat tag mana yang berisi info yang Anda cari (misalnya judul berita, harga, penulis).
- Catat Tag dan Class: Cari identifier unik seperti
class="product-title"atauid="main-content". - Uji Selector Anda: Gunakan metode BeautifulSoup
.find(),.find_all(), atau.select()untuk menargetkan elemen tersebut.
Tips pro: gunakan soup.prettify() untuk mencetak versi HTML yang lebih mudah dibaca di konsol Python Anda.
Mengekstrak dan Menstrukturkan Data dengan BeautifulSoup
Misalnya Anda ingin mengekstrak judul dan penulis dari halaman blog:
articles = soup.find_all("article")
data = []
for article in articles:
    title = article.find("h2").get_text(strip=True)
    author = article.find("span", class_="author").get_text(strip=True)
    data.append({"title": title, "author": author})
Sekarang Anda punya daftar dictionary—sangat cocok untuk diekspor ke CSV atau dianalisis lebih lanjut.
Anda juga bisa mengekstrak tautan, gambar, atau atribut apa pun seperti ini:
for link in soup.find_all("a"):
    print(link.get("href"))
Atau gambar:
for img in soup.find_all("img"):
    print(img.get("src"))
Menyimpan Data Hasil Ekstraksi: Dari Python ke Excel atau CSV
Setelah data Anda terstruktur, ekspornya mudah. Begini cara melakukannya dengan modul csv:
import csv

with open("articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
Atau, kalau Anda lebih suka pandas:
import pandas as pd

df = pd.DataFrame(data)
df.to_csv("articles.csv", index=False)
df.to_excel("articles.xlsx", index=False)
Selalu gunakan encoding UTF-8 untuk menghindari masalah karakter aneh, terutama pada data internasional.
Studi Kasus: Scraping Data Situs Berita dengan BeautifulSoup
Mari kita lihat contoh Python Beautiful Soup yang praktis: scraping judul artikel, penulis, dan tanggal publikasi dari situs berita.
Misalnya Anda ingin melakukan scrape data artikel dari CNN:
import requests
from bs4 import BeautifulSoup
import csv

url = "https://edition.cnn.com/world"
response = requests.get(url)
soup = BeautifulSoup(response.content, "html.parser")

articles = soup.find_all("article")
data = []

for article in articles:
    title_tag = article.find("h3")
    date_tag = article.find("span", class_="date")
    author_tag = article.find("span", class_="author")
    title = title_tag.get_text(strip=True) if title_tag else ""
    date = date_tag.get_text(strip=True) if date_tag else ""
    author = author_tag.get_text(strip=True) if author_tag else ""
    data.append({"title": title, "date": date, "author": author})

with open("cnn_articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "date", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
Script ini akan mengambil artikel terbaru, mengekstrak judul, tanggal, dan penulis, lalu menyimpannya ke CSV — dengan asumsi markup CNN saat ini masih cocok dengan tag di atas. Situs berita besar sering mengganti nama class dan struktur DOM, jadi periksa ulang halaman sebelum menjalankan ini untuk data produksi. Strukturnya (<article> sebagai kontainer, lalu find pada child tag) adalah pola yang tahan lama; nama class spesifik seperti "date" dan "author" hanyalah placeholder yang perlu Anda sesuaikan dengan isi halaman live saat ini.
Meningkatkan Alur Kerja Anda: Menggabungkan BeautifulSoup dengan Thunderbit
Sekarang mari bahas cara membuat alur kerja scraping Anda jauh lebih mulus. Thunderbit adalah Chrome Extension ai web scraper yang menghilangkan tebakan dalam ekstraksi data. Dengan Thunderbit, Anda bisa:
- Menggunakan “AI Suggest Fields”: Thunderbit membaca halaman dan secara otomatis menyarankan field data yang perlu diekstrak—tidak perlu lagi mencari-cari di HTML atau mengutak-atik selector.
- Scrape Subpage: Thunderbit dapat mengikuti tautan ke subpage (seperti halaman produk atau artikel individual) dan memperkaya dataset Anda dengan detail tambahan.
- Ekspor Seketika: Kirim data langsung ke Excel, Google Sheets, Airtable, atau Notion dengan satu klik.
- Menangani Pagination: Thunderbit dapat mengekstrak data di banyak halaman sekaligus (termasuk infinite scroll).
- Menjadwalkan Scrape: Atur tugas berulang agar data Anda selalu terbaru.
Berikut alur kerja hybrid yang saya suka:
- Mulai dengan Thunderbit: Buka situs target Anda, klik ikon Thunderbit, lalu biarkan “AI Suggest Fields” mengidentifikasi kolom yang tepat (seperti title, author, date).
- Ekspor Datanya: Unduh hasilnya sebagai CSV atau kirim ke Google Sheets.
- Gunakan BeautifulSoup untuk Pemrosesan Kustom: Jika Anda perlu analisis lebih mendalam (seperti pembersihan teks, deduplikasi, atau menggabungkan dengan sumber lain), muat CSV yang sudah diekspor ke Python dan gunakan BeautifulSoup atau pandas untuk post-processing.
Kombinasi ini memberi Anda yang terbaik dari dua dunia: kecepatan Thunderbit dan deteksi field berbasis AI, ditambah fleksibilitas BeautifulSoup untuk logika kustom.
Coba AI Web Scraper Thunderbit Gratis
Kecepatan dan Kualitas Data: Mengapa Memakai Thunderbit dan BeautifulSoup Bersama?
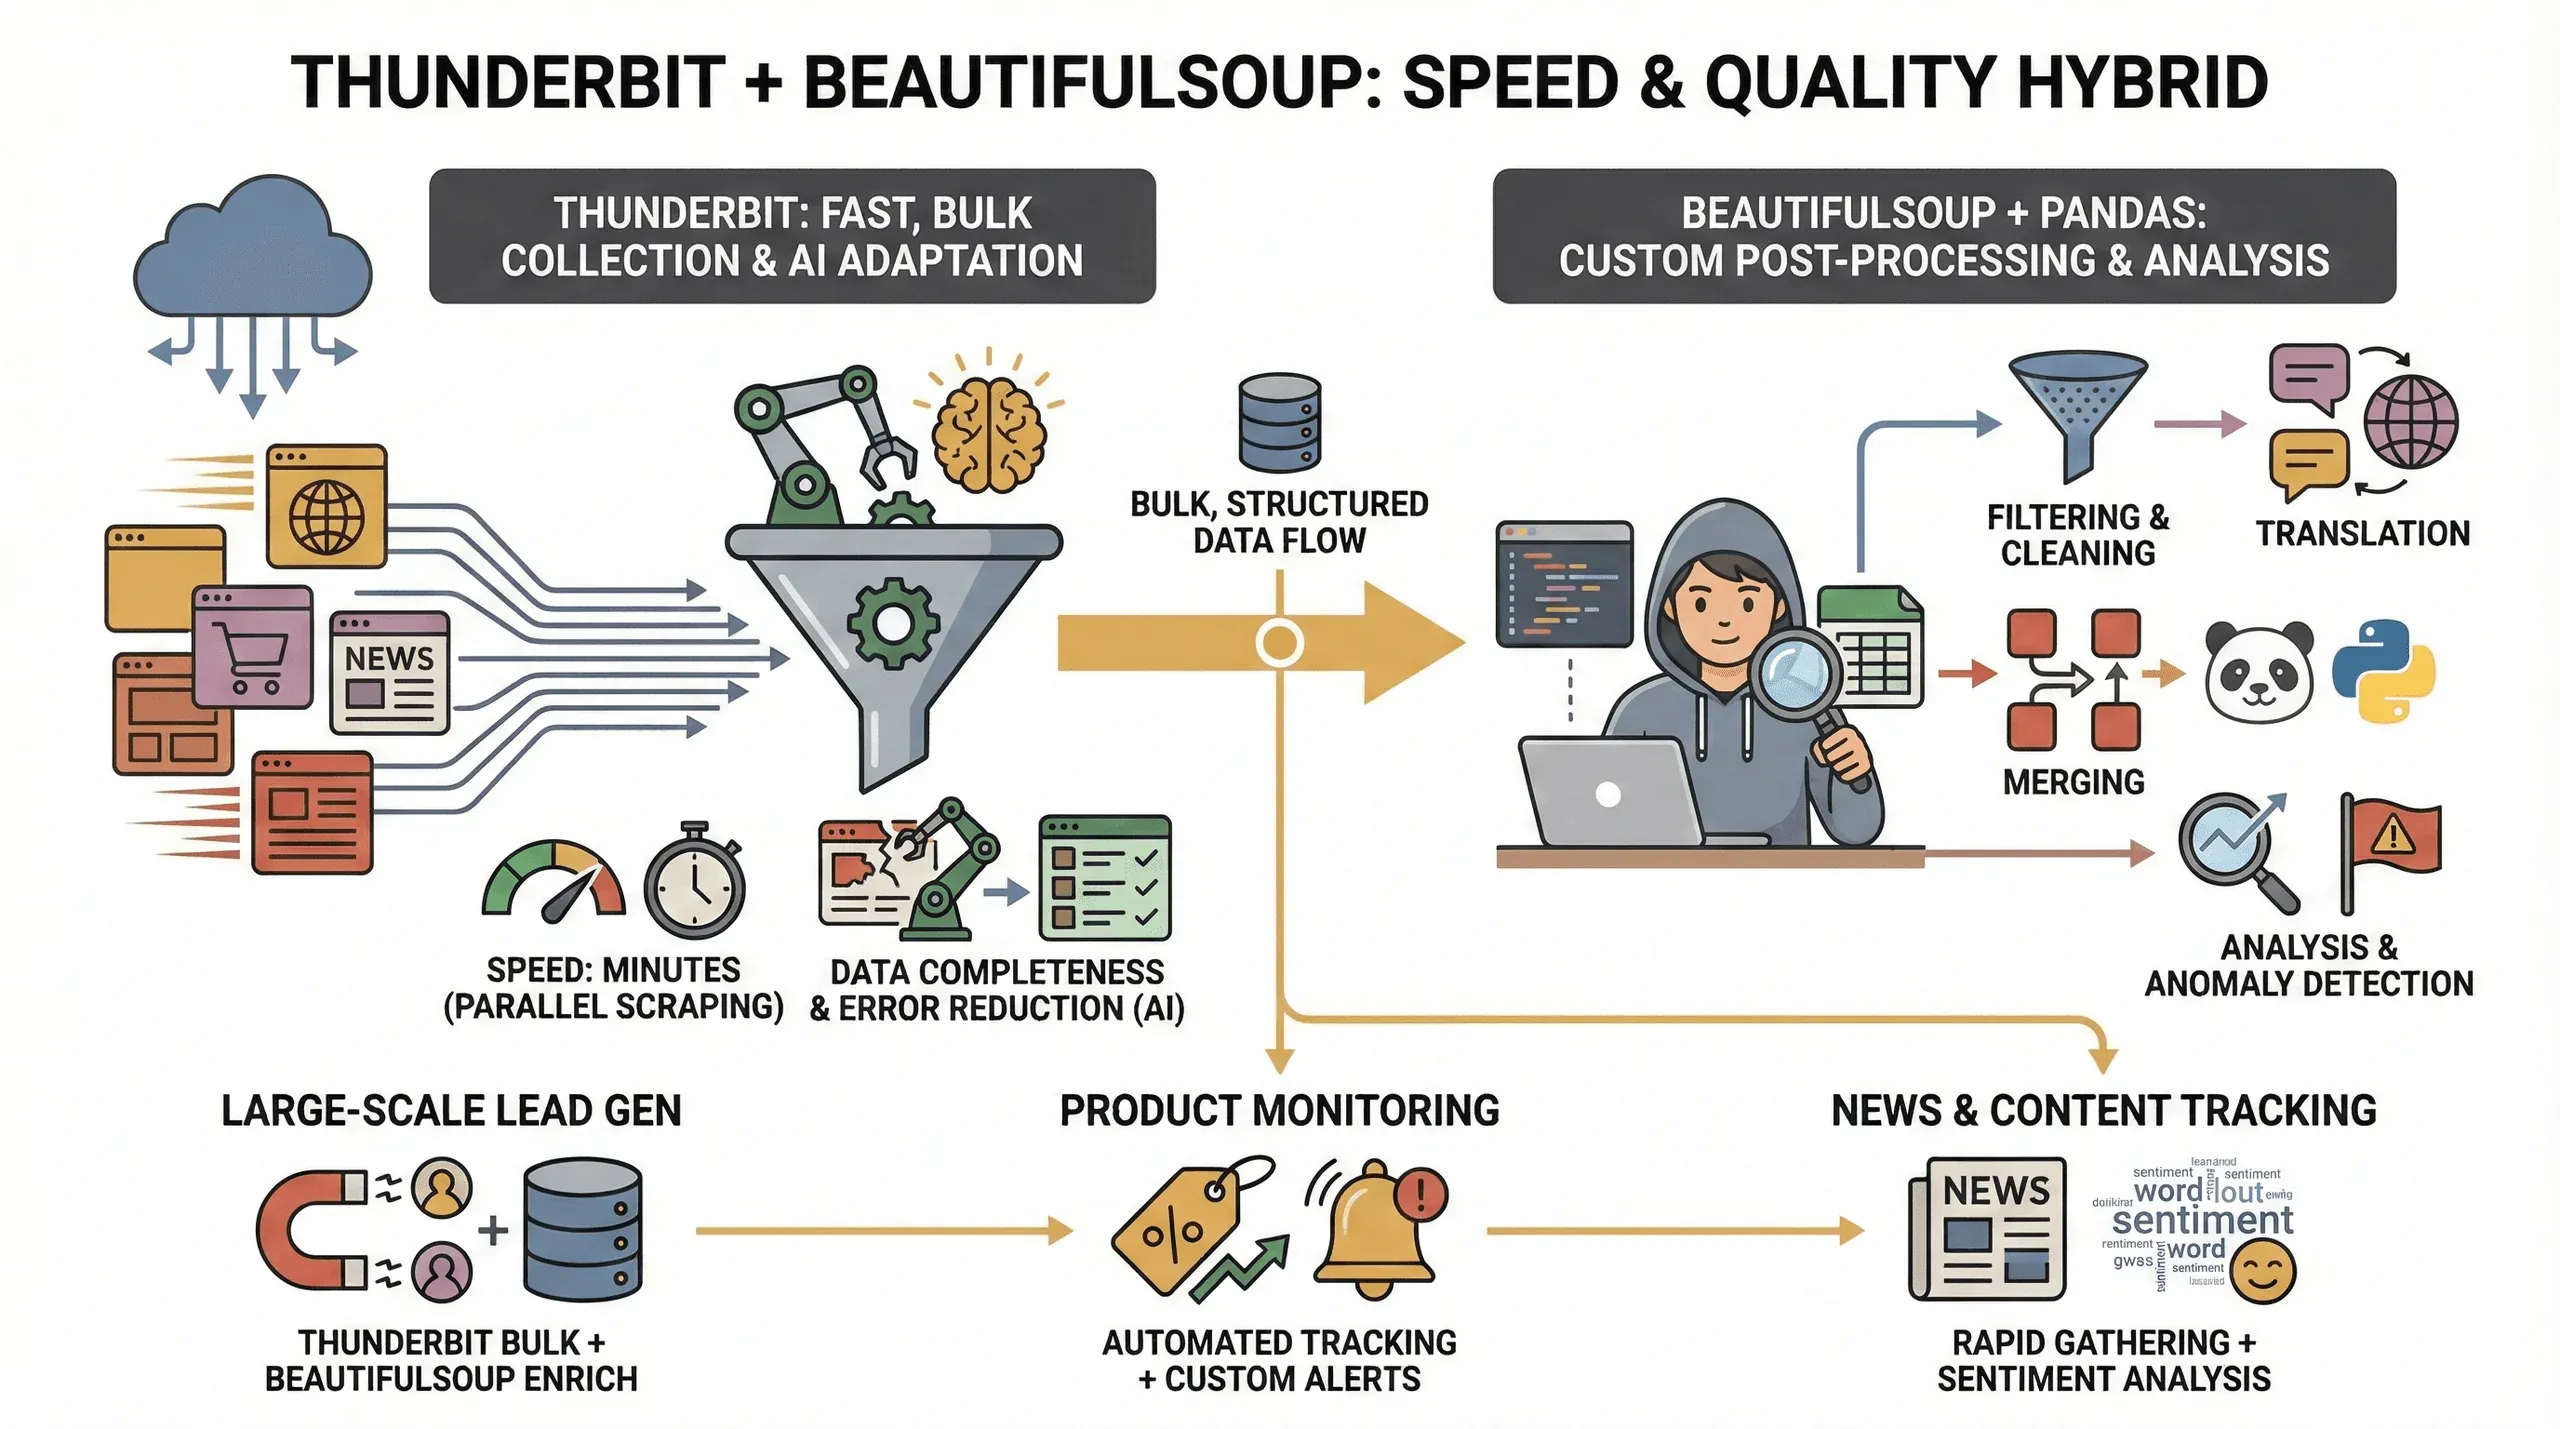 Kenapa repot memakai dua alat? Inilah yang saya temukan:
- Kecepatan: Thunderbit bisa mengekstrak puluhan halaman secara paralel (hingga 50 sekaligus di mode cloud), jadi data Anda didapat dalam hitungan menit, bukan jam.
- Kelengkapan Data: AI Thunderbit beradaptasi dengan perubahan layout dan bisa mengekstrak data terstruktur bahkan dari situs yang rumit, sehingga risiko field hilang jadi lebih kecil.
- Pengurangan Error: Tidak ada lagi script yang rusak saat nama class berubah—AI Thunderbit mengevaluasi ulang halaman setiap kali.
- Post-Processing Kustom: Untuk kebutuhan lanjutan (seperti filtering, penerjemahan, atau menggabungkan dataset), BeautifulSoup dan pandas memberi Anda kontrol penuh.
Pendekatan hybrid ini sangat berguna untuk:
- Lead generation skala besar: Gunakan Thunderbit untuk mengambil data mentah dalam jumlah besar, lalu BeautifulSoup untuk membersihkan dan memperkayanya.
- Pemantauan produk: Thunderbit menangani scraping yang repetitif, sementara BeautifulSoup membantu Anda menganalisis tren atau menandai anomali.
- Pelacakan berita dan konten: Kumpulkan artikel dengan cepat memakai Thunderbit, lalu gunakan Python untuk analisis sentimen atau ekstraksi kata kunci.
Memecahkan Masalah Umum dalam Web Scraping dengan BeautifulSoup
Coba Thunderbit Chrome Extension Ekstrak data dari situs web apa pun dengan AI dalam 2 klik. Get Started Free
Web scraping tidak selalu mulus—berikut beberapa kendala umum dan cara mengatasinya:
- Konten Dinamis: Jika situs memuat data dengan JavaScript (infinite scroll, AJAX), BeautifulSoup saja tidak akan melihatnya. Gunakan Selenium atau mode browser Thunderbit untuk kasus seperti ini.
- Langkah Anti-Bot: Beberapa situs memblokir request otomatis. Coba tambahkan header User-Agent khusus, beri jeda antar request, atau gunakan cloud scraping Thunderbit untuk melewati blok sederhana.
- Perubahan Struktur HTML: Jika script Anda tiba-tiba rusak, kemungkinan HTML situsnya berubah. Periksa lagi halaman dan perbarui selector Anda. AI Thunderbit bisa membantu dengan beradaptasi secara otomatis.
- Data Hilang: Selalu cek apakah elemen ada sebelum memanggil
.get_text(). Gunakan.get()daripada[]untuk atribut agar terhindar dari KeyError. - Masalah Encoding: Simpan file dengan encoding UTF-8 untuk menangani karakter khusus.
Dan selalu, selalu hormati robots.txt dan syarat layanan situs. Lakukan scraping secara bertanggung jawab—tidak ada yang suka robot yang kurang sopan.
Kesimpulan & Poin Penting
Web scraping dengan BeautifulSoup adalah salah satu keterampilan paling praktis yang bisa Anda pelajari di dunia yang digerakkan data seperti sekarang. Berikut yang sudah kita bahas dalam tutorial web scraping BeautifulSoup ini:
- BeautifulSoup adalah titik awal ideal untuk parsing HTML statis dan mengekstrak data terstruktur dengan Python.
- Setup sangat mudah—cukup instal Python, pip, dan beberapa library.
- Memeriksa HTML sangat penting untuk menargetkan data yang tepat.
- Ekspor ke CSV/Excel membuat data langsung siap dipakai untuk analisis bisnis.
- Menggabungkannya dengan Thunderbit memberi Anda deteksi field berbasis AI, scraping lebih cepat, dan ekspor lebih mudah—sempurna untuk pengguna bisnis dan non-coder.
- Workflow hybrid (Thunderbit untuk ekstraksi massal, BeautifulSoup untuk pemrosesan kustom) memberikan kecepatan, kualitas data, dan fleksibilitas terbaik.
Kalau Anda siap meningkatkan kemampuan web scraping Anda, coba kedua alat ini: bereksperimenlah dengan script BeautifulSoup sederhana, lalu lihat seberapa jauh lebih cepat Anda bisa bekerja dengan ai web scraper Thunderbit. Dan untuk panduan praktis lainnya, kunjungi Thunderbit Blog.
Selamat scraping—semoga data Anda selalu bersih, terstruktur, dan siap digunakan.
Coba ai web scraper Thunderbit Get Started Free
FAQ
1. Apa itu BeautifulSoup dan untuk apa digunakan?
BeautifulSoup adalah library Python untuk parsing dokumen HTML dan XML. Alat ini membantu Anda mengekstrak data dari halaman web dan mengubahnya menjadi format terstruktur seperti daftar atau tabel, sehingga ideal untuk proyek web scraping.
2. Bagaimana perbandingan BeautifulSoup dengan Selenium dan Scrapy?
BeautifulSoup ringan dan mudah digunakan untuk halaman HTML statis. Selenium lebih cocok untuk scraping situs dinamis yang berat JavaScript, sedangkan Scrapy adalah framework lengkap untuk scraping skala besar secara asinkron. BeautifulSoup adalah pilihan terbaik untuk pemula dan tugas cepat.
3. Bisakah saya memakai BeautifulSoup dan Thunderbit bersama?
Tentu saja. Thunderbit dapat dengan cepat mengidentifikasi dan mengekstrak field dari halaman web menggunakan AI, lalu Anda bisa memakai BeautifulSoup untuk post-processing kustom atau analisis data yang lebih mendalam.
4. Apa tantangan umum dalam web scraping dengan BeautifulSoup?
Masalah umum meliputi menangani konten dinamis, menghadapi langkah anti-bot, dan menyesuaikan diri dengan perubahan struktur HTML. Fitur AI Thunderbit atau mode browser-nya bisa membantu mengatasi banyak tantangan ini.
5. Bagaimana cara mengekspor data hasil scraping BeautifulSoup ke Excel atau CSV?
Anda bisa menggunakan modul bawaan Python csv atau library pandas untuk menulis data hasil ekstraksi ke file CSV atau Excel. Selalu gunakan encoding UTF-8 untuk menangani karakter khusus dan memastikan kompatibilitas dengan alat spreadsheet.
Siap mencobanya sendiri? Unduh Thunderbit Chrome Extension dan mulai scraping dengan lebih cerdas hari ini. Untuk tutorial dan tips lainnya, kunjungi Thunderbit Blog.
Pelajari Lebih Lanjut




