
Web sekarang sudah berubah jadi medan yang liar dan terus bergeser—ibaratnya bukan lagi “perpustakaan digital,” melainkan “hutan data.” Di 2026, kalau kamu mau mengekstrak data dari situs modern, tantangannya bukan cuma JavaScript, tapi juga benteng pertahanan. Saya sudah lihat sendiri bagaimana tools scraping tradisional kewalahan menghadapi konten dinamis, infinite scroll, dan lapisan anti-bot. Karena itu, naiknya python headless browser bukan sekadar tren—ini benar-benar revolusi buat siapa pun yang butuh ekstraksi data web yang andal dan bisa diskalakan.
Dan ini bukan cuma urusan para teknisi. Per 2025, 73% perusahaan mengandalkan ekstraksi data web otomatis untuk business intelligence, dan lebih dari 94% website kini bergantung pada rendering JavaScript di sisi klien. Entah kamu kerja di sales, ecommerce, atau operasional, python headless browser yang tepat bisa jadi pembeda antara “data ada di tangan” dan “data susah dijangkau.” Jadi, mari langsung ke inti—saya sudah mencoba, membandingkan, dan memakai tool-tool ini, dan di sini saya akan mengulas 10 python headless browser terbaik untuk scraping modern (dengan sorotan khusus pada bagaimana AI mengubah permainan buat non-coder).
Mengapa Python Headless Browser Sangat Penting untuk Scraping Modern?
Ekstrak data dari situs mana pun dengan AI Get Started Free
Mari kita sederhanakan: python headless browser adalah browser web yang kamu kendalikan lewat kode Python, tetapi tanpa jendela browser yang tampil di layar. Ia bisa membuka halaman, menjalankan JavaScript, mengklik tombol, mengisi formulir—semuanya jalan diam-diam di belakang layar. Bayangkan seperti browser hantu yang kerja terus tanpa henti sementara kamu santai minum kopi.
Kenapa ini penting? Karena website modern dibuat untuk pengguna, bukan bot. Data sering disembunyikan di balik JavaScript, butuh login, dan mengharuskan kamu berinteraksi seperti manusia. Scraper tradisional yang cuma mengambil HTML sering kali cuma dapat “kerangka kosong.” Headless browser, sebaliknya, meniru perilaku pengguna nyata—menunggu AJAX selesai, menggulir infinite feed, dan mengambil konten persis seperti yang kamu lihat di Chrome atau Firefox (LiveProxies).
Tapi manfaatnya tidak berhenti di situ:
- Kecepatan & Efisiensi: Headless browser melewati rendering visual, jadi lebih cepat dan lebih hemat memori—cocok untuk scraping skala besar (LiveProxies).
- Dukungan Konten Dinamis: Mereka mengeksekusi JavaScript, jadi kamu dapat data hasil render yang sebenarnya, bukan sekadar HTML mentah.
- Kemampuan Otomatisasi: Perlu login, pindah halaman, atau menangani pop-up? Python headless browser bisa mengotomatisasi semuanya.
- Skalabilitas: Jalankan ratusan instance di cloud, scrape ribuan halaman secara paralel, dan tetap tenang.
Buat pengguna bisnis, ini artinya kamu akhirnya bisa mengumpulkan leads, memantau kompetitor, atau melacak harga—meskipun websitenya terasa seperti Fort Knox. Dan dengan tool terbaru berbasis AI, kamu bahkan nggak perlu jadi coder untuk ikut memanfaatkannya.
Cara Kami Memilih Python Headless Browser Terbaik
Saya tidak asal lempar dart ke daftar nama browser. Ini kriteria yang saya pakai:
- Performa & Kecepatan: Apakah tool ini bisa menangani situs modern yang berat JavaScript dengan cepat dan konsisten?
- Dukungan Browser: Apakah bisa dipakai dengan Chrome, Firefox, WebKit, atau bahkan engine lawas seperti IE?
- Kemudahan Penggunaan: Ramah buat non-coder, atau justru terasa seperti butuh gelar doktor Python?
- Fitur AI & No-Code: Apakah pengguna bisnis bisa memanfaatkan AI untuk otomatisasi scraping tanpa menulis skrip?
- Komunitas & Dukungan: Apakah komunitasnya aktif, dokumentasinya bagus, dan pengembangannya terus jalan?
- Fitur Unik: Apakah ada keunggulan khusus—seperti template instan, cloud scraping, atau navigasi subpage?
Saya sering lihat tim buang waktu berminggu-minggu buat setup, lalu mentok begitu layout situs berubah. Tool terbaik bukan cuma yang bisa jalan—tetapi yang bisa beradaptasi, skalabel, dan bikin kerja kamu jauh lebih ringan.
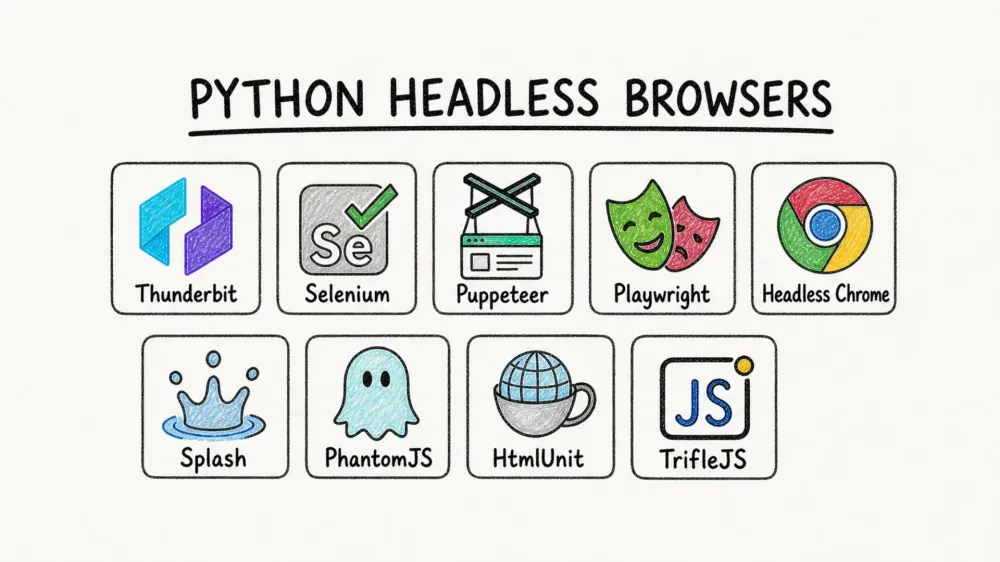
10 Python Headless Browser Terbaik untuk Scraping Modern
Berikut daftar pilihan utama saya, lengkap dengan ulasan mendalam tentang apa yang membuat tiap tool unggul—atau justru tersandung.
1. Thunderbit
 Thunderbit adalah python headless browser yang dulu sangat ingin saya punya bertahun-tahun lalu. Ini bukan sekadar alat otomasi browser—melainkan ekstensi Chrome AI web scraper yang dibuat untuk pengguna bisnis yang ingin hasil, bukan ribet.
Kenapa Thunderbit menonjol:
- AI Field Setup: Cukup buka ekstensi—sekali klik—dan AI Thunderbit akan membaca layout, memilih field, lalu menjalankan scraping buat kamu (Thunderbit Docs).
- Template Data Instan: Untuk situs populer (Amazon, Zillow, LinkedIn, dll.), kamu bisa langsung pakai template sekali klik—tanpa setup.
- Scraping Subpage & Pagination: Thunderbit bisa mengklik subpage, menangani infinite scroll, dan menggabungkan semua data ke satu tabel.
- Prompt Bahasa Natural: Jelaskan kebutuhanmu dengan bahasa biasa; AI Thunderbit akan mengurus sisanya.
- Scraping via Cloud atau Browser: Jalankan scraping secara lokal atau di cloud (hingga 50 halaman sekaligus untuk kecepatan).
- Tanpa Koding: Serius—kalau kamu bisa pakai browser, kamu bisa pakai Thunderbit.
- Ekspor Data Gratis: Ekspor ke Excel, Google Sheets, Notion, atau Airtable hanya dengan sekali klik.
Saya sudah lihat Thunderbit menghemat banyak jam kerja tim sales dan operasional—untuk scraping leads, memantau harga, atau menggabungkan data produk tanpa perlu menyentuh kode sama sekali. Tool ini dipercaya oleh lebih dari 200.000 pengguna di seluruh dunia, dan respons yang paling sering muncul selalu sama: “Nggak nyangka semudah ini.”
Cocok untuk: Pengguna non-teknis, tim bisnis, siapa pun yang ingin AI menangani pekerjaan berat.
Coba Thunderbit AI Web Scraper Gratis
2. Selenium
 Selenium adalah pelopor klasik dalam otomasi browser. Kalau kamu pernah cari “python headless browser” di Google, kemungkinan besar kamu bakal ketemu Selenium WebDriver.
Kelebihan:
- Mendukung Semua Browser Utama: Chrome, Firefox, Safari, Edge, bahkan Internet Explorer (kalau kamu berani).
- Komunitas Sangat Besar: Tutorial, plugin, dan jawaban Stack Overflow melimpah.
- Sangat Fleksibel: Bisa mengotomatisasi hampir semua yang bisa dilakukan pengguna—klik, formulir, navigasi.
Kekurangan:
- Setup Bisa Rumit: Kamu harus mengatur browser driver dan menjaga versinya tetap sinkron.
- Lebih Lambat dari Tool Modern: Protokol WebDriver menambah overhead, dan skalanya kurang nyaman untuk ratusan browser.
- API Cukup Verbose: Kode yang ditulis biasanya lebih panjang dibanding Playwright atau Puppeteer.
Cocok untuk: Tim yang sudah punya pengalaman Selenium, pengujian lintas browser, atau workflow otomasi legacy.
3. Puppeteer
 Puppeteer adalah library otomasi tingkat tinggi dari Google untuk Chrome/Chromium. Walau aslinya berbasis Node.js, pengguna Python tetap bisa memakainya lewat Pyppeteer.
Kelebihan:
- Dirancang Khusus untuk Chrome: Cepat, efisien, dan terintegrasi erat dengan Chrome DevTools.
- API Async: Cocok untuk situs modern yang berat JavaScript.
- Fitur Kaya: Screenshot, ekspor PDF, interception jaringan.
Kekurangan:
- Hanya untuk Chromium: Tidak mendukung Firefox atau Safari.
- Native di Node.js: Pengguna Python harus memakai Pyppeteer (yang sekarang sudah tidak lagi dipelihara—lihat di bawah).
Cocok untuk: Developer yang ingin otomasi Chrome yang cepat dan andal tanpa perlu dukungan lintas browser.
4. Playwright
 Playwright adalah pendatang baru yang dibangun Microsoft—dan cepat banget jadi pilihan utama saya untuk scraping tingkat lanjut.
Kelebihan:
- Dukungan Multi-Browser: Otomatisasi Chromium, Firefox, dan WebKit dengan satu API.
- Auto-Waiting: Tidak perlu menebak kapan halaman siap—Playwright menunggu otomatis.
- Concurrency: Jalankan banyak browser context secara paralel untuk kecepatan tinggi.
- Python-First: Binding Python-nya native, tersedia versi async dan sync.
Kekurangan:
- Ukuran Instalasi Lebih Besar: Karena membundel beberapa browser, setup terasa lebih berat.
- Tetap Butuh Koding: Tidak semudah Thunderbit untuk pengguna non-teknis.
Cocok untuk: Developer yang butuh otomasi modern yang tangguh—terutama untuk web app yang kompleks dan dinamis.
5. Headless Chrome
 Headless Chrome adalah mesin yang menggerakkan banyak tool di atas. Kamu bisa mengendalikannya langsung lewat Chrome DevTools Protocol (CDP) untuk fleksibilitas maksimum.
Kelebihan:
- Dukungan Web Terdepan: Kalau berjalan di Chrome, kemungkinan besar juga berjalan di headless Chrome.
- Kontrol Sangat Detail: Kamu bisa mengakses hampir setiap sudut browser.
Kekurangan:
- Kurva Belajar Tinggi: Kamu perlu memahami CDP atau memakai library pembungkus.
- Hanya Chrome: Tidak ada dukungan lintas browser.
Cocok untuk: Para ahli yang membangun pipeline otomasi kustom atau ingin integrasi Chrome di level rendah.
6. Pyppeteer
 Pyppeteer adalah port Python tidak resmi dari Puppeteer. Tool ini membawa otomasi Chrome async ke Python, tetapi… ada catatannya.
Kelebihan:
- API Bergaya Puppeteer: Kalau kamu sudah akrab dengan Puppeteer, kamu bakal cepat adaptasi.
- Otomasi Chrome yang Cepat: Bagus untuk situs dinamis.
Kekurangan:
- Tidak Lagi Dipelihara: Proyek aslinya sudah tidak diperbarui (para pengembang menyarankan pindah ke Playwright).
- Hanya Chromium: Tidak mendukung Firefox atau Safari.
Cocok untuk: Proyek legacy yang sudah memakai Pyppeteer. Untuk proyek baru, pakai Playwright.
7. Splash
 Splash adalah headless browser ringan dan bisa diprogram, dengan HTTP API, buatan tim Scrapinghub (sekarang Zyte).
Kelebihan:
- Ringan: Menggunakan QtWebKit, jadi konsumsi resource lebih kecil dibanding Chrome.
- HTTP API: Bisa dikendalikan dari bahasa apa pun, bukan Python saja.
- Cocok untuk Scrapy: Terintegrasi mulus dengan spider Scrapy untuk rendering JS.
Kekurangan:
- Engine WebKit Lama: Bisa kesulitan menghadapi JavaScript mutakhir.
- Butuh Lua untuk Scripting: Untuk interaksi lanjutan, kamu perlu mempelajari Lua.
Cocok untuk: Pengguna Scrapy yang kadang butuh rendering JS, atau tugas server-side rendering yang ringan.
8. PhantomJS
 PhantomJS adalah headless browser scriptable pertama yang populer, dibangun di atas WebKit. Ia sempat jadi pionir—tetapi sekarang sudah sangat usang.
Kelebihan:
- Scripting Sederhana: Mudah diotomatisasi dengan JavaScript.
- Dukungan Legacy: Masih bisa dipakai untuk situs lama yang statis.
Kekurangan:
- Tidak Dipelihara: Tidak ada pembaruan sejak 2016.
- Engine Ketinggalan Zaman: Tidak mampu menangani situs modern yang berat JS.
- Risiko Keamanan: Tidak ada patch terbaru.
Cocok untuk: Memelihara skrip lama. Untuk proyek baru, migrasikan ke Playwright atau Puppeteer.
9. HtmlUnit
 HtmlUnit adalah headless browser berbasis Java yang meniru perilaku browser. Tool ini cepat dan ringan, tetapi bukan engine browser sungguhan.
Kelebihan:
- Murni Java: Cocok untuk lingkungan yang banyak memakai Java.
- Cepat untuk Halaman Statis: Tidak perlu menjalankan browser penuh.
Kekurangan:
- Dukungan JS Terbatas: Kesulitan menghadapi situs modern yang dinamis.
- Bukan Native Python: Perlu lapisan integrasi, misalnya HtmlUnitDriver dari Selenium.
Cocok untuk: Workflow berbasis Java, pengujian aplikasi lama, atau scraping halaman sederhana yang di-render server.
10. TrifleJS
 TrifleJS adalah headless browser untuk Internet Explorer (IE), yang ditujukan untuk mengotomatisasi web app legacy di Windows.
Kelebihan:
- Otomasi IE: Menangani aplikasi intranet lama atau sistem yang hanya berjalan di IE.
- API Mirip PhantomJS: Perubahan untuk skrip PhantomJS biasanya minimal.
Kekurangan:
- Hanya Windows: Tidak mendukung lintas platform.
- Usang: IE sudah pensiun; TrifleJS sangat niche dan jarang dipelihara.
Cocok untuk: Workflow legacy khusus yang masih membutuhkan otomasi IE.
Tabel Perbandingan Fitur: Python Headless Browser Sekilas
| Tool | Dukungan Browser | Performa & Skala | Kemudahan Pakai | Fitur AI/No-Code | Komunitas & Dukungan | Paling Cocok Untuk |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (Extension/Cloud) | Tinggi (paralel di cloud) | Paling mudah—tanpa kode | Ya (AI, template) | Tumbuh, aktif | Non-coder, sales/ops, ekstraksi data cepat |
| Selenium | Semua browser utama | Menengah | Menengah (setup) | Tidak | Sangat besar, matang | Lintas browser, legacy, otomasi testing |
| Puppeteer | Chromium/Chrome | Sangat tinggi | Tinggi (developer) | Tidak | Besar (Node.js) | Chrome-only, developer, otomasi cepat |
| Playwright | Chromium, Firefox, WebKit | Sangat tinggi (multi-context) | Tinggi (developer) | Tidak | Bertumbuh cepat | Advanced, multi-browser, scraping modern |
| Headless Chrome | Chrome/Edge | Sangat tinggi | Rendah (CDP manual) | Tidak | N/A (fondasi) | Kustom, ahli, kontrol level rendah |
| Pyppeteer | Chromium/Chrome | Tinggi | Menengah (async) | Tidak | Kecil, tidak dipelihara | Skrip Pyppeteer lama |
| Splash | QtWebKit | Menengah | Menengah (API/Lua) | Tidak | Niche (Scrapy/Zyte) | Pengguna Scrapy, rendering JS ringan |
| PhantomJS | WebKit (lama) | Rendah (kini usang) | Menengah (JS) | Tidak | Tidak aktif | Legacy saja |
| HtmlUnit | Simulasi (Java) | Menengah/Tinggi (statis) | Rendah (Java) | Tidak | Kecil, berpusat pada Java | Workflow Java, halaman sederhana/statis |
| TrifleJS | Internet Explorer (Trident) | Rendah/Menengah | Menengah (JS, Win) | Tidak | Sangat kecil, legacy | Otomasi legacy khusus IE |
Cara Memilih Python Headless Browser yang Tepat untuk Bisnis Anda
Apa Itu Data Scraping dan Cara Melakukannya di 2025 Get Started Free
Ini panduan cepat saya untuk memilih tool yang tepat:
- Butuh scraping cepat, tanpa kode, dan dibantu AI? Pilih Thunderbit. Ini cara paling gampang buat non-coder untuk dapat data yang andal—terutama untuk tim sales, ecommerce, atau riset.
- Ingin kontrol maksimal dan dukungan lintas browser? Playwright adalah pilihan terbaik. Tangguh, modern, dan dibuat untuk skala besar.
- Sudah terlanjur investasi di Selenium? Tetap gunakan Selenium—tool ini masih jadi andalan untuk workflow legacy dan multi-browser.
- Membangun otomasi Chrome-only sebagai developer? Puppeteer (atau Playwright) cepat dan sangat powerful.
- Scraping halaman sederhana dan statis di lingkungan Java? HtmlUnit ringan dan mudah diintegrasikan.
- Masih memelihara skrip legacy atau aplikasi khusus IE? PhantomJS dan TrifleJS bisa jadi pilihan terakhir.
Dan ingat: tool terbaik adalah yang paling cocok dengan workflow kamu, kemampuan tim, dan kebutuhan bisnis kamu. Kadang, kombinasi beberapa tool justru paling masuk akal—Thunderbit untuk kerja cepat, Playwright untuk beban berat, dan Selenium untuk sistem legacy.
FAQ
1. Apa itu python headless browser, dan kenapa saya membutuhkannya untuk scraping?
Python headless browser adalah browser web yang dikendalikan dengan kode Python, tetapi berjalan tanpa tampilan visual (tanpa GUI). Ini penting untuk scraping situs modern yang berat JavaScript karena ia bisa menjalankan skrip, menangani interaksi pengguna, dan mengekstrak konten yang sudah ter-render penuh—sesuatu yang tidak bisa dilakukan scraper HTML tradisional.
2. Python headless browser mana yang paling cocok untuk pengguna non-teknis?
Thunderbit adalah pilihan terbaik untuk non-coder. Tool ini memakai AI untuk mengotomatiskan setup, menyediakan template instan, dan memungkinkan kamu mengekstrak data hanya dengan sekali klik atau dengan memberi instruksi singkat ke AI—tanpa perlu coding.
3. Apa perbedaan Playwright dan Puppeteer untuk pengguna Python?
Playwright mendukung banyak browser (Chromium, Firefox, WebKit) dan punya binding Python yang kuat, sehingga ideal untuk otomasi tingkat lanjut. Puppeteer hanya untuk Chrome dan native di Node.js, tetapi pengguna Python bisa memakai Pyppeteer (meski sekarang sudah tidak dipelihara). Untuk proyek Python baru, Playwright lebih direkomendasikan.
4. Apakah Selenium masih relevan untuk web scraping modern?
Ya—Selenium masih banyak dipakai, terutama untuk pengujian lintas browser dan otomasi legacy. Namun, setup-nya lebih lambat dan lebih kompleks dibanding tool baru seperti Playwright atau Thunderbit, serta kurang efisien untuk scraping dalam skala besar.
5. Kapan saya harus memakai tool legacy seperti PhantomJS, HtmlUnit, atau TrifleJS?
Hanya untuk memelihara atau memigrasikan workflow lama. PhantomJS dan TrifleJS sudah usang, sedangkan HtmlUnit paling cocok untuk lingkungan berbasis Java dengan halaman sederhana. Untuk proyek baru, tetap pakai tool modern yang masih aktif dipelihara.
Kalau kamu sudah siap melihat seperti apa scraping modern berbasis AI, coba Thunderbit sekarang. Dan untuk pembahasan lebih dalam tentang otomasi web, kunjungi Thunderbit Blog. Selamat scraping—semoga data kamu selalu segar dan browser kamu selamanya headless.
Coba Thunderbit AI Web Scraper Hari Ini Get Started Free
Pelajari Lebih Lanjut



