
Minggu lalu, seorang rekan kerja mengirimkan kontrak vendor setebal 47 halaman dan minta saya “tinggal ambil tabel harganya ke spreadsheet.” Saya menatap PDF itu sekitar tiga detik sebelum menutupnya dan membuka PDF scraper sebagai gantinya. Reaksi itu bukan karena malas—melainkan karena bertahun-tahun melihat orang buang waktu berjam-jam cuma untuk menarik data dari file yang memang tidak didesain untuk itu.
Angka-angkanya memang mendukung rasa frustrasi itu. Survei Airbase tahun 2024 terhadap 745 profesional keuangan menemukan bahwa 38% tim menghabiskan lebih dari seperempat total waktu mereka untuk tugas manual. Laporan otomatisasi AP dari SAP Concur menambahkan bahwa 60% entri invoice ke sistem ERP atau akuntansi masih dilakukan secara manual.
PDF ada di mana-mana—invoice, kontrak, laporan keuangan, kuitansi hasil scan—dan terlalu banyak pekerjaan yang masih bergantung pada copy-paste. Di 2026, PDF scraper tersedia mulai dari library Python gratis sampai tool no-code berbasis AI. Salah pilih tool bisa bikin Anda kehilangan hari kerja, bukan menghematnya. Saya menguji 12 PDF scraper terbaik dari sisi ekstraksi tabel, OCR, harga, dan kemudahan pakai supaya Anda bisa menemukan yang paling cocok dalam hitungan menit.
Apa Itu PDF Scraper (dan Kenapa Penting untuk Anda)?
PDF scraper adalah software yang secara otomatis mengekstrak teks, tabel, field, dan data terstruktur dari file PDF. Kalau Anda pernah coba menyalin tabel dari PDF ke Excel lalu melihat kolom-kolomnya berubah jadi satu baris acak yang berantakan, Anda sudah paham masalahnya.
PDF scraper dan web scraper sering ketukar, jadi penting untuk membedakannya. Web scraper membaca HTML, yang setidaknya punya tag struktur seperti heading, tabel, dan div. Sementara PDF scraper berangkat dari format deskripsi halaman visual. Dokumentasi Adobe sendiri menjelaskan dengan jelas: PDF dibuat untuk mempertahankan tampilan halaman secara konsisten di berbagai perangkat, bukan untuk menampilkan struktur tabel atau semantik yang rapi. Itulah sebabnya copy-paste sering merusak baris, kolom, dan urutan baca.
Di mana PDF scraping benar-benar menghemat waktu?
- Pemrosesan invoice: mengambil nama pemasok, ID invoice, total, pajak, dan item per baris
- Laporan keuangan: mengekstrak tabel dari laporan tahunan, pernyataan, dan disclosure
- Dokumen hasil scan: mengambil kembali detail kontak atau data transaksi dari PDF berbasis gambar
- Migrasi data lama: mengubah arsip lama menjadi record terstruktur yang bisa dicari
Dampak bisnisnya lebih luas dari satu workflow. Gartner masih menilai kualitas data yang buruk sebagai penyebab kerugian organisasi setidaknya $12,9 juta per tahun secara rata-rata. Pada Februari 2025, Gartner juga menyebut 63% organisasi tidak punya, atau belum yakin punya, praktik data management yang tepat untuk AI. Sampai 2026, Gartner memperkirakan organisasi akan meninggalkan 60% proyek AI yang tidak didukung data siap-AI. Kalau PDF masih jadi tempat sebagian besar data mentah berada, kualitas ekstraksi dokumen sekarang langsung berkaitan dengan kesiapan AI.
Survei Adobe 2025 terhadap profesional keuangan menemukan bahwa 61% rutin mengedit dokumen berbasis PDF dan 64% rutin menandatanganinya. PDF Association juga mencatat bahwa PDF ada di peringkat format file paling populer ke-3 di web berdasarkan data CommonCrawl. Jelas PDF tidak akan hilang.
Cara Kami Mengevaluasi PDF Scraper Terbaik
Sebelum masuk ke daftar tool, ini kerangka penilaian yang saya pakai. Delapan kriteria berikut langsung mencerminkan pain point yang paling sering saya lihat di forum, issue GitHub, dan ulasan produk:
| Kriteria | Yang Diukur | Kenapa Penting |
|---|---|---|
| Jenis PDF yang didukung | Teks asli, hasil scan/gambar, campuran | Banyak tool gagal bahkan sebelum ekstraksi dimulai |
| Akurasi ekstraksi tabel | Tabel sederhana, tanpa garis, multi-halaman, sel gabungan | Keluhan paling umum dalam ekstraksi PDF |
| Kemampuan OCR | Bawaan, add-on, atau tidak ada | PDF hasil scan tidak berguna tanpa OCR |
| Format output/ekspor | Excel, CSV, JSON, Sheets, Notion, API | Data tidak ada gunanya kalau tidak bisa keluar dari tool dengan rapi |
| Tingkat kesulitan setup | No-code, low-code, atau wajib coding | Tim butuh tingkat kontrol yang sangat berbeda |
| Harga / paket gratis | Harga publik, trial, titik masuk yang realistis | Model billing sangat beragam |
| Otomatisasi / integrasi | Zapier, API, penjadwalan, webhook | Ekspor manual tidak bisa diskalakan |
| Use case terbaik | Untuk apa tool itu paling cocok | Sebagian besar tool tidak unggul di semua hal—mereka spesifik untuk workflow tertentu |
Agar lebih gampang dibaca, 12 tool ini saya bagi jadi tiga kategori: AI scraper no-code, parser dokumen berbasis template atau SaaS, dan library/API/open-source untuk developer.
12 PDF Scraper Terbaik Sekilas
Berikut perbandingan utama supaya Anda bisa langsung lihat profil Anda dan lompat ke bagian yang relevan:
| Tool | Jenis | Ekstraksi Tabel | OCR Bawaan | No-Code | Paket Gratis | Terbaik Untuk |
|---|---|---|---|---|---|---|
| Thunderbit | AI no-code scraper | ✅ Didukung AI | ✅ Ya | ✅ Ya | ✅ Kredit gratis | Pengguna bisnis, layout beragam |
| Tabula | Desktop open-source | ✅ Bagus (PDF teks) | ❌ Tidak | ✅ GUI | ✅ Gratis penuh | PDF teks sederhana dengan banyak tabel |
| Parseur | SaaS hybrid | ⚠️ Template + AI | ✅ Ya | ✅ Ya | ⚠️ Terbatas | Parsing invoice/email berulang |
| Nanonets | SaaS IDP berbasis AI | ✅ Kuat | ✅ Ya | ✅ Low-code | ⚠️ Trial kredit | Otomatisasi dokumen volume tinggi |
| Adobe Acrobat | Suite produktivitas PDF | ⚠️ Dasar | ✅ Ya | ✅ Ya | ❌ Ekspor berbayar | PDF ke Excel sesekali |
| PyMuPDF | Library Python | ⚠️ Parsing manual | ❌ Tidak (opsional Tesseract) | ❌ Wajib code | ✅ Gratis penuh | Developer, PDF berbasis teks |
| Camelot | Library tabel Python | ✅ Kuat (lattice + stream) | ❌ Tidak | ❌ Wajib code | ✅ Gratis penuh | Developer, tabel kompleks |
| Docparser | SaaS berbasis template | ⚠️ Berbasis template | ✅ Ya | ✅ Ya | ⚠️ Trial | Dokumen berulang + workflow Zapier |
| pdfplumber | Library Python | ✅ Bagus (granular) | ❌ Tidak | ❌ Wajib code | ✅ Gratis penuh | Developer, kontrol detail |
| AWS Textract | Cloud API | ✅ Kuat | ✅ Ya | ❌ Wajib API | ⚠️ Paket gratis terbatas | Pipeline skala enterprise |
| Docling | Open-source Python | ✅ Bagus | ✅ Via integrasi | ❌ Wajib code | ✅ Gratis penuh | Pipeline LLM/RAG |
| Parsio | SaaS hybrid | ⚠️ Dibantu AI | ✅ Ya | ✅ Ya | ⚠️ Terbatas | Jenis dokumen berulang |
Butuh tanpa setup sama sekali? Mulai dari baris no-code atau SaaS. Butuh kontrol maksimal? Mulai dari baris untuk developer. Kerja dengan PDF hasil scan? Singkirkan semua tool yang OCR-nya = Tidak.
1. Thunderbit
 Thunderbit adalah PDF scraper yang akan saya kasih ke siapa pun yang bilang, “Saya cuma perlu datanya keluar dari PDF ini,” dan tidak mau dengar soal Python, template, atau API key. Ini adalah AI web data agent—ekstensi Chrome—yang membaca PDF, gambar, dan website, lalu menghasilkan data terstruktur. Tanpa template, tanpa coding.
Kami membangun Thunderbit untuk menangani skenario yang paling sering bikin tool lain gagal: Anda menerima PDF dari lima vendor berbeda, masing-masing dengan layout yang sedikit beda, dan Anda perlu field yang sama dari semuanya. AI membaca tiap dokumen dari awal, mengusulkan nama kolom dan tipe data lewat fitur “AI Suggest Fields”, lalu mengekstrak data ke tabel terstruktur. OCR bawaan menangani PDF hasil scan dan gambar secara native, dengan dukungan 34 bahasa.
Fitur utama:
- One Click Extract menentukan kolom dan tipe data dari layout PDF apa pun—tanpa konfigurasi manual
- OCR bawaan untuk PDF hasil scan dan gambar
- Ekspor ke Excel, Google Sheets, Airtable, Notion, CSV, dan JSON—semuanya gratis
- Pelabelan dan reformating dengan AI: AI bisa menerjemahkan, mengkategorikan, atau menyusun ulang data saat proses ekstraksi, bukan cuma sesudahnya
- Ekstraksi tabel membaca layout secara visual (seperti manusia), sehingga adaptif terhadap format tanpa garis, tidak beraturan, dan multi-vendor
Cara mengekstrak PDF dengan Thunderbit:
- Instal Thunderbit Chrome Extension
- Buka atau unggah PDF Anda di browser
- Klik “One Click Extract”—AI membaca dokumen dan menentukan nama kolom serta tipe datanya
- Klik “Scrape”—data diekstrak ke tabel terstruktur
- Ekspor ke Google Sheets, Excel, Airtable, Notion, CSV, atau JSON
Harga: Paket gratis dengan kredit (sekitar 6 halaman gratis, 10 dengan trial). Paket Starter sekitar ~$15/bulan atau sekitar $9/bulan kalau ditagih tahunan. Kredit berbasis baris (1 kredit = 1 baris output). Lihat Thunderbit Pricing untuk detail.
Cocok untuk: Pengguna non-teknis yang berurusan dengan layout PDF beragam (invoice dari banyak vendor, laporan campuran format) dan ingin hasil hanya dengan satu klik.
Kelebihan: Setup paling mudah di daftar ini; OCR bawaan; ekspor langsung ke Sheets, Notion, Airtable, dan Excel; bekerja pada layout beragam tanpa template.
Kekurangan: Billing berbasis kredit butuh sedikit waktu untuk diterjemahkan ke biaya per halaman; ulasan pihak ketiga lebih sedikit dibanding vendor SaaS besar.
Coba Thunderbit untuk scraping PDF Unggah invoice dari lima vendor berbeda dan biarkan AI menentukan kolom untuk tiap layout — tanpa setup per template. Get Started Free
2. Tabula
 Tabula adalah jawaban gratis klasik untuk ekstraksi tabel dari PDF berbasis teks, dan pada titik ini juga jelas merupakan proyek lama. Repo-nya menyebut ini proyek yang dijalankan sukarelawan, dan aplikasi desktop-nya kemungkinan besar tidak akan mendapat banyak pembaruan dalam waktu dekat. Rilis desktop terbaru masih 1.2.1 dari 2018, sementara tabula-java terakhir merilis 1.0.5 pada 2021.
Fitur utama:
- GUI point-and-click untuk memilih area tabel
- Berjalan lokal—data tidak pernah keluar dari mesin Anda
- Tanpa akun, tanpa langganan, tanpa signup
Harga: Sepenuhnya gratis selamanya. Open source.
Cocok untuk: Pengguna yang punya PDF berbasis teks sederhana dengan tabel bergaris jelas dan ingin solusi lokal gratis.
Kelebihan: Gratis; lokal; sangat mudah untuk tabel dasar.
Kekurangan: Tidak ada OCR (PDF hasil scan bukan pilihan); lemah untuk tabel tanpa garis; tidak ada otomatisasi atau API; tidak ada opsi cloud; praktis sudah tidak terurus.
3. Parseur
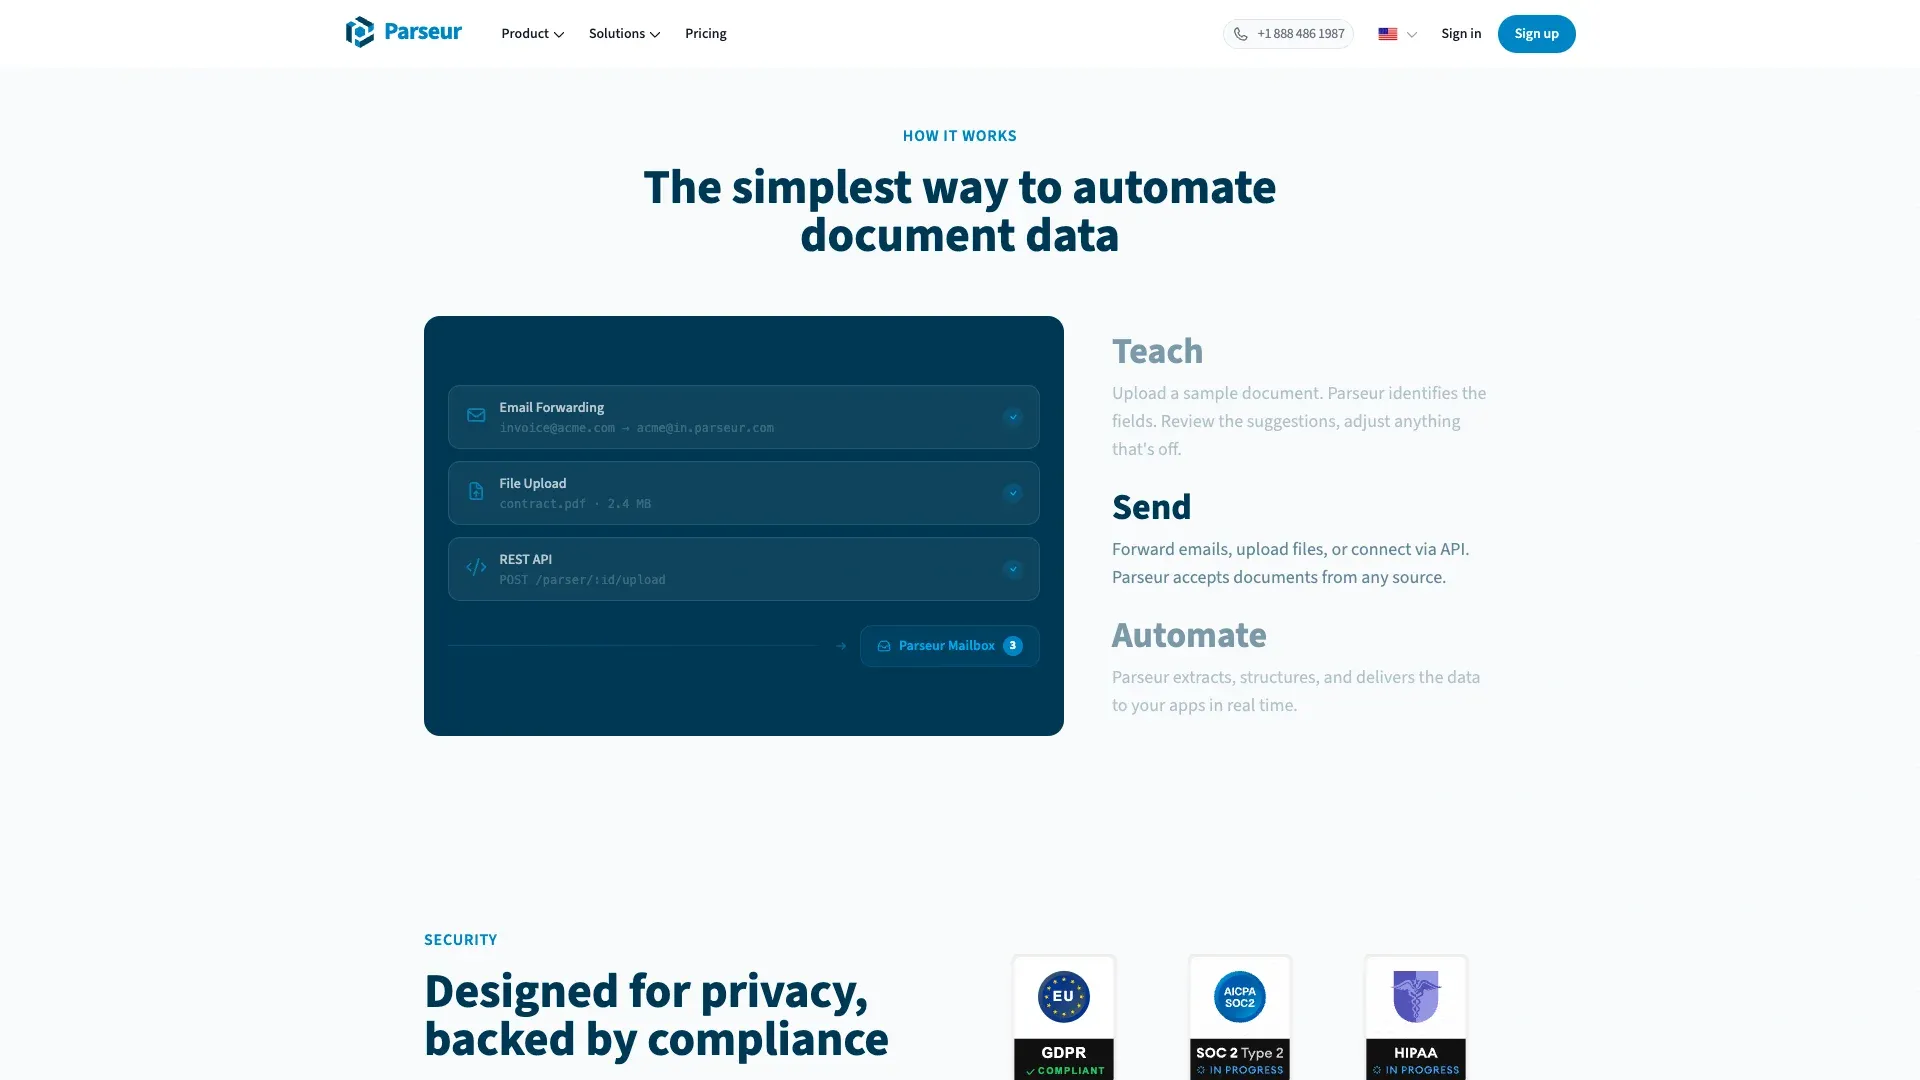 Parseur adalah hybrid paling kuat di kelompok SaaS karena menggabungkan AI parsing, template parsing, dan dynamic OCR. Ini bikin dia lebih fleksibel daripada parser zonal murni, tapi tetap lebih terstruktur dibanding AI scraper serba umum.
Fitur utama:
- OCR bawaan dengan dukungan 60+ bahasa (160+ eksperimental)
- Integrasi dengan Zapier, Make, Power Automate, API, webhook, Google Sheets
- Cocok untuk invoice, shipping notice, order confirmation, dan jenis dokumen berulang
Harga: Paket gratis sekitar 20 halaman/bulan. Batas paket self-serve berbayar terendah sekitar ~$39/bulan. Biaya terstandar di paket terkecil kira-kira $390 per 1.000 halaman, meski tarif efektif turun pada volume lebih tinggi.
Cocok untuk: Tim yang menerima jenis dokumen yang sama berulang kali dan ingin otomatisasi tanpa coding.
Kelebihan: OCR bawaan; stack otomatisasi kuat; bagus untuk layout berulang.
Kekurangan: Setiap layout baru atau layout yang berubah mungkin perlu template atau fallback AI; struktur tabel kompleks masih lebih sulit.
4. Nanonets
 Nanonets lebih dekat ke platform intelligent document processing (IDP) daripada sekadar PDF scraper sederhana—dan itu sekaligus jadi kekuatan sekaligus tingkat kerumitannya. Perusahaan ini mengubah harga pada 31 Januari 2025, beralih ke kredit usage prabayar alih-alih paket sederhana berbasis halaman.
Fitur utama:
- Ekstraksi tabel dan deteksi field berbasis AI
- OCR bawaan dengan dukungan 40+ bahasa
- Otomatisasi workflow dengan langkah approval
- Stack integrasi enterprise yang luas
Harga: Kredit saat mendaftar. Billing berbasis penggunaan. Estimasi kasar berdasarkan dokumen harga publik per blok sekitar $300–$380 per 1.000 halaman untuk workflow ekstraksi sederhana.
Cocok untuk: Tim menengah sampai besar yang memproses ribuan dokumen per bulan (otomatisasi AP, logistik, klaim asuransi).
Kelebihan: Ekstraksi AI kuat; integrasi enterprise; otomatisasi workflow.
Kekurangan: Harga lebih sulit diprediksi; kurva belajar untuk workflow lanjutan; paket gratis terbatas.
5. Adobe Acrobat
 Adobe Acrobat adalah tool PDF standar yang hampir semua orang kenal. Kuat untuk OCR dan konversi, tetapi sebenarnya bukan scraper dalam arti yang sama seperti tool lain di daftar ini.
Fitur utama:
- OCR bawaan di Pro
- Ekspor ke Word, Excel, PowerPoint, HTML, TXT, dan format gambar
- Dukungan OCR multi-bahasa yang luas
Harga: Acrobat Standard $14.99/bulan; Acrobat Pro $19.99/bulan. Reader gratis, tapi fitur ekspor memerlukan paket berbayar.
Cocok untuk: Pengguna yang sesekali perlu mengubah PDF ke Word atau Excel dan sudah punya langganan Adobe.
Kelebihan: Dipercaya luas; OCR bawaan; banyak pengguna sudah memilikinya.
Kekurangan: Ekstraksi tabel hanya dasar untuk layout kompleks; tidak ada otomatisasi atau API untuk pemrosesan massal; memang tidak dirancang sebagai “scraper.”
6. PyMuPDF
 PyMuPDF (juga dikenal sebagai “fitz”) masih jadi library ekstraksi PDF Python serbaguna tercepat dalam roundup ini. Rilis saat ini adalah 1.27.2.2 dari Maret 2026, dan benchmark terus menunjukkan performanya jauh lebih cepat dibanding banyak library PDF Python lainnya.
Fitur utama:
- Ekstraksi teks mentah yang sangat cepat
- Ekstraksi gambar dan akses metadata
- OCR opsional lewat Tesseract (meski dokumentasi menyebut OCR ~1.000x lebih lambat daripada ekstraksi biasa)
- Deteksi tabel melalui
find_tables()
Harga: Sepenuhnya gratis, open source.
Cocok untuk: Developer yang membangun pipeline dan terutama bekerja dengan PDF native berbasis teks.
Kelebihan: Sangat cepat; ringan; komunitas aktif; ekstraksi teks kuat.
Kekurangan: Tidak ada OCR bawaan; ekstraksi tabel butuh logika parsing manual; wajib coding.
7. Camelot
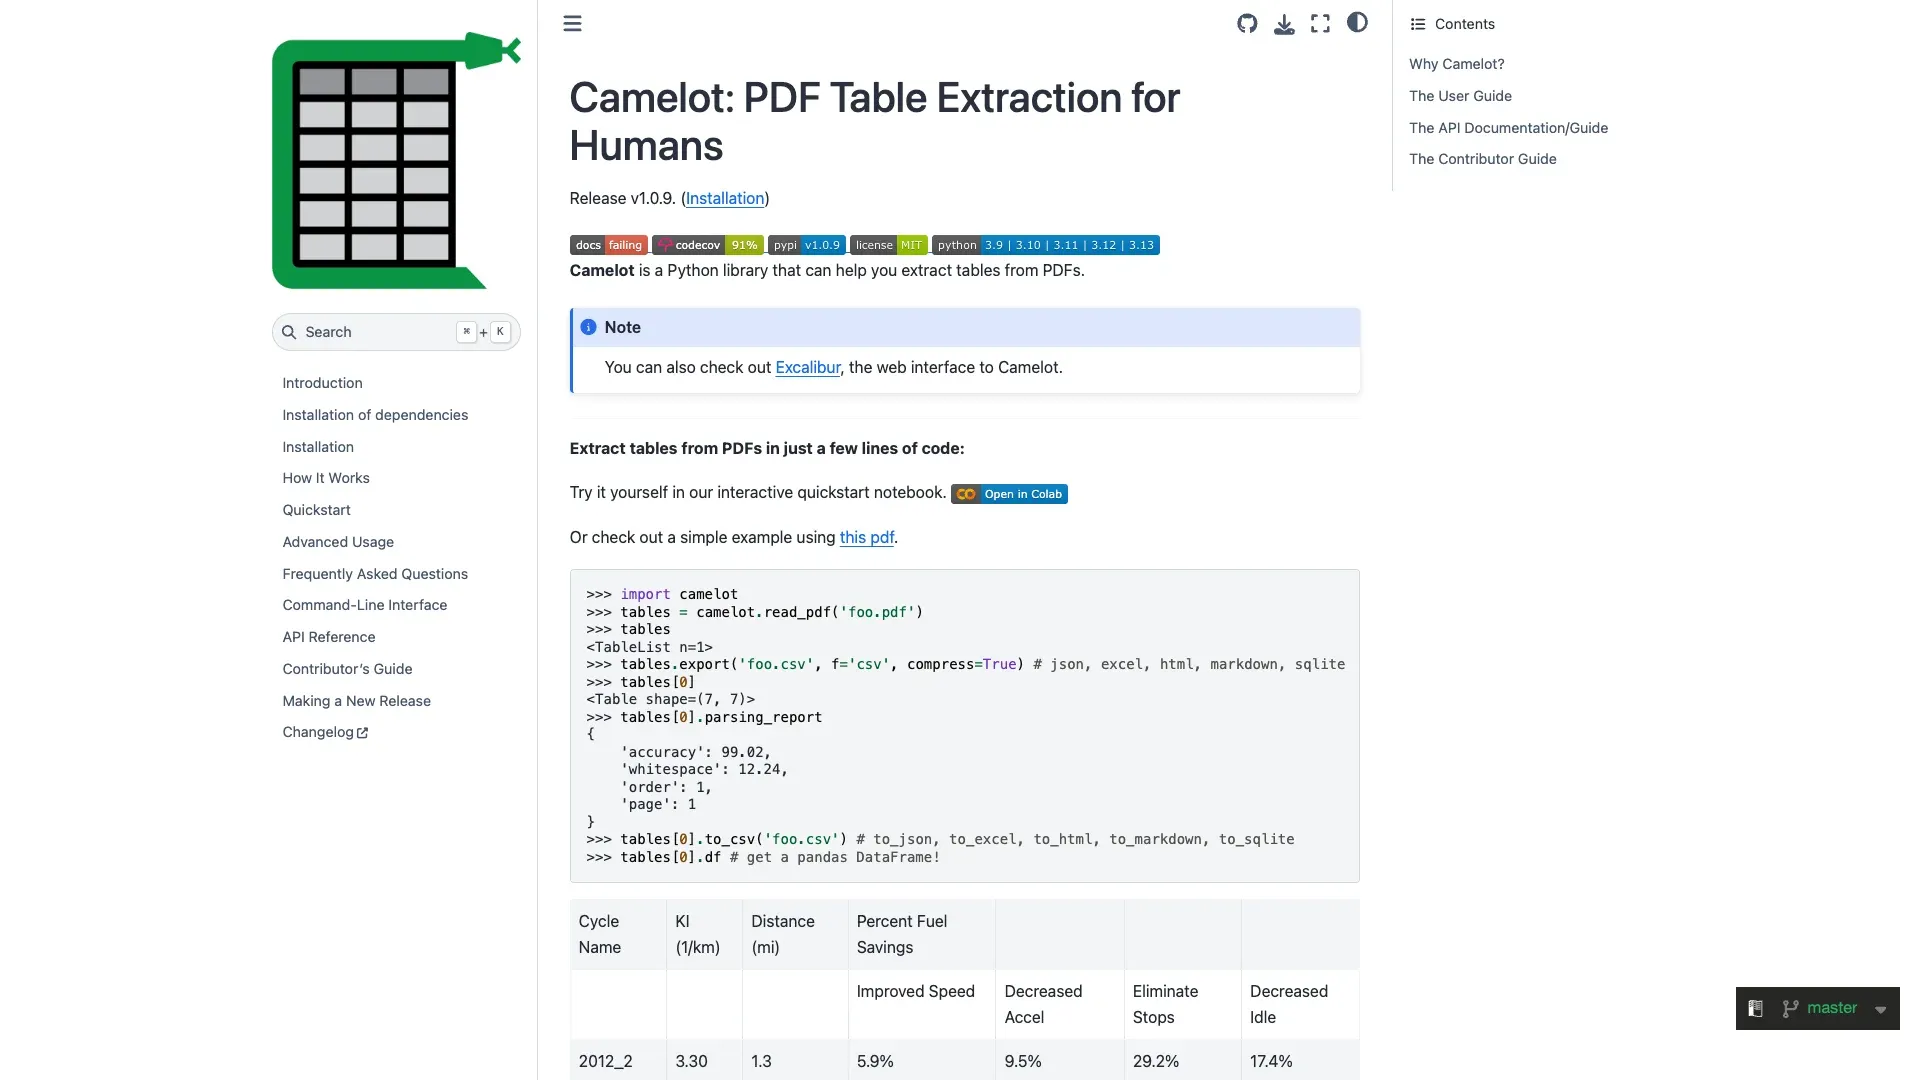 Camelot masih jadi salah satu tool ekstraksi tabel Python yang paling dikenal karena fokusnya memang ke tabel, bukan dokumen secara umum. Repo-nya masih aktif dipelihara, dengan v1.0.9 dirilis pada Agustus 2025.
Fitur utama:
- Dua mode ekstraksi:
latticeuntuk tabel bergaris,streamuntuk tabel tanpa garis/berbasis whitespace - Metrik akurasi di parsing report—salah satu fitur paling berguna Camelot untuk workflow otomatisasi
- Output ke pandas DataFrame, CSV, JSON, Excel
Harga: Sepenuhnya gratis, open source.
Cocok untuk: Developer yang butuh ekstraksi tabel presisi dari PDF terstruktur berbasis teks.
Kelebihan: Akurasi tabel sangat baik; dua mode ekstraksi; ada scoring akurasi.
Kekurangan: Tidak ada OCR; hanya untuk PDF berbasis teks; wajib coding; bisa lambat di dokumen besar.
8. Docparser
 Docparser adalah tool SaaS paling jelas rule-driven di daftar ini. Tool ini memakai zonal OCR, anchor keyword, dan aturan parsing layout tetap, bukan mencoba bertingkah seperti pembaca AI serba umum.
Fitur utama:
- OCR bawaan
- Terintegrasi dengan Zapier, Workato, Power Automate, Google Sheets, Salesforce, dan REST API
- Cocok untuk mengalirkan data hasil ekstraksi ke workflow bisnis
Harga: Starter $39/bulan; Professional $74/bulan; Business $159/bulan. Trial gratis 14 hari. Tagihan berdasarkan dokumen, jadi biaya terstandar per 1.000 halaman tergantung panjang dokumen—sekitar $78–$390 di tier starter.
Cocok untuk: Tim yang perlu mengotomatiskan workflow dokumen berulang dengan integrasi ketat ke tool seperti Zapier atau Salesforce.
Kelebihan: OCR bawaan; integrasi workflow kuat; bagus untuk layout stabil.
Kekurangan: Berbasis template—setiap layout baru perlu setup; ekstraksi tabel bergantung pada definisi zona; paling kuat di halaman 1.
9. pdfplumber
 pdfplumber tetap jadi library developer paling granular di daftar ini. Rilis saat ini adalah 0.11.9 dari Januari 2026, dan repo-nya menyebut proyek ini masih aktif dikembangkan.
Fitur utama:
- Kontrol detail atas objek karakter, garis, persegi panjang, dan strategi pencari tabel
- Filtering berbasis crop dan debugging visual
- Output data sebagai list/dict Python untuk manipulasi yang mudah
Harga: Sepenuhnya gratis, open source.
Cocok untuk: Developer Python yang butuh logika ekstraksi tabel yang granular dan bisa disesuaikan.
Kelebihan: Kontrol low-level sangat baik; akurasi bagus pada tabel kompleks; pengembangan aktif.
Kekurangan: Tidak ada OCR; lebih sulit dipelajari daripada Camelot; wajib coding.
10. AWS Textract
 AWS Textract adalah API paling enterprise-native di daftar ini. Dibangun untuk skala, variasi dokumen, dan penggunaan programatik, bukan untuk kenyamanan GUI.
Fitur utama:
- Ekstraksi tabel dan form berbasis AI
- OCR bawaan dengan dukungan tulisan tangan (paling mendekati di daftar ini, meski tetap belum sempurna)
- Skalabilitas tingkat enterprise
- Integrasi yang mulus dengan ekosistem AWS
Harga: Billing per halaman. Paket gratis: 1.000 halaman/bulan selama 3 bulan. Setelah itu: OCR teks saja $1,50/1.000 halaman; tabel $15/1.000 halaman; forms + tables $65/1.000 halaman; expense documents $10/1.000 halaman.
Cocok untuk: Tim enterprise yang memproses 10.000+ dokumen/bulan lewat pipeline API.
Kelebihan: Ekstraksi form dan tabel akurat; OCR bawaan; skala enterprise.
Kekurangan: Hanya API; tidak ada antarmuka visual; biaya cepat naik pada mode lanjutan; terkunci di ekosistem AWS.
11. Docling
 Docling adalah tool open-source paling futuristik di daftar ini karena memang ditujukan langsung untuk pipeline dokumen ke LLM. Rilis saat ini adalah 2.90.0 dari 17 April 2026, dan proyek ini bergerak cepat.
Fitur utama:
- Output ke Markdown, HTML, WebVTT, DocTags, dan JSON lossless
- Dukungan OCR melalui beberapa engine terintegrasi
- Dibangun untuk LangChain, LlamaIndex, CrewAI, Haystack, dan ekosistem sejenis
- Pertumbuhan komunitas yang kuat
Harga: Sepenuhnya gratis, open source.
Cocok untuk: Developer yang membangun aplikasi LLM/RAG dan perlu mengubah PDF menjadi Markdown terstruktur yang siap untuk AI.
Kelebihan: Output Markdown bersih; OCR lewat integrasi; dibuat untuk workflow AI modern; pengembangan aktif.
Kekurangan: Wajib coding; terutama ditujukan untuk developer; GUI dan opsi ekspor kurang mulus dibanding tool SaaS.
12. Parsio
 Parsio adalah parser SaaS hybrid yang menggabungkan template, OCR, AI parsing, dan parsing berbasis GPT. Secara konsep, posisinya ada di antara Parseur dan Docparser: lebih fleksibel daripada zona murni, tapi tetap dioptimalkan untuk dokumen berulang.
Fitur utama:
- OCR bawaan
- Deteksi field berbantuan AI
- Integrasi dengan Google Sheets, webhook, API, Zapier, Make, n8n, Pabbly
Harga: Sandbox dengan 30 kredit. Starter $41/bulan untuk 1.000 kredit; Growth $124/bulan; Business $249/bulan. Satu dokumen atau halaman PDF yang diparse bisa memakai 1, 2, atau 5 kredit tergantung mode parser, jadi estimasi terstandar di paket starter kira-kira $41–$205 per 1.000 halaman.
Cocok untuk: Tim kecil sampai menengah yang memproses jenis dokumen berulang (invoice, kuitansi) dan ingin solusi SaaS no-code dengan AI ringan.
Kelebihan: OCR bawaan; cakupan jenis dokumen luas; stack otomatisasi luas.
Kekurangan: Kedalaman ulasan pihak ketiga masih tipis; harga kurang transparan antar mode parser; tidak setegas Parseur atau Nanonets dari sisi diferensiasi.
Adu Ekstraksi Tabel: Bagaimana PDF Scraper Terbaik Menangani Tabel Dunia Nyata
Ekstraksi tabel adalah pain point yang paling sering dibahas pengguna PDF scraper—dan memang ada alasannya. Benchmark terbaru seperti OmniDocBench (1.651 halaman dari 10 jenis dokumen) dan riset akademik tentang heterogeneous table extraction menegaskan bahwa “ekstraksi tabel” bukan satu tugas yang seragam. Ini sebuah spektrum.
Tabel Sederhana (Garis Jelas, Satu Halaman)
Sebagian besar tool bisa menangani ini dengan baik. Tabula, Camelot, pdfplumber, Thunderbit, dan AWS Textract semuanya bekerja baik di sini. Kalau PDF Anda cuma berisi tabel bergaris sederhana, hampir semua tool di daftar ini cocok.
Tabel Tanpa Garis dan Berbasis Whitespace
Di sinilah perbedaannya mulai kelihatan. Tanpa garis pembatas, parser berbasis aturan sulit mengenali batas kolom. Mode stream milik Camelot dan tuning parameter khusus pada pdfplumber kuat untuk developer yang bisa ngoprek setting. Tool berbasis AI seperti Thunderbit, Nanonets, dan AWS Textract membaca layout secara visual, jadi biasanya lebih cocok untuk non-developer yang menghadapi format tidak konsisten.
Tabel yang Menyebar ke Banyak Halaman
Ini kasus gagal yang umum. Tool berbasis template dan extractor sederhana sering menganggap setiap halaman sebagai tabel terpisah, kecuali workflow-nya memang secara eksplisit menyambungkannya lagi. Tool AI-first punya keunggulan di sini karena bisa memahami kesinambungan secara semantik, bukan cuma secara geometris—meski tidak ada vendor yang benar-benar sempurna untuk masalah ini.
Sel Gabungan dan Header Bertingkat
Ini skenario paling sulit. Makalah EMNLP 2024 tentang heterogeneous table information extraction melaporkan rentang F1 dari 74,2 sampai 96,1 tergantung metode dan skenarionya. Tool berbasis AI (Thunderbit, Nanonets, AWS Textract) cenderung lebih unggul daripada parser berbasis aturan karena mereka memahami layout secara semantik, bukan bergantung pada garis pembatas.
OCR Dibandingkan: PDF Scraper Mana yang Bisa Menangani Dokumen Hasil Scan?
OCR adalah garis pemisah antara tool yang bisa menangani PDF bisnis sungguhan dan tool yang cuma bisa menangani dokumen ideal buatan mesin. Berikut matriksnya:
| Tool | OCR Asli | Dukungan PDF Hasil Scan | OCR Multi-Bahasa | Dukungan Tulisan Tangan |
|---|---|---|---|---|
| Thunderbit | ✅ Bawaan | ✅ Ya | ✅ 34 bahasa | ⚠️ Terbatas |
| Adobe Acrobat | ✅ Bawaan | ✅ Ya | ✅ Kuat | ⚠️ Terbatas |
| AWS Textract | ✅ Bawaan | ✅ Ya | ✅ Beberapa bahasa utama | ✅ Paling mendekati, tapi belum sempurna |
| Nanonets | ✅ Bawaan | ✅ Ya | ✅ 40+ bahasa | ⚠️ Terbatas |
| Parseur | ✅ Bawaan | ✅ Ya | ✅ 60+ bahasa | ❌ Tidak |
| Parsio | ✅ Bawaan | ✅ Ya | ✅ Multi-bahasa | ⚠️ Terbatas |
| Docparser | ✅ Bawaan | ✅ Ya | ✅ Ya | ⚠️ Terbatas |
| Docling | ✅ Via integrasi | ✅ Ya | Bergantung engine | ⚠️ Terbatas |
| Tabula | ❌ Tidak ada | ❌ Tidak | N/A | N/A |
| PyMuPDF | ❌ Tidak ada bawaan (opsional Tesseract) | ❌ Perlu add-on | Bergantung engine | Bergantung engine |
| Camelot | ❌ Tidak ada | ❌ Tidak | N/A | N/A |
| pdfplumber | ❌ Tidak ada | ❌ Tidak | N/A | N/A |
Tidak ada tool yang benar-benar andal untuk tulisan tangan di semua kasus pada 2026. AWS Textract adalah API enterprise yang paling mendekati, tetapi dukungan tulisan tangan tetap harus dipakai hati-hati. Kalau PDF Anda hasil scan tapi diketik, tool apa pun dengan OCR bawaan akan sangat membantu. Kalau tulis tangan, pasang ekspektasi yang realistis.
Berbasis AI vs. Berbasis Aturan vs. Berbasis Template: Tiga Generasi PDF Scraping
Cara paling gampang memahami pasar PDF scraper di 2026 adalah dengan melihat tiga generasi:
Generasi 1: Berbasis aturan (Tabula, Camelot, pdfplumber)
Ini paling cocok untuk PDF terstruktur berbasis teks dengan layout yang konsisten. Sangat kuat di tangan developer, tapi rapuh saat layout berubah. Kalau dokumen Anda bisa diprediksi, tool ini masih sangat bagus—dan gratis.
Generasi 2: Berbasis template (Parseur, Docparser, Parsio)
Pengguna mendefinisikan zona atau field untuk tiap tipe dokumen. Cocok untuk format berulang seperti invoice dari vendor yang sama. Masalahnya: setiap layout baru atau perubahan layout akan butuh setup atau maintenance.
Generasi 3: Berbasis AI/LLM (Thunderbit, Nanonets, AWS Textract, Docling untuk pipeline LLM)
AI membaca dokumen secara semantik, beradaptasi dengan layout baru tanpa template, dan bisa sekaligus memberi label serta mengubah data. Inilah arah pasar sekarang. Penilaian IDP Everest Group 2025 dan riset tabel multimodal ACL 2025 sama-sama menunjukkan ekstraksi berbasis LLM dan agen sebagai standar berikutnya.
Bagi pengguna non-teknis, ini penting secara praktis: kalau PDF Anda datang dari banyak sumber berbeda (vendor, partner, klien), tool berbasis template akan jadi beban maintenance. Tool berbasis AI bisa menangani variasi sejak awal. Inilah niche yang dibangun Thunderbit—pengguna bisnis yang punya PDF beragam dan sama sekali tidak tertarik menulis Python atau memelihara template ekstraksi.
PDF scraping AI untuk layout beragam Satu skema tidak harus dipaksakan ke semua vendor — AI membaca tiap dokumen dan menemukan strukturnya sendiri. Get Started Free
Rincian Harga: Berapa Sebenarnya Biaya PDF Scraper Terbaik?
Ini perbandingan yang jarang dipublikasikan orang lain, dan justru ini yang paling sering ditanya pengguna. Ini gambaran jujurnya:
| Tool | Paket Gratis | Harga Mulai | Est. Biaya per 1.000 Halaman | Open Source? |
|---|---|---|---|---|
| Thunderbit | ✅ Kredit gratis | ~$15/bln ($9/bln tahunan) | ~$18–$30 | Tidak |
| Tabula | ✅ Tanpa batas | Gratis selamanya | $0 | Ya |
| Camelot | ✅ Tanpa batas | Gratis selamanya | $0 | Ya |
| PyMuPDF | ✅ Tanpa batas | Gratis selamanya | $0 | Ya |
| pdfplumber | ✅ Tanpa batas | Gratis selamanya | $0 | Ya |
| Docling | ✅ Tanpa batas | Gratis selamanya | $0 | Ya |
| Parseur | ⚠️ ~20 halaman/bln | ~$39/bln | ~$390 (tier terendah) | Tidak |
| Nanonets | ⚠️ Kredit saat signup | Berbasis penggunaan | ~$300–$380 | Tidak |
| Docparser | ⚠️ Trial 14 hari | $39/bln | ~$78–$390 | Tidak |
| Parsio | ⚠️ 30 kredit | $41/bln | ~$41–$205 | Tidak |
| Adobe Acrobat | ❌ (ekspor berbayar) | $19.99/bln Pro | Tidak dihitung per halaman | Tidak |
| AWS Textract | ⚠️ 1.000 halaman/bln (3 bulan) | Bayar sesuai penggunaan | $1.50–$65 | Tidak |
Trade-off biaya tersembunyi lebih penting daripada harga yang terlihat. Tool Python open-source memang gratis dalam arti uang, tapi memakan waktu developer untuk setup, maintenance, dan debugging. Tool SaaS berbasis template mudah di awal kalau variasinya rendah, tetapi jadi mahal saat layout berubah. Tool AI no-code seperti Thunderbit memang pakai kredit per baris, tapi secara drastis memangkas waktu setup. Cloud API seperti AWS Textract paling murah saat skala besar—tetapi hanya kalau Anda sudah punya engineering team.
Kalau saya memikirkan “biaya sebenarnya,” saya juga menghitung gaji orang yang mengerjakannya. Satu jam waktu analis data untuk mengonfigurasi template atau menulis Python bukan biaya nol, meski softwarenya gratis.
PDF Scraper Mana yang Sebaiknya Anda Pilih?
Berikut panduan keputusan singkat:
| Situasi Anda | Tool yang Direkomendasikan |
|---|---|
| Non-teknis, layout PDF beragam, ingin hasil cepat | Thunderbit, Nanonets |
| Invoice/kuitansi dengan format yang sama dan berulang | Parseur, Docparser, Parsio |
| Developer yang membangun pipeline data | PyMuPDF, Camelot, pdfplumber |
| Enterprise, 10.000+ dokumen/bulan, butuh API | AWS Textract, Nanonets |
| Membangun aplikasi LLM/RAG | Docling |
| Sesekali perlu PDF ke Excel, sudah punya Adobe | Adobe Acrobat |
| Gratis, lokal, fokus tabel, tanpa coding | Tabula |
Kalau Anda pengguna bisnis yang cuma ingin data keluar dari PDF tanpa coding atau setup template, mulai dari Thunderbit. Tool ini membaca tiap PDF dari awal dengan AI dan mengekspor ke tool yang sudah Anda pakai. Kalau dokumen Anda berulang dengan layout yang mudah dikenali, Parseur atau Docparser mungkin lebih cocok. Dan kalau Anda ingin kontrol engineering penuh, stack open-source tetap jadi titik biaya terendah.
Penutup
PDF scraping di 2026 bukan lagi satu masalah dengan satu jawaban. Tool yang tepat tergantung pada apakah Anda developer, analis bisnis, atau tim enterprise—dan apakah PDF Anda berupa file teks yang rapi atau gambar hasil scan yang berantakan dari belasan vendor.
Kalau Anda ingin melihat seperti apa ekstraksi PDF berbasis AI dalam praktik, coba paket gratis Thunderbit. Saya rasa Anda akan kaget seberapa banyak data yang bisa diambil dari PDF cuma dalam beberapa klik. Dan kalau Thunderbit bukan pilihan paling pas, coba beberapa tool lain dari daftar ini. Belum pernah ada waktu yang lebih baik untuk berhenti copy-paste dari PDF dan mulai benar-benar memanfaatkan data di dalamnya.
Untuk pembahasan lebih lanjut tentang ekstraksi data dan otomatisasi, lihat panduan kami tentang mengekstrak data dari website ke Excel, tool ekstraksi data terbaik, ekstraksi data AI untuk bisnis, dan cara mengonversi gambar ke Excel. Anda juga bisa menonton panduan langkah demi langkah di Thunderbit YouTube Channel.
Coba Thunderbit Gratis Tabel, OCR, dan laporan format campuran dalam satu proses. Paket gratisnya cukup untuk menguji apakah tool ini cocok dengan dokumen Anda. Get Started Free
FAQ
1. Apa PDF scraper gratis terbaik?
Bagi non-developer, Tabula adalah tool GUI gratis paling sederhana untuk tabel PDF berbasis teks. Bagi developer, Camelot, pdfplumber, PyMuPDF, dan Docling semuanya pilihan gratis yang kuat. Untuk opsi no-code dengan paket gratis, Thunderbit adalah titik awal terbaik.
2. Apakah PDF scraper bisa menangani dokumen hasil scan?
Hanya tool dengan OCR bawaan yang bisa menangani PDF hasil scan secara langsung. Termasuk Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio, dan Docling (dengan engine OCR terintegrasi). Tabula, Camelot, dan pdfplumber tidak bisa menangani PDF hasil scan sendiri—mereka perlu dipasangkan dengan OCR eksternal seperti Tesseract.
3. Seberapa akurat ekstraksi tabel dari PDF?
Sangat tergantung pada kompleksitas tabel. Sebagian besar tool bisa menangani tabel bergaris sederhana dengan baik. Tabel tanpa garis, sel gabungan, dan tabel multi-halaman jauh lebih sulit. Tool berbasis AI seperti Thunderbit, Nanonets, dan AWS Textract cenderung mengungguli parser berbasis aturan pada layout yang beragam, sementara tool berbasis aturan masih bisa sangat bagus pada PDF berbasis teks yang stabil.
4. Apakah saya perlu skill coding untuk scraping PDF?
Tidak. Tool seperti Thunderbit, Parseur, Docparser, Parsio, Nanonets, dan Adobe Acrobat bisa dipakai tanpa coding. Tabula juga punya GUI. Library Python seperti PyMuPDF, Camelot, pdfplumber, dan Docling memerlukan kode.
5. Bisakah saya mengekspor data PDF langsung ke Excel atau Google Sheets?
Sebagian besar tool mendukung ekspor ke CSV atau Excel setidaknya. Thunderbit juga mengekspor langsung ke Google Sheets, Airtable, dan Notion secara gratis. Parseur, Docparser, dan Parsio mendukung ekspor ke workflow bisnis lewat integrasi seperti Zapier, webhook, dan API.
Coba AI PDF Scraping dengan Thunderbit Get Started Free
Pelajari Lebih Lanjut



