
Pertanyaan lama itu simpel: “Scraper mana yang bisa menyalin data dari situs web ini?”
Pertanyaan yang lebih tepat untuk 2026 adalah: “Workflow mana yang bisa mengubah halaman web yang berantakan jadi data terstruktur yang andal, dengan validasi yang cukup supaya bisa saya pakai lagi minggu depan?”
Perubahan ini penting karena istilah “AI web scraper” sekarang mencakup beberapa produk yang sangat berbeda. Ada alat yang memakai AI untuk menyarankan field dan mengekstrak data tanpa selector. Ada scraper visual dengan beberapa fitur deteksi cerdas. Ada platform untuk developer, di mana AI membantu membuat atau memelihara kode. Dan ada juga tools lama yang masih muncul di hasil pencarian meski sebenarnya sudah bukan AI-native.
Panduan ini dibuat tetap praktis. Kalau Anda bekerja di sales, marketing, ecommerce, riset, operasional, atau tim data, tujuannya bukan sekadar mengagumi scraper. Tujuannya adalah mendapatkan baris data yang bersih dari website publik ke spreadsheet, CRM, database, atau workflow otomatis, tanpa harus menghabiskan sisa bulan untuk memperbaiki selector.
Scrape website dengan AI Gunakan Thunderbit untuk mengubah halaman web menjadi tabel terstruktur, lalu ekspor ke Sheets, Airtable, Notion, CSV, atau JSON. Get Started Free
Apa yang Dianggap sebagai Free AI Web Scraper di 2026?
AI web scraper yang berguna seharusnya bisa membantu setidaknya salah satu tugas berikut:
- membaca halaman dan menyarankan field yang perlu diambil
- menangani list, pagination, infinite scroll, atau subpage
- mengubah konten halaman yang berantakan menjadi baris data terstruktur
- mengekspor data ke tools yang sudah dipakai tim Anda
- mengurangi kebutuhan maintenance selector saat halaman berubah
- membuat alurnya bisa dipakai berulang oleh tim, bukan cuma satu sesi browser milik satu orang
“Gratis” juga perlu dilihat secara realistis. Ada tool yang benar-benar punya free plan. Ada yang cuma free trial. Ada yang open source tapi butuh waktu engineering. Ada tool enterprise yang hebat, tapi jalur gratisnya lebih mirip demo atau trial. Itu bukan berarti jelek, tetapi memengaruhi siapa yang sebaiknya memakainya.
Aturan praktisnya begini:
- Kalau Anda butuh data hari ini dan tidak mau coding, mulai dari AI scraper tanpa kode.
- Kalau Anda butuh pipeline kustom dan punya engineer, pakai framework developer atau platform otomasi cloud.
- Kalau Anda butuh feed data skala besar yang dikelola, lihat platform data enterprise.
- Kalau sebuah tool sudah legacy atau tidak lagi didukung, anggap itu referensi, bukan pilihan utama.
Cara Kami Memilih Tool-Tool Ini
Saya meninjau shortlist 10 tool pada artikel ini dan mempertahankan sudut evaluasi yang praktis. Pertanyaan pentingnya sekarang bukan lagi “Apakah produk ini bisa scraping?” melainkan “Jenis workflow scraping seperti apa yang jadi lebih mudah dengan produk ini?”
Kriterianya:
- Bantuan AI: saran field, deteksi cerdas, setup dengan bahasa alami, atau parsing berbasis AI.
- Akses gratis: free plan, free trial, ketersediaan open source, atau kredit developer.
- Kemudahan penggunaan: apakah pengguna bisnis bisa memakainya tanpa bantuan engineer.
- Dukungan web modern: pagination, subpage, halaman berat JavaScript, gambar, dan ekspor.
- Kecocokan operasional: apakah hasilnya bisa jadi proses berulang.
- Risiko dan maintenance: seberapa banyak setup, perbaikan selector, review kepatuhan, dan QA yang masih harus ditangani pengguna.
Satu catatan penting: selalu periksa syarat situs target, robots.txt, kebutuhan login, dan kewajiban privasi sebelum scraping. AI memang mempermudah ekstraksi, tapi tidak menghapus tanggung jawab Anda untuk menggunakan data web secara bertanggung jawab.
Pilihan Cepat: Free AI Web Scraper Terbaik Berdasarkan Kebutuhan
| Kebutuhan | Mulai dari sini | Alasan |
|---|---|---|
| Scraping cepat tanpa kode untuk tim bisnis | Thunderbit | Saran field berbasis AI, scraping subpage, ekspor, workflow Chrome |
| Scraping visual ala desktop | ParseHub atau Octoparse | Cocok untuk pengguna yang lebih nyaman dengan workflow berbasis klik |
| Scraping berbasis recipe di browser | Data Miner | Kuat untuk tabel umum dan job berulang berbasis recipe |
| Scraping yang dikontrol developer | Scrapy atau Apify | Paling cocok saat kode, API, dan infrastruktur kustom penting |
| API data AI dan ekstraksi entity | Diffbot | Lebih pas untuk enrichment berbasis API dan data entity terstruktur |
| Crawling open source yang siap AI | Crawl4AI atau Scrapling | Framework developer untuk pipeline LLM dan scraping kustom yang mudah dipelihara |
1. Thunderbit
Thunderbit paling cocok untuk pengguna bisnis yang ingin scraping halaman web publik tanpa menulis kode scraper. Ini adalah ekstensi Chrome yang dibangun dengan alur sederhana: buka halaman, biarkan AI menyarankan field, sesuaikan tabel jika perlu, scrape list atau subpage, lalu ekspor hasilnya.
Alur ini penting karena banyak tim sebenarnya tidak sedang mencari “sebuah scraper.” Mereka butuh lead dari direktori, data produk dari marketplace, harga dari halaman kompetitor, listing properti, review, lowongan kerja, atau data riset ke dalam spreadsheet.
Thunderbit sangat kuat ketika:
- sumbernya website, bukan PDF atau database internal
- pengguna tahu data apa yang dibutuhkan tapi tidak paham CSS selector
- halaman memiliki detail page, pagination, atau kartu yang berulang
- output perlu masuk ke Google Sheets, Airtable, Notion, CSV, atau JSON
- workflow mungkin akan diulang oleh rekan tim yang non-teknis
Sisi AI-nya bersifat praktis, bukan sekadar hiasan. AI membantu menebak field, menulis prompt ekstraksi, dan membuat setup jauh lebih tahan terhadap perubahan dibanding workflow point-and-click murni berbasis selector. Tetap perlu memeriksa sample row sebelum mengekspor job besar, terutama kalau halaman sumber mencampur iklan, rekomendasi, atau listing sponsor ke hasil utama.
Akses gratis: Thunderbit punya jalur gratis untuk job kecil, dengan paket berbayar untuk scraping volume lebih tinggi. Cek halaman harga terbaru sebelum mencantumkan batas kredit secara spesifik, karena paket kredit bisa berubah.
Cocok untuk: tim sales, marketing, ecommerce, real estate, operasional, dan riset yang butuh data web terstruktur dengan cepat.

2. ParseHub
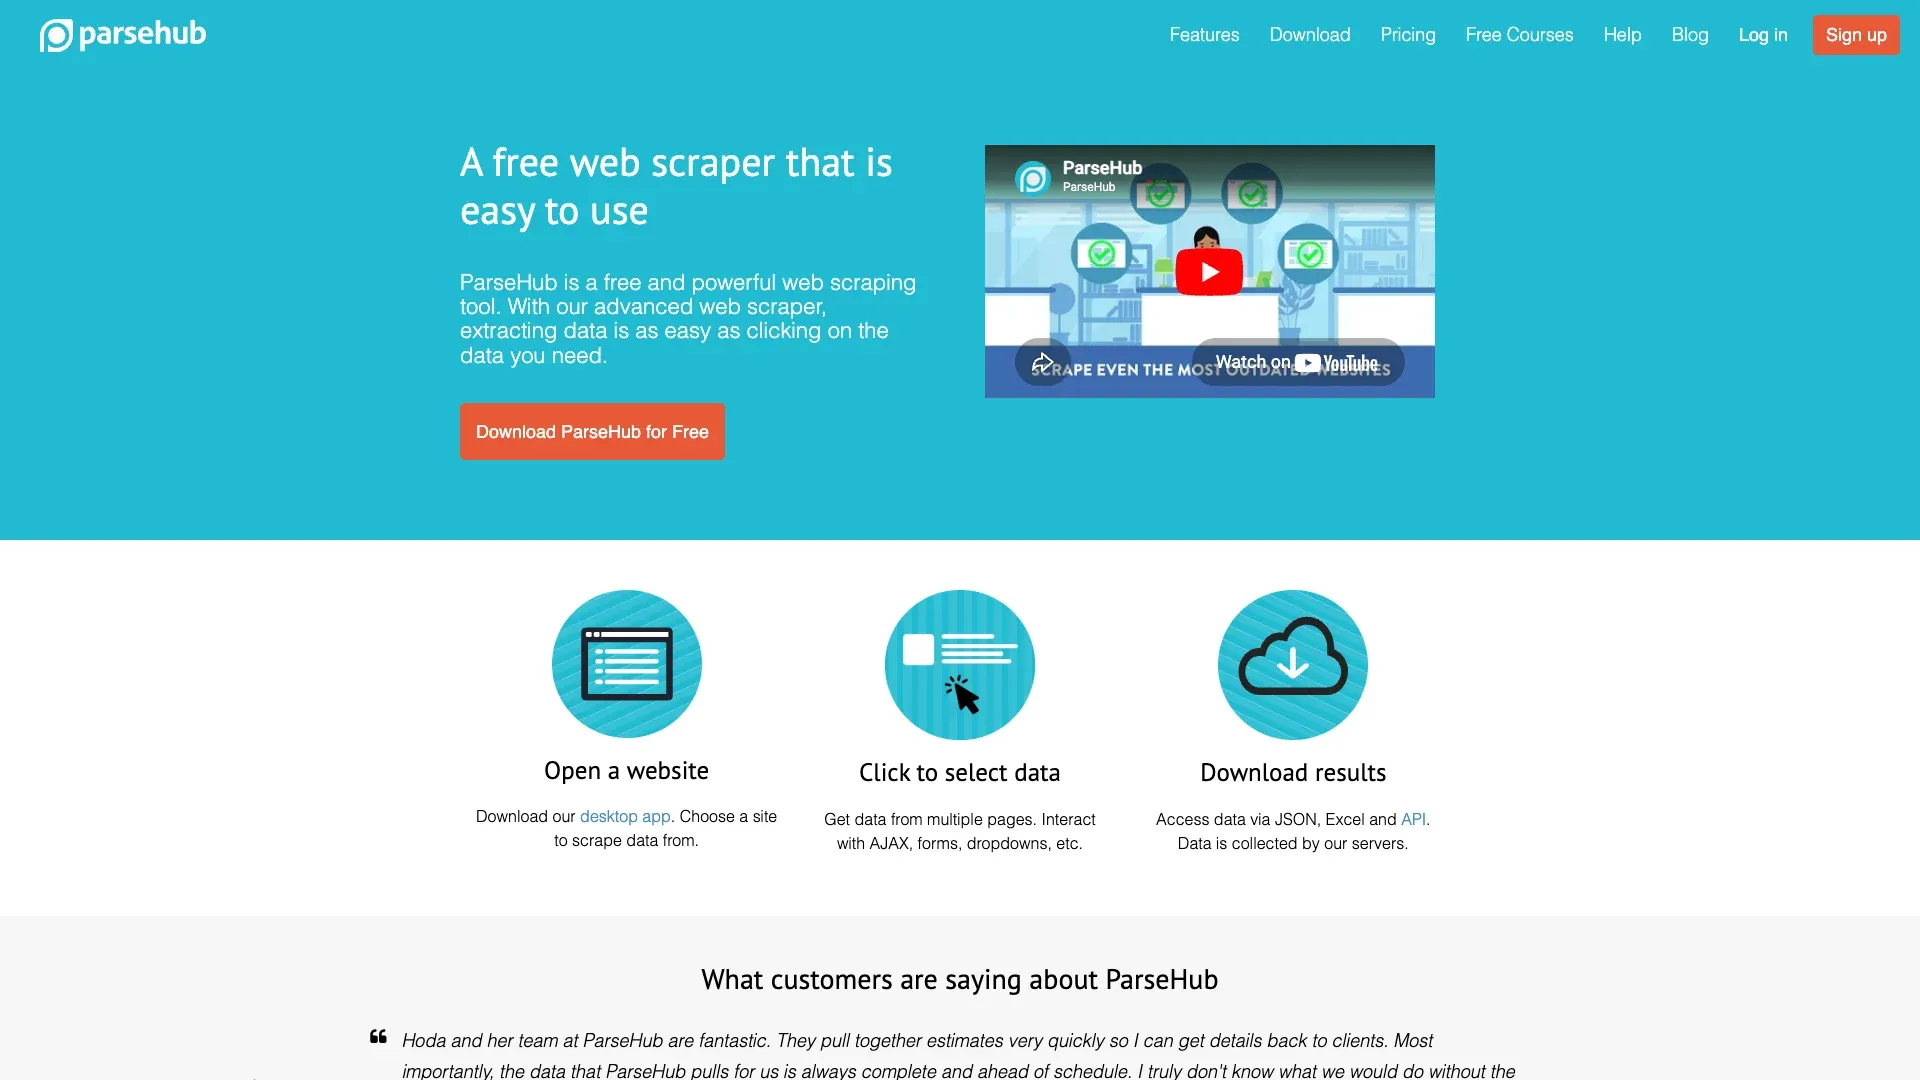
ParseHub adalah web scraper visual untuk pengguna yang lebih suka meng-klik halaman dan mengajarkan tool apa yang harus diambil. Tool ini bisa menangani banyak halaman dinamis dan tetap menjadi opsi familiar bagi tim yang menginginkan scraper visual berbasis desktop atau cloud.
ParseHub berguna saat pengguna nyaman membangun project langkah demi langkah: pilih elemen, perluas seleksi, tambahkan pagination, uji run, lalu ekspor. Ia memang tidak se-“prompt-first” seperti tool AI-native yang lebih baru, tetapi masih efektif untuk list terstruktur, halaman artikel, dan koleksi produk.
Akses gratis: ParseHub secara historis menawarkan free tier untuk proyek dan jumlah run halaman yang terbatas. Pastikan batas project dan halaman saat ini di situs resmi sebelum mencantumkan angka di materi produksi.
Cocok untuk: project scraping visual kecil yang dikerjakan pengguna yang rela meluangkan sedikit waktu untuk konfigurasi workflow.
3. Octoparse
Octoparse adalah platform web scraping no-code yang matang, dengan template, workflow builder, cloud run, penjadwalan, dan dukungan untuk banyak situs dinamis. Fitur-fiturnya lebih berat dibanding ekstensi Chrome ringan, yang bisa jadi keuntungan atau justru beban tergantung penggunanya.
Octoparse adalah pilihan bagus saat scraping dilakukan berulang, situs target cukup kompleks, atau tim membutuhkan workflow visual dengan scheduling dan eksekusi cloud. Setup-nya bisa memakan waktu lebih lama daripada scraping cepat berbantuan AI, tetapi memberi kontrol lebih besar untuk power user.
Akses gratis: Octoparse menyediakan free plan, tetapi batas fitur dan record bisa berubah. Verifikasi limit free plan terkini di halaman harga Octoparse sebelum mencantumkan angka pasti.
Cocok untuk: power user dan tim yang butuh kontrol workflow visual, template, penjadwalan, atau job berulang.

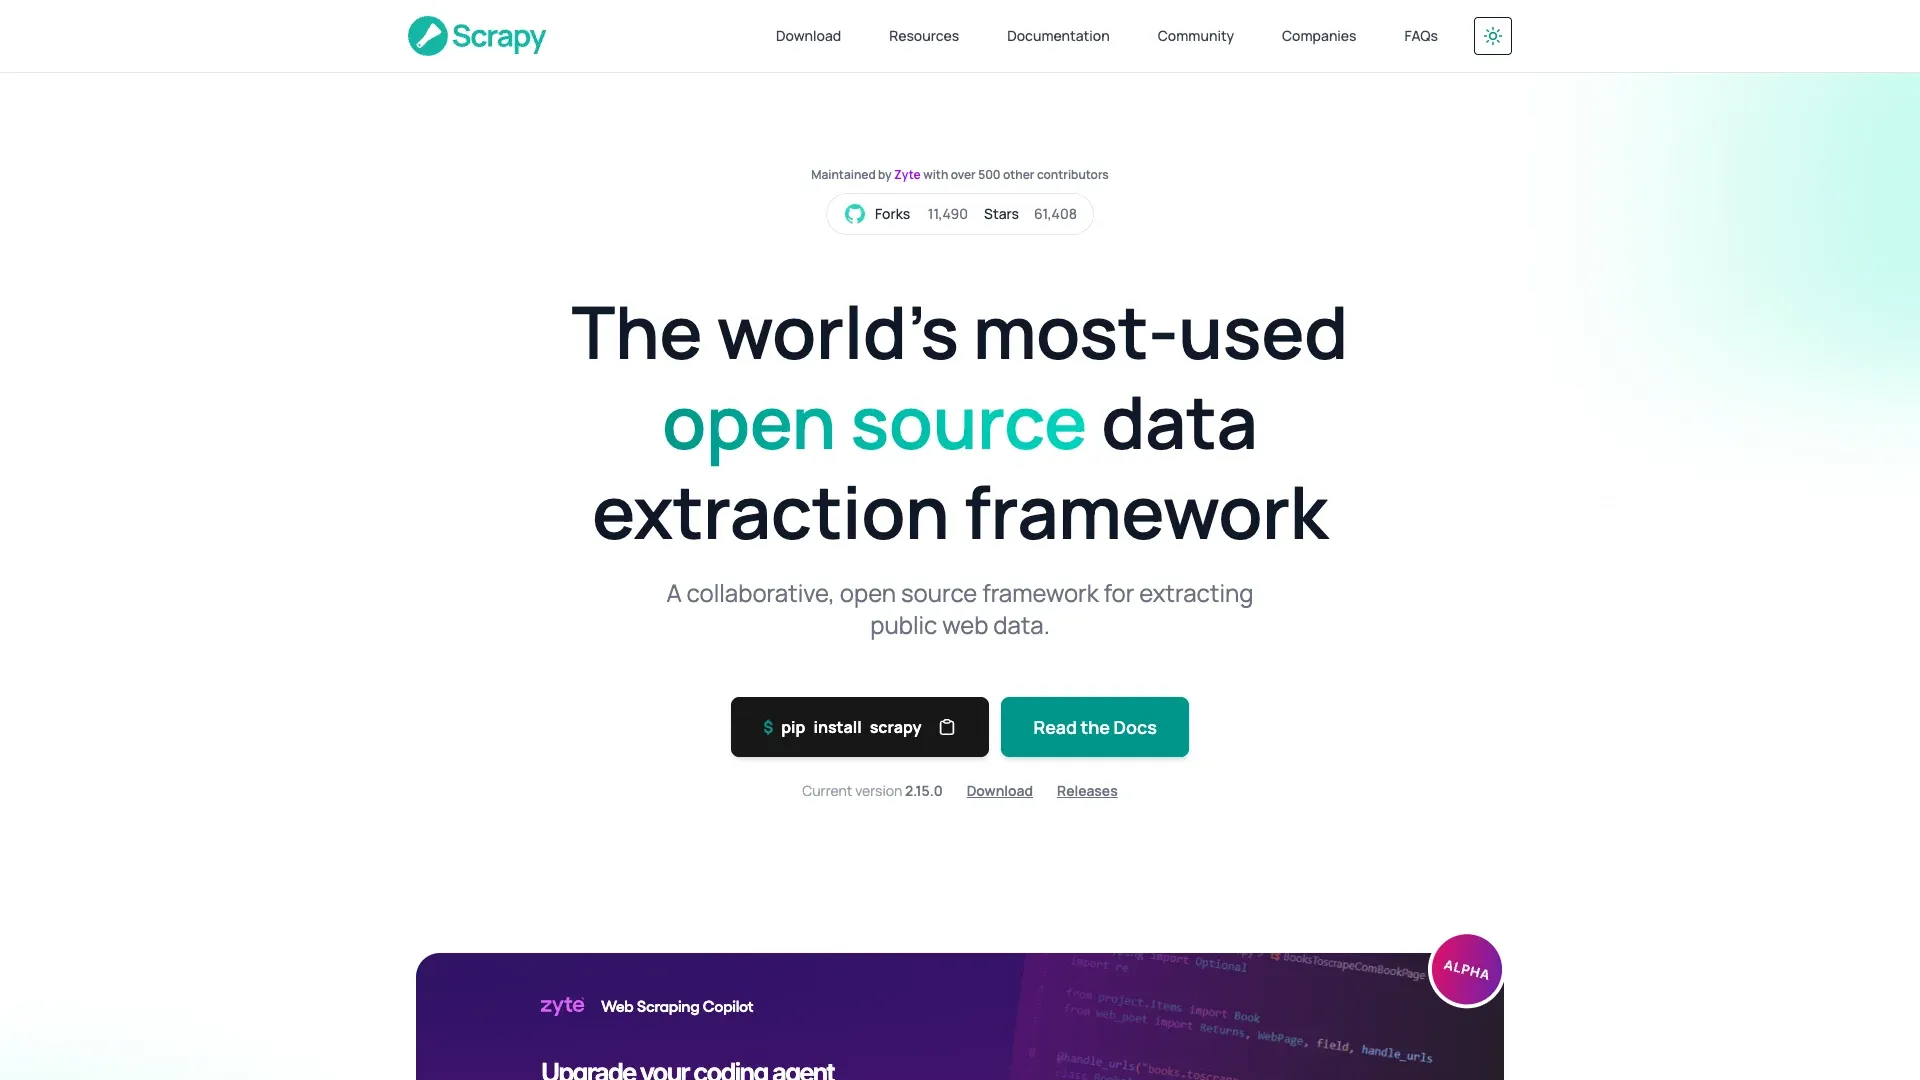
4. Scrapy
Scrapy bukan no-code AI scraper. Ini adalah framework Python open source untuk membangun crawler dan pipeline ekstraksi. Perbedaan ini penting.
Bagi developer, Scrapy masih menjadi salah satu cara paling fleksibel untuk membangun scraper kustom. Anda bisa mengontrol request, parsing, retry, pipeline, storage, dan deployment. Anda juga bisa memanfaatkan LLM di sekitar Scrapy: untuk menyusun selector, meninjau logika parsing, membuat tes, atau menjelaskan kegagalan. Namun Scrapy sendiri tidak menghapus pekerjaan engineering.
Akses gratis: Scrapy bersifat open source. Softwarenya gratis, tetapi hosting, proxy, maintenance, monitoring, dan waktu developer tetap berbiaya.
Cocok untuk: engineer yang membangun sistem scraping kustom dan mudah dipelihara, di mana kepemilikan kode tidak jadi masalah.
5. Data Miner
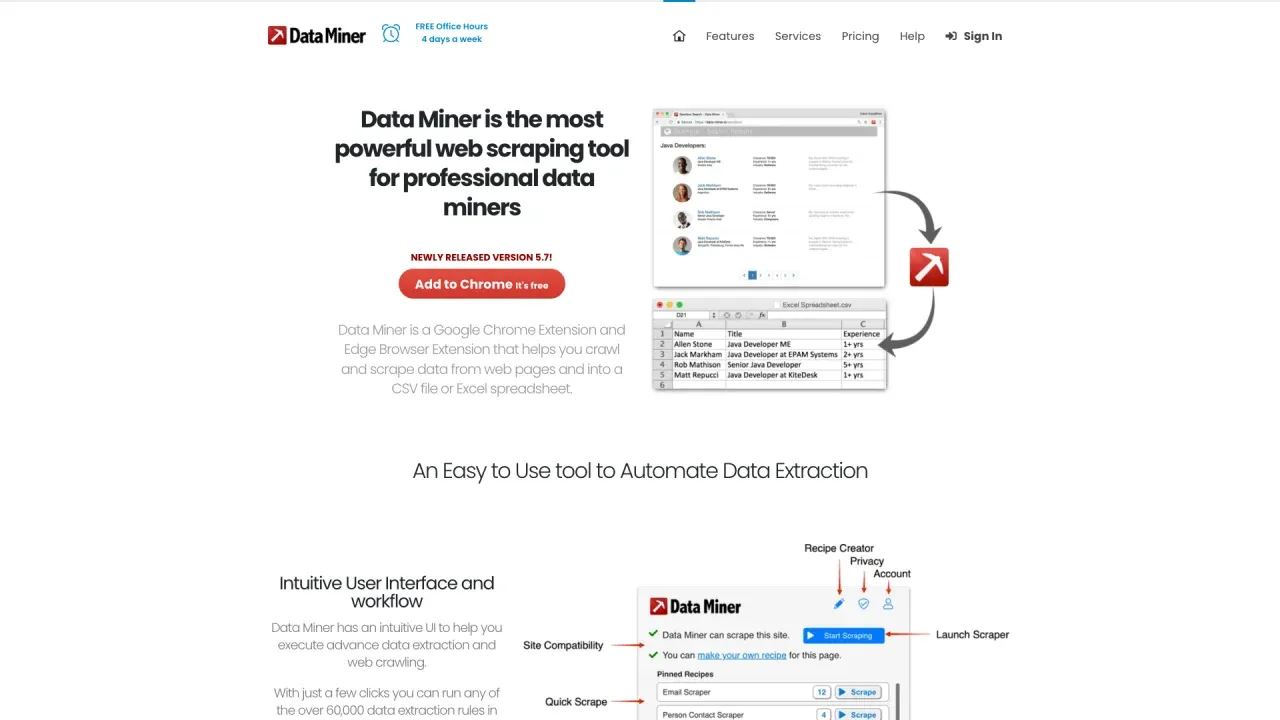
Data Miner adalah ekstensi browser yang fokus pada scraping tabel, list, dan pola halaman umum. Kekuatan utamanya ada di pustaka recipe: kalau recipe untuk sumber Anda sudah tersedia, setup bisa sangat cepat.
Ini cocok untuk pengguna yang berulang kali scraping tipe halaman yang familiar dan tidak butuh platform ekstraksi penuh. Tool ini kurang ideal saat halaman berantakan, sangat dinamis, atau butuh AI untuk menebak field dari konten yang ambigu.
Akses gratis: Data Miner menawarkan penggunaan gratis terbatas dengan paket berbayar untuk volume lebih tinggi. Verifikasi batas halaman atau kredit sebelum menyebutkannya.
Cocok untuk: ekstraksi tabel cepat, direktori umum, dan pengguna yang menyukai workflow ekstensi browser.
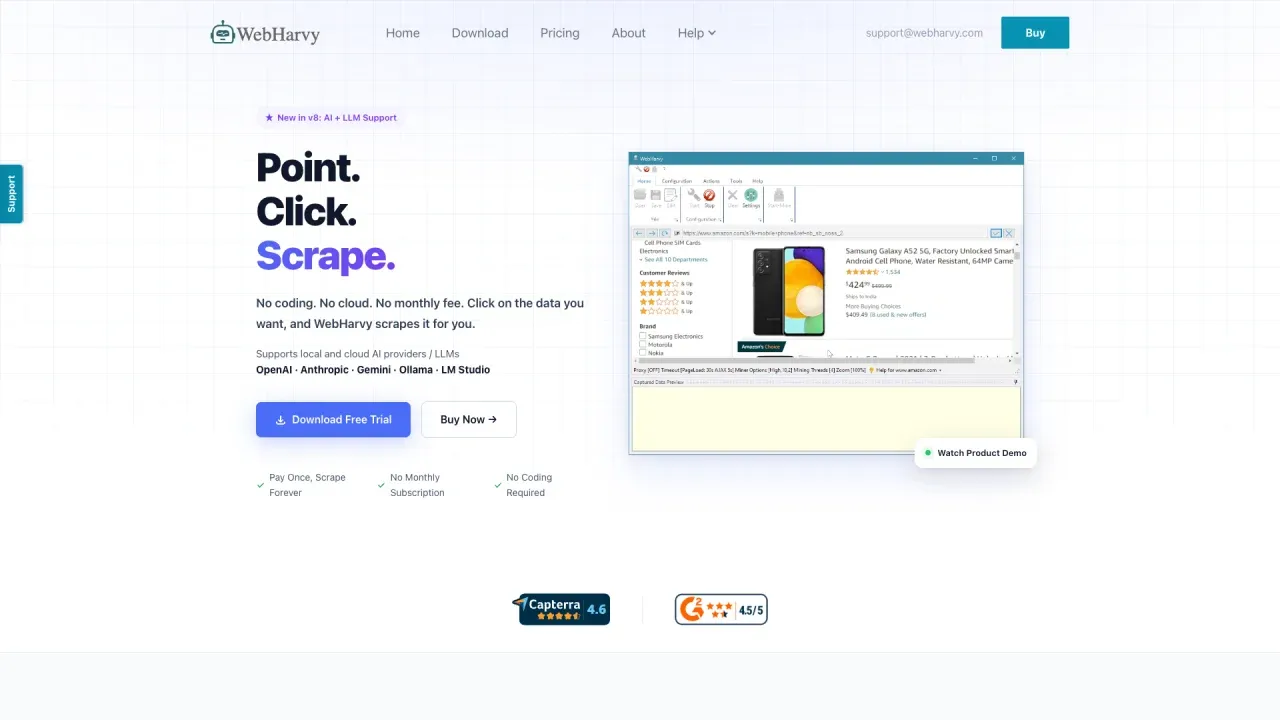
6. WebHarvy
WebHarvy adalah scraper desktop Windows dengan antarmuka visual dan fitur deteksi pola. Tool ini berguna untuk pengguna yang ingin mengklik contoh di halaman dan membiarkan tool menyimpulkan item serupa.
WebHarvy paling kuat untuk halaman produk, halaman yang banyak gambar, dan workflow ala desktop. Ini bukan opsi AI-native paling modern, tetapi masih cukup bagus untuk pengguna yang lebih suka lisensi sekali beli dan software desktop lokal.
Akses gratis: WebHarvy umumnya diposisikan sebagai free trial dan lisensi berbayar, bukan free plan berkelanjutan. Cek situs WebHarvy terbaru sebelum menyebutnya tool gratis.
Cocok untuk: pengguna Windows yang scraping daftar produk, gambar, dan pola halaman berulang.
7. Apify
Apify adalah platform cloud yang ramah developer untuk web scraping, otomasi browser, dan ekstraksi data. Daya tarik utamanya adalah Actor marketplace: alih-alih mulai dari script kosong, tim bisa memakai atau menyesuaikan actor yang sudah ada untuk situs dan workflow umum.
Apify adalah salah satu opsi terkuat ketika scraping harus berubah menjadi software. Ia mendukung API, scheduling, storage, webhook, dan workflow developer. AI juga bisa membantu di sini, tetapi lebih sebagai asisten untuk membangun, debugging, dan memvalidasi actor, bukan antarmuka sekali klik untuk pengguna bisnis.
Akses gratis: Apify memiliki model free plan/kredit. Periksa harga Apify dan dokumentasi platform terbaru sebelum mencantumkan batas komputasi yang spesifik.
Cocok untuk: developer, tim otomasi, dan operator teknis yang membutuhkan infrastruktur scraping cloud.

8. Diffbot
Diffbot adalah platform data AI yang dikenal untuk mengekstrak entity terstruktur dari halaman web dan memelihara knowledge graph besar. Ini lebih mirip platform API dan data intelligence daripada scraper visual.
Diffbot bisa sangat kuat untuk ekstraksi entity, parsing artikel/produk, enrichment, atau pemahaman web terstruktur skala besar. Biasanya ini bukan tool pertama bagi pengguna non-teknis yang hanya ingin meng-klik halaman dan mengekspor spreadsheet.
Akses gratis: Diffbot memiliki free plan dan model akses developer; cek harga Diffbot terbaru untuk mengetahui kredit dan syarat trial terkini.
Cocok untuk: tim teknis yang butuh ekstraksi terstruktur berbasis API, data knowledge graph, atau entity intelligence.
9. Crawl4AI
Crawl4AI adalah web crawler dan scraper open source yang ramah LLM untuk developer yang membangun AI agent, pipeline RAG, dan workflow data kustom. Tool ini bisa menghasilkan Markdown yang bersih, mengekstrak JSON terstruktur dengan CSS atau XPath, dan memakai LLM untuk membuat schema ekstraksi yang bisa dipakai ulang bila sesuai dengan pekerjaannya.
Crawl4AI adalah pilihan kuat saat hasil akhirnya harus menjadi bagian dari workflow engineering, bukan sekadar ekspor spreadsheet sekali pakai. Tool ini mendukung kontrol browser, crawling asinkron, session, dan opsi ekstraksi yang detail, tetapi tetap menuntut Python dan kepemilikan teknis.
Akses gratis: Open source tanpa API key wajib atau paywall platform. Namun ekstraksi berbasis LLM mungkin tetap memerlukan penyedia LLM atau model lokal.
Cocok untuk: developer yang membangun crawler siap-AI, ingestion RAG, atau pipeline data terstruktur yang bisa diulang.
10. Scrapling
Scrapling adalah framework scraping Python adaptif yang mencakup single request, fetching berbasis browser, hingga crawl penuh. Parsing adaptifnya dirancang untuk membantu menemukan ulang elemen halaman saat situs berubah, sehingga bisa mengurangi beban perbaikan selector dalam project scraping yang dimiliki kode.
Ini bukan tool AI no-code: tim tetap perlu mendefinisikan logika ekstraksi, mengujinya, dan mengelola runtime. Namun ini adalah pengganti modern yang layak untuk pintu masuk scraping visual lama karena dokumentasinya aktif dan lebih cocok untuk stack scraping Python saat ini.
Akses gratis: Open source. Infrastruktur, layanan proxy, run browser, dan waktu engineering tetap menjadi biaya terpisah.
Cocok untuk: developer Python yang menginginkan scraping adaptif dan jalur dari satu fetch hingga crawl konkuren.
Tabel Perbandingan: Free AI Web Scraping Tools
| Tool | Tipe | Jalur gratis | AI-native? | Paling cocok untuk |
|---|---|---|---|---|
| Thunderbit | AI Chrome scraper | Free starter usage | Ya | Pengguna bisnis yang butuh data web terstruktur dengan cepat |
| ParseHub | Visual scraper | Free tier terbatas | Sebagian | Project visual kecil |
| Octoparse | Platform scraping no-code | Free plan/trial | Sebagian hingga kuat | Power user dan job no-code berulang |
| Scrapy | Framework Python | Open source | Tidak, tapi coding berbantuan AI bisa | Developer yang membangun scraper kustom |
| Data Miner | Ekstensi browser | Penggunaan gratis terbatas | Terbatas | Tabel, list, scraping berbasis recipe |
| WebHarvy | Scraper visual Windows | Free trial | Terbatas | Scraping produk/gambar di desktop |
| Apify | Platform otomasi cloud | Kredit/free plan | AI-adjacent untuk developer | Pipeline scraping teknis |
| Diffbot | API ekstraksi AI | Kredit/free plan | Ya | Ekstraksi entity dan workflow knowledge graph |
| Crawl4AI | Crawler open source siap-AI | Open source | Ya/ramah LLM | RAG, AI agent, dan pipeline developer |
| Scrapling | Framework scraping Python adaptif | Open source | AI-adjacent/adaptif | Scraping berbasis kode yang butuh ketahanan selector |
Cara Memilih Tool yang Tepat
Mulailah dari sumber data dan penggunanya, bukan dari nama brand.
Kalau datanya ada di halaman web publik dan penggunanya non-teknis, mulai dari Thunderbit, ParseHub, Octoparse, atau Data Miner. Tool-tool ini lebih dekat dengan workflow bisnis yang nyata: buka sumber, tentukan field, jalankan tes, cek baris data, lalu ekspor.
Kalau tugasnya butuh logika kustom, penanganan autentikasi, orkestrasi, API, atau deployment, lihat Scrapy atau Apify. Di sinilah kepemilikan engineering masuk akal. Pakai AI untuk mempercepat review selector dan pembuatan tes, tetapi tetap pertahankan review manusia untuk kepatuhan, penanganan kegagalan, dan kualitas data.
Kalau perusahaan butuh ekstraksi entity berbasis API, enrichment, atau knowledge graph terstruktur, evaluasi Diffbot dan bandingkan syarat trial, cakupan data, serta kecocokan API-nya dengan kebutuhan Anda. Untuk managed data feed yang lebih luas, gunakan proses procurement khusus, bukan memperlakukannya sebagai pilihan scraper gratis.
Kalau situs atau dokumentasi tool terlihat tidak terawat, jangan gunakan untuk pekerjaan sensitif. Uji pada halaman publik yang aman, verifikasi ekspor, dan pastikan produk tersebut masih dipelihara.
Checklist Validasi Sederhana Sebelum Ekspor
Sebelum menjalankan scrape besar, uji sampel kecil:
- Apakah setiap baris mewakili entity yang benar?
- Apakah item sponsor, duplikat, atau rekomendasi ikut tercampur di data?
- Apakah pagination atau infinite scroll berhenti terlalu cepat?
- Apakah harga, tanggal, email, dan nomor telepon diparsing secara konsisten?
- Apakah field dari subpage dipasangkan ke baris induk yang tepat?
- Apakah format ekspor mempertahankan schema yang Anda butuhkan?
- Apakah Anda diizinkan mengumpulkan dan menggunakan data ini untuk tujuan Anda?
AI memang bisa mempercepat setup, tetapi juga bisa membuat hasil ekstraksi yang salah terlihat rapi. QA 20 baris tetap menjadi salah satu cara termurah untuk menghindari dataset yang buruk.
Rekomendasi Akhir
Untuk kebanyakan pengguna bisnis, mulailah dari workflow tercepat dan aman: gunakan AI scraper tanpa kode, uji pada sampel kecil, validasi schema, lalu ekspor ke sistem tempat pekerjaan akan dilanjutkan.
Thunderbit adalah pilihan terkuat saat pekerjaannya adalah data web publik dan pengguna menginginkan workflow AI yang praktis di browser. ParseHub, Octoparse, dan Data Miner layak dicoba jika Anda lebih suka visual project builder atau scraping berbasis recipe. Scrapy, Crawl4AI, Scrapling, dan Apify lebih baik saat scraper harus menjadi kode atau infrastruktur. Diffbot adalah opsi spesialis ketika ekstraksi entity atau data knowledge graph lebih penting daripada workflow berbasis browser.
Tool terbaik bukan yang punya daftar fitur terpanjang. Tool terbaik adalah yang memberi Anda data terstruktur yang andal dengan maintenance sesedikit mungkin untuk tim Anda.
FAQ
Apa itu AI web scraper?
AI web scraper menggunakan machine learning, LLM, computer vision, atau pemahaman halaman cerdas untuk membantu mengidentifikasi field, mengekstrak data terstruktur, atau beradaptasi dengan halaman web yang berantakan. Tool terbaik tetap memungkinkan Anda meninjau dan mengoreksi hasilnya.
Apakah free AI web scraper benar-benar gratis?
Sebagiannya punya starter usage gratis, sebagian lagi free trial, dan sebagian adalah open source. Gratis tidak selalu berarti gratis untuk skala besar. Periksa batas halaman, batas kredit, pembatasan ekspor, dan apakah cloud run disertakan.
AI web scraper gratis mana yang terbaik untuk pengguna non-teknis?
Thunderbit adalah titik awal terbaik untuk tim non-teknis yang ingin scraping website publik menjadi tabel terstruktur. ParseHub, Octoparse, dan Data Miner juga berguna tergantung apakah Anda lebih suka project visual, template, atau recipe browser.
Kapan saya harus memakai Scrapy atau Apify daripada no-code scraper?
Pakai Scrapy atau Apify saat Anda membutuhkan logika kustom, kontrol developer, API, penjadwalan, monitoring, atau integrasi ke workflow software yang lebih besar. Keduanya kuat, tetapi menuntut ownership lebih besar.
Apakah AI web scraper bisa menangani pagination dan subpage?
Banyak tool modern bisa, tetapi Anda tetap perlu menguji dengan hati-hati. Pagination, infinite scroll, dan subpage adalah titik umum di mana scraper berhenti terlalu cepat atau menempelkan data detail page ke baris yang salah.
Apakah legal melakukan scraping website?
Tergantung situsnya, jenis datanya, yurisdiksinya, dan kasus penggunaannya. Tinjau syarat situs, robots.txt, pembatasan login, kewajiban privasi, dan persyaratan kepatuhan internal sebelum mengumpulkan atau menggunakan data hasil scraping.
Pelajari Lebih Lanjut
- Cara Scrape Website Apa Pun dengan AI
- 5 Software Web Data Scraping Terbaik di 2026
- 7 Web Scraping Tools Paling Populer untuk Dipakai di 2026
- 10 AI Web Scraper Tools Terbaik untuk Meningkatkan Produktivitas di 2025
- 8 AI Web Scraper Terbaik untuk Ekstraksi Data yang Lebih Cerdas
Coba AI Web Scraper Get Started Free




