ה־PubMed Scraper של Thunderbit עוזר להפוך דפי PubMed למערכי נתונים נקיים ומובנים באמצעות AI. אפשר לחלץ מחקרים רפואיים פופולריים, ראיות מניסויים קליניים, תקצירים, מחברים, שיוכים מוסדיים, תאריכי פרסום, PMIDs וקישורי מאמרים — ואז לייצא ל־Excel, Google Sheets, Airtable או Notion. פשוט פותחים את PubMed ב־Chrome, נותנים ל־AI להציע את העמודות המתאימות ביותר, ומבצעים scraping.
🧬 מה זה PubMed Scraper
ה־PubMed Scraper הוא AI Web Scraper שנבנה עבור PubMed | US National Library of Medicine. עם Thunderbit (תוסף Chrome ל־AI web scraper), אפשר להיכנס לכל דף תוצאות ב־PubMed, ללחוץ על AI Suggest Columns, ואז על Scrape כדי לחלץ נתונים מובנים בלי לכתוב קוד.
🔎 מה אפשר לחלץ מ־PubMed
PubMed מלא במטא־דאטה ביו־רפואית בעלת ערך, אבל לא תמיד היא מגיעה מוכנה לניתוח. ה־AI Web Scraper של Thunderbit (https://thunderbit.com/) עוזר לאסוף ולארגן רשומות מ־PubMed, ולהעשיר אותן בפרטים ברמת המאמר באמצעות Subpage Scraping (פתיחה של כל דף מאמר והוספת שדות כמו תקציר, שיוכים מוסדיים, DOI ועוד).
להלן שני תהליכי עבודה נפוצים שאפשר להריץ בתוך דקות.
📈 ניטור מחקר רפואי חם ב־PubMed
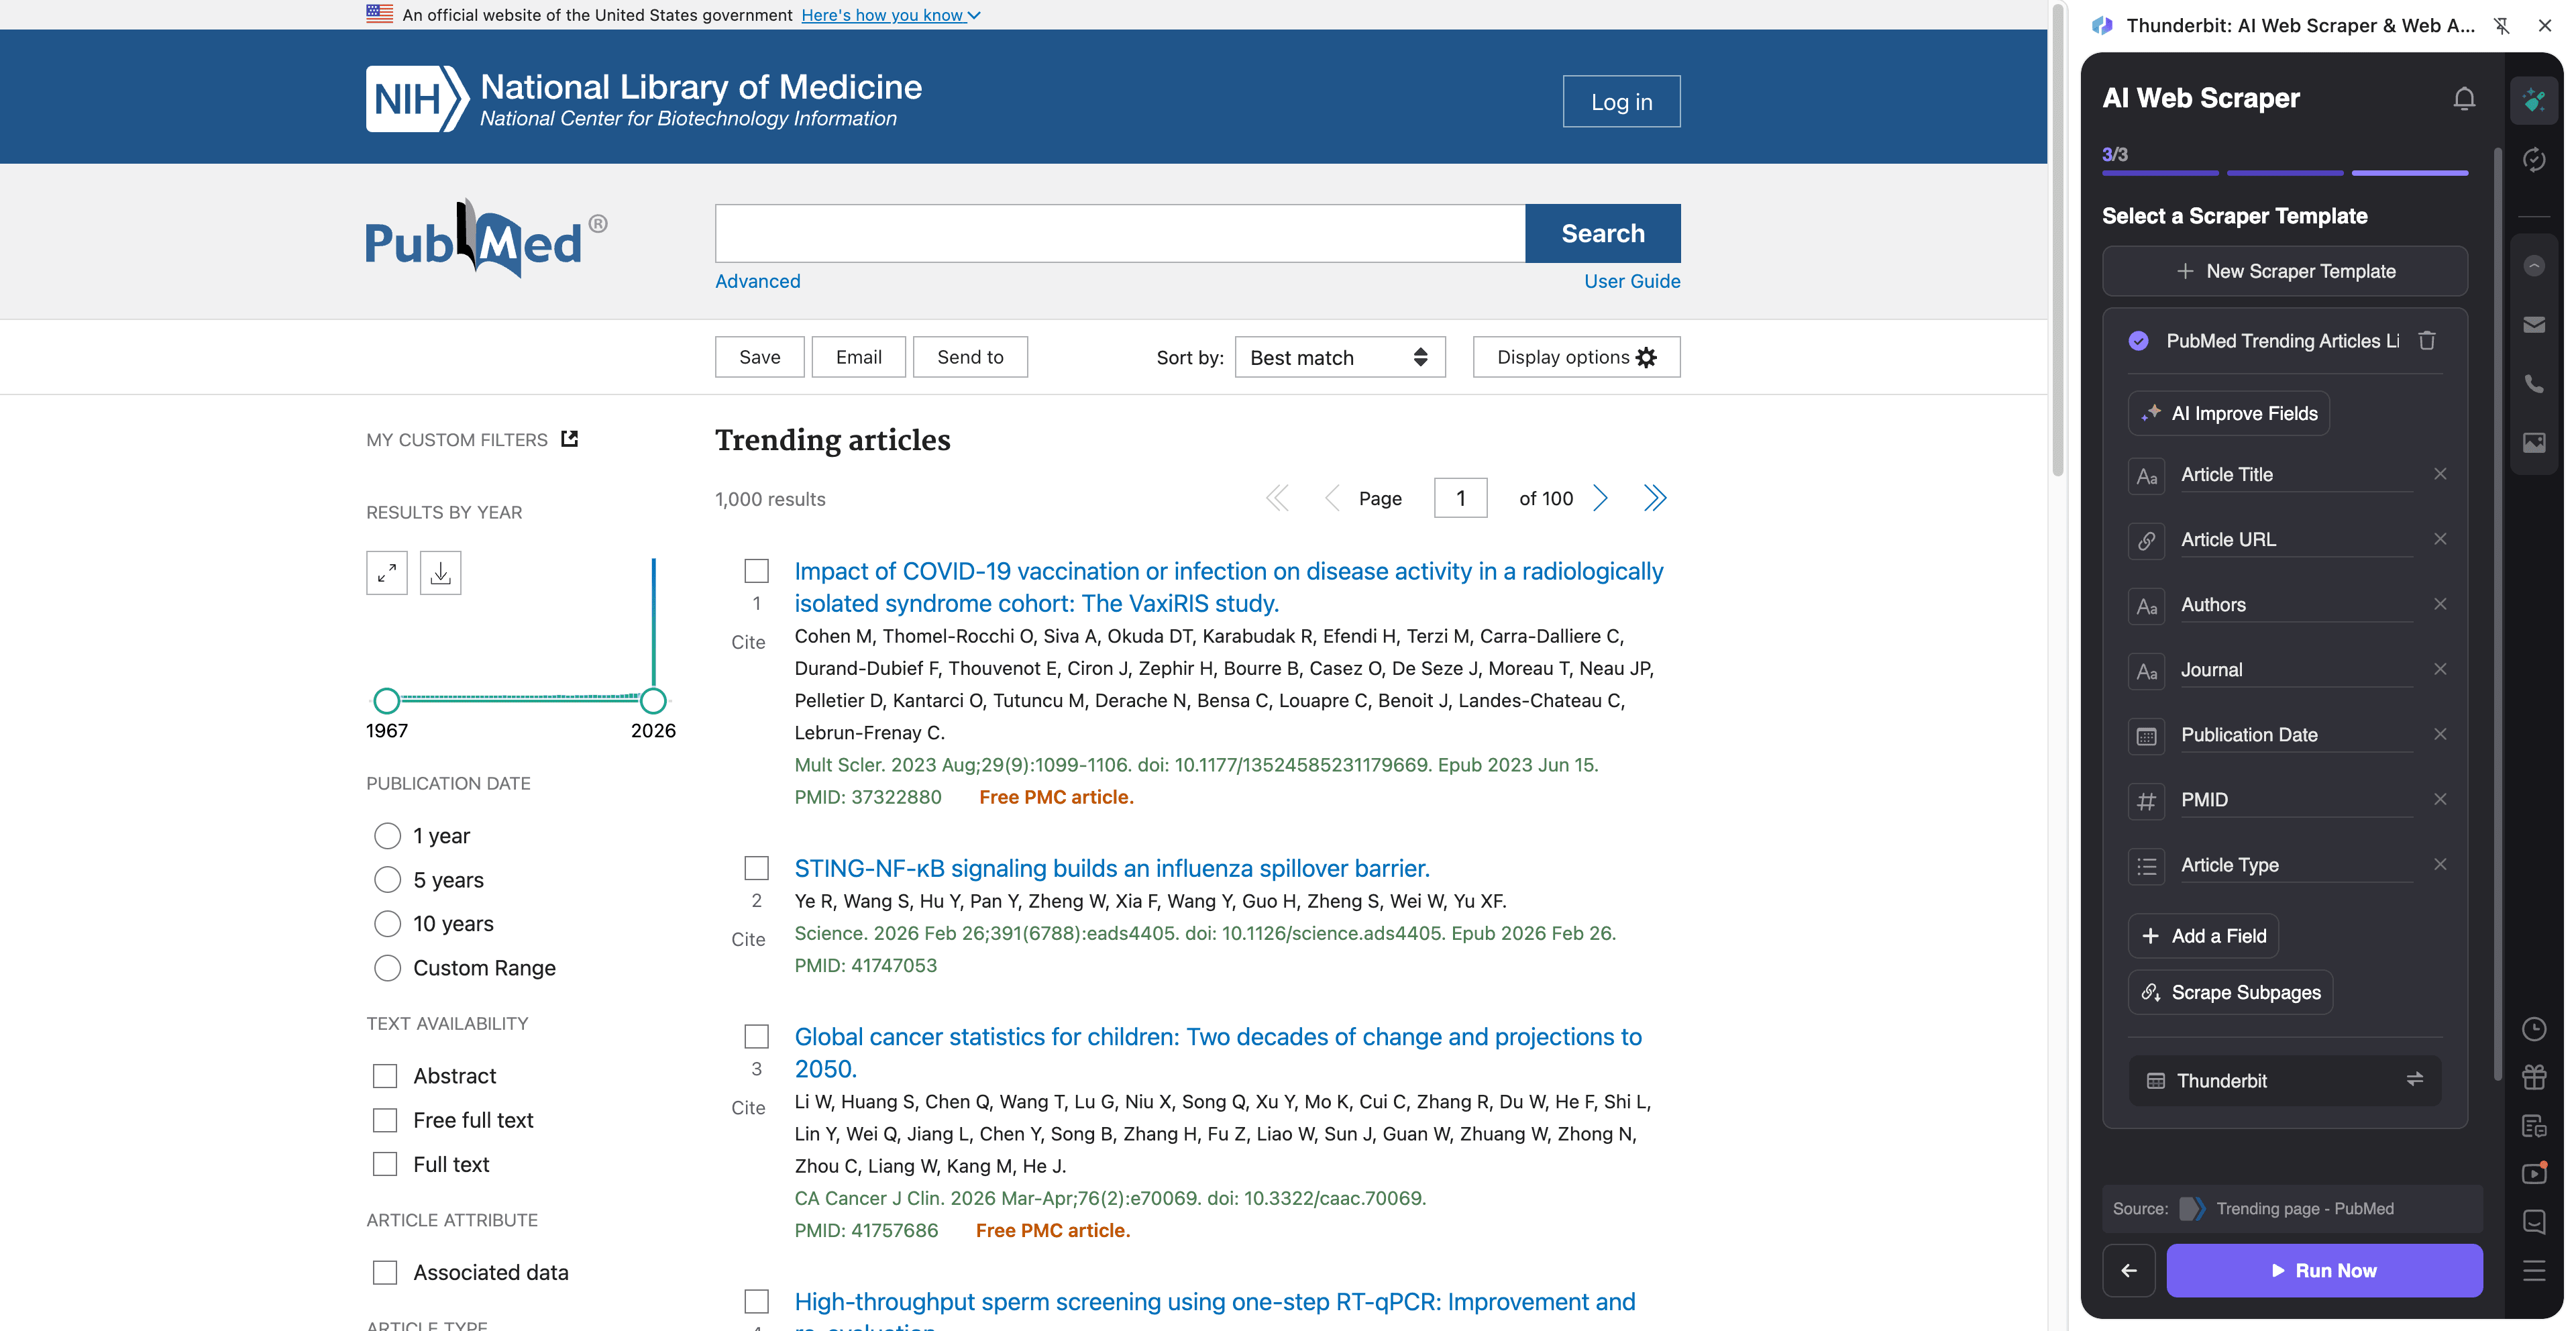
השתמשו בתהליך הזה כדי לעקוב אחר מה שחם כרגע במחקר רפואי בדף הטרנדים של PubMed. זה שימושי כדי להישאר מעודכנים, לבנות סיכומים פנימיים, לעקוב אחרי פרסומי מתחרים או להזין צינור ניטור ספרות מקצועית.
דוגמת דף יעד: PubMed Trending
שלבים:
- הורידו את תוסף Thunderbit ל־Chrome ופתחו חשבון.
- עברו לדף היעד, למשל: PubMed Trending.
- לחצו על AI Suggest Columns כדי לתת ל־AI להמליץ על שמות העמודות וסוגי הנתונים המתאימים.
- לחצו על Scrape כדי לחלץ את הנתונים, ואז ייצאו ל־Excel, Google Sheets, Airtable או Notion.
שמות עמודות
| עמודה | תיאור |
|---|---|
| 🧾 כותרת המאמר | כותרת המאמר הפופולרי ב־PubMed. |
| 🔗 כתובת המאמר | קישור ישיר לדף הרשומה ב־PubMed. |
| 🆔 PMID | מזהה PubMed של הרשומה (שימושי כמפתח יציב). |
| 🏛️ כתב עת | שם כתב העת שבו המאמר פורסם. |
| 📅 תאריך פרסום | תאריך הפרסום שמופיע ברשימה. |
| ✍️ מחברים | רשימת המחברים כפי שמופיעה בכרטיס התוצאה. |
| 🧪 סוג המאמר | סוג הפרסום, כשזמין (למשל Review, Clinical Trial). |
| 🏷️ מילות מפתח / נושאים | תגיות נושא או מילות מפתח גלויות ברשומה (אם קיימות). |
| 📝 תקציר קצר / סיכום | טקסט קצר שמופיע ברשומה (אם קיים). |
| 🧷 DOI | DOI כשזמין (לרוב הכי טוב לחלץ דרך Subpage Scraping). |
| 🧑🔬 שיוכים מוסדיים | שיוכי המחברים (בדרך כלל מחולצים דרך Subpage Scraping). |
| 📄 תקציר | טקסט התקציר המלא (בדרך כלל מחולץ דרך Subpage Scraping). |
🧫 חילוץ ראיות מניסויים קליניים מ־PubMed
השתמשו בתהליך הזה כדי לחלץ ראיות הקשורות לניסויים קליניים מתוצאות החיפוש ב־PubMed, ואז להעשיר כל שורה על ידי כניסה לדף המאמר כדי לתפוס תקציר, סימנים לניסוי ומטא־דאטה שנדרשים לסקירה.
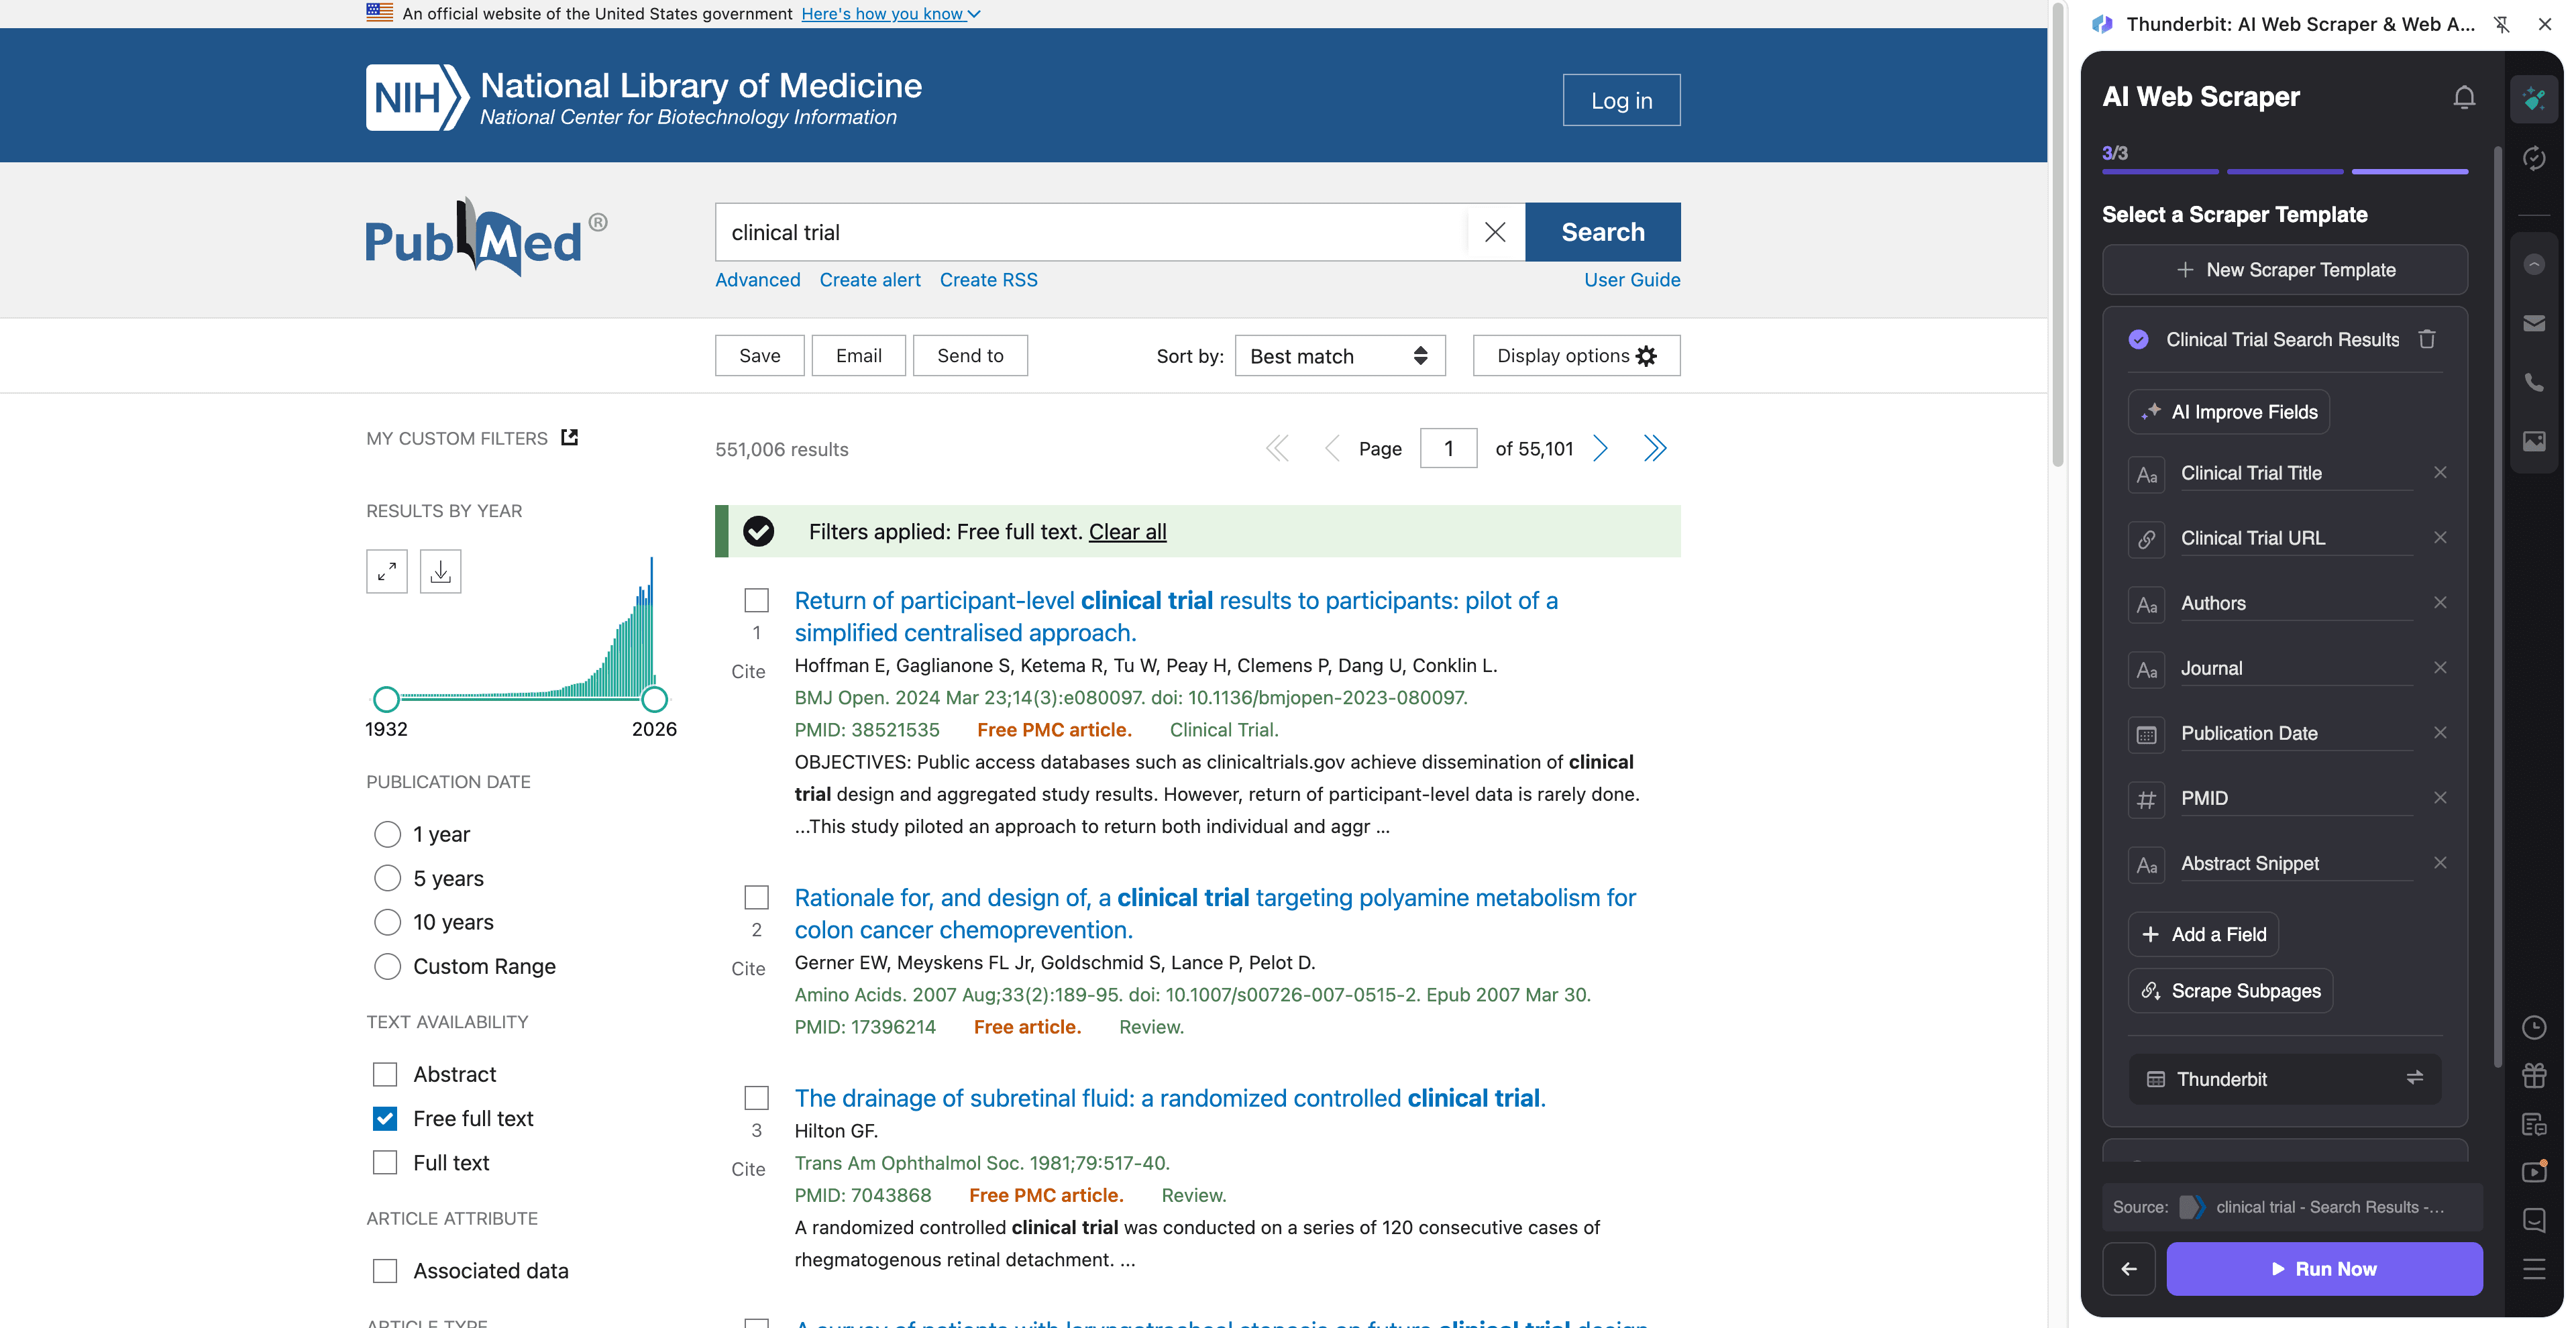
דוגמת דף יעד: תוצאות חיפוש לניסויים קליניים
שלבים:
- הורידו את תוסף Thunderbit ל־Chrome ופתחו חשבון.
- עברו לדף היעד, למשל: תוצאות חיפוש לניסויים קליניים.
- לחצו על AI Suggest Columns כדי לייצר שדות מומלצים (אפשר לשנות שמות או להוסיף שדות משלכם).
- לחצו על Scrape כדי לאסוף את התוצאות, ואז השתמשו ב־Scrape Subpages כדי להעשיר כל שורה בתקציר, שיוכים מוסדיים, DOI ועוד.
שמות עמודות
| עמודה | תיאור |
|---|---|
| 🧾 כותרת | כותרת המאמר מתוך תוצאות החיפוש. |
| 🔗 כתובת PubMed | קישור לדף המאמר ב־PubMed לצורך העשרה דרך דפי משנה. |
| 🆔 PMID | מזהה PubMed לשם מניעת כפילויות ולצורך הפניה. |
| 🧑⚕️ מחברים | המחברים שמופיעים בתקציר התוצאה. |
| 🏛️ כתב עת | שם כתב העת ופרטי הציטוט שמופיעים בתוצאות. |
| 📅 תאריך | תאריך פרסום (או ePub) שמופיע ברשומה. |
| 🧪 סוג פרסום | סימונים כמו Clinical Trial, Randomized Controlled Trial, Meta-Analysis (לעיתים ברור יותר בדף המאמר). |
| 🧾 תקציר | הטקסט המלא של התקציר (מומלץ דרך Subpage Scraping). |
| 🧬 מונחי MeSH | מונחי Medical Subject Headings כשזמינים (לעיתים בדף המאמר). |
| 🧷 DOI | DOI לקישור לדפי המו״ל ולמנהלי מקורות. |
| 🏥 שיוכים מוסדיים | שיוכי המחברים לניתוח מוסדות (Subpage Scraping). |
| 🌍 מדינה / מוסד | ניתוח מתוך השיוכים באמצעות Field AI Prompts (אופציונלי). |
| 🔍 מילות מפתח לניסוי קליני | תיוגי AI כמו “randomized”, “double-blind”, “placebo” (אופציונלי דרך Field AI Prompt). |
| 📎 קישורי טקסט מלא | קישורים יוצאים למו״ל או לטקסט מלא חינמי כשקיימים. |
🎯 למה להשתמש בכלי ל־PubMed
Scraping של PubMed נועד למהירות, עקביות, והפיכת נתוני מחקר לשימושיים לאורך תהליך העבודה שלכם. במקום להעתיק ציטוטים אחד־אחד, אפשר לבנות מערך נתונים מובנה שניתן לסנן, לתייג ולשתף.
סיבות נפוצות שבגללן צוותים מחלצים נתונים מ־PubMed:
- צוותי medical affairs ופרמצבטיקה: מעקב אחר פרסומים חדשים בתחום טיפולי, ניטור ניסויים של מתחרים ובניית טבלאות ראיות לסקירות פנימיות.
- ביוטק ו־clinical operations: איסוף פרסומים הקשורים לניסויים, מיפוי מוסדות וחוקרים, ושמירה על ביבליוגרפיה חיה.
- צוותי שיווק ותוכן בתחום הבריאות: זיהוי נושאים חמים, כתבי עת בעלי השפעה ומילות מפתח חדשות לתכנון תוכן.
- חוקרים אקדמיים וספרנים: בניית מערכי נתונים לסקירות ספרות, מניעת כפילויות לפי PMID, וייצוא לגיליונות עבודה לסינון.
- צוותי דאטה: יצירת קלט מובנה לניתוחים מתקדמים, דשבורדים או מאגרי ידע פנימיים.
Thunderbit מועיל במיוחד כשצריך יותר מאשר רק את דף הרשימה. עם Subpage Scraping, אפשר לחלץ תקצירים, שיוכים מוסדיים, DOI, מונחי MeSH וקישורי טקסט מלא בהיקף רחב.
🧩 איך להשתמש בתוסף Chrome ל־PubMed
- התקינו את תוסף Thunderbit ל־Chrome: הורידו אותו מ־Chrome Web Store וצרו חשבון.
- עברו לדף PubMed: פתחו את PubMed, דף טרנדים כמו Trending, או שאילתה כמו clinical trial results.
- הפעילו את הסקרייפר מבוסס ה־AI: לחצו על AI Suggest Columns כדי ליצור שדות, התאימו סוגי נתונים (text/date/url), והוסיפו Field AI Prompts אופציונליים (לתיווג, עיצוב או חילוץ סימנים לניסוי).
- בצעו Scrape וייצוא: לחצו על Scrape. אם צריך תקצירים/שיוכים/MeSH, הפעילו Scrape Subpages כדי להעשיר כל שורה, ואז ייצאו ל־Excel, Google Sheets, Airtable או Notion.
קריאה מועילה אם אתם בונים תהליך עבודה שחוזר על עצמו:
- איך לגרד כל אתר באמצעות AI
- מה זה Data Scraping ואיך עושים את זה ב־2025
- איך לגרד נתוני אתר ל־Excel באמצעות AI
- מה זה List Crawling ואיך עושים את זה באמצעות AI
💳 תמחור ל־PubMed
Thunderbit משתמש במערכת קרדיטים פשוטה:
- 1 קרדיט = שורת פלט אחת בטבלת התוצאות שלכם (למשל רשומת PubMed אחת).
- הייצוא נתונים בחינם: הורדה כ־CSV/JSON או שליחה ל־Excel, Google Sheets, Airtable או Notion.
אפשר להתחיל עם:
- תוכנית חינמית: scraping של 6 דפים בחודש (הקצאה לפי דפים בתוכנית החינמית).
- ניסיון חינם: scraping של 10 דפים בחינם, אידיאלי לבדיקה של דפי PubMed Trending ומספר דפי תוצאות של ניסויים קליניים.
אם אתם מבצעים scraping באופן קבוע (ניטור שבועי, עדכוני ראיות או שאילתות גדולות), מסלולים בתשלום נותנים יותר קרדיטים. התוכנית השנתית לרוב משתלמת יותר, כי היא כוללת הנחה לעומת תשלום חודשי.
אפשר לבדוק את האפשרויות ב־Thunderbit Pricing.
❓ FAQ
-
מהו ה־AI Powered PubMed Scraper?
ה־AI Powered PubMed Scraper הוא תהליך עבודה ב־Thunderbit שמחלץ נתונים מובנים מתוצאות חיפוש ומדפי מאמרים ב־PubMed. אפשר להשתמש ב־AI כדי להציע עמודות, לגרד רשימות, ולהעשיר כל שורה על ידי כניסה לדפי משנה של מאמרים כדי לחלץ תקצירים, שיוכים מוסדיים, DOI ועוד. -
מה זה Thunderbit?
Thunderbit הוא תוסף Chrome ל־AI web scraper שנבנה עבור תהליכי עבודה עסקיים ומחקריים שבהם צריך נתונים מובנים מאתרים. הוא עוזר לחלץ, לתייג ולייצא נתונים במהירות, בלי לבנות או לתחזק סקריפטים של scraping. -
אפשר לגרד דפי טרנדים של PubMed וגם תוצאות חיפוש רגילות?
כן. אפשר לגרד את דף PubMed Trending, חיפושי מילות מפתח רגילים, ודפי תוצאות מסוננים (כמו שאילתות ממוקדות ניסויים קליניים). ה־AI של Thunderbit מתאים את עצמו לפריסות שונות על ידי קריאת הדף והצעת שדות. -
האם Thunderbit יכול לחלץ תקצירים, שיוכים מוסדיים ומונחי MeSH?
כן, וזה המקום שבו Subpage Scraping מועיל במיוחד. אפשר קודם לגרד את רשימת התוצאות, ואז לתת ל־Thunderbit לפתוח כל דף רשומה ב־PubMed כדי לחלץ טקסט תקציר, שיוכים מוסדיים, מונחי MeSH, DOI ומטא־דאטה נוספת לאותה טבלה. -
איך עובדת חלוקה לעמודים וגלילה אינסופית ב־PubMed?
Thunderbit תומך ב־pagination scraping, כולל ניווט מסוג “next page”. אם PubMed משנה את אופן טעינת התוצאות, החילוץ מבוסס ה־AI נועד להיות עמיד יותר מבחירה קשיחה של selectors, כי הוא קורא מחדש את מבנה הדף בכל הרצה. -
לאילו פורמטים אפשר לייצא נתוני PubMed?
אפשר לייצא ל־CSV או JSON, או לשלוח את מערך הנתונים ל־Excel, Google Sheets, Airtable או Notion. זה שימושי לתהליכי סינון, טבלאות ראיות, דשבורדים ושיתוף עם משתפי פעולה. -
כמה רשומות PubMed אפשר לגרד בחינם?
בתוכנית החינמית אפשר לגרד 6 דפים בחודש, וזה לרוב מספיק למשימות ניטור קטנות. עם תקופת הניסיון החינמית אפשר לגרד 10 דפים בחינם כדי לאמת את הגדרת העמודות ואסטרטגיית העשרת דפי המשנה. -
אפשר להתאים עמודות לצרכי חילוץ ראיות ספציפיים?
כן. אפשר לשנות שמות של עמודות, להגדיר סוגי נתונים (text/date/url), ולהוסיף Field AI Prompts כדי לחלץ או לתייג מידע כמו מילות מפתח של עיצוב ניסוי, אוכלוסייה, התערבות, השוואה, תוצאות או מדינה מתוך השיוכים. כך אפשר לעבור מ־scraping גולמי להכנת ראיות מובנית. -
מותר לגרד את PubMed?
PubMed הוא משאב ציבורי, וצוותים רבים אוספים ממנו מטא־דאטה ביבליוגרפית למחקר וניתוח. עם זאת, עדיין חשוב לפעול לפי החוקים החלים, לכבד את תנאי האתר, ולהקפיד על שיטות scraping אחראיות, במיוחד בהרצות גדולות ותכופות.
📚 למידע נוסף
- הורדת התוסף: Thunderbit Chrome Extension Download Page
- מדריכים נוספים ב־Thunderbit Blog
- למדו את היסודות: מה זה Data Scraping ואיך עושים את זה ב־2025
- בנו תהליכי עבודה לרשימות: מה זה List Crawling ואיך עושים את זה באמצעות AI
- ייצוא לגיליונות: איך לגרד נתוני אתר ל־Excel באמצעות AI
- אם אתם גם מחלצים PDF-ים בתהליכי מחקר: איך לגרד נתונים מ־PDF באמצעות AI