
השנה היא 2026, ואם אתם עובדים במכירות, בתפעול או כמעט בכל תפקיד עסקי אחר, סביר להניח שכבר שמתם לב שהאינטרנט הוא גם החבר הכי טוב שלכם וגם בזבוז הזמן הכי גדול. יש שם יותר מידע שימושי מאי פעם — לידים, מחירים, ביקורות, מהלכים של מתחרים — אבל איך באמת מעבירים את כל התוכן הזה לגיליון או לדשבורד? כאן הדברים מתחילים להיות מעניינים. ראיתי צוותים מבזבזים שעות על העתקה והדבקה, ובסוף נשארים עם נתונים מבולגנים, לא מעודכנים, ועם תחושת שחיקה קשה מול אקסל.
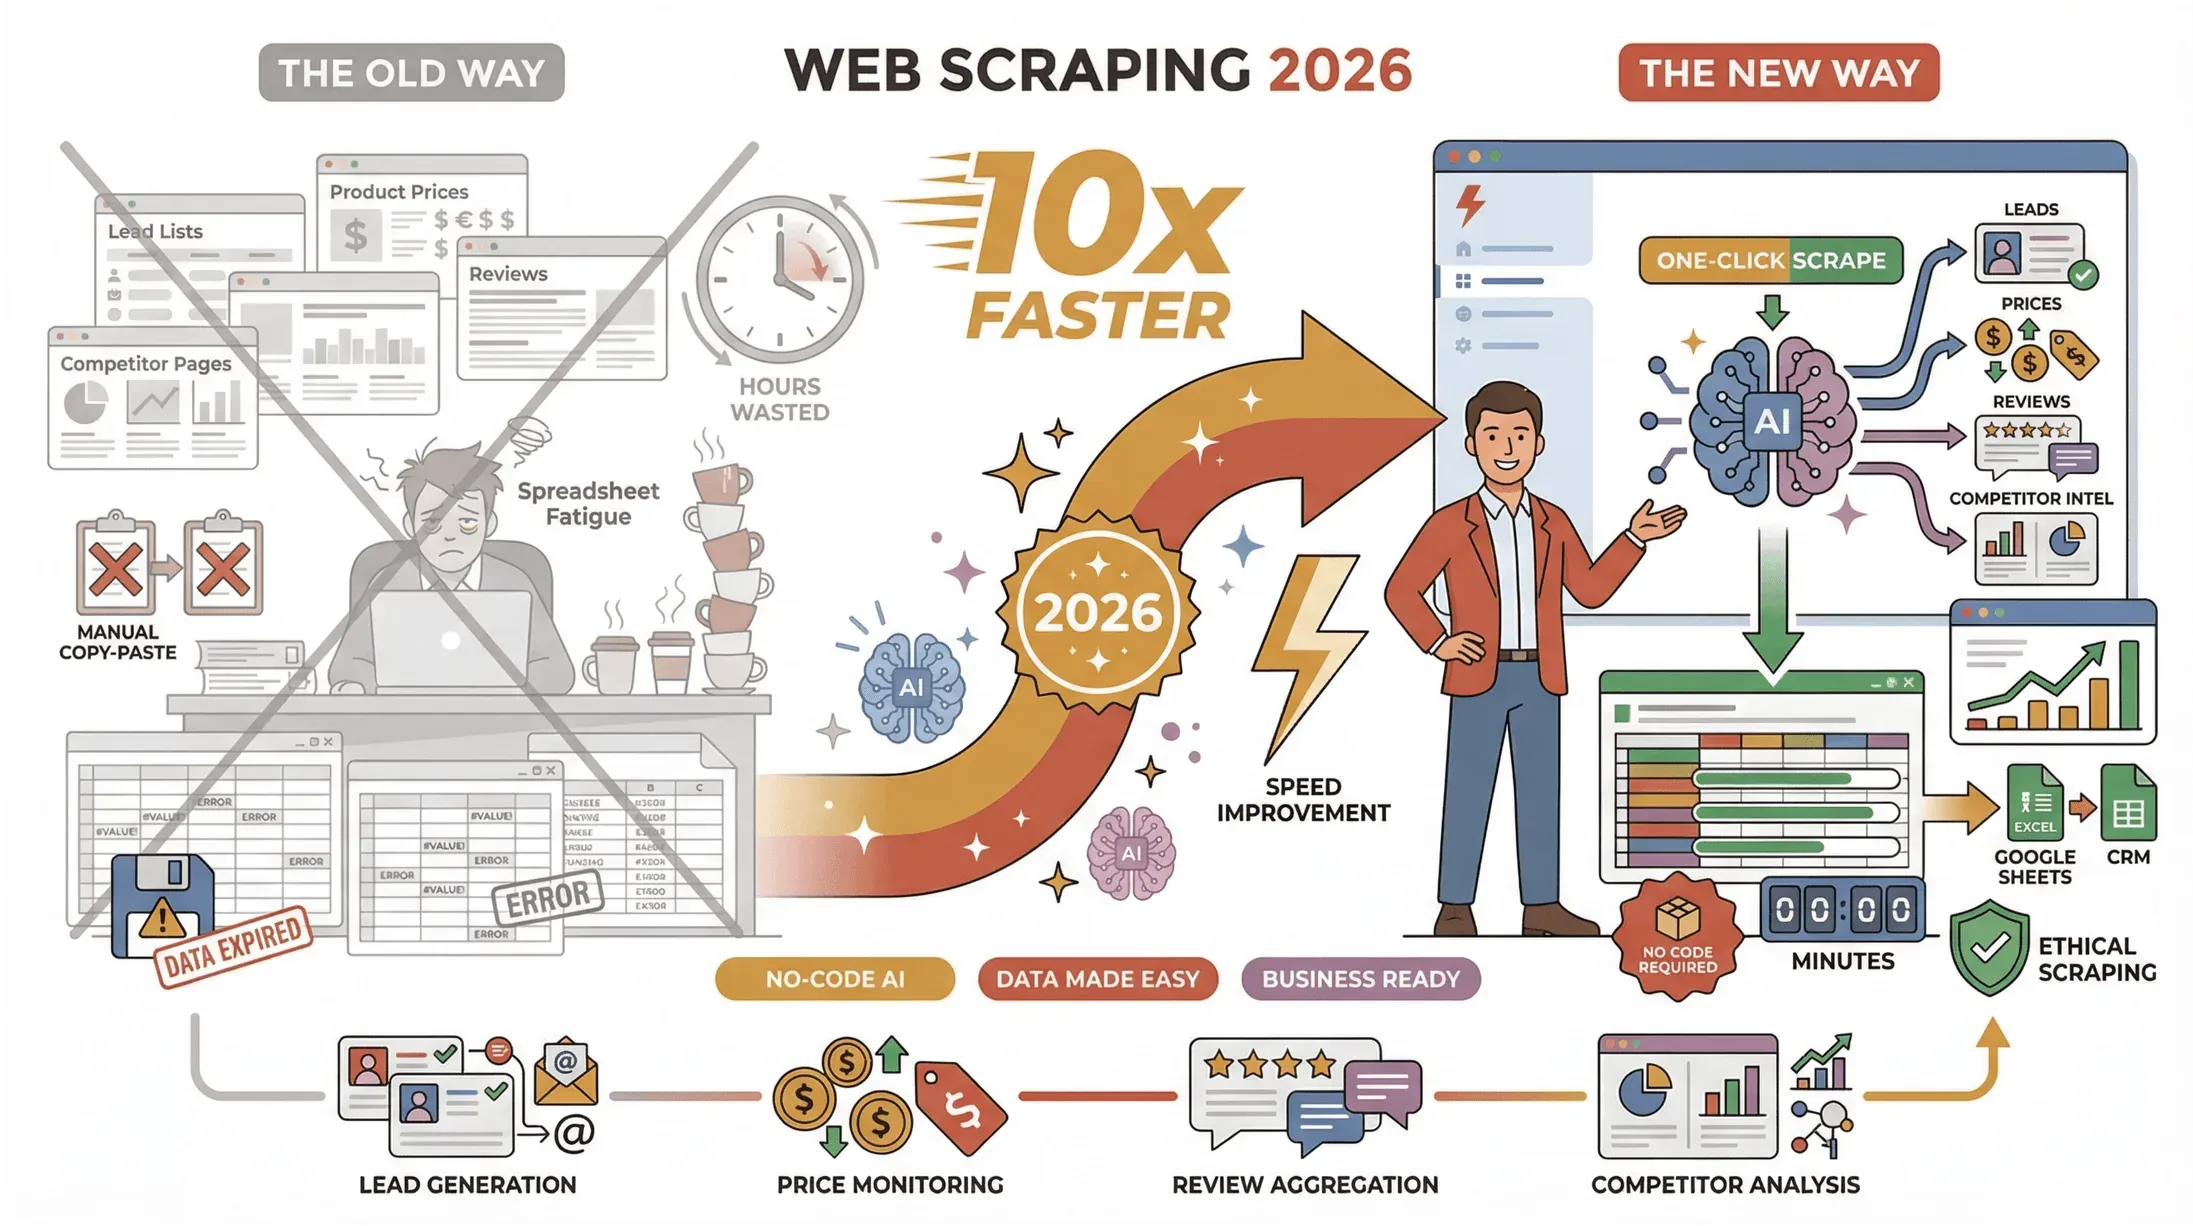
והחדשות הטובות הן שגירוד תוכן מאתרים אחרים לא חייב להיות משימה מעיקה ששמורה למפתחים או למדעני נתונים. עם העלייה של כלים מבוססי AI ללא קוד כמו Thunderbit, גם משתמשים בלי רקע טכני יכולים לשלוף את הנתונים שהם צריכים — מהר, במדויק, ובלי כאב ראש. במדריך הזה אסביר מה באמת אומר Web Scraping, למה הוא הפך לכלי חיוני לעסקים מודרניים, ואיך אפשר להתחיל לגרד תוכן מאתרים ביעילות (ובצורה חוקית) בשנת 2026. בין אם אתם מתחילים לגמרי ובין אם אתם רק רוצים לייעל את תהליך העבודה שלכם — הגעתם למקום הנכון.
מה המשמעות של "גירוד תוכן מאתרים אחרים"?
נפרק את זה: גירוד תוכן מאתרים אחרים פשוט אומר שימוש בתוכנה כדי לחלץ מידע מדפי אינטרנט באופן אוטומטי ולארגן אותו בפורמט מובנה — כמו טבלאות, גיליונות אלקטרוניים או מסדי נתונים. במקום להעתיק ידנית פרטי מוצרים, אנשי קשר עסקיים או ביקורות, כלי גירוד עושה עבורכם את העבודה הקשה (ParseHub).
הנה אנלוגיה קצרה: דמיינו שאתם בספרייה, ובמקום לרשום הערות ביד מכל ספר, יש לכם עוזר רובוטי שסורק את הדפים ומחזיר לכם סיכום מסודר. זה בדיוק מה ש-Web Scraping עושה עבור האינטרנט.
למה אנשים מגרדים תוכן מאתרים?
- יצירת לידים: שליפת שמות, אימיילים ומספרי טלפון ממדריכים או מרשימות עסקים.
- ניתוח מתחרים: מעקב אחר מחירים, השקות מוצרים או ביקורות באתרי מסחר אלקטרוני.
- מחקר שוק: איסוף חדשות, פוסטים בבלוגים או דיונים בפורומים כדי לזהות מגמות.
- אגרגציית תוכן: איסוף מאמרים או משאבים לניוזלטרים או לבסיסי ידע פנימיים.
ההבדל בין העתקה-הדבקה ידנית לבין גירוד אוטומטי הוא שמיים וארץ: גירוד מהיר יותר, מדויק יותר, ויכול להתרחב לאלפי דפים בתוך דקות (Outscraper).
למה גירוד תוכן מאתרים אחרים חשוב למשתמשים עסקיים
מה זה Data Scraping ואיך עושים את זה ב-2026 Get Started Free
אם אתם עדיין נשענים על מחקר ידני, אתם מפספסים את המהירות והחכמה שצוותים מודרניים משתמשים בהן כדי להתקדם. חברות מונחות-נתונים מגבירות פרודוקטיביות בכמעט 63%, ו-2026 — השנה הזו — הייתה השנה שבה אנליסטים סימנו עבור 65% מהארגונים מעבר מלא לפעולה מבוססת-נתונים.
כך גירוד תוכן מאתרים אחרים מייצר ערך עסקי אמיתי:
| שימוש | מה לגרד | היתרון |
|---|---|---|
| יצירת לידים | מדריכי עסקים, LinkedIn, דפי זהב | בניית רשימות לידים ממוקדות והאצת צינור המכירות |
| מעקב מחירים | רישומי מוצרים של מתחרים, אתרי e-commerce | התאמת אסטרטגיית התמחור בזמן אמת |
| תובנות לקוחות | ביקורות, פוסטים ברשתות חברתיות, פורומים | ניתוח משוב, זיהוי מגמות ושיפור מוצרים |
| אגרגציית תוכן | אתרי חדשות, בלוגים, פורומים מקצועיים | אצירת חדשות מהתחום והזנת שיווק התוכן |
אוטומציה של המשימות האלה לא רק חוסכת זמן — היא גם מאפשרת קבלת החלטות טובה ומהירה יותר ומשחררת את הצוות להתמקד במה שבאמת חשוב (Ujeebu).
איך לבחור את כלי ה-Web Scraping הנכון: מדריך למתחילים
אם אתם חדשים בגירוד תוכן מאתרים אחרים, ההחלטה הראשונה והחשובה היא לבחור את הכלי הנכון. הנה מה שלמדתי — לפעמים בדרך הקשה: הבחירה צריכה להיות תלויה בנוחות הטכנית שלכם, במורכבות האתרים שאתם רוצים לגרד, ובמהירות שבה אתם רוצים לראות תוצאות.
הסוגים העיקריים של כלי Web Scraping:
- כלים מבוססי קוד (למשל Python עם BeautifulSoup או Scrapy): גמישות מקסימלית, אבל צריך לדעת לתכנת. מתאים בעיקר למפתחים או לצוותים עם תמיכת IT.
- כלים ללא קוד (למשל ParseHub, Octoparse): ממשקים חזותיים, תבניות ותהליכי עבודה של נקודה ולחיצה. מעולים למי שלא כותב קוד, אבל יכולים להסתבך באתרים מאתגרים.
- תוספי דפדפן (למשל Thunderbit, Web Scraper): פועלים ישירות ב-Chrome, קלים להתקנה ומתאימים במיוחד לגירודים מהירים וממוקדים.
עבור רוב המשתמשים העסקיים — ובמיוחד מתחילים — קלות שימוש היא הכול. לכן אני ממליץ להתחיל עם תוסף דפדפן כמו Thunderbit. הוא נבנה עבור משתמשים לא טכניים ומשתמש ב-AI כדי להפוך את ההגדרה לפשוטה במיוחד.
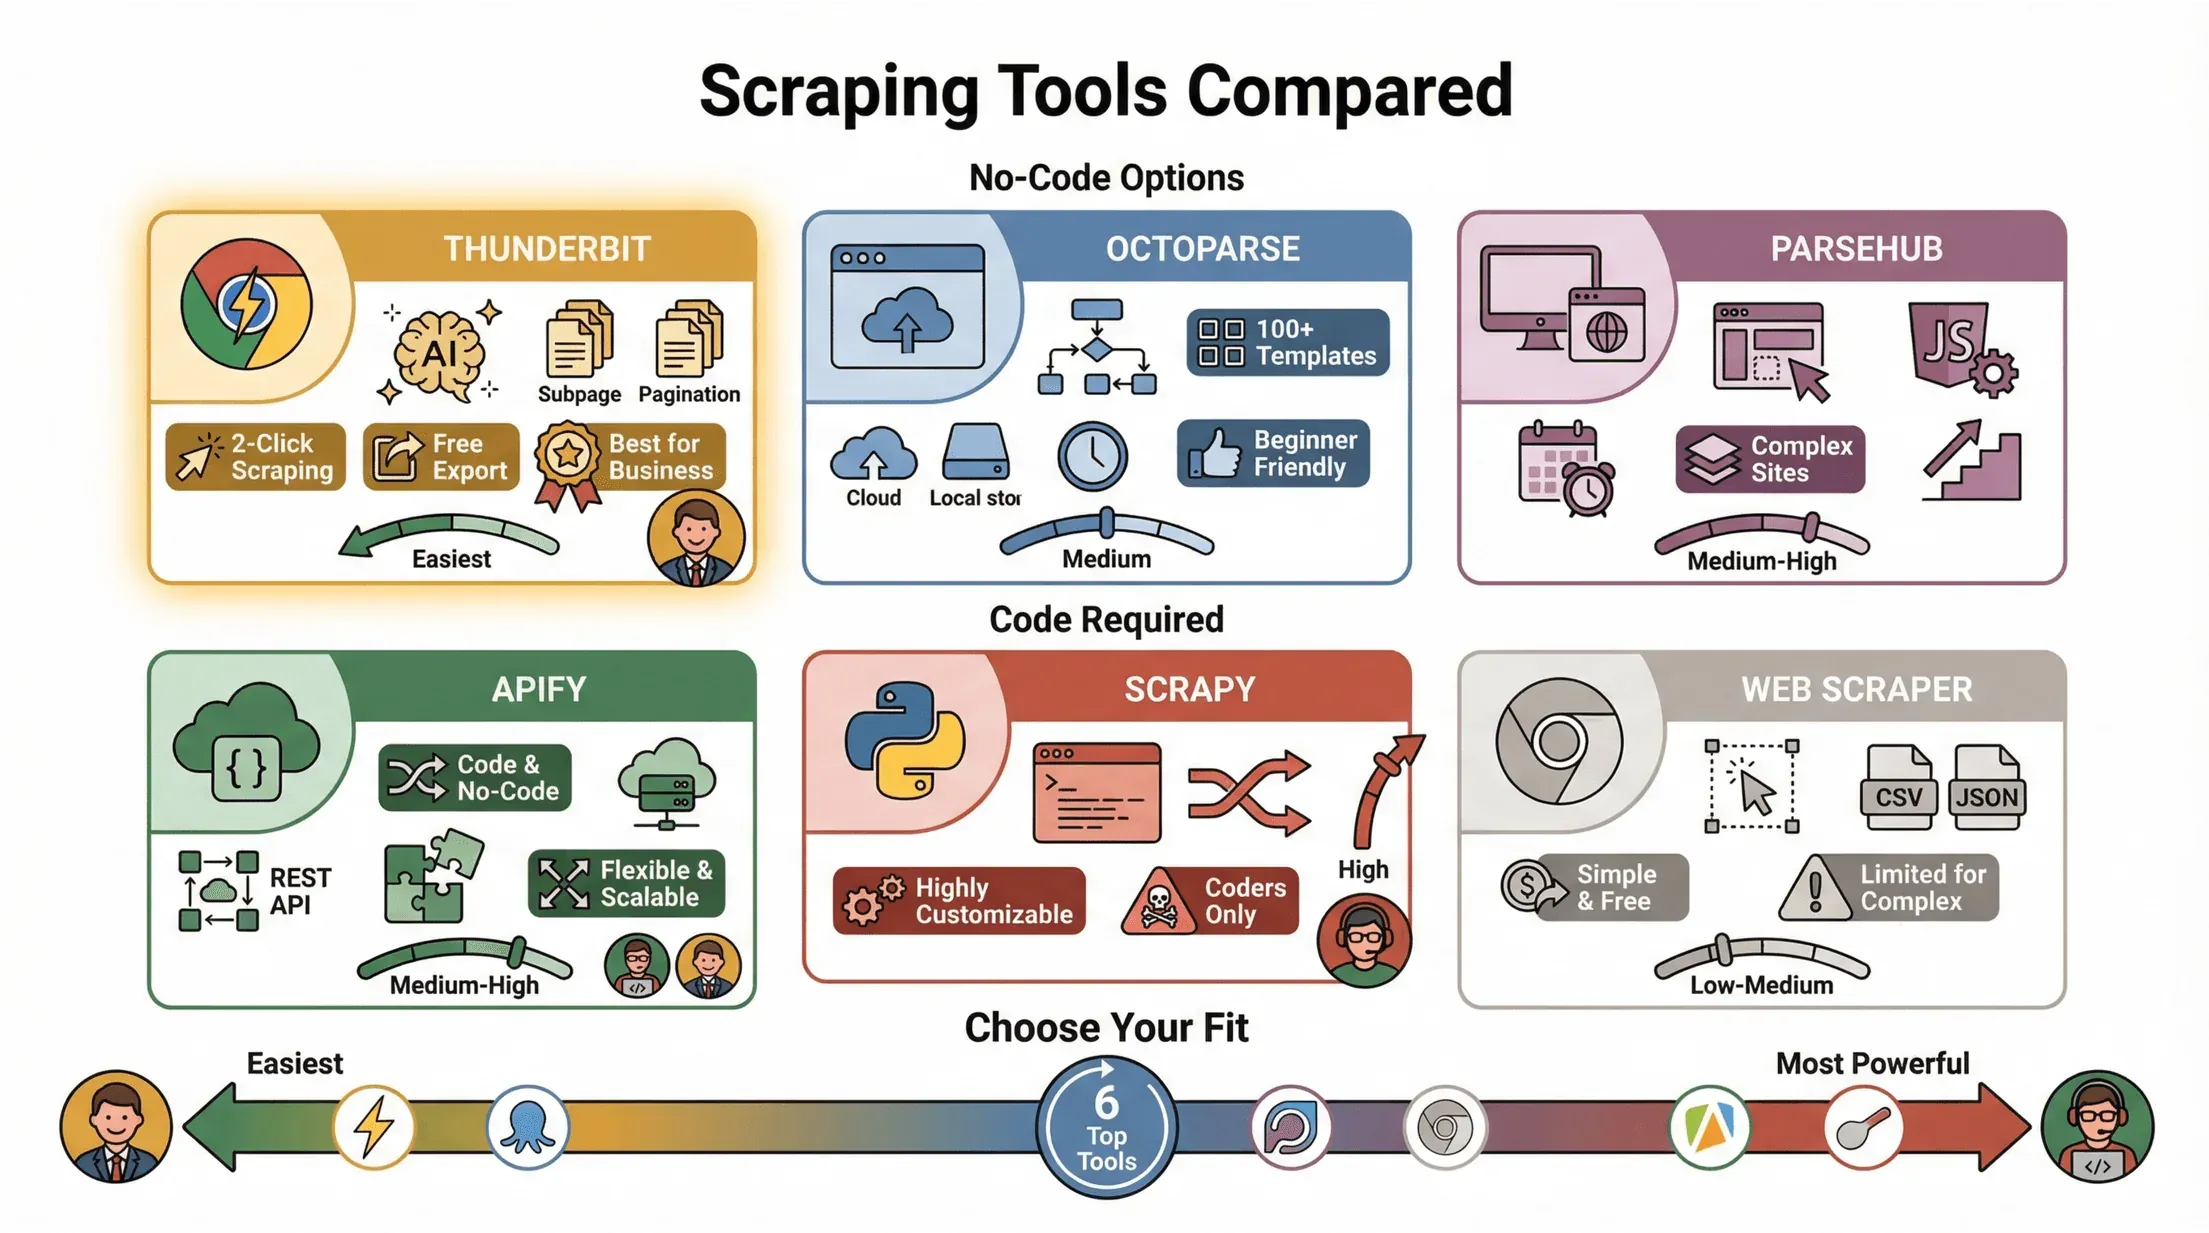
השוואה בין כלי Web Scraping פופולריים
בואו נראה איך כמה מהכלים המובילים משתווים כשמדובר בגירוד תוכן מאתרים אחרים:
| כלי | סוג | תכונות עיקריות | יתרונות / חסרונות |
|---|---|---|---|
| Thunderbit | תוסף Chrome, AI | גירוד ב-2 קליקים, הצעות שדות מבוססות AI, תמיכה בתתי-דפים ובחלוקה לעמודים, ייצוא חינמי | קל במיוחד, ללא קוד, מצוין למשתמשים עסקיים |
| Octoparse | אפליקציית Desktop, ללא קוד | תהליך עבודה חזותי, מעל 100 תבניות, ענן/מקומי, תזמון | נוח למתחילים, אך הגרסה החינמית מוגבלת |
| ParseHub | Desktop/Web, ללא קוד | בונה חזותי, מתמודד עם דפים דינמיים/כבדי JS, תזמון | טוב לאתרים מורכבים, אבל עקומת למידה תלולה יותר |
| Apify | ענן/קוד/ללא קוד | קוד וללא קוד, serverless, REST API, אינטגרציות | גמיש, ניתן להרחבה, נדרש קצת ידע טכני |
| Scrapy | ספריית Python, קוד | זחילה אסינכרונית, ניתן להתאמה גבוהה | עוצמתי, אבל מיועד רק למתכנתים |
| Web Scraper | תוסף Chrome, ללא קוד | בחירה חזותית, ייצוא CSV/JSON | פשוט, חינמי, אבל מוגבל באתרים מורכבים |
עבור רוב המשתמשים העסקיים, Thunderbit ו-Octoparse הם הכי קלים להתחלה (ScrapingLab).
היתרונות הייחודיים של Thunderbit לגירוד תוכן מאתרים אחרים
איך לגרד כל אתר באמצעות AI Get Started Free
עכשיו, תנו לי לשים לרגע את כובע ה-Thunderbit שלי (טוב, יותר כמו קפוצ'ון דיגיטלי): מה שמבדיל את Thunderbit הוא עד כמה הוא ידידותי למתחילים ולמשתמשים עסקיים.
כך Thunderbit בולט מעל כולם:
- ממשק בשפה טבעית: פשוט מתארים מה רוצים (“לשלוף את כל הביקורות והדירוגים מהעמוד הזה”), וה-AI של Thunderbit כבר מבין את השאר.
- AI Suggest Fields ו-Improve Fields: Thunderbit סורק את הדף וממליץ על העמודות הטובות ביותר לחילוץ — שמות, מחירים, אימיילים, כל מה שתרצו. בלי להתעסק בסלקטורים או בקוד.
- תהליך עבודה ב-2 קליקים: לוחצים על “AI Suggest Fields”, ואז על “Scrape”. זה הכול. אפילו אמא שלי הייתה מסתדרת עם זה (והיא עדיין חושבת ש“הענן” זה פשוט מזג אוויר גרוע).
- תמיכה בתתי-דפים ובחלוקה לעמודים: Thunderbit יכול לעקוב אחרי קישורים לדפי פירוט (כמו ביקורות על מוצר בודד) ולטפל ברשימות מרובות עמודים באופן אוטומטי.
- ייצוא מיידי: שולחים את הנתונים ישירות ל-Excel, Google Sheets, Airtable או Notion — בלי שלבים נוספים ובלי עלות נוספת.
דוגמה: נניח שאתם רוצים לחלץ ביקורות על מוצר מאתר e-commerce. פותחים את דף הביקורות, לוחצים על האייקון של Thunderbit, בוחרים “AI Suggest Fields”, ו-Thunderbit יציע עמודות כמו “Reviewer Name”, “Rating” ו-“Review Text”. לוחצים “Scrape”, וזהו. צריכים עוד פרטים מכל ביקורת? משתמשים ב-subpage scraping כדי למשוך את כולם.
ב-Trustpilot המשתמשים ממשיכים לציין שוב ושוב את אותם שני דברים — ש-Thunderbit "התמודד טוב יותר עם דפים ארוכים ממה שציפיתי" ו"הפך גירוד של אתרים דינמיים למשימה קלה" (Trustpilot, ביקורת ינואר 2026).
נסו את Thunderbit בחינם לגירוד Web Scraping ב-2 קליקים
חילוץ תוכן מאתרים מורכבים: חלוקה לעמודים וגירוד תתי-דפים
בואו נהיה כנים: לא כל אתר עושה לכם חיים קלים כשצריך לשלוף ממנו נתונים. פלטפורמות e-commerce, מדריכים ואתרי ביקורות משתמשים לעיתים קרובות ב-pagination (כמה עמודים של רשומות) או ב-תתי-דפים מקוננים (למשל כניסה לכל מוצר או עסק כדי לראות עוד פרטים).
האתגר: גירוד מסורתי מפספס לא פעם נתונים שמוסתרים מאחורי כפתור “Next” או בתוך תתי-דפים. גירוד ידני? תשכחו מזה — תבלו ימים בלחיצות.
הפתרון של Thunderbit: ה-AI מזהה קישורי pagination או גלילה אינסופית וממשיך לגרד עד שהוא אוסף הכול. עבור תתי-דפים, Thunderbit יכול להיכנס לכל קישור בטבלה שלכם (כמו כל רישום של מוצר או עסק), לשלוף שדות נוספים ולמזג אותם לתוך מערך הנתונים הראשי.
צעד אחר צעד: גירוד תוכן מרובה עמודים ותתי-דפים
כך מתמודדים עם אתר מורכב באמצעות Thunderbit:
- פתחו את עמוד הרשימה הראשי (למשל קטגוריית e-commerce או מדריך עסקים).
- לחצו על אייקון Thunderbit ובחרו “AI Suggest Fields”. Thunderbit יציע עמודות כמו “Product Name”, “Price”, “Link”.
- לחצו “Scrape”. Thunderbit יחלץ את כל הפריטים בעמוד הנוכחי — ויעקוב אוטומטית אחרי pagination כדי להביא את השאר.
- צריכים עוד פרטים? לחצו על “Scrape Subpages”. Thunderbit יבקר בכל עמוד פירוט של פריט וימשוך מידע נוסף (כמו ביקורות, מפרטים או פרטי קשר).
- עברו על הנתונים וייצאו את מערך הנתונים המלא והמשופר שלכם.
טיפ: השתמשו ב-subpage scraping כשאתם רואים קישורים ל“details”, “reviews” או “contact” — זה מצוין ל-ecommerce, לדפי זהב או לרשימות נדל״ן.
ארגון וניתוח של נתונים שנשלפו: תגיות, קטגוריות ואפשרויות ייצוא
גירוד תוכן הוא רק הצעד הראשון. כדי להפיק ערך אמיתי, צריך לארגן, לנתח ולשתף את הנתונים.
Thunderbit מקל על זה:
- תיוג וסיווג: אפשר להוסיף תגיות או קטגוריות לשדות שלכם (למשל “Product Type”, “Region”, “Lead Status”) כדי לסנן ולנתח אחר כך.
- Field AI Prompts: רוצים לסווג מק״טים או לתרגם ביקורות? מוסיפים הנחיה מותאמת לשדה, וה-AI של Thunderbit יטפל בזה תוך כדי הגירוד.
- אפשרויות ייצוא: שולחים את הנתונים מיד ל-Excel, Google Sheets, Airtable או Notion. אפשר גם להוריד כ-CSV או JSON לניתוח נוסף.
שיטות מומלצות לארגון הנתונים שלכם:
- השתמשו בשמות עמודות ברורים ועקביים.
- הוסיפו תגיות או קטגוריות כדי להקל על סינון.
- שמרו ארכיון של הגירוד הגולמי לצד מערכי נתונים נקיים.
- הגדירו ייצוא קבוע או גירודים מתוזמנים לפרויקטים מתמשכים.
צוותי מכירות יכולים לסמן לידים לפי מקור או סטטוס, בעוד צוותי תפעול יכולים לסווג מוצרים לפי ספק או אזור. המטרה: להפוך את הנתונים שגרדתם למשהו שימושי, ברור וקל לשיתוף.
שמירה על ציות: היבטים משפטיים כשמגרדים תוכן מאתרים אחרים
לפני שתתחילו לגרד את הרשת בלי הכרה, כדאי לדבר על compliance. החדשות הטובות: גירוד של נתונים ציבוריים הוא בדרך כלל חוקי אם מקפידים על כמה כללים פשוטים (Iubenda, ScraperAPI).
טיפים עיקריים לציות:
- גרדו רק תוכן שזמין לציבור. אל תעקפו התחברויות, חומות תשלום או מנגנוני אבטחה.
- כבדו את robots.txt ואת תנאי השימוש. גם אם הם לא תמיד מחייבים משפטית, הם משקפים את רצון בעלי האתר.
- הימנעו מגירוד של תוכן מוגן בזכויות יוצרים או מידע אישי. הישארו עם מידע עובדתי (שמות, מחירים, מפרטים) ואל תפרסמו מחדש טקסטים ארוכים או תמונות מוגנות.
- ציינו מקורות אם אתם משתמשים בנתונים שנגרדו בדוחות או בפרסומים.
- האטו את קצב הבקשות כדי לא להעמיס על האתרים.
צ'קליסט לגירוד בטוח:
- ✅ רק דפים ציבוריים (ללא התחברות)
- ✅ בדקו robots.txt ותנאי שימוש
- ✅ ללא תוכן מוגן בזכויות יוצרים או מידע אישי
- ✅ ציינו מקורות
- ✅ אל תגרדו מהר מדי
Thunderbit מעודד גירוד אחראי בכך שהוא מקל להתמקד רק בנתונים שאתם צריכים ולייצא אותם לשימוש פנימי.
מדריך שלב אחר שלב: גירוד תוכן מאתרים אחרים עם Thunderbit
מוכנים לנסות בעצמכם? כך תגרדו תוכן מאתרים אחרים באמצעות Thunderbit:
- התקינו את תוסף Chrome של Thunderbit: הורידו אותו כאן והירשמו לחשבון חינמי.
- פתחו את האתר המיועד: עברו לעמוד שברצונכם לגרד (למשל רשימות מוצרים, מדריך עסקים, דף ביקורות).
- לחצו על אייקון Thunderbit: בסרגל הכלים של Chrome, לחצו על Thunderbit כדי לפתוח את התוסף.
- השתמשו ב-“AI Suggest Fields”: Thunderbit סורק את העמוד ומציע עמודות לחילוץ (כמו “Name”, “Price”, “Email”).
- התאימו את העמודות במידת הצורך: אפשר לשנות שמות, להוסיף או להסיר שדות לפי הצורך. אפשר גם להוסיף הנחיות AI מותאמות אישית לתיוג או לסיווג.
- לחצו “Scrape”: Thunderbit מחלץ את הנתונים מהעמוד הנוכחי — וגם עוקב אחרי pagination אם יש.
- גרדו תתי-דפים (אופציונלי): לפרטים נוספים, לחצו על “Scrape Subpages” כדי למשוך מידע מהדפים המקושרים.
- עברו על הנתונים וייצאו: צפו בתצוגה מקדימה, ואז ייצאו ל-Excel, Google Sheets, Airtable, Notion, או הורידו כ-CSV/JSON.
פתרון בעיות נפוצות:
- דפים שדורשים התחברות: השתמשו ב-Browser Scraping של Thunderbit בזמן שאתם מחוברים.
- אתרים חסומים או איטיים: נסו לגרד בשעות פחות עמוסות, או חלקו את הגירוד למנות קטנות יותר.
- תוכן דינמי שלא נטען: גללו את הדף עד הסוף לפני הגירוד, או השתמשו במצב הדפדפן של Thunderbit.
- שינויי פריסה: הפעילו שוב את “AI Suggest Fields” כדי לאפשר ל-AI להסתגל למבנה חדש של הדף.
אם תיתקלו בקושי, התיעוד וצוות התמיכה של Thunderbit תמיד זמינים לעזור.
התחילו לגרד תוכן עם Thunderbit
סיכום ונקודות מפתח
גירוד תוכן מאתרים אחרים עבר מלהיות כלי סודי של מפתחים לצורך עסקי יומיומי. לקראת אמצע 2026, כשנתוני האינטרנט צומחים מהר יותר ממה שכל צוות יכול לקרוא, וכלים ללא קוד מבוססי AI מתבגרים מכל כיוון, כל אחד יכול לשלוף את המידע שהוא צריך — במהירות, בדיוק, ובלי כאב ראש.
מה כדאי לזכור:
- גירוד תוכן מאתרים אחרים חיוני ליצירת לידים, למחקר שוק ולשמירה על יתרון תחרותי.
- כלים מודרניים כמו Thunderbit הופכים את Web Scraping לנגיש לכולם, עם הנחיות בשפה טבעית, הצעות שדות מבוססות AI וייצוא מיידי.
- התמיכה של Thunderbit ב-pagination, בגירוד תתי-דפים ובארגון נתונים מאפשרת להתמודד גם עם האתרים המורכבים ביותר.
- חשוב להישאר compliant: לגרד רק מידע ציבורי, לכבד את כללי האתר, ולהימנע מתוכן מוגן או אישי.
- ההתחלה פשוטה כמו התקנת תוסף Chrome ולחיצה על כמה כפתורים.
מוכנים להשאיר את ההעתקה-הדבקה מאחור? נסו את Thunderbit בחינם ותראו כמה זמן — ושפיות — תוכלו לחסוך בפרויקט נתוני הרשת הבא שלכם. לטיפים ומדריכים נוספים, בקרו ב-Thunderbit Blog.
נסו AI Web Scraper לחילוץ תוכן בלי מאמץ Get Started Free
שאלות נפוצות
1. האם חוקי לגרד תוכן מאתרים אחרים?
בדרך כלל כן — אם נשארים עם נתונים ציבוריים, מכבדים את robots.txt ואת תנאי השימוש, ונמנעים מגירוד של מידע מוגן בזכויות יוצרים או מידע אישי. תמיד כדאי לבדוק את הכללים של כל אתר ולהשתמש בנתונים שנגרדו באחריות (Iubenda).
2. האם צריך לדעת לתכנת כדי לגרד תוכן מאתרים?
לא! כלים כמו Thunderbit נבנו עבור משתמשים לא טכניים. אפשר לחלץ נתונים בכמה קליקים בלבד, באמצעות הנחיות בשפה טבעית והצעות שדות מבוססות AI.
3. מאילו סוגי אתרים אפשר לגרד נתונים עם Thunderbit?
Thunderbit עובד על מגוון רחב של אתרים — e-commerce, מדריכים, פלטפורמות ביקורות, רשימות נדל״ן ועוד. ברוב המקרים הוא יודע להתמודד עם pagination, תתי-דפים ואפילו תוכן דינמי.
4. איך מארגנים ומנתחים את הנתונים שגירדתי?
Thunderbit מאפשר לכם לתייג, לסווג ולתת שמות לנתונים כבר בזמן החילוץ. אפשר לייצא ישירות ל-Excel, Google Sheets, Airtable או Notion לצורך ניתוח ושיתוף.
5. מה עושים אם אתר חוסם את הסקרייפר או משנה את הפריסה שלו?
נסו לגרד בקצב איטי יותר, השתמשו במצב Browser Scraping של Thunderbit, או הפעילו מחדש את “AI Suggest Fields” כדי להתאים לפריסה החדשה. אם הבעיה נמשכת, פנו ל-תיעוד או לצוות התמיכה של Thunderbit.
גירוד נעים — ושגיליונות האקסל שלכם תמיד יהיו נקיים, מסודרים ומוכנים לפעולה.
למידע נוסף



