
Zillow יושבת על גבי 160 מיליון רשומות נכסים בארה״ב, והוצאת הנתונים האלה בקנה מידה גדול היא אחת המשימות הכי מבוקשות — וגם הכי מתסכלות — כשעובדים עם נתוני נדל״ן. אם אי פעם ניסיתם לגרד את Zillow ובמקום נתוני נכסים נתקלתם בעמוד CAPTCHA, אתם ממש לא לבד.
השקעתי לא מעט זמן במחקר ובבדיקה של גישות שונות לגרידת Zillow — גם עם Python וגם עם כלים ללא קוד שבנינו ב-Thunderbit. המדריך הזה מכסה את שני המסלולים. בין אם אתם רוצים הדרכה מלאה ב-Python עם אסטרטגיות נגד-בוט, ובין אם אתם רק צריכים 200 נכסים בגיליון אלקטרוני עד הצהריים, יש כאן חלק בשבילכם. נסקור למה נתוני Zillow חשובים, איך האתר בנוי מתחת למכסה המנוע, מדריך Python שלב-אחר-שלב, הסיבות המדויקות לכך שסקרייפרים נשברים, ואיך לאוטומט גרידות חוזרות לצורך מעקב אחר מחירים.
למה בכלל לגרד נתונים מ-Zillow?
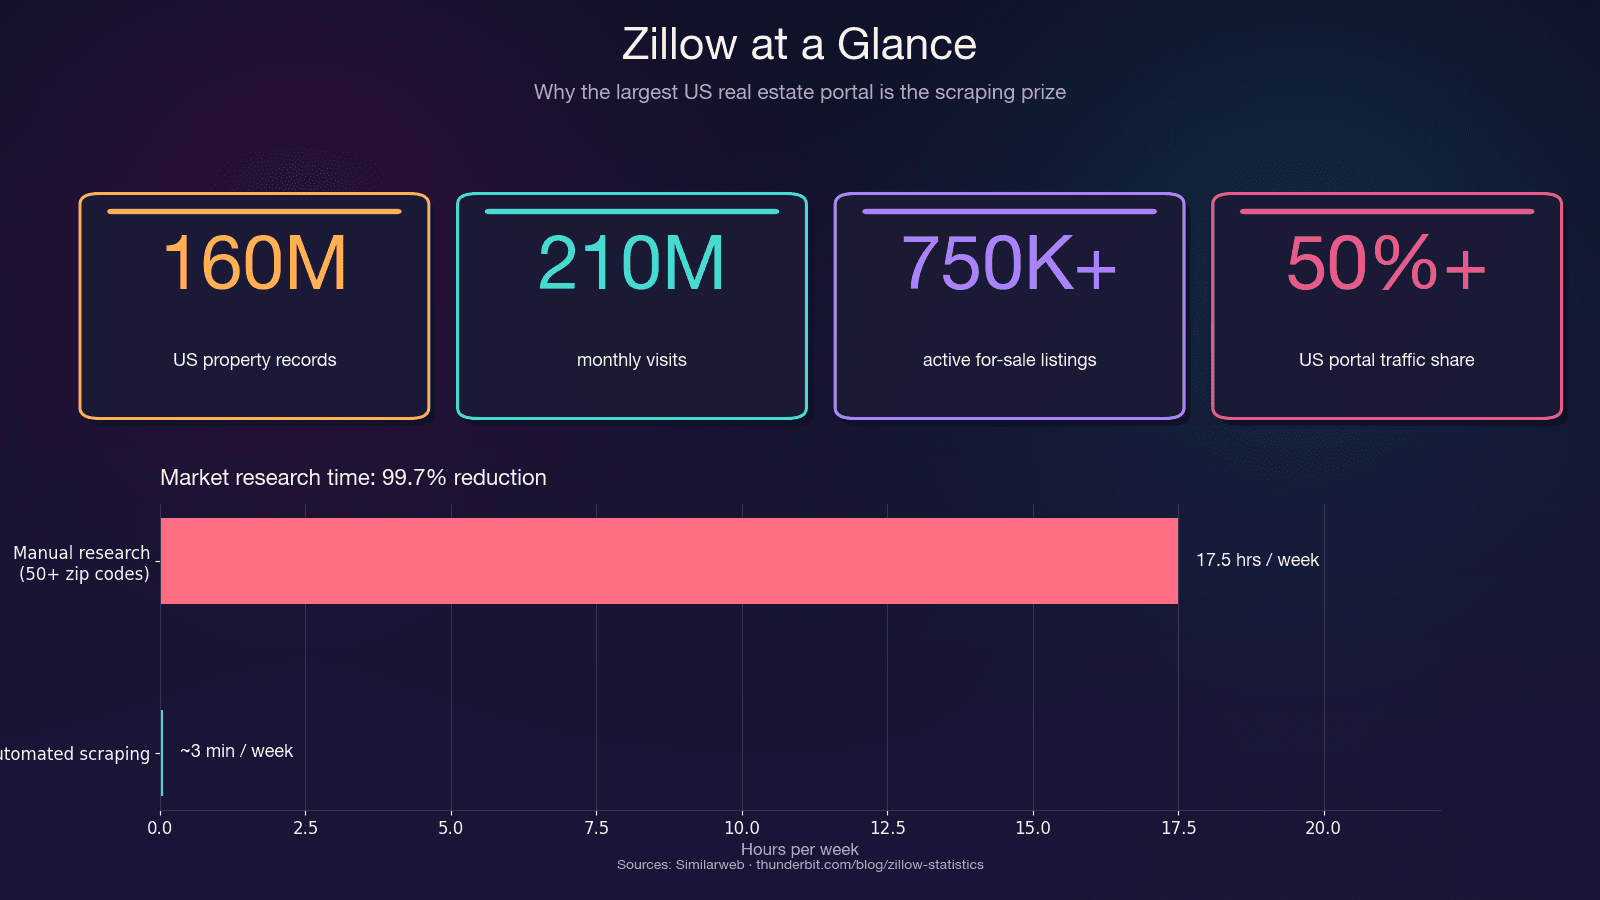
Zillow היא המאגר הגדול ביותר של נתוני נדל״ן למגורים בארה״ב. היא מושכת 210 מיליון ביקורים חודשיים ומארחת כ-750,000+ מודעות מכירה פעילות ועוד 1.9 מיליון מודעות להשכרה. הפלטפורמה אחראית ליותר מ-50% מכל תעבורת פורטלי הנדל״ן בארה״ב — יותר מפי שניים מהמתחרה הבאה.
לפני שקופצים לקוד Python, חשוב לדעת שגרידת Zillow עם Python היא לא האפשרות היחידה, ובחירה בשיטה הלא נכונה עלולה לבזבז שעות. כלי Python כמו httpx ו-BeautifulSoup דורשים רמת מיומנות בינונית, טיפול ידני בכותרות ובפרוקסי, פועלים במהירות בינונית (1–3 שניות לעמוד), ודורשים תחזוקה שוטפת — אבל הם חינמיים; Selenium או Playwright משפרים את ההתמודדות עם מנגנוני חסימה בזכות רינדור JavaScript, אבל הם איטיים יותר (5–15 שניות לעמוד) ועדיין דורשים הרבה תחזוקה; שירותי scraping API כמו ScraperAPI או ScrapFly מהירים יותר וכוללים תמיכה מובנית נגד בוטים ותחזוקה בינונית, אבל עולים 30–599 דולר לחודש; ה-API הרשמי של Zillow דרך Bridge Interactive מהיר ודורש מעט תחזוקה, אך מוגבל ועולה בערך 500 דולר לחודש; וכלים ללא קוד כמו Thunderbit ידידותיים למתחילים, מהירים, לא דורשים תחזוקה בזכות התאמה מבוססת AI, ובדרך כלל מגיעים במודל freemium.
חיסכון הזמן לבדו משמעותי מאוד. מחקר ידני על פני 50+ מיקודים יכול לבלוע 15–20 שעות בשבוע. גרידה אוטומטית עושה את אותה עבודה בדקות — ירידה של 99.7% בזמן המושקע.
כל הדרכים לגרד Zillow: Python מול API מול ללא-קוד (השוואה)
לפני שנכנסים לקוד Python, חשוב להבין ש״לגרד Zillow עם Python״ זו לא הדרך היחידה. בחירה לא נכונה בשיטה תבזבז לכם שעות. הנה השוואה זה לצד זה כדי שתוכלו לבחור נכון:
| שיטה | רמת מיומנות | התמודדות עם מנגנוני חסימה | מהירות | תחזוקה | עלות |
|---|---|---|---|---|---|
| Python + httpx/BeautifulSoup | בינונית | ידנית (כותרות, פרוקסי) | בינונית (1–3 שנ׳/עמוד) | גבוהה (בוררים נשברים) | חינם |
| Python + Selenium/Playwright | בינונית | טובה יותר (מרנדר JS) | איטית (5–15 שנ׳/עמוד) | גבוהה | חינם |
| Scraping API (ScraperAPI, ScrapFly) | בינונית | מובנית | מהירה | בינונית | $30–599 לחודש |
| ה-API הרשמי של Zillow (Bridge Interactive) | מתחיל–בינוני | לא רלוונטי | מהירה | נמוכה | כ-$500 לחודש, גישה מוגבלת |
| כלי ללא קוד (Thunderbit) | מתחיל | מובנית (AI מסתגל) | מהירה | אין (ה-AI קורא מחדש את הדף) | Freemium |
אם אתם צריכים נתונים עכשיו, בלי לכתוב קוד, התחילו עם Thunderbit. אם אתם רוצים להבין את המנגנון לעומק או צריכים התאמה אישית מלאה, המשיכו לקריאת מדריך ה-Python.
הדרך הקצרה: לגרד Zillow עם Thunderbit (בלי קוד)
לפני הצלילה ל-Python, הנה המסלול לכל מי שצריך נתוני Zillow מהר — בלי התקנת Python, בלי הגדרת פרוקסי, בלי תחזוקת בוררים. בנינו את התהליך הזה ב-Thunderbit במיוחד כדי להוציא נתוני נדל״ן מובנים בלי עומס הנדסי.
רמת קושי: מתחיל
זמן נדרש: כ-2 דקות
מה צריך: דפדפן Chrome, תוסף Thunderbit ל-Chrome (הגרסה החינמית מספיקה)
שלב 1: מתקינים את Thunderbit ופותחים את Zillow
התקינו את התוסף של Thunderbit מחנות Chrome. עברו לעמוד תוצאות חיפוש של Zillow — למשל, חיפוש בתים ביוסטון, טקסס.
שלב 2: לוחצים על "AI Suggest Fields"
פתחו את סרגל הצד של Thunderbit ולחצו על "AI Suggest Fields". ה-AI קורא את הדף ומציע אוטומטית עמודות כמו מחיר, כתובת, מספר חדרי שינה, חדרי רחצה, שטח, Zestimate, קישור למודעה ועוד. בבדיקות שלי הוא בדרך כלל מזהה 20+ שדות בלי שום הגדרה ידנית.
שלב 3: לוחצים על "Scrape"
לחצו על כפתור Scrape. הנתונים יופיעו בטבלה מובנית בתוך התוסף. Thunderbit מטפל אוטומטית בעימוד של Zillow — גם בלחיצה בין עמודים וגם בגלילה אינסופית.
שלב 4: מעשירים בעזרת Scrape Subpages
רוצים נתונים מעמודי פירוט כמו היסטוריית מסים, דירוגי בתי ספר או היסטוריית מחירים? השתמשו ב-"Scrape Subpages" כדי להעשיר את הטבלה. Thunderbit עוקב אחרי כל קישור נכס ושואב את השדות הנוספים — בלי לכתוב קוד נוסף.
שלב 5: מייצאים
מייצאים ל-Google Sheets, Excel, Airtable או Notion. הייצוא חינמי.
למה Thunderbit עובד טוב עם Zillow
היתרון האמיתי כאן הוא עמידות. ה-AI של Thunderbit קורא את מבנה הדף מחדש בכל גרידה. כש-Zillow משנה את הפריסה שלה (וזה קורה לא מעט), אין בוררי CSS שבירים שצריך לתקן. ה-AI מסתגל אוטומטית. זה באמת פותר את הנטייה ה״שבירה מטבעה״ של סקרייפרים מבוססי קוד, שמטריפה כל כך הרבה משתמשים.
איזה נתונים אפשר לגרד מ-Zillow? (20+ שדות)
רוב המדריכים לוקחים מחיר וכתובת ועוצרים שם. בפועל, ברישומי Zillow יש הרבה יותר נתונים שניתן לחלץ ממה שרוב האנשים חושבים — הנה טבלת ייחוס:
| שדה | איפה הוא נמצא | קושי החילוץ |
|---|---|---|
| מחיר מבוקש | חיפוש + פירוט | קל |
| כתובת / מיקוד | חיפוש + פירוט | קל |
| Zestimate | חיפוש + פירוט | קל |
| היסטוריית מחירים (כל אירוע) | פירוט | קשה (JSON מקונן) |
| היסטוריית מסים | פירוט | קשה (JSON מקונן) |
| חדרי שינה / חדרי רחצה / שטח | חיפוש + פירוט | קל |
| שנת בנייה | פירוט | קל |
| דמי HOA | פירוט | בינוני |
| Walk Score / Transit Score | פירוט (iframe) | קשה (דורש רינדור JS) |
| דירוגי בתי ספר | פירוט | בינוני |
| גודל המגרש | פירוט | קל |
| מספר ימים ב-Zillow | חיפוש | קל |
| סוכן / משרד תיווך | חיפוש + פירוט | בינוני |
| מספר MLS | פירוט | קל |
| סוג הנכס | חיפוש + פירוט | קל |
| קו רוחב / קו אורך | JSON של __NEXT_DATA__ | בינוני |
| טקסט התיאור | פירוט | קל |
| כתובות תמונות | חיפוש + פירוט | בינוני |
| Rent Zestimate | פירוט | בינוני |
| מכירות דומות בקרבת מקום | פירוט | קשה |
השדות ה״קשים״ — היסטוריית מחירים, היסטוריית מסים, מכירות דומות — נמצאים ב-JSON מקונן בעמודי הפירוט. החלק של Python בהמשך מראה בדיוק איך לחלץ אותם. ואם אתם מעדיפים לדלג על הקוד, ה- AI Suggest Fields של Thunderbit מזהה אוטומטית את רוב העמודות האלה, ו-Scrape Subpages שולף את שדות עמודי הפירוט באופן אוטומטי.
הגדרת סביבת Python לגרידת Zillow
רמת קושי: בינונית
זמן נדרש: כ-5 דקות להגדרה, כ-30 דקות למדריך המלא
מה צריך: Python 3.8+, דפדפן Chrome (לבדיקת עמודים), עורך טקסט או IDE
התקינו את הספריות הנדרשות:
pip install httpx beautifulsoup4 pandas lxml
כך כל אחת מהן עוזרת:
- httpx — לקוח HTTP עם ביצועים טובים יותר מ-
requestsותמיכה ב-async - beautifulsoup4 + lxml — ניתוח HTML
- pandas — ייצוא נתונים ל-CSV/Excel
- אופציונלי: selenium או playwright אם צריך לרנדר עמודים כבדים ב-JavaScript
להבין את מבנה הדפים של Zillow לפני הגרידה
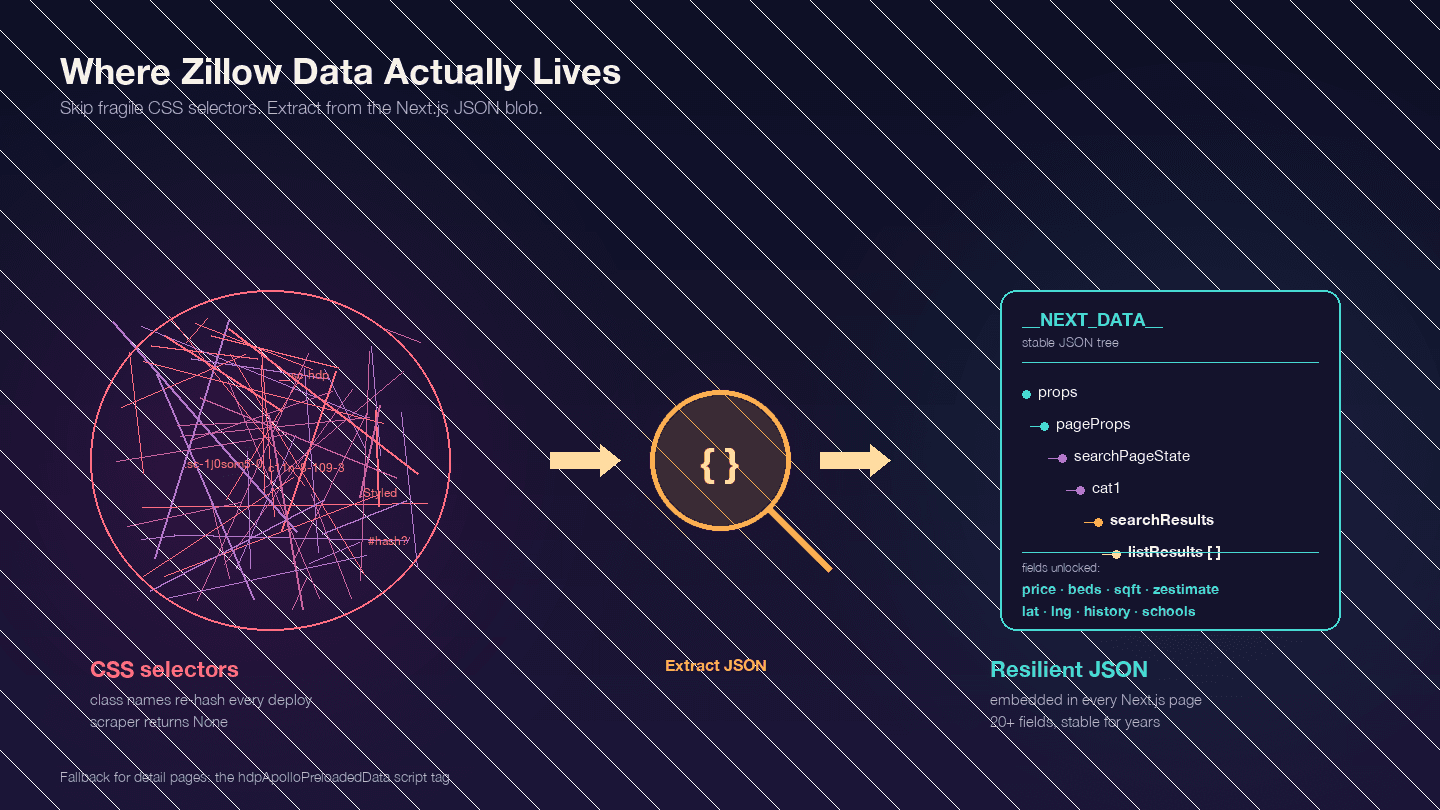
זה הדבר הכי חשוב להבין לפני כתיבת קוד. Zillow היא אפליקציית Next.js — כפי שאושר בפוסטים טכניים של עובדי Zillow. המשמעות היא שרוב הנתונים שאתם מחפשים לא נמצאים באלמנטים הגלויים ב-HTML. הם מוטמעים בתוך בלוק JSON ב-<script id="__NEXT_DATA__">.
פתחו כל עמוד נכס ב-Zillow, לחצו F12, עברו ל-Elements, וחפשו את __NEXT_DATA__. תמצאו שם אובייקט JSON ענק שמכיל את כל נתוני המודעה — מחירים, קואורדינטות, פרטי נכס, היסטוריית מחירים, נתוני מס, דירוגי בתי ספר ועוד.
למה זה חשוב? שמות מחלקות ה-CSS של Zillow הם hashed (נוצרים על ידי styled-components) ומשתנים בכל פריסה חדשה. מחלקה כמו StyledPropertyCardHomeDetailsList-c11n-8-109-3__sc-1j0som5-0 תקבל hash שונה לגמרי בשבוע הבא. כל סקרייפר שמסתמך על בוררי CSS יישבר באופן קבוע.
הגישה של JSON ב-__NEXT_DATA__ הרבה יותר יציבה, כי היא בכלל לא תלויה במבנה ה-HTML.
נתיבי JSON מרכזיים לתוצאות חיפוש:
| נתיב | תוכן |
|---|---|
props.pageProps.searchPageState.cat1.searchResults.listResults | מערך של תוצאות חיפוש |
props.pageProps.searchPageState.cat1.searchResults.mapResults | תוצאות בתצוגת מפה |
props.pageProps.searchPageState.cat1.searchList.totalPages | מספר העמודים הכולל |
בעמודי פירוט, חלק משתמשים ב-__NEXT_DATA__ וחלק אחר ב-hdpApolloPreloadedData כתגית script חלופית. הקוד למטה מטפל בשניהם.
שלב-אחר-שלב: איך לגרד Zillow עם Python
שלב 1: מגדירים כותרות HTTP כדי להימנע מחסימה מיידית
שליחת httpx.get() פשוטה ל-Zillow מחזירה עמוד CAPTCHA, לא נתוני נכס. Zillow משתמשת ב-PerimeterX (HUMAN Security) לצד Cloudflare — שניהם מדורגים 8/10 בקושי לפי מבחני גרידה. המערכת בודקת את טביעת ה-TLS שלכם, כותרות ה-HTTP ומוניטין ה-IP.
אלה הכותרות המינימליות שעובדות נכון ל-2025:
import httpx

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                   "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,"
              "image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-User": "?1",
    "Upgrade-Insecure-Requests": "1",
}
כותרות Sec-Ch-Ua הן קריטיות. הרבה מדריכים משמיטים אותן — וזו בדיוק הסיבה שהקוד שלהם לא עובד מול PerimeterX.
שלב 2: גורדים את תוצאות החיפוש של Zillow
כתובות החיפוש של Zillow נבנות בתבנית צפויה. עבור יוסטון, טקסס:
- עמוד 1:
https://www.zillow.com/houston-tx/ - עמוד 2:
https://www.zillow.com/houston-tx/2_p/ - עמוד 3:
https://www.zillow.com/houston-tx/3_p/
בכל עמוד יש בערך 41 מודעות. Zillow מגבילה את התוצאות ל-20 עמודים (~820 מודעות). עבור מערכי נתונים גדולים יותר, צריך לפצל לפי אזור גאוגרפי (נגיע לזה בהמשך).
הנה הקוד לגרידת תוצאות חיפוש על ידי חילוץ נתונים מ-JSON של __NEXT_DATA__:
from bs4 import BeautifulSoup
import json
import time
import random

def scrape_zillow_search(url):
    """Scrape listing data from a Zillow search results page."""
    response = httpx.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        print(f"Got status {response.status_code} for {url}")
        return []

    soup = BeautifulSoup(response.text, "lxml")
    script_tag = soup.find("script", {"id": "__NEXT_DATA__"})

    if not script_tag:
        print("No __NEXT_DATA__ found — likely blocked by CAPTCHA")
        return []

    next_data = json.loads(script_tag.string)

    try:
        results = (
            next_data["props"]["pageProps"]["searchPageState"]
            ["cat1"]["searchResults"]["listResults"]
        )
    except KeyError:
        print("Unexpected JSON structure — Zillow may have changed its format")
        return []

    listings = []
    for item in results:
        listing = {
            "zpid": item.get("zpid"),
            "address": item.get("addressStreet"),
            "city": item.get("addressCity"),
            "state": item.get("addressState"),
            "zipcode": item.get("addressZipcode"),
            "price": item.get("unformattedPrice") or item.get("price"),
            "beds": item.get("beds"),
            "baths": item.get("baths"),
            "sqft": item.get("area"),
            "zestimate": item.get("zestimate"),
            "days_on_zillow": item.get("daysOnZillow"),
            "listing_url": item.get("detailUrl"),
            "img_src": item.get("imgSrc"),
            "property_type": item.get("hdpData", {}).get("homeInfo", {}).get("homeType"),
            "latitude": item.get("latLong", {}).get("latitude"),
            "longitude": item.get("latLong", {}).get("longitude"),
        }
        listings.append(listing)

    return listings
כדי לגרד כמה עמודים, מריצים לולאה עם השהיות:
all_listings = []
base_url = "https://www.zillow.com/houston-tx/"

for page in range(1, 6):  # First 5 pages
    url = base_url if page == 1 else f"{base_url}{page}_p/"
    print(f"Scraping page {page}...")

    page_listings = scrape_zillow_search(url)
    all_listings.extend(page_listings)

    # Random delay between 3-7 seconds
    delay = random.uniform(3, 7)
    time.sleep(delay)

print(f"Total listings scraped: {len(all_listings)}")
אמור להצטבר אצלכם נתוני מודעות מובנים בתוך all_listings. אם מתקבלות תוצאות ריקות, בדקו את החלק "למה סקרייפרים נשברים" בהמשך.
שלב 3: גורדים עמודי פירוט של נכסים ב-Zillow
תוצאות החיפוש נותנות את הבסיס. עמודי הפירוט מכילים את הנתונים העמוקים יותר: היסטוריית מחירים, היסטוריית מסים, דירוגי בתי ספר, מידע על סוכן ותיאור הנכס. כל קישור מודעה משלב 2 מוביל לעמוד פירוט.
לעמודי פירוט של Zillow יש שני פורמטי נתונים אפשריים. הנה קוד שמטפל בשניהם:
def scrape_zillow_detail(url):
    """Scrape detailed property data from a Zillow listing page."""
    response = httpx.get(url, headers=headers, timeout=15)

    if response.status_code != 200:
        return None

    soup = BeautifulSoup(response.text, "lxml")

    # Try __NEXT_DATA__ first (most common)
    script_tag = soup.find("script", {"id": "__NEXT_DATA__"})
    if script_tag:
        next_data = json.loads(script_tag.string)
        try:
            cache_str = next_data["props"]["pageProps"]["componentProps"]["gdpClientCache"]
            cache = json.loads(cache_str)
            first_key = next(iter(cache))
            prop = cache[first_key]["property"]
            return extract_property_fields(prop)
        except (KeyError, StopIteration):
            pass

    # Fallback: hdpApolloPreloadedData
    apollo_tag = soup.find("script", {"id": "hdpApolloPreloadedData"})
    if apollo_tag:
        raw = json.loads(apollo_tag.string)
        api_cache = json.loads(raw["apiCache"])
        for key, value in api_cache.items():
            if "ForSale" in key or "property" in str(value)[:100]:
                prop = value.get("property", value)
                return extract_property_fields(prop)

    return None


def extract_property_fields(prop):
    """Extract structured fields from a Zillow property JSON object."""
    return {
        "zpid": prop.get("zpid"),
        "zestimate": prop.get("zestimate"),
        "rent_zestimate": prop.get("rentZestimate"),
        "description": prop.get("description"),
        "year_built": prop.get("yearBuilt"),
        "lot_size": prop.get("lotSize"),
        "hoa_fee": prop.get("monthlyHoaFee"),
        "mls_id": prop.get("mlsid"),
        "broker_name": prop.get("brokerName") or prop.get("attributionInfo", {}).get("brokerName"),
        "price_history": [
            {
                "date": event.get("date"),
                "event": event.get("event"),
                "price": event.get("price"),
            }
            for event in prop.get("priceHistory", [])
        ],
        "tax_history": [
            {
                "year": record.get("time"),
                "tax_paid": record.get("taxPaid"),
                "value": record.get("value"),
            }
            for record in prop.get("taxHistory", [])
        ],
        "schools": [
            {
                "name": school.get("name"),
                "rating": school.get("rating"),
                "distance": school.get("distance"),
            }
            for school in prop.get("schools", [])
        ],
    }
עוברים על קישורי המודעות עם השהיות:
detail_data = []
for listing in all_listings[:10]:  # Start with 10 to test
    detail_url = listing.get("listing_url")
    if not detail_url:
        continue

    if not detail_url.startswith("http"):
        detail_url = f"https://www.zillow.com{detail_url}"

    print(f"Scraping detail: {detail_url}")
    detail = scrape_zillow_detail(detail_url)

    if detail:
        detail_data.append({**listing, **detail})

    time.sleep(random.uniform(3, 8))
אחרי השלב הזה אמורה להיות לכם רשימת מילונים שמכילה גם נתוני חיפוש וגם נתוני פירוט לכל נכס.
שלב 4: מטפלים בעימוד כדי לגרד כמה עמודים
באזורים עם יותר מ-820 מודעות (מגבלת 20 העמודים), צריך לפצל לפי אזור גאוגרפי. ה-API הפנימי של Zillow מקבל פרמטרים של mapBounds. האסטרטגיה: לחלק את המפה לרבעים ולגרד כל רבע בנפרד.
def split_bounds(bounds):
    """Split map bounds into 4 quadrants."""
    mid_lat = (bounds["north"] + bounds["south"]) / 2
    mid_lng = (bounds["east"] + bounds["west"]) / 2

    return [
        {"north": bounds["north"], "south": mid_lat, "east": bounds["east"], "west": mid_lng},
        {"north": bounds["north"], "south": mid_lat, "east": mid_lng, "west": bounds["west"]},
        {"north": mid_lat, "south": bounds["south"], "east": bounds["east"], "west": mid_lng},
        {"north": mid_lat, "south": bounds["south"], "east": mid_lng, "west": bounds["west"]},
    ]
ברוב מקרי השימוש — ניטור 50–200 נכסים באזור מסוים — עימוד רגיל לפי URL מספיק. הגישה של רבעים מיועדת לגרידות בקנה מידה עירוני או מדינתי.
שלב 5: מייצאים את נתוני Zillow שגרדתם
שומרים את הכול ל-CSV עם pandas:
import pandas as pd

df = pd.DataFrame(detail_data)
df.to_csv("zillow_houston_listings.csv", index=False)
print(f"Exported {len(df)} listings to zillow_houston_listings.csv")
לייצוא JSON:
with open("zillow_houston_listings.json", "w") as f:
    json.dump(detail_data, f, indent=2)
אם אתם רוצים לדלג לגמרי על שלב הייצוא, Thunderbit מייצא ל-Google Sheets, Airtable ו-Notion בחינם — שימושי אם אתם רוצים את הנתונים בפורמט שיתופי מיד.
למה סקרייפרים של Zillow נשברים (ואיך בונים כאלה עמידים)
זהו מדריך הישרדות.
מהניסיון שלי, סקרייפרים נשברים ב-Zillow משלוש סיבות ספציפיות — ולכל אחת יש פתרון ברור.
PerimeterX ו-CAPTCHA: למה הבקשות שלכם מחזירות נתונים ריקים
האינטגרציה של PerimeterX ב-Zillow בודקת כמה אותות במקביל: טביעת TLS, כותרות HTTP, מוניטין IP ודפוסי בקשות. כשהיא מזהה אוטומציה, היא מחזירה דף CAPTCHA מסוג "Press & Hold" במקום נתוני נכס.
תרחיש הכשל המדויק: אתם שולחים בקשה עם כותרות Python ברירת מחדל. ה-HTML של התגובה מכיל סקריפטים של אתגר PerimeterX במקום נתוני נכס — וה-BeautifulSoup שלכם לא מוצא תגית __NEXT_DATA__.
הפתרון: השתמשו בכל הכותרות המחקות דפדפן משלב 1. אם אתם שולחים יותר מכמה עשרות בקשות, אתם צריכים גם רוטציה של פרוקסי (נכסה זאת בהמשך). לגרידות כבדות, שקלו ספרייה כמו curl_cffi עם impersonate="chrome" — זהו לקוח ה-HTTP של Python היחיד שכמעט מצליח להתאים לטביעת TLS אמיתית של Chrome.
בוררי CSS דינמיים: למה BeautifulSoup מחזיר None
אם אתם משתמשים בבוררי CSS כמו .list-card-price או בשמות מחלקה עם hashes, הסקרייפר שלכם יישבר בכל פעם ש-Zillow תפרוס גרסה חדשה.
Zillow משתמשת ב-styled-components, שמייצרים שמות מחלקה כמו StyledPropertyCardHomeDetailsList-c11n-8-109-3__sc-1j0som5-0. חלק ה-hash משתנה בכל build.
הפתרון: לא להשתמש בכלל בבוררי CSS. לחלץ נתונים מתוך בלוק JSON של __NEXT_DATA__ כפי שמוצג בקוד למעלה. זו גישה שהייתה יציבה במשך שנים, כי מבנה ה-JSON משתנה הרבה פחות ממבנה ה-HTML.
אם אתם חייבים לנתח HTML, חפשו מאפייני data-test (למשל, data-test="property-card") או השתמשו בהתאמת מחלקות לפי תת-מחרוזת כמו [class*="PropertyCard"]. אבל חילוץ מ-JSON הוא הנתיב האמין יותר.
רוטציית פרוקסי ו-Exponential Backoff: קוד ששרד איסורי IP
כתובות IP של דאטה-סנטרים נכנסות ישר לרשימת חסימה ב-Zillow. צריך פרוקסי residential כדי לקבל גישה אמינה. קצב בטוח: בקשה אחת כל 3–8 שניות לכל IP, ובסך הכול פחות מ-~500 בקשות לשעה.
הנה decorator של ניסיון חוזר עם exponential backoff ו-jitter:
import random
import time

def backoff_with_jitter(attempt, base_delay=2, max_delay=60):
    """AWS-style full jitter exponential backoff."""
    delay = min(max_delay, base_delay * (2 ** attempt))
    return random.uniform(0, delay)

def fetch_with_retry(url, max_retries=5):
    for attempt in range(max_retries):
        try:
            response = httpx.get(url, headers=headers, timeout=15)
            if response.status_code == 200:
                return response
            if response.status_code in (403, 429):
                delay = backoff_with_jitter(attempt, base_delay=5)
                print(f"Blocked ({response.status_code}). Retrying in {delay:.1f}s...")
                time.sleep(delay)
                continue
        except Exception as e:
            if attempt == max_retries - 1:
                raise
            time.sleep(backoff_with_jitter(attempt))
    return None
והנה מאגר פרוקסי פשוט עם רוטציה:
class ProxyPool:
    def __init__(self, proxies):
        self.proxies = proxies
        self.index = 0
        self.failures = {}

    def get_next(self):
        proxy = self.proxies[self.index % len(self.proxies)]
        self.index += 1
        return {"http://": proxy, "https://": proxy}

    def report_failure(self, proxy):
        self.failures[proxy] = self.failures.get(proxy, 0) + 1
        if self.failures[proxy] > 3:
            self.proxies.remove(proxy)

# Usage:
pool = ProxyPool(proxies=[
    "http://user:pass@residential1.example.com:8080",
    "http://user:pass@residential2.example.com:8080",
])
לספקי פרוקסי, DataImpulse מציעה פרוקסי residential בכ-1 דולר ל-GB (האפשרות הזולה ביותר), בעוד IPRoyal ו-Smartproxy הן בחירות טובות בטווח הבינוני עם 4–7 דולר ל-GB.
האלטרנטיבה ללא תחזוקה
אם אתם גורדים Zillow באופן קבוע ונמאס לכם לתקן בוררים שבורים או לנהל מאגרי פרוקסי, ה-AI של Thunderbit קורא את מבנה הדף מחדש בכל גרידה. בלי בוררים לתחזק, בלי הגדרת פרוקסי. זה באמת פותר את בעיית השבריריות שהופכת סקרייפרים מבוססי קוד לכאב ראש חוזר.
אוטומציה של גרידת Zillow: תזמון ומעקב מחירים
כל משקיע נדל״ן שדיברתי איתו רוצה את זה, ואף מדריך אחר לגרידת Zillow לא מכסה זאת: גרידות אוטומטיות חוזרות למעקב אחר מחירים.
למשתמשי Python: משימות Cron וזיהוי שינויי מחירים
הגדירו משימת cron שמריצה את הסקרייפר שלכם פעם בשבוע ומסמנת שינויי מחיר:
import pandas as pd
from datetime import datetime

def detect_price_changes(new_data, historical_file, threshold=0.05):
    """Compare new scrape with historical data, flag changes > threshold."""
    try:
        old = pd.read_csv(historical_file)
    except FileNotFoundError:
        new_data.to_csv(historical_file, index=False)
        print("First run — saved baseline data.")
        return pd.DataFrame()

    merged = new_data.merge(old, on="zpid", suffixes=("_new", "_old"))
    merged["price_change_pct"] = (
        (merged["price_new"] - merged["price_old"]) / merged["price_old"]
    )
    alerts = merged[merged["price_change_pct"].abs() > threshold]

    # Append new data with timestamp
    new_data["scraped_at"] = datetime.now().isoformat()
    new_data.to_csv(historical_file, mode="a", header=False, index=False)

    return alerts
הוסיפו את זה ל-crontab כדי להריץ כל שבוע בימי שני ב-6:00 בבוקר:
0 6 * * 1 cd /path/to/scraper && python zillow_monitor.py
דוגמה מעשית: לעקוב אחרי 50 מודעות באוסטין, טקסס, מדי שבוע. בכל יום שני הסקריפט שואב את המחירים הנוכחיים, משווה אותם לשבוע הקודם, ומוציא CSV שמדגיש כל ירידת מחיר של יותר מ-5%.
ללא-קוד: Scheduled Scraper של Thunderbit
ה-Scheduled Scraper של Thunderbit מאפשר לכם לתאר את התדירות בשפה פשוטה ("בכל יום שני ב-9 בבוקר"), להזין את כתובות החיפוש של Zillow, וללחוץ על Schedule. הנתונים מיוצאים אוטומטית ל-Google Sheets בכל הרצה. בלי Python, בלי cron, בלי שרת לתחזק. זה שימושי במיוחד לסוכני נדל״ן או לצוותי תפעול שצריכים מעקב מחירים עקבי בלי תמיכה הנדסית.
טיפים לגרידת Zillow בצורה אחראית
כמה נקודות כדי להישאר בצד הנכון של הקו:
- גרדו רק נתונים שזמינים לציבור. אל תיגשו לעמודים שמאחורי התחברות או אימות.
- השתמשו בקצב בקשות סביר. 3–8 שניות בין בקשות. אל תעמיסו על השרת.
- אל תגרדו נתוני משתמשים אישיים/פרטיים. שמות סוכנים ומידע תיווך ברישומים הם ציבוריים; נתוני חשבון משתמש אינם.
- אחסנו והשתמשו בנתונים באופן אתי. מחקר שוק, ניתוח השקעות ויצירת לידים הם שימושים לגיטימיים. ספאם לא.
- הקשר משפטי: פסק הדין hiQ נגד LinkedIn קבע שגרידה של נתונים נגישים לציבור אינה מפרה את ה-CFAA. גם פסק הדין Meta נגד Bright Data (2024) חיזק עקרונות דומים. עם זאת, תנאי השימוש של Zillow מגבילים גישה אוטומטית, והם אוכפים זאת באמצעות חסימות IP ו-CAPTCHA ולא באמצעות הליך משפטי. תמיד כדאי לבדוק הנחיות עדכניות ולכבד את robots.txt.
בוחרים את הדרך הנכונה לגרד Zillow עם Python
המסלול הטוב ביותר תלוי במצב שלכם:
צריכים נתונים מהר, בלי קוד? Thunderbit מעביר אתכם מעמוד חיפוש של Zillow לגיליון אלקטרוני מובנה בכ-2 דקות. ה-AI מתאים את עצמו לשינויי פריסה, מטפל בעימוד ומאפשר ייצוא בחינם. התקינו את תוסף ה-Chrome ונסו אותו על עמוד חיפוש של Zillow.
רוצים שליטה מלאה? השתמשו בקוד Python שבמדריך הזה. חלצו מ-JSON של __NEXT_DATA__ ולא מבוררי CSS כדי לשמור על יציבות. הגדירו כותרות שמחקות דפדפן. רוטציה של פרוקסי residential ו-Exponential Backoff ישפרו את האמינות.
צריכים קנה מידה? שירותי scraping API כמו ScrapFly (שיעור הצלחה של 99% ב-Zillow) או ScraperAPI מטפלים עבורכם בתשתית הפרוקסי וה-CAPTCHA, בעלות של 30–599 דולר לחודש בהתאם לנפח.
עוקבים אחרי מחירים לאורך זמן? הגדירו משימת cron עם סקריפט לזיהוי שינויי מחיר, או השתמשו ב-Scheduled Scraper של Thunderbit לגישה בלי תחזוקה.
הנתונים שם. השאלה היחידה היא כמה זמן הנדסי אתם רוצים להשקיע כדי להוציא אותם. לעוד מידע על הכנסת נתוני רשת לגיליונות אלקטרוניים, עיינו במדריך שלנו על גרידת נתונים מאתרים ל-Excel או בסיכום הסטטיסטיקות של Zillow לקבלת נתוני הפלטפורמה העדכניים. אפשר גם לצפות במדריכים ב-ערוץ היוטיוב של Thunderbit.
נסו את Thunderbit לגרידת Zillow Get Started Free
שאלות נפוצות
האם אפשר לגרד את Zillow עם Python בחינם?
כן — httpx, BeautifulSoup ו-pandas הם כולם חינמיים וקוד פתוח. המחיר הוא בזמן: תצטרכו לנהל בעצמכם כותרות, רוטציית פרוקסי ותחזוקת בוררים. צפו להשקיע 4–8 שעות בהגדרה ראשונית ועוד 4–10 שעות בחודש על תחזוקה כשהאתר של Zillow משתנה. Thunderbit מציעה גם שכבה חינמית אם אתם רוצים להימנע לחלוטין מהעומס של כתיבת קוד.
האם ל-Zillow יש API רשמי?
Zillow הפסיקה את ה-API הציבורי החינמי שלה בספטמבר 2021. הגישה כיום עוברת דרך Bridge Interactive, שדורש אישור, עולה בערך 500 דולר לחודש, ומיועד בעיקר לאנשי נדל״ן מורשים. עבור רוב המשתמשים — משקיעים, חוקרים, סוכנים שמבצעים ניתוח שוק — גרידה היא החלופה הפרקטית. Zillow עדיין מפרסמת נתוני מחקר חינמיים כ-CSV להורדה ב-zillow.com/research/data/, כולל Zillow Home Value Index ו-Zillow Observed Rent Index.
איך להימנע מחסימה בזמן גרידה של Zillow?
שלושה דברים: (1) השתמשו בכותרות דפדפן מציאותיות, כולל Sec-Ch-Ua — זו הכותרת שרוב המדריכים מפספסים, וזו גם הראשונה ש-PerimeterX בודקת; (2) בצעו רוטציה של פרוקסי residential — כתובות IP של דאטה-סנטר נחסמות מיד; (3) חלצו נתונים מ-JSON של __NEXT_DATA__ במקום מבוררי HTML כדי להימנע משבירה בגלל שינויי פריסה. שמרו על קצב של בקשה אחת כל 3–8 שניות לכל IP. או השתמשו בכלי כמו Thunderbit שמטפל בהגנות נגד-בוטים באופן אוטומטי.
מה הדרך הטובה ביותר לגרד Zillow בלי קוד?
AI Web Scraper של Thunderbit הוא המסלול המהיר ביותר. התקינו את תוסף Chrome, עברו לעמוד חיפוש של Zillow, לחצו על "AI Suggest Fields" כדי לזהות עמודות אוטומטית, ואז לחצו על "Scrape." אפשר לייצא ל-Google Sheets, Excel, Airtable או Notion בלי לכתוב קוד. ה-AI קורא את הדף מחדש בכל פעם, כך שהוא לא נשבר כש-Zillow מעדכנת את הפריסה.
באיזו תדירות Zillow משנה את מבנה האתר שלה, ואיך זה משפיע על סקרייפרים?
Zillow מפרסמת עדכונים לעיתים קרובות — לפעמים מדי שבוע. מאחר שהיא משתמשת ב-styled-components, שמות מחלקות CSS משתנים עם כל פריסה חדשה, וסקרייפרים שמבוססים על CSS נשברים שוב ושוב. הגישה העמידה ביותר ב-Python היא חילוץ מתוך בלוק JSON של __NEXT_DATA__, שהמבנה שלו משתנה הרבה פחות. לגישה בלי תחזוקה, ה-AI של Thunderbit קורא מחדש את מבנה הדף בכל גרידה ומסתגל אוטומטית לשינויי פריסה.
למדו עוד




