
GitHub מציג כרגע יותר מ-2,300 מאגרי reddit scraper. זה נשמע כמו בופה עשיר, אבל יש קאץ': רק כ-28% מהם מציגים פעילות תחזוקה כלשהי ב-12 החודשים האחרונים. בשבועות האחרונים חפרתי במאגרים האלה, בדקתי נקודות קצה, קראתי תורי בעיות והשוויתי לעדכוני המדיניות של Reddit עצמו. המטרה: לחסוך לכם את השלב של שיבוט מאגר, התמודדות עם OAuth וגילוי באמצע הלילה שכל העסק נשבר בשקט כבר ב-2024. נוף ה-Reddit scraper GitHub ב-2026 הוא בית קברות של כוונות טובות, עם קומץ כלים שבאמת עוד שימושיים. המדריך הזה סוקר מה עדיין עובד, מה נשבר, מתי כדאי לוותר לגמרי על קוד, ואיך להישאר בצד הנכון של האכיפה ההולכת ומחמירה של Reddit. אם אתם מחפשים קיצור דרך, Thunderbit הוא פתרון ללא קוד שבנינו בדיוק לסוג הבעיה הזה — אבל אהיה כנה גם לגבי המקומות שבהם פתרונות מבוססי קוד עדיין הגיוניים יותר.
מהו מאגר Reddit Scraper GitHub ולמה כל כך הרבה מהם שבורים
מאגר "reddit scraper github" הוא בדרך כלל פרויקט קוד פתוח ב-Python (ולפעמים JavaScript) שמבצע אוטומציה של שליפת פוסטים, תגובות, נתוני משתמשים או מדיה מ-Reddit. הם מתחלקים בדרך כלל לארבעה סוגים:
- עטיפות API (כמו PRAW): משתמשות ב-API הרשמי של Reddit, דורשות OAuth, ופועלות לפי הכללים של Reddit.
- כלים מבוססי Pushshift/PSAW: שימשו כדי להתחבר לארכיון הענק של Pushshift לצורך נתונים היסטוריים.
- מגרדי נקודת קצה ציבורית
.json: מוסיפים.jsonלכתובות Reddit או ניגשים לנקודות קצה פומביות בלי אימות. - מגרדים מבוססי דפדפן: משתמשים ב-Playwright, Selenium או בתוספי דפדפן כדי לטעון דפי Reddit ולחלץ תוכן מעובד.
למה כל כך הרבה מהם נשברו? שלוש סיבות.
- שינוי דרמטי בתמחור ה-API של Reddit באמצע 2023. מגבלות ה-API החינמיות ירדו ל-100 שאילתות בדקה עם OAuth ורק 10 בלי. שימוש מסחרי בהיקף גבוה יותר עולה עכשיו 0.24 דולר לכל 1,000 קריאות API. הרבה מאגרים נבנו לעולם שבו הגישה ל-API הייתה כמעט בלתי מוגבלת — והעולם הזה איננו.
- הגישה הציבורית ל-Pushshift בוטלה. Pushshift היה עמוד השדרה של מחקר היסטורי ב-Reddit. ברגע ש-Reddit הגבילה אותו, חלק גדול ממאגרי ה-"historical scraper" איבדו את מקור הנתונים המרכזי שלהם. כמה קובצי README עדיין גורמים לכלים האלה להיראות חיים, אבל התלות שמתחת כבר לא קיימת עבור משתמשים רגילים.
- Reddit הקשיחה גם את המדיניות וגם את האכיפה. עדכון robots.txt ב-2024, מדיניות התוכן הציבורי של 2025, ו-מדיניות ה-Responsible Builder ממרץ 2026, כולם מאותתים ש-Reddit כבר לא מתייחסת לגריפת נתונים המונית כרעש רקע תמים. הם אפילו הגישו תלונות נגד Anthropic ו-SerpApi על גישה לא מורשית לנתונים.
השורה התחתונה: תחפשו "reddit scraper github" ותקבלו מאות תוצאות. אבל תאריכי ה-commit האחרונים ומספרי הבעיות הפתוחות מספרים סיפור אחר לגמרי.
בדיקת מצב Reddit Scraper GitHub ב-2026: מה עדיין עובד
רוב המאמרים המתחרים נכתבו ב-2023 או 2024 ומעולם לא עודכנו. משתמשי פורומים ממשיכים להיתקל בשגיאות במאגרים שעבדו לפני שנה — הקריאה של משתמש אחד, "Keep running into Reddit API limitation error :\ Any ideas how I can get past this?" היא בעצם חוויית ה-Reddit scraper של 2026 בקצרה.
ביצעתי בדיקת עדכניות, מאומתת נכון לאפריל 2026. הנה מה שמצאתי.
PRAW: העטיפה הרשמית של Python
מצב: ✅ עדיין עובד, עם הסתייגויות.
PRAW (Python Reddit API Wrapper) נשאר הבסיס הפתוח-מקור האמין ביותר לגריפת Reddit. הוא עדיין מתוחזק באופן פעיל — 4,099 כוכבים, עדכון אחרון ב-20 באפריל 2026, רק 6 בעיות פתוחות, ו-PyPI מציג את praw 7.8.1 (שוחרר באוקטובר 2024).
יתרונות: רשמי, מתועד היטב, ומסתיר את רוב המורכבות של ה-API של Reddit.
מגבלות ב-2026:
- דרישות OAuth מחמירות יותר. צריך אפליקציית Reddit רשומה עם תיאור שימוש מאושר.
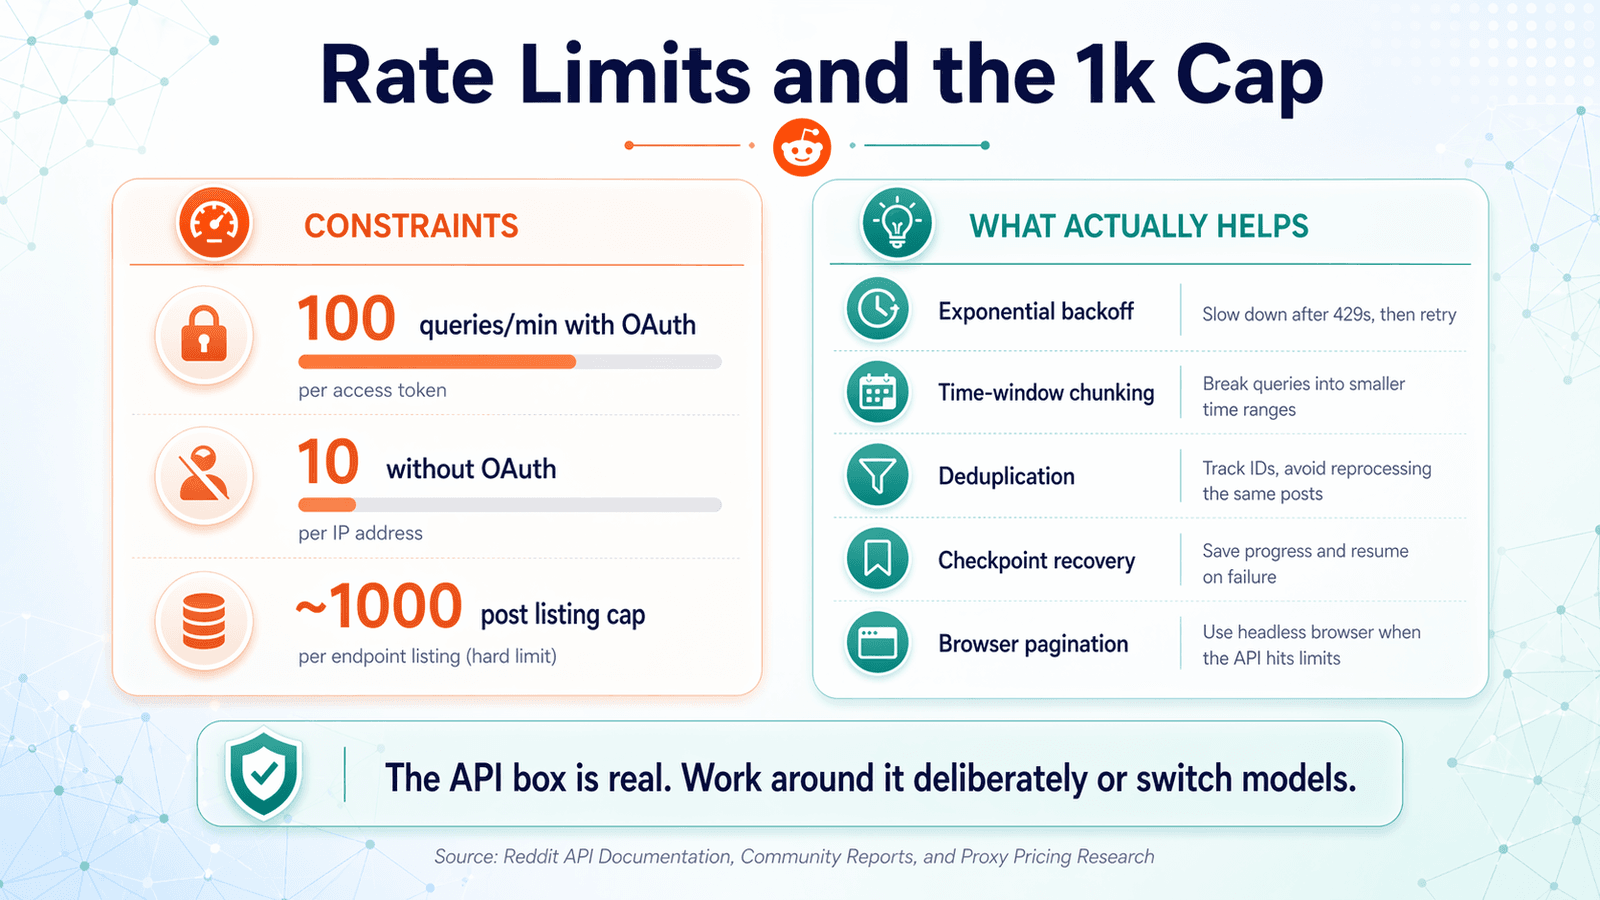
- מגבלות קצב נמוכות יותר מאז 2024 (100 שאילתות/דקה עם OAuth, 10 בלי).
- מגבלת הרשימה הקשיחה של כ-1,000 פוסטים עדיין קיימת. דיונים בקהילה ב-r/redditdev וב-Stack Overflow מאשרים: אין דרך לשלוף יותר מ-1,000 פוסטים לכל נקודת קצה של רשימה.
PRAW הוא ההימור הבטוח ביותר אם אפשר להישאר בתוך הקופסה של ה-API.
פשוט כבר לא מדובר במגרד המוני חופשי-לכל.
אם אתם רוצים הדרכה מעשית למסלול הרשמי של ה-API, המדריך הזה מתאים בדיוק לחלק הזה:
Pushshift / PSAW: הארכיון שנחשך
מצב: ❌ הגישה הציבורית נעלמה.
PSAW היה עטיפת Python הנפוצה ל-Pushshift, שבעבר היה המסלול הקל ביותר לנתונים היסטוריים מ-Reddit. ב-2026 המאגר בארכיון, ה-README אומר במפורש "THIS REPOSITORY IS STALE," ובעיות פתוחות מהזמן האחרון כוללות פנינים כמו "Pushshift.io UNABLE to connect" ו-"The code not working. Possibly due to pushshift api."
ייתכן שעדיין קיימת גישה אקדמית בערוצים מסוימים, אבל עבור כל מי שמחפש היום "reddit scraper github", Pushshift/PSAW אינו אופציה בת-קיימא. אם אתם צריכים נתונים היסטוריים עמוקים מ-Reddit, תצטרכו לבדוק גישה אקדמית מאושרת או מסלולים ברישיון.
snscrape (מודול Reddit): חלקי ולא אמין
מצב: ⚠️ חלקי — שבירות לסירוגין, ללא תחזוקה משמעותית.
snscrape מחזיק 5,337 כוכבים, אבל העדכון האחרון היה ב-15 בנובמבר 2023. ה-README עדיין אומר שגריפת Reddit נתמכת "via Pushshift." בעיות פתוחות הקשורות ל-Reddit כוללות "Error reddit scraping" ו-"Reddit scraper returns no submissions before 2022-11-03," בלי פעילות תיקון משמעותית לאחרונה.
זה יכול לעבוד לשליפות קטנות וחד-פעמיות בחלק מהסביבות, אבל זה לא אמין לייצור או לגריפות חוזרות. התייחסו אליו כאל פתרון מדור קודם.
מגרדים מבוססי Playwright ונקודות קצה .json: העקיפה שעובדת (לפעמים)
מצב: ✅ עובד, אבל שברירי.
הרעיון כאן פשוט: משתמשים בדפדפן ללא ממשק (Playwright, Puppeteer) כדי לטעון דפי Reddit ולגרוף תוכן מעובד, או מוסיפים .json לכתובות Reddit כדי לקבל נתונים מובנים בלי ה-API הרשמי.
יתרונות: אין צורך במפתח API, אפשר לעקוף את מגבלת 1,000 הפוסטים, ויש גישה לתוכן מעובד.
חסרונות: נשבר כש-Reddit משנה את מבנה ה-front-end או את מבנה ה-JSON, עלול להפעיל מנגנוני אנטי-בוט, ודורש יותר הגדרה טכנית. בבדיקות שלי החודש, בקשות ישירות לנקודות הקצה הציבוריות של Reddit ב-.json החזירו תגובות 403. זה לא אומר שכל סביבה תיחסם, אבל כן אומר שקיצור הדרך .json כבר לא משהו שאפשר להניח ש"פשוט יעבוד".
מאגרים כמו yars כנים באופן מרענן לגבי זה: ה-README מזהיר משתמשים "Use with rotating proxies, or Reddit might gift you with an IP ban." זה בעצם הסיפור של אפריל 2026 במשפט אחד.
אם אתם בוחנים את מסלול העקיפה של אוטומציית דפדפן, המדריך הזה ל-Playwright הוא בן לוויה מצוין לחלק למטה:
Thunderbit: גריפת דפדפן מבוססת AI (ללא קוד, ללא מפתח API)
מצב: ✅ עובד — מסתגל אוטומטית לשינויים בדף.
Thunderbit נוקט גישה שונה מהיסוד. זהו תוסף Chrome שמשתמש ב-AI כדי לקרוא דפי Reddit, להציע שדות נתונים (כותרת פוסט, מחבר, הצבעות, חותמת זמן, כתובת URL וכו') ולחלץ נתונים מובנים בשני קליקים. בלי הגדרת OAuth, בלי רישום מפתח API, בלי סביבת Python, ובלי ניהול תלויות. ה-AI קורא את הדף מחדש בכל פעם, כך שכאשר Reddit משנה את הפריסה שלה, Thunderbit מסתגל אוטומטית במקום להישבר בשקט.
ייצוא חינם ל-CSV, Google Sheets, Airtable או Notion. תומך בעימוד ובגריפת תתי-דפים (למשל, גריפת רשימת subreddit ואז כניסה לכל פוסט כדי לשלוף תגובות). עבור קהל שרוצה נתוני Reddit בלי לתחזק מאגר GitHub, זהו מסלול ההתנגדות הנמוכה ביותר.
(גילוי נאות: אנחנו בנינו את Thunderbit, אז יש לי הטיה — אבל אהיה ברור גם לגבי המקומות שבהם פתרונות מבוססי קוד עדיין הגיוניים יותר בהמשך המאמר.)
טבלת סיכום מצב זו מול זו
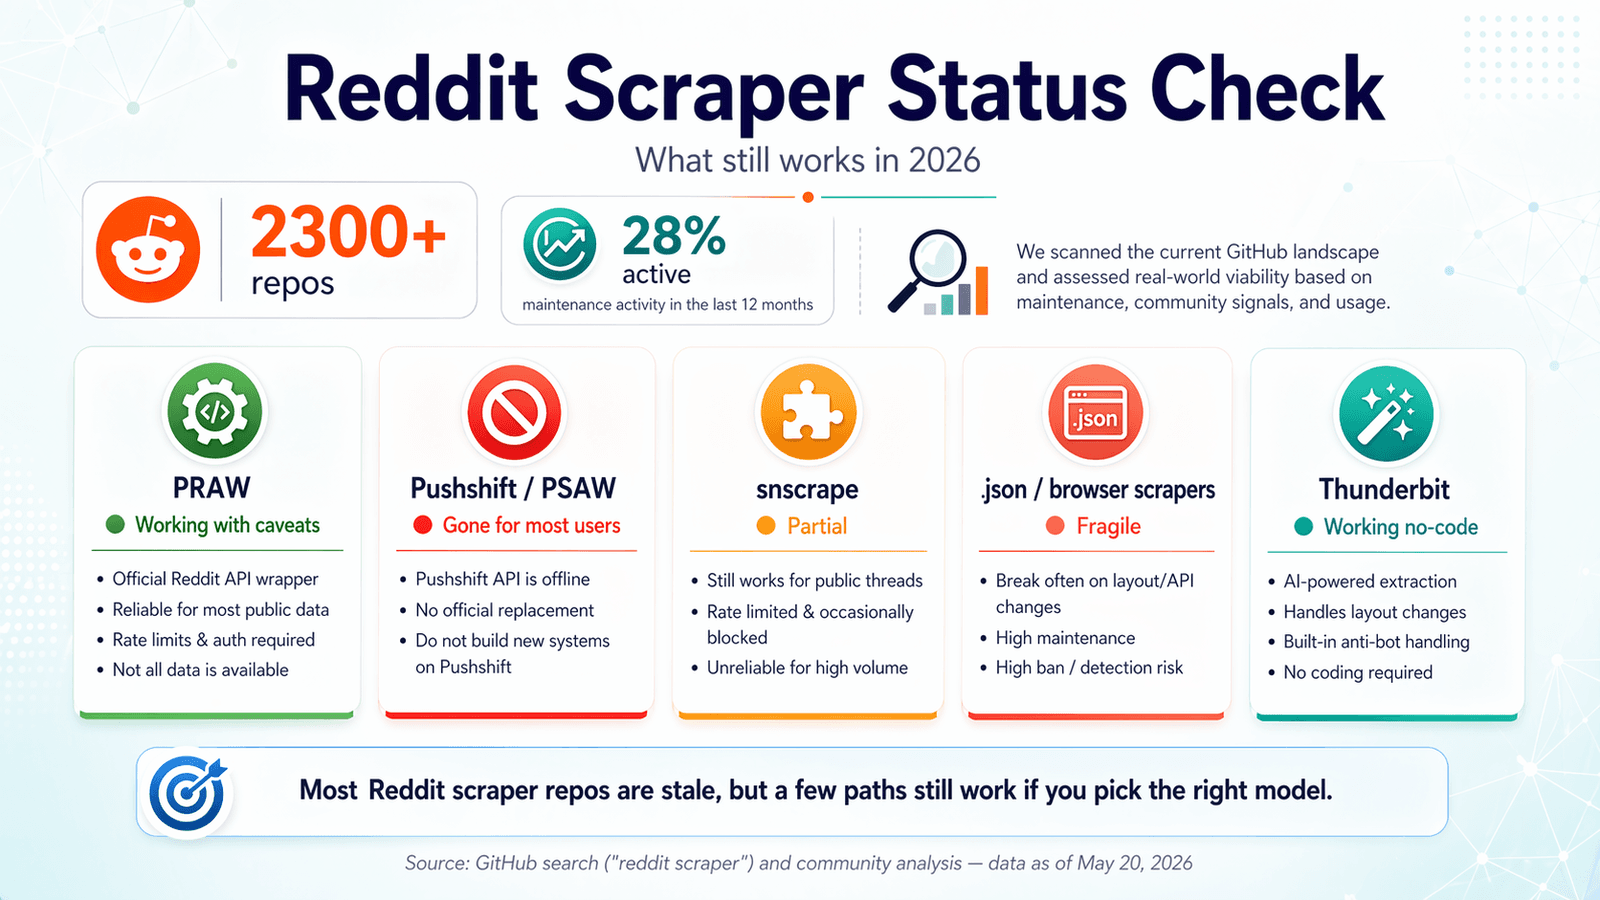
| כלי / קטגוריה | עדיין עובד (אפריל 2026)? | נדרש מפתח API? | הערות |
|---|---|---|---|
| PRAW | ✅ כן, עם הסתייגויות | כן (OAuth) | הבסיס הפתוח-מקור המתוחזק ביותר. מוגבל על ידי מגבלות קצב ותקרת 1,000 פוסטים. |
| Pushshift / PSAW | ❌ לא (עבור רוב המשתמשים) | לא רלוונטי | הגישה הציבורית נעלמה. המאגר בארכיון. |
| snscrape (מודול Reddit) | ⚠️ חלקי / לא אמין | לא | עדיין מתעד Reddit "via Pushshift." התחזוקה נתקעה מאז 2023. |
מגרדי .json / נקודות קצה ציבוריות | ⚠️ חלקי | לא | יכול לעבוד, אבל בקשות ישירות נחסמות יותר ויותר. תלוי בפרוקסי. |
| Playwright / מגרדי דפדפן | ✅ כן, אבל שברירי | בדרך כלל לא | עקיפת DIY הכי ריאלית בלי API. עדיין חשובים שינויים בדף ובדיקות אנטי-בוט. |
| Thunderbit | ✅ כן | לא | תהליך AI/דפדפן. בלי OAuth, בלי סלקטורים. מתאים במיוחד למי שאינם מפתחים. |
מגבלות קצב, תקרת 1,000 הפוסטים, ומה באמת עוזר
זו נקודת הכאב מספר 1 עבור כל מי שמשתמש בפרויקט reddit scraper github. שרשורי פורומים מלאים בתסכול: "tired of runs dying halfway through because of rate limits," "Why am I only getting around 1,000 items?" שתי המגבלות המרכזיות הן מגבלות הקצב של ה-API של Reddit (בקשות לדקה) ותקרת הרשימה של כ-1,000 פוסטים (ה-API מחזיר רק את כ-1,000 הפוסטים האחרונים ביותר לכל נקודת קצה של רשימה).
שיטות עבודה מומלצות לניהול מגבלות קצב
הבסיס הציבורי הנוכחי של Reddit: 100 שאילתות בדקה עם OAuth, 10 בלי. כך מתמודדים עם זה בפועל:
- השהיה אקספוננציאלית. אם קיבלתם תגובת rate-limit, חכו ואז נסו שוב לאחר השהיה ארוכה יותר בכל פעם (1 שנייה, 2 שניות, 4, 8…). אל תכו את נקודת הקצה שוב ושוב.
- קראו את כותרות
X-Ratelimit-Remaining. תגובות ה-API של Reddit כוללות כותרות שמראות כמה בקשות נשארו לכם ומתי החלון מתאפס. קצבו את הבקשות לפי הערכים האלה, לא לפי ניחוש. - User-Agents מתחלפים. חלק מהמאגרים ממליצים על זה כדי להימנע מזיהוי. זה יכול לעזור, אבל השתמשו בזה בצורה אתית — אל תשתמשו בזה כדי לעקוף חסימות שהרווחתם.
- תעדו הכול. הוסיפו לוגים לתגובות API, לכותרות מגבלת הקצב ולשגיאות. כשמגרד הנתונים שלכם קורס ב-2 בלילה, לוגים הם החבר הכי טוב שלכם.
איך שוברים את תקרת 1,000 הפוסטים
העקיפה האמינה ביותר למגבלת כ-1,000 פריטים ברשימה של ה-API היא פיצול לחלונות זמן:
- שואלים מקטע זמן אחד בעזרת פרמטרי
beforeו-afterשל חותמת זמן. - מזיזים את החלון קדימה (או אחורה).
- חוזרים על הפעולה.
- מבצעים דה-דופליקציה לפי מזהה הפוסט.
זה לא אלגנטי, אבל זה כן יותר כן מאשר להעמיד פנים שטופס לולאה יחיד של בקשות יכול לשלוף היסטוריה שרירותית מנקודת קצה של רשימה. עבור נתונים היסטוריים ממש, תצטרכו גישה אקדמית מאושרת או מסלול ברישיון — Pushshift כבר לא התשובה ברירת המחדל.
גריפה מבוססת דפדפן (Playwright או Thunderbit) עוקפת את התקרה הזו לגמרי, כי היא גורפת את מה שמוצג בדף ולא את מה שה-API מחזיר. תכונת העימוד של Thunderbit מאפשרת לכם לעבור בין דפים ולאסוף נתונים על פני כמה דפים שתרצו.
דה-דופליקציה והתאוששות משגיאות
רוב מאגרי reddit scraper github לא מטפלים בדה-דופליקציה או בהתאוששות משגיאות כברירת מחדל. משתמשים מתלוננים במפורש ש-"none had deduping, rate limit avoidance after errors, checking if files are already downloaded." הנה מה לעשות:
- דה-דופליקציה: גיבוב של מזהה כל פוסט (או מזהה + תוכן). שמרו את הגיבובים שכבר נראו במסד SQLite פשוט או אפילו בקובץ שטוח. לפני הוספה, בדקו אם הגיבוב כבר קיים. זה חשוב במיוחד כשמפצלים חלונות זמן או מריצים שוב משימות שנכשלו.
- התאוששות משגיאות: שמרו את ההתקדמות לקובץ checkpoint אחרי כל N רשומות. אם הריצה נכשלת, התחילו מחדש מהנקודה האחרונה במקום מההתחלה. זה הופך משימה של 3 שעות שנופלת בשעה השנייה להרצה נמשכת של שעה אחת.
איך גישות שונות מתמודדות עם המגבלות האלה
| גישה | טיפול במגבלות קצב | יותר מ-1k פוסטים? | דה-דופ אוטומטי? | התאוששות משגיאות? |
|---|---|---|---|---|
| PRAW (גולמי) | ידני (sleep/retry) | ❌ (מגבלת API) | ❌ | ❌ |
| PRAW + פיצול לחלונות זמן | ידני | ✅ (עקיפה) | ❌ | ❌ (אלא אם מוסיפים) |
גריפת .json עם Playwright | לא רלוונטי (אין API) | ✅ | ❌ | ❌ |
| Thunderbit (גריפת דפדפן) | מובנה (קצב מבוסס AI) | ✅ (עימוד) | לא רלוונטי (סקירה חזותית) | מובנה |
מתי Reddit Scraper GitHub אינו התשובה: המסלול ללא קוד
רוב מאמרי reddit scraper github מניחים שליטה ב-Python. אבל הרבה מהאנשים שמחפשים פתרונות לגריפת Reddit הם אנשי שיווק, אנשי מכירות, חוקרים או מייסדים עצמאיים שלא כותבים Python ביום-יום. עבור הקהל הזה, מאגר GitHub מוסיף עלויות נסתרות:
- הגדרת אישורי OAuth ואפליקציית מפתחים של Reddit
- ניהול סביבות וירטואליות של Python והתנגשויות תלויות
- איתור באגים בהודעות שגיאה מוצפנות כשמבנה הפנימי של PRAW משתנה
- טיפול בביטול מפתח API אם Reddit מחליטה שהשימוש שלכם לא מאושר
- תחזוקת הסקריפט בכל פעם ש-Reddit משנה משהו
אלה לא תרחישים היפותטיים. ל-bulk-downloader-for-reddit יש 2,563 כוכבים ו-107 בעיות פתוחות. דיווחים אחרונים כוללים "Struggling to install," "PRAW module error," ו-"Exception not allowing to even authenticate."
השתמשו במאגר GitHub אם...
- אתם צריכים לוגיקת גריפה מותאמת אישית (למשל, מעבר מסוים בעץ תגובות, שילוב עם צינור NLP מותאם).
- אתם רוצים לשלב בצינור נתונים קיים ב-Python.
- אתם צריכים לגרוף בהיקף גבוה מאוד עם אחסון מותאם אישית (מסד נתונים, data warehouse).
- נוח לכם לתחזק קוד ולטפל בשינויים שוברי תאימות.
השתמשו בכלי ללא קוד אם...
- אתם צריכים נתוני Reddit מהר — בתוך דקות, לא אחרי שעות של הגדרה.
- אתם לא רוצים לנהל מפתחות API, אפליקציות OAuth או סביבות Python.
- אתם רוצים לייצא ישירות לגיליונות, Notion או Airtable לשימוש מיידי.
- אתם רוצים שהכלי יסתגל אוטומטית כשהפריסה של Reddit משתנה.
Thunderbit יושב בדיוק בנתיב ללא קוד. משתמשים יכולים לגרוף פוסטים, תגובות ונתוני משתמשים מ-Reddit בשני קליקים עם שדות שמוצעים על ידי AI, לייצא בחינם ל-CSV/Google Sheets/Airtable/Notion, ולטפל בעימוד בלי לכתוב קוד. גריפת הדפדפן שלו אומרת שאין צורך בהגדרת OAuth ואין צורך ברישום מפתח API.
הדרכה מהירה: גריפת Reddit עם Thunderbit (שלב אחר שלב)
- התקינו את תוסף Chrome של Thunderbit.
- נווטו לדף Reddit שברצונכם לגרוף (subreddit, תוצאות חיפוש, פרופיל משתמש).
- לחצו על "AI Suggest Fields." Thunderbit קורא את הדף ומציע עמודות — כותרת פוסט, מחבר, הצבעות, חותמת זמן, כתובת URL וכו'.
- התאימו את השדות אם צריך, ואז לחצו על "Scrape."
- בדקו את טבלת הנתונים. אפשר ללחוץ על "Scrape Subpages" כדי להיכנס לכל פוסט ולשלוף תגובות או פרטים נוספים.
- ייצאו ליעד המועדף עליכם: Google Sheets, Excel, Airtable, Notion, CSV או JSON.
שתי דקות. אפס שורות קוד. אם אתם רוצים לראות את זה בפעולה, בדקו את ערוץ YouTube של Thunderbit.
התאימו את מגרד Reddit למשימה: מטריצת החלטה לפי שימוש
רוב מאמרי reddit scraper github מאורגנים לפי כלי. זו הגישה ההפוכה.
התחילו מהמטרה שלכם ועבדו אחורה לכלי הנכון.
לידים וחיפוש נקודות כאב
מה צריך: פוסטים + תגובות עם סינון מילות מפתח, תיוג/סימון ב-AI, ייצוא לפורמטים מוכנים ל-CRM.
הגישה הטובה ביותר: מגרד ללא קוד עם העשרת AI.
כלי מומלץ: Thunderbit (תיוג AI + ייצוא ל-Google Sheets/Airtable לייבוא ל-CRM).
דוגמת תהליך: גרפו subreddit עבור פוסטים שמזכירים נקודת כאב מסוימת. השתמשו ב-Field AI Prompt של Thunderbit כדי לסווג סנטימנט או לתייג נושאים. ייצאו ל-Airtable או Google Sheet של צוות המכירות.
מחקר שוק ואימות רעיונות
מה צריך: כותרות פוסטים בנפח גבוה + ציונים, נתוני מגמות ברמת subreddit.
הגישה הטובה ביותר: PRAW עם פיצול לחלונות זמן לצורך נפח, או Thunderbit לשליפות מהירות.
דוגמה: גריפת r/SaaS או r/startups לצורך ניתוח נושאים חמים ודפוסי upvote ב-90 הימים האחרונים.
ארכוב תמונות ומדיה
מה צריך: כתובות URL של מדיה, דה-דופליקציה, ריצות מתוזמנות.
הגישה הטובה ביותר: מאגר GitHub ייעודי (למשל, bulk-downloader-for-reddit) + משימת cron.
הערה: דה-דופ חשוב כאן — אותה תמונה שמפורסמת בכמה subreddits היא דבר נפוץ.
מחקר אקדמי ונתונים היסטוריים
מה צריך: נתונים היסטוריים, עצי תגובות מלאים, מערכי נתונים גדולים.
הגישה הטובה ביותר: גישה אקדמית מאושרת או מסלול נתונים ברישיון. Pushshift כבר לא תשובה כללית.
בדיקת מציאות: זהו מקרה השימוש הקשה ביותר ב-2026 בגלל מגבלות Pushshift והקשחת מדיניות הנתונים של Reddit.
ניטור מתחרים וגריפה מתוזמנת
מה צריך: גריפות חוזרות במרווחים קבועים, זיהוי שינויים.
הגישה הטובה ביותר: Scheduled Scraper של Thunderbit (מתארים את מרווח הזמן באנגלית פשוטה, מזינים כתובות URL, לוחצים Schedule) או cron + סקריפט למשתמשי קוד.
טבלת מטריצת החלטה לפי שימוש
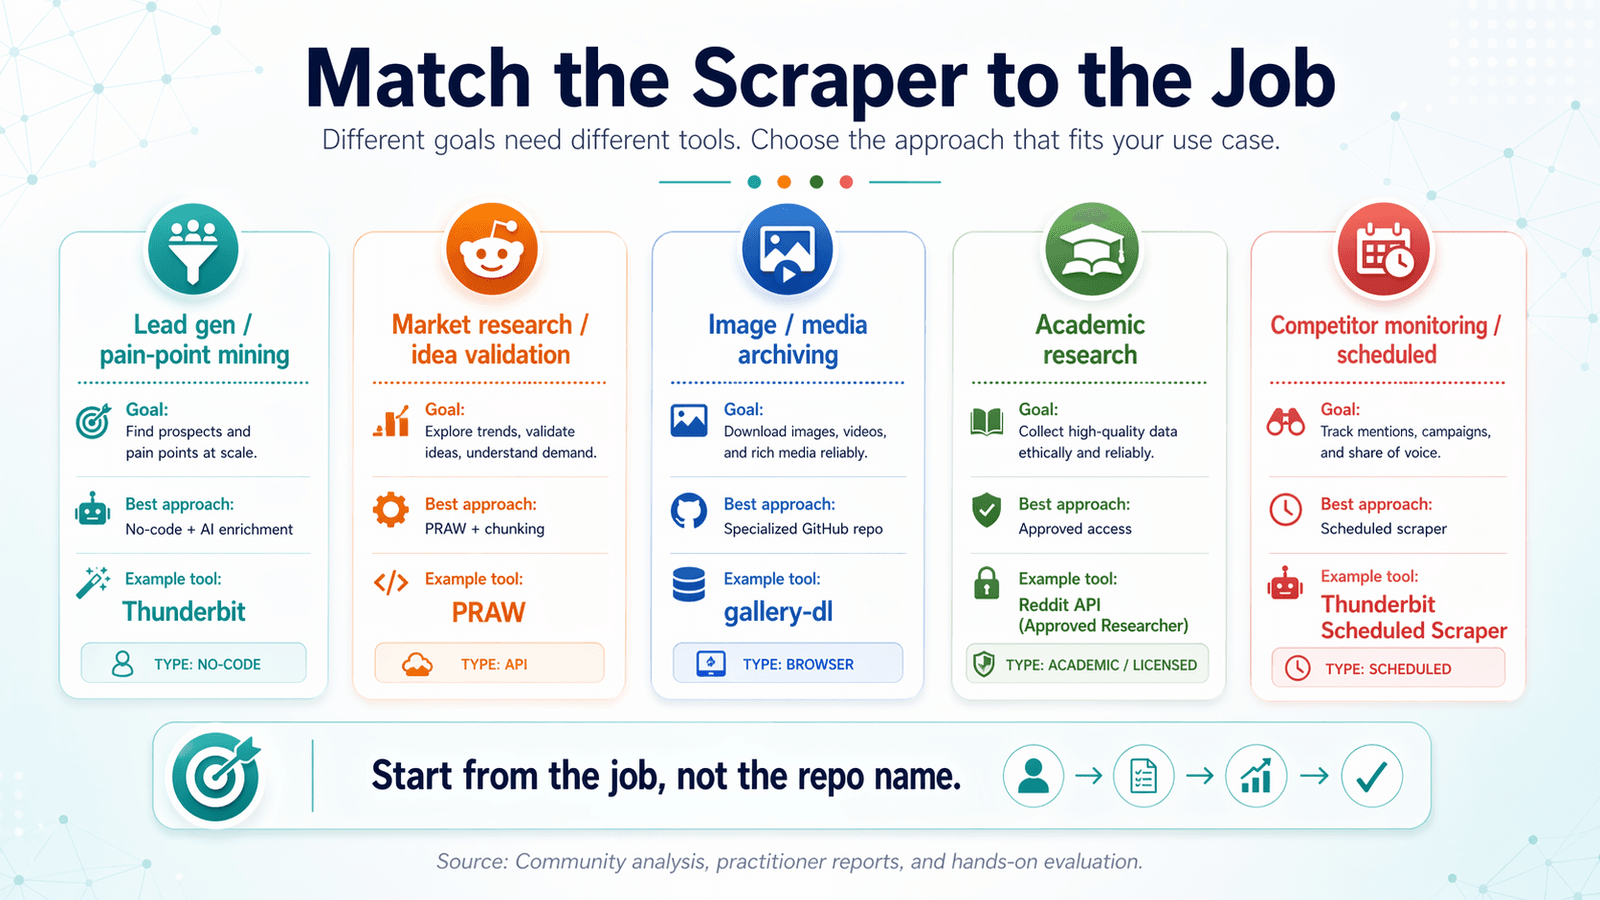
| מקרה שימוש | מה צריך | הגישה הטובה ביותר | כלי לדוגמה |
|---|---|---|---|
| יצירת לידים / חיפוש נקודות כאב | פוסטים + תגובות, סינון מילות מפתח, תיוג AI | מגרד ללא קוד + העשרת AI | Thunderbit |
| מחקר שוק / אימות רעיונות | כותרות פוסטים בנפח גבוה + ציונים, נתוני subreddit | PRAW + פיצול לחלונות זמן או Thunderbit | PRAW או Thunderbit |
| ארכוב תמונות/מדיה | כתובות URL של מדיה, דה-דופ, ריצות מתוזמנות | מאגר GitHub ייעודי + cron | bulk-downloader-for-reddit |
| מחקר אקדמי | נתונים היסטוריים, עצי תגובות מלאים | גישה אקדמית מאושרת או Playwright | Pushshift academic API (אם נגיש) |
| ניטור מתחרים / מתוזמן | גריפות חוזרות, זיהוי שינויים | Scheduled Scraper | Thunderbit Scheduled Scraper או cron + script |
איך להעריך כל מאגר Reddit Scraper GitHub לפני שמתחייבים
לפני שאתם משבטים מאגר ומתחילים לדבג, הריצו את בדיקת הבריאות של 5 דקות. היא תחסוך לכם שעות.
בדיקת בריאות של מאגר ב-5 דקות
- תאריך ה-commit האחרון. אם עברו יותר מ-6 חודשים, המשיכו בזהירות. ה-API של Reddit משתנה לעיתים קרובות.
- יחס בעיות פתוחות לעומת סגורות. מספר גבוה של בעיות ללא מענה הוא דגל אדום. בדקו אם בעיות אחרונות מזכירות כשלים באימות, 403s או השבתות של Pushshift.
- קובץ LICENSE. בדקו אם הוא קיים. אין רישיון = עמימות משפטית (עוד על כך בהמשך).
- תלויות. האם הספריות הנדרשות מעודכנות? האם נעשה שימוש בחבילות שהוצאו משימוש?
requirements.txtמלא בגרסאות נעוצות מ-2022 הוא סימן אזהרה. - איכות ה-README. האם הוא מסביר את ההגדרה בצורה ברורה? האם יש דוגמאות שימוש? תיעוד חלש = יותר זמן דיבוג עבורכם.
- כוכבים מול Forks מול פעילות עדכנית. הרבה כוכבים אבל מעט פעילות עדכנית יכולים להעיד שהפרויקט היה פופולרי בעבר אבל ננטש. השוו את מספר הכוכבים לתאריך
pushed_at.
דוגמה מהירה: ל-PSAW יש 364 כוכבים — נראה אמין במבט ראשון. אבל המאגר בארכיון וה-README אומר "THIS REPOSITORY IS STALE."
כוכבים לבדם לא מספרים את הסיפור.
טיפים להפיק את המקסימום מההתקנה שלכם ל-Reddit Scraper GitHub
אם בכל זאת החלטתם ללכת במסלול קוד, הנה איך לחסוך לעצמכם כאב ראש.
תמיד השתמשו בסביבה וירטואלית
סביבה וירטואלית שומרת את התלויות של המגרד מבודדות, כך שלא יתנגשו עם פרויקטי Python אחרים. פקודה אחת: python -m venv venv ואז מפעילים אותה לפני שמתקינים משהו. זה היגיינה בסיסית, אבל ראיתי מספיק בעיות GitHub שכותרתן "module not found" כדי לדעת שזה שווה חזרה על זה.
אחסנו אישורים בצורה מאובטחת
אל תכתבו hardcode ל-client ID או ל-secret של Reddit בתוך הסקריפט. השתמשו במשתני סביבה או בקובץ .env, והוסיפו את .env ל-.gitignore. אם בטעות דחפתם אישורים ל-GitHub, החליפו אותם מיד — בוטים סורקים אחר מפתחות API חשופים.
תעדו הכול
הוסיפו לוגים לתגובות API, לכותרות מגבלת הקצב ולשגיאות. כשמשהו נשבר, לוגים הם ההבדל בין "אני יודע בדיוק מה קרה" לבין "אין לי מושג למה זה הפסיק".
תזמנו ואטמו בזהירות
אם אתם מריצים גריפות חוזרות, השתמשו ב-cron (Linux/Mac) או ב-Task Scheduler (Windows) — אבל עקבו אחרי כשלים. משימת cron שנכשלת בשקט במשך שבועיים גרועה יותר מאי-אוטומציה בכלל.
חלופה: Scheduled Scraper של Thunderbit מאפשר לכם לתאר את המרווח באנגלית פשוטה, בלי תחביר cron.
שיטות עבודה משפטיות ואתיות מומלצות לגריפת Reddit
זו לא הסתייגות סתמית. Reddit אכפה באגרסיביות את התנאים שלה מאז שינויי ה-API ב-2023, וגריפת נתונים אישיים טומנת בחובה חשיפה משפטית אמיתית.
הנה מה שבאמת חשוב.
תנאי השימוש של Reddit: מה הם באמת אומרים
הסכם המשתמש של Reddit (שעודכן עד 31 במרץ 2026) אוסר במפורש על גישה, חיפוש או איסוף נתונים מהשירותים באמצעים אוטומטיים, אלא אם הדבר מותר בתנאים או בהסכם נפרד. תנאי ה-Data API ו-תנאי המפתחים מוסיפים פרטים נוספים: Reddit רשאית לנטר ולבקר את השימוש של מפתחים, לשנות או להפסיק את הגישה, ולחסום לצמיתות גישה במקרה של שימוש מופרז או פוגעני. שימוש מסחרי בדרך כלל דורש אישור מפורש.
מדיניות ה-Responsible Builder ממרץ 2026 הולכת רחוק יותר: נדרש אישור לפני גישה לנתוני Reddit דרך ה-API, שימוש מסחרי או שימושי AI/data-mining ללא אישור אסורים, והאכיפה יכולה לכלול ביטול טוקנים, השעיית אפליקציות או חשבונות, והשעיית בוטים או דומיינים קשורים.
ציות ל-robots.txt
robots.txt הנוכחי של Reddit הוא מגביל באופן חריג:
User-agent: *
Disallow: /
זהו איסור גורף לכל סוכני המשתמש האוטומטיים. הוא גם מפנה ל-מדיניות התוכן הציבורי. זה הרבה יותר חזק מדפוסי robots.txt המתירניים שכמה מפתחים עדיין מניחים מהנורמות הישנות של גריפת אתרים.
שיטה מומלצת: תמיד לבדוק robots.txt לפני גריפה, גם אם הכלי שלכם לא אוכף זאת אוטומטית.
נתונים אישיים ופרטיות (GDPR/CCPA)
אם אתם גורפים שמות משתמש, היסטוריית פוסטים, או כל מידע מזהה אישי, ייתכן ש-GDPR (EU) ו-CCPA (קליפורניה) יחולו. שיטה מומלצת: אנונימיזציה או צבירה של נתונים אישיים לפני אחסון. אל תבנו פרופילים של משתמשים בודדים בלי בסיס חוקי.
רישוי מאגרי GitHub: לבדוק לפני שבונים
הרבה מאגרי reddit scraper github משתמשים ברישיונות MIT או Apache (מתירניים), אבל לחלקם אין קובץ רישיון בכלל — מה שאומר מבחינה משפטית "all rights reserved." לפני שאתם עושים fork, משנים או בונים על מאגר, בדקו תמיד את קובץ LICENSE. בלי רישיון = עמימות משפטית, בלי קשר למספר הכוכבים.
האכיפה אמיתית גם ב-2025–2026
סיפור האכיפה של Reddit לא נעצר ב-2023. Reddit הגישה תלונה נגד Anthropic ב-2025 בטענה לגריפה/שימוש לא מורשים בתוכן של Reddit, וגם נקטה צעדים ב-Reddit v. SerpApi בסוף 2025. אלה סימנים ש-Reddit מוכנה ללכת על אכיפה משפטית, ולא רק על חסימה טכנית.
איך לבחור את גישת Reddit Scraper GitHub הנכונה ב-2026
נוף ה-reddit scraper github השתנה באופן דרמטי מאז 2023. רוב המאגרים מיושנים. מגבלות הקצב ותקרת 1,000 הפוסטים הן אילוצים אמיתיים. Pushshift נעלם עבור משתמשים רגילים. ומבנה המדיניות של Reddit מפורש ומאכוף יותר מאי פעם.
הגרסה הקצרה:
- PRAW עדיין הבסיס הפתוח-מקור האמין ביותר אם אתם מוכנים לקבל את מגבלות ה-API של Reddit ורוצים לבנות לוגיקה מותאמת.
- Pushshift/PSAW כבר לא תשובה כללית.
- מודול Reddit של snscrape הוא מדור קודם ולא אמין.
- מגרדי
.jsonונקודות קצה ציבוריות הם שבריריים ולעיתים קרובות נחסמים ב-2026. - כלים מבוססי דפדפן — בין אם מאגרי Playwright או אפשרויות ללא קוד כמו Thunderbit — הם המסלול המעשי ביותר עבור משתמשים רבים, במיוחד מי שאינם מפתחים.
התחילו ממקרה השימוש שלכם, לא מהכלי. הריצו את בדיקת הבריאות של 5 דקות לפני שאתם מתחייבים לכל פרויקט GitHub.
ואם אתם מעדיפים לדלג על ההגדרה ולהתחיל לגרוף Reddit תוך דקות, תנו ל-Thunderbit ניסיון.
נסו את Thunderbit לגריפת Reddit Get Started Free
שאלות נפוצות
מהם מגרדי ה-Reddit הפתוח-מקור הטובים ביותר ב-GitHub ב-2026?
PRAW נשאר עטיפת ה-API האמינה ביותר, עם תחזוקה פעילה ותיעוד טוב. URS הוא כלי CLI מתוחזק ואמין שנבנה על PRAW. מגרדים מבוססי Playwright עובדים לגריפה בלי API, ומודול Reddit של snscrape פועל חלקית אך בעיקר ללא תחזוקה. תמיד בדקו את תאריך ה-commit האחרון ואת הבעיות הפתוחות לפני שימוש בכל מאגר — רוב 2,300+ מאגרי reddit scraper ב-GitHub כבר לא מעודכנים.
האם מותר לגרוף נתונים מ-Reddit מבחינה משפטית?
גריפת נתונים זמינים לציבור נמצאת באזור אפור משפטי, אבל תנאי השימוש של Reddit מגבילים. הסכם המשתמש, תנאי ה-Data API, מדיניות התוכן הציבורי, מדיניות ה-Responsible Builder, ו-robots.txt כולם מגבילים גריפה המונית לא מורשית. ייתכן שפצה מסחרי של נתונים שנגרפו ידרוש אישור מפורש מ-Reddit. אם אתם גורפים נתונים אישיים, ייתכן שגם GDPR ו-CCPA יחולו.
איך עוקפים את מגבלות ה-API של Reddit?
השתמשו בהשהיה אקספוננציאלית, עקבו אחרי כותרות X-Ratelimit-Remaining, ושקלו פיצול לחלונות זמן כדי לעבוד בתוך המגבלות. גריפה מבוססת דפדפן (Playwright או Thunderbit) עוקפת את מגבלות ה-API כי היא גורפת דפים מעובדים, אבל יש לה שיקולים משלה (מהירות טעינת דפים, מנגנוני אנטי-בוט). אין טריק קסם שמסיר את מגבלות הקצב לגמרי — הן נאכפות בצד השרת.
אפשר לגרוף Reddit בלי מפתח API?
כן. מגרדים מבוססי Playwright וטריק כתובות ה-URL של .json לא דורשים מפתחות API. גם Thunderbit לא דורש מפתח API כי הוא גורף דרך הדפדפן. החסרונות: נקודות קצה של .json נחסמות יותר ויותר (מחזירות 403 בסביבות רבות נכון לאפריל 2026), וגריפה מבוססת דפדפן איטית יותר וצורכת יותר משאבים מקריאות API.
מה קרה ל-Pushshift לגריפת Reddit?
הגישה הציבורית ל-API של Pushshift הוסרה בעקבות שינויי רישוי הנתונים של Reddit שהחלו ב-2023. העטיפה PSAW נמצאת בארכיון ומיושנת. ייתכן שתהיה גישה אקדמית מוגבלת דרך ערוצים מאושרים מסוימים, אבל עבור רוב המשתמשים שמחפשים היום "reddit scraper github", Pushshift כבר לא אופציה מעשית. אם אתם צריכים נתונים היסטוריים עמוקים מ-Reddit, בדקו את המסלולים האקדמיים או הנתונים ברישיון שאושרו על ידי Reddit.
למידע נוסף




