
בזבזתי מספר מגוחך של לילות מאוחרים על ניפוי באגים בסקריפטים שאמורים היו פשוט “למשוך קובץ ולהמשיך הלאה”. ברוב המקרים, האשם היה cURL שעשה בדיוק מה שביקשתי ממנו — לא מה שבאמת רציתי. מסתבר שיש פער גדול בין “curl -O עובד” לבין “curl -O עובד בצורה אמינה בייצור”.
בשביל הפער הזה נכתב המדריך הזה. cURL מותקן מראש ב-macOS, ברוב הפצות Linux, וב-Windows 10 ומעלה, כך שסביר מאוד שכבר יש לכם אותו על המחשב. אבל בין כשלי הפניה שקטים, שגיאות 403 מסתוריות, והמעבר מ“להוריד קובץ אחד” ל“להוריד 500 קבצים בלי להחריב את הטרמינל”, יש לא מעט מקומות להיתקע. כאן אעבור על הדגלים החשובים, על הפקודות שלב־אחר־שלב שבאמת אני משתמש בהן, על השגיאות שמכשילות הכי הרבה אנשים, ועל הנקודה שבה cURL באמת כבר לא מספיק — ומה כדאי להשתמש במקום.
מה זה cURL ולמה זה חשוב בכלל?
cURL הוא כלי שורת פקודה חינמי וקוד פתוח להעברת נתונים אל שרת או ממנו באמצעות כתובת URL. הוא תומך ב-HTTP, HTTPS, FTP, SFTP, ועוד רשימה ארוכה של פרוטוקולים, ולכן רואים אותו בכל מקום — מסקריפטים של bash ועד Dockerfiles וצינורות CI. מאחורי הקלעים, הפקודה curl שאתם מקלידים בטרמינל משתמשת ב-libcurl, ספריית ההעברה ב-C שמוטמעת אצל הרבה אפליקציות וממשקי שפה. הרחבת cURL של PHP היא דוגמה אחת; ספריית Requests הפופולרית של Python היא לקוח HTTP נפרד שנבנה על urllib3, ולא על libcurl.
הגרסה היציבה הנוכחית נכון לכתיבת שורות אלה היא curl 8.21.0, שיצאה ביוני 2026 — אבל אל תניחו שמערכת ההפעלה שלכם מגיעה בדיוק עם הבילד הזה. גרסאות שמגיעות דרך חבילות של ההפצה לרוב מפגרות אחרי הפרויקט המקורי בחודשים, לפעמים אפילו יותר, ולכן כדאי להריץ curl --version לפני שמניחים שדגל כמו --parallel זמין אצלכם.
למה להוריד קבצים עם cURL? מקרי שימוש מובילים
שואלים אותי לא מעט למה בכלל להשתמש בכלי שורת פקודה כשדפדפנים כבר מורידים קבצים מצוין. התשובה הכנה: דפדפנים נהדרים עד שצריך לבצע אוטומציה.
| שימוש | למה cURL מצטיין |
|---|---|
| הורדת בינאריים בצינורות CI/CD | אפשר לסקריפט, בלי ממשק גרפי |
| שליפת תגובות API או ייצואי נתונים | תומך בכותרות מותאמות, אימות, והעברת פלט הלאה |
| המשכת הורדות גדולות דרך SSH | תמיכה מובנית בהמשך הורדה (-C -) |
| אוטומציה של הורדות חוזרות (משימות cron) | קליל, ומשתלב מצוין עם סקריפטים של shell |
| הורדת קבצים מאחורי אימות | דגלי אימות גמישים (basic, token, cookies, .netrc) |
הורדה בדפדפן היא פעולה חד-פעמית בלחיצה ידנית. cURL הופך את אותה פעולה למשהו שאפשר לתזמן, לחבר לצינור עיבוד, לנסות שוב במקרה של כישלון, ולהריץ באופן זהה על מאה שרתים בבת אחת. בזה כל הקסם — הוא לא נוצץ יותר, הוא פשוט ניתן לחזרה.
דגלי cURL החיוניים להורדת קבצים
אני חוזר שוב ושוב על אותו סט של תריסר דגלים בערך עבור 90% ממה שאני עושה. הנה דף עזר שהלוואי שמישהו היה מוסר לי לפני שנים, מחולק לפי מה שהם באמת עושים.
דגלי פלט ושמירת קבצים
-O(--remote-name) שומר את הקובץ באמצעות החלק האחרון של ה-URL כשם הקובץ. נוח, אבל הוא עלול לדרוס בשקט קובץ קיים עם אותו שם.-o <filename>(--output) מאפשר לכם לבחור בדיוק את שם הקובץ:curl -o report.pdf https://example.com/downloads/file.pdf.-J(--remote-header-name) משתמש בשם הקובץ מתוך כותרתContent-Dispositionשל השרת במקום מתוך ה-URL. זה נוח להורדות מ-API, אבל כדאי להתייחס לשם שמגיע מהשרת כקלט לא מהימן — הורידו לתיקייה ייעודית ולא ל-home directory, בהתאם להנחיות האבטחה של curl.
דגלי התנהגות שכל הורדה צריכה
-L(--location) אומר ל-curl לעקוב אחרי הפניות HTTP. בלי זה, תגובת 3xx נשמרת כעמוד HTML קטן של הפניה במקום הקובץ האמיתי — זו הטעות הכי נפוצה שאני רואה של “למה ההורדה שלי שבורה”.-C -(--continue-at -) ממשיך הורדה שנקטעה מהמקום שבו נפסקה.-s/-Sמריצים בשקט אבל עדיין מציגים שגיאות — מצוין לסקריפטים שבהם לא רוצים סרגל התקדמות שמעמיס על הלוגים.--limit-rate 1Mמגביל רוחב פס (שימושי על חיבור משותף או כשלא רוצים להשתלט על רשת מדודה).--connect-timeout 10ו---max-time 300מונעים מחיבור תקוע להקפיא את הסקריפט לנצח.--retry 3ו---retry-delay 5מנסים מחדש אוטומטית כשיש כשל זמני — לפי דף ה-man של curl, כדאי לצרף את--retry-all-errorsרק כשבאמת בטוח לחזור בדיוק על אותה בקשה.
דגלי התקדמות וניפוי שגיאות
-#מציג פס התקדמות פשוט במקום טבלת הסטטיסטיקות הרגילה.-vמציג פלט מפורט, כולל את כל כותרות הבקשה/תגובה — הבחירה שלי כשמשהו מתנהג מוזר.-I(--head) מביא רק את כותרות התגובה, וזו בדיקה מקדימה מצוינת לפני שמתחייבים להורדה גדולה.-wמאפשר להדפיס פלט מותאם אישית אחרי ההעברה, למשלcurl -o /dev/null -s -w "%{http_code}\n" <url>כדי לבדוק רק קוד סטטוס.
לפני שמתחילים
- רמת קושי: מתחיל עד בינוני (החלקים של batch ואימות קצת מתקדמים יותר)
- זמן נדרש: בערך 15–20 דקות לעבור על הפקודות המרכזיות
- מה צריך: טרמינל (macOS Terminal, shell של Linux, או Windows PowerShell/WSL), מותקן curl (בודקים עם
curl --version), וכתובת URL לבדיקה — אני אשתמש בדוגמה של נכס שחרור ציבורי מ-GitHub כי הוא יציב ונגיש בחינם
איך להוריד קבצים עם cURL: צעד אחר צעד
שלב 1: הורדת קובץ בודד
הבסיס הפשוט: curl -O <url> שומר את הקובץ בשם המקורי שלו, בעוד curl -o myfile.zip <url> מאפשר לשנות את השם בדרך.
curl -LO https://github.com/curl/curl/releases/download/curl-8_21_0/curl-8.21.0.tar.gz
אני מוסיף היום -L כברירת מחדל, תמיד, בלי יוצא מן הכלל — נכוויתי מספיק פעמים מהפניה שקטה שהפכה את ה“הורדה” שלי לקובץ HTML של 400 בייט. אתם אמורים לראות מד התקדמות עולה בטרמינל, ובסוף הקובץ יישב בתיקייה הנוכחית.
כשהפקודה מצליחה, מד ההתקדמות מגיע ל-100% ו-curl-8.21.0.tar.gz מופיע בתיקייה הנוכחית. כדאי לאמת את הקובץ לפני שמשתמשים בו:
ls -lh curl-8.21.0.tar.gz
שלב 2: הורדה ושינוי שם הקובץ
משתמשים ב--o כשצריך שם קובץ מקומי מסוים ולא מה שה-URL מסתיים בו במקרה:
curl -L -o curl-latest.tar.gz -S https://github.com/curl/curl/releases/download/curl-8_21_0/curl-8.21.0.tar.gz
ה--S כאן מפעיל מחדש הצגת שגיאות במקרה שגם העברתם -s במקום אחר בסקריפט. השילוב הזה — -L -o <name> -S — הוא כמעט פקודת ברירת המחדל שלי להורדת קובץ בודד.
שלב 3: המשכת הורדה שנקטעה
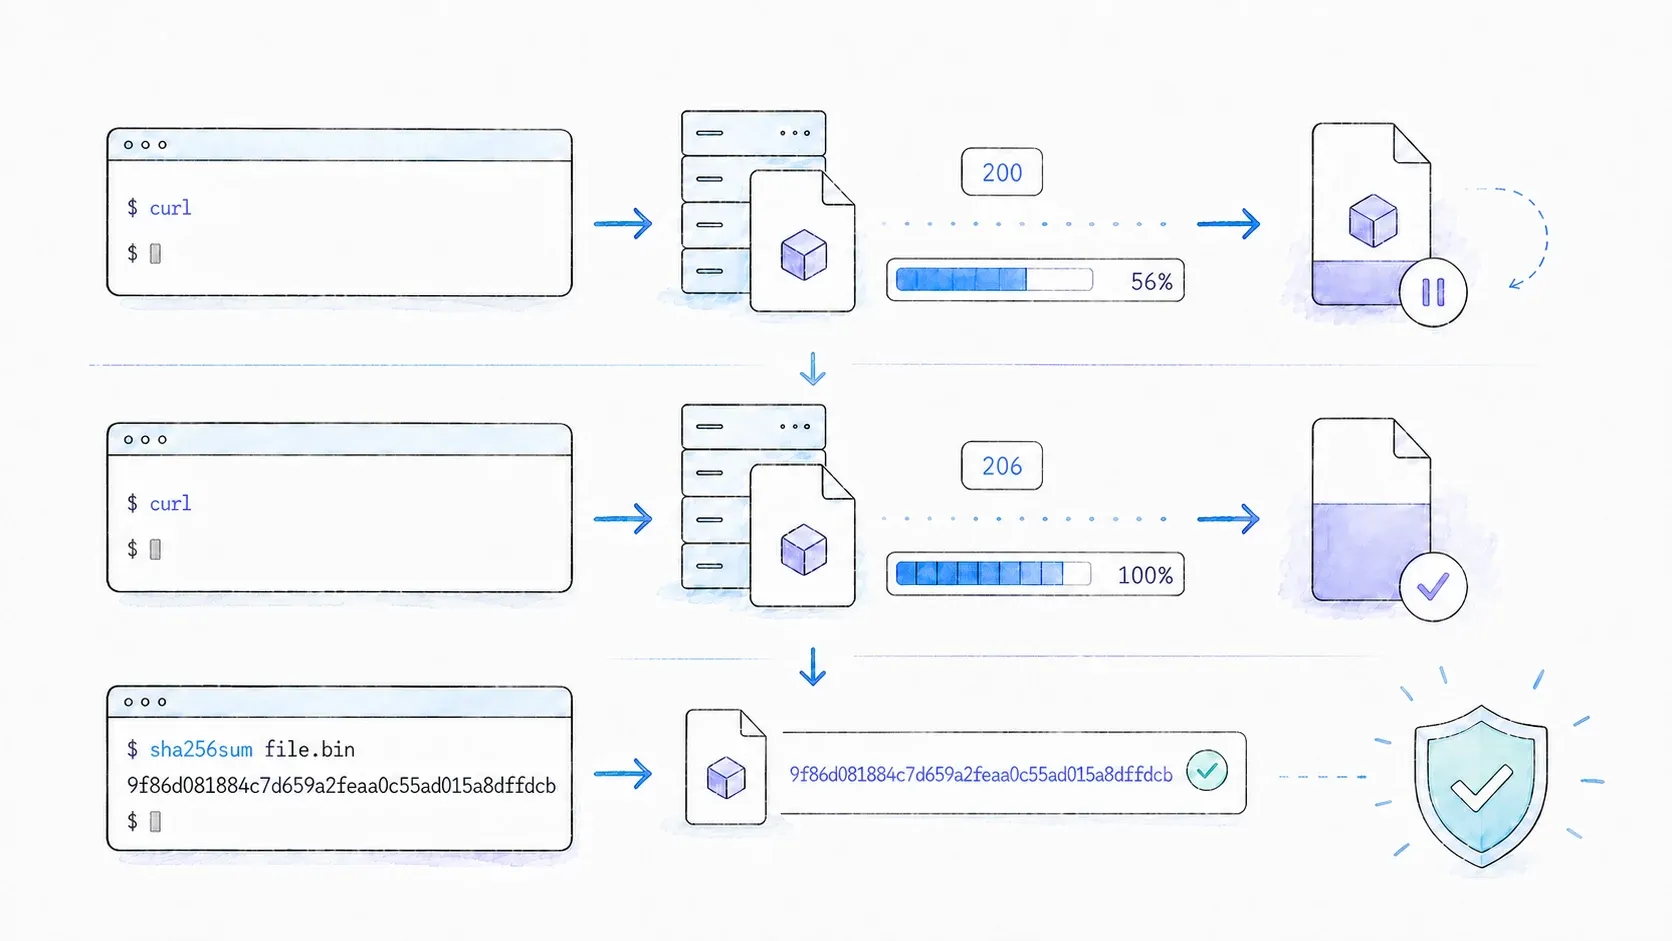
אם הורדה גדולה נופלת באמצע (Wi‑Fi בעייתי, קפיצת VPN, מה שלא יהיה), לא צריך להתחיל מהתחלה. מריצים:
curl -C - -LO https://example.com/large-file.iso
המלכודת: זה עובד רק אם השרת תומך בבקשות טווחי בתים. Accept-Ranges: bytes הוא סימן חיובי שימושי, אבל היעדרו לא מוכיח שטווחים לא נתמכים. הבדיקה האמינה היא תגובת השרת לבקשת טווח אמיתית: תגובה שניתנת להמשך תחזיר בדרך כלל 206 Partial Content עם Content-Range תקין. מריצים את פקודת ההמשך ובודקים את הסטטוס עם -v או -D -; אם השרת מתעלם מהטווח או דוחה את המיקום, עדיף להתחיל מחדש במכוון מאשר להניח שהקובץ החלקי בטוח.
שלב 4: הורדה עם סרגל התקדמות או בשקט
למראה נקי יותר בטרמינל אינטראקטיבי: curl -# -LO <url>. עבור סקריפטים ומשימות cron שבהן רוצים רק שגיאות, בלי רעש: curl -sS -LO <url>. אני משתמש בגרסה השקטה כמעט בכל מקום, חוץ ממצבים שבהם אני מנפה באגים ידנית.
שלב 5: הגבלת מהירות ההורדה
בחיבור משרדי משותף (או כשלא בא לי להיות “האחד הזה” שתופס את כל רוחב הפס במהלך שיחת וידאו), אני מגביל עם:
curl --limit-rate 1M -LO https://example.com/big-dataset.zip
היחידות הן K, M, ו-G עבור קילובייט, מגה-בייט וג׳יגה-בייט לשנייה, בהתאמה.
שלב 6: שמירת כותרות התגובה לצד הקובץ
לפעמים אני צריך לדעת בדיוק מה השרת החזיר — סוג תוכן, כותרות cache, דברים כאלה — בלי להעמיס על הטרמינל:
curl -L -D headers.txt -o file.zip https://example.com/file.zip
זה שומר את כותרות התגובה ב-headers.txt, בזמן שהקובץ עצמו נשמר כ-file.zip. מעולה לניפוי בעיות של אי-התאמה ב-content-type או לאימות ש-CDN באמת שומר במטמון את מה שאתם חושבים שהוא שומר.
טיפים ומלכודות נפוצות
- טיפ: תמיד להשתמש ב-
-Lכברירת מחדל. אני באמת לא מצליח לחשוב על חיסרון בלכלול אותו, ובזבזתי שעות בגלל ששכחתי אותו. - טיפ: כשכותבים סקריפט, שלבו
--failעם פקודת ההורדה כך שתשובה שאינה 2xx באמת תגרום לסקריפט לצאת עם שגיאה, במקום לשמור בשקט עמוד שגיאה כאילו היה הקובץ שלכם. - מלכודת: אל תשלבו
-C -עם--remove-on-error— curl מתעד אותם כלא תואמים, כי המשך הורדה דורש שהקובץ החלקי עדיין יהיה שם. - מלכודת:
-Oיכול לדרוס קבצים בלי אזהרה. אם אתם מורידים באצווה לתיקייה משותפת, השתמשו ב---output-dirכדי לשמור על סדר.
איך מורידים כמה קבצים והורדות batch עם cURL
דוגמאות לקובץ יחיד הן החלק הקל. תהליכי העבודה האמיתיים שבניתי — שליפת ייצואי נתונים ליליים, סנכרון בינאריים בין שרתי build — דרשו מקביליות, וכאן רוב המדריכים פשוט... עוצרים. יש שלוש גישות שכדאי להכיר, כל אחת צעד נוסף במורכבות.
גישה 1: כמה כתובות URL בפקודת cURL אחת
האפשרות הכי פשוטה היא פשוט לרשום כמה URLs:
curl -LO https://example.com/a.zip -LO https://example.com/b.zip -LO https://example.com/c.zip
זה עובד, אבל זה רציף — curl מסיים קובץ אחד לגמרי לפני שהוא מתחיל את הבא. בסדר לשלושה קבצים, מעצבן לשלוש מאות.
גישה 2: הורדות מקביליות עם --parallel (curl 7.66+)
מאז curl 7.66, אפשר להוסיף --parallel (או -Z) כדי להביא כמה URLs במקביל:
curl --parallel --parallel-max 5 --remote-name-all \
  https://example.com/a.zip https://example.com/b.zip https://example.com/c.zip
שווה לדעת: ברירת המחדל של parallel max היא למעשה 50, וזה הרבה יותר חיבורים מקבילים ממה שרוב השרתים — או הרשת שלכם — יעריכו. אני שומר את --parallel-max מפורש ושמרני — בדרך כלל 4 עד 8 — במקום לסמוך על ברירת המחדל.
גישה 3: xargs ולולאות Bash למקביליות מתוך רשימת URLs
עבור רשימה גדולה של URLs בקובץ טקסט, אני בדרך כלל הולך על xargs:
cat urls.txt | xargs -n1 -P 8 curl -O -L
או, אם אני רוצה יותר שליטה על מה שקורה לכל משימה, לולאת bash עם תהליכי רקע:
while read -r url; do
  curl -O -L "$url" &
done < urls.txt
wait
ה-wait בסוף חשוב — בלעדיו הסקריפט יוצא לפני שההורדות ברקע מסתיימות.
מתי עדיף להשתמש ב-wget או aria2 במקום
אגיד את זה ישירות: cURL הוא לא תמיד הכלי הנכון. אם צריך לשקף עץ ספריות שלם של אתר, wget -r עושה סריקה רקורסיבית כבר מהקופסה בדרך ש-cURL פשוט לא נבנה עבורה. אם צריך הורדות מרובות-מקורות ומפוצלות למקטעים כדי להפיק את המהירות המקסימלית על קובץ ענק אחד, aria2c באמת מהיר יותר.
| כלי | הכי מתאים ל |
|---|---|
| cURL | דיוק, סקריפטים, הורדה של קובץ בודד או אצווה קטנה, עבודה עם APIs |
| wget | הורדות רקורסיביות/מראות של אתרים, שליפה פשוטה של קבצים סטטיים בכמות גדולה |
| aria2 | הורדות ממספר מקורות/מקטעים, מקסום תפוקה בקבצים גדולים |
החוזקה של cURL תמיד הייתה דיוק ויכולת חיבור לרכיבים אחרים — piping, סקריפטים, גמישות בפרוטוקולים — ולא סריקה אגרסיבית.
איך מורידים קבצים מוגנים עם cURL: דפוסי אימות
רוב המדריכים על cURL עוצרים ב--u user:pass ומסיימים. זה שריד לאינטרנט של פעם. ב-2026, הקבצים שאני מוריד בפועל מגיעים מ-REST APIs, לוחות בקרה מבוססי סשן, ומערכות CI — וכל אחד מהם רוצה סוג אחר של אישור.
Basic Auth
curl -u username:password -O https://legacy-server.example.com/file.zip
בסדר לשרתי FTP ישנים או לנקודות קצה פשוטות של HTTP. רק כדאי לדעת שהסיסמה מופיעה בהיסטוריית ה-shell וברשימת התהליכים אם לא נזהרים — לא משהו שהייתי משתמש בו למשהו רגיש.
אימות באמצעות Bearer / OAuth Token
זה אחד הדפוסים שפחות מקבלים מקום במדריכים, ובאופן אישי זה מה שאני משתמש בו הכי הרבה היום:
curl -H "Authorization: Bearer $GITHUB_TOKEN" \
  -LO https://api.github.com/repos/curl/curl/releases/assets/12345
זה דפוס אמיתי לשליפת נכס פרטי של שחרור מ-GitHub — פשוט מחליפים את הטוקן ואת מזהה הנכס. כמעט כל REST API ומשאב מוגן ב-OAuth2 מדברים היום בשפה הזו.
אימות מבוסס Cookies
עבור אפליקציות ווב שבהן התחברות יוצרת סשן, שומרים את קובץ ה-cookies בזמן ההתחברות ומשתמשים בו בעת ההורדה:
curl -c cookies.txt -d "user=me&pass=secret" https://example.com/login
curl -b cookies.txt -O https://example.com/protected/file.zip
קובץ .netrc לסביבות סקריפט ו-CI
זו השיטה המועדפת עליי לכל דבר שרץ בלי השגחה. יוצרים קובץ ~/.netrc (או _netrc ב-Windows):
machine example.com
login myusername
password mypassword
נועלים אותו עם chmod 600 ~/.netrc, ואז מפנים אליו כך:
curl --netrc -LO https://example.com/protected-file.zip
היתרון הוא שהאישורים אף פעם לא נוגעים בהיסטוריית ה-shell או בקוד של הסקריפט — וזה באמת חשוב ב-CI/CD, שם סקריפטים לא פעם נרשמים בלוגים במלואם.
| שיטת אימות | דגל/אפשרות | הכי מתאים ל |
|---|---|---|
| Basic auth | -u user:pass | FTP ישן, HTTP פשוט |
| Bearer token | -H "Authorization: Bearer <token>" | REST APIs, OAuth2 |
| Cookie auth | -b cookies.txt (+ -c לשמירה) | אפליקציות ווב מבוססות סשן |
קובץ .netrc | --netrc או --netrc-file | CI/CD, סביבות סקריפט |
פתרון תקלות נפוצות בהורדות cURL
זה החלק שהלוואי שהיה קיים כשאני התחלתי, כי כמעט אף אחד לא מסביר אותו. “למה ההורדה שלי עם curl לא עובדת” היא שאילתה אמיתית, נפוצה ומתסכלת מאוד — וברוב המקרים התיקון הוא שורה אחת ברגע שמבינים את הסיבה.
| סימפטום | סיבה סבירה | תיקון |
|---|---|---|
curl: (60) SSL certificate problem | תעודה חתומה עצמית או שפג תוקפה | --cacert <file> או -k (לסביבת פיתוח בלבד) |
403 Forbidden / קובץ ריק | השרת חוסם את User-Agent ברירת המחדל של curl | -A "Mozilla/5.0..." או -H "User-Agent: ..." |
ההורדה מתחילה מחדש מ-0 עם -C - | השרת לא תומך ב-Range | לבדוק עם curl -I <url> אם יש Accept-Ranges: bytes |
| נשמר קובץ בגודל 0 בייט | ההפניה לא נעקבה | להוסיף דגל -L |
curl: (28) Operation timed out | שרת איטי או בעיות רשת | --connect-timeout 10 --max-time 300 + --retry 3 |
| נשמר עמוד HTML במקום הקובץ | העמוד דורש רינדור JavaScript | curl לא מריץ JS — ראו את הסעיף למטה |
שגיאות SSL: מה הן אומרות ואיך מתקנים
שגיאה 60 אומרת ש-curl לא הצליח לאמת את תעודת ה-SSL של השרת — בדרך כלל כי היא חתומה עצמית, פג תוקפה, או הונפקה על ידי CA ש-curl לא סומך עליו. אם אתם שולטים בשרת, כוונו את curl לשרשרת ה-CA הנכונה עם --cacert /path/to/ca.pem. הדגל -k (--insecure) מדלג על האימות לחלוטין, וזה בסדר בסביבת פיתוח מקומית ורעיון ממש גרוע לכל דבר שנוגע לייצור או לנתוני משתמש אמיתיים.
403 Forbidden והורדות ריקות
מספר מפתיע של שרתים חוסמים בקשות שמזדהות כ-curl/8.21.0 (מחרוזת ה-User-Agent ברירת המחדל של curl), מתוך הנחה שמדובר בבוטים או בסקרייפרים. לרוב התיקון הוא פשוט להתחזות לדפדפן:
curl -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64)" -LO https://example.com/file.zip
כדי לבדוק מה באמת חוזר לפני שמתחייבים להורדה מלאה, אני מריץ: curl -o /dev/null -s -w "%{http_code}\n" <url>.
טיימאאוטים, ניסיונות חוזרים וחיבורים לא יציבים
זו הפקודה שהייתי מקעקע על הזרוע אם הייתי אמיץ יותר לגבי קעקועים.
פקודת ההורדה שלי, זו שבאמת אני משתמש בה בסקריפטים בייצור, משלבת יחד את כל דגלי האמינות:
curl -L -C - --retry 5 --retry-delay 3 --connect-timeout 10 --max-time 600 --fail -O <url>
כלומר: עוקב אחרי הפניות, ממשיך הורדה, חמישה ניסיונות חוזרים עם השהיה של 3 שניות, timeout של 10 שניות לחיבור, תקרת זמן כוללת של 10 דקות, וכשל חזק על קוד HTTP בעייתי — בעצם כל מה שלמדתי בדרך הקשה שכדאי לכלול.
cURL באוטומציה אמיתית: צינורות CI/CD, piping ובטיחות סקריפטים
העברת פלט של cURL לכלים אחרים
curl לא חייב לשמור משהו לדיסק בכלל — העברה ישירה לפקודה אחרת היא אחת היכולות הכי לא מוערכות שלו:
curl -sL https://example.com/archive.tar.gz | tar xz
curl -s https://api.example.com/data | jq '.results'
מורידים ומחלצים, או מורידים ומנתחים, בשורה אחת. זה הדפוס שאני משתמש בו כל הזמן לשליפות נתונים נקודתיות.
שימוש ב-cURL ב-GitHub Actions וב-CI/CD
שלב מינימלי ב-GitHub Actions שמוריד בינארי עם לוגיקת ניסיון חוזר ונכשל בקול רם במקרה של שגיאה:
- name: Download binary
  run: |
    curl -L --fail --retry 3 --retry-delay 5 \
      -o app-binary "https://example.com/releases/app-binary"
שומרים טוקנים כ-secrets של CI ומפנים אליהם דרך משתני סביבה — לעולם לא מקודדים אותם קשיח בתוך הסקריפט עצמו. ומשתמשים ב---fail (או --fail-with-body אם צריך לראות את גוף השגיאה לצורכי ניפוי באגים) כך שהורדה שבורה באמת תפיל את ה-build במקום להצליח בשקט עם זבל.
שאלת האבטחה של curl | sh
הנושא הזה עולה כמעט בכל פורום מפתחים שקראתי, ובצדק: להעביר curl ישירות ל-sh פירושו להריץ קוד מרוחק שלא הסתכלתם עליו, תוך הסתמכות מלאה על כך שהשרת לא נפרץ ושלא נעשתה התערבות בדרך. זה הסיכון האמיתי — לא פרנויה, אלא חשש לגיטימי מאוד משרשרת אספקה.
הגישה הבטוחה יותר היא להוריד קודם, לבדוק את הסקריפט, לאמת checksum או חתימת GPG אם יש כזו, ורק אז להריץ:
curl -sL https://example.com/install.sh -o install.sh
cat install.sh   # ממש לקרוא את הקובץ
sha256sum install.sh   # להשוות ל-checksum שפורסם, אם קיים
bash install.sh
מַתקינים מוכרים כמו rustup ו-Homebrew עדיין משתמשים בדפוס curl | sh, ובדרך כלל זה מקובל במקרים הספציפיים האלה כי התחזוקה וערוץ ההפצה מבוססים היטב. אבל אני עדיין מעדיף להשקיע עוד עשר שניות בבדיקה מאשר לגלות בדרך הקשה שלא הייתי צריך לסמוך על זה.
מתי cURL כבר לא מספיק: דפים עם רינדור JavaScript, אתרים נגד בוטים ונתונים מובנים
יש מצב כשל שמכשיל הרבה אנשים, וברוב הפעמים זה לא באשמתם: מריצים curl -O על משהו שנראה כמו עמוד רגיל, ובמקום התוכן המצופה מקבלים שלד HTML ריק, או דף אתגר של Cloudflare, או משהו שנראה כמו אשפה. curl עשה בדיוק את מה שהוא נבנה לעשות — שלף את תגובת ה-HTTP הגולמית — פשוט הוא לא מסוגל להריץ JavaScript, לפתור CAPTCHA, או לעבור מערכת fingerprinting נגד בוטים. אלה לא באגים ב-curl; זה פשוט מחוץ להגדרת התפקיד שלו.
למה cURL נכשל בדפי אינטרנט מודרניים
אפליקציות חד-עמודיות מודרניות רבות מחזירות שלד HTML כמעט ריק, וההתוכן האמיתי מוצג בצד הלקוח באמצעות JavaScript אחרי טעינת הדף — משהו ש-curl לעולם לא מריץ. מעבר לכך, מערכות כמו Cloudflare ו-Akamai מגישות דפי אתגר באופן יזום לכל דבר שלא נראה כמו דפדפן אמיתי, ובקשות cURL חוזרות מאותו IP יכולות מהר מאוד להיחסם או להיות מזוהות כתעבורת בוטים.
הצעד הבא: APIs של scraping מבוססי AI למפתחים
הייתי אומר ש-curl הוא הכלי הנכון בערך ל-80% מההורדות של קבצים והנתונים שם בחוץ — נכסים סטטיים, תגובות API, וכל דבר שמוגש כמשאב HTTP פשוט. זה ב-20% האחרים, העשירים ב-JavaScript או מוגנים נגד בוטים, שראיתי מפתחים מבזבזים שעות בלחימה בכותרות ו-User-Agent לפני שהם בסוף מוותרים ופונים לשכבה אחרת לגמרי.
בדיוק את הפער הזה הצוות שלי בנה כדי לסגור עם Thunderbit, לצד תוסף Chrome שרוב האנשים מכירים אותנו בזכותו. בצד של המפתחים, ה-Open API של Thunderbit נותן לכם POST /distill, שמחזיר Markdown נקי ומוכן ל-LLM מתוך URL — כשהרינדור של הדף מטופל על ידי השירות — וגם POST /extract, שמחזיר JSON מובנה שתואם לסכימה כשצריך נתונים שדותיים אמיתיים ולא טקסט קריא. יש גם שרת MCP כך שסוכנים ב-Claude או Cursor יכולים לקרוא ל-thunderbit_distill ול-thunderbit_extract באמצע משימה, וגם CLI (npx @thunderbit/thunderbit-cli distill <url>) שמתנהג הרבה כמו curl בטרמינל. אפשר להעביר פלט JSON ל-jq, למשל thunderbit distill <url> --format json | jq -r '.data.markdown'; או לשלוח פלט --format markdown לכלי טקסט או לקובץ במקום.
זה לצד זה, ההבדל חד מאוד. בקשת curl לעמוד מוצר עם רינדור JS עלולה להחזיר בעיקר <div id="root"></div> ריק. הפקודה המקבילה thunderbit distill מחזירה תוכן עמוד מעובד כ-Markdown נקי. Distill עולה 1 קרדיט לכל URL ו-Extract עולה 20 קרדיטים לכל URL. המגבלות הספציפיות לנקודת הקצה כרגע שונות: Batch Distill תומך בעד 100 URLs לכל משימה, בעוד Batch Extract מקבל עד 50 URLs עם סכימה משותפת אחת. כדאי לבדוק את תיעוד ה-API העדכני לפני שמגדירים תור ייצור.
אם אתם חדשים יותר למושג הזה בכלל, ההסבר שלנו על מה באמת כולל web scraping הוא נקודת התחלה טובה, ו-המדריך ל-scraping ללא קוד מכסה את הצד הלא-מפתחי של אותה בעיה לכל מי בצוות שלא מתכוון לפתוח טרמינל. להשוואה רחבה יותר של כלים בתחום, ריכזנו גם סקירה של ה-AI web scrapers הטובים ביותר שכדאי להכיר.
דף עזר מהיר: צ'יט-שיט להורדה עם cURL
| משימה | פקודה |
|---|---|
| הורדה בסיסית | curl -LO <url> |
| שם קובץ מותאם אישית | curl -L -o myfile.zip <url> |
| המשכת הורדה | curl -C - -LO <url> |
| שקט עם הצגת שגיאות | curl -sSL -O <url> |
| הורדות מקביליות | curl --parallel --parallel-max 5 -O <url1> -O <url2> |
| אימות עם Bearer token | curl -H "Authorization: Bearer <token>" -LO <url> |
| פקודת הורדה מומלצת בסקריפטים | curl -LO --retry 5 --retry-delay 3 --max-time 600 --fail <url> |
| העברה לכלי חילוץ | curl -sL <url> | tar xz |
סיכום ונקודות מפתח
הורדת קובץ עם curl מתחילה פשוט — curl -O ואתם כמעט גמורים — אבל המיומנות האמיתית נמצאת בשכבות שמתחת: לדעת מתי להוסיף -L, מתי להמשיך הורדה במקום להתחיל מחדש, איזה דפוס אימות מתאים באמת לזרימת העבודה שלכם, ומה עושים ברגע ש-403 או מעטפת HTML ריקה מופיעים במקום הקובץ שציפיתם לו. נשענתי על כל אחד מהדפוסים האלה מתישהו, בדרך כלל מיד אחרי שלמדתי בדרך הקשה למה זה חשוב.
curl נשאר, בלי ספק, הכלי המועדף שלי להורדות קבצים פשוטות ולעבודה עם HTTP שניתן לסקריפט — הוא מהיר, הוא נמצא כמעט בכל מקום, והוא משתלב נהדר עם שאר צינור ה-shell. אבל כשנתקלים בעמוד עם רינדור JavaScript או בחומת הגנה נגד בוטים, זו לא בעיה שפותרים עם עוד דגלים; זה סימן שצריך שכבה אחרת, ודווקא שם API כמו זה של Thunderbit נכנס לתמונה בלי להוציא אתכם מהטרמינל.
שמרו את דף העזר, נסו את פקודת הניסיון החוזר וההמשך בהורדה הבאה שתהיה לא יציבה, ואם תגיעו לאותו קיר שבו curl פשוט מחזיר זבל — אתם כבר יודעים איך נראה הצעד הבא. דף המחירים של Thunderbit מציג את פירוט הקרדיטים העדכני אם תרצו להבין מה עלות ההסלמה הזו בפועל, ו-ערוץ YouTube שלנו כולל סרטוני הדרכה אם אתם מעדיפים לצפות מאשר לקרוא.
שאלות נפוצות על הורדת קבצים עם cURL
איך מורידים קובץ עם cURL ושומרים אותו בשם מסוים?
משתמשים ב--o ואחריו שם הקובץ הרצוי: curl -L -o yourname.ext <url>. הוסיפו -L כדי שהפניות לא יטרפדו את ההורדה.
איך ממשיכים הורדה שנכשלה ב-cURL?
מריצים curl -C - -LO <url>. זה עובד רק אם השרת תומך בבקשות טווח — קודם כדאי לבדוק עם curl -I <url> ולחפש Accept-Ranges: bytes בתגובה.
האם cURL יכול להוריד קבצים שדורשים התחברות?
כן, בארבע דרכים עיקריות: basic auth (-u user:pass), bearer tokens (-H "Authorization: Bearer <token>"), סשנים מבוססי cookies (-b cookies.txt), או קובץ .netrc לסביבות סקריפט. ראו למעלה את סעיף האימות לפירוט מלא ומתי כל אחת מהאפשרויות מתאימה.
מה ההבדל בין cURL ל-wget כשמורידים קבצים?
cURL תומך ביותר פרוטוקולים ובדרך כלל טוב יותר לסקריפטים, piping, והורדה מדויקת של קובץ בודד או אצווה קטנה. wget נבנה לסריקה רקורסיבית ולשיקוף של ספריות אתרים שלמות, ולכן הוא הבחירה הטובה יותר למשיכת אתרים סטטיים בכמות גדולה.
למה cURL מוריד עמוד HTML במקום את הקובץ האמיתי?
בדרך כלל יש שני אשמים: שכחתם את הדגל -L והשרת הפנה אתכם למקום אחר, או שהעמוד צריך JavaScript כדי לרנדר את התוכן האמיתי שלו — משהו ש-curl פשוט לא יודע להריץ. במקרה השני, תצטרכו כלי שמסוגל לרנדר, לא עוד דגלים של curl.



