
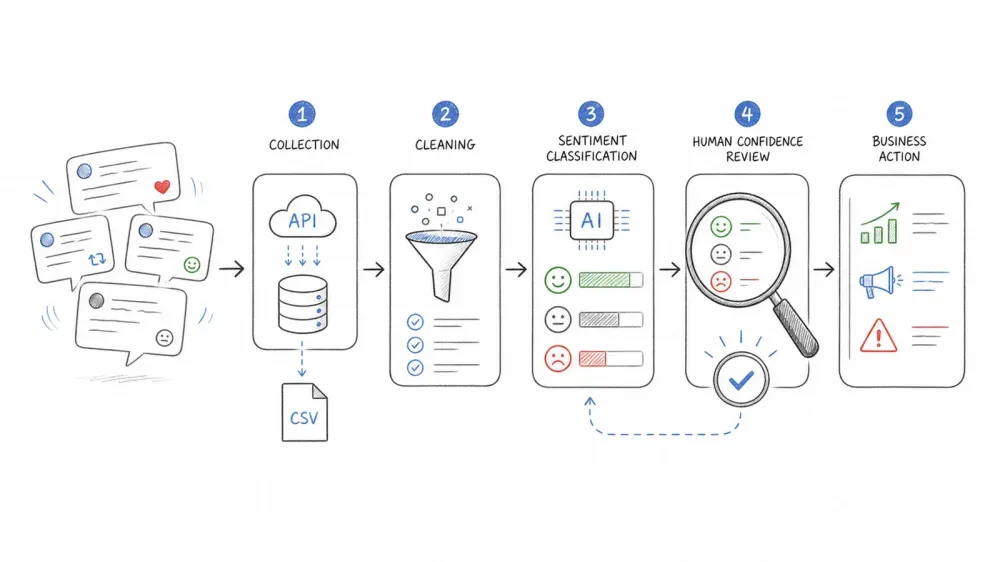
פותחים גיליון עם 300 פוסטים גולמיים, והבעיה נהיית ברורה מיד: להעתיק, להדביק, לקרוא, לצמצם עיניים, לנחש, לחזור על זה — ועדיין לא באמת לדעת אם האנשים אהבו או שנאו את ההשקה שאתם עוקבים אחריה.
בדיוק בגלל זה קיים ניתוח סנטימנט. אבל הנה הקאץ': רוב המדריכים בתחום תקועים ב-2022. הם מניחים שיש גישה חינמית ל-API שכבר לא קיימת, ממליצים על מודלים שמתקשים עם סרקזם ואימוג'י, ומדלגים על שלבי העיבוד המוקדם שבפועל קובעים אם התוצאות שלכם שוות משהו. השקענו לא מעט זמן בעולם ה-SaaS והאוטומציה (כולל בניית Thunderbit), וראיתי את תחום ניתוח הסנטימנט משתנה בצורה דרמטית. המסלול העדכני והכנה כולל גם Python וגם תהליכים ללא קוד, עם שיטות איסוף נתונים ומודלים שמשקפים את המציאות של 2026.
מהו ניתוח סנטימנט בטוויטר?
ניתוח סנטימנט בטוויטר הוא תהליך של סיווג אוטומטי של פוסטים ב-X כחיוביים, שליליים או ניטרליים על סמך הטקסט, האימוג'י וההקשר שלהם. אפשר לחשוב על זה כמו ללמד מכונה לקרוא ציוץ ולענות על השאלה: "האדם הזה שמח, מאוכזב, או איפשהו באמצע?"
עם זאת, ניתוח סנטימנט שונה מ-social listening כללי. Social listening עוסק במעקב אחרי מה אנשים מדברים עליו — נושאים, טרנדים, נפח שיח. ניתוח סנטימנט הוא שכבת הניקוד והסיווג שמעל זה: הוא אומר איך אנשים מרגישים לגבי מה שהם אומרים. הרעיון עצמו נשען על בלשנות חישובית ומחקרי mining opinion שנמשכים כבר עשרות שנים, אבל רק בשנים האחרונות הוא הפך לכלי עסקי נפוץ.
יש כמה רמות סיווג מקובלות:
- בינארי: חיובי או שלילי (הכי פשוט, אבל מאבד ניואנסים)
- תלת-ערכי: חיובי, ניטרלי או שלילי (ברירת המחדל הנפוצה ביותר)
- מפורט: חיובי מאוד → שלילי מאוד (שימושי למחקר ולמעקב מדויק אחר מותג)
יש גם משימות קרובות אך שונות — כמו זיהוי רגשות (כעס, עצב, שמחה), זיהוי עמדה (בעד או נגד טענה), סנטימנט ברמת היבט (איך מישהו מרגיש לגבי מחיר לעומת איכות), וזיהוי סרקזם/אירוניה. TweetEval benchmark מתייחס אליהן כמשימות נפרדות, ובצדק: ניקוד סנטימנט אחד לא יכול לענות על כל שאלה עסקית. אם אתם עוקבים אחרי השקת מוצר, כנראה שתרצו סנטימנט ברמת היבט ("אוהבים את המצלמה, שונאים את הסוללה"). אם אתם עוקבים אחרי משבר, תרצו רגש ונפח, לא רק קוטביות.
למה ניתוח סנטימנט בטוויטר חשוב לעסק שלכם
X בנוי סביב שיחה בזמן אמת, ולכן תגובות להשקות, אירועים חיים וחדשות מתפרצות יכולות להיערם מהר מאוד. עבור עסקים, המהירות הזו היא כל העניין. ניתוח סנטימנט הופך זרם טקסט לא מובנה לנתונים מובנים שהצוות יכול לבדוק ולפעול לפיהם.
השימושים הנפוצים ביותר נראים כך:
| שימוש | צוות | תוצאה עסקית |
|---|---|---|
| מעקב אחר מוניטין המותג | יחסי ציבור, שיווק | לזהות קפיצות שליליות לפני שהן הופכות לוויראליות |
| משוב על השקת מוצר | מוצר, שיווק | להבין מה עובד ומה לא, בזמן אמת |
| השוואה תחרותית | אסטרטגיה, שיווק | להשוות תפיסת מותג מול מתחרים באותם חלונות זמן |
| זיהוי משברים | יחסי ציבור, תפעול | להפעיל בדיקה אנושית כשנפח שלילי מזנק |
| ביצועי קמפיין | שיווק | למדוד שינוי בסנטימנט לפי קריאייטיב, ערוץ או זמן |
| סנטימנט שוק/מניות | פיננסים, מחקר | לעקוב אחרי מצב הרוח הציבורי סביב דוחות, אירועים או מדיניות |
| מחקר פוליטי ומדיניות | מחקר, ממשל | להעריך דעת קהל על נושאים בהיקף גדול |
כדי להפוך את זה למוחשי: סיכום ה-Super Bowl של X ב-2026 דיווח על 16 מיליון פוסטים מ-4 מיליון כותבים, 5 מיליארד חשיפות ו-605 מיליון צפיות וידאו סביב אירוע אחד — כאשר חצי מהשיחה התרחשה בזמן אמת. זה בדיוק קנה המידה שבו קריאה ידנית כבר בלתי אפשרית, וניקוד סנטימנט אוטומטי הופך להכרחי.
וזה לא רק עניין של נפח. מתודולוגיית BrandRanx של X משלבת נפח, מעורבות וסנטימנט — מה שמדגיש שסנטימנט עובד הכי טוב כשהוא משולב עם אותות נוספים, ולא עומד לבד.
השורה התחתונה: אם הצוות שלכם מקבל החלטות על סמך תפיסה ציבורית — מוצר, מותג, קמפיין או משבר — ניתוח סנטימנט על נתוני X הוא אחד ממעגלי המשוב המהירים ביותר שיש.
מציאות 2026 של X API: איך באמת משיגים נתוני ציוצים
כאן רוב המדריכים נופלים. אם אי פעם עקבתם אחרי מדריך מבוסס Tweepy, הדבקתם קוד, ונתקלתם בחומת תשלום או בשגיאה לא מובנת — אתם לא לבד. שכבות המנוי הישנות Free / Basic / Pro כבר לא קיימות. ה-API של X עובד כעת על תשלום לפי שימוש עם קרדיטים נטענים מראש, עלויות לכל endpoint, ומעקב שימוש בזמן אמת.
השוואה כנה בין כל שיטות איסוף הנתונים הקיימות כיום:
| שיטה | עלות (2026) | היקף | רמת מיומנות | הערות |
|---|---|---|---|---|
| X API v2 (תשלום לפי שימוש) | $0.005 לקריאת פוסט | עד 2 מיליון קריאות לפוסטים בחודש (self-serve) | בינונית (Python) | רשמי, ניתן לשחזור, תואם מדיניות |
| Full-Archive Search | $0.005 לכל פוסט מוחזר; $0.010 לכל בקשת full-archive count | אחורה עד מרץ 2006 | בינונית–מתקדמת | זמין בתשלום לפי שימוש וב-Enterprise |
| Filtered Stream | חיוב על קריאת פוסטים בעת המסירה | בזמן אמת, רציף | בינונית–מתקדמת | הכי טוב לאיסוף חי |
| מערכי נתונים מוכנים מראש (Kaggle, Sentiment140) | $0 | סטטי, היסטורי בלבד | מתחילים | מצוין ללמידה, לא לניתוח חי |
| snscrape, Twint, Twikit וכו' | $0 | לא אמין / נשבר לעיתים קרובות | מתקדם | snscrape לא עובד לחיפוש ב-X מאז 2023; Twint בארכיון; Twikit משתמש בשיטות לא רשמיות |
| ארכיון X שלכם | $0 | רק הפוסטים שלכם | מתחילים | שימושי לניתוח אישי |
כמה דברים חשובים לדעת:
- שכבות Free/Basic/Pro הישנות נעלמו. אל תעקבו אחרי מדריך שמתייחס אליהן כאילו הן עדיין קיימות.
- snscrape לא עובד יותר עבור X. המתחזק שלו אישר ב-2024 שחיפוש בטוויטר דרך scraping כבר לא עובד. Twint בארכיון. Twikit משתמש ב-scraping לא רשמי ובקוקיז — פעילות לא שווה להרשאה.
- תנאי השימוש של X אוסרים scraping דרך הדפדפן ללא הסכמה בכתב מראש. כלומר, Selenium, Playwright ותוספי דפדפן אינם פתרונות עוקפים תואמי מדיניות לגישה ל-API ב-X.
X API v2: מה באמת מקבלים
קריאת פוסט סטנדרטית עולה $0.005 לכל פוסט מוחזר. קריאות משתמש עולות $0.010 כל אחת. לכן 10,000 קריאות ייחודיות לפוסטים יעלו בערך $50, לפני עלויות משאבים אחרות. התקרה בשירות self-serve היא 2 מיליון קריאות פוסטים בחודש. המחירים יכולים להשתנות — תמיד בדקו את Developer Console.
לעבודה עם סנטימנט, תרצו יותר מאשר רק id ו-text. סכימת מינימום שימושית כוללת created_at, lang, author_id, conversation_id, referenced_tweets, entities, context_annotations ו-public_metrics. שמרו את התגובה הגולמית ואת רישום השאילתה, ה-endpoint, חלון הזמן ב-UTC וטוקני הדפדוף. בלי אלה, הקורפוס שלכם אינו ניתן לשחזור.
עוד הסתעפות: מיגרציית אינדקס החיפוש ב-4 במאי 2026 של X שינתה את הקורפוס שנצפה. חיפוש REST לפי מילות מפתח כבר לא מחזיר reposts, בעוד Filtered Stream לא השתנה. אם אתם משווים תוצאות לפני ואחרי התאריך הזה, ייתכן שאתם סופרים אוכלוסיות שונות.
מערכי נתונים מוכנים מראש: טובים ללמידה, לא לניתוח חי
Sentiment140 (1.6 מיליון ציוצים, תיוגים ב-supervision מרחוק) ומערכי נתונים שונים ב-Kaggle הם חינמיים ומצוינים ללימוד ולהשוואה. אבל Sentiment140 נאסף ב-2009. תת-הקבוצה של sentiment ב-TweetEval משתמשת בנתוני SemEval מ-2013–2016. הם לא יכולים להוכיח שהמודל שלכם עובד על שפה, סלנג או אירועים של 2026.
הערה לגבי Thunderbit ונתוני X
חשוב לי להיות שקוף כאן, כי בנינו את Thunderbit: Thunderbit הוא כלי AI ל-web scraping ולאוטומציה שעובד על הרבה אתרים תואמים. אבל התנאים הנוכחיים של X אוסרים scraping דרך הדפדפן ללא הסכמה. לכן אני לא אציג את Thunderbit כדרך לעקוף עלויות API של X או מגבלות גישה — זה יהיה מטעה. עבור נתוני X, יש להשתמש ב-API הרשמי, בספק מורשה, או בארכיון החשבון שלכם. המקום שבו Thunderbit כן נכנס לתמונה הוא בהמשך השרשרת: ארגון, תיוג וייצוא של נתונים שכבר נאספו במסלול מותר. נחזור לזה בהמשך.
בחירת מודל הסנטימנט הנכון: VADER מול TextBlob מול RoBERTa
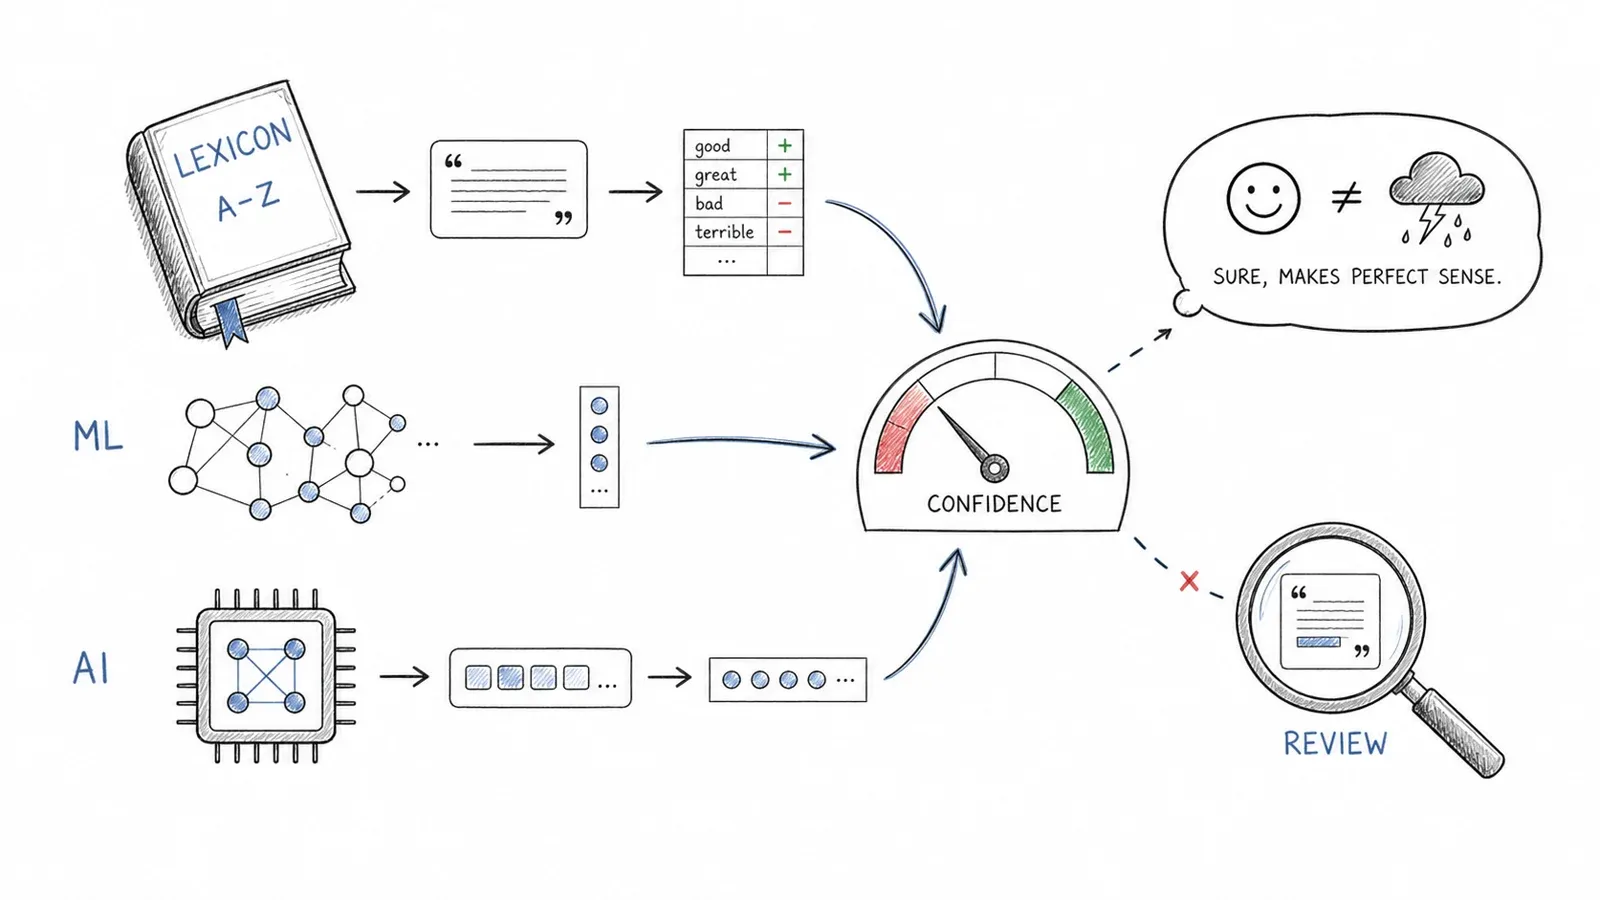
המודל שתבחרו חשוב הרבה יותר ממה שרוב המדריכים מודים. והפער הגדול במדריכים מתחרים הוא שכמעט אף אחד מהם לא מכסה מודלים מבוססי Transformer שעברו fine-tuning על ציוצים — ושם נמצאים כיום חלק מה-baselines החזקים ביותר.
להלן השוואה ישירה. בכוונה לא אכניס לטבלה ציוני F1 אוניברסליים, כי הציונים משתנים לפי דאטהסט, חלוקה, הגדרת תוויות, תקופת זמן ומדד. במקום זאת, אתאר ביצועים יחסיים ואפנה אתכם לבנצ'מרקים כדי שתוכלו לאמת.
| מודל / ספרייה | גישה | מתמודד עם סרקזם? | מתמודד עם סלנג/אימוג'י? | דיוק יחסי על ציוצים | מורכבות התקנה |
|---|---|---|---|---|---|
| VADER (NLTK) | לקסיקון מבוסס חוקים | חלש | תמיכה חלקית באימוג'י | הנמוך ביותר | נמוכה מאוד |
| TextBlob | מבוסס תבניות | חלש | לא | נמוך יותר | נמוכה מאוד |
| Naive Bayes / Logistic Regression (TF-IDF) | ML קלאסי | לא | לא | בינוני | בינונית |
| CardiffNLP RoBERTa | Transformer (עבר fine-tuning על ציוצים) | טוב יותר (לא מושלם) | כן | הגבוה ביותר מבין אלה | בינונית (HuggingFace pipeline) |
VADER: מהיר ופשוט, אבל מוגבל
VADER הוא גישת לקסיקון מבוססת חוקים שנבנתה עבור טקסט חברתי. הוא מהיר, ניתן להסבר, לא דורש דאטה אימון, ומטפל בחלק מהאימוג'י והסמיילים. הוא מתחשב בשלילה, מגבירי עוצמה, פיסוק ואותיות גדולות. כבסיס מהיר או כשחשובה לכם שקיפות וחיסכון בחישוב, VADER שימושי. היכן הוא נופל: סרקזם, סלנג, משמעות תלויה הקשר, וכל דבר שדורש הבנה מעבר למילים בודדות. ערכי ברירת המחדל שלו לסף compound-score (≥0.05 = חיובי, ≤-0.05 = שלילי) הם ברירות מחדל, לא ספי עסק אוניברסליים — כדאי לכייל אותם על סט ולידציה משלכם.
TextBlob: אפילו פשוט יותר, ואפילו מוגבל יותר
TextBlob הוא baseline לימודי קטן. ה-PatternAnalyzer המובנה שלו לא עבר אימון על טקסט בסגנון ציוצים. הוא טוב לניסוי NLP ראשון, אבל לא לניתוח ציוצים בפרודקשן.
ML קלאסי: Naive Bayes, Logistic Regression, SVM
צינור TF-IDF של מילים ותווים יחד עם logistic regression או LinearSVC נשאר baseline מפוקח שימושי מאוד. הוא זול, ניתן להסבר, ולעיתים קרובות מראה האם Transformer באמת מוסיף מספיק ערך כדי להצדיק את המורכבות שלו. כלל חשוב: התאימו את הווקטורייזר רק אחרי פיצול train/validation כדי למנוע דליפה של אוצר מילים ו-IDF.
המודלים האלה עוקפים גישות מבוססות חוקים על גבי דאטהסטים גדולים ומתויגים, אבל הם עדיין מפספסים הקשר, סרקזם וסלנג.
CardiffNLP RoBERTa: הסטנדרט של 2026 לסנטימנט של ציוצים
cardiffnlp/twitter-roberta-base-sentiment-latest הוא מודל מתוחזק, ממוקד-ציוצים, תלת-מחלקתי, ומהווה baseline חזק והגיוני ל-2026. הוא עבר pretraining על קורפוס גדול של ציוצים ו-fine-tuning לסנטימנט, ולכן הוא מטפל באימוג'י, סלנג ושפה לא-פורמלית הרבה יותר טוב מגישות מבוססות חוקים או ML קלאסי.
הנה קטע קוד מינימלי ב-HuggingFace להרצה שלו:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)
scores = classifier("@user Love waiting three hours for support 😒 http")
print(scores)
כמה הסתייגויות:
- הפלט הוא ניקוד של המודל, לא הסתברות עסקית מכוילת. כדאי לכייל או להוסיף סף הימנעות על מדגם מתויג עדכני.
- מודלים הקשריים לרוב מתעלים על מערכות חוקים במשימות רבות של ציוצים, אבל סרקזם, מטרות מעורבות, חוסר בהקשר של thread, דיאלקטים ושפה מוצפנת/מרומזת — כל אלה נשארים מקורות שגיאה מבניים. אל תבטיחו שמודל כלשהו "מבין סרקזם" — מדויק יותר לומר שהוא מטפל בו טוב יותר, לא מושלם.
- חלופות כוללות BERTweet, TimeLMs ומודלים רב-לשוניים של Twitter-XLM-R, בהתאם לשפה ולמשימה.
אז האם ניתוח סנטימנט בטוויטר באמת יכול להיות מדויק? כן — כשהמודל, העיבוד המוקדם, הגדרת התוויות ומדגם ההערכה מתאימים למשימה. סקריפט VADER גנרי שהועתק ממדריך מ-2019 הוא baseline, לא הוכחה לאיכות ייצור.
צינור עיבוד אמיתי לציוצים לפני ניתוח (לא רק text.lower())
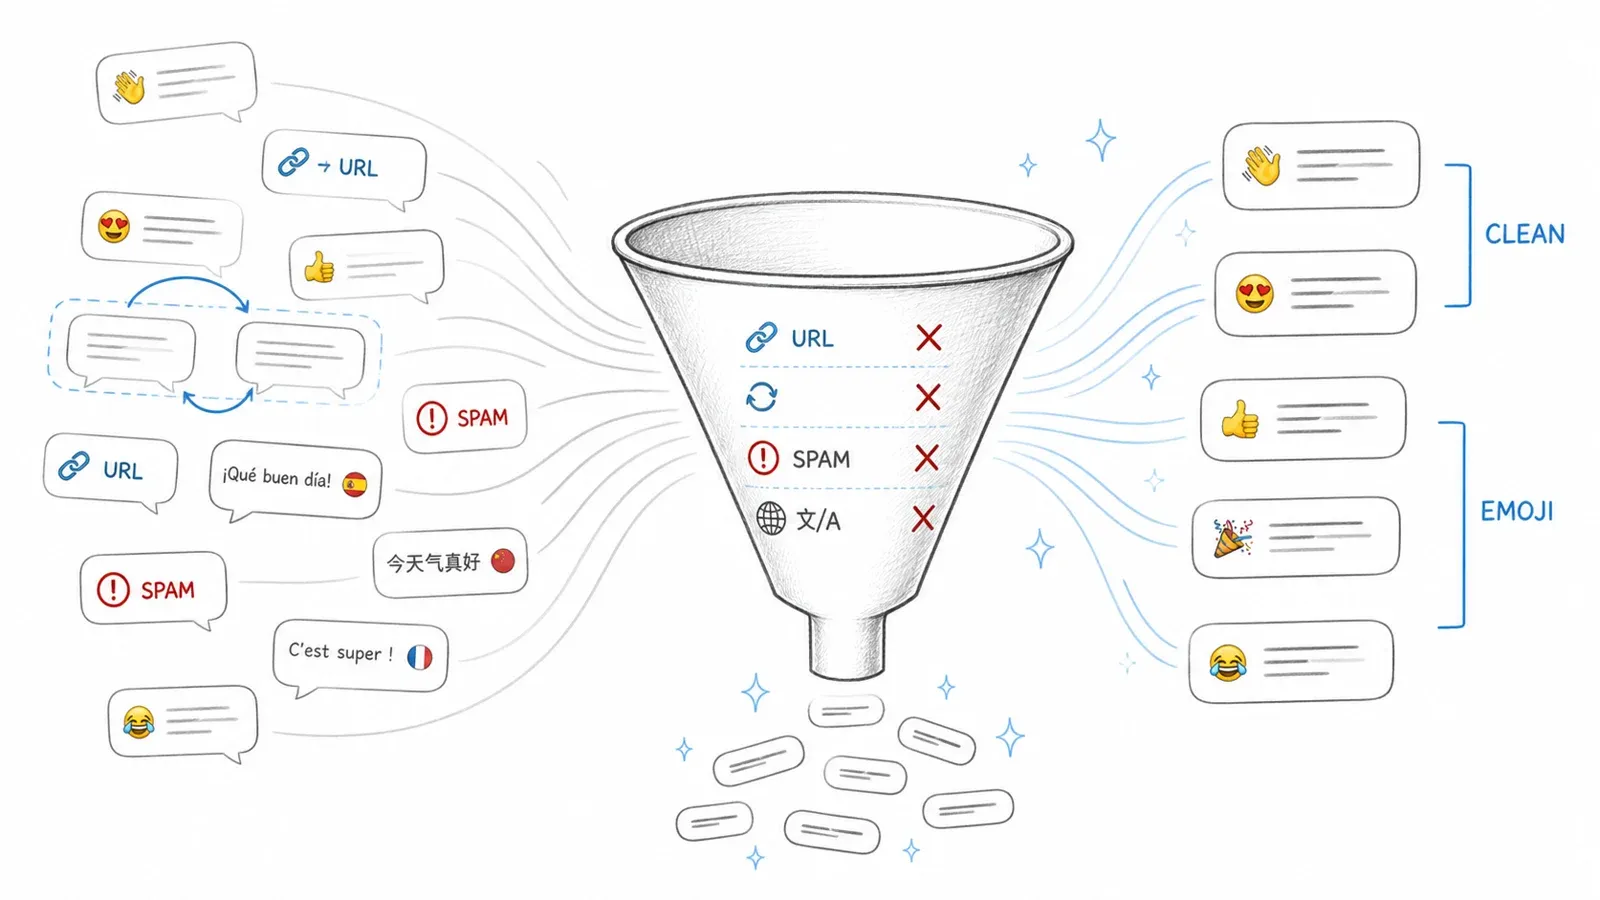
אם מזינים למודל סנטימנט URLs גולמיים, אזכורי @ ויישויות HTML, אפילו מודל טוב יכול להחזיר זבל. רוב המדריכים (כולל אלה שמדורגים גבוה) רק הופכים טקסט לאותיות קטנות לפני שמזינים אותו למודל. זה פוגע בשקט בדיוק — במיוחד ב-ML קלאסי, שבו איכות העיבוד המוקדם יכולה להיות חשובה לא פחות מבחירת המודל.
מה מנקים (ולמה זה חשוב)
| רכיב | מה עושים | למה |
|---|---|---|
| URLs | מחליפים בטוקן מציין כמו http | URLs הם רעש מבחינת סנטימנט; מחיקת הטקסט שסביבם עלולה לשבור הקשר |
| @mentions | מחליפים שמות משתמש ב-@user | שומר על המבנה, מסיר דליפת זהות הכותב |
| אימוג'י/סמיילים | שומרים עבור tokenizers מודרניים; בודקים טקסט לאחר המרה לאימוג'י-לטקסט עבור מודלים דלילים | אימוג'י נושאים אות סנטימנט חזק — מחיקה שלהם היא ויתור על מידע |
| האשטגים | שומרים את הטוקן; אפשר גם להוסיף גרסה מפוצלת (למשל #ClimateChangeIsReal → Climate Change Is Real) | האשטגים לעיתים קרובות מכילים את הדעה עצמה |
| שלילה | שומרים not, no, never, קיצורים ומילות ניגוד | רשימות stop words גנריות לעיתים מסירות אותן והופכות את הסנטימנט |
| אותיות גדולות/פיסוק | שומרים עבור VADER ומודלים תואמים | VADER משתמש באותיות גדולות ובפיסוק כתכונות |
| RT prefix | מסירים את הסימון RT | זה מטא-דאטה, לא סנטימנט |
| reposts/duplicates | מזהים כפילויות מדויקות וכמעט-מדויקות לפני הפיצול | כפילויות בין train ל-test יוצרות leakage |
לפני ואחרי: מה העיבוד המוקדם באמת עושה לציוץ
הנה דוגמה קונקרטית:
| שלב | טקסט |
|---|---|
| ציוץ גולמי | RT @BrandX: Wow, #CustomerServiceFail 😡😡 https://t.co/abc123 I've been waiting 3 hrs ngl this is awful |
| אחרי הסרת URL | RT @BrandX: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| אחרי נירמול אזכור | RT @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| אחרי הסרת RT | @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| אחרי פיצול האשטג | @user: Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| אחרי המרת אימוג'י לטקסט (למודלים דלילים) | @user: Wow, #CustomerServiceFail Customer Service Fail angry_face angry_face http I've been waiting 3 hrs ngl this is awful |
| סופי (עבור CardiffNLP RoBERTa) | @user Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
שימו לב שעבור Transformer כמו CardiffNLP RoBERTa, משאירים אימוג'י, פיסוק ואותיות גדולות — המודל עבר אימון על טקסט שנראה כך. עבור מודל TF-IDF, אפשר להמיר אימוג'י לטקסט, להקטין לאותיות קטנות ולבצע lemmatization.
קוד Python מוכן להעתקה לעיבוד מוקדם
פונקציה נקייה ומודולרית לעיבוד מוקדם תואם-Transformer:
import html
import re
import unicodedata

URL_RE = re.compile(r"https?://\S+|www\.\S+", re.I)
MENTION_RE = re.compile(r"(?<!\w)@[A-Za-z0-9_]+")

def normalize_social_text(text: str) -> str:
    """Normalize a tweet for transformer-based sentiment models."""
    text = html.unescape(text)
    text = unicodedata.normalize("NFC", text)
    text = URL_RE.sub("http", text)
    text = MENTION_RE.sub("@user", text)
    text = re.sub(r"\bRT\b", "", text)
    return " ".join(text.split())
עבור צינורות ML קלאסיים, תרחיבו את זה עם lowercasing, המרת אימוג'י לטקסט (באמצעות הספריות emoji או demoji), פיצול האשטגים (באמצעות wordninja או ekphrasis), נירמול סלנג, הסרת stopwords ולמטיזציה (באמצעות spaCy או NLTK). העיקרון החשוב: התאימו את העיבוד המוקדם למודל שלכם. BERTweet, למשל, משתמש בנורמליזציה מתועדת משלו documented normalization convention — אל תכריחו כל מודל לעבור דרך צינור אחד.
שלב אחר שלב: ניתוח סנטימנט בטוויטר עם Python
זהו ה-workflow המלא, שמחבר את כל מה שדיברנו עליו. אפשר לעקוב אחריו מהתחלה ועד הסוף.
לפני שמתחילים:
- רמת קושי: בינונית (נדרשת היכרות בסיסית עם Python)
- זמן נדרש: כ-30–60 דקות לצינור המלא; כ-10 דקות לנתיב ה-Transformer המהיר
- מה צריך: Python 3.8+, סביבת Google Colab חינמית או סביבת עבודה מקומית,
pandas,transformers,scikit-learn,matplotlib,seaborn, ואופציונליתwordcloud
שלב 1: אוספים את נתוני הציוצים
במדריך הזה אשתמש ב-Sentiment140 (חינמי, 1.6 מיליון ציוצים, זמין ב-Kaggle). הוא מצוין ללמידה ולהשוואה, גם אם הוא היסטורי.
אם אתם רוצים נתונים חיים, השתמשו בשכבת ה-pay-per-use של X API v2. קריאת Post סטנדרטית עולה $0.005. עבור 10,000 פוסטים, זה בערך $50.
טעינת הדאטהסט:
import pandas as pd

columns = ["target", "id", "date", "flag", "user", "text"]
df = pd.read_csv(
    "training.1600000.processed.noemoticon.csv",
    encoding="latin-1",
    names=columns,
)
#Labels: Sentiment140 uses 0 = negative, 4 = positive
df["label"] = df["target"].map({0: "negative", 4: "positive"})
print(df[["text", "label"]].head())
אתם אמורים לראות DataFrame עם טקסט ציוץ גולמי ועמודת תווית.
שלב 2: מנקים ומעבדים מראש את הציוצים
מיישמים את פונקציית העיבוד המוקדם מהסעיף הקודם:
df["clean_text"] = df["text"].apply(normalize_social_text)
print(df[["text", "clean_text"]].head())
בודקים כמה שורות כדי לוודא ש-URLs הוחלפו, אזכורים נורמלו, ותחיליות RT הוסרו.
שלב 3: בוחרים מודל ומסווגים סנטימנט
מסלול A: ML קלאסי עם TF-IDF + Logistic Regression
זהו המסלול של "להבין את היסודות". מפצלים את הנתונים, מתאימים את הווקטורייזר רק על סט האימון, ומאמנים מסווג logistic regression:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    df["clean_text"], df["label"], test_size=0.2, random_state=42
)
vectorizer = TfidfVectorizer(max_features=50000, ngram_range=(1, 2))
X_train_tfidf = vectorizer.fit_transform(X_train)
X_test_tfidf = vectorizer.transform(X_test)

clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_tfidf, y_train)
y_pred = clf.predict(X_test_tfidf)
print(classification_report(y_test, y_pred))
אמור להופיע דוח סיווג עם precision, recall ו-F1 לכל מחלקה. ב-Sentiment140, logistic regression עם TF-IDF בדרך כלל נותן ביצועים סבירים — אבל זכרו: הדאטהסט הזה מ-2009 ומשתמש ב-distant supervision (סמיילים כתוויות), אז אל תתייחסו למספרים האלה כאל benchmark לפרודקשן.
מסלול B: CardiffNLP RoBERTa דרך HuggingFace
לדיוק הטוב ביותר על טקסט של ציוצים, השתמשו ב-Transformer המאומן מראש:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)

sample_tweets = [
    "@user Love waiting three hours for support 😒 http",
    "@user This new update is absolutely fantastic, best one yet!",
    "@user The event was okay, nothing special.",
]
for tweet in sample_tweets:
    result = classifier(tweet)
    print(f"Tweet: {tweet}\nScores: {result}\n")
תראו רשימת ציוני תוויות (negative, neutral, positive) לכל ציוץ. הציוץ הסרקסטי ("Love waiting three hours...") אמור לקבל ציון שלילי גבוה יותר ממה שמודל מבוסס חוקים היה מנבא — למרות ששום מודל לא מושלם כאן.
שלב 4: מעריכים את התוצאות
עכשיו מייצרים heatmap של confusion matrix עבור מסלול ה-ML הקלאסי:
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred, labels=["negative", "positive"])
sns.heatmap(cm, annot=True, fmt="d", xticklabels=["negative", "positive"],
            yticklabels=["negative", "positive"], cmap="Blues")
plt.xlabel("Predicted")
plt.ylabel("Actual")
plt.title("Confusion Matrix: Logistic Regression on Sentiment140")
plt.show()
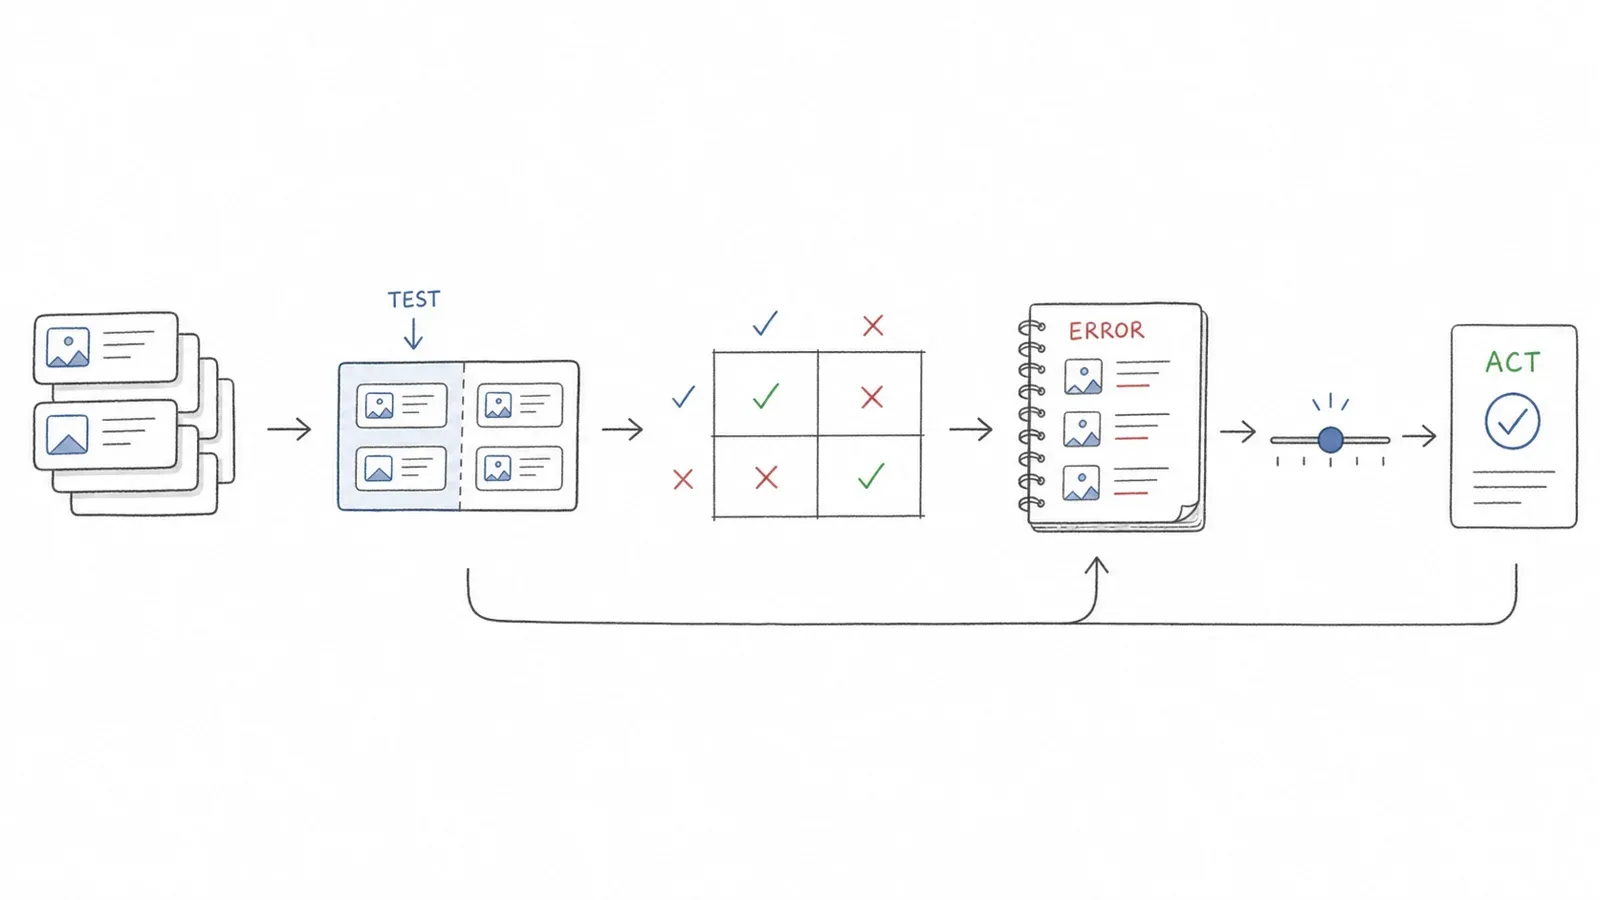
במסלול ה-Transformer, מתייגים ידנית מדגם קטן ועדכני (50–100 ציוצים), מריצים את המודל ומשווים. מדווחים macro F1, precision ו-recall לכל מחלקה, ואת ה-confusion matrix. אם זה פרויקט אמיתי, כדאי גם לבדוק calibration ולהגדיר סף הימנעות למקרים מעורפלים.
שלב 5: בודקים מקרים קצה
מנסים כמה ציוצים שבודקים סרקזם, אימוג'י וסלנג:
edge_cases = [
    "Oh great, another update that breaks everything 🙄",
    "ngl this product slaps 🔥🔥🔥",
    "The camera is amazing but the battery life is trash",
    "Just got my order. It's... fine. I guess.",
]
for tweet in edge_cases:
    clean = normalize_social_text(tweet)
    result = classifier(clean)
    print(f"Tweet: {tweet}\nScores: {result}\n")
מסתכלים איפה המודל מצליח ואיפה הוא מתקשה. ציוצים עם מטרות מעורבות ("camera is amazing but battery is trash") הם אתגר ידוע — סנטימנט ברמת היבט הוא משימה נפרדת.
ניתוח סנטימנט בטוויטר בלי לכתוב קוד
לא כולם רוצים לכתוב Python, וזה בסדר. אם אתם משווקים, מנהלי מותג או מובילי תפעול שצריכים תובנות סנטימנט בלי לגעת בקוד, הנה המסלול שלכם.
הסתייגות כנה: כלים ללא קוד מחליפים התאמה אישית במהירות. הם אידיאליים לניטור מותג מהיר, לא לניתוח ברמת מחקר או לאימון מודלים מותאמים.
אפשרויות ללא קוד במבט אחד
| כלי | מתאים במיוחד ל | סנטימנט מובנה? | טווח מחירים |
|---|---|---|---|
| AWS Comprehend | ניתוח טקסט בהיקף ארגוני | כן | תשלום לפי שימוש |
| Brandwatch / Sprinklr | חבילת social listening מלאה | כן | תמחור ארגוני |
| Google Sheets + תוספי NLP | ניתוח מהיר וקל משקל | דרך תוסף | חינמי–נמוך |
| Thunderbit + גיליון | ארגון ותיוג נתונים מדפים תואמים | AI Field Prompt לתיוג חקרני | יש שכבה חינמית |
Workflow ללא קוד: אוספים נתונים, מסווגים בגיליון
workflow מעשי למי שכבר יש לו נתוני ציוצים (שנאספו דרך ה-X API הרשמי, ספק מורשה, או הארכיון האישי שלו):
- מייצאים את נתוני הציוצים לגיליון. אם השתמשתם ב-X API, מייצאים JSON ל-CSV או משתמשים בכלי כמו Thunderbit כדי לארגן ולייצא נתונים מדפים תואמים שבהם יש לכם הרשאה לאוטומציה.
- פותחים ב-Google Sheets. מדביקים או מייבאים את טקסט הציוצים לעמודה.
- מפעילים מסווג סנטימנט. משתמשים בתוסף NLP ל-Google Sheets (בודקים ב-marketplace את האפשרויות העדכניות) או בשירות כמו AWS Comprehend. חלק מהתוספים מאפשרים לסווג סנטימנט ישירות בתוך נוסחת תא.
- בודקים וממחישים. משתמשים ביכולות הגרף המובנות של Google Sheets כדי ליצור תרשים עמודות של התפלגות סנטימנט או גרף קו של סנטימנט לאורך זמן.
גם AI Field Prompt של Thunderbit יכול להוסיף תווית סנטימנט מבוססת-פרומפט בזמן החילוץ בדפים תואמים — שימושי לניטור חקרני. אבל בהחלטות מבוקרות או רגישות, כדאי לאמת מדגם ולהשתמש במודל מתועד.
מתי לבחור ללא קוד ומתי Python
| תרחיש | מסלול מומלץ |
|---|---|
| בדיקת מותג מהירה, נפח קטן | ללא קוד (גיליון + תוסף) |
| דשבורד צוות, דיווח שבועי | ללא קוד או low-code |
| ניתוח בהיקף גדול, מודלים מותאמים | Python |
| מחקר אקדמי, שחזוריות | Python |
| ניטור בזמן אמת בהיקף גדול | Python + API + pipeline מתוזמן |
ויזואליזציה של תוצאות הסנטימנט בטוויטר
רוב המדריכים עוצרים בדוח סיווג. אבל אם אתם רוצים להציג ממצאים לצוות או לקבל החלטה, אתם צריכים ויזואליזציות.
תרשים עמודות של התפלגות סנטימנט
הפלט הבסיסי אך השימושי ביותר:
import matplotlib.pyplot as plt
import seaborn as sns

sentiment_counts = df["label"].value_counts()
sns.barplot(x=sentiment_counts.index, y=sentiment_counts.values, palette="coolwarm")
plt.xlabel("Sentiment")
plt.ylabel("Tweet Count")
plt.title("Sentiment Distribution")
plt.show()
Word Cloud לפי מחלקת סנטימנט
Word cloud נפרד לחיוביים ולשליליים מגלה מה אנשים באמת אומרים:
from wordcloud import WordCloud

for sentiment in ["positive", "negative"]:
    text = " ".join(df[df["label"] == sentiment]["clean_text"])
    wc = WordCloud(width=800, height=400, background_color="white").generate(text)
    plt.figure(figsize=(10, 5))
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")
    plt.title(f"Word Cloud: {sentiment.capitalize()} Tweets")
    plt.show()
סנטימנט לאורך זמן: הגרף שאף אחד אחר לא מראה לכם
זו הויזואליזציה שהופכת נתונים גולמיים לסיפור. אם יש לכם חותמות זמן, אפשר לעקוב אחרי שינויי סנטימנט במהלך אירוע, השקה או משבר:
df["date"] = pd.to_datetime(df["date"])
df["day"] = df["date"].dt.date
sentiment_map = {"positive": 1, "neutral": 0, "negative": -1}
df["score"] = df["label"].map(sentiment_map)
daily = df.groupby("day")["score"].mean()

plt.figure(figsize=(12, 5))
daily.plot()
plt.xlabel("Date")
plt.ylabel("Average Sentiment Score")
plt.title("Sentiment Over Time")
plt.axhline(0, color="gray", linestyle="--")
plt.show()
צניחה פתאומית ביום ההשקה? זה האות שלכם לרדת לעומק הציוצים השליליים ולגלות מה השתבש.
Heatmap של Confusion Matrix
כבר הוצג בשלב ההערכה למעלה. העיקרון החשוב: להסתכל איפה המודל מתבלבל בין חיובי לשלילי (או להפך). אלו הציוצים שכדאי לקרוא ידנית.
למי שלא כותב קוד: גרפים ב-Google Sheets או Notion
אם ייצאתם את הנתונים המתויגים בסנטימנט לגיליון, אפשר ליצור תרשימי התפלגות ומגמות ישירות ב-Google Sheets, Notion, או בכלי BI אחר. בלי צורך ב-Python.
מלכודות נפוצות בניתוח סנטימנט בטוויטר (ואיך להימנע מהן)
ב-workflows אמיתיים של סנטימנט, אותן טעויות חוזרות שוב ושוב.
סרקזם ואירוניה
הורד הגדול ביותר לדיוק. "Love waiting three hours for support 😒" נראה חיובי למודל מבוסס חוקים. מודלי Transformer מצליחים טוב יותר, אבל סרקזם נשאר קשה מבנית — במיוחד כשאין לפוסט עצמו הקשר (ה-thread, ההיסטוריה של הכותב, האירוע). במקרי שימוש רגישים, משלבים את פלט המודל עם בדיקות אנושיות מדגמיות.
כתמים עיוורים לאימוג'י ולסלנג
אם העיבוד המוקדם שלכם מוחק אימוג'י במקום להמיר אותם לטקסט (במודלים דלילים) או לשמור אותם (ב-Transformer), אתם זורקים חלק מאותות הסנטימנט החזקים ביותר בדאטה. אותו דבר לגבי סלנג — "ngl this slaps" הוא חיובי, אבל מודל שאומן על אנגלית פורמלית לא יבין את זה.
מדריכים ישנים על API ו-scrapers שבורים
אם מדריך משתמש ב-Tweepy עם API v1.1, הוא לא מעודכן. אם הוא ממליץ על snscrape, זה לא עבד לחיפוש ב-X מאז 2023. תמיד בודקים את התאריך ואת גרסת ה-API של כל מדריך.
התאמת יתר לדאטהסט יחיד
Sentiment140 מצוין לאימון, אבל הוא מ-2009. ביקורת EMNLP 2024 על 20 דאטהסטים של רשתות חברתיות מצאה שהסרת כפילויות הורידה F1 ב-14 מתוך 19 דאטהסטים שנבדקו ושינתה דירוגי מודלים ב-17 מתוך 19. השתמשו בפיצולים מבוססי זמן, מבוססי אירוע, ועדיף גם מבוססי כותב. בדקו את המודל על ציוצים עדכניים כדי לראות אם הוא מכליל.
התייחסות לציוני סנטימנט כאילו היו אמת מוחלטת
ציון של מודל אינו הסתברות מכוילת. אל תפעילו תגובות אוטומטיות או החלטות מול הציבור רק על סמך תווית סנטימנט. תמיד נדרשת בדיקה אנושית כשמדובר בהחלטות שמשפיעות על אנשים או על תגובות למשבר.
פרטיות, מדיניות פלטפורמה ושימוש אחראי
החלק הזה אינו אופציונלי.
Developer Policy של X מדגישה פרטיות, שליטת המשתמש, מחיקת תוכן והגבלות על התאמה מחוץ ל-X. כללי עבודה מעשיים:
- אוספים רק שדות הכרחיים.
- מציגים תוצאות באופן מצרפי ולא מפרסמים handles גולמיים.
- שומרים Post IDs וחותמות זמן של שליפה לצורכי ציות.
- מסירים או מעדכנים תוכן מאוחסן לאחר מחיקה, שינויי הגנה או בקשות מתאימות.
- לא מסיקים תכונות רגישות על אנשים.
- לא מחברים ציוני סנטימנט לזהויות ב-CRM בלי בסיס מורשה והסכמה.
- לא מאמנים או מבצעים fine-tuning על foundation model ב-X Content היכן שזה אסור לפי כללי השימוש המוגבל.
- מתעדים גודל מדגם, מונחי שאילתה, חלון זמן, מסנני שפה והחרגות.
- לעולם לא מפעילים תגובה פומבית אוטומטית רק מתוך ציון סנטימנט.
ניתוח סנטימנט הוא כלי חזק, אבל הוא מגיע עם אחריות אמיתית. תתייחסו אליו בהתאם.
סיכום ותובנות מרכזיות
ניתוח סנטימנט בטוויטר עובד ב-2026 — אבל רק אם מעדכנים את הגישה כך שתתאים למציאות הנוכחית. המתכון הישן (API חינמי, עיבוד מוקדם של lowercasing בלבד, VADER או Naive Bayes, בלי הערכה) שבור. מה שבאמת עובד:
- משיגים את הנתונים דרך מסלול מותר. משתמשים ב-X API v2 (תשלום לפי שימוש), בספק מורשה או בדאטהסט שקוף. לא נשענים על scrapers שבורים או על עוקפים דרך דפדפן.
- מעבדים מראש לפי המודל, לא רק כדי לצאת ידי חובה. שומרים אימוג'י, שלילה ואותיות גדולות עבור Transformer. מנרמלים URLs ואזכורים. מתאימים את ה-pipeline לדאטה שעליו המודל אומן.
- משווים בין baseline זול ל-Transformer ייעודי לציוצים. TF-IDF + logistic regression עדיין מהווה בדיקת שפיות מצוינת. CardiffNLP RoBERTa הוא ברירת המחדל החזקה הנוכחית לסנטימנט של ציוצים.
- מעריכים בכנות. מדווחים macro F1, מדדים לכל מחלקה ו-confusion matrix. משתמשים במדגם עדכני שמתויג ידנית. מגדירים סף הימנעות למקרים עמומים.
- ממחישים כדי לקבל החלטות, לא רק כדי לקשט. גרפים של סנטימנט לאורך זמן ו-word clouds מספרים סיפור שדוח סיווג לא יכול.
- משאירים בני אדם בלולאה. אף מודל לא מושלם בסרקזם, במטרות מעורבות או במשמעות תלוית הקשר. במקרי שימוש רגישים, משלבים פלט מודל עם בדיקה אנושית.
אם אתם רק בתחילת הדרך, קחו דאטהסט חינמי, פתחו Google Colab, והריצו את ה-HuggingFace pipeline. תוכלו לקבל ציוני סנטימנט עובדים בפחות מעשר דקות. אם אתם רוצים לאסוף ולארגן נתוני web בלי קוד עבור חלקים אחרים ב-workflow, Thunderbit יכול לעזור בדפים תואמים שבהם יש לכם הרשאה לאוטומציה.
ואם אתם בונים את זה לתיק עבודות או לראיון עבודה: הוספת השוואת Transformer, צינור עיבוד מוקדם אמיתי וגרף של סנטימנט לאורך זמן תבדיל את הפרויקט שלכם מיד מהמוצר הסטנדרטי של bootcamp.
לקריאה נוספת
- How to Master Automated Data Scraping Using Thunderbit
- 6 Best Twitter (x.com) Scrapers in 2026
- How to Scrape Tweets from Twitter Using Python in 2025
- How to Use Twitter AI Scraping for Enhanced Data Insights
- Twitter (X) Statistics 2026: Users, Demographics & Ads
שאלות נפוצות
האם ניתוח סנטימנט בטוויטר מדויק?
זה תלוי במודל ובאופן ההערכה. כלים מבוססי חוקים כמו VADER נוטים להציג ביצועים נמוכים יחסית על נתוני ציוצים. מודלי Transformer כמו CardiffNLP RoBERTa עושים עבודה טובה בהרבה — אבל הציונים המדויקים משתנים לפי דאטהסט, חלוקה, הגדרת תוויות ומדד. גם איכות העיבוד המוקדם חשובה. תמיד כדאי להעריך על מדגם עדכני שמתויג ידנית, ולא לסמוך על מספר יחיד מבנצ'מרק.
אפשר לעשות ניתוח סנטימנט בטוויטר בחינם?
כן. אפשר להשתמש בדאטהסט חינמי (Sentiment140 ב-Kaggle), בסביבת Python חינמית (Google Colab), ובמודל HuggingFace מאומן מראש. עבור נתונים חיים, X API גובה $0.005 לקריאת Post, כך שאיסוף בהיקף קטן הוא בר ביצוע. ל-Thunderbit יש שכבה חינמית לארגון נתונים בדפים תואמים.
מהי ספריית Python הטובה ביותר לניתוח סנטימנט בטוויטר?
לפרוטוטייפ מהיר: VADER דרך NLTK. לדיוק הטוב ביותר על ציוצים: ספריית HuggingFace transformers עם מודל RoBERTa של CardiffNLP. לבסיסי ML קלאסיים: scikit-learn עם TF-IDF. הבחירה הנכונה תלויה בנפח, ברמת הדיוק הנדרשת ובתקציב החישוב.
איך מתמודדים עם סרקזם בניתוח סנטימנט בטוויטר?
מודלי Transformer מתמודדים עם סרקזם טוב יותר ממודלים מבוססי חוקים או ML קלאסי, כי הם מעבדים הקשר ולא רק מילים בודדות. אבל שום מודל לא מושלם בסרקזם — המחקר מראה שאפילו מתייגים אנושיים לא תמיד מסכימים על כוונה סרקסטית. במקרים קריטיים, משלבים את פלט המודל עם בדיקה אנושית ושוקלים להשתמש ב-דאטהסטים ייעודיים לסרקזם לצורך הערכה.
אפשר לנתח סנטימנט בטוויטר בלי קוד?
כן. אוספים את הנתונים דרך מסלול מותר (X API, ספק מורשה או הארכיון האישי), מייצאים ל-Google Sheets, ומפעילים מסווג סנטימנט ללא קוד דרך תוסף NLP ל-Sheets או שירות כמו AWS Comprehend. גם Thunderbit יכול להוסיף תוויות סנטימנט מבוססות פרומפט בזמן ארגון הנתונים בדפים תואמים. לעוד על workflows ללא קוד, בדקו את המדריך שלנו על כלי AI ל-Google Sheets.



