
יש משהו ממש מספק בלראות Web Scraper רץ בין דפים ושואב נתונים שאחרת היו לוקחים לכם שעות, או אפילו ימים, לאסוף ידנית. אבל אם אי פעם ה־scrape נתקע פתאום — אולי התנתקתם, או שהגישה נחסמה בלי שום הסבר — כנראה נתקלתם בשומרי הסף הבלתי נראים של הרשת המודרנית: עוגיות. לאורך השנים שבניתי כלי אוטומציה ועבדתי עם צוותי מכירות, eCommerce ומחקר, ראיתי עוגיות שקבעו אם פרויקט נתונים יצליח או יקרוס. הן הגיבורות האלמוניות, ולעיתים גם הנבלות, של Web Scraping — והטיפול הנכון בהן הוא ההבדל בין שיט חלק לבין טביעה.
בואו נבין למה עוגיות כל כך חשובות ל־Web Scraping, אילו כאבי ראש נוצרים כשמנהלים אותן בשיטות הישנות, ואיך כלים מבוססי AI כמו Thunderbit משנים את התמונה עבור משתמשים עסקיים. אשתף גם בשיטות עבודה מעשיות שיעזרו לכם לשמור על העוגיות — ועל המידע שלכם — בטוח, מוגן ותואם לדרישות.
למה ניהול עוגיות ב־Web Scraping חשוב כל כך למשתמשים עסקיים
ראו איך עובד Agentic Web Scraping ה־AI של Thunderbit קורא דף כמו אדם ומחלץ נתונים בלחיצה אחת, בלי שתצטרכו לנהל עוגיות או כותרות ידנית. Get Started Free
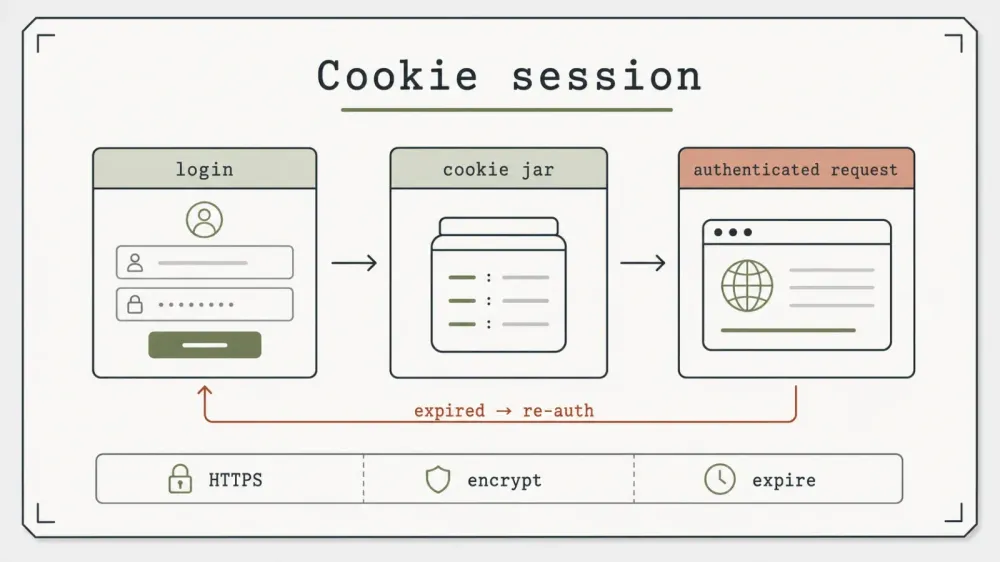
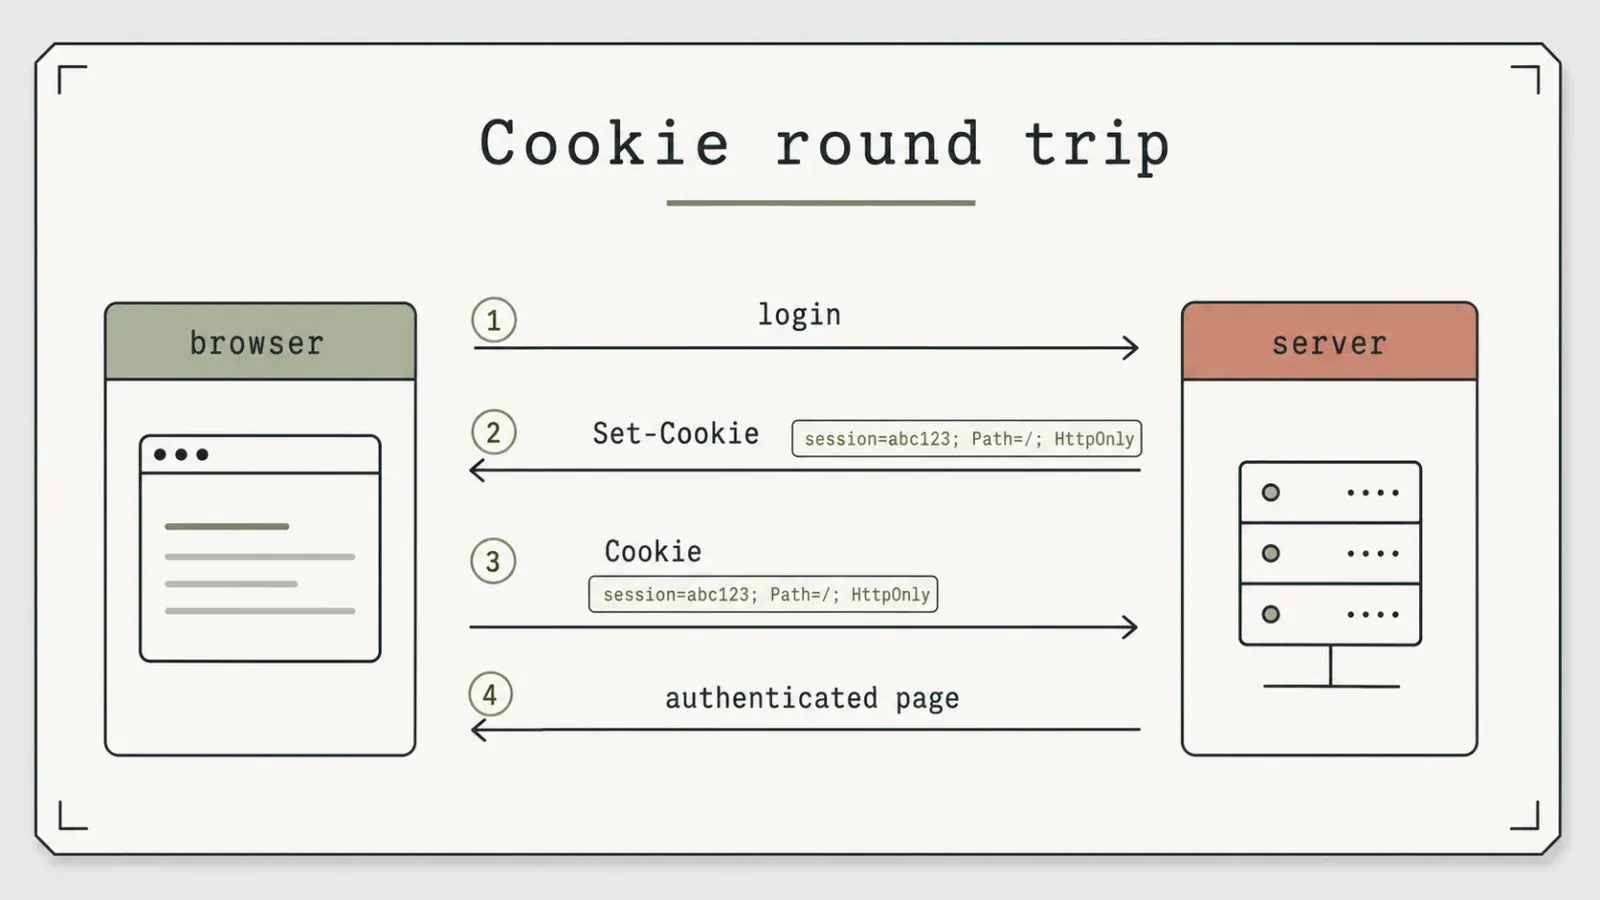
עוגיות הן לא רק הדרך לעקוב אחרי מה שמוסיפים לעגלת הקניות. בעולם של Web Scraping, הן הדבק שמחזיק את הסשן שלכם יחד. בין אם אתם עושים איסוף לידים, מעקב מחירים או מחקר שוק, העוגיות הן מה שמאפשר ל־scraper שלכם:
- להישאר מחובר לאתרים או דשבורדים שמוגנים בכניסה
- לגשת לנתונים מותאמים אישית (למשל תצוגה אישית של מערכת CRM או מלאי)
- לשמור על סשן בין כמה בקשות, כך שלא תיזרקו החוצה אחרי הדף הראשון
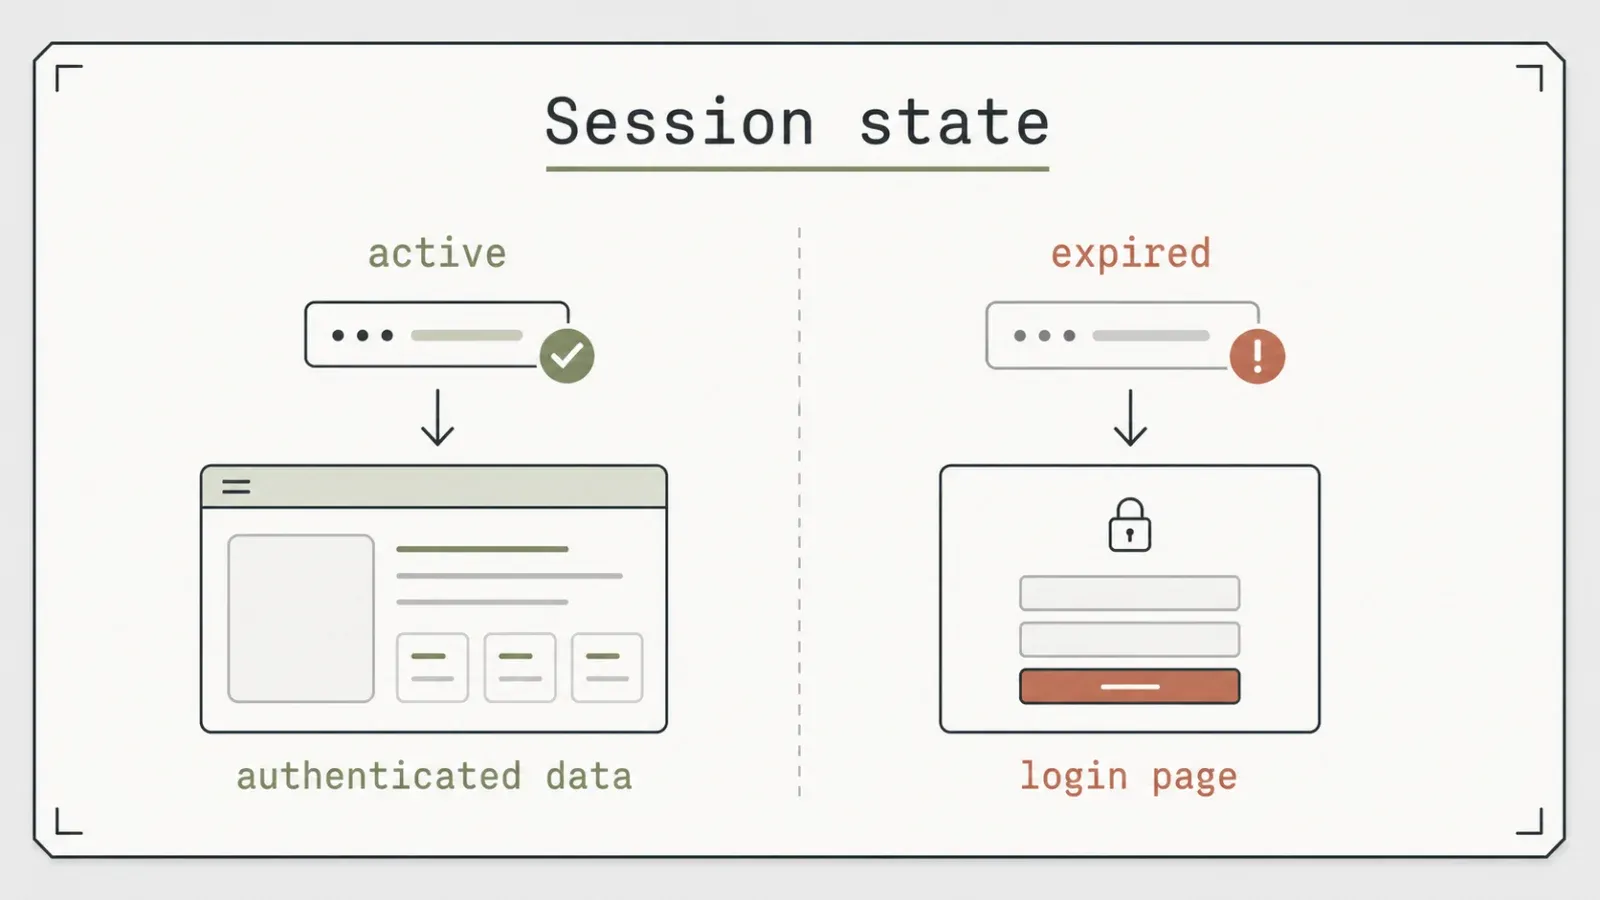
לפי דוחות בתעשייה, עוגיות סשן הן קריטיות לאימות התחברות ולשמירה על תצוגות מותאמות למשתמש. עם 42% מתעבורת האינטרנט שמגיעה מבוטים לפי Akamai—ועם פעילות בוטים מונעת AI שזינקה בכ־300% עד 2025—אתרים נשענים יותר ויותר על בדיקות עוגיות וטביעות אצבע של סשן כדי להבחין בין בני אדם לאוטומציה.
מה קורה אם מטפלים בעוגיות בצורה לא נכונה? אתם מסתכנים ב:
- התנתקות באמצע ה־scrape (להתראות, נתונים)
- קבלת מידע חלקי או גנרי במקום הנתונים המותאמים שאתם צריכים
- הפעלת חסימות אבטחה או אפילו חסימת חשבון — במיוחד באתרים עם מדיניות אנטי־בוט נוקשה
ראיתי צוותים מאבדים ימי עבודה כי עוגיית סשן פגה תוקף או לא עודכנה, וה־scraper שלהם אסף רק דפי התחברות. בקיצור, ניהול עוגיות חזק הוא הבסיס ל־Web Scraping יציב ואמין.
האתגרים הסמויים של ניהול עוגיות ב־Web Scraping בשיטות המסורתיות
בואו נהיה כנים: ניהול עוגיות ידנית הוא בערך כמו להרכיב רהיט של IKEA בלי הוראות. עם כלי Scraping מסורתיים, לרוב צריך:
- להתחבר ידנית דרך הדפדפן
- לייצא עוגיות (באמצעות DevTools של הדפדפן או תוסף)
- להזריק את העוגיות לקוד ה־scraper
- לחזור על כל התהליך בכל פעם שהעוגיות פגות או שהאתר משנה את תהליך ההתחברות
אם מדובר בהתחברות בכמה שלבים (למשל 2FA, הפניות, או CAPTCHA), זה נהיה מסובך עוד יותר. ואם אתם מריצים scrapers בכמה Threads או דרך פרוקסיז, צריך לסנכרן את העוגיות ביניהם — אחרת תשברו סשנים או תדליקו נורות אדומות אצל מערכות האבטחה של האתר (מקור).
נקודות הכאב:
- זמן הקמה גבוה: כתיבת סקריפטים להתחברות ולכידת עוגיות היא עבודה מייגעת
- תחזוקה תכופה: עוגיות פגות, אתרים משתנים, סקריפטים נשברים
- נטייה לטעויות: מספיק עדכון עוגייה אחד שנשכח, וכל ה־scrape נכשל
גם כלים מתקדמים כמו Selenium או Puppeteer דורשים קוד מותאם אישית כדי לשמר עוגיות. ואם שוכחים לרענן את הסשן, אפשר להיחסם או להתחיל לאסוף נתונים לא נכונים (מקור). לכן כל כך הרבה משתמשים עסקיים מוותרים עוד לפני שהתחילו.
Thunderbit: אוטומציה של עוגיות ב־Web Scraping לחילוץ נתונים אמין
הורידו את תוסף Chrome של Thunderbit התקינו את תוסף Chrome החינמי של Thunderbit והתחילו לחלץ נתונים מדפים שמוגנים בעוגיות בלחיצה אחת. Get Started Free
כאן נכנס Thunderbit. בתור מישהו שבילה שנים ב־SaaS ובאוטומציה, רציתי לבנות כלי שהופך את כאב הראש של עוגיות לדבר מהעבר. כך Thunderbit מטפל בעוגיות בשבילכם:
- מצב Browser Scraping: Thunderbit פועל כתוסף Chrome, ולכן הוא משתמש בסשן וב־cookies האמיתיים של הדפדפן שלכם. אם אתם רואים את זה ב־Chrome, Thunderbit יכול לחלץ את זה — בלי לייצא עוגיות ידנית (מקור).
- לכידת עוגיות אוטומטית: פשוט מתחברים כרגיל, לוחצים על “One Click Extract”, ו־Thunderbit מאמץ את עוגיות הסשן שלכם מאחורי הקלעים.
- טיפול בהתחברות מרובת שלבים: אם אתר משתמש ב־2FA, הפניות או זרימות מורכבות אחרות, פשוט מסיימים את השלבים האלה בדפדפן. Thunderbit יקלט את הסשן הסופי באופן אוטומטי.
- Cloud Scraping לנתונים ציבוריים: לאתרים פתוחים, מצב הענן של Thunderbit מהיר במיוחד (עד 50 דפים בו־זמנית), אבל לכל דבר שמאחורי התחברות — מצב הדפדפן הוא החבר הכי טוב שלכם.
התוצאה בפועל: פחות scrapes שנופלים בגלל התנתקות, פחות סשנים שנשברים אחרי שינוי בתהליך האימות של האתר, והרבה פחות זמן מבוזבז על ייצוא עוגיות מ־DevTools ידנית. זה לא קסם — אתרים עם הגנת בוטים אגרסיבית עדיין יתנגדו — אבל החיכוך יורד משמעותית כשמפסיקים לגעת בעוגיות ידנית.
נסו את Thunderbit לניהול עוגיות בלי מאמץ ה־agentic web scraper של Thunderbit מטפל ברינדור של הדף בעצמו, כך שלחיצה אחת מחליפה את כל ההגדרה הידנית של עוגיות וסשן. Get Started Free
שיפור הדיוק והיעילות של עוגיות בעזרת AI
Scrapers מסורתיים הם שבירים — שינוי אחד במבנה העוגיות של האתר או בזרימת ההתחברות, והסקריפט שלכם פשוט קורס. כלים מונעי AI כמו Thunderbit לוקחים את זה לשלב הבא:
- זיהוי עוגיות אוטומטי: ה־AI של Thunderbit “רואה” ומבין את הדף, ומזהה אוטומטית אילו עוגיות דרושות לכל בקשה.
- רענון סשן אוטומטי: אם עוגיית סשן פגה, ה־AI יכול לבקש מכם להתחבר מחדש ולעדכן את מאגר העוגיות מיידית.
- הסתגלות לשינויים באתר: כשאתר משנה את הלוגיקה של ההתחברות או של העוגיות, ה־AI של Thunderbit מסתגל — בלי לכתוב סקריפטים מחדש או לחפש שמות עוגיות חדשים.
- צמצום טעויות אנוש: לא עוד שכחתם לרענן עוגיות או איסוף בטעות כמשתמש לא מחובר.
המשמעות היא זמינות גבוהה יותר, פחות הפרעות, ונתונים מדויקים יותר — במיוחד למשתמשים עסקיים שצריכים מידע אמין ועדכני (מקור).
שיטות מומלצות לטיפול מאובטח ותואם בעוגיות ב־Web Scraping
עוגיות יכולות להכיל נתוני סשן רגישים, ולכן הטיפול בהן בצורה מאובטחת הוא לא רק חכם — לעיתים הוא גם נדרש בחוק. כך תישארו בטוחים ותואמים:
- להצפין את אחסון העוגיות: לעולם אל תשמרו עוגיות כטקסט גלוי או בקבצים לא מאובטחים. השתמשו במסדי נתונים מוצפנים או ב־cookie jars מאובטחים (מקור).
- להשתמש תמיד ב־HTTPS: עוגיות עם מאפיין
Secureצריכות להישלח רק דרך חיבורים מוצפנים (מקור). - להגדיר דגלי HttpOnly: זה מונע גישה לעוגיות דרך JavaScript זדוני ומפחית סיכוני XSS (מקור).
- להגביל את משך שמירת העוגיות: שמרו עוגיות רק כל עוד הן נחוצות לאימות. מחקו עוגיות ישנות או לא בשימוש באופן קבוע.
- לעמוד בדרישות GDPR ו־CCPA: תחת GDPR, עוגיות שיכולות לזהות משתמשים נחשבות לנתונים אישיים. תמיד צריך בסיס חוקי לשימוש בעוגיות, ולכבד בקשות opt-out או מחיקת מידע.
- לכבד את מדיניות האתר: תמיד בדקו את תנאי השימוש ואת robots.txt לפני Scraping. יש אתרים שדורשים הסכמה מפורשת לשימוש בעוגיות.
אם תעבדו לפי העקרונות האלה, תפחיתו סיכונים משפטיים ותשמרו על המידע שלכם — ועל המשתמשים שלכם — בטוח.
השוואה בין גישות לניהול עוגיות: ידני, אוטומטי ומבוסס AI
בואו נפרק את היתרונות והחסרונות של אסטרטגיות שונות לניהול עוגיות:
| גישה | מאמץ הקמה | אמינות | אבטחה | ציות ותחזוקה |
|---|---|---|---|---|
| ידני (Python, cURL) | גבוה (סקריפטים מותאמים, לכידת עוגיות ידנית) | משתנה (נשבר עם שינויים באתר) | המפתח צריך לממש הצפנה/דגלים | מועד לטעויות, דורש עדכונים תכופים |
| כלים אוטומטיים | בינוני (הגדרת הכלי, ניהול אישורים) | טוב לאתרים יציבים | לרוב כולל אבטחה סטנדרטית | עדיין דורש פיקוח, יש שלבים ידניים |
| מבוסס AI (Thunderbit) | נמוך (ללא קוד, מבוסס דפדפן) | גבוה (מסתגל לשינויים באתר, מרענן אוטומטית) | אחסון מוצפן, סשנים מאובטחים | ציות מובנה, תחזוקה מינימלית |
כלים מונעי AI כמו Thunderbit דורשים הכי מעט מאמץ ומספקים את התוצאות החזקות והעמידות ביותר לעתיד (מקור).
טעויות נפוצות שכדאי להימנע מהן כשמטפלים בעוגיות ב־Web Scraping
גם עם כלים מצוינים, קל ליפול לטעויות. שימו לב למלכודות הנפוצות האלה:
- עוגיות שפג תוקפן או חסרות: תמיד רעננו עוגיות סשן לפני scrape גדול. אם ה־scraper מתחיל להחזיר דפי התחברות, כנראה שהעוגיות פגו (מקור).
- אחסון לא מאובטח: לעולם אל תשמרו עוגיות כטקסט גלוי או תשתפו אותן במייל או בצ’אט. השתמשו באחסון מוצפן.
- התעלמות ממאפייני עוגייה: ודאו שה־scraper שלכם מכבד את הדגלים
Secureו־HttpOnly. - הזנחת מדיניות האתר: כישלון בטיפול בבאנרים של עוגיות או חלונות הסכמה עלול לגרום לחסימת ה־scraper.
- בעיות מקביליות: אם אתם מריצים scraping במקביל, ודאו שכל ה־threads משתמשים במאגר העוגיות הנכון.
- הנחות קשיחות מדי: אל תנעלו את ה־scraper על שמות או ערכים ספציפיים של עוגיות — אתרים משנים אותם כל הזמן.
טיפ לפתרון תקלות: אם ה־scraper מפסיק לעבוד, בדקו את ערכי העוגיות, השוו בין בקשות הדפדפן לבקשות מהסקריפט, ונסו להשתמש באוטומציה בדפדפן לאתרים מסובכים.
מדריך שלב־אחר־שלב: הגדרת ניהול עוגיות בטוח ויעיל ב־Thunderbit
מוכנים ליישם את כל השיטות המומלצות? כך מטפלים בעוגיות בצורה בטוחה עם Thunderbit:
- בחרו את המצב הנכון: עבור דפים שמוגנים בכניסה או מותאמים אישית, השתמשו במצב Browser Scraping. עבור נתונים ציבוריים, השתמשו ב־Cloud Scraping כדי ליהנות ממהירות.
- התחברו כרגיל: פתחו את Chrome, התחברו לאתר היעד כמו תמיד. השלימו כל שלב של 2FA או הסכמה.
- הפעילו לכידת עוגיות אוטומטית: לחצו על תוסף Thunderbit ואז על “One Click Extract”. Thunderbit ישתמש אוטומטית בעוגיות הסשן שלכם — בלי ייצוא ידני (מקור).
- אמתו את הסשן שלכם: בדקו את תצוגת הצד של Thunderbit כדי לוודא שאתם רואים את התוכן הנכון, כלומר התוכן של משתמש מחובר.
- הריצו בדיקת Scrape: התחילו עם כמות קטנה כדי לוודא שאתם מקבלים את הנתונים הצפויים.
- נטרו ואמתו מחדש: בעבודות מתוזמנות או ארוכות, עקבו אחרי פקיעת הסשן. אם התנתקתם, פשוט התחברו שוב — Thunderbit יעדכן את העוגיות אוטומטית.
- ייצאו בצורה מאובטחת: בעת ייצוא נתונים, Thunderbit שומר על העוגיות שלכם מאובטחות ולא חושף אותן בקבצי הפלט.
זה הכול — בלי קוד, בלי התעסקות ידנית בעוגיות, רק Scraping אמין ומאובטח.
התחילו Web Scraping מאובטח עם Thunderbit התוכנית החינמית כוללת 6 דפים בחודש, בלי צורך בכרטיס אשראי — מספיק כדי לבדוק Crawl לפני שמגדילים קנה מידה. Get Started Free
נקודות מפתח לצוותים עסקיים שמשתמשים בעוגיות ב־Web Scraping
- עוגיות הן חיוניות ל־Web Scraping יציב, מאומת ומותאם אישית. טיפול לא נכון עלול להוביל לאובדן נתונים, חסימת חשבונות או בעיות משפטיות.
- ניהול עוגיות ידני הוא תהליך שגוזל זמן ונוטה לטעויות. כלים מבוססי AI כמו Thunderbit הופכים את התהליך לאוטומטי, מקצרים את זמן ההקמה ומשפרים אמינות.
- אחסון מאובטח וציות לדרישות הם קריטיים. תמיד הצפינו עוגיות, השתמשו ב־HTTPS ועמדו בדרישות GDPR/CCPA.
- טיפול בעוגיות מבוסס AI מסתגל לשינויים באתר, מפחית טעויות אנוש ושומר על זרימת הנתונים.
- הימנעו ממלכודות נפוצות: רעננו עוגיות באופן קבוע, אל תאחסנו אותן בצורה לא מאובטחת, וכבדו את מדיניות האתר.
אם תיישמו את השיטות האלה — הצפנת אחסון, כיבוד Secure/HttpOnly, ורענון סשנים לפי לוח זמנים קבוע — רוב התקלות היומיומיות בעוגיות פשוט ייעלמו. ואם ניהול עוגיות ידני עדיין מרגיש כמו המקום הלא נכון להשקיע בו את השבוע שלכם, תוסף Chrome של Thunderbit מטפל בלכידה וברענון בתוך סשן הדפדפן שלכם. עוד מדריכים מעמיקים על עוגיות וחסימות תמצאו ב־Thunderbit Blog.
נסו ניהול עוגיות מבוסס AI עם Thunderbit Get Started Free
שאלות נפוצות
1. למה עוגיות כל כך חשובות ל־Web Scraping?
עוגיות שומרות את ה־scraper מחובר, מחזיקות את מצב הסשן ומאפשרות גישה לתוכן מותאם אישית או מוגן. בלי ניהול עוגיות נכון, ה־scraper עלול להתנתק, להיחסם או לאסוף נתונים חלקיים (מקור).
2. מהם הסיכונים בטיפול שגוי בעוגיות במהלך scraping?
טיפול שגוי בעוגיות עלול לגרום לאובדן נתונים, ל־scrapes שנקטעים, לחסימת חשבונות, ואפילו לבעיות משפטיות אם העוגיות נשמרות בצורה לא מאובטחת או משמשות בניגוד לחוקי פרטיות (מקור).
3. איך Thunderbit עושה אוטומציה לניהול עוגיות?
Thunderbit משתמש בסשן Chrome הפעיל שלכם כדי לאמץ עוגיות אוטומטית — בלי ייצוא ידני ובלי קוד. הוא מטפל באימות, ברענון סשן, ומסתגל לשינויים באתר באמצעות AI (מקור).
4. מהן השיטות הטובות ביותר לאחסון עוגיות בצורה מאובטחת?
תמיד הצפינו את אחסון העוגיות, השתמשו ב־HTTPS להעברת נתונים, הגדירו HttpOnly ו־Secure, ולעולם אל תשמרו עוגיות כטקסט גלוי או תשתפו אותן בדרכים לא מאובטחות (מקור).
5. איך אפשר לוודא שניהול העוגיות שלי תואם ל־GDPR ו־CCPA?
התייחסו לעוגיות כאל מידע אישי: אספו רק מה שנחוץ, קבלו הסכמה מהמשתמשים כשנדרש, וכבדו בקשות ביטול או מחיקה. בדקו באופן שוטף את מדיניות העוגיות שלכם כדי להישאר תואמים לרגולציה המשתנה (מקור).
6. איך סוכני דפדפן מבוססי AI משנים את התמונה של ניהול עוגיות? הדור החדש של הכלים — תוסף Chrome של Thunderbit, יחד עם סוכנים בקוד פתוח כמו Browser Use שרצים מעל Playwright — מדלגים לגמרי על שלב ייצוא העוגיות ועובדים מתוך פרופיל דפדפן חי ומחובר. עוגיות, localStorage ומצב הסשן נשמרים אוטומטית; אם הסשן פג, פשוט מתחברים מחדש בדפדפן וה־scraper ממשיך. המחיר הוא ויתור מסוים על שליטה עדינה שהייתם מקבלים מכתיבת כותרות עוגייה ידנית ב־Python. עבור משתמשים עסקיים שמריצים scraping מאחורי התחברות, זו בדרך כלל עסקה משתלמת.
מוכנים לקחת את ה־Web Scraping שלכם לשלב הבא? נסו את Thunderbit בחינם ותנו ל־AI לטפל בעוגיות — כדי שתוכלו להתמקד בנתונים שבאמת חשובים.
למידע נוסף




