
בחודש שעבר, אינטגרציית Stripe של חבר שלי התחילה בשקט להחזיר שגיאות 503 בשעה 23:00 ביום שישי. אף אחד לא שם לב לזה עד שבת בבוקר — ואז תיבת התמיכה התמלאה ביותר מ-200 מיילים זועמים מלקוחות שהצ'קאאוט שלהם נכשל.
הסיפור הזה לא חריג. מדד נפוץ ומצוטט מעריך את עלות ההשבתה הממוצעת ב-5,600 דולר לדקה, בעוד תקלות חמורות במיוחד יכולות להגיע למיליוני דולרים לשעה. המספר המדויק תלוי בתנועה, שיעור ההמרה, שווי הזמנה, חשיפה ל-SLA ועלויות התאוששות — אבל המסקנה ברורה: APIs שלא מנוטרים הן סיכון עסקי, לא רק מטרד הנדסי. ועם ארגונים שמריצים כיום בממוצע 131 APIs של צד שלישי ו-רק 16% שמדווחים על יכולת גבוהה לצמצם סיכון מ-API של צד שלישי, ניטור כבר לא אופציונלי. מה שרציתי לעשות במדריך הזה הוא משהו שלא ראיתי במקום אחר: לארגן כלים לפי תסריט השימוש שלכם, להעריך את איכות ההתראות (לא רק את עצם קיומן), להציג מחירי 2026 אמיתיים, ולמדוד כמה מהר אפשר באמת להתחיל לעבוד. לא עוד רשימת לוגואים שטוחה.
ועוד דבר: אם העבודה שלכם עם API כוללת איסוף נתוני רשת, הזנה ל-LLMs, בניית מערכות RAG, ניטור עמודי מתחרים או חילוץ נתוני מחיר/מוצר מאתרים, שיחת "כלי API" לא צריכה להסתיים בניטור זמינות. צריך גם דרך אמינה להפוך דפי אינטרנט מבולגנים לנתונים מובנים. כאן Thunderbit Open API נכנס למדריך הזה: הוא לא מוניטור זמינות, אבל הוא אחד הפתרונות המהירים ביותר להפוך אתרים ל-Markdown נקי או ל-JSON מבוסס סכימה דרך API.
מה זה ניטור API ולמה לצוות שלכם כדאי להתייחס לזה?
ניטור API פירושו בדיקה מתמשכת שה-Endpoints שלכם זמינים, מהירים ומחזירים את הנתונים הנכונים. לא רק "השרת עלה?" — מוניטור טוב מאמת קודי HTTP, תוכן התגובה, זמני תגובה, תעודות SSL, תהליכי עבודה מרובי שלבים (כמו התחברות → חיפוש → צ'קאאוט), ואפילו תקינות של הסכימה.
זה שונה מניטור אתר כללי, שבודק אם עמוד נטען, וגם מ-APM (Application Performance Monitoring), שנכנס לעומק של traces בקוד, שאילתות בסיס נתונים ומרכיבי runtime. ניטור API יושב בדיוק על הגבול: הוא בודק מה המשתמשים, השותפים והאינטגרציות שלכם באמת חווים כשהם קוראים ל-Endpoints.
יש גם קטגוריה קרובה שכדאי להזכיר: APIs לנתוני רשת. אלה לא מנטרים אם ה-API שלכם בריא; הם עוזרים למוצר או ל-workflow שלכם לאסוף בצורה אמינה נתוני אינטרנט חיצוניים. למשל, Thunderbit Open API יכול לדחוס דף אינטרנט ל-Markdown נקי, לחלץ שדות מובנים כ-JSON, ולהריץ עבודות batch על פני הרבה URLs. אם פרויקט ה-"API" שלכם תלוי בנתוני ספק עדכניים, עמודי מוצר, רישומים ציבוריים, עמודי תיעוד או מקורות מחקר, API כזה לחילוץ נתונים יכול להיות חשוב תפעולית לא פחות מבדיקות uptime.
למה גם מי שלא מפתח צריך להתעניין? כי APIs אחראים ל-71% מתעבורת האינטרנט הדינמית ו-62% מאנשי ה-API אומרים ש-APIs מייצרים הכנסה ישירות. כששער תשלומים, שירות אימות או API של משלוחים נופל, זו לא בעיית תשתית מופשטת — זה אובדן הכנסה, שבירת חוזים עם שותפים, עומס על התמיכה ושחיקה באמון. מנהלי מוצר, מכירות, תפעול והצלחת לקוחות כולם מושפעים מזה.
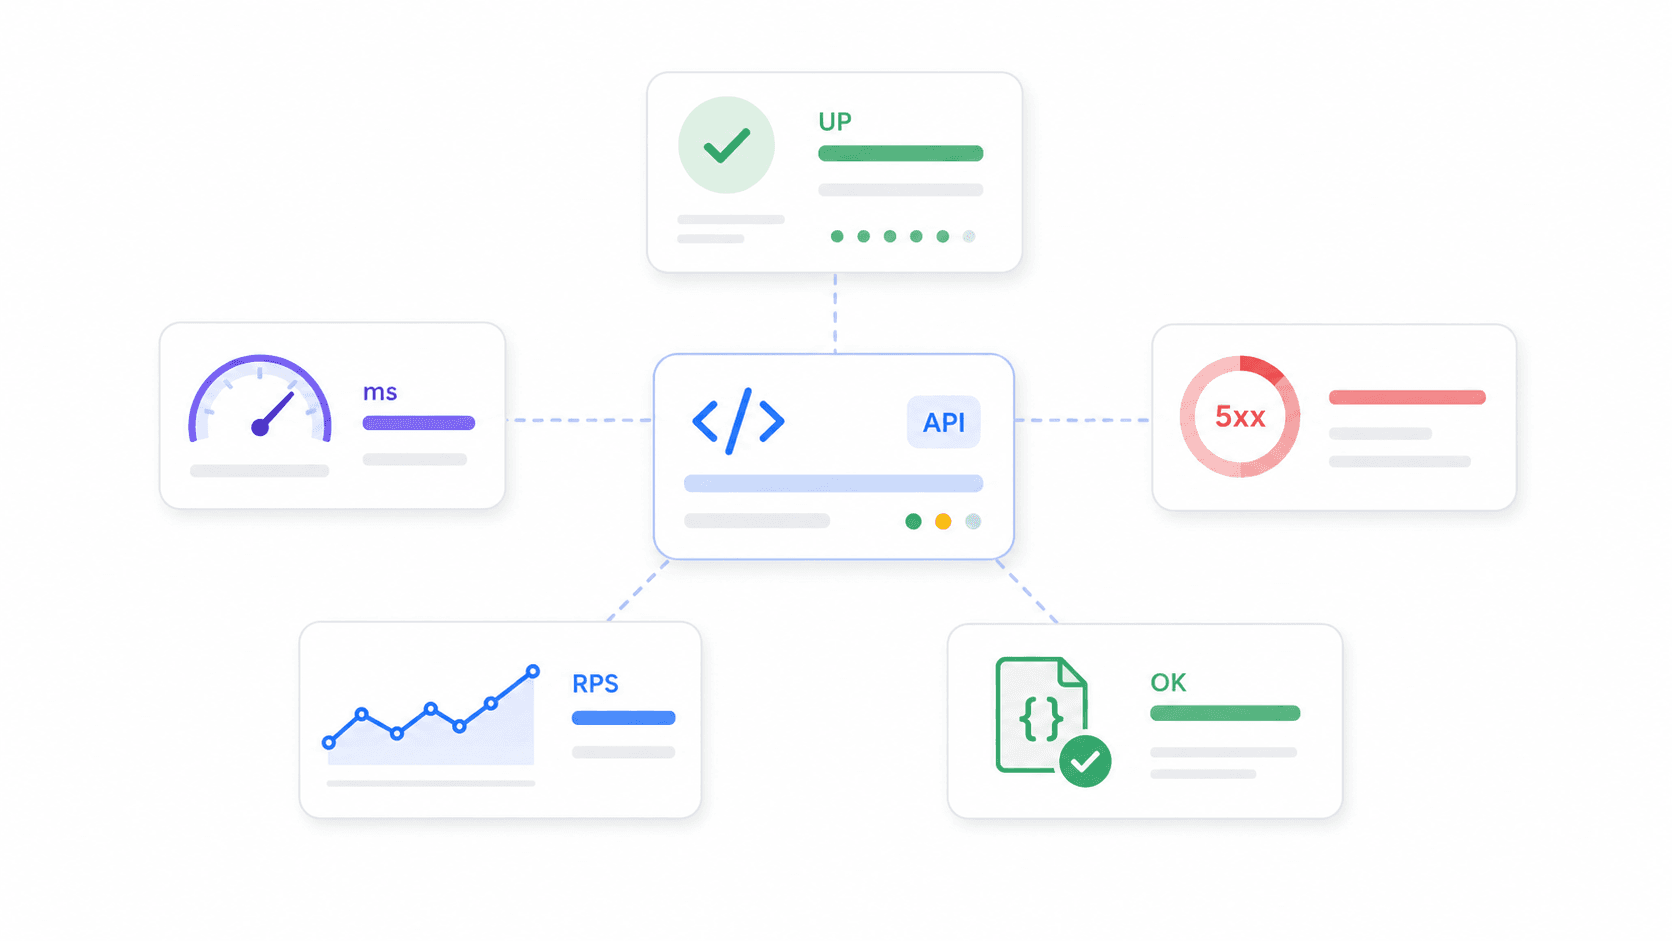
מדדים מרכזיים שכדאי לעקוב אחריהם:
- אחוז זמינות: החלק מהזמן שבו ה-Endpoint זמין
- זמן תגובה / latency: כמה זמן לוקח ל-Endpoint להגיב (ממוצע, p95, p99)
- שיעור שגיאות: חלק מהבקשות שמחזירות 5xx, timeouts או כשלים בבדיקות
- Throughput: מספר הבקשות לשנייה/דקה
- תקינות: האם ה-API מחזיר את הנתונים הצפויים, ולא רק 200 OK
איך הערכנו את כלי ניטור ה-API הטובים ביותר ל-2026
רוב המאמרים על "כלי ניטור API הטובים ביותר" פשוט מערימים שמות ספקים ופיצ'רים. רציתי להיות מכוון יותר בבחירת הקריטריונים — גם כי ביליתי לא מעט זמן בקריאת פורומים של מפתחים, וגם כי הצוות של Thunderbit עזר לי לחלץ בכמות גדולה נתוני מחירים ופיצ'רים מאתרי ספקים כדי לבנות השוואה אמיתית (עוד על ה-workflow הזה בהמשך).
כך שקללנו:
| קריטריון | למה זה חשוב |
|---|---|
| קלות ההקמה / זמן להתראה ראשונה | צוותים קטנים צריכים כיסוי עכשיו, לא אחרי פרויקט פלטפורמה |
| אינטליגנציה של התראות וצמצום רעש | אם ההתראות רועשות, הצוותים מתעלמים מהן ומפספסים תקלות אמיתיות |
| נדיבות ה-free tier | פרויקטים צדדיים וסטארטאפים בתחילת הדרך מתחילים הרבה פעמים בחינם |
| שקיפות בתמחור | חשבונות observability עלולים להתנפח בגלל hosts, seats, logs, synthetic runs ו-data ingest |
| רוחב האינטגרציות | ההתראות חייבות להגיע למקום שבו הצוות כבר עובד (Slack, PagerDuty וכו') |
| סקייל ועומק נתונים | צוותים בוגרים צריכים traces, logs, APM, RBAC, SSO ושמירת נתונים |
| איכות קהילה ותמיכה | צוותי קוד פתוח צריכים קצב שחרורים; צוותי אנטרפרייז צריכים SLA |
| יכולת חילוץ נתוני רשת | אפליקציות AI, workflows של RAG וכלי מחקר שוק צריכים לעיתים נתונים חיצוניים נקיים, לא רק uptime של endpoint |
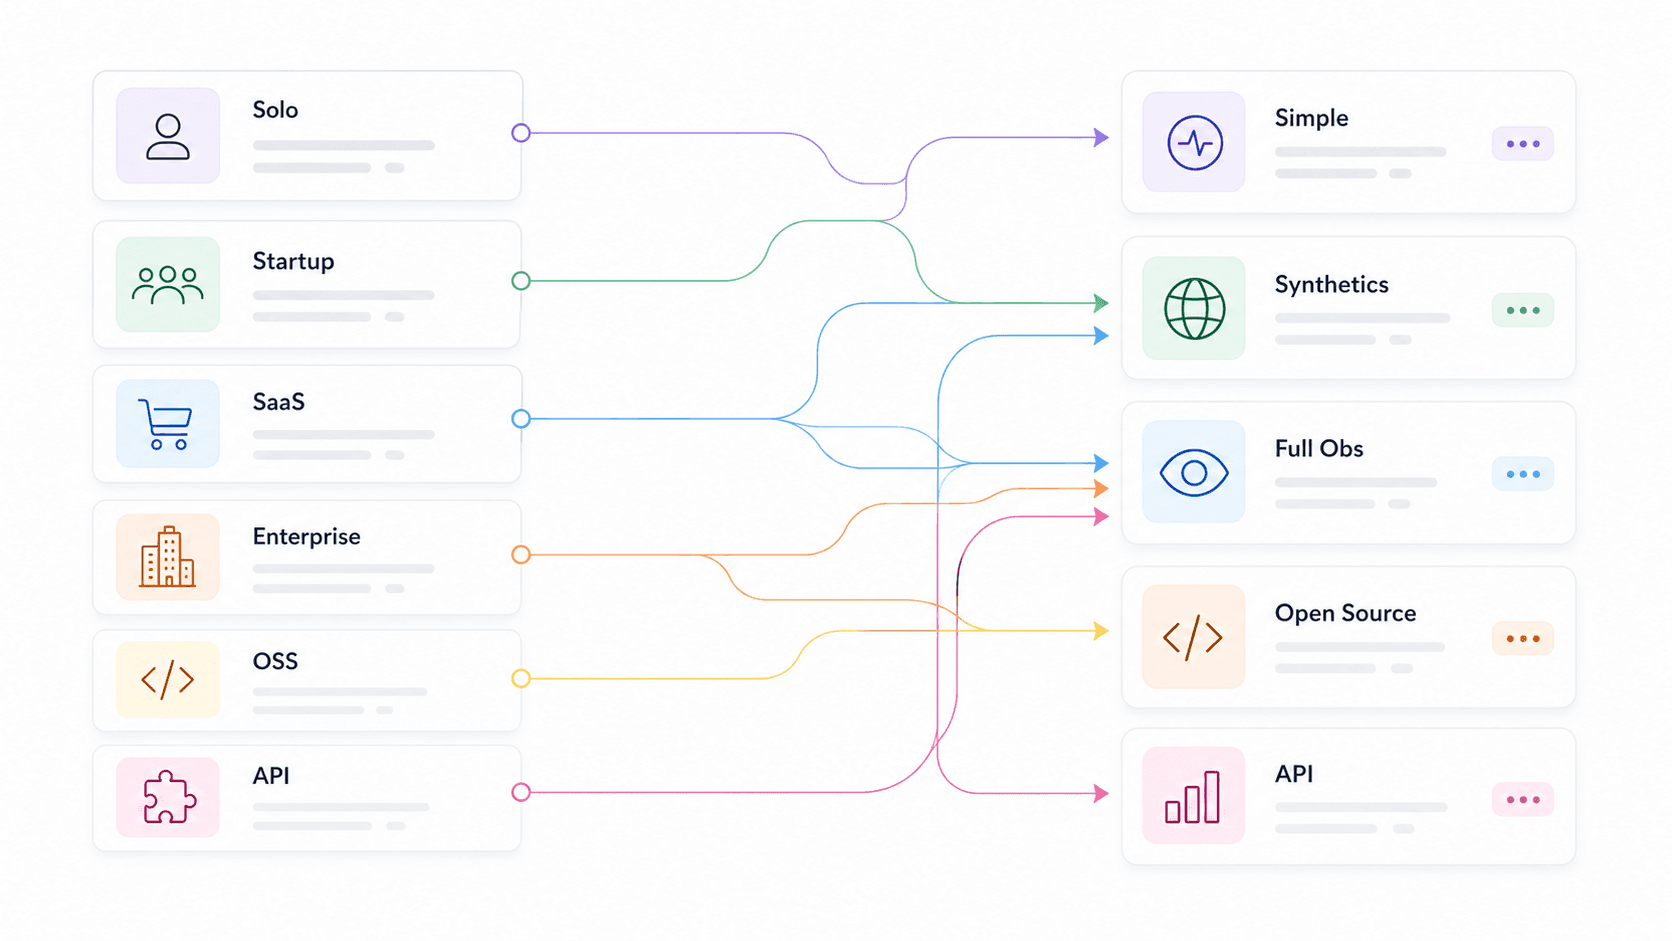
גם חילקנו את ההמלצות לפי שימוש — מפתח יחיד, סטארטאפ, e-commerce/SaaS, אנטרפרייז, תומך קוד פתוח, צוות מוצר API, וצוות נתוני רשת/אפליקציית AI — כדי שתוכלו לדלג ישר להקשר שלכם במקום לקרוא 14 סיכומי כלים ולקוות לנחש איזה מהם מתאים. הסקר של Grafana ל-2025 מצא ש-46% מהמשיבים ציינו תאימות בין מערכות ו-35% ציינו קלות מעבר עתידי כקריטריונים לבחירה, מה שמאשר שאלו לא רק "nice to have".
כלי ניטור API הטובים ביותר לפי שימוש: טבלת בחירה מהירה
זו הדרך הקצרה. מצאו את השורה שלכם, ואז עברו למקטעי הכלים למטה לפירוט המלא.
| שימוש | כלים מומלצים | ההבדל המרכזי |
|---|---|---|
| צוותי נתוני רשת / אפליקציות AI | Thunderbit Open API, Moesif, Apitally | להפוך אתרים ל-Markdown נקי או ל-JSON מובנה עבור LLMs, RAG, מחיר ומחקר |
| מפתח יחיד / פרויקט צדדי | UptimeRobot, Uptime Kuma, Gatus | חינם או self-hosted, קונפיגורציה מינימלית, התחלה מהירה |
| סטארטאפ (צוות של 5–15 אנשים) | Checkly, Better Stack, Postman | התראות חכמות, הקמה מהירה, מחיר נגיש, עמודי סטטוס |
| e-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | מדדי עסק, APM/tracing, עומק SDK, synthetics רב-שלביים |
| אנטרפרייז / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | distributed tracing, תאימות, hybrid, RBAC/SSO |
| חובבי קוד פתוח טהור | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | שליטה מלאה, OTel native, בלי lock-in לספק |
| צוותי מוצר API | Moesif, Apitally, New Relic | שימוש לפי לקוח, מגמות ב-Endpoints, התראות אנומליה |
התבנית הבולטת ביותר: הכלים שהכי מהירים להקמה נוטים להיות דלים יותר באנליטיקה, בעוד הפלטפורמות העמוקות יותר דורשות יותר קונפיגורציה ומשמעת עלויות. זו לא תקלה — זו פשרה שצריך להכיר. Thunderbit יושב קצת במסלול אחר: הוא הכי מהיר כשהמשימה היא להפוך דפי אינטרנט לנתונים מוכנים ל-API, לא להתריע למפתחים על השבתה.
Thunderbit Open API: הכי טוב להפיכת אתרים לנתוני API מובנים
התחילו לבנות עם Thunderbit Open API הפכו עמודים ל-Markdown, חלצו JSON מובנה, ועבדו על URLs באצווה בלי לתחזק תשתית scraping. Get Started Free
Thunderbit Open API הוא ה-API שהייתי שם במקום הראשון עבור צוותים שה"ניטור" או ה-workflow המחקרי שלהם תלוי בנתוני רשת חיצוניים. זה לא כלי ניטור uptime מסורתי כמו Checkly או UptimeRobot. במקום זה, Thunderbit הופך כל דף אינטרנט לנתונים נקיים ומובנים שהאפליקציות, ה-agents, הדשבורדים וצינורות ה-LLM שלכם באמת יכולים להשתמש בהם.
ל-API יש שלושה תהליכי עבודה מרכזיים. Distill ממיר דף ל-Markdown נקי ומוכן ל-LLM. Extract לוקח סכימה ומחזיר שדות JSON מובנים כמו שם מוצר, מחיר, זמינות, גודל חברה, שלב גיוס או ציון ביקורות. Batch מאפשר לעבד עד 100 URLs באופן אסינכרוני עם webhooks, מה שנוח כשאתם מנטרים עמודי תמחור, קטלוגי מתחרים, תיעוד ספקים, מקורות חדשות או רשימות מחקר גדולות.
הסיבה שהוא נכנס למדריך כלי API היא שצוותים לעיתים מזלזלים בכמות התשתית שצריך כדי ש"פשוט תגרדו את הדף הזה" יעבוד. אתרים כבדי JavaScript צריכים רינדור. חלק מהעמודים צריכים ניתוב גאוגרפי. צריך לנקות HTML מסרגלי ניווט, פרסומות, חלונות קופצים וטקסט גנרי לפני שהוא שימושי ל-LLM. selectors נשברים כשהפריסה משתנה. סבב proxy, טיפול ב-anti-bot, retries, queues ו-polling של תוצאות יכולים להפוך Workflow נתונים קטן לפרויקט תחזוקה. Thunderbit סופג הרבה מהעבודה הזו מאחורי API אחד.
הכי מתאים ל: בוני אפליקציות AI, צוותי RAG, תפעול e-commerce, תפעול מכירות, growth, חוקרי שוק, ומפתחים שצריכים נתוני אתרים דרך API בלי לבנות ולתחזק סט scraping שלם.
תמחור: 600 יחידות API חד-פעמיות בחינם, כולל עד 600 עמודי Distill או 30 עמודי Extract, עם 2 בקשות במקביל. Starter מופיע ב-16 דולר לחודש בתשלום שנתי עבור 60,000 יחידות API לשנה ו-30 בקשות במקביל. Pro מופיע ב-40 דולר לחודש בתשלום שנתי עבור 600,000 יחידות API לשנה ו-50 בקשות במקביל.
מהירות הקמה: כ-5–15 דקות כדי לקבל API key ולהריץ בקשת Distill או Extract ראשונה עם cURL, SDKs או Thunderbit CLI.
חסרונות: Thunderbit לא יחליף את Datadog, New Relic, Better Stack או Checkly עבור בדיקות uptime, הסלמה באירועים, traces, logs או ניתוב on-call. תחשבו עליו כ-API שמשמש לאיסוף ולבנייה של נתוני רשת — כולל תמחור של ספקים, תיעוד, עמודי מתחרים, רשימות מוצרים או datasets ציבוריים — לא כמערכת שמצלצלת למהנדס הכונן.
Datadog: הכי טוב לנראות מלאה על כל ה-stack
Datadog הוא הכלי שאני רואה שוב ושוב בסטאקים של אנטרפרייז ו-mid-market SaaS, ולא במקרה. זה לא רק ניטור API — זו פלטפורמת observability מלאה שמחברת בדיקות API סינתטיות עם distributed traces, logs, מדדי תשתית ו-real user monitoring בתצוגה אחת.
באופן ספציפי ל-API, Datadog תומך ב-HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC, ו-multi-step API tests. ה-anomaly detection monitors שלו לומדים דפוסים צפויים ומתריעים על חריגות במקום על ספים סטטיים — קפיצה משמעותית מ"להתריע כשה-latency מעל 500ms". הוא גם מציע forecast monitors שמנבאים מתי מדד יחצה סף, וכן composite monitors שמשלבים כמה תנאים.
הכי מתאים ל: צוותי e-commerce, SaaS ואנטרפרייז שצריכים חלון אחד על APIs, תשתית, logs ו-traces.
תמחור: פרטי ה-free tier משתנים לפי מוצר. Infrastructure Pro מתחיל ב-15 דולר ל-host לחודש; בדיקות API סינתטיות ב-5 דולר לכל 10,000 הרצות. יותר מ-800 אינטגרציות.
מהירות הקמה: כ-15–30 דקות להתקנת agent ובדיקה סינתטית בסיסית.
חסרונות: יכול להיות יקר בסקייל — "bill shock" הוא נושא שחוזר שוב ושוב ב-Hacker News וב-Reddit. המספר הגדול של קטגוריות חיוב (hosts, logs, custom metrics, synthetics, users) אומר שצריך מישהו שעוקב אחרי החשבון, לא רק אחרי הדשבורדים. עקומת הלמידה אמיתית עבור הפלטפורמה המלאה.
Checkly: הכי טוב לבדיקות סינתטיות שמיועדות למפתחים
Checkly הוא הכלי שהייתי מוסר לצוות הנדסה של סטארטאפ שרוצה שבדיקות API יישבו קרוב לקוד. הרעיון המרכזי שלו הוא "monitoring as code": מגדירים בדיקות API ודפדפן באופן פרוגרמטי, מריצים אותן ממיקומים גלובליים, משלבים עם CI/CD ומנהלים הכול דרך Git.
הזווית של איכות ההתראות חזקה מאוד כאן. לוגיקת ה-retry של Checkly מוצגת במפורש כ"קו ההגנה הראשון" נגד false positives — אפשר להגדיר retries קבועים, ליניאריים או אקספוננציאליים, retries מאותו מיקום או ממיקום אחר, ומשך retry מקסימלי לפני שההתראה נשלחת. הוא גם מבדיל בין מצבים של degraded, failed ו-recovered, מה שעוזר לצמצם התראות רועשות.
הכי מתאים ל: סטארטאפים וצוותי פיתוח שרוצים בדיקות API פרוגרמטיות, בדיקות דפדפן מבוססות Playwright, אינטגרציה עם CI/CD והקמה מהירה.
תמחור: נתונים ציבוריים עדכניים מצביעים על תוכנית חינמית עם 10 מוניטורי uptime, 1,000 בדיקות דפדפן ו-10,000 בדיקות API. Starter סביב 24 דולר לחודש בתשלום שנתי — כדאי לאמת את עמוד התמחור הרשמי לפני רכישה.
מהירות הקמה: כ-10–20 דקות לבדיקה ראשונה ולערוץ התראה.
חסרונות: ממוקד בבדיקות סינתטיות. לא מחליף APM עמוק, ניתוח logs או distributed tracing. אם צריך לקשור בין כשל ב-API לבין צוואר בקבוק בבסיס הנתונים, תצטרכו כלי נוסף לידו.
UptimeRobot: הכי טוב למעקב uptime פשוט ומשתלם
UptimeRobot הוא ה-Honda Civic של ניטור API. הוא עושה דבר אחד טוב: יוצרים מוניטור HTTP, keyword, ping, port, SSL או heartbeat, בוחרים interval, ומקבלים התראה כשיש כשל. זהו.
הכי מתאים ל: מפתחים יחידים, צוותים קטנים, סוכנויות, או כל מי שצריך מעקב uptime ו-latency בסיסי בלי מורכבות.
תמחור: חינם: 50 מוניטורים, אינטרוולים של 5 דקות. תוכנית Solo בתשלום מתחילה סביב 7 דולר לחודש בתשלום שנתי. לא נדרש כרטיס אשראי בתוכנית החינמית. מהירות הקמה: כ-2–5 דקות — הכי מהיר ברשימה.
חסרונות: אינטליגנציה מוגבלת בהתראות. התראות threshold בסיסיות, בלי anomaly detection, בלי distributed tracing, בלי אנליטיקה עמוקה. אם צריך להבין למה endpoint איטי, ולא רק שהוא איטי, UptimeRobot לא יוביל אתכם לשם.
Uptime Kuma: כלי ניטור API חינמי ו-self-hosted הטוב ביותר
Uptime Kuma הוא יקיר קהילת ה-self-hosting, והמספרים ב-GitHub מאשרים: 86,637 כוכבים, 7,831 forks, 1,060 תורמים, וגרסה 2.3.2 נכון למאי 2026. הוא ברישיון MIT, תומך ב-HTTP(s), keyword, שאילתת JSON, WebSocket, TCP, ping, DNS, push, Docker, כמה עמודי סטטוס, ויותר מ-90 שירותי התראה.
הכי מתאים ל: מפתחים יחידים וצוותים שרוצים שליטה מלאה, פרטיות, ואפס עלות SaaS חוזרת — אם יש לכם שרת.
תמחור: חינם. העלות האמיתית היא ה-VM/container, הגיבויים, העדכונים, והדאגה שהמוניטור עצמו יישאר באוויר. מהירות הקמה: כ-5–15 דקות עם Docker לבדיקה בסיסית; 15–30 דקות כשמוסיפים התראות ועמוד סטטוס.
חסרונות: אתם אחראים על התחזוקה. וזו המלכודת הקריטית: אם מארחים את Uptime Kuma על אותה תשתית שהוא מנטר, תקלה בענן או ב-DNS תוריד גם את האפליקציה וגם את המוניטור. עדיף לארח אותו חיצונית או לשלב אותו עם בדיקת SaaS.
Better Stack: הכי טוב לטיפול מהיר באירועים
Better Stack, שלעיתים עדיין נקרא Better Uptime, משלב ניטור uptime עם incident management, תזמון on-call, מדיניות הסלמה ועמודי סטטוס בפלטפורמה אחת. החוזקה שלו היא פחות ככלי אנליטיקה ויותר ככלי workflow לאירועים, עטוף סביב הניטור.
מדיניות הסלמה מגדירה מי מקבל התראה, באיזה סדר, ובאילו השהיות עד לאישור קבלה. ניתוב מבוסס מטא-דאטה שולח אירועים לפי חומרה או בעלות. הוא משתלב עם Slack, Teams, webhooks ו-Zapier.
הכי מתאים ל: סטארטאפים וצוותים בינוניים שרוצים ניטור + תגובה לאירועים + עמודי סטטוס בלי לחבר שלושה כלים נפרדים.
תמחור: תוכנית חינמית: 10 מוניטורים/heartbeats, עמוד סטטוס אחד. Team סביב 29 דולר לחודש בתשלום שנתי. מהירות הקמה: כ-5–10 דקות דרך אשף GUI.
חסרונות: פחות עומק באנליטיקה של payloads, distributed tracing או ניתוח KPI עסקיים לעומת Datadog, New Relic או Moesif.
Prometheus + Grafana: סטאק הקוד הפתוח הטוב ביותר לניטור API
זהו צמד הקוד הפתוח הסטנדרטי בתעשייה. Prometheus אוסף ושומר מדדי time-series. Grafana (73,705 כוכבי GitHub, 3,010 תורמים) מספקת דשבורדים והתראות. Alertmanager מטפל בניתוב, קיבוץ, מניעת כפילויות, השתקה והדחקה. לבדיקות של endpoint API, צוותים מוסיפים את Blackbox Exporter עבור HTTP, HTTPS, DNS, TCP, ICMP ו-gRPC probing.
הכי מתאים ל: חובבי קוד פתוח, צוותי Kubernetes/SRE, וארגונים שכבר תקננו על מדדי Prometheus.
תמחור: חינם ב-self-hosted. ל-Grafana Cloud יש תוכנית חינמית (100k הרצות API test בחודש) ותוכניות בתשלום לפי שימוש.
מהירות הקמה: 1–4 שעות לסט בסיסי של Blackbox + Prometheus + Grafana + Alertmanager. ימים עבור HA ייצור וכיוונון התראות.
חסרונות: PromQL, YAML, relabeling, עיצוב דשבורדים, retention, אחסון, HA וכיוונון התראות הם עבודה תפעולית אמיתית. הפשרה החוזרת היא "פחות UI, יותר YAML". זה הסטאק לצוותים שכבר חושבים במונחי מדדים ורוצים control plane אחד — לא לצוותים שרוצים ניטור עוד לפני ארוחת צהריים.
New Relic: הכי טוב לביצועי אפליקציות SaaS
New Relic משלב APM, ניטור תשתית, logs, distributed tracing, ניטור סינתטי, התראות, דשבורדים וניתוח אירועים בעזרת AI. ה-free tier שלו — 100 GB של data ingest בחודש ו-1 full platform user — נדיב באמת עבור צוותים קטנים.
האינטליגנציה של ההתראות היא המקום שבו New Relic בולט בדיון על עייפות מהתראות. היכולות של incident intelligence כוללות קורלציה בין אירועים, anomaly detection, התראות חזויות, root-cause analysis ודיכוי flapping. New Relic פרסמו דוגמה שבה 97.2% יעילות ב-flapping פירושה רק 28 בעיות שמוצגות מתוך 1,000 אירועי flapping — זה מספר קונקרטי לצמצום רעש.
הכי מתאים ל: צוותי SaaS ופלטפורמות e-commerce שרוצים ניטור API שמשתלב הדוק עם traces ברמת האפליקציה, שגיאות, throughput והשפעה על משתמשים.
תמחור: חינם: 100 GB לחודש, 1 משתמש מלא. בתשלום, המודל מבוסס על משתמשים ועל נפח נתונים.
מהירות הקמה: כ-15–30 דקות להתקנת agent ולהגדרה מונחית.
חסרונות: התמחור יכול להסתבך בסקייל. גם ההגדרה של ההתראות דורשת למידה — הפלטפורמה חזקה, אבל לא אינטואיטיבית מיד.
Moesif: הכי טוב לאנליטיקה של API ולמדדים עסקיים
Moesif הוא לא מוניטור uptime מסורתי. זו אנליטיקת API ואינטליגנציה מוצרית: להבין שימוש ב-API לפי לקוח, endpoint, cohort, חברה, גאוגרפיה, SDK, תוכנית והתנהגות. אם השאלה שלכם היא "איזה לקוח נפגע?" ולא "האם ה-endpoint עובד?", זה הכלי שנבנה לזה.
הוא תומך ב-התראות threshold סטטיות והתראות אנומליה דינמיות עבור מדדי API כמו קפיצות/ירידות בתנועה, latency ושינויים בהתנהגות. ההתראות הדינמיות צריכות כמה ימים של התנהגות API כדי לבנות מודל, אבל אחרי האימון הן מזהות שינויים ש-rules סטטיים מפספסים.
הכי מתאים ל: צוותי מוצר API, חברות SaaS ופלטפורמות e-commerce שצריכות לקשר בין ביצועי API להכנסות, engagement ו-retention.
תמחור: יש Free/trial; התוכניות בתשלום גדלות לפי נפח אירועי API. מחירי self-service מדויקים לא היו ניתנים לחילוץ מלא במחקר שלי — כדאי לאמת בעמוד הנוכחי.
מהירות הקמה: כ-20–45 דקות (אינטגרציית SDK/proxy/gateway עמוקה יותר מ-ping חיצוני).
חסרונות: יותר ממוקד אנליטיקה מאשר ניטור uptime מסורתי. סביר שתרצו לשלב אותו עם Checkly, UptimeRobot או Datadog synthetics לבדיקות זמינות חיצוניות.
Splunk: הכי טוב לניתוח לוגים ולתאימות בארגונים
Splunk הוא הכלי שאליו פונים כשאגרגציית לוגים, חיפוש, קורלציה, auditability מוכנה לתאימות ותמיכה ב-hybrid/multi-cloud הם דרישות שאי אפשר לוותר עליהן. Splunk Observability Cloud מכסה תשתית, APM, synthetics, real user monitoring, logs ותגובה לאירועים. ITSI/Event Analytics יכול לקבץ אירועים בולטים לפרקים ולצמצם רעש בין סילואי ניטור.
מחקר ה-observability של Splunk ל-2025 מציג תמונה מדאיגה: 73% ממשיבי ITOps/engineering דיווחו על השבתות בגלל התראות שהתעלמו מהן או הודחקו, 59% התקשו עם יותר מדי כלים נפרדים, ו-52% התקשו עם false alerts.
הכי מתאים ל: צוותי אנטרפרייז ו-multi-cloud עם דרישות מחמירות של תאימות, אבטחה, audit וחיפוש בלוגים.
תמחור: מבוסס שימוש ובדרך כלל דורש הצעת מחיר. אין free tier פשוט לייצור.
מהירות הקמה: ה-onboarding לענן יכול להיות מהיר יותר, אבל בפריסת אנטרפרייז זה לרוב לוקח ימים עד שבועות.
חסרונות: יקר בסקייל. ההגדרה מורכבת. מוגזם עבור מפתחים יחידים וסטארטאפים קטנים.
Postman: הכי טוב לצוותים שכבר בודקים APIs
Postman הוא בעיקר פלטפורמה לפיתוח ובדיקת API, אבל מוצר הניטור שלו מאפשר לצוותים לתזמן collections של Postman ולהריץ אותם ממיקומי ענן. הטיעון החזק ביותר הוא reuse: אם לצוות QA או dev כבר יש collections עם assertions, להפוך אותן למוניטורים הוא שלב טבעי.
הכי מתאים ל: צוותי פיתוח ו-QA שכבר משתמשים ב-Postman collections ורוצים בדיקות מתוזמנות בלי לקנות כלי synthetic נפרד.
תמחור: יש תוכנית חינמית. חריגות בניטור ב-0.75 דולר לכל 1,000 קריאות; חבילת תוספת של 50,000 קריאות ב-20 דולר לחודש. כדאי לאמת את עמוד התוכנית העדכני — מבנה החבילות של Postman משתנה.
מהירות הקמה: כ-10 דקות אם ה-collections כבר קיימים.
חסרונות: יכולות הניטור קלות יותר מכלים ייעודיים כמו Checkly, Datadog או New Relic. אפשרויות ההתראה בסיסיות.
עוד כלי ניטור API שכדאי להכיר
Gatus: דשבורד בריאות קל, self-hosted ומבוסס קונפיגורציה. 10,906 כוכבי GitHub, תומך ב-HTTP, ICMP, TCP, DNS, מדדים ידידותיים ל-Prometheus ובאייקוני uptime. מעולה למפתחים יחידים שרוצים משהו פשוט יותר מ-Prometheus אבל מעדיפים YAML/config-as-code על פני ה-UI של Uptime Kuma.
Apitally: כלי חדש יותר שמתמקד באנליטיקה של תעבורת API ומעקב איכות עבור סטארטאפים. טוען ל-הקמה בפחות מ-5 דקות עם התראות מותאמות אישית על פני 14 מדדים. טוב לאנליטיקת API קלה בלי לאמץ פלטפורמת observability מלאה.
Sematext: ניטור full-stack עם logs, synthetics ונראות לתשתית. Synthetics סביב 2 דולר למוניטור HTTP, 7 דולר למוניטור דפדפן, מינימום 5 דולר לחודש. חלופה זולה יותר ל-Datadog עבור צוותי mid-market.
Uptrace: backend של OpenTelemetry-native עבור APM, tracing, metrics ו-logs. 4,198 כוכבי GitHub. לא בודק uptime טהור, אבל אידיאלי לצוותים שמתקננים על OTel ורוצים backend פתוח-friendly ל-tracing.
Build vs. Buy: האם לבנות בעצמכם ניטור API?
"למה פשוט לא לכתוב סקריפט שמבצע ping ל-endpoints שלי, במקום להשתמש בכלי ייעודי?"
השאלה הזו עולה כל הזמן בפורומים של מפתחים. קראתי מספיק שרשורי Reddit כדי לראות את הדפוס בבירור: צוותים מתחילים עם curl + cron, זה עובד לא רע תקופה מסוימת, ואז עוברים לכלי ייעודי ברגע שהם צריכים דשבורדים, היסטוריית נתונים, בדיקות מרובות אזורים, ניתוב התראות אמין או נראות בין-צוותית.
מטריצת החלטה כנה:
| גורם | סקריפט מותאם אישית | כלי ייעודי |
|---|---|---|
| זמן הקמה | 1–4 שעות (בסיסי); ימים (חזק) | 5–30 דקות |
| תחזוקה | באחריותכם לנצח | הספק מטפל בעדכונים |
| איכות התראות | בסיסית (up/down) | חכמה (מגמות latency, אנומליות, retries) |
| עלות | חינם (זמן שלכם) | 0–500+ דולר לחודש |
| דשבורד | לבנות מאפס | מוכן מראש, ניתן להתאמה |
| מתי הכי מתאים | עד 3 endpoints, צוות כבד-פיתוח, פרויקט תחביב | 5+ endpoints, צוות ops/product, יש הכנסה על הכף |
התובנה העיקרית מהפורומים: הרבה מאלה שבונים לבד מתחרטים ברגע שהם צריכים דשבורדים, היסטוריית נתונים או נראות בין-צוותית. ויש גם את הבעיה המטא — "צריך ניטור על הניטור שלכם". מוניטור self-hosted, בסיס נתונים, גיבוי, מסלול רשת וספק התראות — כולם צריכים להיות אמינים גם הם.
בנו אם יש לכם 2 endpoints ואתם נהנים מ-tinkering. קנו אם יש לכם מוצר להשיק.
אותה לוגיקה חלה גם על חילוץ נתוני רשת. אפשר לכתוב scraper, להריץ דפדפנים headless, לסובב proxies, לתחזק selectors, לנקות HTML ולבנות queue. אבל אם המשימה היא להזרים בצורה אמינה נתוני רשת למוצר API, ל-agent AI או ל-workflow מחקרי, שימוש ב-Thunderbit Open API הוא בדרך כלל מהיר יותר מלבנות תשתית scraping משלכם.
עייפות מהתראות: למה איכות ההתראה עדיפה על כמות ההתראות
זה אולי הקריטריון הכי לא מוערך בבחירת כלי ניטור API. עייפות מהתראות קורה כשצוותים מקבלים כל כך הרבה התראות רועשות, כפולות או לא-ניתנות-לפעולה, עד שהם מתחילים להתעלם מכולן — ואז מפספסים תקלות אמיתיות.
המספרים חדים. הדוח של BigPanda ל-2025 מצא שהארגון החציוני ייצר 2,350 התראות ביום ו-803,406 התראות בשנה. ה-actionability החציונית של אירועים עמדה רק על 18% — כלומר פחות מאחת מכל חמש תקלות שמקורן בהתראות הייתה באמת ניתנת לפעולה. הסקר של NeuBird ל-2026 מצא ש-77% מצוותי ה-on-call מקבלים לפחות 10 התראות ביום ו-80% אומרים שחצי או פחות מההתראות האלה באמת ניתנות לפעולה.
כלי הניטור הטוב ביותר הוא זה שההתראות שלו באמת זוכות לאמון. כך הכלים מתמודדים עם אינטליגנציה של התראות:
| כלי | סוג התראה | שיטת צמצום רעש | ערוצי התראה |
|---|---|---|---|
| Datadog | ML anomaly, forecast, composite | תחומי אנומליה היסטוריים, baselines דינמיים, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, ועוד 20+ |
| Checkly | Threshold + based on degradation | retries לפני שליחה, retries מאותו/ממיקום אחר | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | קיבוץ בעיות בעזרת AI, anomaly, predictive | קורלציית אירועים, דיכוי flapping, הקשר של root-cause | Slack, PagerDuty, Teams, webhooks |
| Moesif | Anomaly התנהגותי | מודלים דינמיים אחרי כמה ימי התנהגות | Slack, PagerDuty, email, SMS |
| Better Stack | uptime/incident/on-call | מדיניות הסלמה, ניתוב לפי בעלות, השהיות | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | התראות rule ב-PromQL | קיבוץ, מניעת כפילויות, השתקה, inhibition | Email, PagerDuty, Opsgenie, webhooks |
| Splunk | אירועים, פרקים, health של שירות | ITSI Event Analytics, קיבוץ episodes, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | לא פלטפורמת התראות | לשימוש עם scheduler משלכם, כלי workflow או סטאק ניטור | Webhooks לעבודות batch; ההתראות מטופלות חיצונית |
עצה מעשית: התחילו עם פחות התראות אבל כאלה שיש בהן יותר ביטחון. השתמשו ב-retry-before-firing, אימות מרובה אזורים, התראות לפי SLO burn-rate, מניעת כפילויות וניתוב לפי בעלות. תתריעו על השפעה על משתמשים ועל מסלולים קריטיים לעסק (כשל בצ'קאאוט, כשל באימות, 5xx בתשלומים), לא על כל סימפטום פנימי.
תמחור ו-free tiers ב-2026: כמה באמת משלמים
עמודי תמחור משתנים. ה-free tiers זזים. עלויות נסתרות (hosts, seats, logs, synthetic runs, data ingest) יכולות להפתיע. זה המקטע שהייתי רוצה לראות בכל מאמר "הכלים הטובים ביותר". תמונת מצב ל-2026:
| כלי | תוכנית חינמית | מחיר התחלה בתשלום | נדרש כרטיס אשראי? | תסריט חינמי הטוב ביותר |
|---|---|---|---|---|
| Thunderbit Open API | 600 יחידות API חד-פעמיות | ~16 דולר לחודש בתשלום שנתי | לא | חילוץ נתוני רשת ל-LLMs, RAG, מחיר ומחקר |
| Uptime Kuma | ללא הגבלה (self-host) | — | לא | ניטור מלא, על שרת משלכם |
| UptimeRobot | 50 מוניטורים, אינטרוולים של 5 דק' | ~7 דולר לחודש | לא | בדיקות uptime בסיסיות |
| Better Stack | 10 מוניטורים, עמוד סטטוס אחד | ~29 דולר לחודש | לא | uptime + status page לסטארטאפ |
| Checkly | 10 uptime, 10k בדיקות API | ~24 דולר לחודש | כן | בדיקות API סינתטיות |
| Postman | חשבון חינמי + quota לניטור | ~14 דולר למשתמש לחודש | לא | reuse של collections קיימים |
| Prometheus + Grafana | ללא הגבלה (self-host) | — | לא | מדדים + ויזואליזציה |
| Grafana Cloud | 100k הרצות API test בחודש | 29 דולר לחודש לפלטפורמה + שימוש | לאמת | ניסיון של synthetics מנוהלים |
| New Relic | 100 GB לחודש, משתמש מלא אחד | לפי משתמש + נתונים | בחלק מהתוכניות | APM + observability בסיסי |
| Datadog | ניסיון/משתנה לפי מוצר | 15 דולר ל-host לחודש (Infra Pro) | לעיתים כן | הערכה מלאה של ה-stack |
| Moesif | יש Free/trial | מבוסס נפח | לאמת | הערכת אנליטיקת API |
| Splunk | זמינות ניסיונות | מבוסס הצעת מחיר | תהליך מכירה | הוכחת היתכנות לאנטרפרייז |
| Gatus | ללא הגבלה (self-host) | — | לא | דשבורד סטטוס מבוסס YAML |
| Apitally | Free/trial זמין | לאמת | לאמת | אנליטיקת API קלה |
| Sematext | Trial/free משתנה | ~2 דולר למוניטור HTTP | לאמת | synthetics/logs בעלות נמוכה יותר |
| Uptrace | חינם ב-self-host | רמות ענן משתנות | לאמת | הערכת OTel APM |
הערת עלות נסתרת: כלים self-hosted (Uptime Kuma, Prometheus, Gatus) הם "חינם" מבחינת רישיון, אבל VM קטן, גיבויים, זמן תחזוקה ו-failover חיצוני יכולים בקלות להפוך לעלות האמיתית. עבור APIs של נתוני רשת, העלות הנסתרת שונה בדרך כלל: תחזוקת דפדפנים headless, selectors שבורים, מאגרי proxy, workaround ל-anti-bot וניקוי HTML.
הערכת צוות קטן: עבור 10 endpoints של API ו-3 אנשי צוות, הנתיב הזול ביותר ב-SaaS הוא בדרך כלל UptimeRobot חינמי או נמוך-עלות, Better Stack חינמי/Team, או Checkly אם נפח ההרצות מתאים. Datadog ו-New Relic יכולים להיות סבירים להערכה, אבל החשבון האמיתי תלוי ב-hosts, משתמשים, logs, traces ונפח הרצות הסינתטיות. אם הפרויקט שלכם צריך נתוני אתר כ-API, יחידות ה-API החינמיות של Thunderbit מספיקות כדי לבדוק את ה-workflow לפני התחייבות לתוכנית בתשלום.
כרטיס ניקוד למורכבות הקמה: כמה מהר מגיעים להתראה ראשונה
לא מצאתי מאמר מתחרה שבודק time-to-value — כמה זמן עובר מהרשמה ועד קבלת ההתראה המשמעותית הראשונה. עבור צוותים קטנים זה חשוב יותר מעומק הפיצ'רים.
| כלי | זמן להתראה ראשונה | רמת מיומנות נדרשת | אופן קונפיגורציה |
|---|---|---|---|
| Thunderbit Open API | ~5–15 דקות | נמוכה–בינונית | API key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 דקות | נמוכה | GUI, קליק להוספה |
| Better Stack | ~5–10 דקות | נמוכה | אשף GUI |
| Checkly | ~10–20 דקות | נמוכה–בינונית | קוד או GUI |
| Postman | ~10 דקות (עם collections) | נמוכה–בינונית | תזמון collection |
| Uptime Kuma | ~5–30 דקות | בינונית | Docker + GUI |
| Gatus | ~15–45 דקות | בינונית | YAML + Docker |
| Datadog | ~15–30 דקות | בינונית | התקנת agent + GUI |
| New Relic | ~15–30 דקות | בינונית | agent + setup מונחה |
| Moesif | ~20–45 דקות | בינונית | אינטגרציית SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 דקות | בינונית | GUI, Terraform אופציונלי |
| Prometheus + Grafana | 1–4 שעות | בינונית–גבוהה | YAML, PromQL |
| Uptrace | 30–90 דקות | בינונית–גבוהה | אינטגרציית OTel SDK |
| Splunk | שעות עד שבועות | גבוהה | onboarding לאנטרפרייז |
אם הניטור צריך להיות פעיל עד סוף היום, התחילו בחצי העליון של הטבלה. אם המטרה היא observability פלטפורמתית לטווח ארוך, תכננו פרויקט נפרד לחצי התחתון. ואם אבן הדרך הראשונה שלכם היא "להביא נתונים נקיים מ-100 דפי אינטרנט לתוך אפליקציה", התחילו עם Thunderbit לפני בניית תשתית scraping מותאמת.
השוואה מלאה: כלי ניטור ה-API הטובים ביותר זה לצד זה
טבלה אחת לסריקה לפני שמחליטים:
| כלי | תסריט השימוש הטוב ביותר | תוכנית חינמית | אינטליגנציה של התראות | זמן הקמה | Hosting | פיצ'ר בולט |
|---|---|---|---|---|---|---|
| Thunderbit Open API | חילוץ נתוני רשת / pipelines של נתוני API | 600 יחידות API | לא כלי התראה | 5–15 דק' | Cloud | הפיכת עמודים ל-Markdown או חילוץ JSON מבוסס סכימה |
| Datadog | אנטרפרייז/SaaS full-stack | ניסיון/משתנה | anomaly, forecast, AI | 15–30 דק' | Cloud | קורלציה בין synthetics ל-logs/traces/infra |
| Checkly | synthetics למפתחים | נדיב, מבוסס checks | retries, degradation | 10–20 דק' | Cloud | Monitoring as code + Playwright |
| UptimeRobot | uptime פשוט | 50 מוניטורים | thresholds בסיסיים | 2–5 דק' | Cloud | המוניטור הבסיסי הזול והמהיר ביותר |
| Uptime Kuma | self-hosted בחינם | ללא הגבלה | status/threshold בסיסי | 5–30 דק' | Self-hosted | UI נקי, בלי דמי SaaS |
| Better Stack | תגובה לאירועים / עמודי סטטוס | 10 מוניטורים | הסלמות, ניתוב | 5–10 דק' | Cloud | ניטור + on-call + status page |
| Prometheus + Grafana | סטאק מדדים בקוד פתוח | ללא הגבלה (self-host) | קיבוץ של Alertmanager | 1–4 שעות | Self-hosted/cloud | עומק אקוסיסטם PromQL |
| New Relic | APM + בדיקות API ב-SaaS | 100 GB לחודש, משתמש אחד | קיבוץ AI, דיכוי flapping | 15–30 דק' | Cloud | APM חזק יחד עם synthetics |
| Moesif | אנליטיקת API / מדדים עסקיים | Free/trial | אנומליות התנהגותיות | 20–45 דק' | Cloud | אנליטיקת התנהגות API לפי לקוח |
| Splunk | לוגים ותאימות לאנטרפרייז | ניסיון | episodes של ITSI, AIOps | ימים+ | Cloud/self-managed | חיפוש לוגים וניהול בארגונים |
| Postman | צוותים שכבר בודקים APIs | חשבון חינמי | התראות monitor בסיסיות | 10 דק' | Cloud | reuse של API test collections |
איך Thunderbit יכול להאיץ את הערכת כלי ה-API שלכם
גילוי נאות: Thunderbit הוא לא כלי ניטור API — הוא agentic web scraper ו-Open API להפיכת דפי אינטרנט ל-Markdown נקי או ל-JSON מובנה. זה הופך אותו לשימושי בחלק אחר של תהליך קבלת ההחלטה על כלי ניטור: איסוף מחירי ספקים, מגבלות תוכניות, טענות לפיצ'רים, פרטי תיעוד ורשימות אינטגרציה לפני בחירת הפלטפורמה.
במקום לפתוח ידנית יותר מ-10 עמודי תמחור של ספקים, להעתיק שמות תוכניות, מגבלות מוניטורים, מרווחי בדיקה, אינטגרציות ודרישות לכרטיס אשראי לגיליון, השתמשנו ב-Thunderbit Chrome Extension כדי לחלץ נתונים מובנים מכל עמודי התמחור והפיצ'רים. ה-AI של Thunderbit קורא כל עמוד ומציע שדות — שם התוכנית, פרטי free tier, מחיר בתשלום, אינטגרציות נתמכות — ואז מבנה את הפלט לגיליון שניתן לייצוא.
ל-workflows של מפתחים, Thunderbit Open API נותן לכם את אותו רעיון בצורה פרוגרמטית. השתמשו ב-Distill כשאתם רוצים Markdown נקי ל-LLMs או ל-RAG. השתמשו ב-Extract כשאתם צריכים שדות ספציפיים ב-JSON. השתמשו ב-Batch כשאתם צריכים לעבד רשימה של עמודי תמחור, URLs של תיעוד, עמודי מוצרים או עמודי מתחרים ולקבל תוצאות באופן אסינכרוני.
ה-workflow:
- פותחים עמוד תמחור של ספק (Datadog, Checkly, UptimeRobot וכו')
- לוחצים "One Click Extract" — ה-AI של Thunderbit קורא את העמוד, מבין את המבנה שלו וממלא טבלה בבת אחת
- משתמשים ב-subpage scraping כדי להגיע לעמודי התמחור, הפיצ'רים והתיעוד של כל ספק
- מייצאים ל-Google Sheets, Excel, Airtable, Notion או CSV
עבור צוותים שעובדים API-first, ה-workflow של ה-API ישיר לא פחות:
- מקבלים API key חינמי מ-Thunderbit
- קוראים ל-endpoint של Distill כדי לקבל Markdown נקי מכל עמוד ציבורי
- קוראים ל-endpoint של Extract עם תיאורי סכימה כדי לקבל JSON מובנה
- משתמשים ב-endpoints של Batch וב-webhooks עבור רשימות URLs גדולות יותר
- שולחים את הפלט לאפליקציה, לגיליון, למחסן נתונים, ל-vector database או ל-workflow ניטור
להשוואה של יותר מ-10 ספקים, העתקה-הדבקה ידנית יכולה בקלות לקחת 2–3 שעות, כשמוסיפים עמודי תמחור משנה, תיעוד ועמודי אינטגרציות. Thunderbit קיצר את חילוץ הסבב הראשון לכ-15–30 דקות, והזמן שנותר הוקדש לאימות ולשיקול דעת. אם צוות התפעול, הרכש, המחקר או מוצר ה-AI שלכם מעריך כלים תחת לחץ זמן, זה קיצור דרך פרקטי. אפשר לקרוא עוד על סוג כזה של workflow במדריך שלנו על web scraping ללא קוד, לעיין ב-תמחור ה-API של Thunderbit, או לבדוק את ערוץ YouTube שלנו להדגמות.
איך לבחור את כלי ניטור ה-API הטוב ביותר לצוות שלכם
הכלי "הטוב ביותר" תלוי בגודל הצוות, בעומק הטכני, בתקציב ובאיך כשל נראה עבור המוצר שלכם.
מפתח יחיד לא צריך Splunk. ארגון מפוקח לא צריך להסתמך על cron job. צוות מוצר API אולי צריך יותר אנליטיקה על לקוחות כמו Moesif מאשר pings של uptime. צוות e-commerce צריך לתת עדיפות לבדיקות מסלול קריטי של התחברות, חיפוש, הוספה לעגלה, צ'קאאוט ואישור תשלום. צוות AI או מוצר נתונים עשוי להזדקק קודם לחילוץ נתוני רשת בסגנון Thunderbit לפני שהוא צריך observability מלאה.
שלושה עקרונות שעמדו בכל המחקר שלי:
- להתאים את הכלי לשימוש. טבלת הבחירה המהירה קיימת מסיבה טובה — התחילו שם.
- להעדיף איכות התראות על כמות התראות. אם הצוות מתעלם מהתראות, אין לכם ניטור. יש לכם רעש.
- לא להמעיט בחשיבות מהירות ההקמה. מוניטור שעולה היום ושולח התראות אמינות עדיף על תוכנית פלטפורמה מושלמת שמשאירה את הצ'קאאוט לא מנוטר עוד חודש.
אם אתם משווים כמה כלים במקביל ורוצים להאיץ את המחקר, נסו את Thunderbit כדי לחלץ בכמות גדולה נתוני ספקים לגיליון אחד. אם אתם בונים מוצר API, צינור RAG, agent AI או workflow של אינטליגנציה שיווקית שצריך נתוני רשת נקיים, התחילו עם Thunderbit Open API. הוא לא יבחר עבורכם את כלי הניטור — אבל הוא יוביל אתכם להחלטה מהר יותר, והוא גם יכול לתת למוצר שלכם שכבת נתוני רשת אמינה.
שאלות נפוצות על כלי ניטור API הטובים ביותר
מהו כלי ניטור ה-API החינמי הטוב ביותר ב-2026?
למי שמחפש פשטות SaaS, UptimeRobot מציע 50 מוניטורים בחינם באינטרוולים של 5 דקות, בלי צורך בכרטיס אשראי. למי שרוצה שליטה ב-self-hosted, Uptime Kuma הוא קוד פתוח, ללא הגבלה, ויש לו UI נקי ויותר מ-90 שירותי התראה. לצוותים שרוצים עומק מדדים וכבר יש להם מיומנות טכנית, Prometheus + Grafana + Alertmanager הוא הסטאק הפתוח הטוב ביותר — אבל ההקמה לוקחת שעות, לא דקות.
אם המטרה שלכם היא לא ניטור uptime אלא חילוץ נתוני רשת דרך API, ל-Thunderbit Open API יש free tier עם 600 יחידות API חד-פעמיות, שמספיק כדי לבדוק distillation של עמוד ל-Markdown או חילוץ JSON מבוסס סכימה לפני שמתרחבים.
מה ההבדל בין ניטור API ל-APM?
ניטור API בודק זמינות endpoint, זמן תגובה, שגיאות ותקינות מבחוץ — הוא מדמה את מה שמשתמש או אינטגרציה חווים. APM (Application Performance Monitoring) נכנס עמוק יותר לתוך האפליקציה: traces ברמת קוד, שאילתות מסד נתונים, שגיאות runtime, latency בתורים ותלויות שירות. כלים כמו Datadog ו-New Relic מציעים את שניהם; UptimeRobot ו-Uptime Kuma מתמקדים בבדיקות זמינות חיצוניות.
Thunderbit Open API שונה משניהם: זהו API לחילוץ נתוני רשת. הוא עוזר לכם להפוך אתרים חיצוניים ל-Markdown או ל-JSON מובנה, שימושי עבור אפליקציות LLM, workflows מחקריים, אינטליגנציה על תמחור וצינורות נתונים.
באיזו תדירות כדאי לנטר את ה-APIs שלי?
APIs קריטיים להכנסות בייצור, כמו checkout, auth ותשלומים, בדרך כלל צריכים להיבדק כל דקה. APIs פנימיים או בעלי תנועה נמוכה אפשר לעיתים לבדוק כל 5 דקות. אבל התדירות לבדה אינה הסיפור המלא — השתמשו ב-retries, בכמה אזורים גאוגרפיים וב-assertions משמעותיות כדי שכל בדיקה תהיה גם מהירה וגם אמינה. בדיקה כל דקה שיוצרת false alarms גרועה יותר מבדיקה כל 5 דקות שאפשר לסמוך עליה.
ב-workflows של חילוץ נתוני רשת, התדירות תלויה בקצב השינוי של המקור. עמודי תמחור עשויים לדרוש חילוץ יומי או שבועי. נתוני מלאי, נסיעות או marketplace שמשתנים מהר עשויים לדרוש רענון שעתי או תכוף יותר. ה-Batch API וה-webhooks של Thunderbit שימושיים כשצריך לעבד הרבה URLs לפי לוח זמנים.
האם אפשר לנטר APIs בלי לכתוב קוד?
כן. UptimeRobot, Better Stack ו-Uptime Kuma אפשר להשתמש בהם לגמרי דרך GUI. Checkly תומך גם ב-GUI וגם בהקמה מבוססת קוד. Postman משתמש בממשק מבוסס collections. Prometheus/Grafana בדרך כלל דורשים YAML ו-PromQL. Datadog ו-New Relic יכולים להתחיל דרך setup מונחה, אבל הופכים חזקים יותר עם instrumentation עמוקה.
אם אתם רוצים לחלץ נתוני אתר בלי לכתוב קוד, התוסף של Thunderbit ל-Chrome הוא המסלול ללא קוד. אם אתם רוצים לאוטומט את אותו workflow מתוך אפליקציה, Thunderbit Open API נותן למפתחים endpoints של Distill, Extract ו-Batch.
איך מפחיתים עייפות מהתראות מניטור API?
בחרו כלים עם התראות חכמות: זיהוי אנומליות (Datadog, New Relic), retry-before-firing (Checkly), אנומליות התנהגותיות (Moesif), או קיבוץ/השתקה (Prometheus Alertmanager). התחילו עם פחות התראות, אבל כאלה שיש בהן יותר ביטחון, וממוקדות בהשפעה על המשתמש. השתמשו ב-SLO burn-rate alerts במקום ספים סטטיים, מנעו כפילויות בין שירותים, ניתבו לפי בעלות, ומדדו actionability — אם פחות מ-20% מההתראות מובילות לפעולה אמיתית, צמצמו רעש קודם.
נסו את Thunderbit Open API לחילוץ נתוני רשת Get Started Free
למידע נוסף



