Extracteur Tumblr









Débloquez les données Tumblr avec Thunderbit
Extrayez facilement des données Tumblr comme le contenu des posts et le nombre de mentions J’aime.
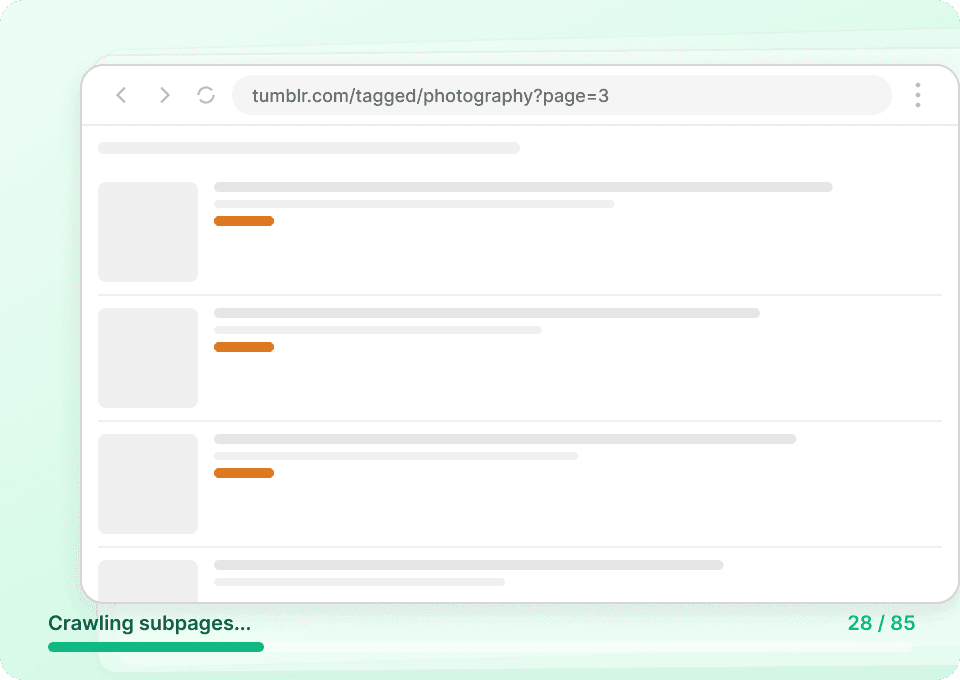
Obtenez l’histoire complète de Tumblr
Les صفحات de liste Tumblr n’affichent que des extraits. Pour obtenir une vision complète, vous avez besoin du contenu intégral des publications, des détails de l’auteur et de toutes les métadonnées associées. Thunderbit visite automatiquement chaque page de publication liée, extrait toutes les informations complètes et les ajoute dans de nouvelles colonnes — afin que vous puissiez capturer les ID des posts, les dates de publication et bien plus encore, sans aucun clic manuel.
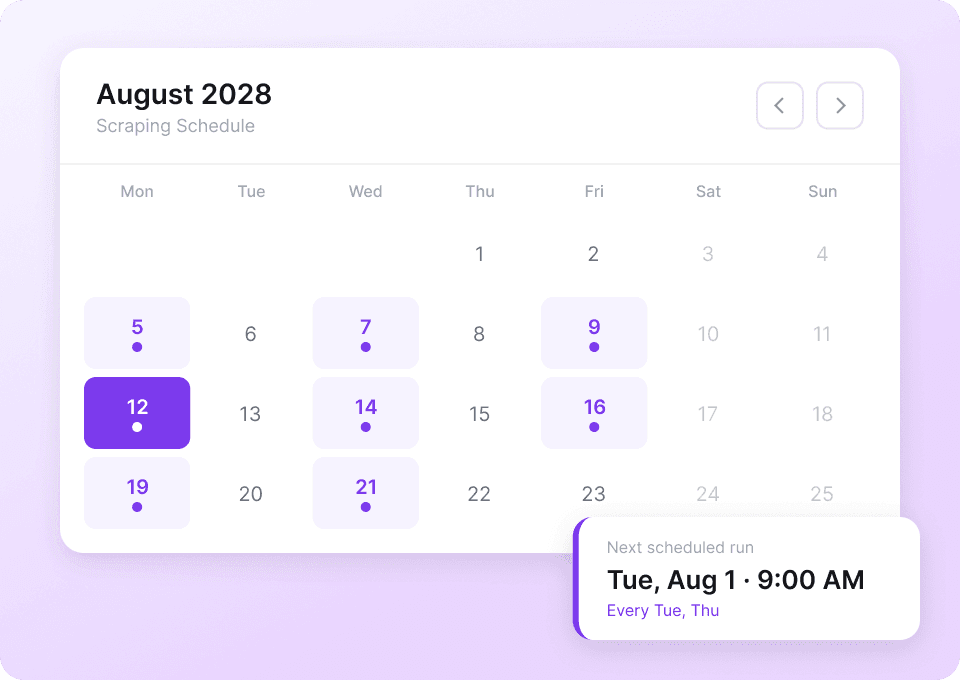
Automatisez votre collecte de données Tumblr
Les données Tumblr changent en permanence. Revenir manuellement sur les mêmes blogs pour relancer une extraction est fastidieux et source d’erreurs. Avec le scraping programmé de Thunderbit, vous pouvez configurer des extractions récurrentes en pilote automatique. Recevez de nouveaux nombres de mentions J’aime et du contenu de posts directement dans Google Sheets — sans aucun travail manuel.
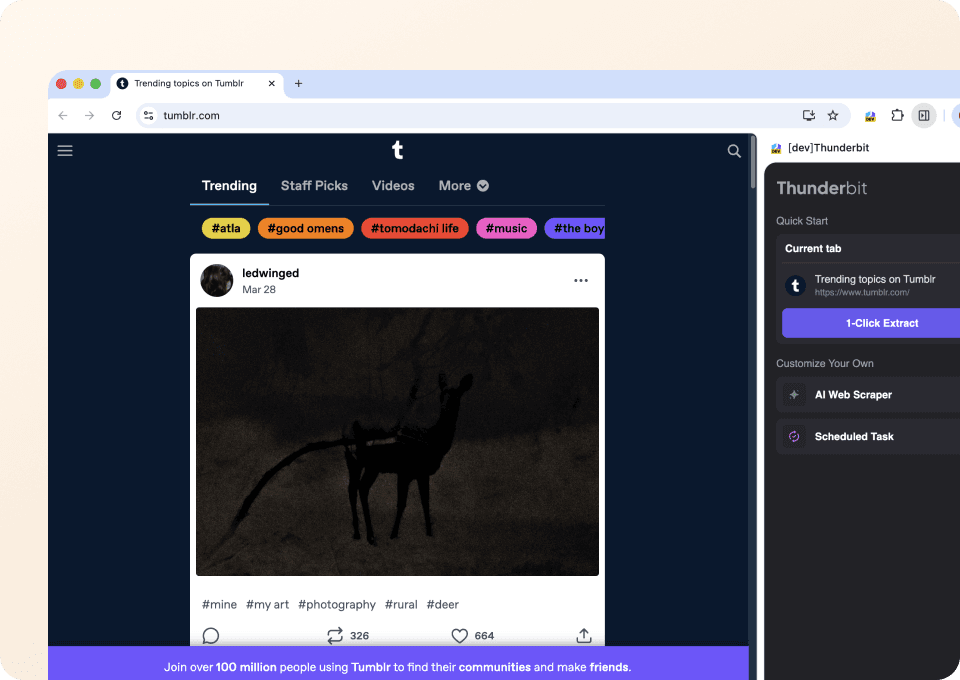
Scrapez les posts Tumblr en deux clics
Aucun code ni sélecteur CSS nécessaire. Thunderbit vous permet d’extraire des données Tumblr en seulement deux clics. Il suffit de pointer sur ce que vous voulez — type de post, auteur, contenu, nombre de mentions J’aime — et l’IA sémantique de Thunderbit détecte les champs pertinents et extrait tout automatiquement.
En quoi Thunderbit est-il différent des scrapers Tumblr traditionnels ?
Extrayez les données Tumblr sans effort, même lorsque les mises en page changent ou évoluent de façon inattendue.
Scrapers traditionnels
L’ancienne méthodeThunderbit IA
L’approche la plus intelligenteNe vous fiez pas qu’à notre parole
Découvrez ce que nos utilisateurs disent de Thunderbit.
Questions fréquentes
Associé cas d'utilisation
Explorez d'autres cas d'utilisation de l'extracteur web de Thunderbit.
Extracteur Minds
L’Extracteur Minds de Thunderbit vous permet de récupérer facilement les données des fils d’actualité et des membres de groupes sur Minds grâce à des suggestions de champs intelligentes basées sur l’IA. Collectez les titres de posts, noms d’auteurs, likes, commentaires et informations sur les membres pour vos besoins en recherche, marketing ou analyse de communauté. Exportez rapidement des données structurées de Minds en toute simplicité.
En savoir plus ->
Extracteur MeWe
L’Extracteur MeWe de Thunderbit vous permet d’extraire facilement les données des profils utilisateurs et des publications de groupes MeWe grâce à des suggestions de champs intelligentes par IA. Rassemblez noms de profils, biographies, dates d’inscription, contenus de posts, likes et commentaires pour vos besoins en recherche, marketing ou analyse. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données MeWe structurées.
En savoir plus ->
Extracteur Parler
L’Extracteur Parler de Thunderbit vous permet de récupérer des données issues des résultats de recherche et des listes de hashtags sur Parler, grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez des termes de recherche, publications d’utilisateurs, hashtags, scores de popularité et bien plus, pour vos besoins en recherche, marketing ou analyse de contenu. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données structurées de Parler.
En savoir plus ->
Extracteur d'Élément
L’Extracteur Element de Thunderbit vous permet de collecter facilement les données des salles d’administration Synapse sur Element grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez les identifiants de messages, noms d’expéditeurs, horodatages, contenus et pièces jointes pour vos analyses ou votre veille. Parfait pour les développeurs, responsables de communauté et chercheurs souhaitant obtenir des données structurées depuis Element.
En savoir plus ->
Extracteur Odnoklassniki
L’Extracteur Odnoklassniki de Thunderbit vous permet de collecter facilement des données issues des groupes et listes de jeux Odnoklassniki grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez les noms de groupes, descriptions, effectifs, informations sur les jeux, notes et bien plus encore pour vos besoins en recherche, marketing ou analyse. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données Odnoklassniki structurées.
En savoir plus ->
Extracteur Triller
L’Extracteur Triller de Thunderbit vous permet de récupérer les données des pages de blog et des profils de créateurs collectifs sur Triller. Grâce aux suggestions intelligentes de champs, rassemblez rapidement les titres d’articles, dates de publication, noms d’auteurs, biographies de créateurs et nombre d’abonnés pour vos besoins en recherche, marketing ou analyse.
En savoir plus ->Prêt à booster votre extraction de données ?
Rejoignez plus de 200 000 professionnels qui utilisent déjà Thunderbit pour automatiser leurs workflows d'extraction web.
L’essai gratuit offre des crédits illimités pour 8 pages web.



