Extracteur Medium









Extrayez les données Medium sans effort avec Thunderbit
S’adapte aux mises en page de Medium qui évoluent en permanence
Marre des extracteurs qui cassent à chaque changement de design sur Medium ? Thunderbit lit le sens de chaque champ — titres d’articles, noms d’auteurs, nombre de claps — au lieu de se baser uniquement sur des sélecteurs CSS figés. Il s’adapte automatiquement aux changements de mise en page, pour que vos tâches de scraping continuent sans maintenance constante.
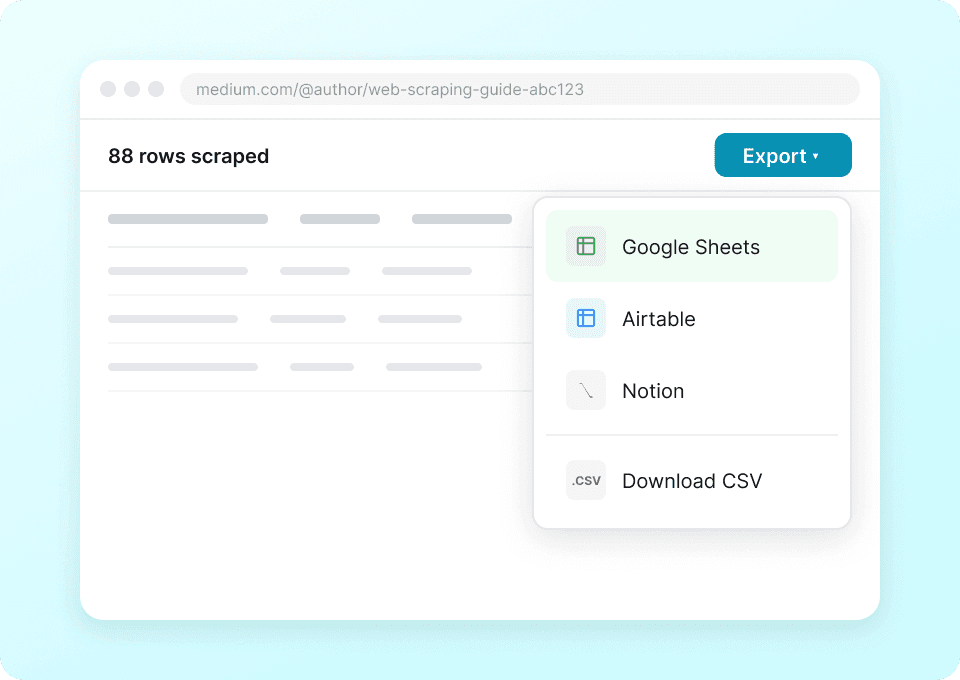
Envoyez les données Medium là où vous en avez besoin
N’ayez plus à copier-coller manuellement vos données Medium dans des feuilles de calcul. Thunderbit exporte en un clic vos articles, statistiques d’auteurs et données de publication directement vers Google Sheets, Notion, Airtable ou Excel. Passez moins de temps à manipuler les données, et plus de temps à les exploiter.
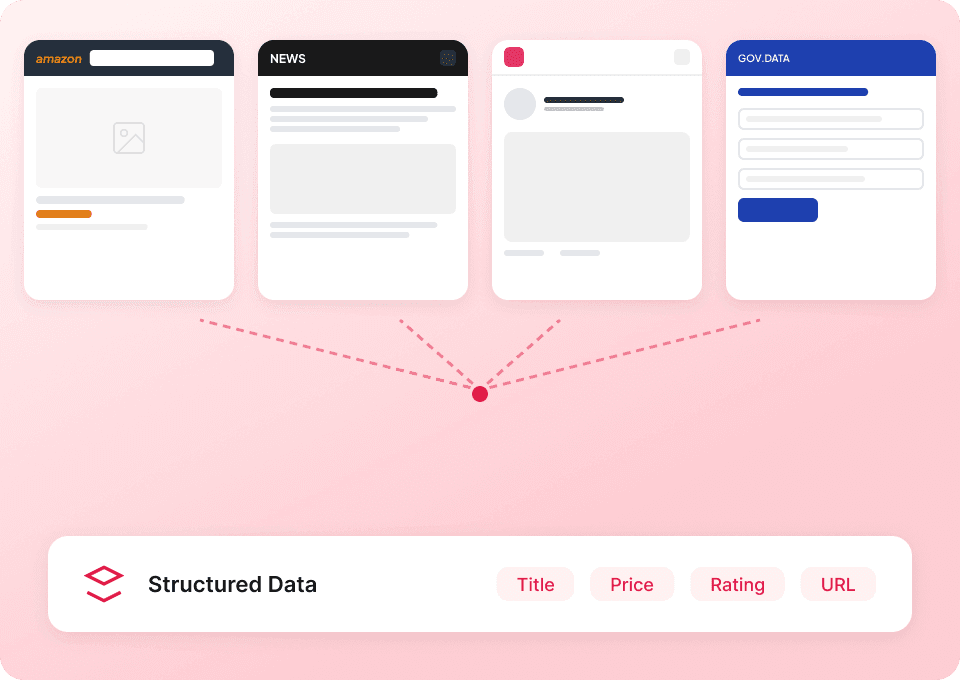
Un seul extracteur pour Medium et bien plus encore
Pourquoi jongler entre plusieurs outils quand un seul peut tout gérer ? Thunderbit fonctionne sur Medium et sur pratiquement n’importe quel autre site. Avec plus de 50 modèles prêts à l’emploi et la possibilité d’extraire n’importe quel site dès l’installation, vous en faites davantage avec un seul outil polyvalent.
Fatigué de vous battre avec la mise en page de Medium ?
Arrêtez de lutter avec des extracteurs cassés. Thunderbit s’adapte automatiquement à Medium.
Extracteurs traditionnels
L’ancienne manière de faireThunderbit
L’approche la plus intelligenteNe vous fiez pas qu’à notre parole
Découvrez ce que nos utilisateurs disent de Thunderbit.
Questions fréquemment posées
Associé cas d'utilisation
Explorez d'autres cas d'utilisation de l'extracteur web de Thunderbit.
Extracteur Minds
L’Extracteur Minds de Thunderbit vous permet de récupérer facilement les données des fils d’actualité et des membres de groupes sur Minds grâce à des suggestions de champs intelligentes basées sur l’IA. Collectez les titres de posts, noms d’auteurs, likes, commentaires et informations sur les membres pour vos besoins en recherche, marketing ou analyse de communauté. Exportez rapidement des données structurées de Minds en toute simplicité.
En savoir plus ->
Extracteur MeWe
L’Extracteur MeWe de Thunderbit vous permet d’extraire facilement les données des profils utilisateurs et des publications de groupes MeWe grâce à des suggestions de champs intelligentes par IA. Rassemblez noms de profils, biographies, dates d’inscription, contenus de posts, likes et commentaires pour vos besoins en recherche, marketing ou analyse. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données MeWe structurées.
En savoir plus ->
Extracteur Parler
L’Extracteur Parler de Thunderbit vous permet de récupérer des données issues des résultats de recherche et des listes de hashtags sur Parler, grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez des termes de recherche, publications d’utilisateurs, hashtags, scores de popularité et bien plus, pour vos besoins en recherche, marketing ou analyse de contenu. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données structurées de Parler.
En savoir plus ->
Extracteur d'Élément
L’Extracteur Element de Thunderbit vous permet de collecter facilement les données des salles d’administration Synapse sur Element grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez les identifiants de messages, noms d’expéditeurs, horodatages, contenus et pièces jointes pour vos analyses ou votre veille. Parfait pour les développeurs, responsables de communauté et chercheurs souhaitant obtenir des données structurées depuis Element.
En savoir plus ->
Extracteur Odnoklassniki
L’Extracteur Odnoklassniki de Thunderbit vous permet de collecter facilement des données issues des groupes et listes de jeux Odnoklassniki grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez les noms de groupes, descriptions, effectifs, informations sur les jeux, notes et bien plus encore pour vos besoins en recherche, marketing ou analyse. Parfait pour les professionnels du marketing, les chercheurs et les entreprises souhaitant obtenir des données Odnoklassniki structurées.
En savoir plus ->
Extracteur Triller
L’Extracteur Triller de Thunderbit vous permet de récupérer les données des pages de blog et des profils de créateurs collectifs sur Triller. Grâce aux suggestions intelligentes de champs, rassemblez rapidement les titres d’articles, dates de publication, noms d’auteurs, biographies de créateurs et nombre d’abonnés pour vos besoins en recherche, marketing ou analyse.
En savoir plus ->Prêt à booster votre extraction de données ?
Rejoignez plus de 200 000 professionnels qui utilisent déjà Thunderbit pour automatiser leurs workflows d'extraction web.
L’essai gratuit offre des crédits illimités pour 8 pages web.



