Raspador de TechCrunch













Desbloquea los datos de TechCrunch en dos clics
Raspado sencillo de TechCrunch en dos clics
Copiar manualmente títulos, autores, fechas de publicación o el contenido completo de artículos de TechCrunch es tedioso. Thunderbit te permite olvidarte por completo del trabajo manual. Solo señala los datos que necesitas y la IA se encarga del resto. Con dos clics, estarás extrayendo datos estructurados sin escribir una sola línea de código ni lidiar con configuraciones complicadas.
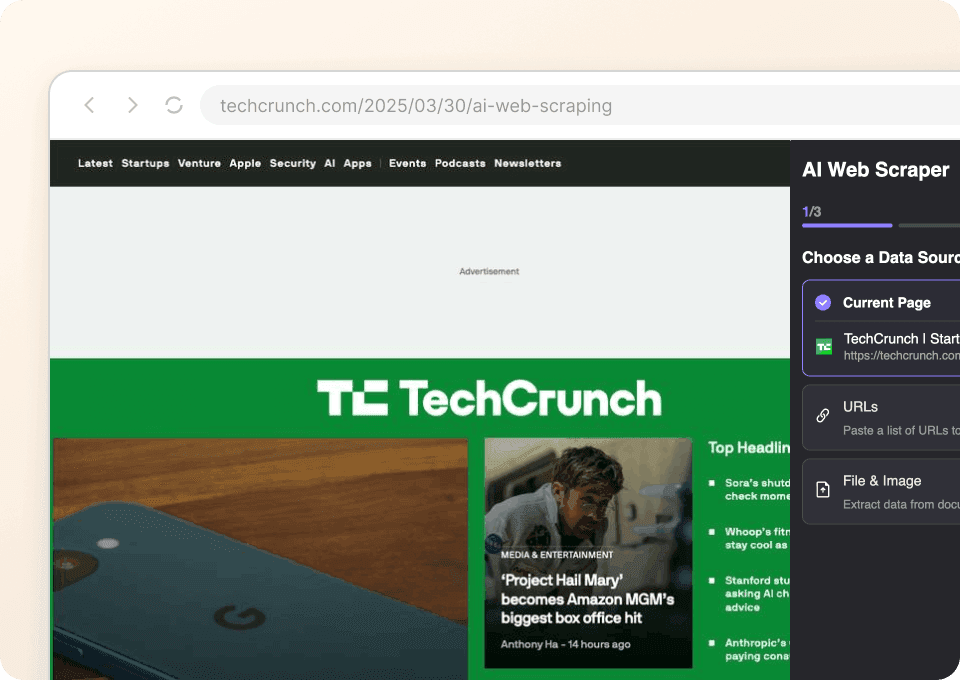
Obtén datos limpios de TechCrunch al instante
Extraer HTML en bruto de TechCrunch no te lleva a ninguna parte: necesitas datos limpios y estructurados. Thunderbit limpia y formatea automáticamente los datos mientras los extrae, para que puedas analizar de inmediato categorías de artículos, seguir autores o comparar fechas de publicación. Exporta directamente a Google Sheets, Notion o Airtable y empieza a trabajar con datos organizados al instante, sin limpieza manual.

Extrae datos de cualquier sitio, no solo de TechCrunch
¿Por qué aprender una herramienta nueva para cada sitio web? Thunderbit funciona en prácticamente cualquier página, incluido TechCrunch. Con más de 50 plantillas prediseñadas, puedes empezar todavía más rápido. Ya sea que estés recopilando contenido de artículos, perfiles de autores o etiquetas de publicación, Thunderbit es tu solución única para la extracción de datos web en toda la web.
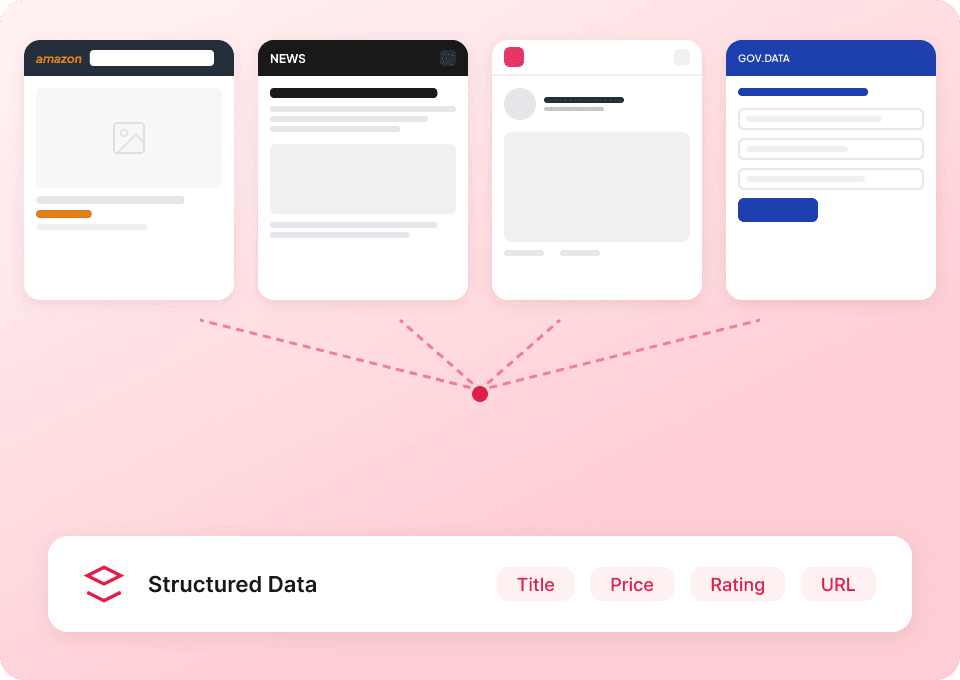
¿Te cuesta extraer datos de TechCrunch de forma eficaz?
Mira cómo Thunderbit simplifica la extracción de datos de TechCrunch frente a los métodos tradicionales.
Raspadores tradicionales
La forma de hacerlo de siempreThunderbit
El enfoque más inteligenteNo te quedes solo con nuestra palabra
Mira lo que nuestros usuarios dicen sobre Thunderbit.
Preguntas frecuentes
Relacionados casos de uso
Explora más casos de uso del web scraper de Thunderbit.

Raspador de 4PDA
El Raspador Web 4PDA de Thunderbit te permite extraer datos de artículos de noticias y publicaciones de foros en 4PDA utilizando IA. Recopila rápidamente títulos de artículos, fechas de publicación, autores y contenido de publicaciones para investigación, análisis o seguimiento de debates tecnológicos. Perfecto para entusiastas de la tecnología, investigadores y profesionales de marketing que buscan datos estructurados de 4PDA.
Saber más ->
Raspador de Ptt
El Raspador Web de Ptt de Thunderbit te permite extraer información de foros y publicaciones de Ptt con sugerencias inteligentes impulsadas por IA. Recopila nombres de foros, enlaces, popularidad, títulos de publicaciones, autores y comentarios para investigación, marketing o análisis de contenido. Perfecto para profesionales de marketing, investigadores y creadores de contenido que buscan datos estructurados de Ptt.
Saber más ->
Raspador de Mercado de Pizza
El Raspador Web de Pizza Marketplace de Thunderbit te permite extraer datos de los listados de noticias y directorios de proveedores de Pizza Marketplace. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de noticias, fechas de publicación, autores, nombres de proveedores, ubicaciones y datos de contacto para investigación, marketing o análisis.
Saber más ->
Raspador de Failory
El Raspador Failory de Thunderbit te permite extraer datos estructurados del cementerio de startups y artículos de noticias de Failory. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar nombres de startups, años, causas de fracaso, títulos de artículos, autores y mucho más para tus investigaciones o análisis. Perfecto para emprendedores, inversores e investigadores que buscan información valiosa de Failory.
Saber más ->
Raspador de Investing.com
Extrae datos bursátiles — símbolos, precios, volumen y capitalización de mercado — de Investing.com en 2 clics y expórtalos directamente a Google Sheets, Notion o Excel. Abre cualquier página de Investing.com y deja que la IA identifique los campos por ti.
Saber más ->
Raspador de Substack
Extrae en 2 clics el número de suscriptores de Substack, títulos de artículos y descripciones de publicaciones — y luego expórtalos a Excel, Google Sheets o Notion. No necesitas programar; la IA de Thunderbit se encarga de estructurarlo todo por ti.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.



