
TripAdvisor reúne más de mil millones de reseñas repartidas en millones de fichas — hoteles, restaurantes, atracciones, tours — y casi cualquier negocio del sector hospitality con el que hablo quiere aprovechar esos datos. ¿El problema? La protección anti-bots DataDome de TripAdvisor lo convierte en uno de los sitios más fastidiosos de internet para hacer scraping.
Llevo años creando herramientas en Thunderbit para ayudar a equipos no técnicos a extraer datos web sin programar, y TripAdvisor es uno de los sitios que más nos piden nuestros usuarios. Las quejas son siempre las mismas: captchas que saltan después de dos páginas, scripts que dejan de funcionar de un día para otro, proxies que se comen el presupuesto.
Por eso preparé esta comparativa de 8 scrapers de TripAdvisor que de verdad rinden en 2026 — evaluados por facilidad de uso, manejo anti-bot, precios, formatos de exportación y tipos de datos compatibles. Tanto si eres un comercial armando una lista de leads de hoteles como si eres un analista de datos haciendo análisis de sentimiento sobre 10.000 reseñas, aquí hay una herramienta que encaja.
Prueba Thunderbit para extraer datos de TripAdvisor
¿Por qué extraer datos de TripAdvisor en 2026?
TripAdvisor no es solo una web de reseñas. Es una base de datos estructurada de la industria global del turismo y la hostelería, y los datos que muestra tienen muchísimo valor comercial para montones de casos de uso.
Los hoteles muestran precios, valoraciones, servicios, tipos de habitación y subpuntuaciones por categoría (limpieza, servicio, relación calidad-precio, calidad del sueño). Los restaurantes exponen tipo de cocina, rango de precios, platos del menú, horarios y etiquetas por tipo de comida. Las atracciones muestran precios de entradas, consejos para visitantes, duración estimada y, más recientemente, resúmenes de reseñas generados por IA que agrupan opiniones por temas.
En la encuesta propia de Tripadvisor sobre compradores de hoteles, el 76% dijo que prefiere reseñas largas al reservar alojamiento, y la parte que más les importaba era el contenido, con un 40%. Eso significa que el texto narrativo — no solo la puntuación — es donde está la inteligencia de verdad.
Aquí tienes un vistazo rápido de lo que suelen buscar distintos equipos en TripAdvisor:
| Caso de uso | Datos necesarios |
|---|---|
| Seguimiento de precios de la competencia | Precios de hoteles, valoraciones, servicios |
| Seguimiento de reputación de marca | Texto de reseñas, sentimiento, subpuntuaciones |
| Generación de leads (ventas hoteleras) | Nombre del negocio, email, teléfono, dirección |
| Investigación de mercado de restaurantes | Tipo de cocina, rango de precios, platos del menú, reseñas |
| Investigación académica/de viajes | Valoraciones de atracciones, consejos para visitantes, precios de entradas |
| Investigación para copy de marketing | Lenguaje real de clientes en las reseñas |
La trampa es que no todos los scrapers manejan TripAdvisor igual. Las defensas anti-bot del sitio son tan agresivas que muchas herramientas fallan en silencio: devuelven datos incompletos, se bloquean tras unas pocas páginas o requieren tanta configuración de proxies que la promesa de "sin código" se desinfla.
El problema de DataDome: por qué TripAdvisor es uno de los sitios más difíciles de scrapear
Si alguna vez intentaste hacer scraping en TripAdvisor y te apareció un captcha tipo rompecabezas deslizante después de dos páginas, acabas de topar con DataDome — el servicio anti-bots que TripAdvisor usa para detectar y bloquear accesos automatizados, y la verdad es que hace bien su trabajo. No se limita a revisar tu IP: analiza huellas del navegador (versión, tamaño de pantalla, fuentes instaladas), huellas de hardware (GPU y CPU), cómo resuelves los desafíos de JavaScript y tu comportamiento (la velocidad a la que haces scroll, si el movimiento del ratón parece humano), todo eso además de límites de tasa. Un script básico de Python con requests — o incluso un navegador sin interfaz — se bloquea casi al momento.
Cada vez que alguien nos pregunta por TripAdvisor, salen dos dudas: por qué llega tan rápido el bloqueo y si hay alguna forma de evitarlo sin pagar proxies y un solucionador de captchas.
La respuesta honesta depende de la escala. Para unas pocas páginas, una extensión de Chrome ejecutándose en tu sesión real del navegador puede esquivar la mayoría de las detecciones porque parece un usuario normal. Para miles de páginas, necesitas infraestructura: proxies rotativos, solucionadores de captchas o una herramienta que integre todo eso por detrás.
Así comparan las 8 herramientas de este artículo en manejo anti-bot, además de un script de Python hecho a medida como referencia:
| Enfoque anti-bot | Herramientas | Esfuerzo de configuración | Coste continuo |
|---|---|---|---|
| Integrado (la herramienta lo gestiona) | Thunderbit (Cloud), Apify, Bright Data, ScrapFly, ScrapeHero, WebAutomation.io | Bajo | Incluido en el plan |
| Integrado, pero medido | Octoparse | Medio | Standard cubre proxies y resolución de captchas; después del crédito adicional del plan, las recargas cuestan 3 $/GB y 1–1,5 $ por 1.000 soluciones |
| Sin protección integrada | Instant Data Scraper, Python DIY | Ninguno para Instant Data Scraper, alto para DIY | 0 $ hasta que te bloquean; DIY añade proxies y solucionadores de captcha |
Thunderbit ofrece dos modos aquí. Cloud Scraping se ejecuta en los servidores de Thunderbit con gestión anti-bot integrada para páginas públicas. Browser Scraping corre dentro de tu propia sesión de Chrome — como es un navegador real con tus cookies y tu estado de inicio de sesión, puede saltarse algunas detecciones que tumban a los bots sin interfaz. Para la mayoría de casos de uso de TripAdvisor, el modo Cloud es la ruta más rápida.
Qué buscar en los mejores scrapers de TripAdvisor
Antes de entrar en las herramientas, aquí va la rúbrica que usé. Son los criterios que de verdad importan al elegir un scraper de TripAdvisor — no palabras de marketing, sino los factores que determinan si sacarás datos útiles o perderás la tarde.
- Facilidad de uso — ¿No-code, low-code o requiere código completo? Si trabajas en un equipo comercial y necesitas datos en Google Sheets para mañana, no puedes permitirte una configuración de 4 horas.
- Manejo anti-bot de TripAdvisor — ¿La herramienta resuelve DataDome/captchas de forma nativa o tienes que poner tus propios proxies y solucionadores?
- Tipos de datos compatibles — ¿Solo hoteles, o también restaurantes, atracciones y tours? Muchas herramientas solo soportan páginas de hotel.
- Precios y plan gratuito — ¿Cuál es el coste real para, por ejemplo, 10.000 reseñas? ¿Hay créditos gratis o plan free?
- Formatos de exportación — CSV, JSON, Excel, Google Sheets, Airtable, Notion... Cuantos menos pasos haya entre la extracción y la hoja de cálculo, mejor.
- Capacidad de escala — Máximo de reseñas o páginas por ejecución, soporte de paginación y si la herramienta maneja offsets de reseñas estilo
or10de TripAdvisor. - Enriquecimiento de subpáginas — ¿Puede seguir enlaces desde una página de resultados hasta fichas individuales de hoteles o restaurantes para sacar datos más completos?
- Para quién es mejor — ¿Qué perfil de usuario sirve realmente bien esta herramienta?
Si eres desarrollador y vas a montar un pipeline a medida, darás más peso a la flexibilidad de la API y a la infraestructura anti-bot. Si eres un usuario de negocio que solo quiere una hoja de cálculo, las opciones de exportación y la facilidad de uso importan mucho más que cualquier otra cosa.
8 mejores scrapers de TripAdvisor de un vistazo
Aquí tienes las 8 herramientas comparadas lado a lado. La columna de coste refleja lo que realmente pagas en un mes por 10.000 reseñas — el plan mensual más barato, con el descuento de su cuota gratis ya aplicado; la explicación de cada cifra está más abajo.
| Herramienta | Facilidad de uso | Manejo anti-bot | Tipos de datos | Factura mensual (10K reseñas) | Formatos de exportación | Escala | Enriquecimiento de subpáginas | Ideal para |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Sin código (1 clic) | ✅ Integrado (Cloud + Browser) | Hoteles, restaurantes, atracciones, tours | 288 $ pago único (30K créditos); Business si es mensual | Excel, CSV, Sheets, Airtable, Notion | 200 páginas paginadas y 2.000 URLs por ejecución (Pro) | ✅ 1 clic | Equipos no técnicos, ventas, operaciones |
| Apify | Low-code (interfaz de plataforma) | ✅ Integrado | Hoteles, reseñas, restaurantes, atracciones | 29 $/mes (Starter, cualquier actor) | JSON, CSV, Excel, XML, API | Alta (actors en la nube) | ⚠️ Depende del actor | Equipos de datos, desarrolladores |
| Octoparse | Sin código (constructor visual) | ✅ Proxies + resolución de captchas incluidos en el plan | Hoteles, reseñas | 83 $/mes (Standard; facturado por tareas, no por filas) | CSV, Excel, JSON, DB | Ejecución local y en la nube | ⚠️ Requiere configurar el flujo | Fans del scraping visual |
| ScrapFly | Código (SDK/API en Python) | ✅ API integrada | Cualquier página de TripAdvisor | 30 $/mes (Discovery, 200K créditos) | HTML/JSON en bruto (el usuario analiza) | Alta (basado en API) | Programación manual | Desarrolladores Python |
| Bright Data | Low-code a código | ✅ Integrado (más de 400M de proxies) | Hoteles, reseñas, datasets | 7,50 $ pago por uso (después de 5.000 registros gratis) | CSV, JSON, API | Nivel enterprise | ✅ Scraper IDE | Equipos enterprise |
| ScrapeHero | Cero configuración (gestionado) | ✅ Totalmente gestionado | Hoteles, reseñas, restaurantes | Presupuesto personalizado (por sitio, no por fila) | CSV, JSON, Excel, API | Entrega gestionada | ✅ Gestionado | Compradores de datos sin intervención |
| WebAutomation.io | Sin código (preconstruido) | ✅ Incluido en todos los planes | Hoteles (enfocado en datos de contacto) | Desde 1 $ (1.000 créditos, sin suscripción) | CSV, JSON, XML | Moderada | ⚠️ Limitado | Generación de leads (emails, teléfonos) |
| Instant Data Scraper | Sin código (1 clic) | ❌ Ninguno | Cualquier tabla visible | 0 $ (se bloquea tras unas pocas páginas) | CSV, Excel | Pequeña (unas pocas páginas) | ❌ No | Extracciones rápidas y puntuales |
Veredicto rápido: la opción más rápida para equipos no técnicos → Thunderbit. La mejor para extracción masiva de reseñas → Apify. La mejor opción gratis para trabajos pequeños → Instant Data Scraper. La mejor para desarrolladores → ScrapFly. La mejor para enterprise → Bright Data. La mejor para entrega sin intervención → ScrapeHero.
Ahora, vamos al detalle.
1. Thunderbit — mejor scraper de TripAdvisor para equipos no técnicos
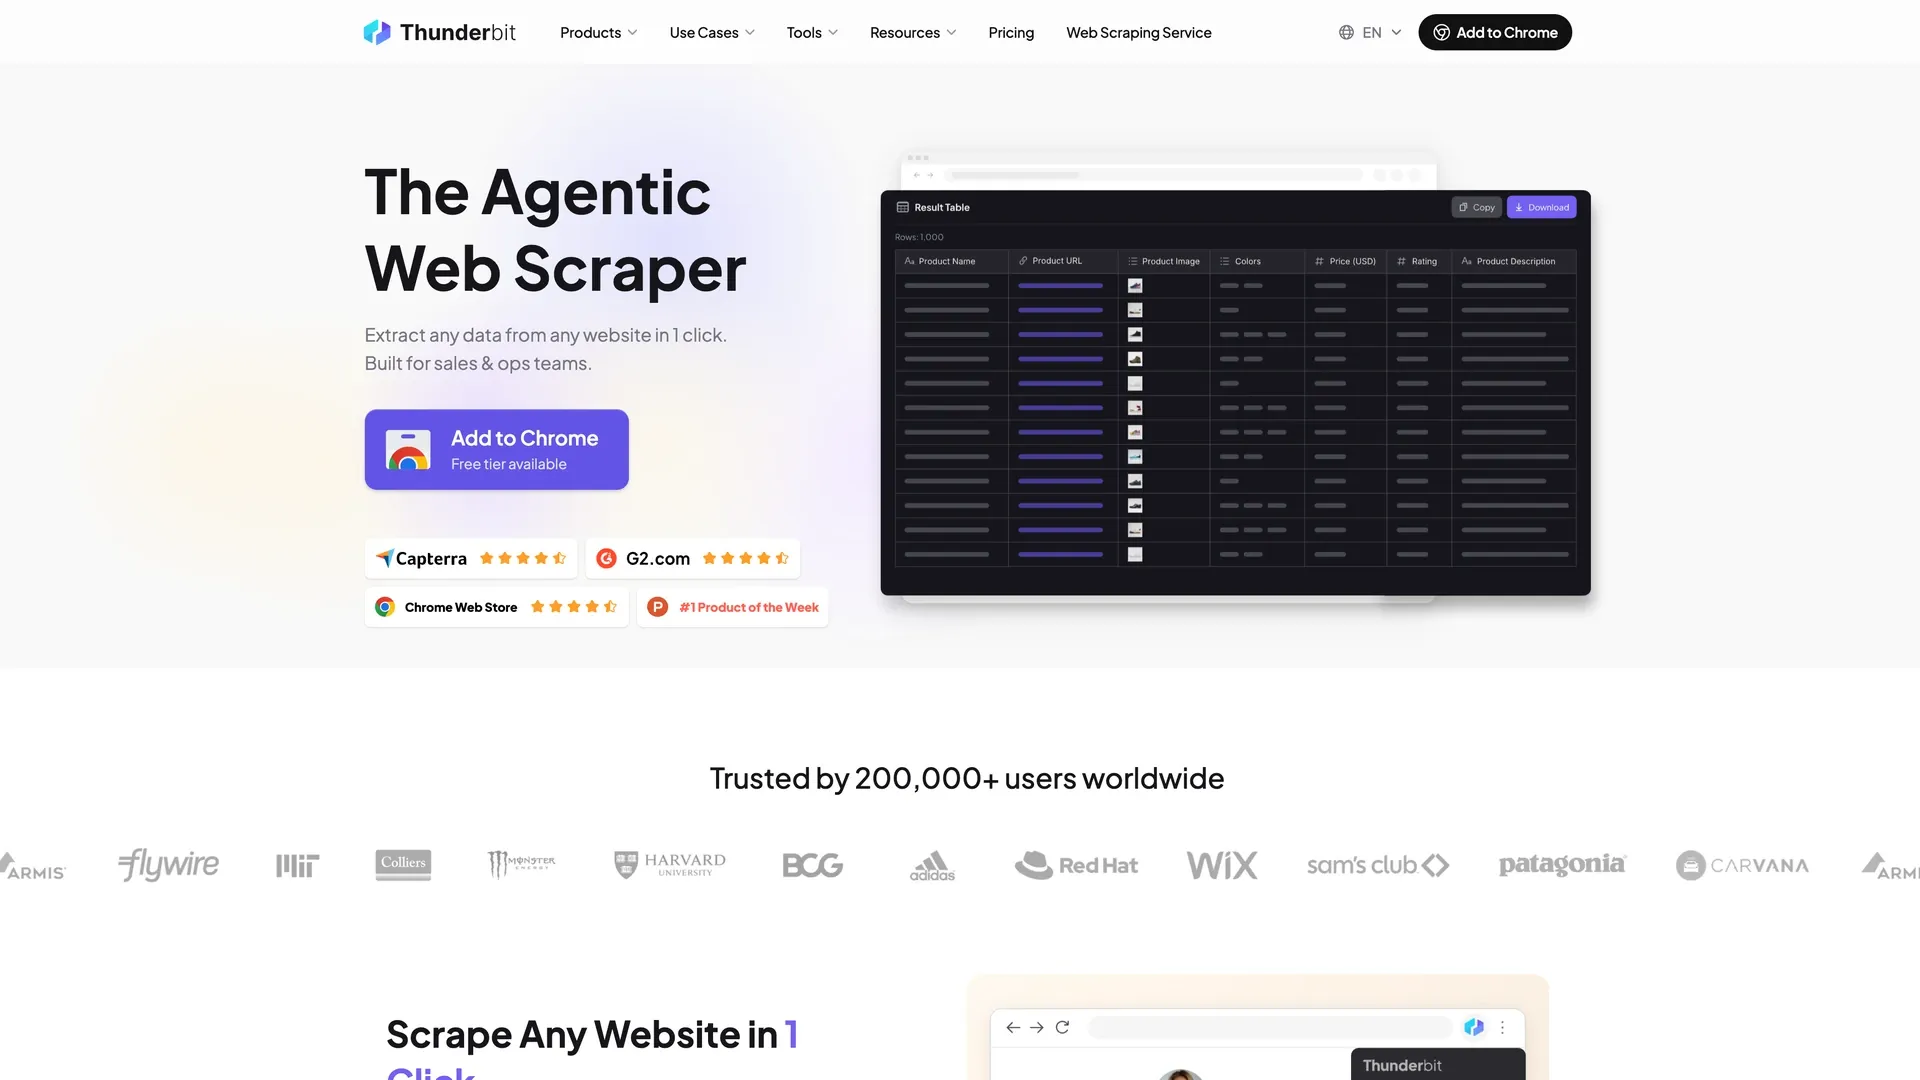 Thunderbit es la extensión de Chrome con IA que mi equipo y yo creamos precisamente para hacer que el scraping web sea accesible para quienes no programan. En TripAdvisor, el flujo es literalmente de un clic: abre una página de hotel, restaurante o atracción y lanza la extensión. La IA lee la página, decide qué campos extraer — nombre del hotel, valoración, precio, número de reseñas, servicios, lo que muestre la página — y empieza a extraerlos. Si quieres otra cosa, solo dilo en lenguaje natural y usará eso en su lugar. En cualquier caso puedes dejarlo funcionando y obtendrás una tabla lista para mandar directamente a Google Sheets, Excel, Airtable o Notion.
Donde Thunderbit realmente brilla en TripAdvisor es en el scraping de subpáginas. Imagina que estás viendo una página de resultados con 30 hoteles. Thunderbit puede extraer la lista y luego seguir automáticamente cada enlace de hotel para sacar campos de la página de detalle — texto completo de reseñas, lista de servicios, información de contacto, rangos de precio, subpuntuaciones por categoría — sin configuración extra. Pulsas un botón y obtienes datos enriquecidos de cada ficha.
Funciona igual con los otros tipos de página. En una página de restaurante obtienes cocina, rango de precios, horario y platos del menú en lugar de servicios del hotel; en una atracción, precios de entradas, duración y consejos de visitantes.
No hay que mantener plantillas por categoría: la IA lee lo que haya en la página. Conviene saber de antemano algunas limitaciones: en Pro una sola ejecución llega como máximo a 200 páginas paginadas y 2.000 URLs, cada fila consume un crédito (dos si está activado el scraping de subpáginas), y el modo Cloud solo funciona en páginas públicas; cualquier cosa detrás de un login debe ejecutarse en modo Browser, que es más lento.
¿Necesitas datos recurrentes? El Scheduled Scraper de Thunderbit se ejecuta semanal o mensualmente — justo lo que necesitan las pequeñas empresas de hostelería para vigilar precios de la competencia o la reputación.
Extrae datos de TripAdvisor con IA Get Started Free
Funciones clave
- Scraping con 1 clic: la IA define las columnas por sí sola o tú dices lo que quieres en una sola línea (se adapta a cualquier tipo de página de TripAdvisor)
- Enriquecimiento de subpáginas con un clic: extrae una lista y luego enriquece la ficha de cada elemento
- Cloud Scraping (rápido, anti-bot integrado) y Browser Scraping (usa tu sesión real de Chrome)
- Scraping programado para monitorización automática semanal o mensual
- Exportación gratuita a Excel, Google Sheets, Airtable, Notion, CSV y JSON
- Extractores gratuitos de email y teléfono para generación de leads
- Compatible con 34 idiomas
Precios
- Plan gratuito: 6 páginas al mes (hasta 30 créditos por página)
- Planes de pago por créditos: 1 crédito por cada fila de salida, 2 si la fila viene de una subpágina. Starter cuesta 15 $/mes por 500 créditos; Pro cuesta 38 $/mes por 3.000 créditos. La facturación anual entrega todos los créditos por adelantado: 108 $/año por 5.000 créditos en Starter, 288 $/año (24 $/mes) por 30.000 en Pro. No existe un nivel autoservicio mayor que Pro; los volúmenes más altos se cotizan como plan Business. Consulta precios de Thunderbit para ver los detalles actualizados.
Ideal para
- Equipos de ventas y operaciones que necesitan datos de TripAdvisor en una hoja de cálculo sin programar
- Pequeñas empresas que monitorizan reseñas de la competencia cada semana
- Equipos de marketing que extraen el lenguaje real de clientes de las reseñas para anuncios y landing pages
Prueba gratis la extensión de Chrome de Thunderbit para ver cómo funciona el flujo de 1 clic en tus propias páginas de TripAdvisor.
2. Apify TripAdvisor Scraper — ideal para extraer reseñas a gran volumen
 Apify es una plataforma de scraping en la nube con un marketplace de "Actors" ya preparados, y hay varios dedicados a TripAdvisor. Los más populares te permiten introducir URLs o búsquedas de TripAdvisor, configurar parámetros (ubicación, tipo de lugar, número de reseñas), ejecutar el actor y descargar los resultados en JSON, CSV o Excel.
La verdadera fortaleza de Apify es el volumen. Si necesitas más de 10.000 reseñas para un proyecto de análisis de sentimiento, los actores de Apify están pensados para eso. El actor API Ninja TripAdvisor cuesta aproximadamente 0,50 $ por cada 1.000 resultados para datos de hoteles, mientras que el actor Crawler Bros cuesta 2,00 $ por cada 1.000 resultados pero incluye respuestas del propietario, votos útiles y metadatos del lugar. Ambos gestionan medidas anti-bot y paginación.
La contrapartida: Apify requiere cierta soltura con su plataforma. No es una extensión de Chrome — trabajas en un panel web, configuras las entradas del actor y esperas a que termine la ejecución en la nube.
Cuenta con unos diez minutos para la primera ejecución: crear la cuenta, elegir un actor, pegar tus URLs y esperar a que el proceso termine en la nube.
Funciones clave
- Actors específicos de TripAdvisor con lógica de extracción ya construida
- Manejo de paginación y medidas anti-bot
- Escalable para conjuntos de datos grandes (10K+ reseñas)
- Acceso API para automatización e integraciones
- Compatible con hoteles, reseñas, restaurantes y atracciones (según el actor)
Precios
- Plan gratuito: 5 $ de uso de la plataforma al mes, sin pago por uso más allá de eso ni descuento de Apify Store
- Precio por resultado: de ~$0,50/1.000 resultados (API Ninja) a ~$2,00/1.000 resultados (Crawler Bros) — ambas tarifas requieren un plan de pago: API Ninja cobra 0,50 $ en cualquier plan de pago, mientras que Crawler Bros cobra 2,67 $ por 1.000 en Starter y solo baja a 2,00 $ en sus planes más altos
- Planes de plataforma desde 29 $/mes (Starter) — esos 29 $ son crédito de uso prepagado, no una cuota extra, e incluyen el descuento de Store
Ideal para
- Equipos de datos que necesitan conjuntos de reseñas a gran escala
- Desarrolladores que quieren extracción basada en API
- Proyectos de análisis de sentimiento y NLP
3. Octoparse — mejor scraper de escritorio sin código para TripAdvisor
 Octoparse es una herramienta de scraping visual para escritorio, sin código, con un constructor de flujos de trabajo de apuntar y hacer clic. Para TripAdvisor, Octoparse ofrece plantillas listas: pegas una URL, ejecutas la detección automática, revisas los campos sugeridos y exportas. La plantilla de TripAdvisor Hotel Reviews cuesta 0,8 $ por cada 1.000 líneas.
El constructor visual funciona bien si quieres más control que una extensión de Chrome, pero no quieres escribir código. Puedes definir lógica condicional, manejar paginación y programar ejecuciones en la nube. Pero hay dos matices importantes. Primero, las plantillas de TripAdvisor de Octoparse pueden romperse cuando TripAdvisor cambia el diseño de la página — y TripAdvisor lo hace a menudo. Segundo, las herramientas anti-bloqueo vienen incluidas, pero su uso está medido: el plan Standard ya incluye rotación de IP, proxies residenciales y resolución automática de captchas, así que no tienes que añadir nada antes de empezar; aun así, un trabajo con mucho DataDome consume ancho de banda de proxy y soluciones, y una vez superado lo cubierto por el plan, se factura a 3 $/GB y 1–1,5 $ por cada 1.000 soluciones.
Funciones clave
- Constructor visual de flujos de trabajo
- Plantillas TripAdvisor preconstruidas
- Ejecución local y en la nube
- Scraping programado
Precios
- Plan gratuito: 10 tareas, extracción local, 50.000 filas exportables al mes
- Plan Standard: 83 $/mes facturado mensualmente, o 69 $/mes facturado anualmente — la plantilla de TripAdvisor necesita este nivel. La página de precios de Octoparse muestra un precio Standard más alto, 119 $/mes, cuando indicas que vas a cubrir varios sitios con frecuencia; para un solo sitio, se mantiene en 83 $/69 $ por mucha frecuencia que tenga la actualización
- Uso de plantilla: 0,8 $/1.000 líneas para reseñas de hoteles de TripAdvisor
- Incluido en Standard: rotación de IP, proxies residenciales, resolución automática de captchas y un crédito mensual adicional del que se descuentan las plantillas premium, proxies y resoluciones; Octoparse no publica el tamaño de ese crédito. Una vez superado lo cubierto por el plan, las recargas cuestan 3 $/GB y 1–1,5 $ por 1.000 soluciones
Ideal para
- Usuarios que quieren un scraper visual con más control que una extensión de Chrome
- Equipos que extraen varios sitios de viajes, no solo TripAdvisor
4. ScrapFly — mejor scraper de TripAdvisor para desarrolladores Python
 ScrapFly es una API y SDK de scraping web pensada para desarrolladores. Envías peticiones HTTP a través de la infraestructura de ScrapFly, y esta se encarga de saltar anti-bots, renderizar JavaScript y rotar proxies por ti. ScrapFly tiene tutoriales y ejemplos de código específicos para TripAdvisor, lo cual suma bastante.
El flujo para desarrolladores es bastante claro: usa el SDK de Python de ScrapFly (o httpx/requests directamente) para obtener páginas de TripAdvisor, y el backend de ScrapFly se encarga de DataDome, captchas y renderizado. Luego recibes HTML o JSON en bruto, y tú escribes la lógica de parseo para extraer los campos que necesites.
Si quieres control fino — extracción personalizada de campos, lógica de paginación compleja, integración con tu propio pipeline de datos — ScrapFly cumple. Pero no es para usuarios no técnicos.
No hay interfaz visual ni exportación preconstruida a una hoja de cálculo, y los 1.000 créditos gratis que recibes al registrarte cubren unas 200 páginas de TripAdvisor con bypass anti-bot activado — suficiente para prototipar, no para sacar un trabajo completo.
Funciones clave
- API de bypass anti-bot (maneja DataDome y captchas)
- Renderizado de JavaScript
- Proxies rotativos integrados
- Tutorial y ejemplos de código para TripAdvisor
Precios
- Plan gratuito: 1.000 créditos al registrarte, sin tarjeta y sin caducidad
- Los créditos se cobran por solicitud: 1 para una petición simple a datacenter, 5 con renderizado JavaScript o bypass anti-bot, 25 con proxies residenciales
- Discovery cuesta 30 $/mes por 200.000 créditos prepagados; Pro cuesta 100 $/mes por 1.000.000
Ideal para
- Desarrolladores Python que crean scrapers personalizados de TripAdvisor
- Equipos que necesitan control fino sobre la lógica de extracción
5. Bright Data — mejor scraper de TripAdvisor para operaciones a escala enterprise
 Bright Data es la opción más completa. Ofrece un Web Scraper IDE para construir scrapers a medida, datasets ya preparados de TripAdvisor y la mayor red de proxies del sector — más de 400 millones de IPs entre residenciales, datacenter y móviles. Incluye resolución de captchas integrada.
La guía de scraping de TripAdvisor de Bright Data explica cómo usar Selenium con su infraestructura de navegador gestionado, apuntando a URLs de búsqueda de TripAdvisor con parámetros como q, geo, ssrc y offset. La guía también cubre los retos habituales de bloqueo: desafíos JavaScript, fingerprinting del navegador y contenido dinámico.
La contrapartida es la complejidad, no el precio. La API Web Scraper de Bright Data cuesta 1,5 $ por 1.000 registros en pago por uso sin necesidad de adquirir un plan, lo que sitúa 10.000 reseñas en 15 $ — en la práctica 7,50 $, ya que una cuenta nueva recibe 5.000 registros gratis al mes y se consumen primero. La parte cara es el trabajo alrededor de eso: eliges un dataset ya hecho o montas el Scraper IDE, no simplemente pulsas un botón. Y el plan Scale de 499 $/mes (384.000 registros incluidos) no compensa hasta pasar aproximadamente los 338.000 registros al mes — terreno enterprise, donde el mismo pipeline también extrae Booking.com y Google Maps.
Funciones clave
- Web Scraper IDE (visual + código)
- Más de 400 millones de proxies residenciales y datacenter
- Datasets de TripAdvisor listos para usar
- Manejo integrado de captchas y anti-bot
- Cumplimiento de nivel enterprise
Precios
- Plan gratuito: 5.000 registros al mes, renovados mensualmente y consumidos antes que cualquier opción de pago
- API Web Scraper: 1,5 $/1.000 registros en pago por uso
- Plan Scale: 499 $/mes por 384.000 registros
- Precios enterprise personalizados
Ideal para
- Equipos enterprise que necesitan datos de TripAdvisor a gran escala
- Empresas que requieren recopilación de datos preparada para cumplimiento normativo
- Agregación multiplataforma (TripAdvisor + Booking.com + Google Maps)
6. ScrapeHero — mejor servicio gestionado de scraping de TripAdvisor
 ScrapeHero es un servicio de scraping totalmente gestionado. Tú dices qué datos de TripAdvisor necesitas — hoteles de una región, reseñas de una serie de propiedades, fichas de restaurantes en una ciudad — y ScrapeHero construye, ejecuta y mantiene el scraper por ti. Te entregan datos limpios y estructurados según el calendario que marques.
Esta es la opción de "no quiero tocar ninguna herramienta". ScrapeHero se encarga de anti-bot, proxies, mantenimiento y formato de datos — tú recibes la entrega en CSV, JSON, Excel o vía API.
La desventaja es el coste. Los servicios gestionados suelen ser bastante más caros que las herramientas de autoservicio, y el tiempo de respuesta para peticiones personalizadas puede convertirse en un cuello de botella.
Funciones clave
- Scraping totalmente gestionado (sin configuración del usuario)
- Calendarios de entrega de datos personalizados
- Gestiona anti-bot, proxies y mantenimiento
- Salida estructurada de datos (CSV, JSON, Excel, API)
Precios
- Precio personalizado según volumen y complejidad — la página de precios presenta sus cifras publicadas como referencia, no como presupuesto final
- On Demand empieza en 550 $ por sitio y actualización, con configuración incluida y sin suscripción
- Business empieza en 199 $/mes por sitio, con una tarifa única de configuración adicional; ambos niveles están pensados para 1–5K páginas por sitio al mes
Ideal para
- Equipos de negocio que quieren datos de TripAdvisor entregados sin operar ninguna herramienta
- Empresas que necesitan feeds de datos fiables y continuos para inteligencia hotelera
7. WebAutomation.io — mejor para extraer datos de contacto de TripAdvisor
 WebAutomation.io es una plataforma de scraping sin código con extractores de TripAdvisor preconstruidos centrados en datos de contacto: nombres de hoteles, direcciones, servicios, emails, teléfonos, precios, reseñas y valoraciones. El flujo es sencillo: selecciona el extractor de TripAdvisor, introduce las URLs, ejecuta la extracción y descarga los datos.
La ventaja de WebAutomation.io es su enfoque en campos de generación de leads. Si eres un equipo comercial hotelero y tu objetivo principal es crear una lista de contactos — nombres, emails, teléfonos, direcciones — esta herramienta está pensada para eso. Es menos flexible que Thunderbit u Octoparse para scraping de uso general, pero para el caso concreto de extraer información de contacto de fichas de TripAdvisor, cumple sin problema.
Funciones clave
- Extractor de TripAdvisor preconstruido
- Extrae datos de contacto (email, teléfono, dirección)
- No requiere programación
- Scraping programado disponible
Precios
- Prueba gratuita para testear — la tarjeta del plan anuncia 10M créditos y la FAQ de la misma página dice 500, así que tómalo como una prueba, no como un nivel de volumen
- El plan Project cuesta 99 $/mes por 400.000 créditos, luego Start-Up 249 $, Business 449 $ y Corporate 999 $; un crédito equivale a una extracción exitosa de una página, y las recargas sin suscripción empiezan en 1 $ por 1.000 créditos
Ideal para
- Equipos comerciales que extraen información de contacto de hoteles/restaurantes para outreach
- Generación de leads a partir de fichas de TripAdvisor
8. Instant Data Scraper — mejor scraper gratis de TripAdvisor para trabajos rápidos
 Instant Data Scraper es una extensión gratuita de Chrome que detecta automáticamente tablas de datos en cualquier página web y te deja exportarlas con un clic. Entras a una página de TripAdvisor, haces clic en el icono de la extensión, detecta la tabla de datos y exportas a CSV o Excel. Sin cuenta, sin configuración, sin coste.
Me gusta Instant Data Scraper por lo que es: una forma rápida y gratis de capturar una pequeña muestra de datos. Si necesitas los 10 mejores hoteles de una página de resultados o unas cuantas reseñas para un análisis rápido, funciona. Pero no tiene absolutamente ningún manejo anti-bot. Tras unas pocas páginas, DataDome de TripAdvisor te bloqueará. No hay enriquecimiento de subpáginas, no hay programación, no hay adaptación por IA a cambios de diseño y no hay manera de escalar más allá de lo visible en una sola carga de página.
Funciones clave
- Extensión gratuita de Chrome
- Detecta automáticamente tablas de datos
- Exportación con un clic a CSV/Excel
- Sin cuenta ni configuración
Precios
- Completamente gratis
Ideal para
- Extracciones rápidas y puntuales de datos (unas pocas páginas de listados de hoteles)
- Investigadores académicos o estudiantes sin presupuesto
- Usuarios que solo necesitan una pequeña muestra de datos de TripAdvisor
Más allá de los hoteles: extraer restaurantes, atracciones y tours de TripAdvisor
La mayoría de las guías de scraping de TripAdvisor se quedan en los hoteles.
Pero los restaurantes y las atracciones representan una gran parte de las fichas de TripAdvisor. Los datos de esas páginas son igual de valiosos — quizá más para ciertos casos de uso.
Las páginas de restaurantes muestran tipo de cocina, rango de precios, platos del menú, tipos de comida, características, horarios, dirección, teléfono, web y subpuntuaciones por reseña de valor, servicio, comida y ambiente. Las páginas de atracciones muestran precios de entradas, horarios, duración estimada, consejos para visitantes y los nuevos resúmenes de reseñas generados por IA de TripAdvisor con etiquetas como "Ambiente", "Duración", "Mejor momento" y "Valor". Las páginas de tours van más allá con itinerarios, tamaño de grupo, idiomas del guía, inclusiones y códigos de producto.
Los scrapers basados en plantillas suelen soportar solo URLs de hoteles. Si pegas una URL de restaurante o atracción en una herramienta creada para la estructura de páginas de hotel, obtendrás datos rotos o incompletos.
Aquí es donde las herramientas impulsadas por IA marcan la diferencia. Thunderbit trabaja con la página que tengas abierta, así que la misma extensión que maneja una ficha de hotel también puede trabajar con una página de restaurante o una página de atracción. No tienes que esperar a que un proveedor publique una plantilla para cada categoría.
Esto también importa para la investigación de copy de marketing. Las reseñas de restaurantes y atracciones están llenas de las frases exactas que la gente usa para describir una cena o una visita a un museo. Si trabajas en marketing de hostelería, ese es el lenguaje que quieres en tus anuncios, landing pages y campañas de email.
¿Cuánto cuesta realmente extraer datos de TripAdvisor?
El coste es la pregunta que más escucho: ¿se puede hacer sin pagar proxies y solucionadores de captchas? Aquí va un desglose realista para extraer 10.000 reseñas de hotel, una referencia muy habitual.
Primero, una nota de normalización: actualmente TripAdvisor muestra 10 reseñas por página en las páginas de detalle de hotel, así que 10.000 reseñas ≈ 1.000 páginas de reseñas. Las herramientas que cobran por página en lugar de por fila tienen perfiles de coste muy distintos, así que la segunda columna de abajo refleja lo que realmente se cobra a tu tarjeta en un mes a este volumen: ya descontadas las cuotas gratuitas mensuales, y usando el plan mensual más barato que factura el proveedor. Varios de estos proveedores salen más baratos si pagas el año por adelantado, pero un prepago anual no es una factura mensual, así que no entra en la columna. Los extras — proxies, solucionadores, tiempo de desarrollo — tampoco entran en la cifra y se explican en la columna de al lado.
| Herramienta | Factura mensual real (10K reseñas) | Cómo se factura, qué se descuenta | Configuración y mantenimiento |
|---|---|---|---|
| Thunderbit | 288 $ pago único (Business si es mensual) | Las reseñas extraídas desde la página propia de cada ficha cuentan como filas de subpágina, así que cuestan 2 créditos cada una — 10.000 reseñas son 20.000 créditos. El plan Pro anual prepaga 30.000 créditos por 288 $, suficiente para una extracción única de este tamaño. Si lo repites cada mes, superas lo que cubren los planes autoservicio (Pro da 3.000 créditos al mes), así que pasa a ser presupuesto de Business. El plan gratis, 6 páginas al mes, no se acumula con un plan de pago. Una ejecución se detiene en 200 páginas paginadas, así que esto equivale a cinco ejecuciones para los mismos créditos. | 5 min; bajo — la IA vuelve a leer la página en cada ejecución |
| Apify (actor API Ninja) | 29 $/mes | El descuento de Apify Store empieza en Starter, así que la tarifa de 0,50 $ por 1.000 resultados es una tarifa de plan de pago — en el plan gratis el mismo actor factura diez veces más, y los 5 $ gratuitos compran alrededor de mil resultados sin pago por uso que te permita ir más allá. A diferencia de Crawler Bros más abajo, este actor cobra lo mismo en todos los planes de pago, así que Starter paga la tarifa destacada: 10.000 resultados cuestan 5,00 $ contra los 29 $ que ya tienes prepagados, así que la factura son 29 $. | 10 min; bajo |
| Apify (actor Crawler Bros) | 29 $/mes | Mismo plan de 29 $, pero se gasta más. Este actor fija el precio por nivel de plan: Starter paga 2,67 $ por 1.000, así que 10.000 resultados cuestan 26,70 $ — aún dentro de los 29 $ prepagados. El 2,00 $ por 1.000 destacado es lo que pagan los planes superiores. | 10 min; bajo |
| Instant Data Scraper | 0 $ | Extensión gratis, sin cuenta, sin cuota que descontar — y tampoco hay forma de completar el trabajo: DataDome lo bloquea tras unas pocas páginas. | 2 min; nada que mantener |
| Octoparse | 83 $/mes | Se factura por tareas y concurrencia en la nube, no por filas, así que el volumen no decide el nivel — lo decide la plantilla, y necesita Standard: 83 $/mes, o 69 $/mes facturado anualmente. Un solo sitio se mantiene en ese precio de 83$/69$ por muchas veces que lo actualices. Las líneas de la plantilla a 0,8 $/1.000, los proxies residenciales a 3 $/GB y las soluciones de captcha son extras que salen del crédito mensual adicional incluido en el plan, y Octoparse no publica su tamaño. | 30 min; medio — las plantillas se rompen cuando TripAdvisor mueve cosas |
| ScrapFly | 30 $/mes | TripAdvisor requiere activar el bypass anti-bot, que cuesta 5 créditos por solicitud, así que 1.000 páginas de reseñas = 5.000 créditos. Los 1.000 créditos de registro son únicos y cubren unas 200 páginas, así que el trabajo corre sobre Discovery: 30 $/mes por 200.000 créditos prepagados. La cuota nunca es el factor limitante aquí — la cuota del plan es toda la factura. | 1–2 horas de código; medio — tú eres dueño del parser |
| Bright Data | 7,50 $ | Un registro equivale a una fila, así que 10.000 reseñas = 10.000 registros = 15 $ a 1,50 $/1.000 en pago por uso. Una cuenta nueva recibe 5.000 registros gratis al mes, que se consumen antes que cualquier opción de pago, por lo que se reduce a la mitad. Sin plan obligatorio, sin compromiso mínimo. | 30 min; medio |
| ScrapeHero | Presupuesto personalizado | Se cotiza por sitio y por actualización, no por fila, y la página de precios presenta sus cifras como una base, no como precio final. Los mínimos son 550 $ por sitio y actualización (On Demand) o 199 $/mes por sitio más una tarifa de configuración única (Business) — ambos pensados para 1–5K páginas por sitio, el rango en el que entra 1.000 páginas de reseñas. | Ninguno — ellos lo construyen y lo ejecutan; ninguno |
| WebAutomation.io | Desde 1 $ | Un crédito equivale a una extracción exitosa de una página, así que 1.000 páginas de reseñas son aproximadamente 1.000 créditos, más si una página requiere varias solicitudes o renderizado JavaScript. Las recargas no necesitan suscripción y empiezan en 1 $ por 1.000 créditos; la suscripción más barata, Project a 99 $/mes, compra 400.000 créditos que aquí no llegarías a usar. El plan gratis se contradice en la propia página — 10M créditos en la tarjeta, 500 en la FAQ — así que no se descuenta nada. | Sin código, extractor preconstruido; bajo — el proveedor lo mantiene |
| Python DIY + proxies | Medido por gigabyte y por solución | La factura es ancho de banda residencial, alrededor de 3 $/GB — lo mismo que cobra Octoparse por ese extra — más 1–1,5 $ por cada 1.000 soluciones de captcha. Convertir eso en una cifra mensual requiere un dato de megabytes por página de reseña que no puedo justificar con una fuente, así que no hay una cifra única honesta que poner aquí. El tiempo de desarrollo se suma a todo lo anterior. | 4–8 horas; alto — el código se rompe |
El coste que más suele pasar desapercibido es el mantenimiento. Los scrapers Python DIY se rompen cuando TripAdvisor cambia sus IDs de consulta GraphQL, actualiza DataDome o reorganiza módulos de la página. He visto equipos pasar más tiempo depurando scrapers rotos que el que tardaron en construirlos al principio. Las herramientas con IA como Thunderbit vuelven a leer la página en cada ejecución, así que un cambio de diseño normalmente no se convierte en trabajo para ti — eso no significa que seas inmune a los bloqueos, pero sí que no tendrás que reescribir selectores cada vez que TripAdvisor mueva algo.
Sí existen rutas gratis, y todas se quedan cortas en algún punto. Los extractores de email y teléfono de Thunderbit son gratis, pero el plan gratuito es de 6 páginas al mes. El plan gratis de Apify te da 5 $ de uso de plataforma al mes. Instant Data Scraper es gratis y sigue hasta que DataDome te detecta.
¿Qué scraper de TripAdvisor encaja con tu caso de uso?
Distintos flujos de trabajo piden herramientas distintas. Aquí tienes una matriz de decisión basada en los casos de uso que más nos plantean nuestros usuarios:
| Caso de uso | Mejor herramienta(s) | Por qué |
|---|---|---|
| Exportar rápido reseñas de un hotel (1 propiedad) | Thunderbit, Instant Data Scraper | 1 clic, sin configuración |
| Análisis de sentimiento a gran escala (10K+ reseñas) | Apify, Bright Data | Diseñadas para volumen + salida por API |
| Monitorización semanal de la competencia | Thunderbit (Scheduled Scraper), Apify | Programación automática |
| Investigación académica (muestra pequeña, sin presupuesto) | Instant Data Scraper, plan gratuito de Thunderbit | Gratis — y pequeña: 6 páginas al mes en el plan free, e Instant Data Scraper se detiene cuando DataDome lo detecta |
| Agregación multiplataforma (TA + Booking + Google) | Thunderbit, Bright Data | Capacidad multi-sitio |
| Generación de leads en hostelería (emails, teléfonos) | Thunderbit, WebAutomation.io | Extracción de datos de contacto |
| Pipeline de datos personalizado (desarrollador) | ScrapFly, Apify | API-first, alta personalización |
| Entrega de datos sin intervención | ScrapeHero | Totalmente gestionado |
Una pregunta que sale a menudo en foros: ¿se pueden usar asistentes de programación con IA como ChatGPT o Claude para escribir scrapers de TripAdvisor? En teoría, una IA puede redactar un script de Python. En la práctica, esos scripts se rompen casi de inmediato en TripAdvisor porque DataDome derrota la automatización genérica del navegador. Una herramienta de scraping con IA como Thunderbit es fundamentalmente distinta de un asistente de programación con IA — Thunderbit se ejecuta en un entorno de navegador real con manejo anti-bot integrado, mientras que un script generado por ChatGPT corre en un navegador sin interfaz desnudo que DataDome bloquea al instante.
Si dos herramientas parecen igual de buenas en esa matriz, deja que decida el caso: una hoja de cálculo que alguien abrirá mañana, o un pipeline que tiene que seguir funcionando sin que nadie lo vigile.
Sin código vs. código: la ventaja de la extensión Chrome de 1 clic
La diferencia entre una extensión de Chrome y un script en Python es enorme para usuarios no técnicos. Así comparan los tres enfoques principales en una primera tarea de scraping de TripAdvisor:
| Factor | Extensión de Chrome (Thunderbit) | Plataforma sin código (Octoparse) | Python DIY |
|---|---|---|---|
| Tiempo hasta el primer resultado | ~2 minutos | ~15–30 minutos | ~2–4 horas |
| Requiere programación | No | No | Python intermedio |
| Gestiona cambios de diseño | ✅ La IA vuelve a leer la página en cada ejecución | ⚠️ La plantilla guardada deja de coincidir con la página | ❌ Requiere corrección manual |
| Enriquecimiento de subpáginas | ✅ 1 clic | ⚠️ Hay que configurar el flujo | Programación manual |
| Manejo anti-bot | Integrado (modo Cloud) | Incluido en el plan Standard | Proxies + captcha DIY |
Aquí va el mini tutorial de Thunderbit para TripAdvisor:
- Entra en cualquier página de TripAdvisor (hotel, restaurante, atracción) en Chrome
- Haz clic una vez en el icono de la extensión Thunderbit
- Thunderbit convierte la página en columnas (nombre del hotel, valoración, precio, número de reseñas, etc.)
- Empieza a extraer los datos por su cuenta — si una columna no era la que querías, cámbiala y vuelve a ejecutarlo
- Para obtener datos más ricos, ve un nivel más profundo — Thunderbit sigue cada enlace para extraer campos de la página de detalle (servicios, reseñas completas, datos de contacto)
- Exporta directamente a Google Sheets, Excel, Airtable o Notion
Todo el proceso tarda unos dos minutos para una página de listados, y la IA maneja la paginación automáticamente. Sin selectores que configurar, sin XPath que depurar, sin proxies que rotar.
Consejos para hacer scraping de TripAdvisor de forma responsable
Unas cuantas reglas básicas para hacerlo bien:
- Extrae solo datos disponibles públicamente. No inicies sesión para extraer contenido privado o restringido.
- Respeta los límites de velocidad. Si usas herramientas basadas en código, añade pausas entre solicitudes. Herramientas como Thunderbit y Apify lo gestionan automáticamente.
- No almacenes datos personales innecesariamente. El nombre de un usuario en una reseña pública es una cosa; extraer y guardar emails desde reseñas es otra.
- Usa los datos para fines comerciales legítimos — análisis competitivo, investigación de mercado, generación de leads, estudio académico.
- Ten en cuenta los Términos de Servicio de TripAdvisor sobre acceso automatizado. El marco legal del scraping web sigue evolucionando (GDPR, CCPA, políticas de plataformas), así que conviene estar al día.
Para profundizar en la parte legal, consulta nuestro artículo sobre implicaciones legales del web scraping.
Cómo elegir el mejor scraper de TripAdvisor para tus necesidades
La versión corta:
- Thunderbit es la vía más rápida de pasar de una página de TripAdvisor a una hoja de cálculo útil. Un clic, sin código, con IA que se adapta a hoteles, restaurantes, atracciones y tours. Ideal para equipos de ventas, operaciones y marketing que necesitan datos ya.
- Apify es la mejor relación valor/volumen para extracción masiva de reseñas si te sientes cómodo con una plataforma en la nube. Muy buena para análisis de sentimiento y proyectos de ciencia de datos.
- Instant Data Scraper es la mejor opción gratis para capturar una pequeña muestra — pero no esperes que escale más allá de unas pocas páginas.
- Octoparse funciona bien para quienes quieren un constructor visual con más control; los proxies y la resolución de captchas ya vienen con el plan, así que lo que debes presupuestar es el mantenimiento de plantillas y las recargas si el volumen supera la cuota.
- ScrapFly es la elección del desarrollador — alta personalización, API anti-bot sólida, pero tú escribes y mantienes tu propio código de parseo.
- Bright Data está pensada para recopilación de datos a escala enterprise y multiplataforma, con la red de proxies más grande del sector. Demasiado para equipos pequeños.
- ScrapeHero es la opción sin intervención — envías tus requisitos y recibes los datos limpios.
- WebAutomation.io es una opción de nicho para generación de leads en hostelería, centrada en extraer datos de contacto de fichas de TripAdvisor.
Si quieres ver cómo es el scraping moderno de TripAdvisor sin escribir una sola línea de código, empieza con el plan gratuito de Thunderbit y pruébalo en tu propia página de TripAdvisor. Creo que te sorprenderá lo rápido que pasas de "necesito estos datos" a "ya están en mi hoja de cálculo".
Elijas lo que elijas, pruébalo en una sola página antes de comprometerte con un plan — en dos minutos sabrás si supera DataDome en las páginas que de verdad te importan.
Prueba el scraping con IA de TripAdvisor con Thunderbit Get Started Free
Preguntas frecuentes
¿Es legal hacer scraping de TripAdvisor?
Extraer datos disponibles públicamente suele considerarse legal en muchas jurisdicciones, pero debes respetar los Términos de Servicio de TripAdvisor, evitar extraer contenido privado o restringido y cumplir normativas de privacidad como GDPR y CCPA. El panorama legal sigue cambiando, así que conviene mantenerse al día. Para más contexto, consulta nuestra guía sobre implicaciones legales del web scraping.
¿Por qué TripAdvisor bloquea mi scraper tan rápido?
Porque DataDome perfila el navegador y el comportamiento, no solo la IP — así que ralentizar el script o cambiar a una dirección nueva ayuda poco una vez que tu configuración ya ha sido identificada por huella. Sí ayudan dos cosas: ejecutar desde una sesión real de Chrome que ya uses, que parece una persona navegando, o pagar por infraestructura que se encargue de huellas y captchas por ti — Apify, Bright Data y ScrapFly integran proxies y resolución, y el modo Cloud de Thunderbit lo hace en sus propios servidores.
¿Puedo extraer restaurantes y atracciones de TripAdvisor, no solo hoteles?
Sí, pero no todas las herramientas soportan páginas que no sean de hoteles. Los scrapers basados en plantillas pueden funcionar solo con URLs de hotel. Las herramientas con IA como Thunderbit se adaptan a cualquier tipo de página de TripAdvisor — restaurantes, atracciones, tours — porque leen la estructura de la página de forma dinámica en lugar de depender de plantillas fijas. Restaurantes, atracciones y tours ocupan una parte importante de lo que hay en TripAdvisor, así que hay muchos datos más allá de los hoteles.
¿Existe un scraper de TripAdvisor completamente gratis?
Instant Data Scraper es 100% gratis y sirve para trabajos pequeños y rápidos (unas pocas páginas de listados). Thunderbit ofrece un plan gratuito con 6 páginas, y el plan free de Apify incluye 5 $ de uso de plataforma al mes. Para cualquier cosa más allá de una muestra pequeña, probablemente necesitarás una herramienta de pago — pero puedes empezar perfectamente a coste 0 para probar si encaja con tu flujo de trabajo.
¿Puedo extraer reseñas de TripAdvisor sin programar?
Por supuesto. Thunderbit solo requiere 1 clic — abre una página de TripAdvisor, lanza la extensión y la IA toma el control: elige las columnas, ejecuta la extracción y te deja una tabla lista para exportar. ¿Quieres campos concretos? Díselo y construye la tabla en torno a eso. Octoparse y WebAutomation.io también ofrecen interfaces sin código, aunque requieren más tiempo de configuración. Para un paso a paso, consulta nuestra plantilla de scraper de TripAdvisor o mira tutoriales en el canal de YouTube de Thunderbit. Más información



